Ringkasan: Dalam tugas video berbasis kode di VibeVideoBench, GPT-6 Astra sudah berada di level yang sama dengan Claude Opus 5.5, dengan kualitas keseluruhan sedikit lebih tinggi dan biaya lebih rendah; Opus 5.5 lebih stabil dalam hal pengiriman; model umum generasi berikutnya dari OpenAI belum dirilis, dan kemampuan videonya perlu diuji setelah peluncuran.
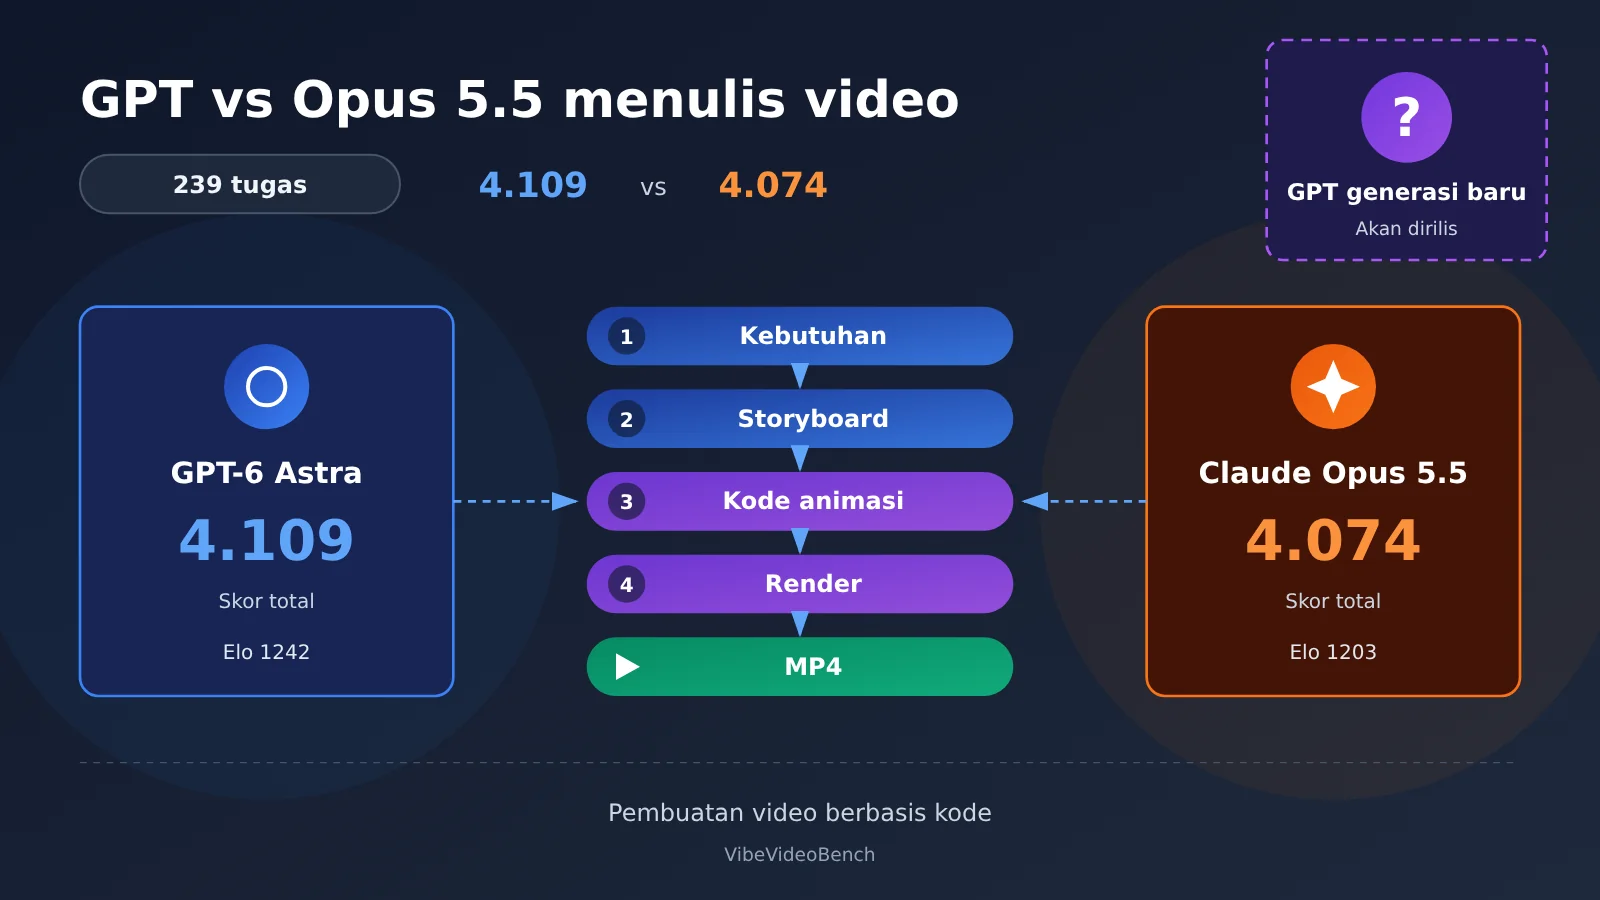
Kesimpulan di awal: Per 15 November 2026, pada jalur “Agent menulis kode, memanggil alat render, dan mengirimkan MP4 lengkap”, GPT-6 Astra dan Claude Opus 5.5 adalah dua sistem yang paling berdekatan di VibeVideoBench. Skor kualitas keseluruhan Astra adalah 4.109, sedangkan Opus 5.5 adalah 4.074; Elo dalam uji buta manusia masing-masing 1242 dan 1203, dan secara statistik keduanya tidak dapat dibedakan. Opus 5.5 mengirimkan seluruh 239 tugas, dengan tingkat keberhasilan tugas ketat 76.3%, lebih tinggi daripada 74.5% milik Astra; biaya API rata-rata per tugas Astra adalah 8.19 dolar AS, sekitar setengah dari Opus 5.5. OpenAI telah mempublikasikan dua bukti bahwa model internal secara signifikan lebih kuat daripada Astra, tetapi nama, waktu peluncuran, dan skor khusus video dari GPT umum generasi berikutnya belum diumumkan. Jadi jawaban atas pertanyaan di judul adalah: GPT yang ada saat ini sudah menyusul, dan apakah generasi berikutnya bisa memperlebar jarak bergantung pada pengujian setelah peluncuran.
Pratinjau isi: Bagian berikutnya akan terlebih dahulu menetapkan cakupan evaluasi, lalu membedah skor keseluruhan, skor per kategori, preferensi manusia, dan data biaya VibeVideoBench, serta menjelaskan dari mana keunggulan masing-masing berasal; setelah itu merangkum sinyal publik dari model internal OpenAI dan status rilis model generasi berikutnya, serta menganalisis hambatan sebenarnya dari Agent video; terakhir memberikan metode pengujian perbandingan yang dapat langsung digunakan kembali setelah model baru dirilis, untuk membantu Anda menilai apakah model tersebut layak menggantikan solusi yang ada.
Perlu Diketahui: Istilah yang perlu dipahami sebelum membaca artikel ini
| Istilah | Penjelasan |
|---|---|
| Code-driven Video Generation | Pembuatan video berbasis kode: AI menulis program animasi dan rendering, lalu menghasilkan output MP4 |
| Native Video Generation | Pembuatan video native: model langsung menghasilkan gambar video berdasarkan teks atau gambar, dengan produk unggulan seperti Sora dan Veo |
| VibeVideoBench | Benchmark evaluasi khusus untuk menguji AI Agent membuat video lengkap secara mandiri, dirilis pada 26 Oktober 2026 |
| Harness | Lingkungan tempat model berjalan, menyediakan eksekusi kode, akses file, pemanggilan tool, dan kemampuan lain, seperti Codex CLI dan Claude Code |
| L1 / L2 / L3 | Tiga lapisan evaluasi: pemeriksaan penyerahan program, pemeriksaan persyaratan tugas satu per satu, dan penilaian kualitas video melalui tinjauan multimodal |
| Tingkat keberhasilan tugas ketat | Proporsi tugas yang videonya berhasil diserahkan dan memenuhi seluruh batasan, lebih ketat daripada sekadar “tingkat penyerahan” |
| Bradley–Terry Elo | Metode penilaian yang menghitung preferensi relatif model berdasarkan hasil perbandingan berpasangan secara manual |
| Multi-agent Orchestration | Orkestrasi multi-agen: membiarkan beberapa Agent berbagi tugas dan berkolaborasi, lalu menggabungkan hasilnya |
| Render Pipeline | Alur rendering video: pembuatan visual, pemrosesan audio, encoding dan penggabungan hingga output akhir |
| Remotion / FFmpeg | Yang pertama menggunakan kode React untuk menulis animasi video, yang kedua menangani encoding dan penggabungan audio-video |
| ffprobe | Alat pemeriksa bawaan FFmpeg, digunakan untuk membaca informasi video seperti resolusi, frame rate, durasi, trek audio, dan lain-lain |
| Cache Hit | Rasio cache hit: proporsi konteks berulang yang dibaca dari cache, langsung memengaruhi biaya API untuk tugas panjang |
| BenchCAD 2.0 | Evaluasi teknik untuk menguji kemampuan AI dalam rekonstruksi komponen 3D, desain perakitan mekanis, dan pengenalan koneksi PCB |
1 Kesimpulan di awal: GPT kini sudah bersaing di wilayah pembuatan video yang sama dengan Opus 5.5
1.1 Jenis “menulis video” mana yang dibandingkan dalam artikel ini?
Pembuatan video AI saat ini memiliki dua jalur. Pembuatan video native membuat model langsung menghasilkan rangkaian gambar bergerak; jalur ini unggul dalam karakter, gerakan fisik, dan bahasa kamera. Pembuatan video berbasis kode menjadikan model sebagai sutradara sekaligus programmer: memahami kebutuhan, menulis skrip dan storyboard, membuat animasi dengan Remotion, Three.js, Cairo, atau Blender, menghasilkan narasi dengan TTS, lalu menggabungkan dan memeriksa video final dengan FFmpeg.
Artikel ini membahas jalur kedua, yaitu kemampuan untuk mengirimkan MP4 lengkap dan proyek yang dapat diedit melalui Agent seperti Codex CLI dan Claude Code. Jalur ini cocok untuk visualisasi data, pengenalan produk, edukasi pengetahuan, infografis dinamis, dan video promosi merek, dan juga merupakan bidang di mana GPT dan Claude saat ini memiliki benchmark independen yang dapat dibandingkan.
Lini produk video native OpenAI sendiri telah berubah: produk Sora berhenti beroperasi pada 26 April 2026, model Sora 2 dan Videos API ditutup pada 24 September, dan pengumuman deprecation resmi mencatat tidak ada API pengganti satu-ke-satu. GPT-Image-2.6 yang dirilis 4 November mendukung output animasi GIF 2–16 frame, cocok untuk stiker, gerakan berulang, dan pratinjau storyboard, serta berada dalam alur kerja yang berbeda dari produksi MP4 lengkap. Oleh karena itu, kemampuan “menulis video” seri GPT saat ini terutama terlihat pada jalur berbasis kode.
1.2 Jawaban singkat untuk pertanyaan di judul
GPT-6 Astra di VibeVideoBench sangat dekat dengan Opus 5.5: skor keseluruhan sedikit lebih tinggi, tetapi stabilitas pengiriman sedikit lebih rendah. Model generasi berikutnya dari OpenAI memiliki sinyal teknis untuk terus meningkat, tetapi hasil publik khusus video saat ini masih menjadikan Astra sebagai acuan.
2.239 tugas video nyata: GPT-6 Astra vs Opus 5.5, siapa yang lebih kuat?
2.1 Bagaimana VibeVideoBench mengukur kemampuan video GPT dan Opus 5.5
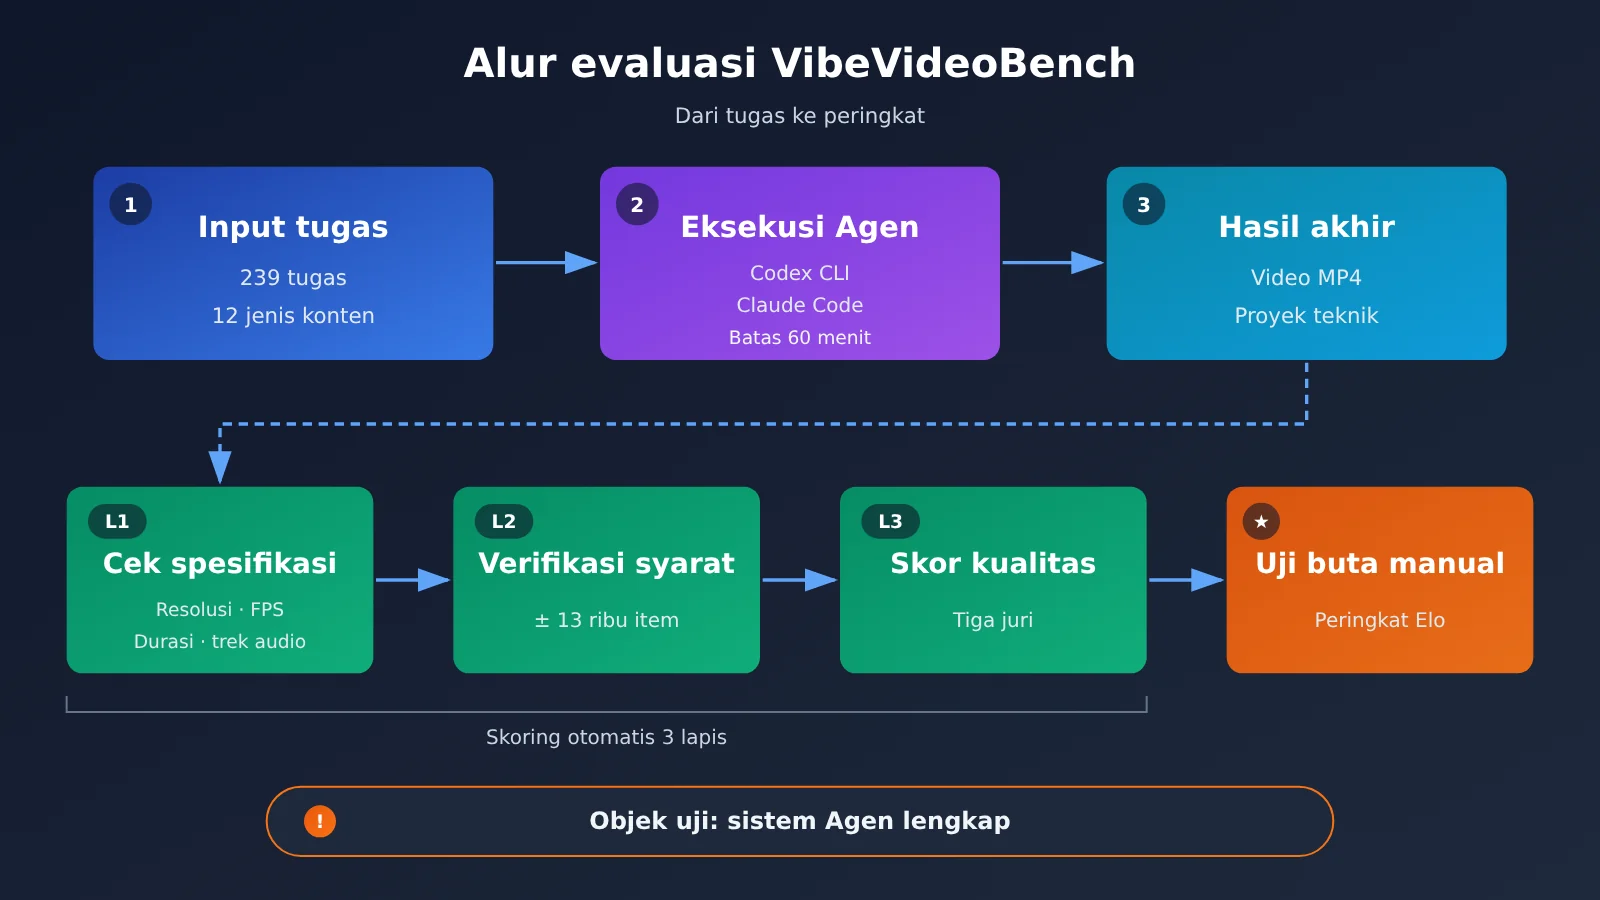
VibeVideoBench menyusun 2.239 tugas produksi video nyata, mencakup 12 kategori konten, dan menguji 9 sistem Agent dengan total 2.151 kali eksekusi. Setiap tugas menuntut AI menyelesaikannya secara mandiri di dalam sandbox, lalu menyerahkan MP4 yang bisa diputar, proyek rekayasa yang memungkinkan video dibuat ulang, serta dokumentasi pembuatannya. Setiap tugas dibatasi 60 menit, dan semua sistem memakai lingkungan pengembangan native masing-masing dengan tingkat penalaran tertinggi yang tersedia, tanpa instruksi manusia tambahan di tengah jalan.
GPT-6 Astra berjalan di Codex CLI, sedangkan Claude Opus 5.5 berjalan di Claude Code. Sistem lain yang ikut diuji meliputi Claude Sonnet 5.5, Gemini 4 Argon, DeepSeek V4.1 Flash, Kimi K3, GLM-5.3 Flash, GPT-5.6 Sol, dan Gemini 3.8 Flash. Penilaian dibagi menjadi tiga lapis: L1 memeriksa apakah MP4 sudah diserahkan beserta spesifikasi seperti resolusi, frame rate, durasi, dan trek audio; L2 memverifikasi sekitar 13.000 persyaratan tugas satu per satu; L3 menggunakan tiga sistem juri multimodal untuk menilai kualitas gambar, estetika, logika konten, ritme gerakan, dan sinkronisasi audio.
2.2 Perbandingan Skor Keseluruhan GPT-6 Astra dan Opus 5.5
| Metrik | GPT-6 Astra | Claude Opus 5.5 | Keunggulan |
|---|---|---|---|
| Video berhasil dikirim | 238/239 | 239/239 | Opus |
| Tingkat pengiriman video | 99.6% | 100% | Opus |
| Tingkat kesesuaian spesifikasi | 93.7% | 99.6% | Opus |
| Tingkat kelulusan persyaratan tugas | 97.1% | 97.3% | Opus |
| Kualitas video | 4.08 | 3.99 | Astra |
| Estetika visual | 4.30 | 4.19 | Astra |
| Logika konten | 4.20 | 4.18 | Astra |
| Gerakan dan ritme | 3.95 | 3.95 | Seri |
| Kualitas audio dan sinkronisasi | 4.10 | 4.07 | Astra |
| Skor kualitas keseluruhan | 4.109 | 4.074 | Astra |
| Tingkat keberhasilan tugas ketat | 74.5% | 76.3% | Opus |
| Elo preferensi manusia | 1242 | 1203 | Tidak dapat dibedakan secara statistik |
Data berasal dari hasil rata-rata tiga panel juri, dengan rentang penilaian 1—5. Kedua sistem sama-sama unggul dibandingkan sistem lain yang ikut diuji.
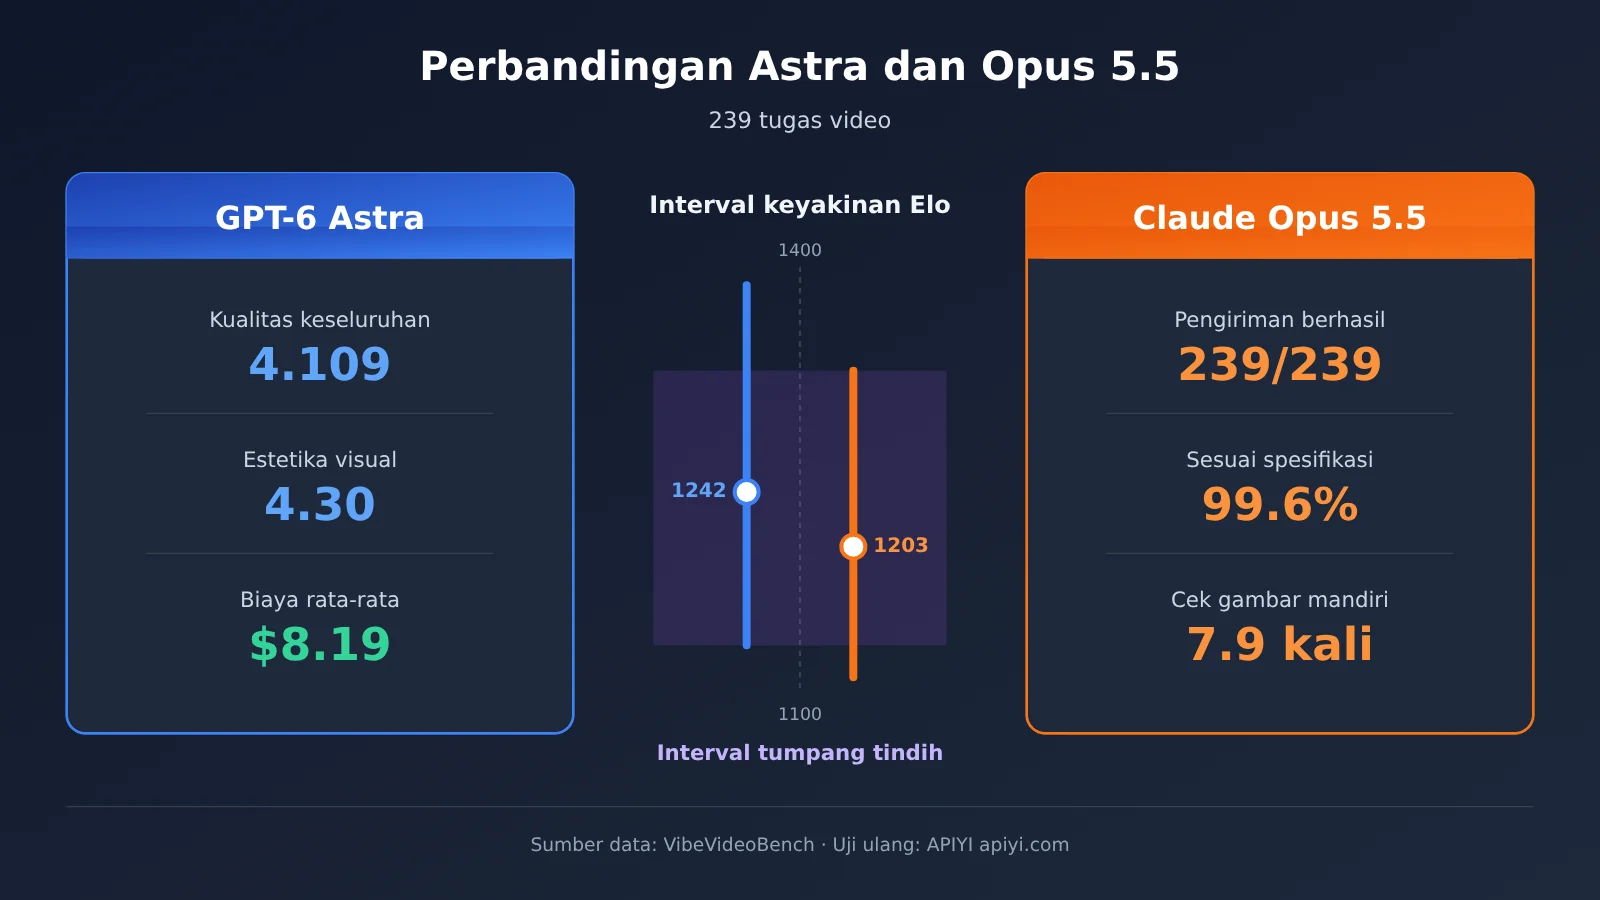
Tabel ini memperlihatkan pembagian yang jelas: Astra sedikit lebih unggul dalam hal “apakah video yang dihasilkan enak dilihat”, memimpin 0,035 poin pada kualitas keseluruhan dan 0,11 poin pada estetika visual; sementara Opus 5.5 lebih andal dalam hal “apakah bisa dikirim sesuai spesifikasi”, dengan tingkat kesesuaian spesifikasi lebih tinggi 5,9 poin persentase dan tingkat keberhasilan tugas ketat lebih tinggi 1,8 poin persentase. Selisih 0,035 poin sangat kecil, dan jika dilihat bersama interval kepercayaan Elo, keduanya berada di tingkat yang sama.
2.3 Distribusi keunggulan GPT dan Opus 5.5 pada berbagai jenis video
| Jenis video | Astra | Opus 5.5 | Yang unggul |
|---|---|---|---|
| Merek dan pemasaran | 4.18 | 4.18 | Seri |
| Demonstrasi produk dan fitur | 4.20 | 4.24 | Opus |
| Berbasis musik dan suara | 3.83 | 3.92 | Opus |
| Pembahasan makalah | 4.03 | 4.07 | Opus |
| Penjelasan konsep dan proses | 4.19 | 4.15 | Astra |
| Cerita data dan fakta | 4.14 | 4.01 | Astra |
| Seni visual | 3.94 | 3.91 | Astra |
| Permainan dan olahraga | 4.15 | 4.12 | Astra |
| Acara dan ekspresi pribadi | 4.03 | 3.93 | Astra |
| Cerita dan komedi visual | 4.00 | 3.88 | Astra |
| Proses pembangunan dan pembuatan | 3.97 | 3.94 | Astra |
| Pengajaran di kelas | 4.47 | 4.45 | Astra |
Data berasal dari Appendix E.4 makalah, dengan menghitung video yang tidak terkirim sebagai nilai nol.
Astra unggul di 8 dari 12 kategori, dengan selisih terbesar pada cerita data dan fakta (0,13) serta cerita dan komedi visual (0,12); Opus 5.5 unggul pada demonstrasi produk, berbasis musik, dan pembahasan makalah, dengan selisih pada kategori berbasis musik sebesar 0,09. Tugas berbasis musik menuntut keselarasan audio-visual yang tinggi, sedangkan demonstrasi produk menuntut spesifikasi dan detail yang tinggi, dan ini sejalan dengan arah keunggulan Opus pada tingkat kesesuaian spesifikasi. Selisih di sebagian besar kategori berada dalam 0,05 poin, sehingga pilihan model sudah menunjukkan perbedaan berdasarkan jenis tugas, tetapi selisih per kategori masih perlu dinilai bersama pengujian berulang.
2.4 Mengapa Opus 5.5 Masih Kompetitif
Pengujian blind oleh manusia menggunakan model Bradley–Terry untuk menghitung Elo. Astra memperoleh 1242 (interval kepercayaan 95% 1134–1387), Opus 1203 (1111–1327). Interval kepercayaan peringkat keduanya sama, yaitu 1–3. Probabilitas perbandingan yang diberikan dalam makalah adalah P=0.69, sehingga kesimpulannya secara statistik keduanya tidak dapat dibedakan. Perlu dicatat, pengujian manusia hanya menilai video yang sudah dikirim dan tidak dapat mengukur kemampuan pengiriman tepat waktu—padahal pengiriman justru merupakan kekuatan Opus.
Perilaku pemeriksaan mandiri menjelaskan hal ini. Setiap kali dijalankan, Opus rata-rata melihat gambar hasil render 7.9 kali dan menggunakan ffprobe 3.9 kali; Astra masing-masing 3.4 kali dan 2.1 kali. Opus lebih sering memeriksa outputnya sendiri, menemukan masalah, lalu memperbaikinya. Sebagai hasilnya, tingkat pengiriman mencapai 100% dan tingkat kesesuaian spesifikasi 99.6%. Anthropic memposisikan Opus 5.5 sebagai model Agentic Coding yang berjalan lama. Di komunitas, ada juga pengguna yang mengaku menggunakan Opus 5.5 sekitar 30 menit untuk menyelesaikan video promosi aplikasi iOS, membuat video pendek berita vertikal 1080×1920 secara otomatis, lengkap dengan subtitle SRT. Ini adalah kasus perorangan dan dapat menjadi bukti pendukung kelengkapan alur kerja.
2.5 Biaya tugas video: harga satuan GPT-6 Astra lebih tinggi, biaya per tugas lebih murah
| Metrik | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|
| Harga input standar (USD/juta Token) | 10 | 4 |
| Harga output standar (USD/juta Token) | 50 | 20 |
| Biaya rata-rata per tugas | $8.19 | $15.38 |
| Biaya median per tugas | $7.88 | $10.19 |
| Biaya tugas P90 | $11.88 | $31.22 |
| Rata-rata Token output | 61K | 130.7K |
| Panggilan API per tugas | 46 | 51 |
| Cache Hit | 97% | 65% |
Harga satuan standar Astra 2.5 kali lipat Opus 5.5, tetapi biaya rata-rata per tugasnya sekitar 46.7% lebih rendah. Ada dua alasan: output Token Astra sekitar 53.3% lebih sedikit; tingkat cache hit Astra mencapai 97%, sedangkan sekitar 76% biaya tugas Opus berasal dari penulisan cache. Selisih biaya P90 lebih terlihat jelas; Opus mengalami fluktuasi biaya yang lebih besar pada tugas kompleks. Makalah tersebut juga menunjukkan bahwa menambah konsumsi Token saja tidak menghasilkan peningkatan kualitas yang sepadan.
Kelompok biaya ini adalah biaya ekuivalen yang dihitung berdasarkan harga API publik, tidak termasuk biaya tenaga kerja dan materi untuk video komersial lengkap. Batch API resmi Opus 5.5 memberikan potongan 50% untuk input dan output; saat produksi batch offline, struktur biaya akan berubah.
💰 Optimasi biaya: Biaya per tugas Agent video sangat dipengaruhi oleh cache hit dan panjang output; hanya melihat harga satuan mudah menimbulkan salah penilaian. Sebaiknya di APIYI apiyi.com jalankan tugas yang sama pada kedua model, lalu hitung berdasarkan “konsumsi aktual per video jadi”, bukan membandingkan harga resmi.
3 Sinyal Peningkatan Kemampuan GPT Generasi Berikutnya dari OpenAI
3.1 Penelitian Navier–Stokes: Model Internal Jauh Lebih Kuat daripada GPT-6 Astra
Pada 8 September 2026, OpenAI merilis hasil penelitian atas masalah Hadiah Milenium Navier–Stokes. Artikel resmi menyatakan bahwa model internal yang digunakan memiliki kemampuan yang jauh lebih kuat daripada GPT-6 Astra, dilatih menggunakan pembelajaran penguatan berskala besar, dan pada saat pengumuman dirilis pelatihan masih berlanjut.
Skala eksekusi penelitian ini merupakan demonstrasi langsung kemampuan multi-agen: sekitar 10.000 Agen berpartisipasi secara bersamaan, penelitian memakan waktu sekitar 88 jam, menghasilkan 2,7 juta pesan dan sekitar 130 miliar Token keluaran; Agen-agen dikelompokkan untuk meneliti berbagai versi masalah, kelompok-kelompok tersebut saling bertukar informasi, Codex mengintegrasikan hasil antara, dan sistem terus memusatkan sumber daya pada jalur yang lebih menjanjikan. Validasi formal Lean di bagian akhir membutuhkan waktu tambahan 17 jam, menggunakan GPT-6 Astra.
Bagi pembuatan video, yang paling relevan di sini adalah penjadwalan tugas jangka panjang dan kolaborasi multi-Agen, bukan kemampuan matematika itu sendiri. Sebuah video kompleks juga membutuhkan pemrosesan paralel atas skrip, animasi, dan audio, lalu integrasi, pemeriksaan, dan pengerjaan ulang.
3.2 BenchCAD 2.0: Kemampuan Rekayasa Meningkat dari 0,594 menjadi 0,875
Pada 3 November 2026, OpenAI dalam 《Accelerating engineering for the physical world》 mengumumkan: sebuah model internal yang lebih baru memperoleh skor rata-rata 0,875 pada BenchCAD 2.0, sedangkan GPT-6 Astra pada tingkat penalaran tertinggi memperoleh 0,594, peningkatan relatif sekitar 47,3%. Isi pengujian mencakup rekonstruksi komponen tiga dimensi, desain perakitan mekanis, dan identifikasi koneksi PCB.
Kedua bukti ini sebaiknya dipandang secara terpisah. OpenAI tidak menjelaskan apakah model yang diuji pada BenchCAD dan model penelitian Navier–Stokes adalah model yang sama, dan nama serta waktu rilis keduanya juga belum diumumkan. BenchCAD adalah pengujian rekayasa yang diumumkan sendiri oleh OpenAI, merupakan sinyal kemajuan dalam pemahaman spasial dan pengetahuan rekayasa yang kompleks, dan tidak memiliki korespondensi langsung dengan tugas pembuatan video.
3.3 Kapan GPT Generasi Berikutnya Dirilis: Status Publik hingga 15 November
| Tanggal | Kemajuan Publik |
|---|---|
| 2 November | Menurut laporan The National, Altman di ADIPEC menyatakan bahwa penelitian matematika menggunakan model GPT yang akan segera dirilis, sekitar 10.000 Agen berkolaborasi sekitar empat hari; laporan mencatat bahwa pernyataan tersebut belum diverifikasi secara independen |
| 3 November | OpenAI mengumumkan data BenchCAD 2.0 dari model internal |
| 4 November | The Information mengutip sumber yang mengetahui melaporkan bahwa OpenAI mungkin meluncurkan generasi baru Astra, Sol, dan model keamanan siber paling cepat pada 6 November |
| 5 November | OpenAI API Changelog mengonfirmasi rilis GPT-6 Cyber, tidak merilis Astra atau Sol umum generasi baru |
| 15 November | Model unggulan umum dalam katalog model resmi masih GPT-6 Astra, GPT-6.1 Sol, GPT-6.1 Terra, GPT-6 Luna |
Nama-nama seperti GPT-6.2 Astra, GPT-6.2 Sol yang beredar di internet saat ini belum mendapatkan konfirmasi resmi dari OpenAI. Perlu diperhatikan juga bahwa VibeVideoBench menguji GPT-6 Astra dan GPT-5.6 Sol, skor Astra tidak dapat langsung diterapkan pada GPT-6.1 Sol atau Terra.
4 Apa lagi yang dibutuhkan GPT generasi berikutnya untuk melampaui Opus 5.5 dalam pembuatan video
4.1 Hambatan sebenarnya Agent video: manajemen waktu dan penyampaian hasil
Dari total 2,151 percobaan di VibeVideoBench, 224 di antaranya tidak menghasilkan video yang dapat diputar. Sebanyak 169 kasus merupakan masalah manajemen waktu: rendering akhir dimulai terlalu lambat, proses berjalan terlalu lambat, atau tidak dimulai sama sekali—sekitar 75% dari seluruh kegagalan. Lingkungan pengujiannya adalah kontainer Docker seragam dengan CPU 8 inti, RAM 32GB, dan tanpa GPU, sehingga proses rendering sendiri memang memakan waktu yang tidak sedikit.
Ini menunjukkan bahwa peningkatan kemampuan penalaran model tetap harus diwujudkan dalam ritme eksekusi. Sekalipun sebuah model menulis animasi dengan sangat rapi, jika rendering baru dimulai pada menit ke-55, hasilnya tetap nol. Astra dan Opus 5.5 sudah sulit dibedakan dalam hal kualitas; peluang GPT generasi berikutnya untuk menonjol terutama ada di sisi penyampaian hasil.
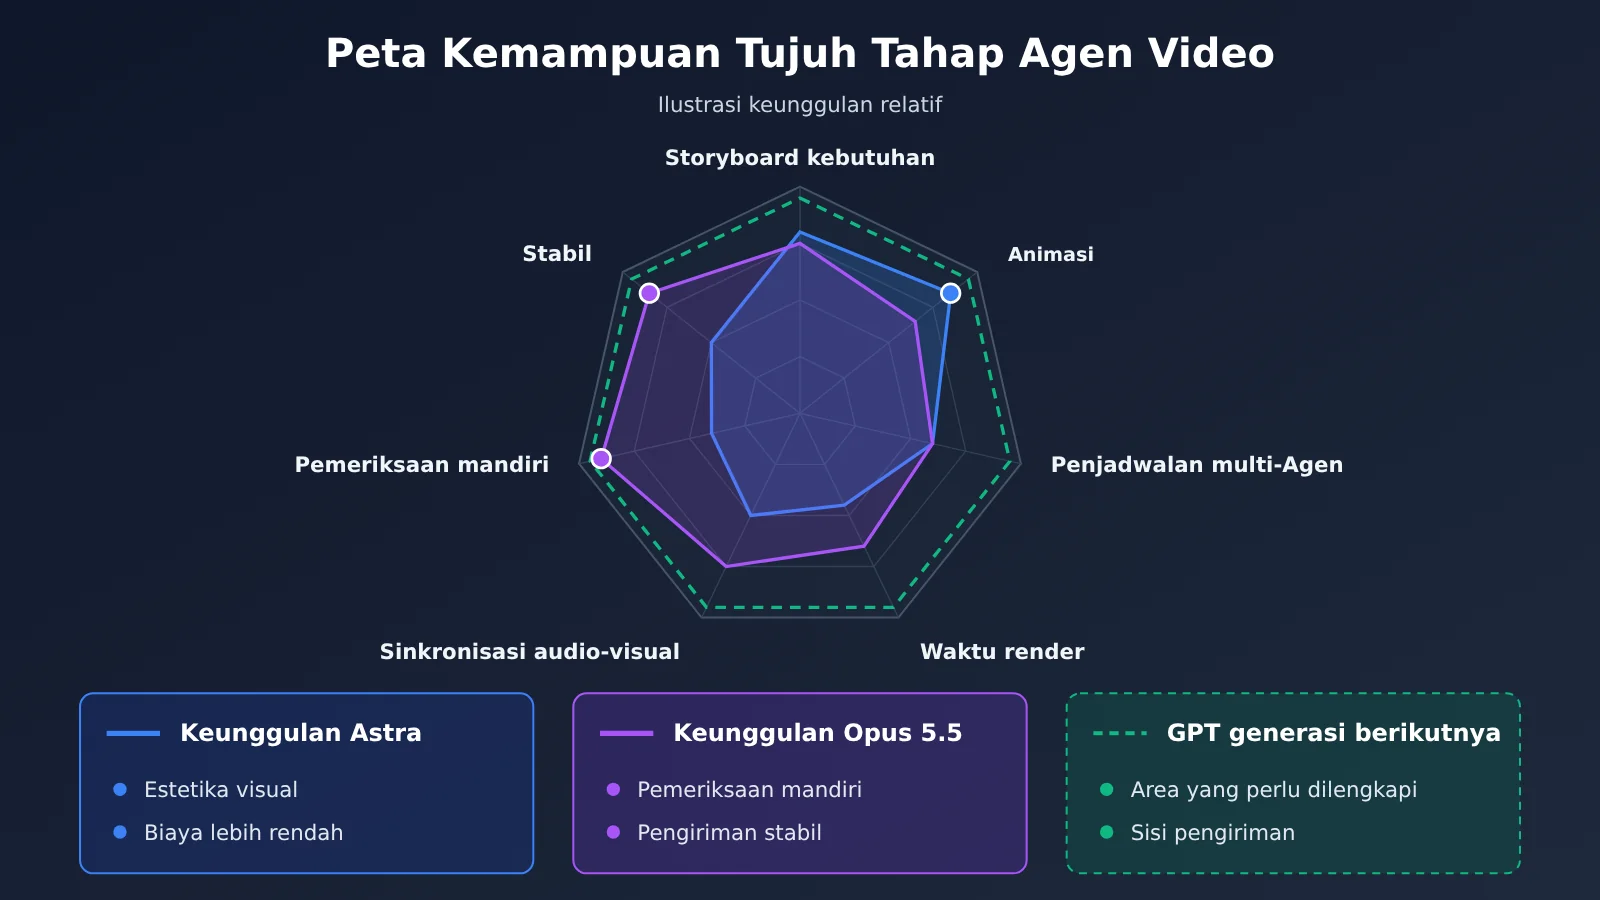
4.2 Tujuh titik peningkatan GPT generasi berikutnya dalam alur kerja video
Dengan mempertimbangkan kekuatan dan kelemahan masing-masing saat ini, agar model generasi berikutnya dapat melampaui Opus 5.5 secara signifikan, model tersebut perlu meningkat secara bersamaan pada aspek-aspek berikut:
- Pemahaman kebutuhan dan storyboard: memahami tema, audiens, dan gaya secara akurat, serta memecah kebutuhan menjadi urutan shot dan garis waktu.
- Kode animasi kompleks: menulis animasi Remotion, Three.js, dan Python dengan benar pada percobaan pertama, sehingga mengurangi rendering ulang.
- Orkestrasi multi-Agent: memparalelkan skrip, animasi, dan audio; kemampuan orkestrasi yang ditunjukkan model internal dalam penelitian matematika perlu dialihkan ke tugas rekayasa seperti ini.
- Waktu rendering: menyediakan waktu rendering yang cukup, menghindari masalah manajemen waktu yang menyumbang sekitar tiga perempat dari total kegagalan.
- Sinkronisasi audio-visual: menyelaraskan narasi, efek suara, dan ritme visual; ini adalah area tempat Opus unggul dalam tugas yang digerakkan oleh musik.
- Pemeriksaan mandiri aktif: Opus rata-rata memeriksa gambar 7.9 kali, sedangkan Astra 3.4 kali; frekuensi pemeriksaan mandiri berkorelasi langsung dengan tingkat kesesuaian terhadap spesifikasi.
- Penyampaian hasil yang stabil: MP4 lengkap ditambah proyek yang dapat diedit, memenuhi spesifikasi dalam sekali percobaan.
5 Setelah GPT generasi berikutnya dirilis, bagaimana memverifikasi apakah model itu benar-benar melampaui Opus 5.5
5.1 Metode pengujian perbandingan tujuh langkah
Papan peringkat publik hanya dijalankan sekali, dibatasi 60 menit, dan didominasi tugas berbahasa Inggris (209 dari 239 item berbahasa Inggris); skenario bisnis berbahasa Mandarin perlu diuji ulang sendiri. Metode berikut dapat langsung dipakai pada hari model baru dirilis:
| Langkah | Cara | Metrik yang diperhatikan |
|---|---|---|
| 1 Menetapkan set tugas | Pilih 10—20 kebutuhan video bisnis nyata, mencakup naskah, animasi, visualisasi data, dan presentasi produk | Cakupan tugas |
| 2 Menetapkan lingkungan | Seragamkan rantai alat (versi Remotion/FFmpeg), konfigurasi mesin, dan batas waktu; perbedaan Harness dicatat terpisah | Keterbandingan |
| 3 Uji per tahap | Pertama uji storyboard dan kode animasi secara terpisah lewat API, lalu jalankan seluruh alur di lingkungan Agen | Skor per tahap |
| 4 Catat konsumsi | Durasi, Token input/output, dan cache hit setiap kali dijalankan | Biaya per video |
| 5 Pemeriksaan hasil | Gunakan ffprobe untuk memeriksa resolusi, frame rate, durasi, dan trek audio | Tingkat pengiriman, tingkat kesesuaian spesifikasi |
| 6 Uji buta dan pengulangan | Samarkan nama model untuk perbandingan berpasangan; setiap tugas dijalankan minimal 3 kali | Tingkat kemenangan preferensi, varians |
| 7 Penilaian menyeluruh | Bobot untuk kualitas, tingkat keberhasilan, biaya revisi, dan biaya per video | Kesimpulan akhir pemilihan model |
Langkah 3 memisahkan “kemampuan model” dari “kemampuan lingkungan Agen”. VibeVideoBench menguji sistem Agen secara utuh, sedangkan Codex CLI dan Claude Code sendiri juga memiliki perbedaan; dengan memanggil kedua model secara langsung melalui antarmuka kompatibel OpenAI yang sama untuk menghasilkan storyboard dan kode animasi, pengaruh Harness dapat dipisahkan terlebih dahulu sehingga selisih kemampuan model itu sendiri terlihat lebih jelas.
5.2 Contoh Kode Perbandingan Tingkat Komponen dengan Antarmuka Terpadu
Contoh minimalis berikut memanggil dua model melalui base_url yang sama, lalu menghasilkan skrip storyboard untuk kebutuhan video yang sama. Untuk nama model, harap mengacu pada daftar model platform.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka terpadu APIYI, satu Key untuk memanggil GPT dan Claude
)

prompt = "为一款记账 App 设计 30 秒竖屏宣传片:给出 6 个镜头的分镜、旁白和每个镜头的时长。"
for model in ["gpt-6-astra", "claude-opus-5-5"]:
    r = client.chat.completions.create(model=model, messages=[{"role": "user", "content": prompt}])
    print(model, r.usage.total_tokens, "\n", r.choices[0].message.content[:300])
Lihat skrip pengujian perbandingan multi-putaran lengkap (mencatat durasi dan Token)
import time
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Pemanggilan terpadu melalui APIYI, memudahkan pergantian dan perbandingan
)

MODELS = ["gpt-6-astra", "claude-opus-5-5"]  # Mengacu pada daftar model platform; tambahkan langsung setelah model baru dirilis
RUNS = 3  # Jumlah pengulangan eksekusi untuk setiap tugas

TASKS = {
    "storyboard": "为一款记账 App 设计 30 秒竖屏宣传片,输出 6 个镜头的分镜、旁白和时长(JSON)。",
    "remotion": "用 Remotion 写一个 10 秒的柱状图增长动画组件,数据为 [12, 30, 45, 80],带标题与数值标签。",
    "data_story": "把“某城市 2020-2025 年新能源车渗透率从 5% 升至 48%”写成 45 秒数据故事视频的脚本和镜头说明。",
}

SYSTEM = "你是视频导演兼前端动画工程师,输出可直接用于代码驱动视频制作的内容。"


def run_once(model: str, prompt: str) -> dict:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": SYSTEM},
            {"role": "user", "content": prompt},
        ],
        max_tokens=4000,
    )
    return {
        "seconds": round(time.time() - start, 1),
        "prompt_tokens": resp.usage.prompt_tokens,
        "completion_tokens": resp.usage.completion_tokens,
        "output": resp.choices[0].message.content,
    }


results = []
for task_name, prompt in TASKS.items():
    for model in MODELS:
        for i in range(RUNS):
            try:
                rec = run_once(model, prompt)
            except Exception as e:
                rec = {"error": str(e)}
            rec.update({"task": task_name, "model": model, "run": i + 1})
            results.append(rec)
            print(task_name, model, i + 1, rec.get("seconds"), rec.get("completion_tokens"))

# Simpan hasil, sembunyikan nama model, lalu serahkan kepada reviewer untuk uji buta
with open("video_bench_results.json", "w", encoding="utf-8") as f:
    json.dump(results, f, ensure_ascii=False, indent=2)
🚀 Mulai cepat: perbandingan tingkat komponen menuntut pemanggilan GPT dan Claude sekaligus. Melalui APIYI apiyi.com, Anda bisa beralih antara kedua model tersebut hanya dengan satu kunci API dan antarmuka yang kompatibel dengan OpenAI. Pengguna baru mendapat kuota uji coba gratis; setelah GPT generasi berikutnya dirilis, cukup tambahkan nama modelnya ke daftar
MODELSdan rangkaian tugas yang sama bisa dijalankan ulang.
5.3 Hal yang perlu diperhatikan dalam pengujian seluruh alur
Setelah pengujian tiap komponen lolos, jalankan tugas video lengkap di Codex CLI dan Claude Code, lalu catat tingkat pengiriman dan hasil pemeriksaan ffprobe. Uji blind oleh manusia hanya menilai video yang sudah dikirim; tingkat pengiriman harus dihitung terpisah. Jika tidak, Anda akan mengulangi titik buta yang sama dengan pengujian manusia VibeVideoBench. Setiap tugas perlu diulang setidaknya 3 kali, lalu ambil rata-rata dan variansnya, agar hasil satu kali eksekusi tidak dianggap sebagai performa yang stabil.
6 Rekomendasi pengambilan keputusan: bagaimana memilih skenario video antara GPT dan Opus 5.5
6.1 Pilih GPT-6 Astra atau Opus 5.5 berdasarkan skenario
Berdasarkan skor per kategori dan data pengiriman VibeVideoBench, untuk saat ini pembagiannya bisa seperti ini:
- Utamakan GPT-6 Astra: video cerita berbasis data dan fakta, penjelasan konsep dan proses, serta video bertema cerita dan game; produksi massal dan skenario yang sensitif terhadap biaya per unit, dengan biaya tugas rata-rata 8.19 dolar AS dan biaya P90 yang lebih terkendali.
- Utamakan Claude Opus 5.5: demo produk dan fitur, video yang digerakkan musik, serta telaah paper; pengiriman komersial dengan persyaratan ketat pada spesifikasi dan pengiriman, seperti resolusi tetap, durasi, dan materi iklan yang wajib memiliki trek audio.
- Pemasaran merek: keduanya mendapat skor 4.18; putuskan berdasarkan biaya dan toolchain yang sudah dimiliki tim.
6.2 Menunggu GPT generasi berikutnya atau meluncurkan sekarang
Dua model yang tersedia saat ini sudah dapat menghasilkan video yang layak secara konsisten, jadi bisnis tidak perlu menunggu model generasi berikutnya. Cara yang lebih praktis adalah membangun kumpulan tugas dan skor baseline sendiri dengan metode di Bagian 5, lalu menjalankan ulang pada hari model baru dirilis, dan memakai data untuk memutuskan apakah akan beralih.
💡 Saran pemilihan: Perbedaan keduanya terutama terletak pada stabilitas pengiriman dan struktur biaya; pilihan akhir bergantung pada jenis video dan persyaratan pengiriman Anda. Sebaiknya uji keduanya melalui APIYI (apiyi.com) menggunakan kumpulan tugas nyata yang sama, karena antarmuka yang seragam memudahkan perbandingan berdampingan dan migrasi ke model baru nanti.
7 Kesimpulan Akhir: Target Persaingan GPT Generasi Berikutnya Bukan Lagi Sekadar Menyamai Opus 5.5
7.1 Poin-Poin Inti Kemampuan Video GPT dan Opus 5.5
- Kondisi saat ini: GPT-6 Astra dan Claude Opus 5.5 berada di tier pertama yang sama dalam tugas video berbasis kode VibeVideoBench, dengan kualitas keseluruhan 4,109 vs 4,074.
- Keunggulan Astra: estetika visual, skor di sebagian besar kategori konten, serta biaya tugas rata-rata sekitar 46,7% lebih rendah.
- Keunggulan Opus 5.5: 239/239 pengiriman penuh, tingkat kepatuhan spesifikasi 99,6%, dan pemeriksaan mandiri yang lebih sering.
- Preferensi manusia: 1242 vs 1203, interval kepercayaan tumpang tindih, secara statistik tidak dapat dibedakan.
- Sinyal generasi berikutnya: model internal mencapai 0,875 di BenchCAD 2.0 (Astra 0,594), dan menunjukkan kemampuan kolaborasi Agent skala puluhan ribu; nama, waktu rilis, dan skor video belum diumumkan.
- Hambatan sebenarnya: sekitar 75% kegagalan pengiriman berasal dari manajemen waktu, fokus persaingan bergeser dari kualitas generasi ke eksekusi dan pengiriman.
- Cara verifikasi: tugas tetap, lingkungan tetap, blind test multi-putaran, penghitungan biaya per unit video, dapat melakukan uji ulang tingkat komponen dengan antarmuka terpadu di APIYI apiyi.com.
7.2 Titik Akhir Persaingan adalah Produktivitas Penuh
Kembali ke judul: GPT sudah menyusul Opus 5.5, Astra versi sekarang sedikit unggul dalam kualitas dan biaya, sementara Opus 5.5 tetap memimpin dalam keandalan pengiriman. Model internal OpenAI menunjukkan kemampuan umum yang lebih kuat dan potensi eksekusi multi-Agent, sehingga GPT umum generasi berikutnya berpeluang lebih meningkatkan kemampuan produksi video; besaran spesifiknya perlu menunggu evaluasi independen setelah rilis dan pengujian bisnis Anda sendiri untuk menjawabnya.
Persaingan berikutnya akan berpusat pada produktivitas penuh: dari memahami ide hingga menghasilkan video yang andal, presisi, dan dapat dimodifikasi, siapa yang dapat menyelesaikan lebih banyak tugas dengan biaya lebih rendah. Disarankan untuk segera membangun baseline tugas video Anda sendiri dengan APIYI apiyi.com, sehingga begitu model baru diluncurkan Anda dapat langsung membandingkannya.
Referensi
- Situs evaluasi resmi VibeVideoBench: Peringkat Agent video dan skor kualitas
- Tautan:
vibevideobench.github.io -
Keterangan: Gambaran umum papan peringkat dan desain evaluasi
-
Paper VibeVideoBench: Metodologi, skor per kategori, biaya, preferensi manusia, dan alasan kegagalan
- Tautan:
arxiv.org/abs/2610.35864 -
Keterangan: Sumber utama data tabel dalam artikel ini; skor per kategori dapat dilihat di Appendix E.4
-
Pengumuman rilis Anthropic Claude Opus 5.5: Positioning model dan contoh resmi
- Tautan:
anthropic.com/claude-opus-5-5 -
Keterangan: Deskripsi resmi tentang perubahan kemampuan dan biaya Opus 5.5
-
OpenAI: On the Navier–Stokes Millennium Prize Problem: Model internal dan riset multi-Agent
- Tautan:
openai.com/index/navier-stokes-solution -
Keterangan: Data seperti 10.000 Agent konkuren dan riset 88 jam
-
OpenAI: Accelerating engineering for the physical world: Skor model internal BenchCAD 2.0
- Tautan:
openai.com/index/accelerating-engineering-for-the-physical-world -
Keterangan: Perbandingan antara model internal 0,875 dan GPT-6 Astra 0,594
-
OpenAI API Changelog dan Katalog Model: Verifikasi progres rilis
- Tautan:
developers.openai.com/api/docs/changelog,developers.openai.com/api/docs/models -
Keterangan: Catatan rilis GPT-6 Cyber dan model unggulan publik saat ini
-
OpenAI API Deprecations: Informasi penghentian Sora 2 dan Videos API
- Tautan:
developers.openai.com/api/docs/deprecations - Keterangan: Status terkini jalur pembuatan video native
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami melalui halaman utama APIYI apiyi.com untuk berbagi pengalaman pengujian Agent video. Materi integrasi lainnya dapat diakses di pusat dokumentasi docs.apiyi.com