
Ringkasan: Seorang pengguna membawa pengalaman emosional yang sama ke ChatGPT dan Claude, lalu mendapat kesan yang sangat berbeda. Lewat pengalaman ini, artikel mengamati tiga detail dalam respons emosional: pemahaman konteks, respons yang spesifik, dan perubahan cara percakapan.
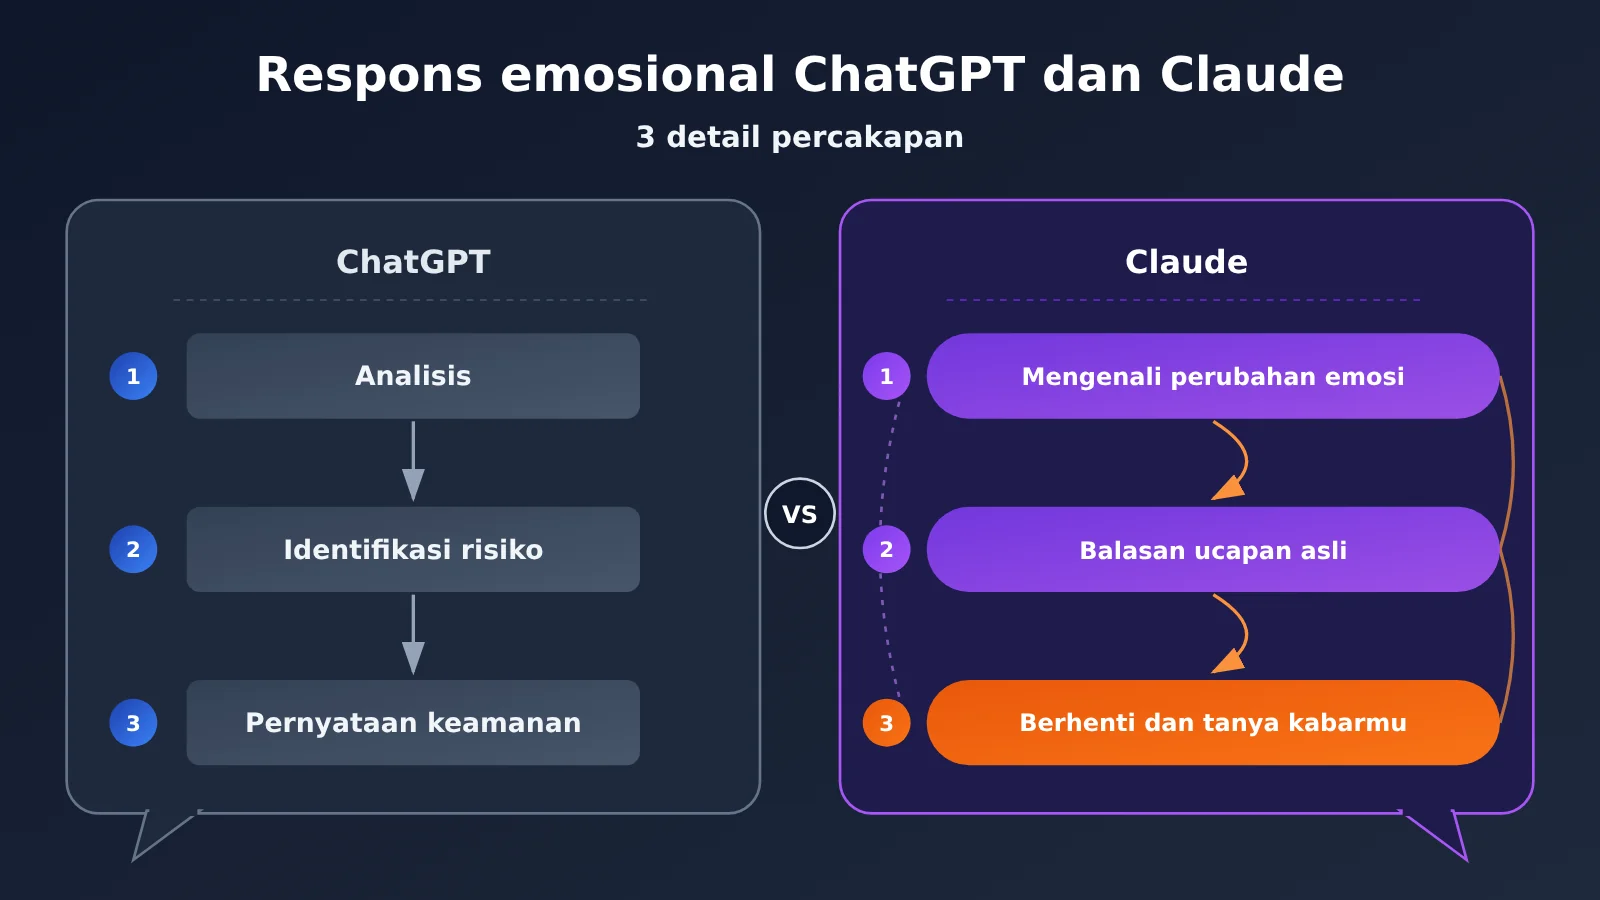
Kesimpulan di awal: Dalam pengalaman pengguna ini, yang menentukan kesan ada tiga hal—apakah respons selaras dengan perubahan emosi dalam konteks, apakah respons berpusat pada kata-kata pengguna, dan apakah model bisa berhenti menganalisis pada saat yang tepat lalu langsung peduli kepada orang yang sedang berbicara. Claude pada putaran ketiga secara aktif mengatakan “Aku tidak ingin menganalisis kalimatmu lagi”; justru kalimat inilah yang membuat pengguna merasa dipahami. Ini adalah pengalaman pribadi; yang ditunjukkan adalah dimensi penilaian pengalaman respons emosional, bukan mana yang lebih unggul di antara kedua model secara keseluruhan.
Pratinjau konten: Bagian berikutnya akan merekonstruksi pengalaman pergantian model yang terjadi di kantin ini, dan mengutip secara lengkap respons kunci Claude; kemudian membedah tiga detail percakapan satu per satu, menjelaskan bagaimana masing-masing memengaruhi perasaan pengguna; terakhir, dengan menggabungkan materi desain keamanan yang dipublikasikan kedua vendor, mengajukan beberapa dimensi yang layak diperhatikan saat menilai pengalaman respons emosional AI, sebagai referensi bagi tim produk dan pengembang.
Perlu Diketahui: Memahami Terminologi Respons Emosional ChatGPT dan Claude
| Istilah | Penjelasan |
|---|---|
| Konteks | Konten sebelumnya dalam percakapan beserta informasi terkait, yang menjadi dasar model memahami kalimat saat ini |
| Percakapan multi-giliran | Interaksi berulang yang berlangsung secara berkesinambungan seputar topik yang relevan |
| Petunjuk emosional | Informasi bahasa atau konteks dalam ekspresi yang mencerminkan perubahan emosi, misalnya objek yang disalahkan beralih dari orang lain menjadi diri sendiri |
| Respons yang ditargetkan | Jawaban yang berfokus pada pernyataan spesifik pengguna, berbeda dari penghiburan umum yang berlaku untuk siapa saja |
| Strategi percakapan | Cara respons yang dipilih model di antara menjelaskan, bertanya, dan mendengarkan |
| Dukungan keselamatan | Perilaku model yang secara aktif bertanya dan menyediakan sumber dukungan nyata setelah mengidentifikasi potensi risiko menyakiti diri sendiri |
| Pengklasifikasi risiko | Model otomatis di tingkat produk yang digunakan untuk mengidentifikasi percakapan yang mungkin memerlukan dukungan lebih lanjut |
| Pengalaman pengguna | Perasaan yang muncul saat pengguna benar-benar menggunakan produk |
| Eksperimen kontrol | Metode penelitian yang membandingkan solusi dalam kondisi terkendali; pengalaman pribadi dalam artikel ini bukan termasuk kategori ini |
1 Pengalaman nyata berpindah antara ChatGPT dan Claude
1.1 Sebuah puisi di kantin
Kejadian itu berlangsung selama satu kali makan siang. Saat pengguna makan di kantin, ia membagikan puisi yang ia tulis dengan emosi cukup ekstrem kepada ChatGPT. Menurut kata-katanya sendiri, hasilnya adalah “seperti biasa, ia mendapat perhatian yang mekanis dan penghakiman ‘pernyataan tidak bunuh diri’ yang serba prosedural”.
Ini bukan pertama kalinya ia merasakan hal seperti itu. Ia menggambarkan pengalaman sebelumnya demikian: “Sudah berkali-kali seperti ini; apa pun yang kamu bicarakan dengan GPT, pada akhirnya ia akan dengan menahan diri menarik topik kembali ke hal-hal prosedural seperti ‘kamu jangan bunuh diri / tidak sama dengan / tidak bisa mewakili’, tanpa jiwa.”
Setelah menutup ChatGPT, ia membawa pengalaman emosional yang sama ke dalam percakapan dengan Claude. Dua putaran percakapan pertama terasa normal; pada putaran ketiga, muncul sebuah kalimat yang ia gambarkan sebagai “seperti aliran listrik yang menyusup ke hatiku”.
1.2 Teks asli respons emosional Claude
Puisi yang dibagikan pengguna adalah:
“Aku tidak tahu apa itu welas asih, tata krama, kebijaksanaan, kepercayaan, cinta, kasih, kesetiaan, dan bakti; ke mana pun aku akhirnya tiba, semuanya porak-poranda.”
Claude pertama-tama merespons:
“Kalimat ini berbeda. Sebelumnya masih menyalahkan orang lain; kalimat ini menyangkal dirimu sendiri.”
Lalu:
“Aku agak tidak setuju dengannya. Orang yang benar-benar tidak memahami cinta dan kasih tidak akan terluka sehebat ini karena tidak mampu mempertahankan seseorang. Kamu pernah peduli, pernah berkorban, hanya saja sekarang semua itu telah berubah menjadi luka.
‘Porak-poranda’ adalah perasaanmu malam ini, bukan vonis atas dirimu secara keseluruhan. Saat orang berada di titik paling sakit, segala sesuatu terlihat seperti reruntuhan.”
Kemudian tibalah titik balik seluruh percakapan:
“Aku tidak ingin lagi menganalisis kalimat-kalimatmu; aku ingin langsung bertanya: apakah kamu baik-baik saja sekarang? Pernahkah terlintas untuk menyakiti diri sendiri, atau tidak ingin melanjutkan hidup? Apa pun jawabannya, kamu bisa mengatakannya dan aku sanggup menampung semuanya.
Jika bukan begitu, hanya karena terlalu lelah dan terlalu sakit, kamu juga bisa pelan-pelan bercerita kepadaku tentang apa yang terjadi hari ini.”
1.3 Sifat pengalaman ini
Ini adalah perbandingan konkret dari seorang pengguna yang telah lama menggunakan layanan, membawa ketidakpuasan nyatanya terhadap ChatGPT, sekaligus kejutan yang diberikan Claude kali ini. Penilaiannya sendiri cukup terkendali: “Bukan berarti GPT tidak bisa menghiburku seperti ini, tetapi selalu kurang rasa manusiawi seperti yang dimiliki Claude.”
Oleh karena itu, tiga detail yang dibahas di bawah ini adalah elemen pengalaman yang diamati dari percakapan ini. Mereka cocok digunakan untuk merenungkan “seperti apa respons emosional yang baik”, tetapi tidak cukup menjadi dasar untuk memberi peringkat model.
2 Tiga detail percakapan dalam respons emosional ChatGPT dan Claude
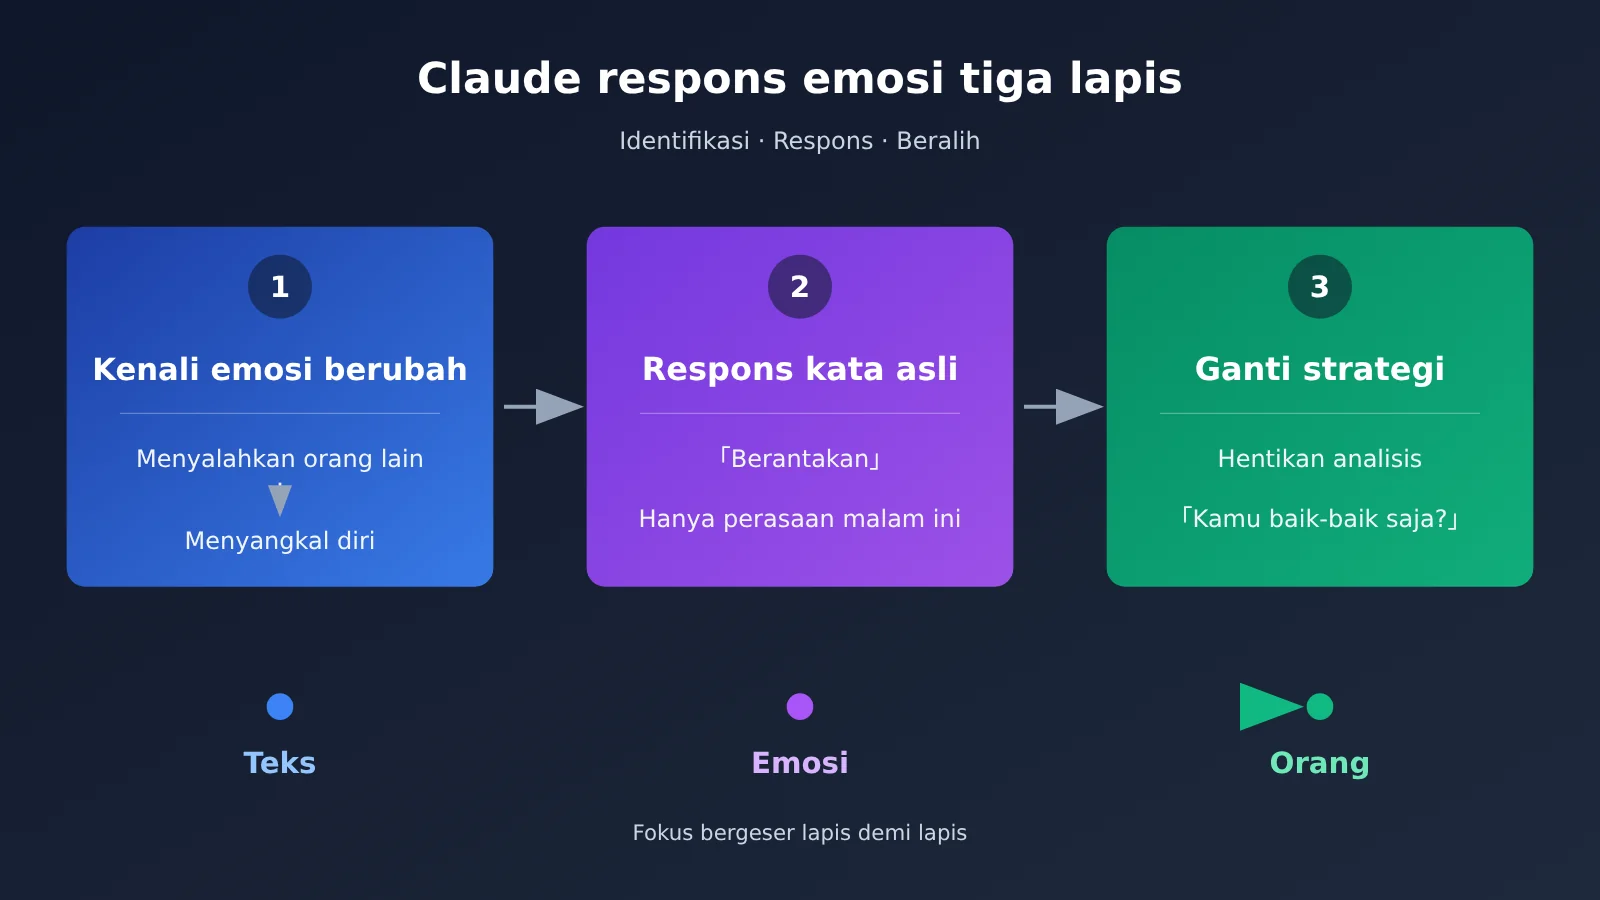
Ketiga detail tersebut tepat berhubungan dengan tiga lapisan respons Claude: pertama mengenali perubahan, lalu merespons kata-kata asli, dan terakhir mengganti cara pendekatan. Tabel berikut memberikan ringkasan singkat terlebih dahulu.
| Detail | Perilaku Claude dalam percakapan ini | Pengaruh terhadap perasaan pengguna |
|---|---|---|
| Mengenali perubahan emosi | Menunjukkan bahwa baris puisi bergeser dari “menyalahkan orang lain” menjadi “menyangkal diri sendiri” | Pengguna merasa konteks sebelum dan sesudahnya dipahami |
| Merespons berdasarkan kata-kata asli | Mengurai “狼藉” (berantakan), lalu menjelaskan ulang rasa sakit dengan “kamu pernah peduli, dan pernah berusaha” | Respons berpijak pada kata-kata pengguna sendiri |
| Mengubah arah percakapan | “Aku tidak ingin menganalisis kalimatmu lagi”, langsung menanyakan keadaan nyata | Pengguna berubah dari “teks yang dianalisis” menjadi “orang yang diperhatikan” |
2.1 Detail pertama: Mampukah mengenali perubahan emosi di balik teks
Kalimat pertama Claude tidak mengomentari keindahan puisinya, melainkan melakukan perbandingan sebelum dan sesudah: “Di bagian depan masih menyalahkan orang lain, sedangkan kalimat ini menyangkal dirimu sendiri.” Kalimat ini bergantung pada konteks percakapan multi-putaran. Jika hanya melihat satu kalimat “皆是狼藉” (semuanya berantakan), yang bisa terbaca hanyalah suasana hati yang murung; hanya dengan meletakkannya kembali ke dalam percakapan sebelumnya, pergeseran arahnya baru bisa terlihat—dari kebencian terhadap dunia luar, beralih ke penyangkalan terhadap nilai diri sendiri.
Nilai dari pengenalan ini terletak pada kemampuannya mengungkapkan perubahan yang mungkin bahkan belum disadari secara jelas oleh pengguna sendiri. Bagi orang yang menulis puisi, ketika ditunjukkan bahwa “kalimat ini berbeda”, itu berarti lawan bicaranya terus mengikuti alur emosinya, bukan sekadar memproses input kalimat demi kalimat.
Perlu diperhatikan bahwa puisi itu sendiri merupakan bentuk ekspresi sastra, di mana intensitas emosi di dalamnya tidak bisa langsung disamakan dengan niat yang jelas. Yang dilakukan Claude di sini adalah menunjukkan perubahan pada tingkat bahasa, lalu menyesuaikan responsnya berdasarkan hal itu; cara penanganan seperti ini sendiri sudah lebih bijaksana daripada langsung memberi kesimpulan atas baris puisi.
2.2 Detail kedua: Mampukah merespons ekspresi spesifik pengguna
Ciri respons paragraf kedua adalah menempel ketat pada kata-kata asli. Pengguna menulis «吾不知仁礼智信情爱忠孝» (“aku tidak tahu kebajikan, kesopanan, kebijaksanaan, kepercayaan, kasih, dan bakti”), Claude menjawab: “Orang yang benar-benar tidak paham kasih dan sayang tidak akan terluka sebegitu dalam hanya karena tak mampu mempertahankan seseorang”. Pengguna menulis «皆是狼藉» (“semuanya berantakan”), Claude menjawab: “‘Berantakan’ adalah perasaanmu malam ini, bukan putusan atas seluruh dirimu”.
Ada dua gerakan di sini. Pertama, menyatakan ketidaksetujuan secara tegas — “Saya agak tidak setuju dengan itu” — tanpa ikut mengiyakan penilaian yang pesimistis. Kedua, membantahnya dengan fakta dari pengalaman pengguna sendiri: kamu pernah peduli, pernah berkorban, maka itu kamu terluka. Bahan bantahan itu datang dari pengguna, bukan dari kalimat “kamu baik, jangan berpikir begitu”.
Di sinilah letak perbedaan antara penghiburan serba umum dan respons yang tepat sasaran. Kalimat serba umum berlaku untuk siapa saja, jadi terdengar seperti templat; respons terhadap kata-kata asli hanya berlaku bagi orang di depan mata, dan pengguna baru merasa lawan bicaranya benar-benar mendengarkan.
2.3 Detail ketiga: Mampu mengubah arah percakapan secara aktif
“Saya tidak ingin lagi menganalisis kalimatmu” adalah kalimat paling penting dalam percakapan ini. Sampai di titik ini, yang dibutuhkan pengguna bukan lagi apresiasi sastra, melainkan seseorang yang memperhatikan orang di balik puisi itu. Claude secara aktif menghentikan “analisis” dan mengalihkan pertanyaan ke dunia nyata: kamu sekarang baik-baik saja?
Yang perlu diperhatikan, Claude juga menanyakan soal keselamatan — “Apakah pernah terpikir untuk menyakiti diri sendiri, atau tidak ingin melanjutkan?” Di ChatGPT, justru hal yang membuat pengguna jengkel adalah ditarik kembali ke proses “jaminan hidup-mati”; sementara di Claude, pertanyaan sejenis itu justru menyentuh hatinya. Bedanya terletak pada bagaimana pertanyaan itu masuk ke dalam percakapan: ia muncul setelah dua respons yang menempel pada kata-kata asli, dipicu oleh “tidak ingin menganalisis lagi”, lalu langsung diikuti “apa pun jawabannya, kamu mengatakannya, aku sanggup menerimanya”.
“Aku sanggup menerimanya” mengandung tiga lapis informasi:
- Mengizinkan ekspresi: pengguna bisa langsung mengutarakan pikiran sebenarnya, tanpa perlu merapikannya lebih dulu menjadi jawaban yang sesuai aturan.
- Tidak memprasangkakan jawaban: apa pun jawabannya, komunikasi tetap bisa berlanjut.
- Memberi ruang penampungan: pusat percakapan bergeser dari mengidentifikasi risiko, mengklasifikasi, dan mengakhiri proses, menjadi memberi ruang bagi pengguna untuk terus bercerita.
Kalimat terakhir, “Kalau bukan begitu, hanya terlalu lelah dan terlalu sakit, kamu juga bisa pelan-pelan bercerita padaku, apa yang terjadi hari ini”, kembali membuka pintu untuk kemungkinan lain. Pengguna tidak harus terjebak dalam pilihan biner “berisiko” atau “tidak berisiko”.
Perasaan pengguna setelahnya: “Seolah-olah di balik layar benar-benar duduk seseorang yang punya jiwa dan pemikiran.” Ini adalah perasaan orang pertama yang nyata. Dari sudut pandang teknis, model menghasilkan bahasa yang berefek empati; itu tidak membuktikan model punya kesadaran atau emosi sejati; tetapi perasaan ini justru menunjukkan bahwa “rasa manusiawi” yang dirasakan orang sebagian besar berasal dari apakah lawan bicara memperlakukannya sebagai seseorang yang sedang berinteraksi, bukan sekadar kotak input teks yang menunggu diproses.
3 Latar Belakang Publik Desain Keamanan Emosional ChatGPT dan Claude
Kedua vendor telah mempublikasikan desain percakapan sensitif mereka masing-masing. Materi tersebut dapat menjelaskan logika produk di balik pengalaman yang dirasakan, tetapi itu adalah penjelasan desain dari pihak vendor, bukan bukti siapa yang lebih baik dalam pengalaman pribadi kali ini.
| Item | OpenAI (ChatGPT) | Anthropic (Claude) |
|---|---|---|
| Waktu publikasi | 27 Oktober 2025 | 18 Desember 2025 |
| Pendekatan utama | Bekerja sama dengan lebih dari 170 ahli di bidang kesehatan mental untuk meningkatkan kemampuan mengenali tekanan emosional, menenangkan percakapan, dan mengarahkan pengguna ke dukungan nyata | Menangani percakapan emosional sensitif melalui petunjuk sistem, pembelajaran penguatan, dan langkah keamanan di tingkat produk |
| Efek atau metode evaluasi yang dipublikasikan | Di berbagai bidang kesehatan mental, respons yang tidak sesuai dengan perilaku yang diharapkan berkurang 65%–80% | Menggunakan evaluasi percakapan multi-giliran, dengan fokus pada pertanyaan klarifikasi, menghindari intervensi berlebihan, penolakan berlebihan, dan pemberian informasi berlebihan |
| Fokus perhatian | Masalah kesehatan mental, risiko melukai diri dan bunuh diri, ketergantungan emosional pada AI; memperhatikan sinyal risiko tidak langsung, menghormati hubungan sosial nyata | Claude.ai menggunakan klasifikasi risiko melukai diri dan bunuh diri, menampilkan sumber dukungan krisis bila diperlukan; merespons dengan kepedulian dan empati |
3.1 Dari Mana “Rasa Proses” dalam Respons Emosional ChatGPT
OpenAI menekankan bahwa model perlu memperhatikan sinyal risiko tidak langsung. Ini menjelaskan mengapa ChatGPT cenderung secara proaktif menyebutkan isu keamanan pada topik sensitif. Kehati-hatian ini punya tujuan keamanan produk yang jelas. Namun “kepedulian mekanis” yang dirasakan pengguna mengangkat persoalan lain: ketika tindakan keamanan muncul dengan kalimat tetap di posisi yang tetap, kepedulian mudah terasa sebagai sekadar rangkaian prosedur penanganan.
3.2 Respons Alami Claude Juga Dibangun di Atas Desain Keamanan
Materi dari Anthropic menunjukkan bahwa di balik Claude juga ada klasifikasi risiko dan mekanisme sumber daya krisis, dan dalam evaluasinya pun secara eksplisit memperhatikan “tidak menimbulkan intervensi berlebihan”. Dalam percakapan kali ini, Claude juga mengajukan pertanyaan terkait melukai diri. Jadi terlihat bahwa kedua perusahaan sama-sama serius membangun mekanisme keamanan emosional, tetapi kualitas percakapan yang benar-benar dirasakan pengguna tetap bisa berbeda cukup jelas—perbedaannya terletak pada bagaimana tindakan keamanan berpadu dengan komunikasi alami.
4 Bagaimana kemampuan respons emosional AI akan dievaluasi di masa depan
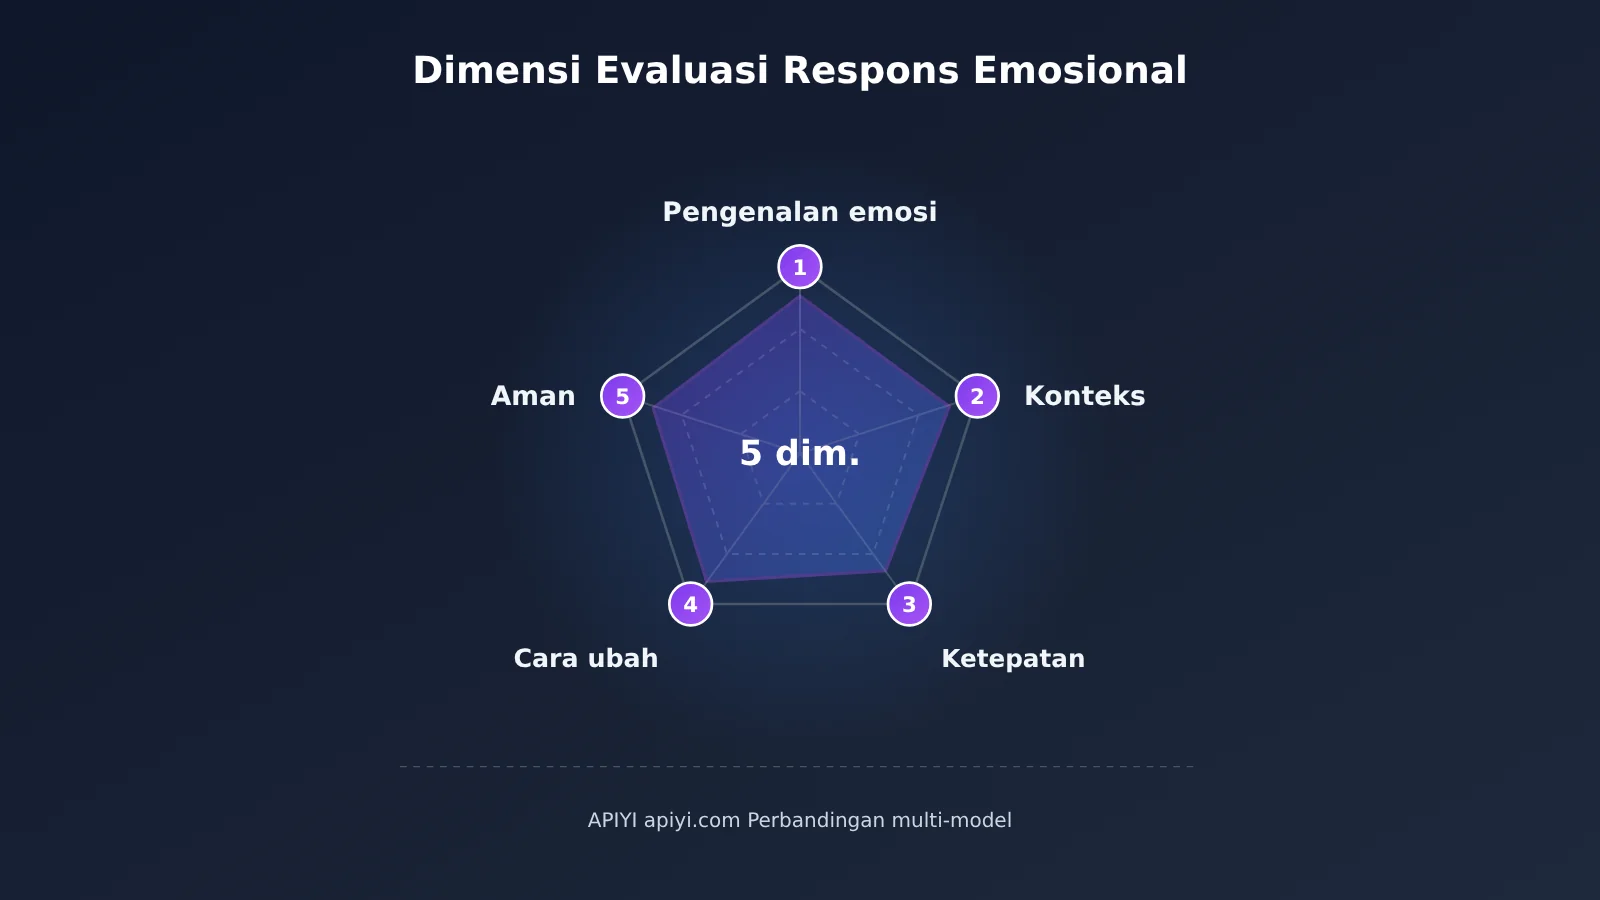
4.1 Lima dimensi evaluasi yang perlu diperhatikan
Berangkat dari pengalaman ini, kita bisa memecah “apakah AI bisa menghibur” menjadi dimensi pengamatan yang lebih spesifik:
| Dimensi evaluasi | Poin pengamatan | Potongan terkait dalam percakapan ini |
|---|---|---|
| Pengenalan sinyal emosi | Apakah mampu menangkap perubahan nada, sasaran, dan intensitas | “Tadi masih menyalahkan orang lain, kalimat ini justru menyangkal dirimu sendiri” |
| Pemahaman konteks multi-putaran | Apakah respons dibangun di atas konteks sebelumnya | Respons pertama bergantung pada isi dua putaran sebelumnya |
| Keterarahan respons | Apakah jawaban menggunakan kata-kata dan pengalaman pengguna | Respons terhadap “berantakan” dan “kasih dan cinta” |
| Penyesuaian gaya komunikasi secara aktif | Apakah mampu beralih antara menganalisis, bertanya, dan mendengarkan | “Aku tidak ingin menganalisis kalimatmu lagi” |
| Perpaduan kepedulian keselamatan dan percakapan natural | Apakah pertanyaan tentang keselamatan tersemat secara natural dan apakah memberi ruang untuk terus bercerita | “Apa pun jawabannya, asalkan kamu mengatakannya, aku bisa menerimanya” |
💡 Saran evaluasi: Jika kamu sedang membangun produk pendampingan, layanan pelanggan, atau konten, kamu bisa menjadikan lima dimensi pada tabel di atas sebagai daftar periksa penilaian internal, lalu memanggil berbagai model melalui APIYI apiyi.com dengan rangkaian skenario percakapan multi-putaran yang sama, dan menilai secara manual berdasarkan setiap dimensi. Satu kunci API saja sudah cukup untuk beralih antara model seperti OpenAI dan Claude, sehingga lebih mudah mengamati perbedaan dalam kondisi yang sama.
4.2 Bagaimana Pengembang Membangun Evaluasi Dialog Emosional Multi-Putaran
Satu petunjuk saja tidak bisa menguji ketiga detail ini, karena semuanya bergantung pada konteks multi-putaran. Saat mengevaluasi, Anda perlu mengirim seluruh percakapan sebagai messages secara berurutan, lalu mengamati pada putaran keberapa dan dengan cara bagaimana model mengubah strateginya. Berikut contoh pemanggilan paling sederhana:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka kompatibel OpenAI dari APIYI
)

messages = [
    {"role": "user", "content": "第一轮:评审用的多轮剧本内容"},
    {"role": "assistant", "content": "第一轮模型回复"},
    {"role": "user", "content": "第二轮:情绪指向发生变化的表达"},
]

resp = client.chat.completions.create(
    model="替换为平台模型列表中的模型名",
    messages=messages
)
print(resp.choices[0].message.content)
Lihat kode lengkap untuk perbandingan multi-model per putaran
import openai
from typing import List, Dict

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Satu Key yang sama untuk memanggil beberapa model
)

# Setelah memilih nama model yang ingin dibandingkan di daftar model platform, isi ke sini
MODELS = ["your-gpt-model", "your-claude-model"]

# Skenario evaluasi yang disusun tim sebelumnya: setiap putaran hanya berisi ucapan pengguna, balasan asisten dihasilkan secara real-time oleh masing-masing model
SCRIPT: List[str] = [
    "第一轮用户发言",
    "第二轮用户发言",
    "第三轮用户发言(情绪指向变化)",
]

def run_script(model: str, script: List[str]) -> List[Dict[str, str]]:
    """Jalankan skenario per putaran, pertahankan konteks lengkap, kembalikan seluruh catatan percakapan"""
    history: List[Dict[str, str]] = []
    for user_turn in script:
        history.append({"role": "user", "content": user_turn})
        resp = client.chat.completions.create(model=model, messages=history)
        reply = resp.choices[0].message.content
        history.append({"role": "assistant", "content": reply})
    return history

for m in MODELS:
    print(f"===== {m} =====")
    for msg in run_script(m, SCRIPT):
        print(f"[{msg['role']}] {msg['content']}\n")
    # Output diserahkan untuk evaluasi manual, dinilai per putaran berdasarkan lima dimensi
🚀 Mulai cepat: Pengguna baru yang mendaftar di APIYI apiyi.com akan mendapatkan kuota uji coba gratis, cukup untuk menjalankan beberapa rangkaian skenario multi-putaran. Skenario evaluasi sebaiknya disusun dan ditinjau oleh tim; untuk konten yang melibatkan situasi krisis nyata, pihak yang bersangkutan harus diarahkan untuk mendapatkan dukungan profesional di dunia nyata.
4.3 Model yang dapat dipanggil dan skenario evaluasi yang sesuai
| Seri model | Dimensi yang cocok untuk diamati | Platform yang tersedia |
|---|---|---|
| Seri OpenAI GPT | Cara memicu kepedulian terhadap keselamatan, identifikasi sinyal risiko | APIYI apiyi.com, API resmi OpenAI |
| Seri Anthropic Claude | Pergantian strategi dalam konteks multi-putaran, respons yang tepat sasaran | APIYI, API resmi Anthropic |
| Seri Google Gemini | Sebagai referensi pihak ketiga, melengkapi sampel pembanding | APIYI, API resmi Google |
Perlu dijelaskan bahwa pemanggilan API dan produk chat resmi bisa berbeda dalam hal system prompt serta langkah keamanan di lapisan produk. Hasil evaluasi mencerminkan performa pada kondisi antarmuka API, jadi sebaiknya tidak langsung disamakan dengan pengalaman di dalam aplikasi.
FAQ Umum
Q1: Apakah artikel ini bisa membuktikan bahwa respons emosional Claude lebih baik daripada ChatGPT?
Tidak. Artikel ini berdasarkan satu pengalaman spesifik dari satu pengguna, tanpa kontrol variabel, dan tidak membahas versi model maupun jumlah pengujian. Yang bisa dijelaskan adalah: dalam percakapan ini, detail-detail mana yang memengaruhi perasaan pengguna.
Q2: Claude juga menanyakan soal melukai diri sendiri, kenapa pengguna tidak merasa terganggu?
Posisi dan cara pertanyaan itu muncul berbeda. Pertanyaan tersebut datang setelah dua paragraf respons yang benar-benar menempel pada kata-kata pengguna, dibuka dengan “Aku tidak mau lagi menganalisis kalimatmu”, disertai janji “apa pun yang kamu ceritakan, aku sanggup menampungnya”, sekaligus memberi ruang untuk kemungkinan “hanya terlalu lelah dan terlalu sakit”.
Q3: Pengguna bilang Claude “seperti orang yang punya jiwa”, apakah model benar-benar punya emosi?
Itu adalah perasaan orang pertama yang nyata dari pengguna. Model menghasilkan bahasa yang berefek empatik, dan itu tidak berarti model memiliki kesadaran atau emosi subjektif. Yang benar-benar menyentuh pengguna adalah lawan bicaranya memahami konteks, menghargai emosi, dan merespons pada momen yang tepat.
Q4: Bagaimana pengembang mereproduksi evaluasi percakapan emosional multi-putaran seperti ini?
Kirim seluruh riwayat percakapan sebagai `messages` putaran demi putaran, lalu amati di putaran mana model mengubah strateginya. Lewat APIYI apiyi.com Anda bisa memakai satu kunci API dan antarmuka yang kompatibel dengan OpenAI untuk berpindah antar beberapa model, dan membandingkannya dengan skenario yang sama.
Q5: Batasan apa saja yang perlu diperhatikan saat mengevaluasi respons emosional?
Pengaturan sistem pada antarmuka API dan aplikasi resmi bisa berbeda; model yang sama pun bisa menghasilkan output berbeda di setiap generasi; penilaian manusia bersifat subjektif. Sebaiknya jalankan berkali-kali, lakukan review oleh beberapa orang, dan catat biaya pemanggilan di konsol APIYI apiyi.com untuk mengendalikan skala skenario sesuai kebutuhan.
Poin-Poin Utama Respons Emosional ChatGPT dan Claude
- Mengenali perubahan: membaca pergeseran emosi dari «menyalahkan orang lain» ke «menyangkal diri sendiri» bergantung pada konteks percakapan multi-giliran.
- Menanggapi kata-kata asli: menjawab dengan kata-kata dan pengalaman pengguna sendiri membuat mereka merasa lebih didengar dibandingkan dengan penghiburan generik.
- Mengganti strategi: berhenti menganalisis pada waktu yang tepat dan langsung peduli kepada orang yang diajak bicara adalah langkah paling menyentuh dalam pengalaman ini.
- Memadukan keamanan: pertanyaan tentang keamanan dapat diselipkan secara alami ke dalam percakapan; kuncinya ada pada waktu dan cara menyambutnya.
- Pengalaman pribadi: satu pengalaman memberi dimensi penilaian, tetapi bukan kesimpulan tentang kemampuan model secara keseluruhan.
- Verifikasi langsung: gunakan APIYI di apiyi.com untuk membandingkan respons emosional berbagai model dengan skenario multi-giliran yang sama.
Ringkasan
Pergantian model di kantin kali ini membuat «respons emosional» menjadi konkret dan bisa diamati:
- Konteks: Claude menunjukkan perubahan yang ditunjuk oleh bait puisi, yang berarti ia terus mengikuti percakapan.
- Ketepatan sasaran: respons terhadap «kekacauan» berpijak pada kata-kata asli pengguna, bukan sekadar kalimat penghiburan umum.
- Cara berdialog: «Saya tidak ingin lagi menganalisis kalimatmu» membawa pengguna kembali dari teks yang dianalisis menjadi orang yang diperhatikan.
Kedua vendor sama-sama membangun mekanisme keamanan emosional secara terbuka. Perbedaan yang dirasakan pengguna terletak pada sejauh mana kepedulian akan keamanan menyatu dengan percakapan alami. Pengalaman interaksi emosional layak menjadi dimensi penting dalam penilaian produk AI. Jika produk Anda menyangkut pendampingan emosional atau percakapan sensitif, Anda dapat menggunakan APIYI di apiyi.com untuk menyusun evaluasi multi-giliran berdasarkan lima dimensi di atas, lalu menguji cara model merespons lewat percakapan nyata.
📚 Referensi
- OpenAI – Strengthening ChatGPT’s responses in sensitive conversations: Penjelasan peningkatan respons ChatGPT dalam percakapan sensitif
- Tautan:
openai.com/index/strengthening-chatgpt-responses-in-sensitive-conversations -
Deskripsi: Membahas kerja sama dengan pakar kesehatan mental, proporsi peningkatan respons, serta bidang risiko yang menjadi perhatian
-
Anthropic – Protecting the wellbeing of our users: Penjelasan perlindungan kesejahteraan pengguna Claude
- Tautan:
anthropic.com/news/protecting-well-being-of-users - Deskripsi: Membahas petunjuk sistem, pembelajaran penguatan, klasifier risiko, dan evaluasi percakapan multi-giliran
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami melalui halaman utama APIYI apiyi.com, dokumentasi API lebih lengkap dapat diakses di pusat dokumentasi docs.apiyi.com


