Récemment, un client a posé une question très typique dans le groupe : « Avec notre images2, on peut générer un ensemble d’images e-commerce, non ? » La réponse est oui, mais pas en un seul appel qui recracherait toute une série d’images. L’API de gpt-image-2 fonctionne selon le principe « une invite correspond à une génération ». Pour obtenir un ensemble d’images aux contenus tous différents — image principale, image d’arguments de vente, image de contexte, page de détails — il faut un peu réfléchir à la façon d’appeler l’API.
Cet article décompose l’ensemble e-commerce avec gpt-image-2 en deux approches : la première consiste à faire porter plusieurs dimensions d’information par une seule image, adaptée aux longues pages de détails ; la seconde consiste à d’abord décomposer le besoin avec un modèle de texte, générer l’invite de chaque image, puis appeler gpt-image-2 en parallèle, adaptée au vrai ensemble multi-images. À la fin de votre lecture, vous aurez un design de flux complet, du code exécutable, et quelques astuces clés pour garder la cohérence de style sur toute la série.
La limite fondamentale de l’ensemble e-commerce gpt-image-2 : un appel, une invite
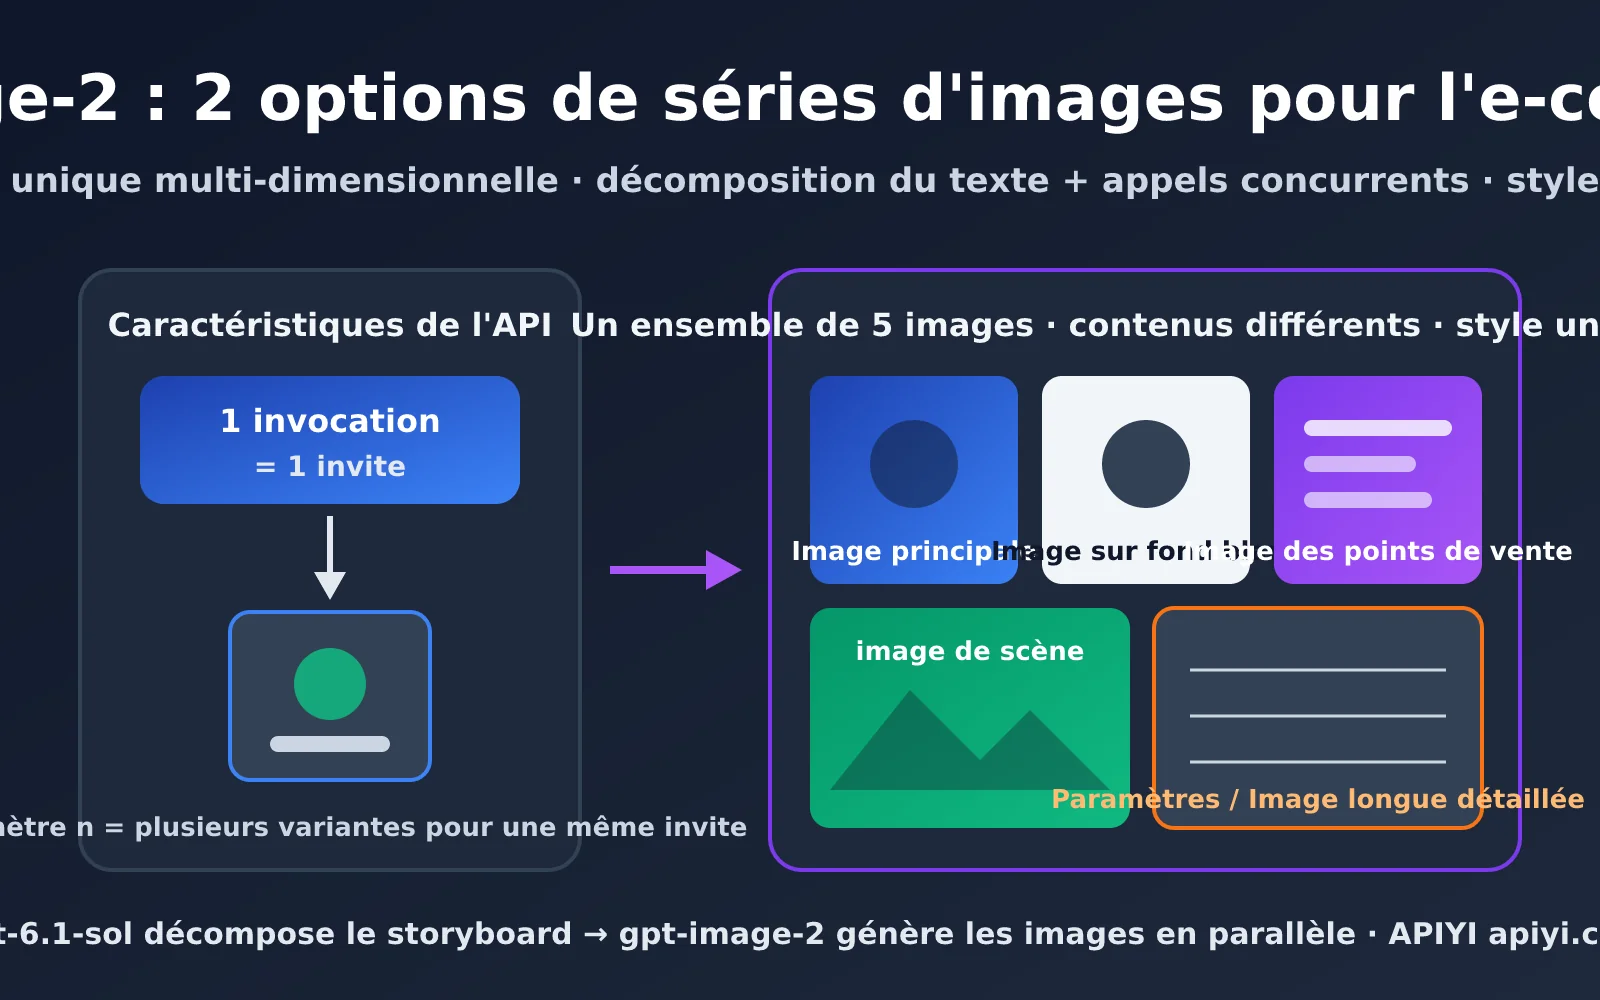
Commençons par clarifier le comportement de l’API, car toute la conception qui suit repose sur ce principe. Les endpoints /v1/images/generations et /v1/images/edits de gpt-image-2 n’acceptent qu’une seule invite par requête. Les séries officielles gpt-image-2 et 2.5 prennent en charge le paramètre n, et APIYI aussi, mais n signifie « générer n variantes à partir de la même invite », et non « n invites produisant chacune une image ».
Avec n=5, vous obtenez donc 5 versions de la même scène, ce qui convient pour « en générer plusieurs et choisir la meilleure », mais pas pour un ensemble d’images. L’essence d’un ensemble e-commerce, c’est plusieurs images au contenu différent mais au style unifié : l’image principale doit mettre le produit en avant, l’image d’arguments doit inclure du texte, l’image de contexte doit montrer l’environnement d’utilisation, et l’image de paramètres doit comporter des annotations de dimensions. Chaque image a sa propre invite, il faut donc naturellement plusieurs appels.
Les 3 vraies difficultés d’un ensemble e-commerce avec gpt-image-2
Une fois la limite comprise, on réalise que la difficulté ne réside pas dans « produire plusieurs images », mais dans les trois points suivants :
- Cohérence du sujet : le produit doit être le même sur les 5 images, la couleur, le logo et la structure ne peuvent pas changer d’une image à l’autre.
- Cohérence du style : la teinte, la lumière, la texture du fond et le style typographique doivent sembler sortir de la main d’un même designer.
- Répartition de l’information : chaque image assume une tâche marketing différente, on ne peut pas répéter le même argument sur les 5.
Ces trois points impliquent qu’on ne peut pas résoudre la question en « jetant une phrase au modèle » : il faut planifier avant d’appeler. Le tableau ci-dessous présente la composition standard d’un ensemble sur les plateformes e-commerce courantes ; il peut servir de point de départ à la planification.
| Position dans l’ensemble | Usage principal | Ratio recommandé | Densité d’information | Texte nécessaire ? |
|---|---|---|---|---|
| Image principale (première) | Taux de clic dans les résultats | 1:1 | Faible, produit mis en avant | Optionnel, peu |
| Image sur fond blanc | Conformité plateforme, publicité | 1:1 | Très faible | Non |
| Image d’arguments de vente | Communiquer 2-3 arguments clés | 1:1 ou 3:4 | Moyenne | Oui |
| Image de contexte | Créer une ambiance d’utilisation | 1:1 ou 4:5 | Moyenne | Optionnel |
| Image de dimensions/paramètres | Réduire les questions et les retours | 1:1 | Élevée | Oui |
| Longue image de page de détails | Présenter le produit en détail | 9:16 ou plus | Très élevée | Oui |
🎯 Conseil de planification : avant d’écrire du code, déterminez à partir du tableau combien d’images votre plateforme nécessite et quelle tâche chacune doit remplir. Nous recommandons de lancer d’abord manuellement 2-3 images individuelles avec gpt-image-2 sur APIYI apiyi.com, pour vérifier que la fidélité du produit et le rendu du texte correspondent à vos attentes, avant de passer au flux d’ensemble par lots.
Option 1 : gpt-image-2 — une seule image pour porter plusieurs dimensions d’information (image longue de fiche produit)
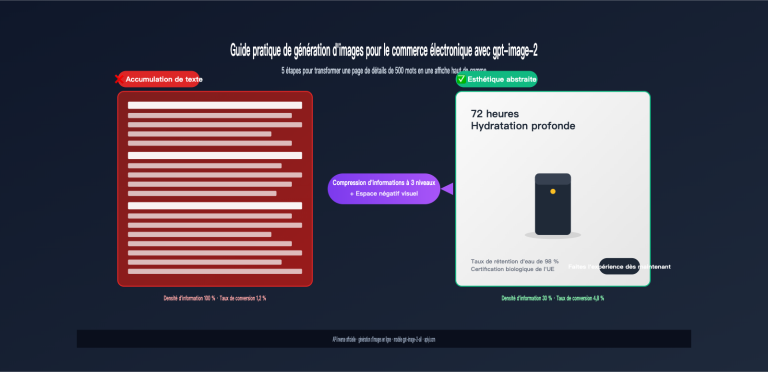
La première approche, c’est « tout dire en une seule image ». gpt-image-2 est très fort pour le rendu du texte chinois et la compréhension de la mise en page : répartir par zones, dans une grande image au format portrait, le visuel principal, les arguments de vente et le tableau des caractéristiques est parfaitement faisable. Pour une image longue de fiche produit, une image récapitulative des arguments de vente ou une infographie, un seul appel suffit à produire un livrable très dense en information.
Le grand avantage de cette approche, c’est qu’elle n’a aucun problème de cohérence par nature. Tout le contenu est généré d’un coup par le modèle dans une même image : les tons et le style sont naturellement homogènes, et aucun code d’orchestration supplémentaire n’est nécessaire. Le revers de la médaille, c’est que la surface d’une seule image reste limitée : quand il y a trop de contenu, le texte rétrécit et s’entasse, et on ne peut pas découper le résultat en images principales indépendantes à utiliser séparément.
Comment rédiger un prompt par zones pour une image longue de fiche produit avec gpt-image-2
La clé d’une image unique à plusieurs dimensions, c’est la description par zones. N’écrivez pas un gros paragraphe fourre-tout : suivez l’ordre de la mise en page, de haut en bas, et indiquez au modèle ce qu’il faut mettre dans chaque zone. Voici un exemple de structure de prompt pour l’image longue de la fiche produit d’une gourde isotherme :
竖版 9:16 电商详情页长图,整体风格:简约北欧风,米白色背景,柔和自然光。
【顶部区域】产品主视觉:一只哑光墨绿色保温杯斜 45 度放置,标题文字“24 小时长效保温”。
【中部区域】三栏卖点,每栏一个线性图标加短文案:“316 不锈钢内胆”“一键弹盖单手开”“500ml 大容量”。
【底部区域】参数表格:容量 500ml、重量 320g、高度 22cm、材质 316 不锈钢。
所有文字使用清晰的无衬线中文字体,不要出现多余文字。
Côté dimensions, on recommande le format portrait 9:16 pour l’image longue, par exemple 1152x2048 en 2K. Si vous avez besoin d’un asset final en plus haute définition, vous pouvez passer à 2160x3840 en 4K.
L’approche mono-image ne nécessite qu’un seul appel : c’est le coût le plus bas, et le style est naturellement homogène. En contrepartie, la capacité d’information est limitée : au-delà de 5 blocs, le texte devient vite serré, et on ne peut pas l’extraire pour l’utiliser seul comme visuel principal de recherche. Elle convient surtout aux fiches produit et aux récapitulatifs d’arguments de vente de produits standard axés sur les caractéristiques, comme l’électroménager, les accessoires numériques ou les articles du quotidien.
💡 Astuce pratique : au-delà de 5 zones, le taux d’erreur sur le rendu du texte monte nettement. Mieux vaut découper l’image longue en 2 à 3 « demi-écrans » générés séparément, puis les assembler verticalement dans la fiche produit. Ces demi-écrans forment déjà une petite série d’images, ce qui nous amène tout naturellement à l’option 2.
Option 2 : un modèle textuel pour décomposer + des appels multiples à gpt-image-2 pour générer une série d’images e-commerce
Si vous voulez une vraie série d’images multiples (image principale, image d’arguments de vente, image d’ambiance, chacune indépendante), il vous faut un petit pipeline. L’idée : confier « la compréhension du besoin et la planification des plans » au modèle textuel, et « la génération d’images » à gpt-image-2, les deux étant reliés par du JSON structuré.
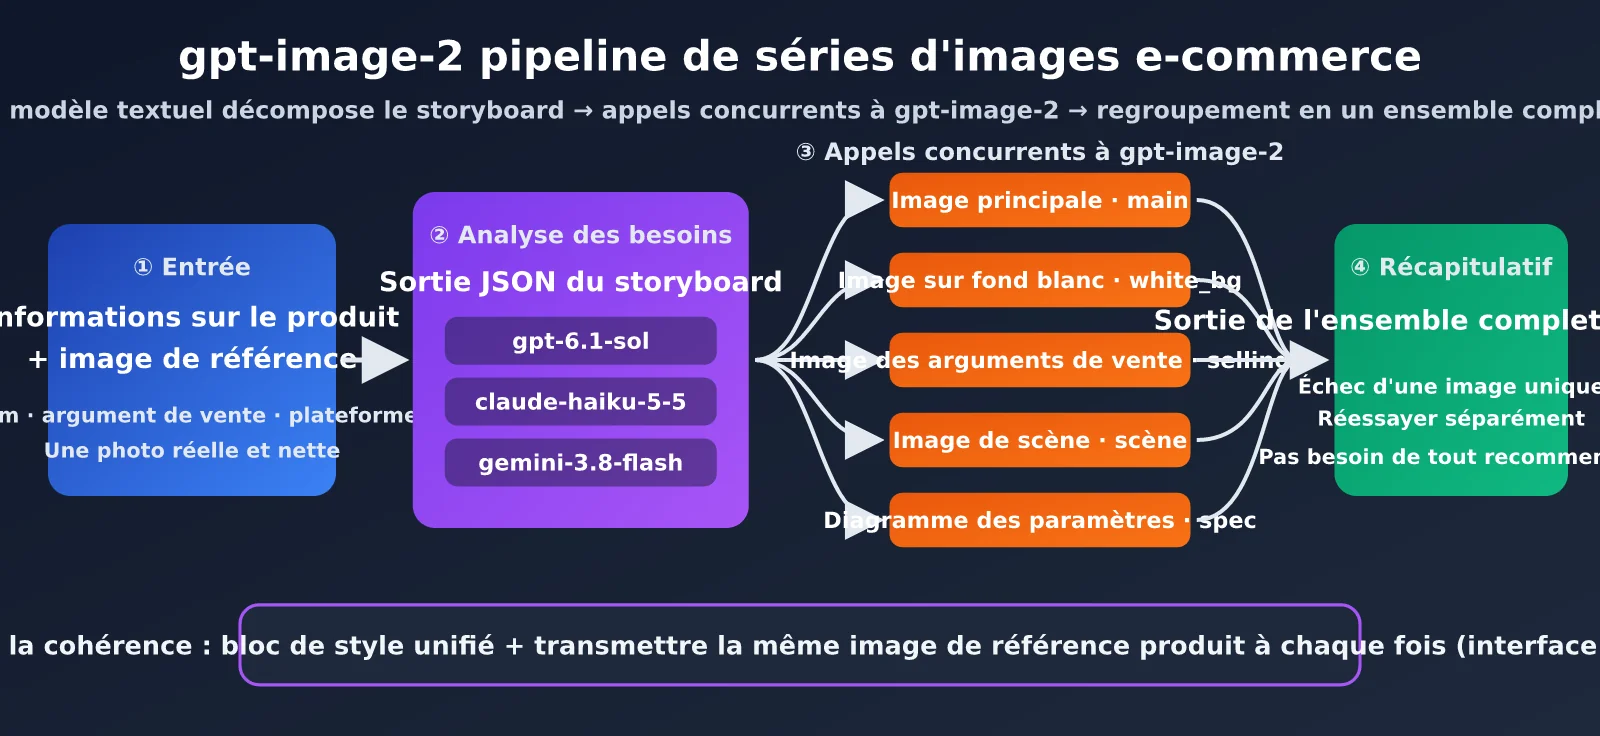
Le processus complet se déroule en 4 étapes :
- Entrée : le marchand fournit le nom du produit, les arguments de vente, la plateforme cible, ainsi qu’au moins une photo nette du produit réel.
- Analyse du besoin : à partir de ces entrées, le modèle textuel produit un tableau JSON dont chaque élément correspond au plan d’une image, avec l’usage, le prompt, la taille et le texte.
- Génération en parallèle : le programme parcourt le tableau de plans et appelle gpt-image-2 une fois par plan, en passant toujours la même image de référence du produit.
- Consolidation et vérification : on rassemble tous les résultats, on relance individuellement les images en échec, puis on sort la série complète dans l’ordre.
Comment choisir le modèle textuel : le « cerveau » de la série gpt-image-2
Pour l’étape d’analyse du besoin, ce qu’on attend du modèle textuel : comprendre la logique marketing e-commerce, produire du JSON de façon fiable, et écrire des prompts à forte imagerie. Les quelques modèles les plus récents disponibles sur APIYI font tous l’affaire :
| Modèle | Positionnement | Cas d’usage | Pourquoi le choisir |
|---|---|---|---|
| gpt-6.1-sol | Recommandé, haut de gamme | Produits à prix élevé, extraction d’arguments complexes | Meilleure qualité de copywriting et de planification des plans |
| claude-haiku-5-5 | Bon marché et rapide | Lots de SKU, catégories standardisées | Suivi d’instructions stable, sortie JSON propre |
| gemini-3.8-flash | Bon marché et rapide | Gros volumes, produits transfrontaliers multilingues | Rapide, peu coûteux, copy multilingue naturel |
L’analyse du besoin n’est appelée qu’une fois par série, la consommation de tokens est faible : l’essentiel du coût vient de la génération d’images. On conseille de commencer par peaufiner le template de prompt avec gpt-6.1-sol, puis de passer à claude-haiku-5-5 ou gemini-3.8-flash pour réduire les coûts quand vous traitez du volume. Les trois modèles passent par l’interface compatible OpenAI sur APIYI apiyi.com : il suffit de changer le paramètre model pour basculer.
Concevoir le JSON des plans pour une série e-commerce gpt-image-2
Faire produire au modèle textuel un JSON à structure fixe est la clé d’un pipeline qui tourne de façon stable. Voici la conception de champs recommandée :
| Champ | Type | Description | Exemple |
|---|---|---|---|
scene |
string | Identifiant de l’emplacement dans la série | main / white_bg / selling |
purpose |
string | La mission marketing de cette image | Mettre en avant l’apparence du produit et améliorer le taux de clic |
prompt |
string | Le prompt complet pour gpt-image-2 | Gourde vert forêt mat posée sur un bureau en bois… |
size |
string | Taille de sortie | 2048x2048 |
text_overlay |
string | Le texte à rendre dans l’image | Isolation longue durée 24 heures |
Le code minimal pour une série gpt-image-2
Voici la version minimale qui fonctionne : on fait d’abord générer les plans par le modèle textuel, puis on appelle l’API edits de gpt-image-2 plan par plan (avec l’image de référence du produit).
import json, base64
from openai import OpenAI

client = OpenAI(api_key="YOUR_APIYI_KEY", base_url="https://api.apiyi.com/v1")

plan = client.chat.completions.create(
    model="gpt-6.1-sol",
    response_format={"type": "json_object"},
    messages=[{"role": "user", "content": "为墨绿色 316 保温杯规划 5 张淘宝套图,输出 {\"shots\": [...]},"
               "每项含 scene/purpose/prompt/size/text_overlay,统一风格:北欧简约、米白背景、柔和自然光"}],
)
shots = json.loads(plan.choices[0].message.content)["shots"]

for s in shots:
    img = client.images.edit(model="gpt-image-2", image=open("cup.png", "rb"),
                             prompt=s["prompt"], size=s["size"])
    open(f"{s['scene']}.png", "wb").write(base64.b64decode(img.data[0].b64_json))
Ce code s’exécute en série : les 5 images s’attendent l’une après l’autre. La section suivante le transforme en version parallèle.
Comment garder un style cohérent sur une série e-commerce gpt-image-2
Le problème le plus courant quand on multiplie les appels, c’est que les 5 images finissent par ressembler à celles de 5 boutiques différentes. En combinant les astuces suivantes, vous pouvez amener la cohérence à un niveau exploitable en production :
- Un style block figé : écrivez les tons, la lumière, le fond et le langage de prise de vue dans un texte fixe, que vous collez à la fin de chaque prompt de plan. Ne laissez pas le modèle textuel improviser la description du style à chaque fois.
- Une image de référence produit fixe : à chaque appel, passez la même photo du produit réel via l’API edits, et précisez dans le prompt « conservez à l’identique la couleur, le logo et la structure du produit de l’image de référence ». C’est le moyen le plus efficace de garantir la cohérence du sujet.
- Des paramètres fixes : utilisez le même niveau
qualitypour toute la série, et ne changez la taille que si nécessaire (par exemple, format portrait pour une image longue). - Utiliser le paramètre
npour choisir : pour les emplacements les plus critiques, comme l’image principale, réglezn=2oun=3pour générer plusieurs variantes et sélectionnez la meilleure à la main. C’est exactement le bon usage du paramètren.
🎯 Conseil cohérence : le style block est la « charte de marque » de toute la série ; on conseille d’en figer un template pour chaque boutique. Quand vous appelez gpt-image-2 via APIYI apiyi.com, vous pouvez stocker le style block dans un fichier de configuration partagé par tous les SKU, et le mettre à jour d’un coup à chaque changement de saison.
Appels concurrents de gpt-image-2 pour les séries e-commerce : gagner en vitesse et monter en charge
Générer une série de 5 images en séquentiel revient à additionner le temps de chaque image : plus il y a d’images, plus c’est lent. Or les différents plans d’une série ne dépendent pas les uns des autres, donc rien n’empêche de les appeler en parallèle : la durée totale se rapproche alors de celle de « l’image la plus lente ».
APIYI n’impose aucune limite de concurrence sur les appels à gpt-image-2 : en dessous de 500 RPM, vous pouvez l’utiliser directement, sans demande particulière. Pour la grande majorité des marchands, même en lançant les séries de plusieurs dizaines de SKU en parallèle, on reste très loin de ce plafond.
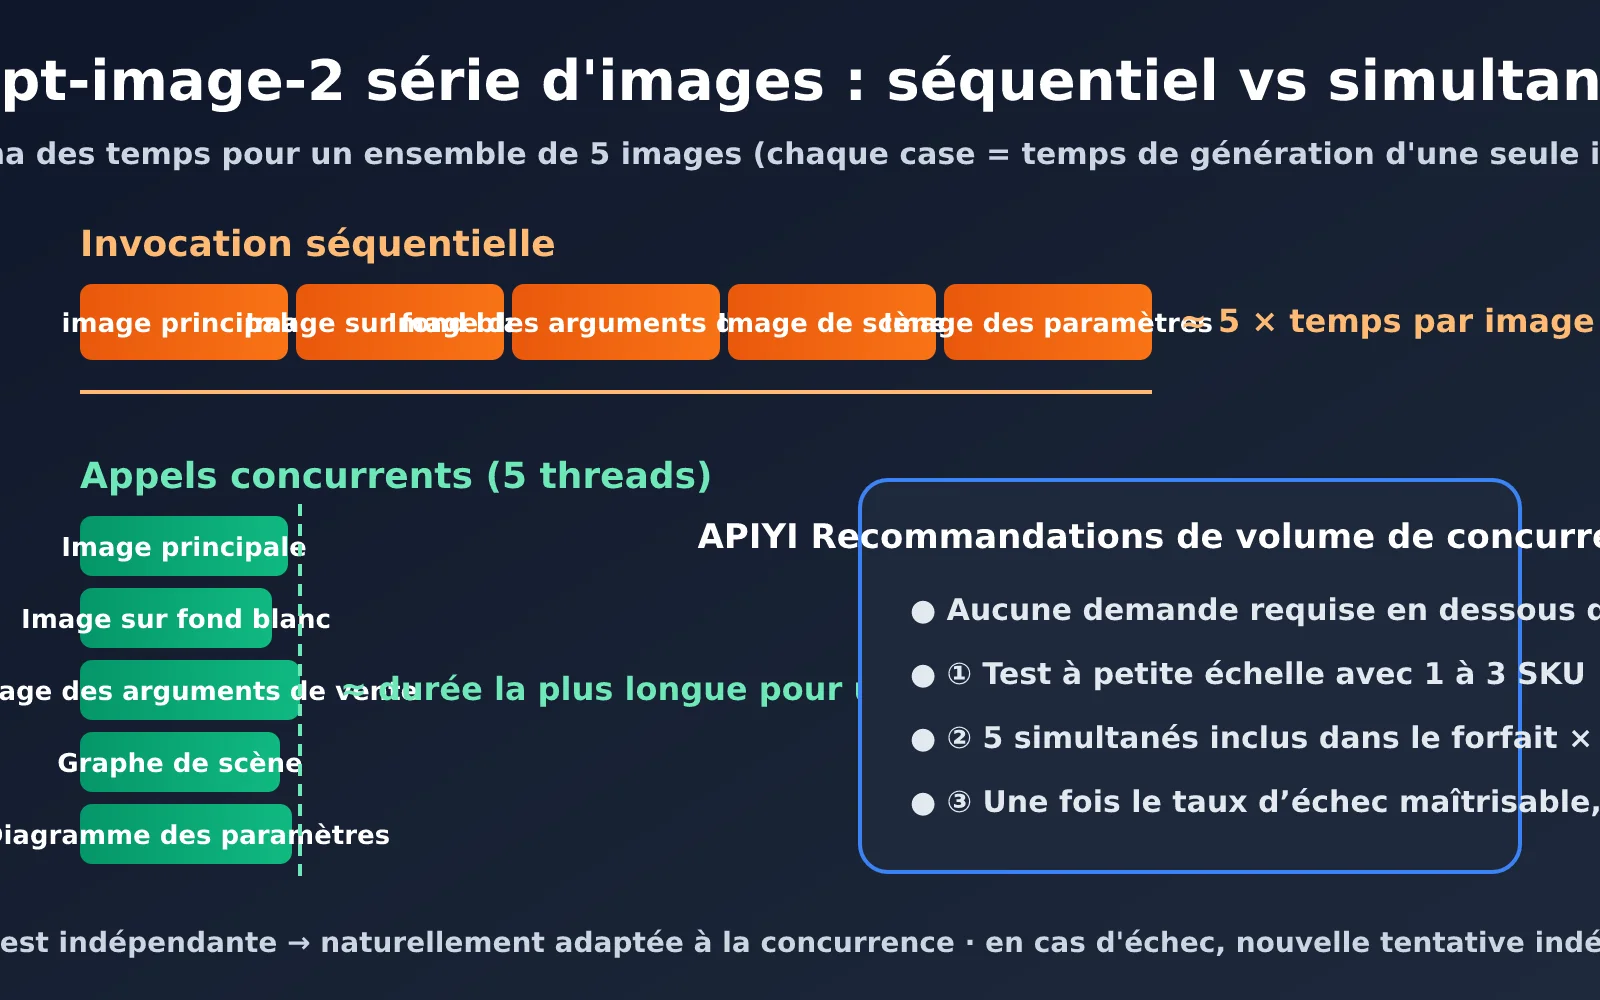
Le code pour générer les séries gpt-image-2 en parallèle
Il suffit de remplacer la boucle séquentielle ci-dessus par un pool de threads pour lancer les générations en parallèle, avec en prime une nouvelle tentative en cas d’échec : pas besoin de tout relancer parce qu’une seule image a planté.
from concurrent.futures import ThreadPoolExecutor

def gen_one(s, retries=2):
    for i in range(retries + 1):
        try:
            img = client.images.edit(model="gpt-image-2", image=open("cup.png", "rb"),
                                     prompt=s["prompt"] + STYLE_BLOCK, size=s["size"])
            return s["scene"], img.data[0].b64_json
        except Exception as e:
            if i == retries:
                return s["scene"], None

with ThreadPoolExecutor(max_workers=5) as pool:
    results = dict(pool.map(gen_one, shots))
failed = [k for k, v in results.items() if v is None]
Voir le code complet (style block, traitement multi-SKU, régénération des échecs, écriture des résultats sur disque)
import json, base64, time
from pathlib import Path
from concurrent.futures import ThreadPoolExecutor
from openai import OpenAI

client = OpenAI(api_key="YOUR_APIYI_KEY", base_url="https://api.apiyi.com/v1")

STYLE_BLOCK = (
    "。整体风格:北欧简约,米白色背景,柔和自然光,低饱和配色,"
    "保持参考图中产品的颜色、Logo 和结构完全不变,文字使用清晰无衬线中文字体。"
)

PLAN_PROMPT = """你是资深电商视觉策划。根据以下商品信息规划一套 {count} 张的{platform}套图。
商品信息:{product}
输出 JSON:{{"shots": [{{"scene": "...", "purpose": "...", "prompt": "...",
"size": "2048x2048", "text_overlay": "..."}}]}}
要求:每张图承担不同营销任务;prompt 只描述画面内容,不要描述整体风格;
需要文字时把文字原文写进 prompt 并用引号标出。"""


def plan_shots(product: str, platform: str = "淘宝", count: int = 5,
               model: str = "gpt-6.1-sol") -> list:
    """Découpe les plans avec un modèle texte ; pour du volume, on peut passer à claude-haiku-5-5 / gemini-3.8-flash"""
    resp = client.chat.completions.create(
        model=model,
        response_format={"type": "json_object"},
        messages=[{"role": "user", "content": PLAN_PROMPT.format(
            count=count, platform=platform, product=product)}],
    )
    return json.loads(resp.choices[0].message.content)["shots"]


def gen_one(shot: dict, ref_image: str, retries: int = 2):
    """Génère une image, avec retry et backoff exponentiel en cas d'échec"""
    for attempt in range(retries + 1):
        try:
            with open(ref_image, "rb") as f:
                img = client.images.edit(
                    model="gpt-image-2",
                    image=f,
                    prompt=shot["prompt"] + STYLE_BLOCK,
                    size=shot.get("size", "2048x2048"),
                )
            return shot["scene"], img.data[0].b64_json
        except Exception as e:
            print(f"[{shot['scene']}] 第 {attempt + 1} 次失败:{e}")
            time.sleep(2 ** attempt)
    return shot["scene"], None


def gen_image_set(sku: str, product: str, ref_image: str, workers: int = 5):
    shots = plan_shots(product)
    out_dir = Path("output") / sku
    out_dir.mkdir(parents=True, exist_ok=True)
    (out_dir / "plan.json").write_text(json.dumps(shots, ensure_ascii=False, indent=2))

    with ThreadPoolExecutor(max_workers=workers) as pool:
        results = dict(pool.map(lambda s: gen_one(s, ref_image), shots))

    # une passe de régénération pour les images en échec
    failed = [s for s in shots if results.get(s["scene"]) is None]
    for s in failed:
        results[s["scene"]] = gen_one(s, ref_image, retries=3)[1]

    for scene, b64 in results.items():
        if b64:
            (out_dir / f"{scene}.png").write_bytes(base64.b64decode(b64))
    print(f"{sku}: 成功 {sum(1 for v in results.values() if v)}/{len(shots)} 张")


if __name__ == "__main__":
    gen_image_set(
        sku="cup-green-500",
        product="墨绿色 316 不锈钢保温杯,500ml,24 小时保温,一键弹盖",
        ref_image="cup.png",
    )
Les 3 étapes pour monter en charge
Même sans limite de concurrence, mieux vaut augmenter le volume par paliers : on valide d’abord la qualité, puis on élargit, histoire de ne pas se retrouver avec des centaines d’images ratées d’un coup.
- Test à petite échelle : choisissez 1 à 3 SKU, lancez en séquentiel ou à faible concurrence, puis vérifiez à la main la fidélité du produit, la justesse des textes et la cohérence du style.
- Concurrence moyenne : une fois le résultat stable, passez à 5 appels simultanés par série et 5 à 10 SKU en parallèle, en surveillant le taux d’échec et la durée moyenne.
- Montée en charge : quand le taux d’échec reste sous contrôle, augmentez la concurrence selon votre volume métier. Jusqu’à 500 RPM, tout passe directement.
| Mode d’appel | Durée pour une série de 5 images | Stabilité | Étape concernée |
|---|---|---|---|
| Appels séquentiels | environ 5 fois le temps d’une image | le plus stable, pratique pour déboguer | réglage des invites |
| Concurrence dans la série (5 threads) | proche de l’image la plus lente | stable | mises en ligne quotidiennes |
| Multi-SKU + concurrence dans la série | proche d’une série unique | nécessite des retries | mises en ligne en volume avant promo |
🚀 Conseil pour monter en charge : pour les mises en ligne groupées avant une grande promo, nous conseillons de passer par APIYI apiyi.com en mode « multi-SKU + concurrence dans la série ». En dessous de 500 RPM, la plateforme ne demande aucune autorisation, et avec le mécanisme de régénération des images en échec, les séries complètes de plusieurs dizaines de SKU sont bouclées en très peu de temps.
Comment choisir la solution de kit d’images e-commerce pour gpt-image-2
Les deux solutions ne sont pas mutuellement exclusives : en pratique, on les combine souvent. Voici les recommandations par plateforme et par scénario courants :
| Plateforme / Scénario | Solution recommandée | Nombre d’images conseillé | Explication |
|---|---|---|---|
| Images principales Taobao/Tmall | Solution 2 | 5 images | Une image principale, une sur fond blanc, une sur les arguments de vente, une en situation, une sur les caractéristiques |
| Pages de détails Taobao/Pinduoduo | Solution 1 + Solution 2 | 3 à 6 images demi-écran | Génération par sections puis assemblage vertical |
| Listing Amazon | Solution 2 | 7 images | La première image sur fond blanc doit être strictement conforme ; les autres servent aux arguments de vente et aux mises en situation |
| Page produit d’un site indépendant | Solution 2 | 4 à 6 images | Les images de situation ont plus de poids, pour mettre en avant l’identité de la marque |
| Recommandations Xiaohongshu | Solution 2 | 3 à 6 images | Format vertical 3:4, axé sur des scènes du quotidien |
| Affiche événementielle / compilation d’arguments de vente | Solution 1 | 1 image | L’information est concentrée sur une seule image, ce qui améliore l’efficacité de diffusion |
Le principe de base pour choisir est simple : pour les images destinées à être diffusées et affichées indépendamment, utilisez la solution 2 ; pour les contenus lus en continu sur une seule page, utilisez la solution 1. En cas de doute, commencez par la solution 2 pour produire l’image principale et les images de situation, puis utilisez la solution 1 pour créer une longue image compilant les arguments de vente : c’est ce qui couvre le plus de cas.
💡 Conseil de combinaison : les deux solutions utilisent le même modèle gpt-image-2 et la même clé API. On recommande d’encapsuler les deux processus dans un seul service qui choisit automatiquement la solution selon le type de produit ; le marchand n’a plus qu’à téléverser une photo du produit et quelques lignes d’arguments de vente.
Questions fréquentes
Le paramètre n de gpt-image-2 permet-il de générer directement un kit d’images e-commerce ?
Non. Les séries officielles gpt-image-2 et 2.5 prennent en charge le paramètre n, et APIYI aussi, mais il s’agit de générer n variantes à partir de la même invite. Comme chaque image du kit a un contenu différent et nécessite une invite différente, il faut faire plusieurs appels. Le paramètre n est plus adapté pour sélectionner la meilleure image à un endroit clé comme l’image principale.
Que faire si le produit n’a pas le même aspect sur les différentes images générées ?
C’est le problème le plus courant avec les kits d’images. La méthode la plus efficace consiste à passer la même photo réelle du produit à l’interface edits à chaque appel, et à préciser dans l’invite « gardez la couleur, le logo et la structure du produit de l’image de référence inchangés ». Fixez aussi la description du style dans un style block, sans laisser le modèle texte improviser. Pour l’image de référence, privilégiez une photo réelle avec un fond propre et un éclairage uniforme : le rendu sera le plus fidèle.
Comment gérer les erreurs de rendu du texte chinois dans les images ?
La capacité de rendu du chinois de gpt-image-2 est déjà solide, mais plus il y a de texte, plus le risque d’erreur augmente. On conseille de limiter le texte de chaque image à 2 ou 3 phrases courtes, et de mettre le texte exact entre guillemets dans l’invite. Si le texte d’une image est erroné, il suffit de régénérer cette image seule, sans refaire tout le kit.
Quel modèle est le plus économique pour la décomposition du texte ?
Pour déboguer le modèle d’invite, utilisez gpt-6.1-sol, qui offre la meilleure qualité de planification ; une fois le modèle stabilisé et passé en production à grande échelle, vous pouvez basculer sur claude-haiku-5-5 ou gemini-3.8-flash, moins cher et plus rapide. Cette étape n’est appelée qu’une fois par kit d’images, et coûte bien moins que la génération d’images elle-même. Les trois modèles sont accessibles avec la même clé API sur APIYI apiyi.com.
Faut-il demander un quota pour les appels concurrents ?
Non. APIYI n’impose aucune limite de concurrence pour gpt-image-2 : en dessous de 500 RPM, vous pouvez l’utiliser directement. On conseille de commencer par un test à petite échelle sur 1 à 3 SKU, puis d’augmenter progressivement la concurrence une fois les résultats confirmés.
En résumé
Pour générer des séries d’images e-commerce avec gpt-image-2, la clé est de bien comprendre la particularité de son interface : « un appel correspond à une invite ». Le paramètre n sert à choisir la meilleure image parmi plusieurs, alors qu’une série d’images nécessite plusieurs appels avec des invites différentes. Partant de là, les contenus à lecture continue comme les pages de détails ou les récapitulatifs d’arguments de vente peuvent être générés en une seule fois avec l’approche mono-image multi-dimensionnelle ; les séries nécessitant un affichage indépendant, comme les images principales ou les mises en situation, se réalisent en batch via un pipeline de décomposition par modèle textuel + appels concurrents.
Le point commun aux deux approches, c’est le contrôle de cohérence : un bloc de style (style block) fixe combiné à la même image de référence du produit, voilà la clé pour que plusieurs images semblent issues de la même équipe de design. Côté concurrence, en dessous de 500 RPM, vous pouvez envoyer directement à pleine charge ; la démarche la plus sûre reste en trois étapes : « test à petite échelle → concurrence moyenne → montée en charge par lots ».
Nous recommandons de réaliser toute la chaîne en une seule plateforme via APIYI apiyi.com : gpt-6.1-sol, claude-haiku-5-5 et gemini-3.8-flash se chargent de la décomposition des besoins, gpt-image-2 génère les images, et une seule clé API relie toutes les étapes. Vous pouvez ainsi mettre en place rapidement votre propre service de génération de séries d’images e-commerce.
Auteur : APIYI Team | Spécialisé dans le partage technique sur les API de grands modèles de langage. Pour plus de tutoriels d’intégration de modèles, rendez-vous sur APIYI apiyi.com