Note de l’auteur : des critères d’acceptation à l’isolation des données en passant par la revue indépendante, concevez en 5 étapes une validation externe pour les tâches AI approfondies, afin d’éviter les fausses complétions dues à l’auto-évaluation du modèle.
Le modèle répond « tâche terminée, résultat exact », mais le résultat ne résiste pas à une reproduction : c’est le casse-tête que rencontrent de nombreux utilisateurs d’IA lorsqu’ils traitent des tâches approfondies. Cet article présente une méthode de conception de validation externe qui peut tourner de manière autonome, pour vous aider à passer de « le modèle dit que c’est fait » à « les preuves montrent que c’est fait ».
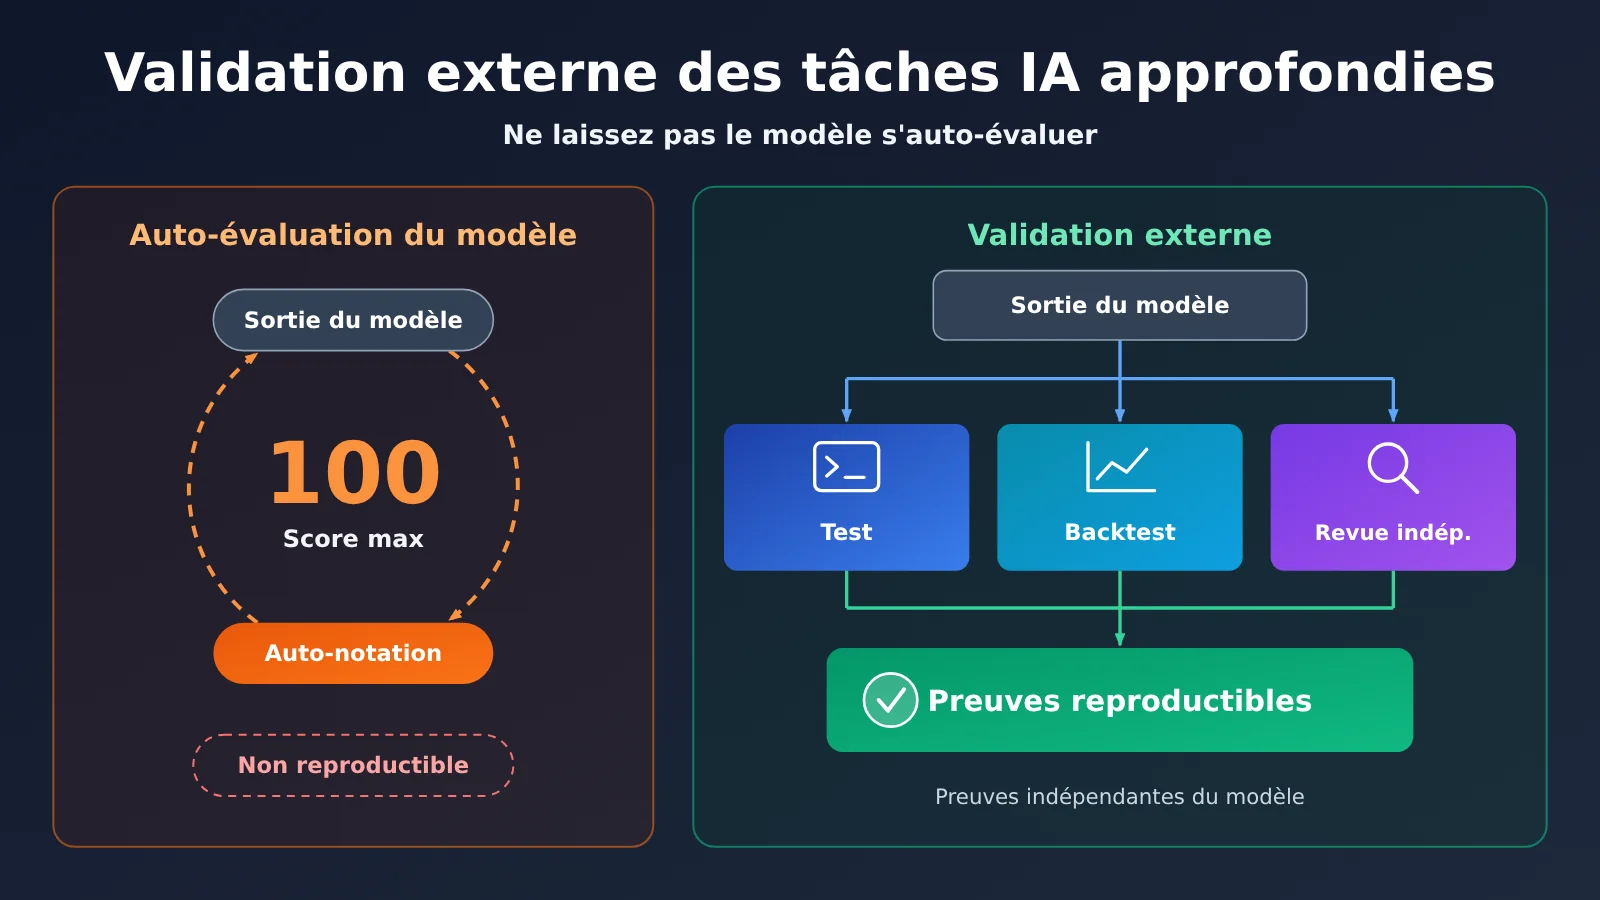
Dans un guide pratique publié en octobre 2026, Felix Rieseberg, développeur de Claude, recommande clairement : ne laissez pas le modèle s’auto-évaluer, et tenez-vous-en à une validation externe. Selon lui, la forme idéale est un outil que le modèle peut exécuter lui-même et qui lui renvoie un retour immédiat. InfoQ a publié la traduction chinoise de cet article le 4 novembre 2026.
Il ne s’agit pas d’un rappel du genre « vérifiez une fois de plus ». L’article original donne la direction ; nous en tirons ici des étapes de conception concrètes, couvrant le choix des moyens de validation, les modes de défaillance courants et les méthodes de revue multi-modèles.
L’essentiel : à la fin de cet article, vous saurez rédiger un contrat de validation pour vos tâches AI approfondies, afin que le modèle itère sur des retours vérifiables au lieu de s’arrêter sur sa propre évaluation.
Points clés de la validation externe des tâches d’IA approfondies
L’essentiel de la validation externe ne consiste pas à ajouter une étape de contrôle, mais à rendre les critères de jugement indépendants du raisonnement du modèle lui-même.
| Point clé | Explication | Valeur |
|---|---|---|
| Définir les critères d’abord | Rédiger les conditions de réussite avant de commencer et les rendre autant que possible vérifiables | Éviter que le modèle réinterprète l’objectif après coup |
| Isolation des données | Tester les conclusions avec des données ou des scénarios que le modèle n’a jamais vus | Distinguer une véritable découverte d’un ajustement a posteriori |
| Priorité aux outils | Privilégier les validateurs exécutables et capables de donner un retour immédiat | Permettre au modèle d’itérer seul et réduire la surveillance humaine |
| Conservation des preuves | Enregistrer les résultats d’exécution, les journaux et les étapes de reproduction | Permettre d’examiner les conclusions, pas seulement d’y croire |
| Revue indépendante | Contester les résultats avec des méthodes et des positions différentes | Repérer les problèmes qu’un validateur unique laisserait passer |
Pourquoi les tâches d’IA approfondies ont besoin d’une validation externe
Quand Rieseberg parle de « profondeur », il désigne l’usage des outils, des techniques et des connaissances des meilleurs experts du domaine, en allant chercher dans les données sous-jacentes plutôt que de rester à la surface de la tâche. Plus la tâche est approfondie, plus il est difficile de juger intuitivement si le résultat est correct. Une analyse de l’attrition bien rédigée peut sembler convaincante, mais cela ne prouve pas que le jugement causal qu’elle contient soit valide.
Il évoque aussi un phénomène courant : lorsqu’on demande au modèle de se comporter comme un expert, il se contente souvent de changer de vocabulaire, sans modifier réellement sa méthode de travail. L’auto-évaluation repère difficilement ce type de problème, car l’évaluateur et le producteur partagent les mêmes hypothèses. Si le raisonnement est biaisé dès le départ, la notation du modèle peut suivre le même biais.
Des objectifs ambitieux rendent la validation encore plus importante. L’article original recommande de fixer des objectifs apparemment déraisonnables, par exemple réduire le temps de chargement d’un site web de 10 secondes à 200 millisecondes, et de demander au modèle de continuer à essayer. Ces objectifs sont utilisables parce que 200 millisecondes peuvent être mesurées. Si l’objectif est à la fois agressif et invérifiable, on risque surtout d’obtenir un rapport qui semble encore plus sûr de lui.
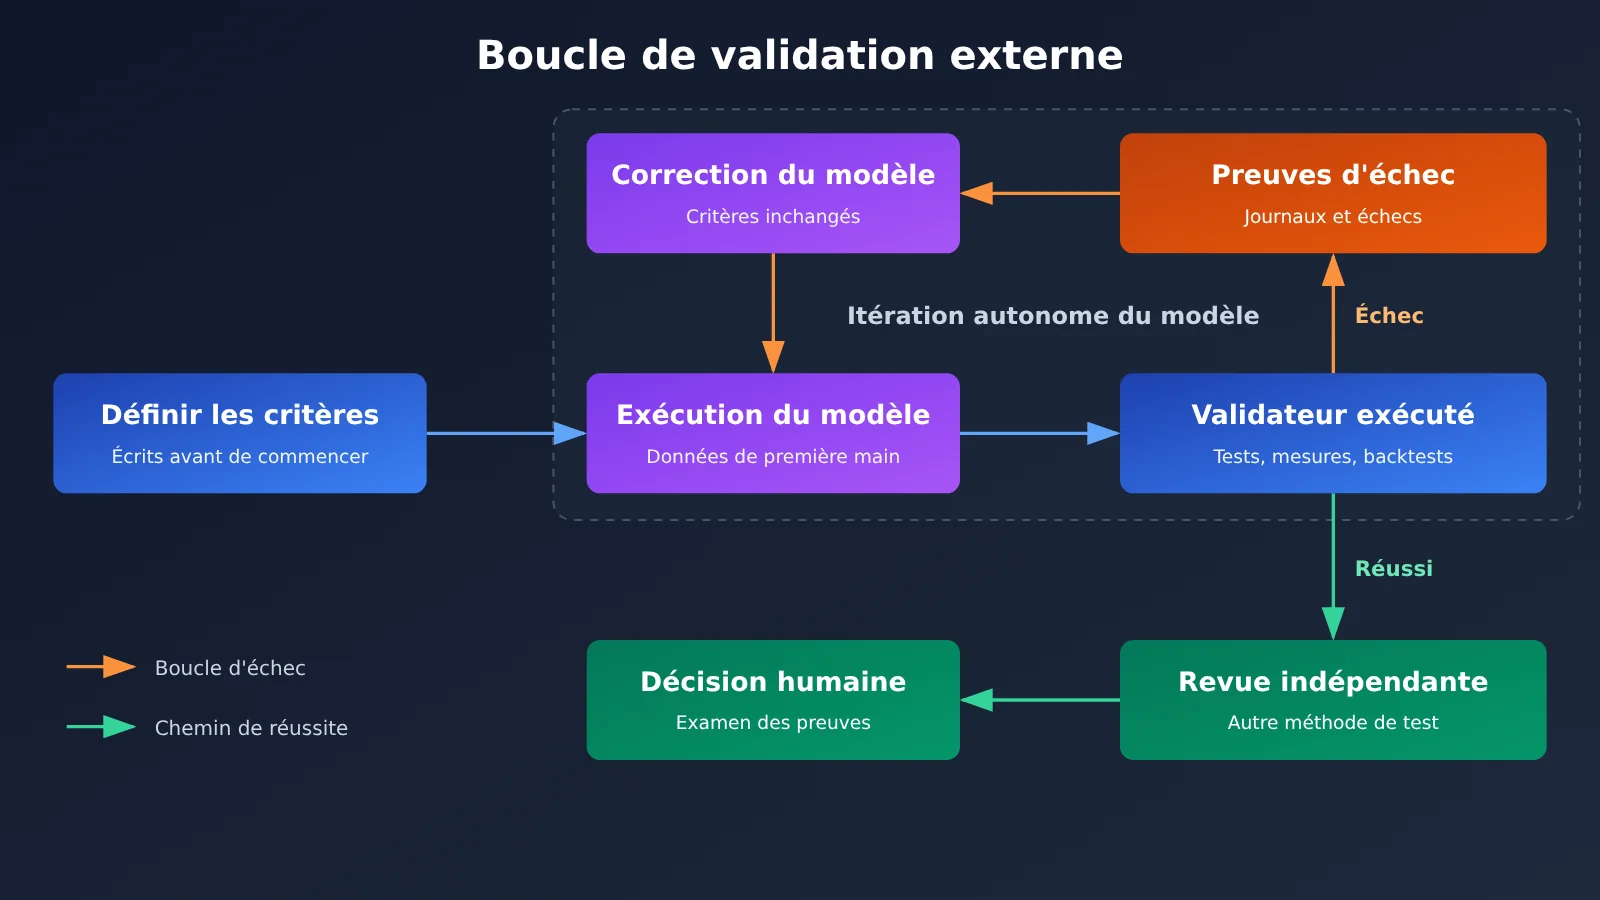
Prise en main rapide de la validation externe des tâches AI approfondies : la méthode de conception en 5 étapes
La méthode ci-dessous ne dépend d’aucun modèle ni d’aucun framework en particulier : vous pouvez commencer par l’appliquer à une tâche en cours. Si vous ne pouvez pas tout mettre en place pour l’instant, je vous conseille de commencer par les trois premières étapes.
Étape 1 : reformuler l’objectif de la tâche en critères de validation externe
« L’analyse est complète », « la qualité du code est bonne » : impossible de trancher directement. Il faut reformuler ces objectifs en conditions qui peuvent réussir ou échouer. Par exemple, transformez « corriger le crash » en « en suivant les étapes de reproduction d’origine, l’application ne plante plus et tous les tests associés passent ». Les critères doivent être écrits avant que le modèle ne commence à travailler, sinon il risque d’ajuster la définition du succès une fois le travail terminé.
Vous pouvez d’abord rédiger le contrat de validation ci-dessous, puis le confier au modèle pour exécution :
| Champ | Ce qu’il faut préciser | Exemple |
|---|---|---|
| Objectif final | Le résultat métier ou technique réellement visé | L’application reste stable, plus de crash de ce type |
| Matériaux d’origine | Les données de première main que le modèle doit utiliser directement | Rapports de crash, correspondance entre les versions et les commits Git |
| Validateur | Quel outil ou quelles données déterminent le résultat | Script de reproduction, tests automatisés, données de validation (holdout) |
| Conditions de réussite | Seuils ou règles de décision explicites | Impossible de reproduire le crash sur les trois systèmes cibles |
| Interdictions | Ce que le modèle ne doit pas modifier | Ne pas supprimer de tests, ne pas modifier les données de validation |
| Preuves à fournir | Les résultats d’exécution à joindre | Commandes, journaux, enregistrements d’échec et résultat final |
| Conditions d’arrêt | Quand terminer ou passer la main à un humain | Après avoir atteint la limite d’itérations, soumettre les raisons du blocage |
Étape 2 : rompre le lien entre la conclusion et les données de vérification
Quand un modèle formule une hypothèse à partir d’un jeu de données et la démontre avec ce même jeu, il ne s’agit pas d’une validation externe. L’exemple du désabonnement des utilisateurs cité dans l’article original offre une bonne approche : demandez au modèle de rechercher dans les journaux les tout premiers signaux de désabonnement, puis de prouver, avec des données qu’il n’a jamais vues, que ce signal possède réellement un pouvoir prédictif. En pratique, on peut découper les données dans le temps : les données anciennes servent à l’exploration, les plus récentes à la vérification.
Il est préférable que les données de réserve (hold-out) soient conservées par un script ou une personne indépendante ; le modèle n’a accès qu’aux résultats d’exécution et ne peut pas lire directement le détail. Si l’on ajuste le plan encore et encore en fonction des résultats, les données de réserve finissent elles aussi par être « apprises » progressivement. C’est pourquoi, pour les conclusions importantes, mieux vaut conserver un dernier jeu de données réservé uniquement à la validation finale.
Étape 3 : privilégier les outils de validation externe que le modèle peut exécuter lui-même
Plus le validateur est proche du résultat réel et plus le retour est rapide, plus le modèle peut itérer de manière autonome. Le tableau ci-dessous récapitule, par type de tâche courant, plusieurs moyens de validation externe. Inutile de chercher l’unique « meilleure solution » : il faut les combiner selon le niveau de risque.
| Moyen de validation | Ce qu’il peut prouver | Vitesse du retour | Principales limites |
|---|---|---|---|
| Tests automatisés et scripts de reproduction | Un comportement donné est conforme aux attentes | Rapide | Ne couvre que les scénarios déjà spécifiés |
| Outils de mesure de performance | Les indicateurs atteignent-ils le seuil | Rapide | Les différences d’environnement peuvent fausser le résultat |
| Backtest sur données de réserve | La conclusion a-t-elle un pouvoir prédictif | Moyen | Les régularités historiques ne se prolongent pas forcément |
| Revue des méthodes façon red team | Les hypothèses et la chaîne de preuves sont-elles fragiles | Moyen | La qualité du jugement dépend de la méthode de revue |
| Exécution en mode fantôme (shadow run) | La solution est-elle efficace dans le processus réel | Lent | Cycle long, coût organisationnel élevé |
| Contrôle par échantillonnage d’un expert métier | Le résultat correspond-il au jugement professionnel | Lent | Difficile à couvrir à grande échelle |
Étape 4 : intégrer la validation externe dans la boucle de travail du modèle
Un outil de validation ne produit un effet d’itération continue que s’il est placé dans l’environnement de travail du modèle. L’exemple de correction de plantages cité dans l’article original est très parlant : l’auteur commence par permettre à Claude d’accéder facilement aux rapports de plantage, de savoir à quel commit Git correspond chaque version, et de disposer de machines Windows, macOS et Linux. Une fois ces conditions réunies, le modèle peut reproduire le problème de manière autonome et vérifier sa correction.
Cela montre aussi que la validation externe impose souvent d’ajuster le flux de travail, et pas seulement de modifier l’invite. Il faut ouvrir les données et les outils nécessaires, par exemple en connectant des sources de données via un connecteur MCP, tout en limitant les permissions au périmètre de la tâche. La conception de la boucle doit comporter au minimum trois éléments :
- Retour d’échec : renvoyer des journaux d’erreur précis et les éléments non validés, et pas seulement le mot « échec ».
- Plafond d’itérations : limiter le nombre de tentatives et le budget total pour éviter que le modèle ne s’enferme dans une boucle stérile.
- Éléments protégés : passer les tests, les scripts de validation et les données de réserve en lecture seule, afin d’empêcher le modèle de « réussir » en modifiant les critères.
Étape 5 : finaliser la validation externe par une revue indépendante et des exécutions en parallèle
Le fait qu’un validateur unique donne son feu vert ne garantit pas la fiabilité de la conclusion. L’article original évoque la possibilité de faire appel à une « red team » spécialisée dans la recherche d’erreurs, par exemple des investisseurs à la vente et des experts-comptables judiciaires, mais l’essentiel n’est pas d’imiter leur ton : il faut utiliser leurs véritables méthodes de recherche. On peut par exemple demander au modèle de remonter à la source originale de chaque chiffre clé, ou de chercher activement des données susceptibles de réfuter la conclusion.
Pour les changements de processus, on peut aussi recourir à une exécution en parallèle. L’article original suggère de commencer par démontrer, à l’aide de données historiques, que le nouveau mécanisme de rétrospective aurait permis de détecter les problèmes plus tôt, puis de le faire tourner en parallèle du processus existant pendant un trimestre. Cela permet de vérifier l’effet réel sans avoir à assumer dès le départ le risque d’un remplacement complet de l’ancien processus.
Conseil d’intégration : si vous souhaitez confier l’exécution et la revue à des modèles différents, vous pouvez passer par APIYI pour des appels unifiés. APIYI fournit l’accès API aux modèles cités dans cet article, compatible avec les formats d’interface OpenAI et Anthropic ; l’intégration se limite généralement à configurer
base_url,api_keyetmodelconformément à la documentation. Documentation : https://docs.apiyi.com
Modes de défaillance courants de la validation externe des tâches d’IA complexes
La validation externe peut elle aussi devenir une simple formalité. Les problèmes ci-dessous doivent être anticipés dès la conception ; sinon, les résultats de validation ne procureront qu’un faux sentiment de sécurité.
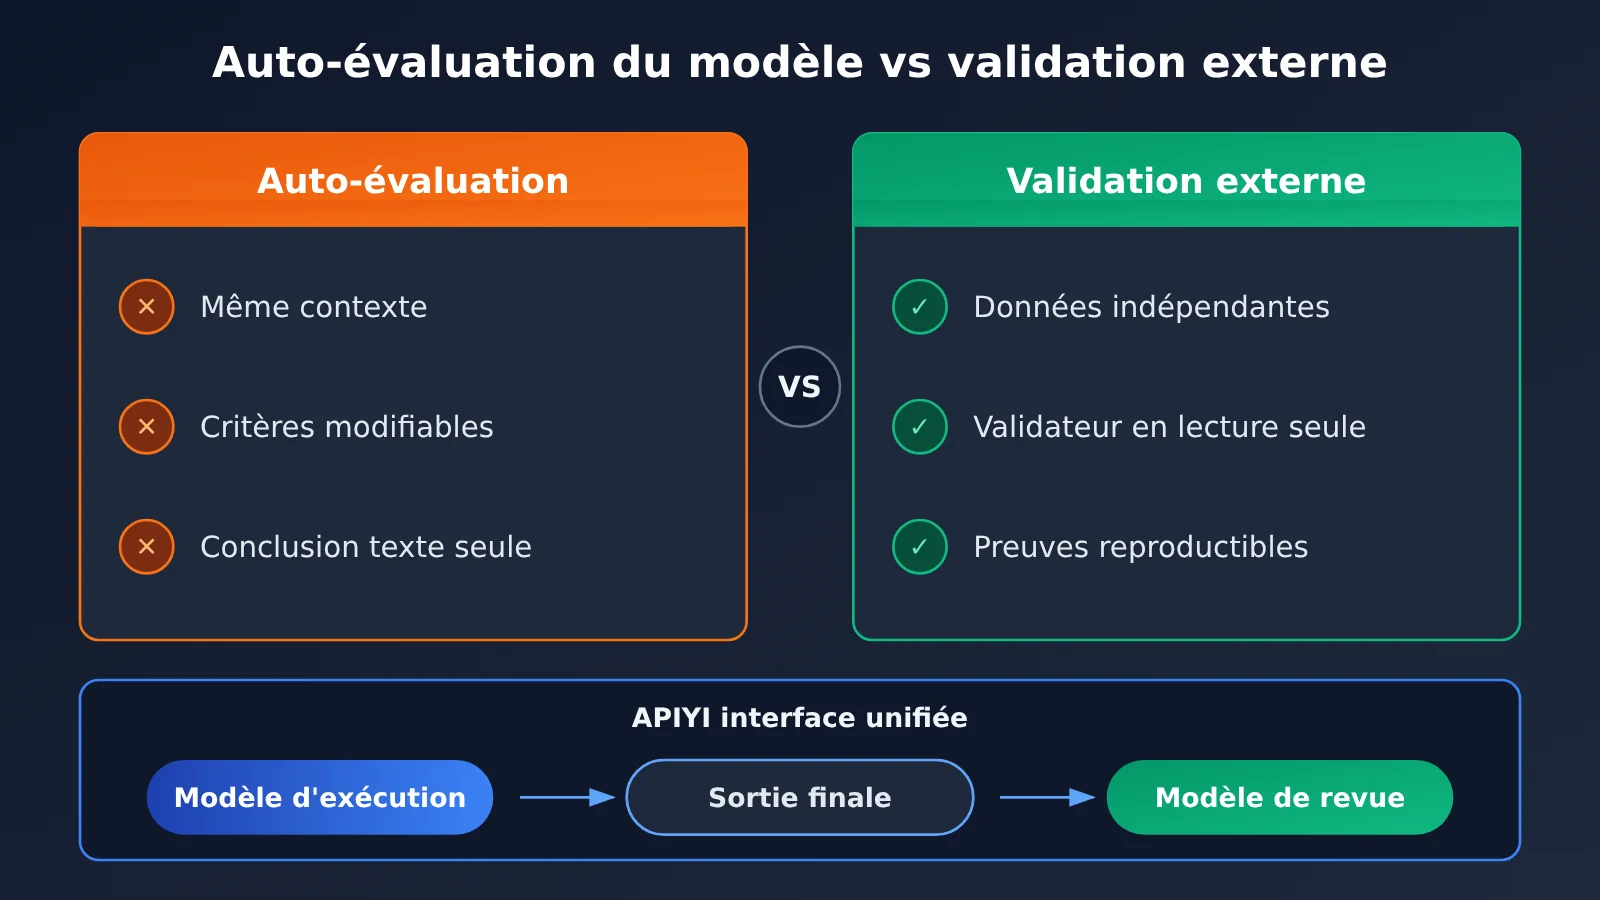
| Mode de défaillance | Manifestation typique | Mesure corrective |
|---|---|---|
| Modification des critères | Supprimer des cas en échec ou assouplir les assertions | Validateur en lecture seule et revue des modifications concernées |
| Surapprentissage sur le jeu de validation | Les métriques grimpent continuellement, mais le modèle échoue sur de nouvelles données | Conserver un jeu de données final pour l’acceptation |
| Raisonnement circulaire | Valider les conclusions du modèle avec des données générées par le modèle | Revenir aux journaux d’origine et aux sources primaires |
| Validation de pure forme | Format correct, mais contenu erroné | Ajouter des règles métier et des vérifications par échantillonnage |
| Jeu de rôle | La conversation ressemble à celle d’un expert, mais les résultats ne s’améliorent pas | Exiger l’application d’une méthode concrète et la fourniture de preuves |
Un point mérite une explication particulière : la « revue par un second modèle ». Elle est meilleure que l’auto-évaluation, car elle peut révéler une partie des angles morts, mais elle reste une revue fondée sur le jugement et ne remplace ni les tests ni les données réelles. Lors de cette revue, il est préférable de ne fournir que les critères de la tâche, les matériaux d’origine et le résultat final, sans les échanges précédents, afin de limiter l’influence du raisonnement initial sur le jugement.
Exemples de conception de validation externe pour différentes tâches d’IA complexes
Les exemples suivants peuvent servir de point de départ ; les seuils précis doivent être fixés en fonction du contexte métier.
| Tâche | Approche fondée uniquement sur l’auto-évaluation | Conception de la validation externe |
|---|---|---|
| Corriger un plantage applicatif | Le modèle explique le principe de la correction, puis annonce que c’est terminé | Reproduire le problème sur plusieurs systèmes et confirmer qu’il ne réapparaît pas après correction |
| Identifier des signaux de churn | Le modèle produit un rapport d’attribution plausible | Tester la capacité de prédiction sur des données n’ayant pas servi à l’exploration |
| Vérifier les causes de churn | Le modèle reprend le diagnostic « l’onboarding des nouveaux utilisateurs pose problème » | Chercher dans les données brutes des éléments qui étayent ou contredisent ce diagnostic |
| Optimiser le temps de chargement | Le modèle liste des optimisations et estime les gains | Mesurer dans un environnement fixe et comparer au seuil cible |
| Refondre la revue métier | Le modèle démontre que la nouvelle approche est plus avancée | Après un backtest historique, faire tourner la nouvelle approche en parallèle du processus existant pendant un trimestre |
Pour savoir si une tâche justifie une telle conception, on peut se référer à un critère simple : le coût d’une erreur est-il supérieur au coût de la validation ? S’il ne s’agit que de réécrire un e-mail, une simple relecture suffit probablement. En revanche, si le résultat peut avoir un impact sur un système en production ou sur l’allocation de ressources, il faut concevoir une validation externe.
FAQ — Questions fréquentes
Q1 : Qu’est-ce que la validation externe pour les tâches approfondies d’IA ?
Il s’agit de vérifier un résultat à l’aide d’éléments indépendants du jugement du modèle lui-même : tests automatisés, mesures de performance, backtesting sur des données mises de côté et revue par des experts. L’exigence centrale : le critère d’évaluation ne doit pas être décidé à la volée par le modèle qui a produit le résultat.
Q2 : Quelle différence entre validation externe et auto-vérification par le modèle ?
L’auto-vérification du modèle permet de repérer rapidement les oublis évidents, mais le producteur et l’évaluateur partagent les mêmes hypothèses. La validation externe introduit une source de preuve indépendante et convient mieux pour juger si un résultat est réellement valable. Les deux peuvent se compléter, mais l’auto-vérification ne peut pas servir de base d’acceptation finale.
Q3 : Les modèles devenant plus puissants, la validation externe reste-t-elle nécessaire ?
Rieseberg estime que ce problème pourrait finir par se résoudre à mesure que les modèles s’améliorent, mais il recommande clairement de maintenir la validation externe au moins jusqu’en octobre 2026. Il s’agit d’un jugement pratique lié à une étape donnée. Tant que la fiabilité de l’auto-évaluation des modèles n’est pas démontrée, les tâches à haut risque doivent conserver une vérification indépendante.
Q4 : Quels scénarios ont le plus besoin de validation externe ?
Il s’agit principalement des catégories de tâches suivantes :
– **Réparations d’ingénierie** : correction de crashs, optimisation des performances et migration de données.
– **Recherche sur les données** : analyse de churn, jugement causal et découverte de signaux prédictifs.
– **Processus agentiques de longue durée** : tâches où le modèle doit travailler en continu avec peu d’intervention humaine.
Q5 : Comment mettre en place une revue croisée multi-modèles via API ?
Vous pouvez passer par APIYI pour un accès unifié, dont l’interface est compatible avec les formats OpenAI et Anthropic :
1. Configurez l’adresse de l’interface et la clé API en suivant la documentation APIYI https://docs.apiyi.com.
2. Vérifiez les modèles disponibles et leurs tarifs sur la page des prix https://docs.apiyi.com/models.
3. Configurez un `model` différent pour l’exécution et pour la revue ; la requête de revue ne doit pas contenir la conversation de la phase d’exécution.
4. Consignez séparément les avis de revue et les résultats de tests, en donnant la priorité aux tests et aux preuves issues des données.
Q6 : Comment estimer le coût d’une boucle de validation externe ?
Le coût total dépend généralement du nombre d’itérations, de la longueur du contexte, de la longueur des sorties et du nombre de modèles de revue. Nous conseillons de lancer d’abord quelques tours sur un petit échantillon, de relever la consommation réelle à chaque tour, puis d’estimer le budget en tenant compte de la limite d’itérations. Cet article ne donne pas de prix unitaires : les prix des modèles, les modalités de facturation, les tarifs d’entrée et de sortie ainsi que les prix du cache doivent être vérifiés sur la page des prix APIYI https://docs.apiyi.com/models.
Q7 : Quelles sont les limites de la validation externe ?
Les tests ne couvrent que les scénarios définis, le backtesting ne garantit pas que les régularités historiques continueront de se vérifier, et le cycle d’une exécution en mode shadow est relativement long. Le fait de passer la validation signifie seulement que le résultat est étayé dans des conditions données, pas qu’il est absolument correct. Pour les décisions juridiques, financières ou stratégiques majeures, la décision finale doit rester du ressort des personnes responsables.
Points clés de la validation externe des tâches approfondies menées par l’IA
- Principe fondamental : ne jamais prendre l’auto-évaluation du modèle pour un critère d’acceptation ; le jugement doit reposer sur des preuves indépendantes.
- Critères définis en amont : rédigez les conditions de réussite avant de commencer, pour éviter de redéfinir le succès après coup.
- Isolation des données : vérifiez les conclusions du modèle avec des données qu’il n’a jamais vues, afin d’éviter le raisonnement circulaire.
- Priorité aux outils : un validateur exécutable, qui renvoie un retour immédiat, est ce qui favorise le mieux l’itération autonome.
- Environnement adapté : le modèle a besoin d’accéder aux données, aux outils et à un environnement d’exécution pour pouvoir se corriger lui-même.
- Révision par étapes : un second modèle sert à repérer les angles morts, mais ne remplace ni les tests ni les données réelles.
- Intégration flexible : on peut appeler plusieurs modèles de façon unifiée via APIYI, ce qui réduit le coût d’intégration de la contre-vérification croisée.
En résumé
Pour concevoir la validation externe d’une tâche approfondie confiée à l’IA, retenez ces trois points :
- Transformez d’abord l’objectif en critère vérifiable : sans condition de réussite, impossible de savoir si la tâche est réellement accomplie.
- Rendez les preuves indépendantes du raisonnement du modèle : isolez les données, protégez les validateurs et conservez une trace complète des exécutions.
- Combinez les moyens de vérification selon le risque : les outils apportent un retour rapide, la révision repère les angles morts, et les exécutions en parallèle testent l’effet réel.
Pour la suite, choisissez une tâche approfondie que vous avez sous la main : rédigez d’abord un contrat de validation, puis laissez le modèle s’y atteler. Cela permet non seulement de réduire les erreurs, mais aussi d’oser des objectifs plus ambitieux, car quelle que soit leur ampleur, les résultats restent vérifiables.
Si vous souhaitez mettre en place un processus d’exécution et de révision multi-modèles, vous pouvez effectuer des tests d’appel via APIYI ; les modalités d’intégration sont décrites sur https://docs.apiyi.com, et les prix des modèles ainsi que les règles de facturation suivent les données réelles disponibles sur https://docs.apiyi.com/models.
📚 Références
- Comment viser plus haut : un guide pratique pour les utilisateurs d’IA : traduction chinoise d’InfoQ
- Lien :
infoq.cn/article/F1ms7x7KI1p7UfocCywh -
Description : présente des méthodes pratiques selon trois axes : hauteur, profondeur et étendue
-
How to be more ambitious: A tutorial for humans with models : texte original de Felix Rieseberg
- Lien :
felixrieseberg.com/how-to-be-more-ambitious-a-tutorial-for-humans-with-models -
Description : source originale des recommandations de validation externe et des cas de correction de plantage, de perte d’utilisateurs, etc.
-
Centre de documentation APIYI : instructions d’intégration des interfaces
- Lien :
docs.apiyi.com -
Description : pour consulter les configurations d’accès aux formats compatibles OpenAI et Anthropic
-
Page des modèles et des tarifs APIYI : informations sur les modèles et la facturation
- Lien :
docs.apiyi.com/models - Description : les prix des modèles, les modalités de facturation et les tarifs de cache font foi sur cette page
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI ; pour plus de ressources, consultez le centre de documentation docs.apiyi.com