作者注:拿到 Kimi K3.1 Pro 開放權重後,先判斷許可證是否約束你的用法,再評估 1.56 TB 權重的自部署門檻。本文按場景給出這兩件事的判斷方法。
2026 年 11 月 4 日,Moonshot 在 Hugging Face 公開了 Kimi K3.1 Pro 的完整開放權重。這個日期是它 10 月 23 日在應用和 API 上線該模型時承諾的日期。倉庫 moonshotai/Kimi-K3.1-Pro 公開可下載,沒有設置申請門檻。企業團隊拿到權重後,通常會先問兩個問題:我們的用法會不會觸發許可證限制?自部署需要準備多少資源?
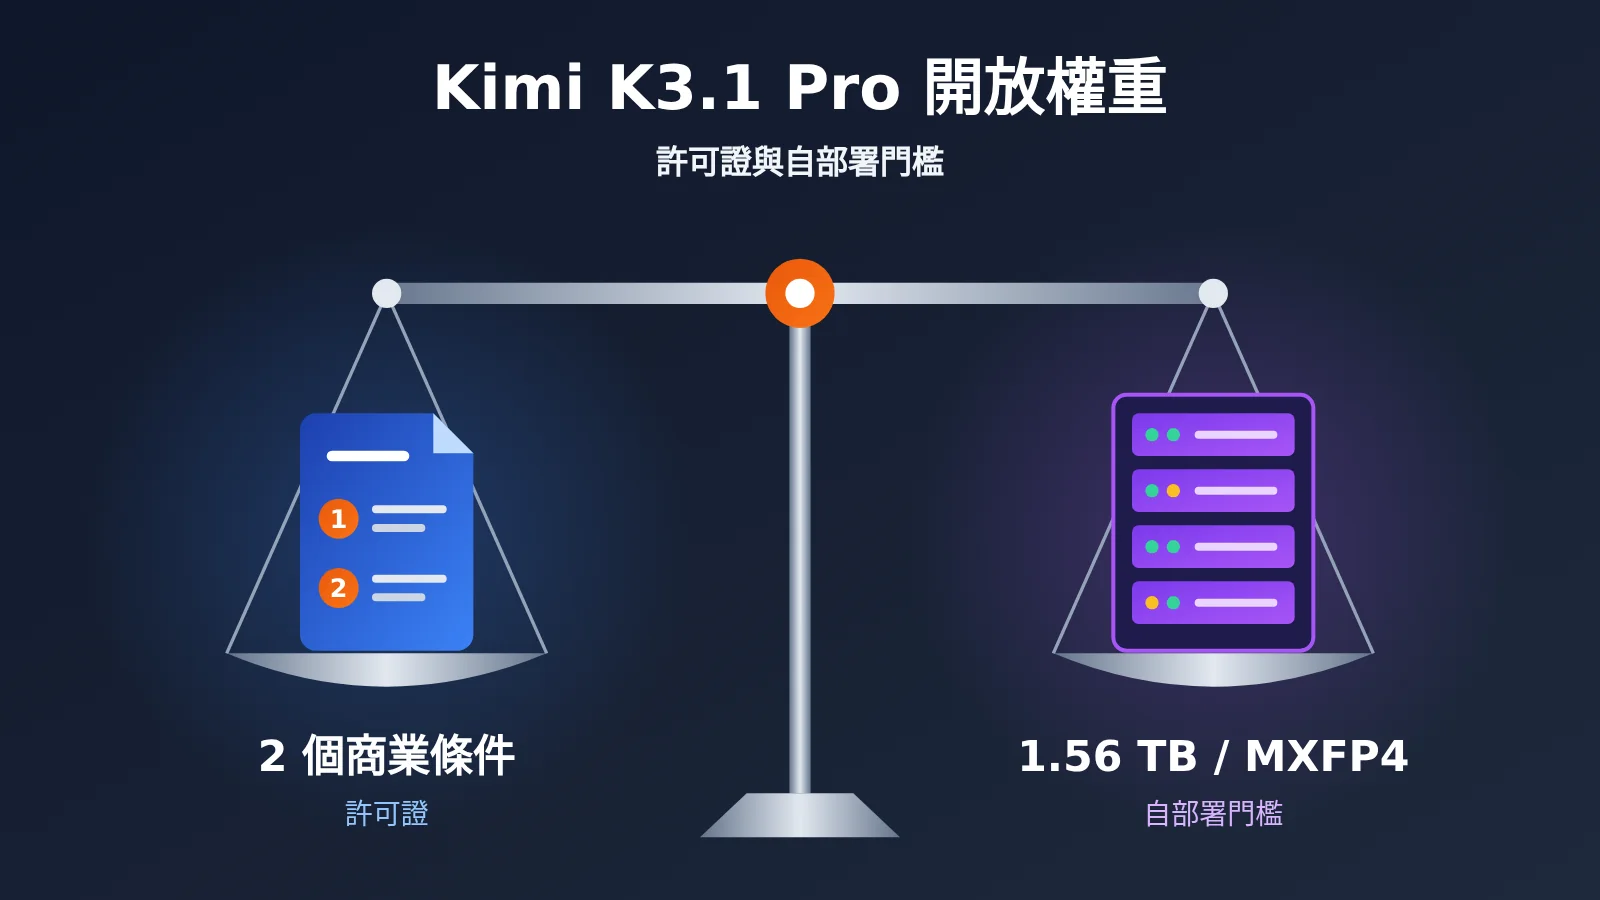
這不是一篇“開放權重等於隨便商用”的樂觀解讀。許可證裏有兩個帶金額和用戶量門檻的商業條件,適用對象並不相同。自部署方面,僅權重文件就有 1.56 TB,門檻也不低。
核心價值:讀完本文,你能分清兩個許可證條件各自約束誰,確認內部使用不受這兩個條件約束,並能根據權重體量、精度格式和推薦推理框架,對自部署可行性做出初步判斷。
Kimi K3.1 Pro 開放權重核心要點
先用一張表彙總本次發佈中與企業決策最相關的信息。
| 要點 | 說明 | 對決策的意義 |
|---|---|---|
| 發佈時間 | 10 月 23 日 API 上線,11 月 4 日權重公開 | 按承諾日期兌現,間隔 12 天 |
| 許可證 | 與 Kimi K3 許可證逐字相同,僅更換了名稱 | 已評估過 K3 的團隊可以直接沿用法務結論 |
| 自由權利 | 使用、修改、微調、再分發均免費 | 內部落地基本沒有許可證障礙 |
| 兩個商業條件 | 對外賣模型服務的高收入公司需另籤協議;超大規模產品需顯著署名 | 隻影響少數大體量對外業務 |
| 權重體量 | 96 個 safetensors 分片,共 1.56 TB | 需要多機多卡級別的部署能力 |
| 精度格式 | MXFP4 權重 + MXFP8 激活,量化感知訓練 | 這就是官方服務時使用的原生精度 |
Kimi K3.1 Pro 發佈背景詳解
據 ArtificialWatch 的統計,從 7 月到 11 月初,AI 實驗室在發佈時明確承諾開放權重日期的共有 5 次,5 次都按時兌現。從 API 上線到權重公開,間隔在 0 到 25 天之間,中位數爲 12 天。Moonshot 佔了其中兩次,Kimi K3 和 Kimi K3.1 Pro 都在上線後第 12 天交付權重。對需要提前規劃自部署的團隊來說,這是一個可參考的節奏信號。
模型本身是在 Kimi K3 基礎上做後訓練得到的,架構只改了一處:原來的全注意力層換成了 Gated DeepSeek Sparse Attention 層,目的是降低長上下文的計算成本。目前共 93 層,其中 69 層 KDA、24 層 Gated DSA。模型總參數 2.8 萬億,每個 token 激活 1,040 億,上下文長度 1,048,576 個 token,支持文本和圖像輸入。
Kimi K3.1 Pro 許可證條件逐條拆解
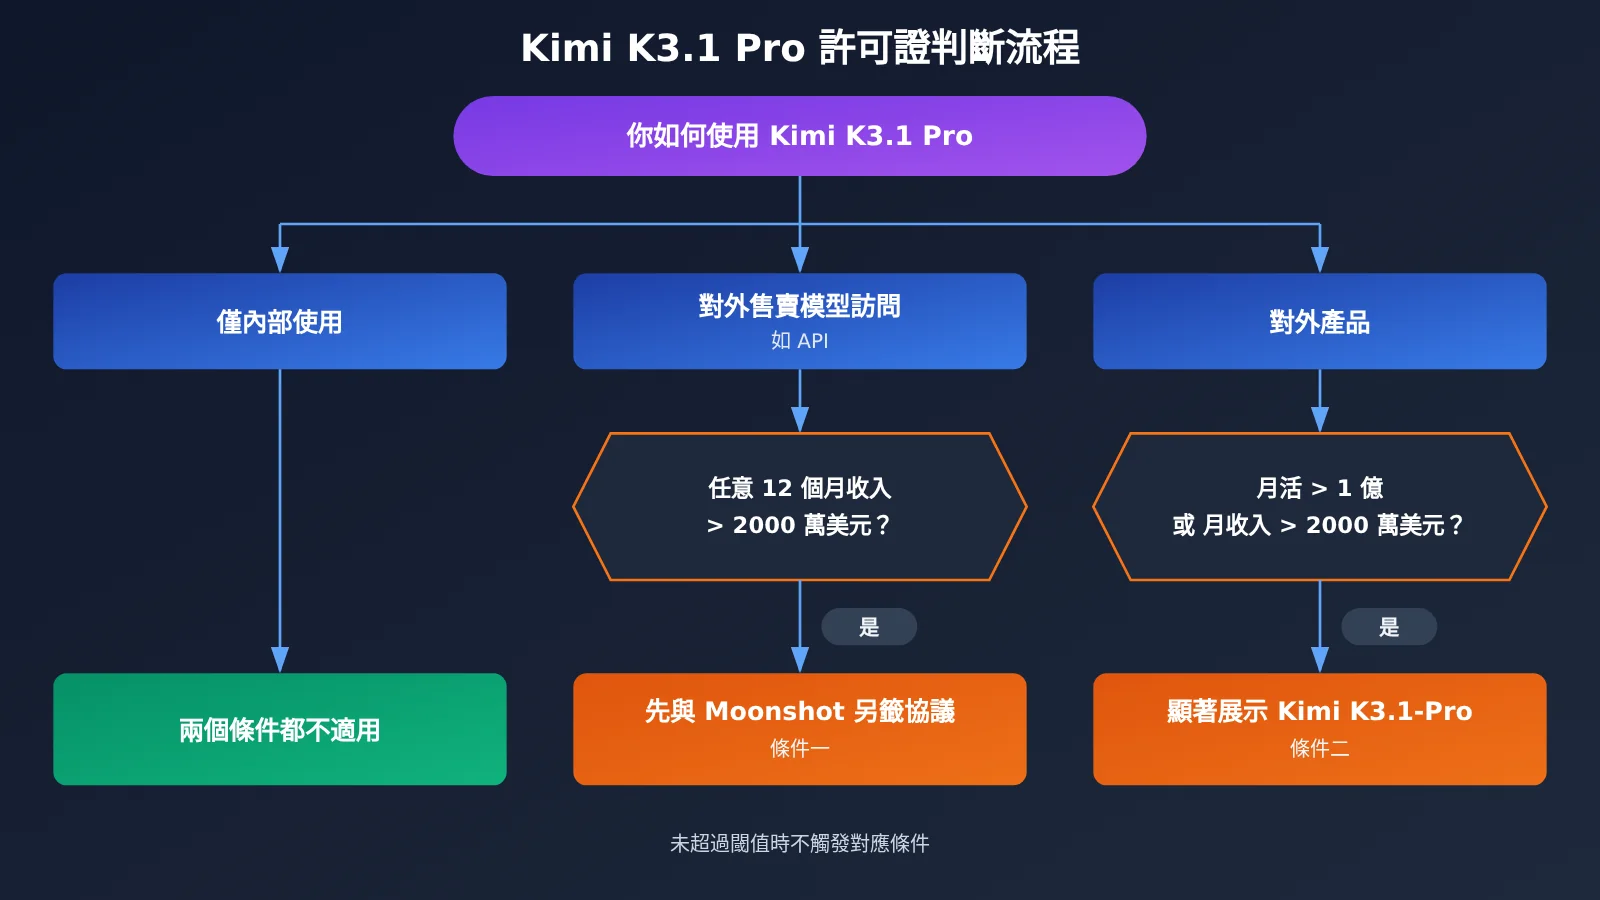
許可證給出的默認權利範圍較寬:使用、修改、微調、再分發都免費。限制只來自兩個附加條件,而且兩個條件約束的對象不同,需要分開看。
條件一:對外售賣模型訪問服務的公司
第一個條件針對的是“把模型訪問作爲服務出售”的公司,典型形式就是提供 API。如果這類公司在任意 12 個月內收入超過 2,000 萬美元,商業使用前需要先與 Moonshot 單獨簽訂協議。這裏有兩個關鍵詞:一是“售賣模型訪問”,二是“任意 12 個月”的滾動窗口,並不按自然年計算。
協議的具體條款目前沒有公開資料,費用、分成方式和審批流程都不清楚。原文對“收入”的口徑也有理解空間:它指公司整體收入,還是模型服務這部分收入?如果你的業務接近這個門檻,建議讓法務直接對照 LICENSE 原文判斷,不要只依賴二手解讀。
條件二:超大規模產品的署名要求
第二個條件針對產品體量。月活用戶超過 1 億,或月收入超過 2,000 萬美元的產品,必須顯著展示“Kimi K3.1-Pro”字樣。這條只要求署名,不要求另籤協議。注意這裏的收入門檻按“月”計算,和條件一的“12 個月”口徑不同,填寫合規清單時容易混淆。
Kimi K3.1 Pro 許可證場景對照
以下判斷依據公開報道對許可證的轉述整理,正式商用前仍請以 LICENSE 原文和法務意見爲準。
| 使用場景 | 是否觸發條件一(另籤協議) | 是否觸發條件二(顯著署名) | 判斷要點 |
|---|---|---|---|
| 企業內部使用(知識庫、內部助手、研發工具) | 否 | 否 | 資料明確說明兩個條件均不適用於內部使用 |
| 內部微調後自用 | 否 | 否 | 微調屬於免費權利範圍 |
| 對外提供 API,近 12 個月收入不超過 2,000 萬美元 | 否 | 視產品規模而定 | 需持續監控滾動 12 個月收入 |
| 對外提供 API,任意 12 個月收入超過 2,000 萬美元 | 是 | 視產品規模而定 | 商業使用前必須先簽協議 |
| C 端產品,月活超過 1 億或月收入超過 2,000 萬美元 | 視是否售賣模型訪問而定 | 是 | 需在產品中顯著展示模型名 |
| 再分發微調後的權重 | 否 | 否 | 再分發免費,附帶義務請覈對 LICENSE |
Kimi K3.1 Pro 自部署門檻評估
許可證沒有障礙,不代表團隊就能部署起來。下表彙總模型卡和公開報道中的部署相關規格。
| 規格項 | 數值 | 部署含義 |
|---|---|---|
| 權重文件 | 96 個 safetensors 分片,合計 1.56 TB | 與 Kimi K3 體量相同,下載和存儲都要單獨規劃 |
| 總參數 / 激活參數 | 2.8 萬億 / 每 token 1,040 億 | MoE 結構,單次計算量遠小於總參數量,但全部權重都要加載 |
| 權重與激活精度 | MXFP4 權重,MXFP8 激活 | 推理框架和硬件需要支持這兩種格式 |
| 上下文長度 | 1,048,576 tokens | 長上下文會顯著增加 KV Cache 佔用 |
| 注意力結構 | 69 層 KDA + 24 層 Gated DSA | 新增的稀疏注意力層需要框架適配 |
| 輸入模態 | 文本 + 圖像 | 多模態預處理鏈路也要部署 |
| 推薦推理框架 | vLLM、SGLang、TokenSpeed | 優先選用模型卡推薦的框架 |
MXFP4 量化感知訓練對部署精度的含義
這一點最容易被誤讀。按模型卡說明,Kimi K3.1 Pro 在訓練階段就以 MXFP4 權重、MXFP8 激活的方式進行,也就是量化感知訓練。因此 1.56 TB 的文件不是訓練完成後再壓縮出來的“縮水版”,而是 Moonshot 自己對外提供服務時使用的精度。
這會帶來三個實際影響:
- 自部署精度與官方服務一致:只要框架正確支持這些格式,理論上不存在“自部署版比官方 API 更差”的量化損失問題。
- 不建議反量化到更高精度:把權重轉換成 BF16 之類的格式,不會恢復額外能力,反而會讓顯存需求成倍增加。
- 硬件與框架兼容性是關鍵:MXFP4/MXFP8 需要推理框架和加速卡的支持,選型時要確認框架版本是否已適配這個模型。
Kimi K3.1 Pro 硬件規模的初步推算
公開資料沒有給出官方的硬件配置建議和成本數據,下面只是基於文件體量做的推算。僅加載權重就需要超過 1.56 TB 的聚合顯存,再加上 KV Cache、激活值和框架開銷,實際需求會更高。如果要用滿百萬 token 上下文,需求還會繼續增加。這意味着單機單卡方案基本不可行,團隊需要具備多卡甚至多機張量並行或專家並行的部署經驗。具體卡型、卡數和成本,建議參考推理框架的官方部署文檔,並以小規模壓測結果爲準。
另外,Moonshot 同期發佈了號稱速度快 2 到 3 倍的 Kimi K3.1 Pro Highspeed,但目前不清楚它是否是獨立的 checkpoint,Hugging Face 上也沒有對應倉庫。期待用開放權重複現 Highspeed 速度的團隊,需要等待官方進一步說明。
Kimi K3.1 Pro 快速上手路徑
由於權重體量較大,建議按“先驗證能力、再決定是否自部署”的順序推進,避免在硬件採購上過早投入。
第一步:用 API 驗證 Kimi K3.1 Pro 能力
在投入 1.56 TB 級別的部署資源之前,先用 API 跑通自己的業務樣本,是成本最低的驗證方式。具體可以這樣做:
- 準備 50 到 200 條真實業務樣本,覆蓋長文檔、圖文混合和代碼等典型輸入。
- 通過 OpenAI 兼容接口調用模型,把
model參數設爲平臺提供的 Kimi K3.1 Pro 模型名,記錄輸出質量和延遲。 - 同時用 1 到 2 個備選模型跑同一批樣本,形成橫向對比數據。
🚀 快速開始:API易 apiyi.com 提供兼容 OpenAI 與 Anthropic 兩種接口格式的統一調用,現有 SDK 只需替換
base_url和 API Key 即可接入。Kimi K3.1 Pro 是否已上線、對應的模型名,請以價格頁 https://docs.apiyi.com/models 的列表爲準,接入參數見文檔中心 docs.apiyi.com。
第二步:Kimi K3.1 Pro 自部署前的檢查清單
能力驗證通過、確實有自部署需求後,再按以下清單逐項確認:
- 合規確認:對照上文的場景表,確認業務屬於內部使用還是對外服務,並讓法務審閱 LICENSE 原文。
- 存儲與下載:準備至少 1.56 TB 的高速存儲,規劃 96 個分片的下載與完整性校驗。
- 框架選型:在 vLLM、SGLang、TokenSpeed 中選擇一個,確認當前版本已支持 Gated DSA 層和 MXFP4/MXFP8 格式。
- 上下文規劃:根據業務實際需要設置最大上下文,不必默認開到百萬 token,以節省 KV Cache。
- 壓測與迴歸:用第一步積累的樣本做對照測試,確認自部署輸出與 API 結果一致。
Kimi K3.1 Pro 自部署對比 API 調用
| 維度 | 自部署開放權重 | 通過 API 調用 |
|---|---|---|
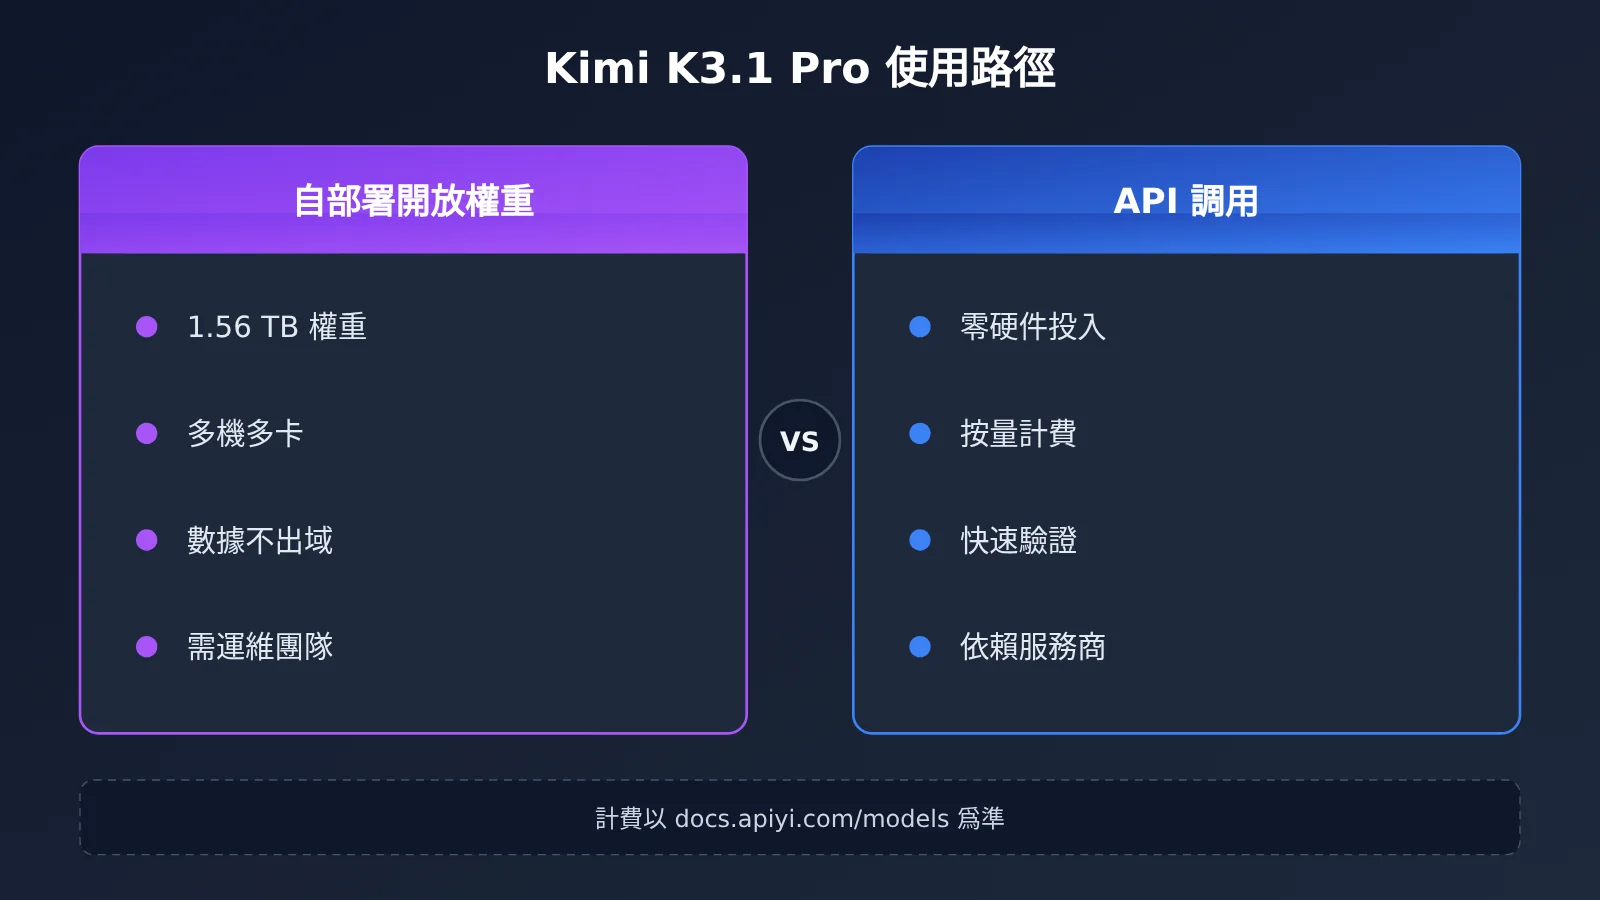
| 前期投入 | 高,需要多機多卡和存儲 | 低,按調用量付費 |
| 數據控制 | 數據完全留在內網 | 數據需要發送給服務商 |
| 許可證影響 | 內部使用不受兩個條件約束 | 由服務商承擔對外服務的合規義務 |
| 上線速度 | 需要數週的部署與調優 | 當天即可接入 |
| 運維要求 | 需要專職推理運維 | 基本無運維 |
| 適合階段 | 規模化、強合規場景 | 能力驗證、中小規模業務 |
| 可用渠道 | Hugging Face moonshotai/Kimi-K3.1-Pro |
Moonshot 官方 API;API易 apiyi.com(是否上線以模型列表爲準) |
💰 成本說明:API 調用的輸入輸出單價、緩存價格等計費口徑,請以 API易 價格頁 https://docs.apiyi.com/models 的實時數據爲準,本文不提供未經覈實的價格數字。Moonshot 官方 API 價格也請以其官方公佈爲準。
如何解讀 Kimi K3.1 Pro 的排名數據
公開報道稱 Kimi K3.1 Pro 目前是“排名最高的開放權重模型”。這個說法有明確的統計口徑,評估時應把它當作參考信號,而不是能力結論。
| 指標 | 數值 | 統計口徑 |
|---|---|---|
| ArtificialWatch Bench Index | 69.9,在 44 個模型中排第 11 | 在所有給它打分的公開榜單上取百分位,再取中位數,開源和閉源模型混排 |
| 開放權重模型中的位置 | 第 1 | 小幅領先 DeepSeek V4.1 Flash(68) |
| Coding Index | 45.1,在 45 個模型中排第 21 | 編程類榜單,排在另外 4 個開放模型之後 |
需要注意三點。第一,中位百分位反映的是模型在多個榜單上的“相對位置”,並不對應某項具體任務的絕對能力。第二,69.9 和 68 的差距很小,不足以說明兩者在你的業務上有明顯差別。第三,Kimi K3.1 Pro 的綜合排名很靠前,但編程指數相對靠後,以代碼生成爲主的團隊應該重點做專項評測。
常見問題 FAQ
Q1:Kimi K3.1 Pro 開放權重是否可以免費商用?
大部分情況下可以。使用、修改、微調和再分發都免費,只有兩類情況需要額外處理:對外售賣模型訪問、且任意 12 個月收入超過 2,000 萬美元的公司需要另籤協議;月活超過 1 億或月收入超過 2,000 萬美元的產品需要顯著署名。
Q2:Kimi K3.1 Pro 許可證和 Kimi K3 有什麼區別?
根據 ArtificialWatch 對兩份文件的逐字比對,兩份許可證內容完全相同,只是名稱改了。已經完成 K3 合規評估的團隊,結論可以直接沿用,但仍建議法務快速複覈一遍。
Q3:企業內部部署 Kimi K3.1 Pro 會觸發許可證限制嗎?
不會。資料明確說明,兩個商業條件都不適用於內部使用。內部知識庫、研發助手、數據分析等場景,可以直接使用和微調。
Q4:Kimi K3.1 Pro 自部署需要什麼硬件?
官方沒有公佈具體配置和成本。僅權重就有 1.56 TB,加上 KV Cache 後需求更高,因此需要多卡乃至多機集羣,並且推理框架要支持 MXFP4/MXFP8 格式。建議先通過 API易 apiyi.com 等 API 渠道驗證業務效果,再決定是否投入硬件。
Q5:如何通過 API 快速調用 Kimi K3.1 Pro?
可以使用 Moonshot 官方 API,也可以使用聚合平臺。API易 兼容 OpenAI 與 Anthropic 接口格式,現有代碼改動很小。接入方式見 docs.apiyi.com,模型是否已上線以及計費標準,以 https://docs.apiyi.com/models 爲準。
Q6:Kimi K3.1 Pro Highspeed 版本能自部署嗎?
目前不確定。Moonshot 沒有說明 Highspeed 是否是獨立的 checkpoint,Hugging Face 上也沒有對應倉庫。現在能下載的只有標準版 `moonshotai/Kimi-K3.1-Pro`。
Q7:Kimi K3.1 Pro 有哪些已知限制?
主要有四點:自部署硬件門檻高,且沒有官方配置建議;“另籤協議”的條款內容沒有公開;編程指數排在另外 4 個開放模型之後;Highspeed 版本的可獲得性未知。如果業務涉及這些方面,需要預留評估時間。
Kimi K3.1 Pro 核心要點 Key Takeaways
- 按承諾日期開放:11 月 4 日權重公開,距 API 上線 12 天,倉庫不設申請門檻。
- 許可證寬鬆:使用、修改、微調、再分發都免費,內容與 K3 許可證逐字相同。
- 兩個條件對象不同:一個針對高收入的模型服務商,一個針對超大規模產品。
- 內部使用不受限:兩個商業條件都不適用於企業內部場景。
- 原生 MXFP4 精度:量化感知訓練,自部署精度與官方服務一致。
- 門檻在硬件:1.56 TB 權重需要多機多卡,官方未給出配置建議。
- 先驗證再部署:可先通過 API易 apiyi.com 用業務樣本驗證效果,降低前期投入風險。
總結
Kimi K3.1 Pro 開放權重的核心要點:
- 許可證判斷:先確認業務屬於內部使用、對外 API 還是大規模 C 端產品,再對照兩個商業條件。大多數企業的內部使用不受影響。
- 部署門檻:1.56 TB 的 MXFP4 權重是官方服務時的原生精度,難點在於多機多卡資源和框架適配。
- 排名口徑:Bench Index 的 69.9 是多個榜單中位百分位的彙總,只能作爲參考信號,編程場景需要單獨評測。
對多數團隊來說,更穩妥的做法是先用 API 跑通業務樣本,確認效果和調用量後,再評估是否值得投入自部署資源。推薦通過 API易 apiyi.com 用統一接口完成多模型對比驗證,計費以 https://docs.apiyi.com/models 爲準。
📚 參考資料
- ArtificialWatch – Kimi K3.1 Pro 開放權重發布報道:權重文件、許可證與排名分析
- 鏈接:
artificialwatch.com/wire/kimi-k3-1-pro-open-weights-out -
說明:包含分片數量、精度格式、許可證條件和 Bench Index 數據
-
ArtificialWatch – 開放權重承諾兌現統計:7 月以來各實驗室開放權重的時間線
- 鏈接:
artificialwatch.com/wire/open-weights-promises-five-for-five -
說明:可用於判斷廠商開放權重的節奏
-
Hugging Face – Kimi K3.1 Pro 模型倉庫:模型卡、LICENSE 原文與權重文件
- 鏈接:
huggingface.co/moonshotai/Kimi-K3.1-Pro - 說明:許可證條款以此處的 LICENSE 原文爲準
作者:APIYI 技術團隊
技術交流:歡迎通過 API易 官網 apiyi.com 聯繫我們,接入文檔見 docs.apiyi.com,模型與價格見 docs.apiyi.com/models