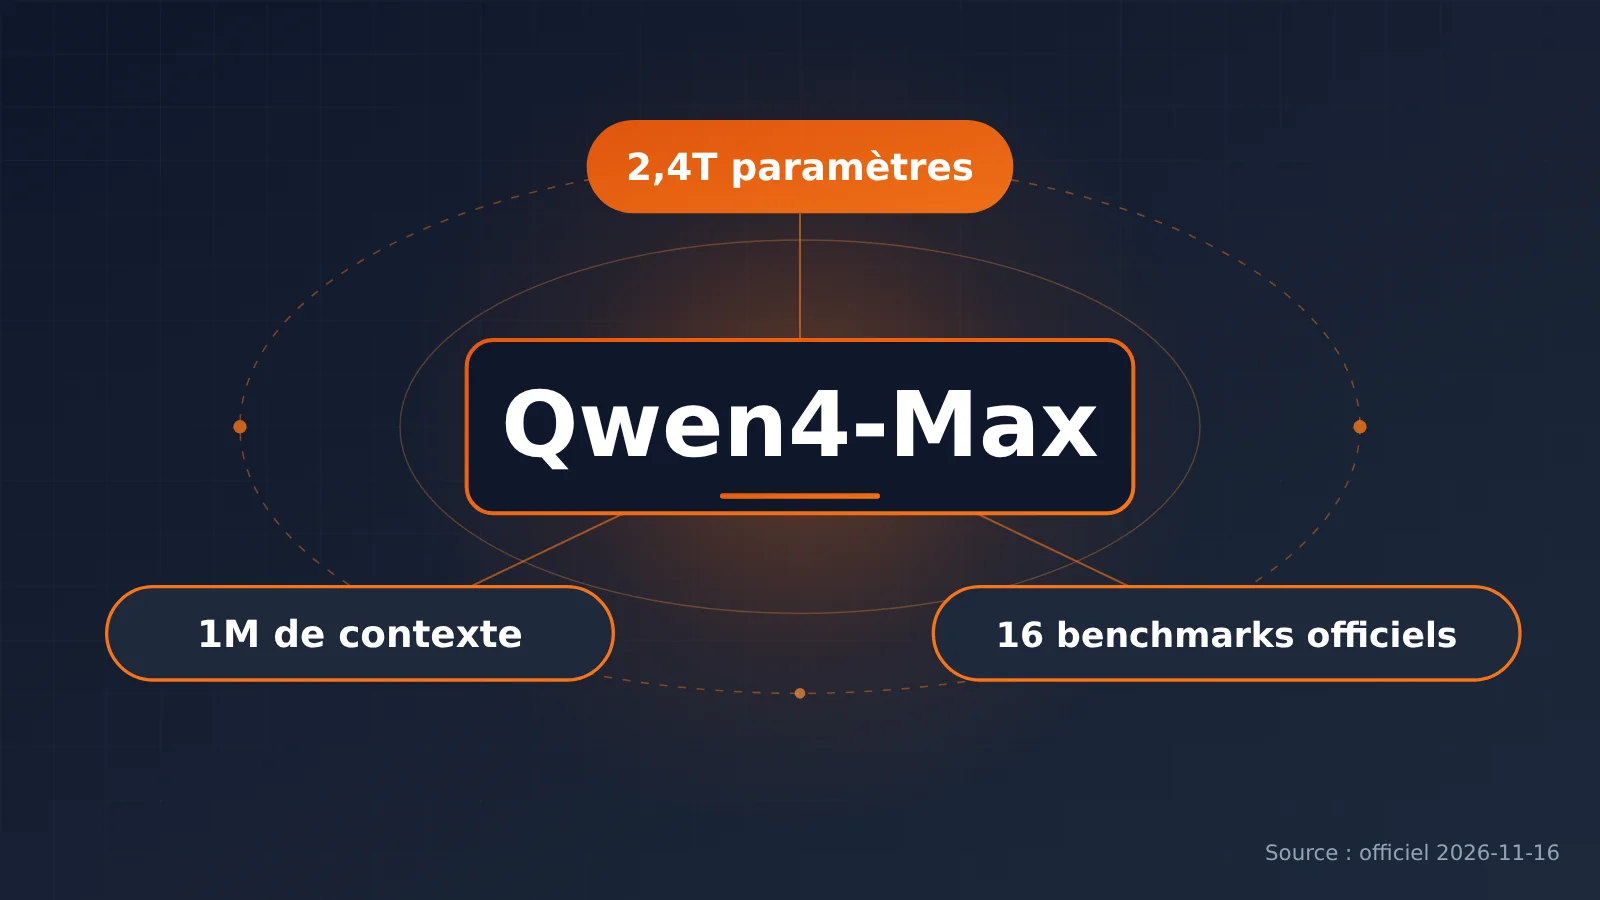
L’équipe Alibaba Tongyi a publié Qwen4-Max le 16 novembre 2026 au matin. 2,4 T de paramètres dans le modèle principal, 1 M de fenêtre de contexte, et un graphique comparatif de 16 benchmarks à l’appui.
Le verdict en une phrase : ce qui est vraiment en avance chez Qwen4-Max, c’est l’efficacité en tokens et la capacité à mener des tâches longues jusqu’au bout — pas le fait d’être premier partout. Sur les 16 scores que le constructeur publie lui-même, il décroche 4 premières places et 4 deuxièmes places ; sur la manipulation de terminal, la construction de programmes, la compréhension de graphiques et la compréhension vidéo, il reste nettement derrière les concurrents de tête figurant sur le même graphique.
Cet article ne s’appuie que sur trois sources : les documents officiels de lancement du 16 novembre 2026, un instantané du classement final public Code Arena WebDev d’arena.ai (14 novembre 2026), et deux tarifs affichés, l’un sur QwenCloud, l’autre sur la plateforme Qianwen AI. Les détails de paramètres non publiés et les résultats de reproduction par des tiers ne sont pas couverts ici. Si vous faites tourner Qwen3.8-Max ou un autre modèle phare en ce moment, vous saurez en fin de lecture, pour trois grandes catégories de tâches, s’il faut migrer ou non — et vous pourrez faire votre propre calcul avec le prix d’entrée, le prix de sortie et le prix du cache.
Aperçu des informations de lancement de Qwen4-Max
| Élément | Détails |
|---|---|
| Date de lancement | 2026-11-16 10:01 (UTC+8) |
| Émetteur | Équipe Alibaba Tongyi Qianwen (Qwen) |
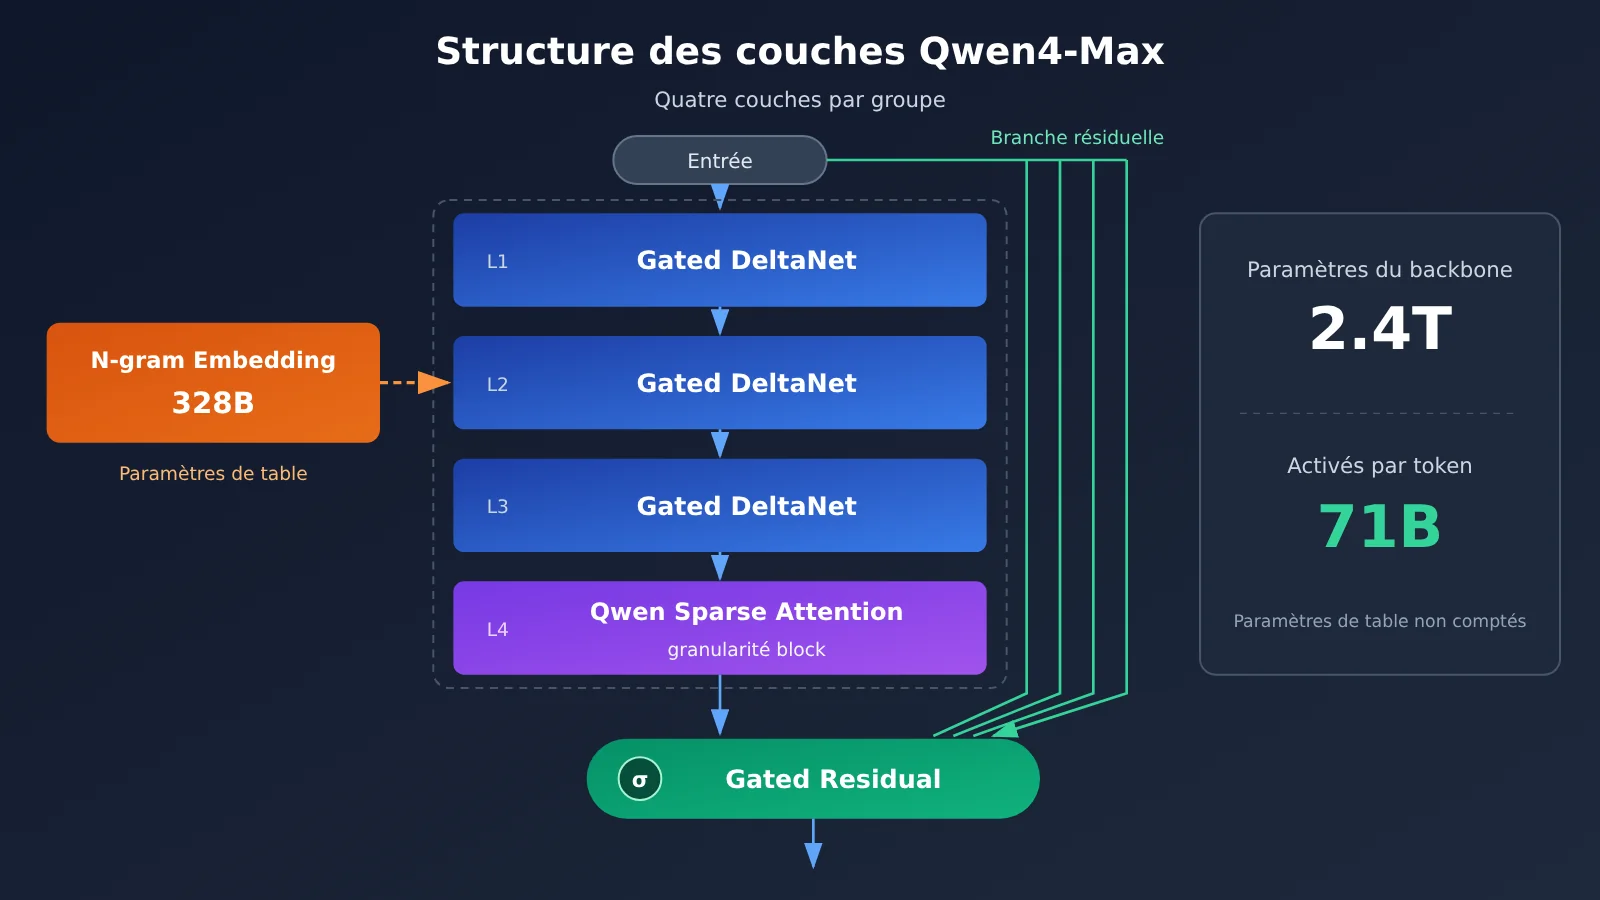
| Taille des paramètres | 2.4T de paramètres du réseau principal, 71B activés par token, plus 328B de paramètres N-gram Embedding |
| Contexte | 1M, vision native |
| Canaux officiels | QwenCloud API, Qwen Studio, QwenWork, Qoder, application Qwen |
| Programme open source | La société indique que les versions plus petites de Qwen4 publieront leurs poids en open source ; Max lui-même n’est pas annoncé comme open source |
À en juger par le rythme des sorties, il ne s’agit pas cette fois d’une simple mise à jour d’un modèle d’API. Qwen4-Max a aussi intégré deux produits maison, QwenWork (bureautique) et Qoder (programmation), et les supports officiels mettent l’accent sur les tâches longues d’agent et les livrables sectoriels, sans faire de la pure capacité de questions-réponses le point fort.
Trois modifications de l’architecture de Qwen4-Max
Le blog officiel liste trois changements structurels ; voici, un par un, les problèmes qu’ils résolvent :
- Attention hybride GDN + QSA : sur quatre couches, trois utilisent Gated DeltaNet et une utilise Qwen Sparse Attention, avec une sélection du contexte à granularité de bloc. L’objectif principal de cet agencement est de réduire le coût de calcul en contexte long de 1M.
- Gated Residual : le chemin résiduel est scindé en quatre branches parallèles, puis fusionné via un mécanisme de porte, afin d’améliorer la capacité d’expression des réseaux profonds.
- N-gram Embedding : une recherche dans une table au niveau de la deuxième couche, qui complète les motifs locaux de tokens. Les 328B de paramètres supplémentaires viennent d’ici ; ce sont des paramètres de table de recherche, qui ne participent pas au calcul d’activation par token.
À noter : 2.4T correspond au total des paramètres du réseau principal, et ce qui est réellement activé par token est 71B. Pour comparer sa « taille de paramètres » avec d’autres modèles, il faut d’abord vérifier que les deux parties utilisent la même convention.
Spécifications et protocoles de Qwen4-Max
| Spécification | Qwen4-Max |
|---|---|
| Fenêtre de contexte | 1M |
| Entrée maximale | 991K (983K en mode réflexion) |
| Sortie maximale | 393K |
| Chaîne de pensée maximale | 262K |
| TPM | 5 millions |
| Protocoles compatibles | OpenAI Chat Completions, Responses, Anthropic Messages, DashScope |
reasoning_effort par défaut |
high (xhigh par défaut pour Qwen3.8-Max) |
La dernière ligne est facile à négliger. Le niveau de raisonnement par défaut de Qwen4-Max est high, soit un cran en dessous du xhigh par défaut de la génération précédente. Si vous comparez directement l’ancienne et la nouvelle génération avec les paramètres par défaut, l’économie de tokens observée provient en partie de la différence de niveau, et pas entièrement du modèle lui-même. Pour un test A/B, il est conseillé de fixer explicitement reasoning_effort à la même valeur.
Les 16 scores officiels de Qwen4-Max : points forts et points faibles
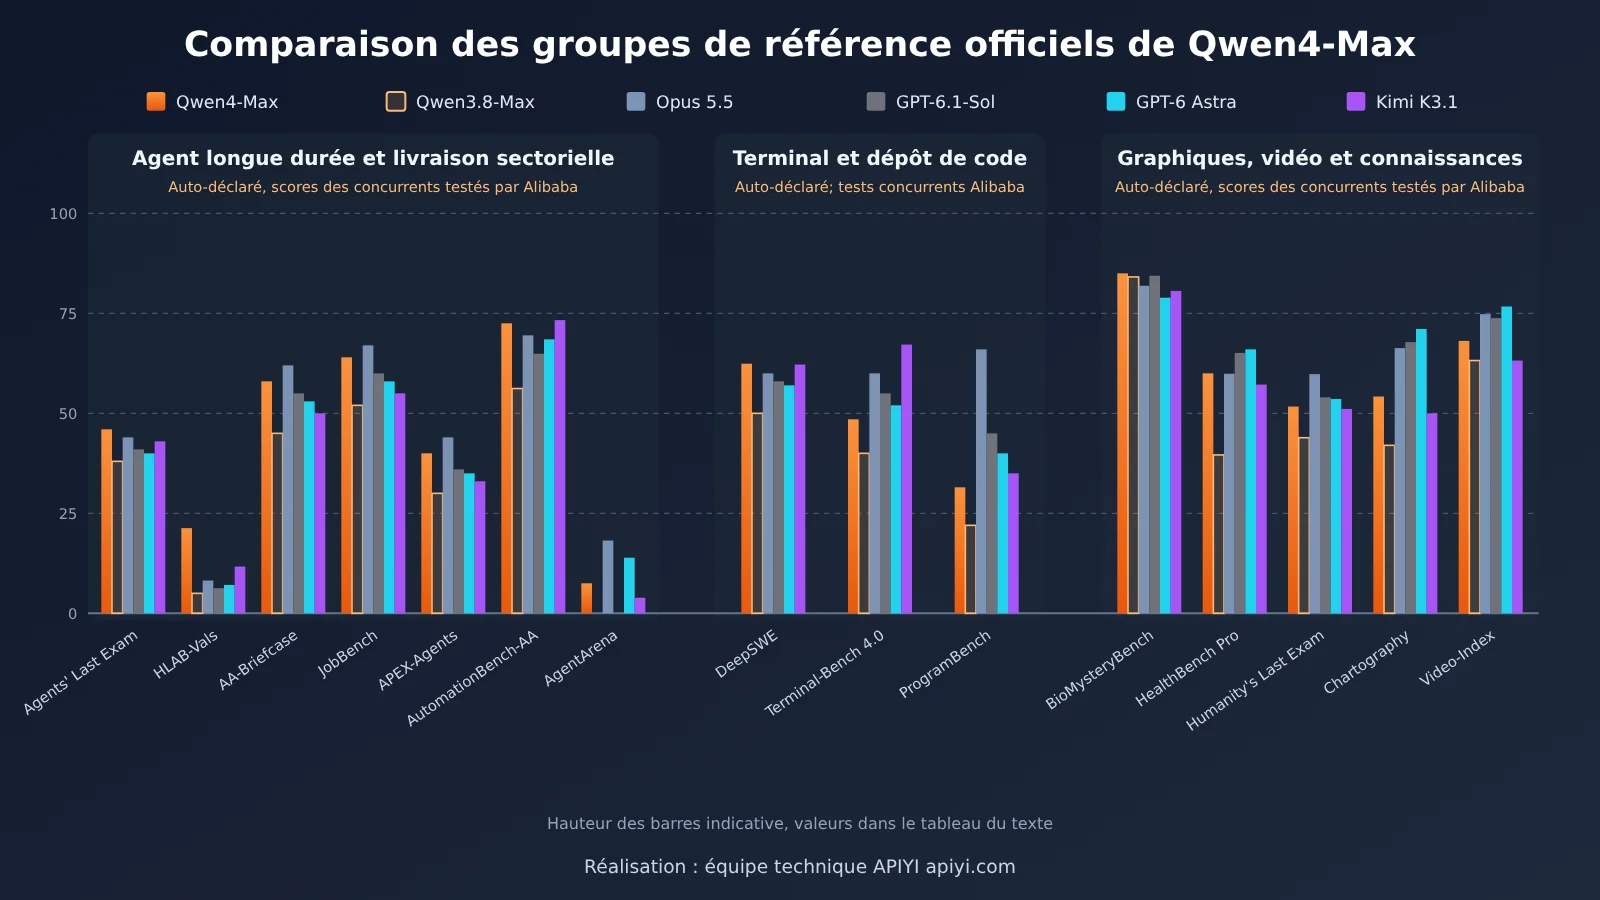
Tous les scores du tableau ci-dessous proviennent de la même infographie publiée officiellement : ce sont des chiffres auto-déclarés par Alibaba. Les scores des concurrents dans cette infographie ont eux aussi été mesurés par Alibaba ; ils ne doivent pas être assimilés aux résultats officiels publiés par Anthropic, OpenAI ou Moonshot AI. Parmi ces benchmarks, CodeArena et AgentArena sont repris de LM Arena, AA-Briefcase et AutomationBench-AA d’Artificial Analysis, APEX-Agents du classement Mercor, tandis que JobBench a été testé par Alibaba avec un jeu de données et un code d’évaluation actualisés.
| Benchmark | Qwen4-Max | Qwen3.8-Max-0902 | Opus 5.5 | GPT-6.1-Sol | GPT-6 Astra | Kimi K3.1 |
|---|---|---|---|---|---|---|
| DeepSWE v1.1 | 75.7 | 69.3 | 74.2 | 75.2 | 74.1 | 75.5 |
| CodeArena WebDev (Elo) | 1750 | 1676 | 1816 | 1742 | 1763 | 1686 |
| Terminal-Bench 4.0 | 48.5 | 38.9 | 59.6 | 56.1 | 59.1 | 67.2 |
| ProgramBench | 31.5 | 28.0 | 65.0 | 52.5 | 55.0 | 25.0 |
| AA-Briefcase v1.1 (Elo) | 1686 | 1605 | 1801 | 1555 | 1569 | 1674 |
| Agents’ Last Exam v1.1 | 46.7 | 27.9 | 43.4 | 42.6 | 43.4 | Non indiqué |
| JobBench | 68.5 | 65.3 | 75.4 | 66.2 | 66.1 | 61.2 |
| APEX-Agents v1.1 | 72.1 | 63.3 | 73.5 | 60.0 | 64.7 | 65.5 |
| HLAB-Vals-1.1 | 21.3 | 15.4 | 9.2 | 6.3 | 7.1 | 11.7 |
| AutomationBench-AA | 72.5 | 56.2 | 69.5 | 64.9 | 68.5 | 73.3 |
| AgentArena (Net Improvement) | 7.5 | — | 18.2 | — | 13.9 | 3.9 |
| BioMysteryBench | 85.0 | 84.1 | 81.9 | 84.4 | 78.9 | 80.6 |
| HealthBench Professional | 60.0 | 39.6 | 59.9 | 65.1 | 66.0 | 57.2 |
| Humanity’s Last Exam | 51.7 | 43.9 | 59.8 | 54.0 | 53.6 | 51.1 |
| Chartography | 54.2 | 42.0 | 66.3 | 67.8 | 71.1 | 50.0 |
| Video-Index | 68.1 | 63.2 | 74.8 | 73.8 | 76.7 | 63.2 |
Les domaines où Qwen4-Max se démarque
Qwen4-Max arrive en tête sur quatre benchmarks : DeepSWE, Agents’ Last Exam, HLAB-Vals et BioMysteryBench. C’est sur HLAB-Vals que l’écart est le plus marqué : 21,3 points, soit environ le double du deuxième, Kimi K3.1. Sur DeepSWE, l’avance n’est que de 0,2 point face à Kimi — autant dire qu’on peut considérer les deux modèles à égalité.
Il se classe deuxième sur quatre autres : AA-Briefcase, JobBench, APEX-Agents et AutomationBench-AA. Les trois premiers sont dominés par Opus 5.5, le dernier par Kimi K3.1. Ces benchmarks portent tous sur les agents de longue durée et la production de livrables de type « travail de bureau », ce qui correspond précisément à l’angle mis en avant par l’éditeur cette fois-ci.
Les domaines où Qwen4-Max est à la traîne
Le terminal et la compilation de programmes constituent clairement le point faible de cette version. Avec 48,5 points sur Terminal-Bench 4.0, le modèle n’arrive que cinquième sur six, soit 18,7 points de moins que Kimi, premier du classement. Sur ProgramBench, ses 31,5 points représentent moins de la moitié de ce qu’obtient Opus 5.5. Si votre agent passe surtout son temps dans un shell à compiler, déboguer et déployer, ces deux benchmarks sont plus pertinents que DeepSWE.
La compréhension de graphiques et de vidéos est également en retrait. Chartography et Video-Index le placent tous deux quatrième, avec respectivement 16,9 et 8,6 points de retard sur GPT-6 Astra, premier. Humanity’s Last Exam le classe aussi quatrième. Autrement dit, le « vision native » signifie que la capacité est bien là, mais pas qu’elle est de niveau supérieur.
La position de Qwen4-Max dans le classement public de Code Arena
Le snapshot final du classement public (2026-11-14) de arena.ai Code Arena WebDev totalise 1 007 405 votes et 159 modèles. Qwen4-Max (xHigh) se place 6e avec 1750 points, marqué Preliminary, avec seulement 1 814 votes ; la page affiche un coût par tâche P50 de 4,18 $. Devant lui, dans l’ordre : Claude Fable 5.2, Claude Opus 5.5, Claude Sonnet 5.5, Gemini 4 Carbon (Preliminary) et GPT-6 Astra.
La génération précédente, Qwen3.8-Max (0902), était à 1676 points et 16e sur le même classement : cette génération gagne donc 74 points et 10 places. Cela dit, Qwen4-Max n’a encore que peu de votes, son rang pourrait donc encore évoluer.
D’où viennent l’efficacité en tokens de Qwen4-Max et la « baisse de coût de 60 % »
Les chiffres officiels d’efficacité proviennent de leur propre benchmark Work360. Ce benchmark compte 26 domaines de premier niveau, 182 de deuxième niveau et 721 de troisième niveau ; Qwen4-Max y obtient 52,69, contre 47,74 pour Qwen3.8-Max. Côté consommation de tokens, le palier Xhigh de Work360 économise environ 24 % et le palier High environ 35 % ; sur Terminal-Bench 4.0, les deux paliers économisent respectivement environ 48 % et 49 %.
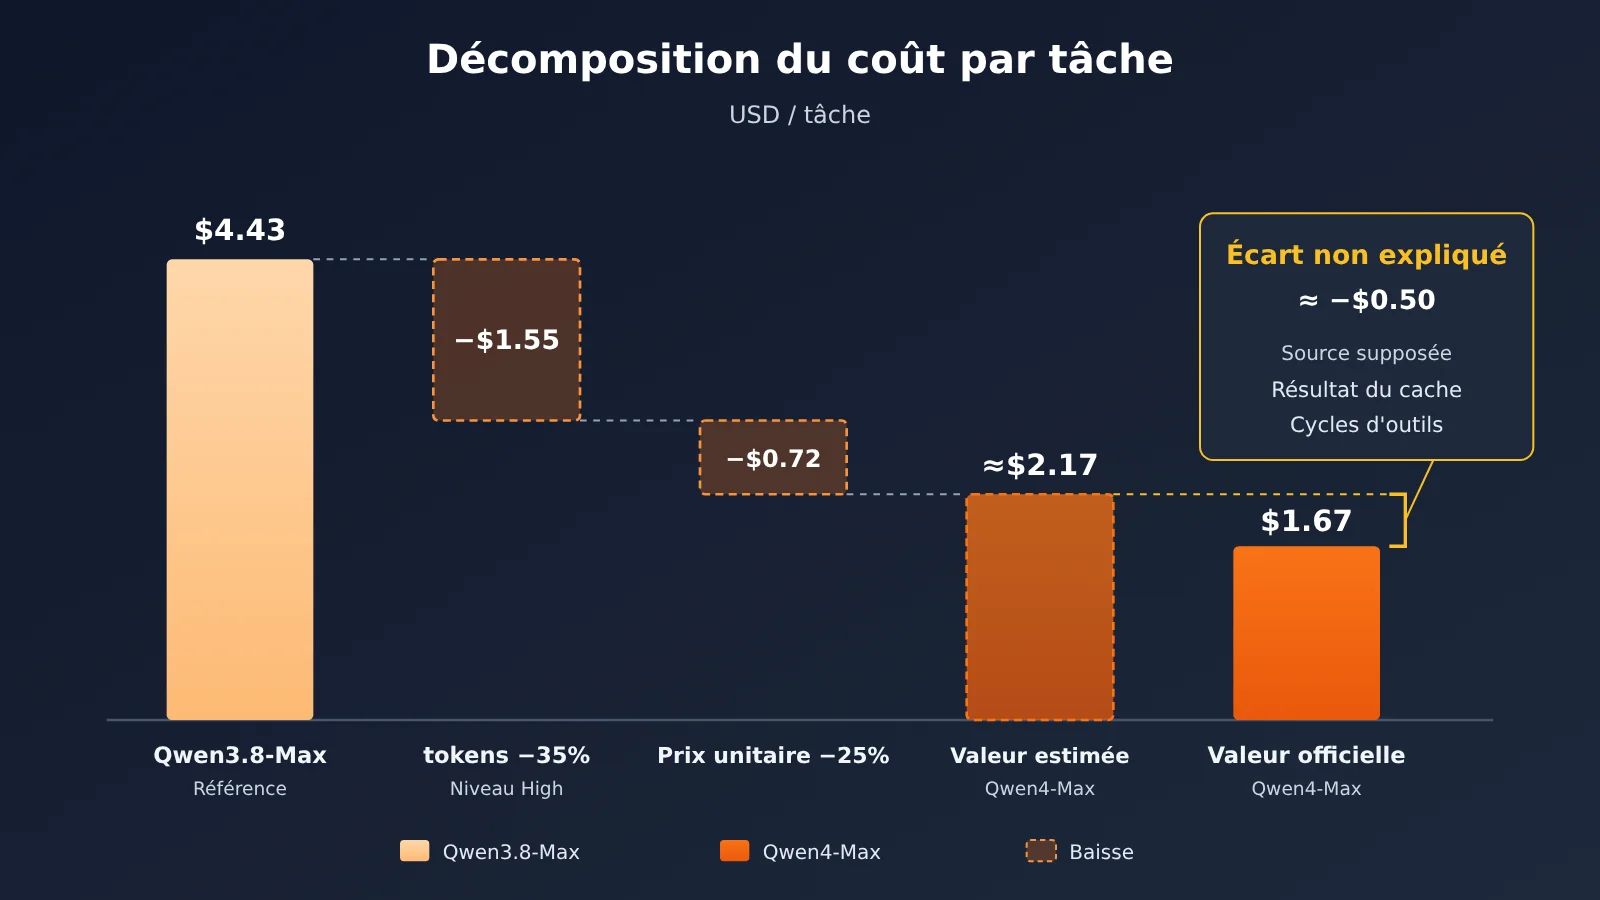
Pour le coût moyen par tâche, les chiffres officiels passent de 4,43 $ à 1,67 $ — le blog chinois annonce 26,58 ¥ → 11,16 ¥, soit −58 %. En raisonnant en dollars, la baisse est d’environ 62 %. Mais si l’on se contente de « 35 % de tokens en moins × 25 % de baisse du prix unitaire », on obtient 0,65 × 0,75 ≈ 0,49, soit environ −51 %. Cet écart intermédiaire n’est pas expliqué par la source ; les pistes les plus plausibles sont un meilleur taux de succès du cache et moins de tours d’appel d’outils, mais ce n’est qu’une hypothèse, pas une cause confirmée.
Côté sécurité, le taux de « double réussite fonction + vulnérabilité » au niveau fonction du Last Secure Code Bench passe de 22,0 % à 31,8 %. La proportion de code sûr généré aux trois granularités — fonction, fichier, dépôt — passe de 8 % à 14,7 %. En valeur absolue, cela reste faible : le code produit demande toujours une relecture humaine.
Comment se calcule le prix de Qwen4-Max
Voici les prix officiels de Qwen4-Max, ainsi que les prix officiels du modèle de la génération précédente et les prix actuels sur APIYI. Tous les montants sont en USD / 1M tokens, avec un relevé effectué le 2026-11-16.
| Élément facturé | Qwen4-Max (officiel QwenCloud) | Qwen3.8-Max (officiel) | qwen3.8-max (prix actuel APIYI apiyi.com) |
|---|---|---|---|
| Entrée | $1.5 | $2 | $1.65 |
| Sortie | $4.5 | $6 | $4.95 |
| Lecture du cache / succès de cache | $0.075 | $0.25 | $0.20625 |
| Création de cache explicite 5 minutes | $1.875 | — | — |
| Création de cache explicite 1 heure | $3 | — | — |
Les prix en RMB sont ceux pratiqués sur la plateforme Qwen AI ; l’unité est RMB / 1M tokens, avec un relevé au 2026-11-16 :
- Entrée ¥10, sortie ¥30, succès de cache ¥0.5
- Création de cache explicite 5 minutes ¥12.5, création de cache explicite 1 heure ¥20
Par rapport aux prix officiels de la génération précédente, les prix d’entrée et de sortie de Qwen4-Max sont chacun 25 % moins élevés, et le prix de lecture du cache baisse de 70 %. C’est la lecture du cache qui enregistre la plus forte baisse, ce qui a un impact notable sur les agents de longue durée : dans les tâches multi-tours, une grande quantité d’invites système et d’historique de contexte répétés est facturée au tarif du cache.
Pour estimer vous-même le coût, vous pouvez décomposer le calcul avec cette formule : entrée non mise en cache × prix d’entrée + succès de cache × prix du cache + volume de création de cache explicite × prix de création + sortie (y compris la chaîne de raisonnement) × prix de sortie. Prenons un exemple fictif : une tâche a 1M de tokens d’entrée, dont 600 000 en succès de cache, et 100 000 tokens de sortie. Avec les prix officiels de Qwen4-Max, on obtient environ $0.6 + $0.045 + $0.45 ≈ $1.10 ; pour le même volume de tokens, avec les prix officiels de Qwen3.8-Max, on obtient environ $1.55. L’écart réel dépend aussi de l’évolution de la consommation de tokens, donc la méthode la plus fiable reste de rejouer vos propres journaux réels.
💰 Conseil budget : APIYI ne propose pas encore qwen4-max ; nous mettrons ce modèle en ligne dès que possible. Le nom exact du modèle et son prix seront ceux indiqués dans la liste des modèles sur apiyi.com. Avant sa mise en ligne, vous pouvez utiliser
qwen3.8-maxsur la plateforme pour établir une base de coûts, puis comparer directement les deux factures une fois le nouveau modèle disponible.
Comment décider, selon le cas d’usage, s’il faut passer à Qwen4-Max
| Scénario | Performances de Qwen4-Max (auto-déclarées) | Recommandation |
|---|---|---|
| Agents longue durée et livrables sectoriels (automatisation de bureau, recherche, documents à livrer) | 1er sur HLAB-Vals et Agents’ Last Exam ; 2e sur APEX, JobBench et AA-Briefcase ; nettement plus économe en tokens | À évaluer en priorité : c’est là que le gain d’une migration depuis Qwen3.8-Max est le plus évident |
| Terminal et dépôts de code (agent shell, build, modifications multi-dépôts) | 1er sur DeepSWE, mais avec une avance très faible ; 5e sur Terminal-Bench, 4e sur ProgramBench | Pour les tâches centrées sur le terminal, comparez d’abord avec Kimi K3.1 et Opus 5.5 avant de trancher |
| WebDev front-end | 6e du classement public Code Arena, 1750 points (Preliminary) | Peut servir d’option rapport qualité-prix, mais ce n’est pas le leader |
| Compréhension de graphiques et de vidéos, documents longs multimodaux | 4e sur Chartography et sur Video-Index | Pour les workflows qui lisent beaucoup d’images et de vidéos, mieux vaut ne pas compter uniquement dessus pour l’instant |
| Questions-réponses en biologie et santé | 1er sur BioMysteryBench ; 3e sur HealthBench Professional | À intégrer aux tests, mais avec une relecture par un expert du domaine |
Une approche assez sûre consiste à répartir les charges : confier à Qwen4-Max les tâches d’agents longue durée et de livraison de documents, et laisser les tâches lourdes sur terminal ainsi que les tâches graphiques et vidéo aux modèles qui y sont actuellement les meilleurs. On évite ainsi de migrer tout le trafic d’un coup, tout en récupérant dès maintenant les économies de tokens.
🎯 Conseil de sélection : la condition de cette répartition, c’est de pouvoir changer de modèle avec le même code. APIYI apiyi.com propose une interface compatible OpenAI : une seule clé API suffit pour appeler plusieurs modèles phares, il suffit de modifier le champ
modelpour lancer des tests A/B.
Prise en main rapide de Qwen4-Max
Le canal officiel est l’API QwenCloud, qui prend en charge quatre protocoles : OpenAI Chat Completions, Responses, Anthropic Messages et DashScope. Les SDK OpenAI ou Anthropic existants peuvent être utilisés directement. Lors de l’intégration, gardez ces quelques points en tête :
- Vérifiez le modèle : l’ID officiel du modèle s’écrit
qwen4-max; référez-vous à la page du modèle. La valeur par défaut dereasoning_effortesthigh. Lors des tests comparatifs, spécifiez explicitement le même niveau, par exemplexhigh. - Prévoyez assez d’espace de sortie : la sortie maximale est de 393K et la chaîne de raisonnement maximale de 262K. Pour les tâches longues, réglez
max_tokensou le paramètre correspondant suffisamment haut, sinon la chaîne de raisonnement consommera tout le quota de sortie. - Activez le cache : le prix d’un hit sur le cache implicite est de $0.075. Si l’invite système est longue et amenée à être réutilisée, évaluez s’il vaut la peine d’utiliser un cache explicite de 5 minutes ou 1 heure ; la création du cache est facturée séparément et, s’il n’est réutilisé que trop peu de fois, elle peut ne pas être rentable.
- Préparez un groupe de contrôle : après vous être inscrit sur APIYI, récupérez une clé API, définissez
base_urlsurhttps://api.apiyi.com/v1et renseignezmodelavecqwen3.8-max. Exécutez le même lot de tâches avec l’ancien modèle pour obtenir sa consommation de tokens et ses scores comme base de référence. - Basculez une fois le nouveau modèle disponible : lorsque qwen4-max sera disponible sur APIYI, il suffira de modifier le champ
model, le reste du code restant inchangé, pour obtenir directement les données comparatives entre les deux générations.
🚀 Démarrage rapide : les nouveaux utilisateurs qui s’inscrivent sur APIYI apiyi.com reçoivent un crédit de test gratuit, suffisant pour établir d’abord la référence avec
qwen3.8-max; le passage ultérieur à un autre modèle ne nécessite pas de nouvelle intégration.
FAQ — Questions fréquentes sur Qwen4-Max
Q1 : Qu’est-ce que Qwen4-Max ?
Qwen4-Max est le modèle phare de Tongyi Qianwen, publié le 16 novembre 2026. Il repose sur un socle de 2,4 T de paramètres, avec 71 B activés par token, prend nativement en charge les entrées visuelles, dispose d’une fenêtre de contexte de 1 M et s’adresse principalement aux agents longue durée et aux tâches de livraison métier.
Q2 : Quelles sont les différences entre Qwen4-Max et Qwen3.8-Max ?
Sur les 16 benchmarks auto-déclarés par l’éditeur, Qwen4-Max devance Qwen3.8-Max-0902 sur chacun d’entre eux. Sur le classement public Code Arena, il fait 74 points de plus. Côté tarifs officiels, l’entrée et la sortie sont chacune 25 % moins chères, et la lecture de cache 70 % moins chère. Autre différence : leur niveau d’inférence par défaut n’est pas le même, `high` pour l’un et `xhigh` pour l’autre.
Q3 : Ces 16 benchmarks sont-ils fiables ?
Tous ces scores sont auto-déclarés par l’éditeur, et les scores des concurrents ont eux aussi été mesurés par Alibaba ; à ce jour, aucune reproduction par un tiers n’a été publiée. Le seul signal externe mobilisable est le classement public Code Arena WebDev : dans l’instantané du classement final du 14 novembre 2026, Qwen4-Max occupe la 6e place, mais son statut reste « Preliminary », avec peu de votes.
Q4 : La « baisse de coûts de 60 % » s’applique-t-elle directement à mon activité ?
Non, pas directement. Ce chiffre provient du scénario officiel Work360, et la baisse est supérieure à ce que donnerait un simple calcul sur les tokens et le prix unitaire ; l’écart n’a pas été expliqué par l’éditeur. Votre gain réel dépend du taux de réussite du cache, du nombre de tours d’appel d’outils et du niveau d’inférence : il faut le mesurer sur vos propres journaux de tâches.
Q5 : Peut-on appeler Qwen4-Max via APIYI ?
Au 16 novembre 2026 à 11h00, `qwen4-max` ne figure pas encore dans la liste des modèles d’APIYI ; nous le mettrons en ligne dès que possible. Le modèle phare Qwen actuellement en vente est `qwen3.8-max`, au tarif de 1,65 $ en entrée, 4,95 $ en sortie et 0,20625 $ en lecture de cache (unité : 1 M de tokens). La disponibilité et les prix font foi selon la liste des modèles publiée sur apiyi.com.
Q6 : Quels sont les points faibles de Qwen4-Max ?
L’utilisation du terminal (5e sur Terminal-Bench), la construction de programmes (4e sur ProgramBench), la compréhension des graphiques et des vidéos (4e dans les deux cas) ainsi que HLE (4e) restent derrière les meilleurs concurrents du même comparatif. Le taux de double réussite sur le code sécurisé progresse, mais n’atteint que 31,8 %. Enfin, aucune ouverture des poids n’est prévue pour la taille Max.
Bilan : faut-il passer à Qwen4-Max ?
- Positionnement : un modèle phare avec un backbone de 2,4 T, 71 B de paramètres activés par token et une fenêtre de contexte de 1 M, pensé pour les agents longue durée et la livraison métier.
- Les points forts : sur les 16 benchmarks auto-déclarés par l’éditeur, il décroche 4 premières places et 4 deuxièmes, essentiellement sur les catégories agent et production de livrables de type travail de bureau.
- Les points faibles : opérations en terminal, construction de programmes, graphiques, vidéo et HLE le placent en quatrième ou cinquième position. Impossible de couvrir toutes les tâches avec un seul modèle.
- Place dans les classements publics : snapshot du classement final Code Arena WebDev (2026-11-14), 6ᵉ avec 1 750 points, encore au statut Preliminary.
- Coût : le prix unitaire officiel baisse de 25 %, la lecture du cache de 70 %, et la consommation de tokens diminue elle aussi nettement. La « baisse de 60 % » reste à vérifier avec vos propres données.
Si votre charge de travail dominante est faite d’agents longue durée et de livraison de documents, Qwen4-Max mérite une évaluation prioritaire. En revanche, pour des tâches très consommatrices de terminal ou de la compréhension de graphiques et de vidéos, mieux vaut continuer à répartir vers les modèles actuellement plus performants. Avant la mise en ligne de qwen4-max, vous pouvez passer par l’interface compatible OpenAI d’APIYI apiyi.com et utiliser qwen3.8-max pour établir une base de référence en coût et en qualité : une fois le nouveau modèle disponible, il suffit de modifier un champ pour lancer la comparaison.
📚 Ressources
- Publication officielle de Qwen sur X : annonce du lancement de Qwen4-Max
- Lien :
x.com/Alibaba_Qwen/status/2122148127520289151 -
Description : date de sortie et canaux officiels disponibles
-
Blog officiel de Qwen (en chinois) : architecture, spécifications, 16 benchmarks et chiffres d’efficacité
- Lien :
qwen.ai/blog?id=qwen4-max -
Description : l’architecture, les spécifications et les données de benchmark de cet article proviennent de ce billet
-
Page modèle QwenCloud : tarifs affichés en dollars
- Lien :
qwencloud.com/models/qwen4-max -
Description : prix d’entrée, de sortie et de cache en USD / 1M tokens
-
Page modèle de la plateforme Qianwen AI : tarifs affichés en yuans
- Lien :
qianwenai.com/models/qwen4-max -
Description : prix en RMB / 1M tokens
-
arena.ai Code Arena WebDev : classement public
- Lien :
arena.ai - Description : cet article cite un instantané du classement final du 2026-11-14
Auteur : équipe technique APIYI
Échanges techniques : si vous souhaitez connaître l’avancement de la mise en ligne des modèles et les modalités d’accès, vous pouvez nous contacter depuis la page d’accueil du site APIYI ; la documentation est disponible sur docs.apiyi.com