Claude Fable 5.2 est sorti le 9 novembre 2026. Son tarif API standard est inférieur de 20 % à celui de la version 5.1.
Beaucoup d’équipes se posent alors la question : puisque le modèle coûte moins cher, peut-on directement passer au niveau max ?
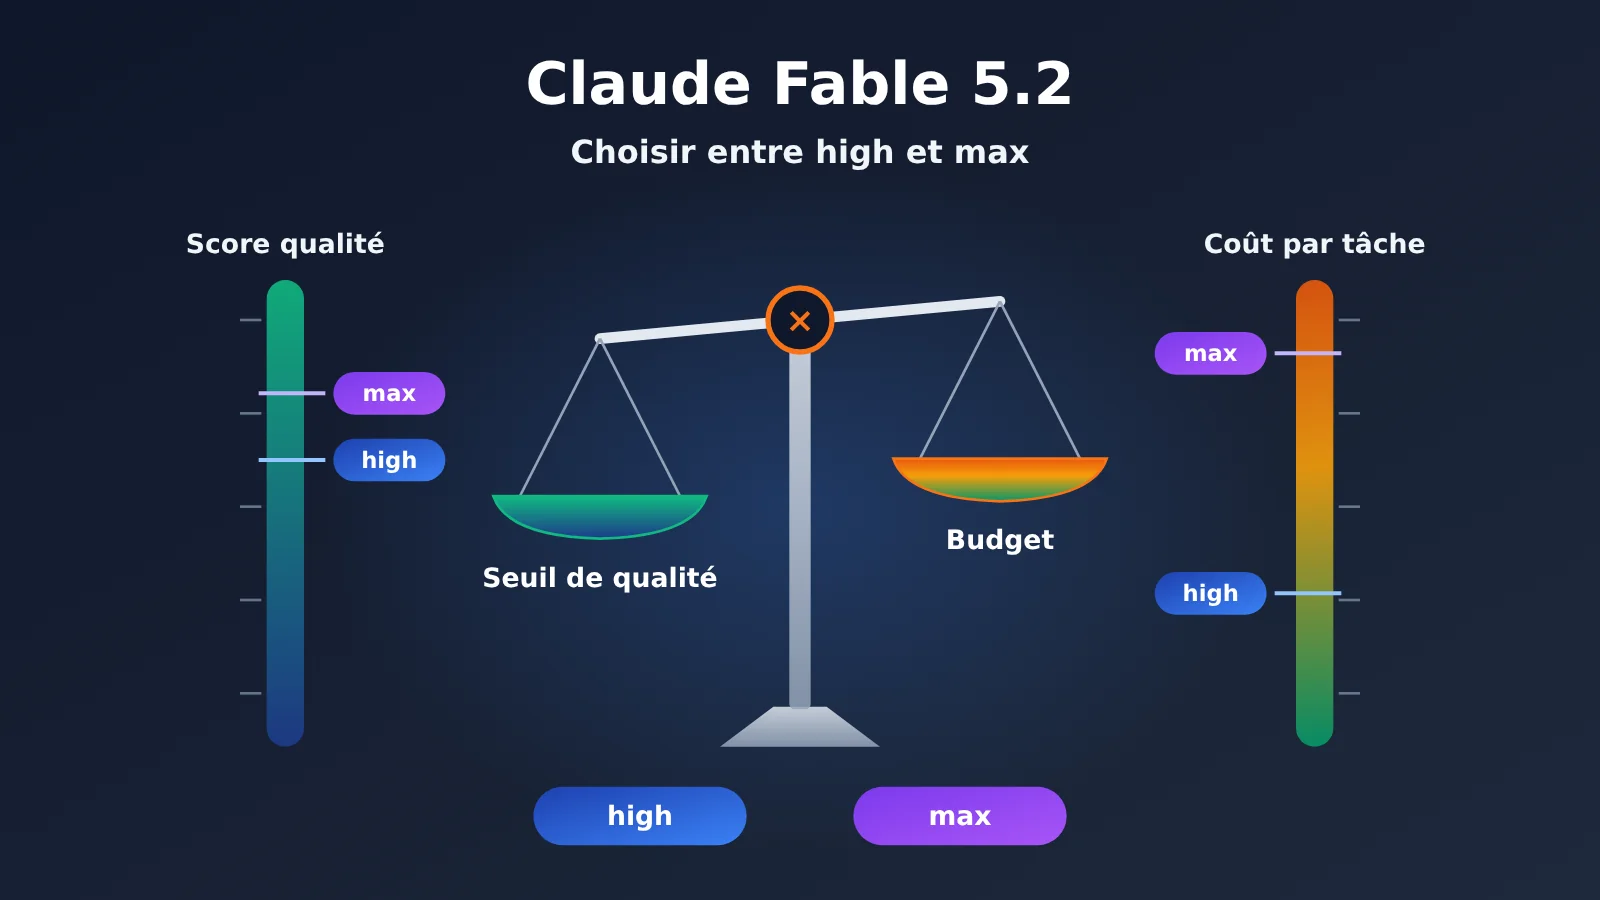
Cet article compare Fable 5.2 high et Fable 5.2 max dans un même cadre, en examinant à la fois la qualité et le coût par tâche.
L’essentiel : à la fin de cet article, vous saurez dans quelles conditions choisir high ou max pour Fable 5.2. Vous disposerez aussi d’une liste de contrôle prête à l’emploi pour valider une mise à niveau.
Sommaire
- À connaître : les termes liés au choix du niveau de Fable 5.2
-
- Avec Fable 5.2, high et max ne modifient pas le même tarif unitaire
-
- Comparer la qualité et le coût de Fable 5.2 dans un même tableau
-
- Vérifier les tendances entre les niveaux de Fable 5.2 à l’aide de données indépendantes
-
- Choisir le niveau de Fable 5.2 selon le type de tâche
-
- Décider, à partir de vos propres critères de validation, si Fable 5.2 doit passer au niveau max
- Foire aux questions / Points clés / Conclusion
À savoir
| Terme | Signification | À retenir pour lire cet article |
|---|---|---|
| Effort | Paramètre qui contrôle l’investissement du modèle dans la réflexion | La valeur par défaut de l’API pour Fable 5.2 est high |
| Adaptive thinking | Mécanisme qui permet au modèle d’ajuster automatiquement la quantité de réflexion | Toujours activé dans Fable 5.2 |
| Harness | Environnement d’exécution qui fournit au modèle des outils, des sessions et des règles d’exécution | Le Harness de Cursor et celui d’AA sont différents |
| Intelligence Index | Indice composite calculé par AA à partir de plusieurs évaluations pondérées | C’est un indice, pas un taux de réussite |
| Points de pourcentage | Écart absolu obtenu en soustrayant deux pourcentages | Passer de 56,9 % à 60,0 %, c’est gagner 3,1 points de pourcentage |
| Coût par tâche | Coût du modèle réparti sur une seule tâche dans le cadre d’un test donné | Ce n’est pas votre facture API |
| Seuil d’acceptation | Niveau de qualité qu’une tâche doit atteindre | Il faut d’abord franchir le seuil, puis comparer les budgets |
| Segmentation des tâches | Répartition des tâches par difficulté et coût d’un échec | Chaque niveau appelle un palier différent |
1. Les paliers high et max de Fable 5.2 ne changent pas le même coût unitaire
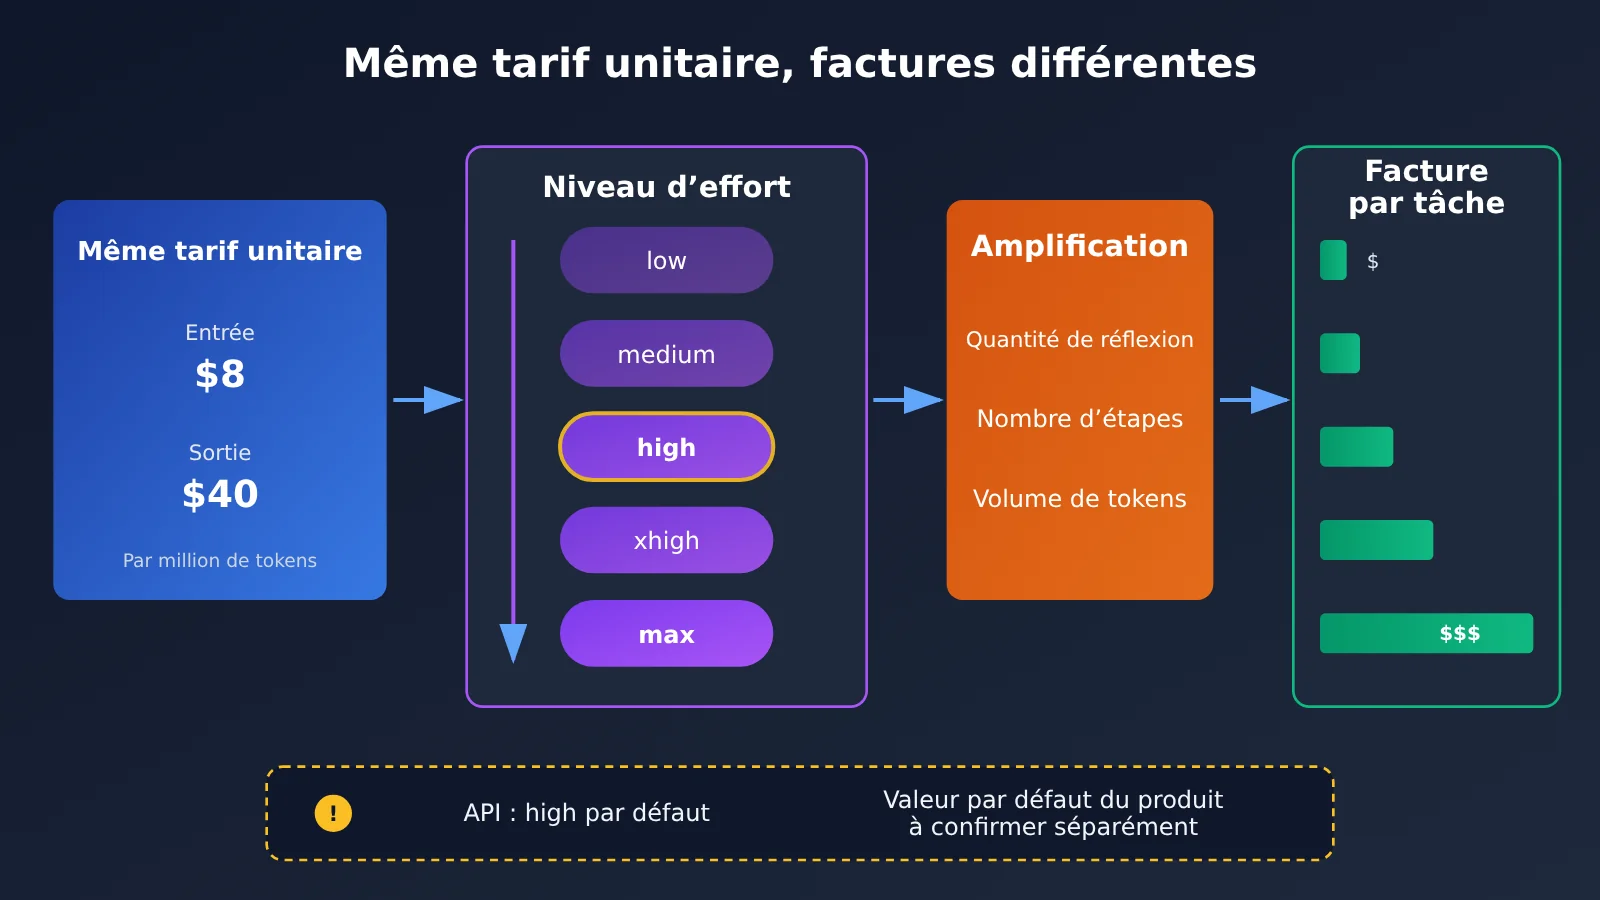
Beaucoup pensent qu’un palier supérieur entraîne un tarif unitaire plus élevé. En réalité, selon les tarifs standard officiels d’Anthropic, les tokens d’entrée de Fable 5.2 coûtent 8 dollars par million et les tokens de sortie, 40 dollars par million. Ces prix unitaires ne varient pas selon le palier.
L’effort détermine la quantité de réflexion investie par le modèle dans une tâche, ainsi que le nombre d’étapes, le temps passé et le nombre de tokens consommés. Le prix unitaire reste identique, mais la facture d’une tâche peut varier de plusieurs fois.
Comment les paliers de Fable 5.2 influent sur la facture
Dans Fable 5.2, la réflexion adaptative est toujours activée ; l’effort détermine le niveau maximal et la tendance de l’investissement dans la réflexion. En règle générale, plus le palier augmente, plus le modèle effectue de raisonnement et d’appels d’outils, ce qui accroît le nombre de tokens facturés.
Prenons 100 000 tokens d’entrée dans les deux cas. Si la sortie passe de 20 000 à 40 000 tokens, le coût du mode standard de la version 5.2 passe de 1,60 à 2,40 dollars. Il dépasse alors les 2 dollars qu’aurait coûté la version 5.1 avec le volume initial.
Il faut aussi distinguer deux types de « valeur par défaut ». La documentation officielle du modèle indique que la valeur par défaut de l’effort dans l’API est high. Les produits comme Cursor disposent de leur propre couche de configuration. Par exemple, son contexte par défaut est de 300K, ce qui ne se situe pas au même niveau que la capacité de 1M indiquée dans la documentation de l’API.
Autre point à garder en tête : le guide officiel sur les invites précise qu’un palier portant le même nom peut correspondre à une quantité de réflexion différente d’une version à l’autre. Les repères établis avec la version 5.1 ne s’appliquent donc pas tels quels à la 5.2.
2 Comparer la qualité et le coût de Fable 5.2 dans un même tableau
CursorBench 4.0 est une évaluation menée par Cursor dans son propre environnement de tâches et d’outils. Il ne s’agit pas d’une évaluation indépendante et généraliste, mais les cinq niveaux y sont comparés avec le même harness, ce qui permet d’observer leurs différences relatives. Les données ci-dessous ont été relevées le 10 novembre 2026.
| Niveau de Fable 5.2 | Score | Coût par tâche (USD) | tokens (champ agrégé) | Étapes |
|---|---|---|---|---|
| Low | 53.2% | 3.94 | 36,616 | 30 |
| Medium | 54.8% | 4.66 | 44,103 | 35 |
| High | 56.9% | 9.70 | 99,259 | 69 |
| Extra High | 56.3% | 15.48 | 161,251 | 108 |
| Max | 60.0% | 32.79 | 352,794 | 218 |
Remarque : la colonne tokens est un champ agrégé de la page de référence. Il ne faut pas l’interpréter comme correspondant uniquement aux tokens de sortie. Source : CursorBench 4.0.
De High à Max sur Fable 5.2 : 3,1 points de pourcentage pour un coût environ 3,38 fois supérieur
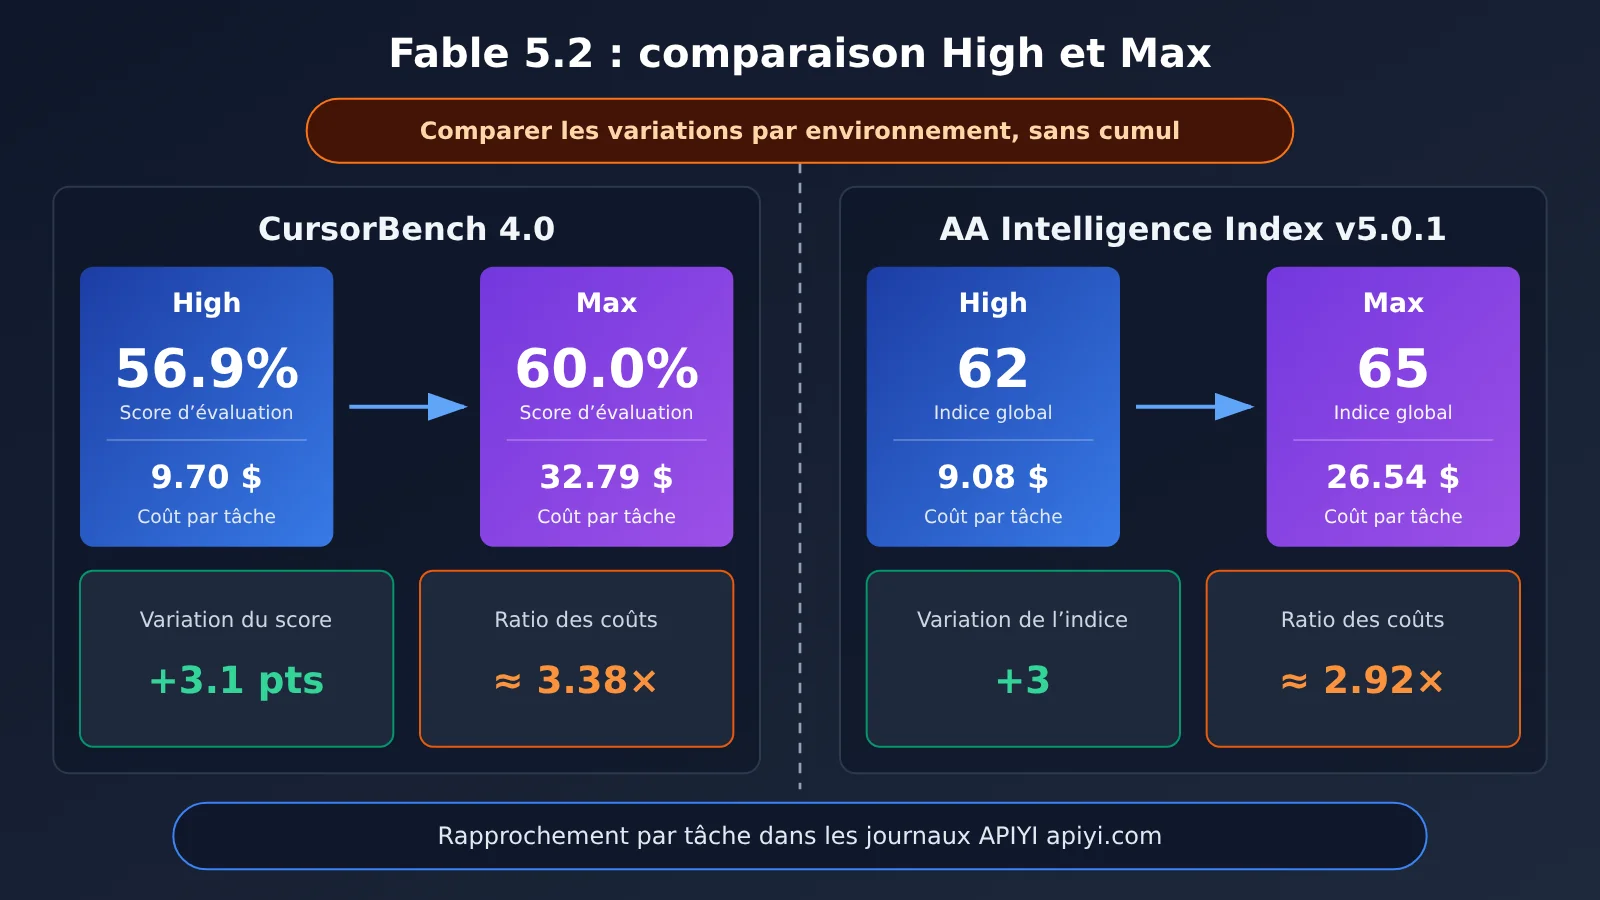
Dans ce tableau, le score passe de 56,9 % en mode High à 60,0 % en mode Max, soit une hausse de 3,1 points de pourcentage. Le coût par tâche passe de 9,70 à 32,79 dollars, soit environ 3,38 fois plus, une augmentation d’environ 238 %.
D’après nos calculs, la valeur du champ tokens est multipliée par environ 3,55, tandis que le nombre d’étapes passe de 69 à 218, soit environ 3,16 fois plus. La hausse des coûts s’explique principalement par l’augmentation du nombre d’étapes de réflexion et d’exécution, et non par le prix unitaire.
Ces données montrent uniquement que, dans cet environnement, un score plus élevé s’accompagne de dépenses nettement supérieures.
Comment interpréter le résultat surprenant d’Extra High
Un autre point mérite l’attention : Extra High coûte environ 60 % de plus que High, alors que son score est inférieur de 0,6 point de pourcentage.
💡 Conseil pour choisir : vous pouvez comparer les écarts entre les niveaux dans un même tableau, mais pas combiner des chiffres issus d’évaluations différentes. Pour reproduire une comparaison similaire sur vos propres tâches, vous pouvez utiliser l’interface unifiée d’APIYI apiyi.com et les journaux d’appels pour rapprocher les résultats, après avoir vérifié que l’ID de modèle et les niveaux correspondants sont bien pris en charge par la plateforme ce jour-là.
3 Vérifier la tendance des niveaux de Fable 5.2 à partir des données d’un organisme indépendant
Les conclusions tirées d’un seul environnement d’évaluation peuvent être influencées par ses particularités. AA est un organisme indépendant ; son classement permet de vérifier si la tendance observée dans Cursor se retrouve dans un autre environnement. Voici un instantané au 10 novembre 2026, établi selon la version 5.0.1 de l’Intelligence Index.
| Configuration | Intelligence Index | Coût par tâche (USD) |
|---|---|---|
| Fable 5.2 medium | 56 | 3.80 |
| Fable 5.2 high | 62 | 9.08 |
| Fable 5.2 xhigh | 62 | 14.83 |
| Fable 5.2 max | 65 | 26.54 |
| Opus 5.5 max | 59 | 10.04 |
65 ne signifie pas un taux de réussite de 65 %
La page méthodologique d’AA précise que l’indice v5.0.1 se compose de 9 évaluations, réparties à parts égales entre quatre catégories de compétences. Le score de 65 est donc un indice composite, et non un taux de réussite de 65 %. Dans l’environnement d’AA, le passage de high à max fait gagner 3 points à l’indice, pour un coût par tâche multiplié par environ 2,92. high et xhigh obtiennent tous deux 62, ce qui signifie seulement que leur score composite est identique, pas que leur comportement est exactement le même pour chaque tâche.
Comparer les résultats uniquement au sein de chaque environnement
Les deux environnements montrent la même tendance : max obtient un score plus élevé, pour un coût environ trois fois supérieur à celui de high. Cela confirme la tendance, sans pour autant permettre de comparer directement les résultats. AA et Cursor utilisent des tâches, des méthodes de notation et des calculs de coûts différents : il ne faut pas combiner le score de 65 d’AA et le taux de réussite de 60,0 % de Cursor pour en faire un seul taux de réussite.
4 Choisir le niveau de Fable 5.2 selon la tâche
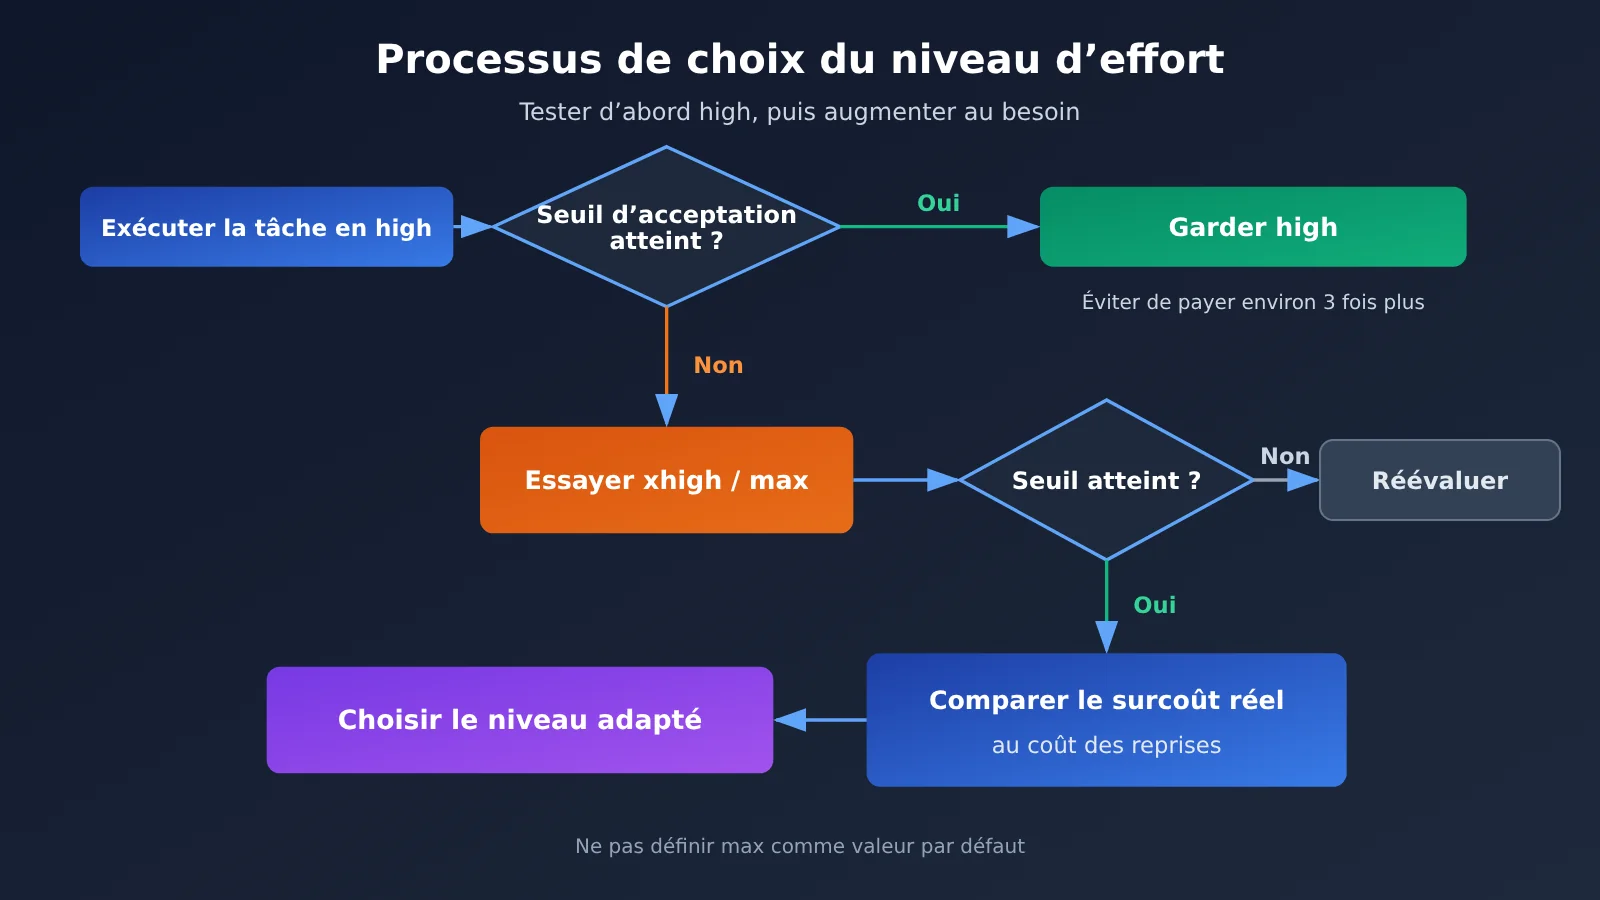
Le guide officiel de prompting propose une logique pour démarrer : pour l’API, partez du niveau high, puis augmentez-le ou réduisez-le en fonction de vos évaluations. Le niveau medium convient davantage aux scénarios interactifs. Réservez xhigh aux tâches longues et difficiles pour lesquelles un gain supplémentaire a été démontré. Utilisez max pour évaluer les capacités maximales du modèle, ou pour les rares tâches où ni le temps ni le nombre de tokens ne sont un problème. Avec les niveaux les plus bas, attention au risque que la tâche s’interrompe avant d’être terminée.
Recommandations par scénario pour Fable 5.2
Les trois scénarios ci-dessous sont hypothétiques et servent à illustrer la démarche de sélection.
| Scénario hypothétique | Niveau de départ conseillé | Quand envisager un niveau supérieur | À éviter |
|---|---|---|---|
| Modification des exigences (changer un champ, ajuster une API, ajouter des tests) | Évaluer medium, puis passer à high si nécessaire |
Si medium s’interrompt avant la fin ou omet des modifications |
Activer max par défaut pour de petits changements |
| Correctif complexe (bug touchant plusieurs modules, problème de concurrence) | high |
Si le taux de réussite de high n’atteint pas le seuil d’acceptation |
Passer directement à xhigh sans l’avoir évalué |
| Recherche au long cours (question ouverte, exploration de solutions) | Commencer par high |
Si la question a une grande valeur, que l’échec coûte cher et que des évaluations ont déjà démontré l’intérêt de max |
Définir max comme niveau par défaut pour toutes les requêtes |
Quand choisir Fable 5.2 high
- Pour la plupart des tâches API exigeant un raisonnement approfondi et assorties de critères d’acceptation clairs ;
- Si votre équipe n’a pas encore mis en place de système d’évaluation des niveaux et qu’il lui faut un point de départ recommandé par le fournisseur ;
- Pour les environnements de production à fort volume de requêtes, où le coût par tâche compte.
Quand choisir Fable 5.2 max
- Pour évaluer les capacités maximales du modèle dans une catégorie de problèmes donnée ;
- Pour les quelques questions ouvertes où le coût d’un échec dépasse largement celui du modèle ;
- Si vos propres exemples ont déjà montré que
maxpermet de dépasser le seuil de réussite, contrairement àhigh.
🎯 Conseil technique : choisissez le niveau en fonction des catégories de tâches, plutôt que de prendre une décision pour chaque requête. La bonne pratique recommandée consiste à commencer par faire traiter un ensemble représentatif de tâches avec
high. Si vous prévoyez de passer par APIYI, sur apiyi.com, pour centraliser l’accès, vérifiez sur la plateforme, avant le lancement, l’ID du modèle disponible ce jour-là, le groupe, le point de terminaison et la prise en charge des niveaux d’effort.
5 Décider à partir de vos propres tests si Fable 5.2 vaut la peine d’être passé en mode max
Les évaluations publiques vous donnent une idée des tendances, mais seuls vos propres résultats de validation vous permettront de décider si la mise à niveau en vaut la peine. Vous pouvez utiliser directement la liste de suivi ci-dessous. Le principe essentiel est de ne modifier qu’une seule variable à la fois : le niveau d’effort.
| Élément à consigner | Exigences |
|---|---|
| Tâches et entrées | Même série de tâches, mêmes entrées et même invite système |
| Autorisations des outils | Outils disponibles et autorisations strictement identiques |
| Modèle et niveau d’effort | Consigner l’ID du modèle et le niveau d’effort ; ne modifier que ce dernier à chaque série de tests |
| Critères de réussite | Définir les seuils de validation à l’avance, sans les modifier après avoir vu les résultats |
| Usage | Consigner séparément les jetons d’entrée, les écritures et lectures du cache, et les jetons de sortie |
| Durée et nouvelles tentatives | Consigner la durée totale, le nombre de nouvelles tentatives et le nombre d’arrêts anticipés |
| Montant réellement facturé | Se fier au montant effectivement facturé dans les journaux de la plateforme, sans le remplacer par une estimation fondée sur les tarifs officiels |
| Cas d’échec | Conserver les sorties d’origine et analyser les problèmes résolus par le mode max |
Prise en main rapide de Fable 5.2 : commencer par consigner l’usage
Cet exemple minimal montre uniquement comment lancer un appel et consigner l’usage. Cet article ne présente pas de méthode pour transmettre le paramètre effort : pour savoir si Fable 5.2 est disponible sur la plateforme et si la transmission d’effort est prise en charge, consultez la documentation de la plateforme à jour.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatible avec OpenAI d’APIYI
)

resp = client.chat.completions.create(
    model="YOUR_MODEL_ID",  # Indiquez l’ID de modèle dont la disponibilité a été confirmée par la plateforme le jour même
    messages=[{"role": "user", "content": "按验收标准修复以下函数……"}]
)
print(resp.usage)  # Consignez l’usage pour le rapprochement ultérieur
Afficher le code complet de consignation et de rapprochement
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Tarifs officiels standards d’Anthropic (dollars par million de jetons), à titre d’estimation uniquement ; ils ne représentent pas le montant réellement facturé
RATE_IN, RATE_OUT = 8.0, 40.0

def run_task(task_id: str, prompt: str, model: str, effort_label: str, passed_fn):
    """Exécute une tâche et renvoie un enregistrement de validation. effort_label est uniquement une étiquette de suivi."""
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}]
    )
    text = resp.choices[0].message.content
    u = resp.usage
    est_usd = u.prompt_tokens / 1e6 * RATE_IN + u.completion_tokens / 1e6 * RATE_OUT
    return {
        "task_id": task_id,
        "model": model,
        "effort": effort_label,
        "passed": passed_fn(text),          # Fonction de validation écrite à l’avance
        "prompt_tokens": u.prompt_tokens,
        "completion_tokens": u.completion_tokens,
        "est_usd": round(est_usd, 4),       # Valeur estimée
        "seconds": round(time.time() - start, 1),
        "output": text,                     # Conserve le texte original des cas ayant échoué
    }

def quota_to_usd(quota: int) -> float:
    """Dans les journaux de la plateforme, quota ÷ 500000 correspond au montant réellement facturé en dollars."""
    return quota / 500000
La documentation des journaux d’APIYI répertorie des champs comme model_name, prompt_tokens, completion_tokens, quota, duration_for_view et request_id. quota ÷ 500000 correspond au montant réellement facturé en dollars, tandis que le champ other contient des informations complémentaires, comme le multiplicateur de groupe. En reliant les enregistrements de validation aux journaux à l’aide de request_id, vous pouvez calculer le coût réel des « tâches réussies », au lieu de vous limiter au coût de chaque requête.
🚀 Pour commencer rapidement : pour valider le processus sur un petit échantillon, inscrivez-vous sur APIYI, à l’adresse apiyi.com, puis utilisez le crédit d’essai gratuit réservé aux nouveaux utilisateurs. Testez cette méthode — « même tâche, une seule variable à la fois, montant réellement facturé consigné » — avant d’augmenter la taille de l’échantillon.
Le principe à suivre est le suivant : vérifiez d’abord si high atteint le seuil de qualité requis. Si c’est le cas, inutile de payer environ trois fois plus pour gagner quelques points de pourcentage. Ce n’est que si high n’atteint pas le seuil, mais que max y parvient, qu’il faut comparer le surcoût de max au coût d’un échec ou d’une reprise. Évitez de définir max comme valeur par défaut pour toutes les requêtes.
FAQ
Q1 : Quels sont les niveaux d’effort de Claude Fable 5.2 ?
Le paramètre `effort` contrôle les ressources de réflexion mobilisées par le modèle. Les niveaux disponibles vont de `low` à `max`. Il ne modifie pas le prix unitaire des tokens, mais la quantité de réflexion, le nombre d’étapes, le temps de traitement et la consommation de tokens. La facture d’une même tâche peut donc varier plusieurs fois selon le niveau choisi. Le niveau par défaut de l’API est `high`.
Q2 : Quel est l’écart entre Fable 5.2 en mode high et en mode max ?
Sur CursorBench 4.0, le mode `high` obtient 56,9 % pour 9,70 dollars, tandis que le mode `max` obtient 60,0 % pour 32,79 dollars. L’écart est de 3,1 points de pourcentage, pour un coût environ 3,38 fois supérieur. Sur AA, `high` obtient 62 pour 9,08 dollars, et `max` 65 pour 26,54 dollars, soit un coût environ 2,92 fois supérieur. Ces deux séries de données ne peuvent être comparées qu’au sein de leur environnement respectif.
Q3 : De quand datent ces données ? Peuvent-elles changer ?
Fable 5.2 est sorti le 9 novembre 2026. Les données de cet article sont un instantané relevé le 10 novembre. Les pages d’AA et de Cursor sont mises à jour en continu : les chiffres peuvent évoluer avec les versions, les jeux de tâches ou les méthodes de calcul des coûts. Pensez à indiquer la date de consultation lorsque vous les citez.
Q4 : Extra High obtient un score inférieur à High. Faut-il éviter de l’utiliser ?
Il s’agit uniquement des résultats de cette évaluation sur CursorBench 4.0 : on ne peut pas en conclure que `xhigh` est moins performant pour toutes les tâches. La recommandation officielle est de réserver `xhigh` aux tâches longues et difficiles pour lesquelles vos propres évaluations ont déjà montré un gain. Tant que vous n’avez pas constaté de bénéfice, inutile de l’activer par défaut.
Q5 : Comment comparer le coût des différents niveaux de Fable 5.2 via l’API ?
Utilisez le même lot de tâches en ne changeant que le niveau, puis relevez les données `usage` et le montant réellement débité par la plateforme. Avec l’interface unifiée d’APIYI (apiyi.com), vous pouvez convertir le montant réellement débité en dollars à partir de `quota÷500000`, indiqué dans les journaux. Avant de lancer vos tests, vérifiez les identifiants de modèle, les groupes et la prise en charge d’`effort` par la plateforme ce jour-là. Cet article ne propose aucune méthode de transmission qui n’ait pas été vérifiée.
Q6 : Quelles sont les limites des données d’évaluation publiques ?
CursorBench est une évaluation réalisée par un fournisseur d’outils dans son propre environnement, tandis que l’indice AA est un score composite pondéré. Aucun des deux ne reflète le taux de réussite de vos propres usages. Un écart d’environ 3 points de pourcentage ne suffit pas non plus à établir une différence significative. Les premiers avis publiés sur les réseaux sociaux peuvent fournir des pistes, mais votre conclusion doit reposer sur vos propres échantillons de validation.
Q7 : Après une baisse de 20 % du prix de l’API, le mode max devient-il plus avantageux ?
Pas forcément. À consommation égale, une baisse de prix permet d’économiser dans la même proportion. Mais le mode `max` peut consommer plus de trois fois plus de tokens et d’étapes que `high` : la hausse de la consommation peut facilement annuler la baisse du prix unitaire. Comparez le montant réellement débité pour mener une tâche à bien, plutôt que le seul prix unitaire.
Points clés sur Fable 5.2 high et max
- Le prix unitaire ne change pas, mais la facture, si : le niveau d’effort modifie la quantité de réflexion et le nombre d’étapes. À prix unitaire identique, le coût d’une tâche peut varier de plusieurs fois.
- L’API utilise high par défaut : la recommandation officielle est de commencer avec high, puis d’ajuster à la hausse ou à la baisse selon vos propres évaluations.
- Comparaison avec Cursor : le score augmente de 3,1 points de pourcentage entre high et max, pour un coût environ 3,38 fois supérieur.
- Comparaison avec AA : l’indice passe de 62 à 65, pour un coût environ 2,92 fois supérieur. Un score de 65 ne correspond pas à un taux de réussite.
- Ne fusionnez pas les environnements : les deux évaluations doivent être comparées séparément, chacune dans son propre environnement. Il ne faut pas les combiner pour calculer un score unique de rapport qualité-prix.
- Réservez max à quelques tâches : ce niveau convient à l’évaluation des capacités maximales et aux questions ouvertes à forte valeur.
- Validez avec les coûts réellement facturés : utilisez la même tâche, ne faites varier qu’un seul paramètre et consignez les données d’utilisation. Vous pouvez rapprocher les comptes à l’aide des journaux d’APIYI sur apiyi.com.
Conclusion
Le choix entre Fable 5.2 high et max se résume à trois points :
- Distinguez le prix unitaire de la facture par tâche : le niveau ne modifie pas le prix unitaire, mais le volume de ressources utilisées.
- Interprétez les données dans un même environnement : Cursor et AA montrent tous deux que max obtient un score légèrement supérieur, pour un coût environ trois fois plus élevé que high. Ces deux comparaisons ne doivent toutefois pas être combinées.
- Fondez votre choix sur les critères d’acceptation : si high atteint le seuil requis, gardez ce niveau. Comparez le coût supplémentaire et le risque de reprise uniquement si high échoue alors que max réussit.
Pour la plupart des équipes, une approche prudente consiste à commencer avec high, à définir des catégories de tâches et à consigner les critères d’acceptation, puis à évaluer max séparément sur quelques tâches à forte valeur. Nous vous recommandons d’utiliser l’interface unifiée et les journaux d’appels d’APIYI sur apiyi.com pour valider rapidement vos propres échantillons. Vérifiez d’abord que le modèle et le niveau choisi sont pris en charge avant d’élargir le déploiement.
📚 Références
- Annonce d’Anthropic : disponibilité de Fable et Mythos 5.2, et évaluations publiées par le fournisseur
- Lien :
anthropic.com/claude-fable-and-mythos-5-2 -
À noter : publication datée du 2026-11-09, avec les données de vitesse et un tableau d’évaluation
-
Tarifs de l’API Claude : tarifs standards officiels
- Lien :
platform.claude.com/docs/en/about-claude/pricing -
À noter : pour Fable 5.2, les tarifs d’entrée et de sortie sont de 8 / 40 dollars par million de tokens
-
Caractéristiques de Fable 5.2 : contexte, limite de sortie et niveau d’effort par défaut
- Lien :
platform.claude.com/docs/en/models/fable-5-2/overview -
À noter : la pensée adaptative est toujours activée ; le niveau par défaut de l’API est
high -
Guide d’invite pour Fable 5.2 : recommandations officielles pour choisir un niveau
- Lien :
platform.claude.com/docs/en/build-with-claude/prompt-engineering/prompting-claude-fable-5-2 -
À noter : cas d’usage respectifs de
medium,high,xhighetmax -
CursorBench 4.0 : évaluation sur cinq niveaux dans l’environnement propre à Cursor
- Lien :
prod.cursor.com/evals -
À noter : évaluation réalisée par le fournisseur de l’outil, et non par une étude indépendante à vocation générale
-
Classement des modèles d’Artificial Analysis : classement dynamique d’un organisme indépendant
- Lien :
artificialanalysis.ai/leaderboards/models -
À noter : Intelligence Index et coût par tâche
-
Méthodologie d’évaluation d’Artificial Analysis : composition de l’Intelligence Index v5.0.1
- Lien :
artificialanalysis.ai/methodology/intelligence-benchmarking -
À noter : 9 évaluations, réparties entre quatre catégories de capacités, chacune comptant pour 25 %
-
Comment Cursor compare la qualité des modèles : article sur la méthodologie de l’ancienne version du benchmark
- Lien :
prod.cursor.com/blog/cursorbench -
À noter : utile uniquement pour comprendre les principes de conception ; ne permet pas de tirer des conclusions statistiques sur la version 4.0
-
API de consultation des journaux d’APIYI : champs des journaux et calcul du montant réellement débité
- Lien :
docs.apiyi.com/api-capabilities/log-query - À noter :
quota÷500000correspond au montant réellement débité en dollars
Auteur : équipe technique d’APIYI
Échanges techniques : contactez-nous depuis la page d’accueil d’APIYI, apiyi.com. Pour en savoir plus, consultez le centre de documentation docs.apiyi.com.