Note de l’auteur : à partir de la métaphore de Lai Jie, de 星尘智能 — « Ne me facturez pas des tokens pour chaque vis serrée » —, cet article examine les étapes d’un workflow IA à confier à des programmes prédéfinis et celles qui nécessitent le jugement d’un grand modèle de langage.
Le 5 novembre 2026, la rubrique « Entreprises de la diversité » d’Aifanr a publié une interview de Lai Jie, fondateur et PDG de 星尘智能. Une phrase a été largement reprise par les personnes qui développent des applications IA : « Je veux que ce soient des programmes prédéfinis qui serrent les vis, en tournant 24 heures sur 24. Ne me facturez pas des tokens pour chaque vis serrée. »
Ce n’est pas juste une formule. Dans l’interview, Lai Jie parle de la répartition des tâches en robotique : un modèle d’IA incarnée se charge des mouvements physiques et, en cas de problème, interroge un grand modèle de langage généraliste en langage naturel. Appliquée aux workflows logiciels, cette idée soulève une question très concrète : dans une application IA, quelles étapes ne devraient pas faire appel à un grand modèle de langage ?
Ce que vous allez en retenir : cet article transpose le point de vue exprimé dans l’interview sur la robotique à la conception des limites d’invocation dans les workflows logiciels. Il présente 5 types d’étapes qui ne devraient pas faire appel à un grand modèle de langage, des critères de décision par niveau et un exemple de code de routage à adapter directement. Précisons que les robots et les logiciels sont deux types de systèmes différents : la transposition proposée est une analogie, dont les effets doivent être vérifiés à partir de votre propre consommation réelle.
« Ne me facturez pas des tokens pour chaque vis serrée » : l’essentiel
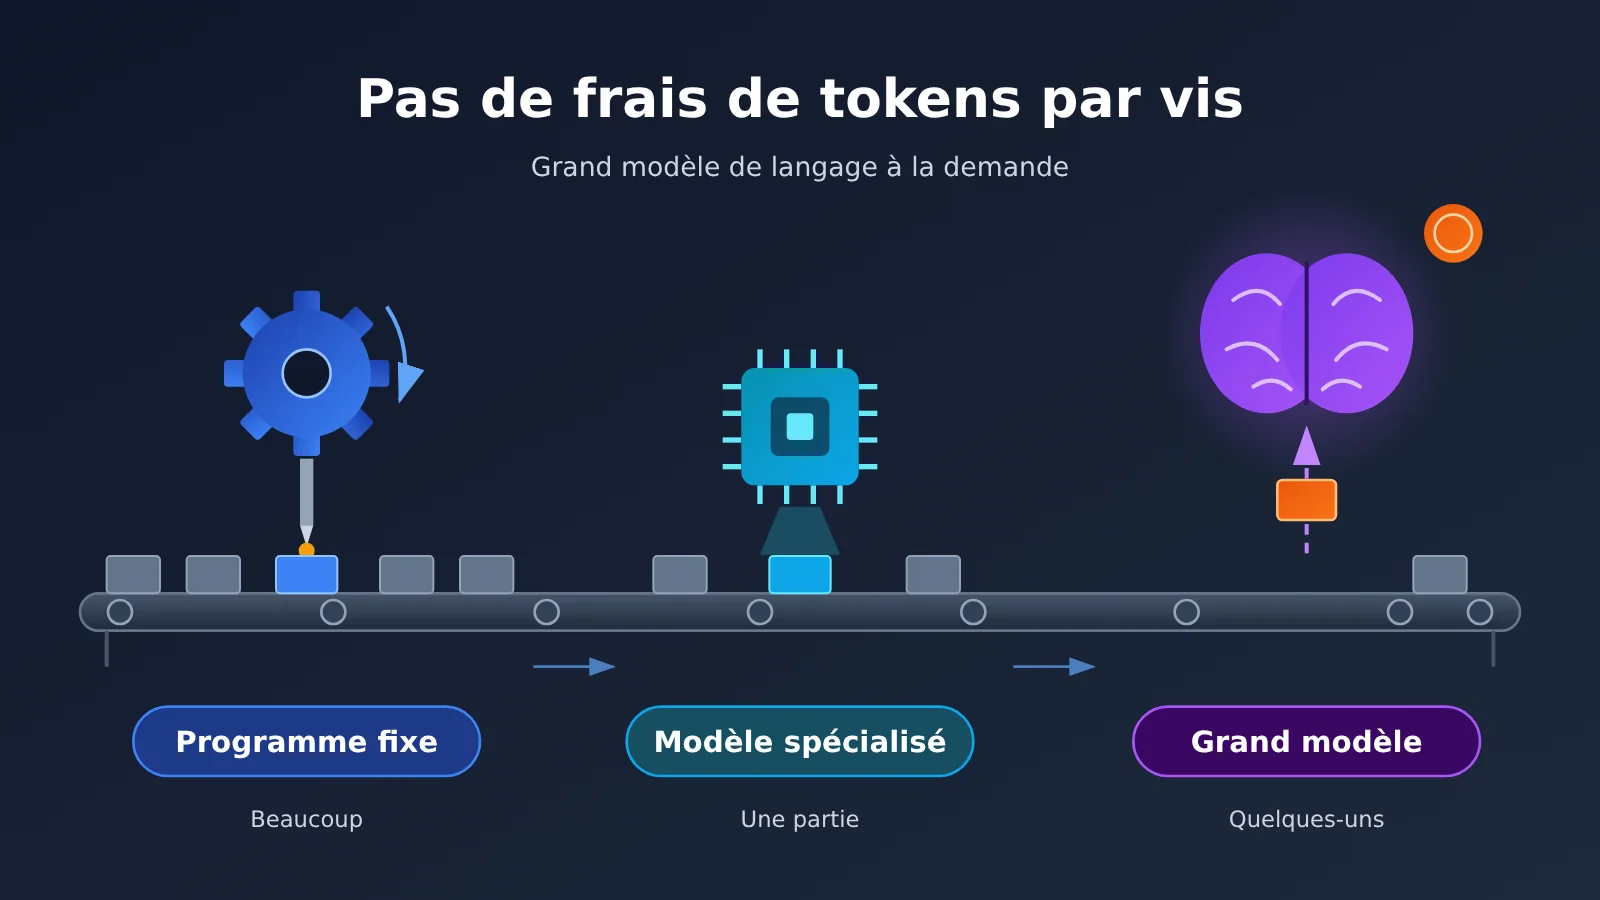
Cette phrase vient de la dernière question de l’entretien. Lorsqu’on lui demande de quoi les robots devraient libérer les humains, Lai Jie répond clairement qu’il ne souhaite pas les voir « serrer des vis à l’usine ». Pour lui, la valeur des robots tient à l’étendue de leurs capacités. Côté coûts, payer des tokens pour chaque geste d’une tâche répétitive n’en vaut pas la peine.
| Élément | Détail |
|---|---|
| Source | 15e entretien de la rubrique « Entreprises de la diversité » d’爱范儿 |
| Date de publication | 5 novembre 2026 |
| Personne interrogée | Lai Jie, fondateur et PDG de 星尘智能, ancien premier employé du laboratoire de robotique Tencent Robotics X |
| Idée centrale | Les gestes répétitifs devraient être confiés à des programmes fixes, sans frais de tokens à chaque action |
| Répartition des rôles | Le modèle d’IA incarnée se charge de l’exécution physique et, en cas de problème, interroge un grand modèle de langage de base en langage naturel |
| Enseignement pour les logiciels | Les flux de travail d’IA doivent définir quand faire appel à un programme fixe, à un modèle spécialisé ou à un grand modèle de langage de base |
Précisons que cet entretien présente le point de vue du fondateur : il ne fournit ni mesures de coûts réelles ni données vérifiées par un tiers. Nous reprenons ici sa logique de répartition des rôles, pas ses conclusions particulières.
La métaphore de Lai Jie : « appeler maman en vidéo » pour compléter le contexte
Dans l’entretien, Lai Jie utilise une métaphore qui explique mieux la répartition des tâches que celle du « vissage ». Il ne sait pas cuisiner, mais il veut apprendre : il appelle donc sa mère en vidéo. Elle lui dit par exemple : « Commence par mettre un peu d’huile dans la poêle chaude », sans avoir besoin de lui préciser quelle bouteille contient l’huile. S’il a un doute, il lui pose une question. L’essentiel est là : sa mère apporte les connaissances contextuelles, mais il doit savoir verser l’huile lui-même, car elle ne peut pas le faire à sa place à distance.
Pour un robot, le principe est similaire : le modèle incarné doit percevoir lui-même les paramètres physiques, comme le poids, la force de préhension ou la stabilité de la prise. Il ne consulte le grand modèle de langage généraliste que pour des questions comme : « Je n’arrive pas à bien saisir l’objet, il est un peu instable : que faire ? » Selon Lai Jie, intégrer aussi les informations tactiles dans l’entraînement du grand modèle de langage généraliste « n’est pas impossible, mais le coût ne se justifie pas et la bande passante de communication poserait aussi problème ». Il ajoute qu’il ne s’agit pas simplement d’une architecture en couches, mais plutôt d’une intelligence à base d’agents, comparable à celle des fourmis : chaque agent n’est pas forcément très performant seul, mais leur combinaison est puissante.
| Rôle dans le système robotique | Responsabilité dans l’entretien | Rôle analogue dans un workflow logiciel |
|---|---|---|
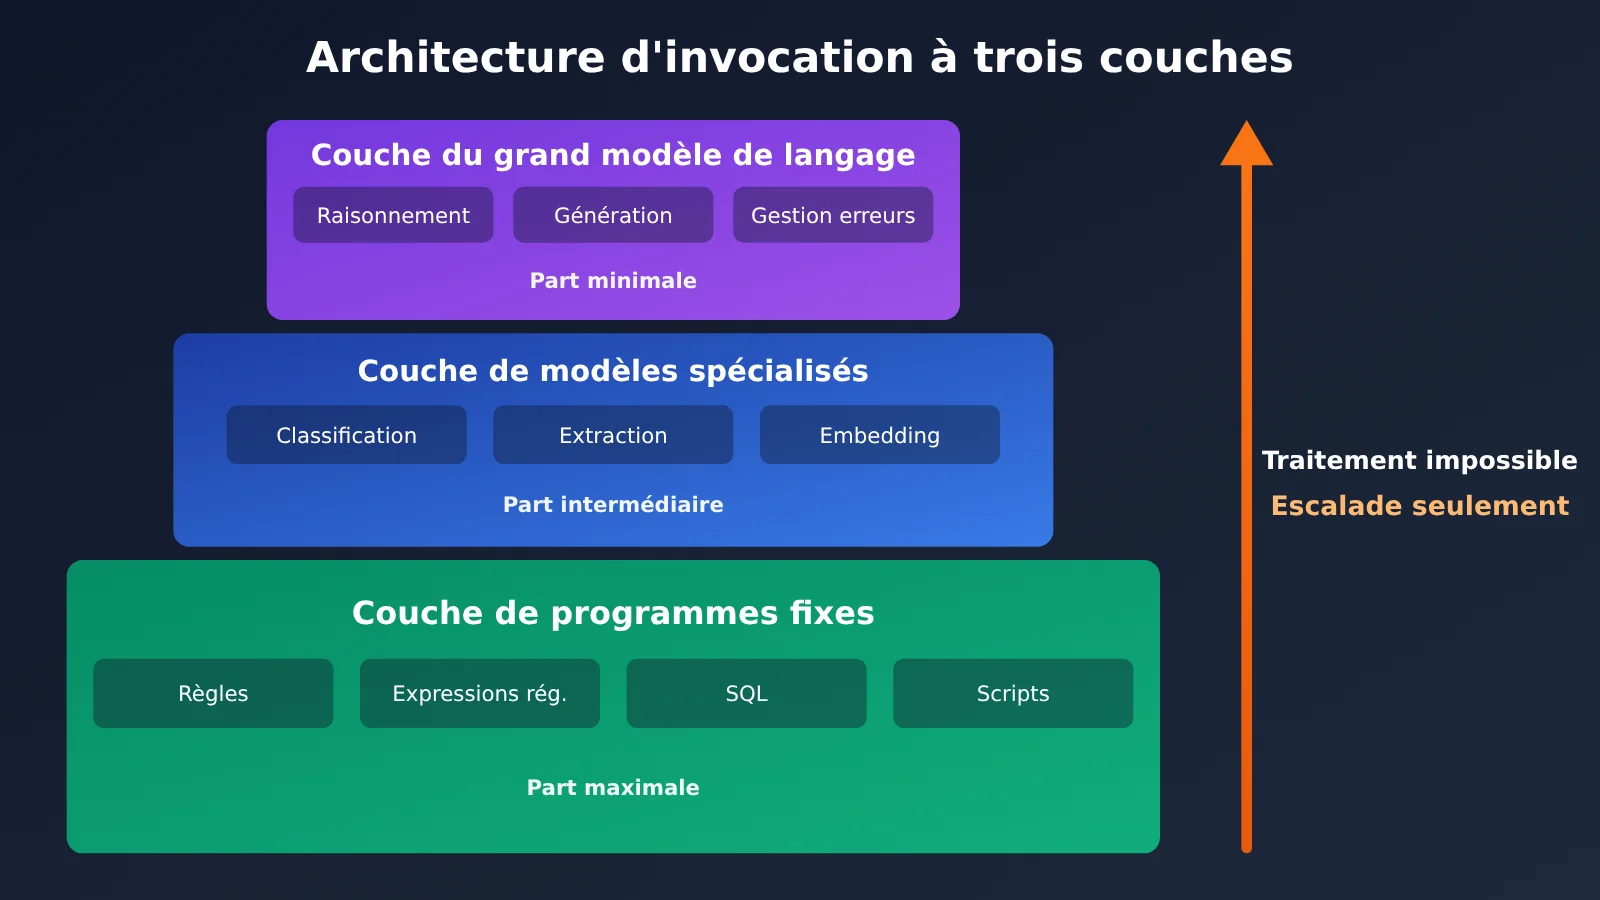
| Programme fixe | Visser en continu, 24 heures sur 24 | Moteur de règles, expressions régulières, scripts, requêtes de base de données |
| Modèle incarné | Exécution physique, perception des paramètres, traduction de l’état en langage naturel | Petits modèles spécialisés dans la classification, l’extraction, la recherche vectorielle, etc. |
| Grand modèle de langage généraliste | Apport de connaissances contextuelles, solutions aux problèmes complexes | Raisonnement complexe, génération ouverte, décisions en cas d’exception |
| Système d’exploitation AOS | Regroupement des capacités en modules de compétences, compatibles avec le grand modèle de langage et les agents | Couche d’orchestration des workflows, couche d’appel d’outils, routeur |
Ce tableau est une extrapolation de l’article, pas une citation de l’entretien. Les robots doivent composer avec le contrôle en temps réel du monde physique et les limites de bande passante des communications. Les workflows logiciels sont davantage contraints par la facturation des tokens, la latence et la stabilité. Leurs goulots d’étranglement ne sont donc pas tout à fait les mêmes.
Quand éviter de faire appel à un grand modèle de langage dans une application d’IA : 5 critères
Pour la première version d’un agent, beaucoup d’équipes ont tendance à confier toutes les étapes à un grand modèle de langage : validation du format, conversion des dates et même vérification qu’un champ n’est pas vide, le tout sous forme d’invites. C’est rapide pour un prototype, mais en production, chaque requête paie pour des opérations déterministes tout en introduisant une part d’aléatoire inutile.
En reprenant la métaphore du « serrage de vis », voici 5 critères pour décider si une étape mérite de faire appel à un grand modèle de langage.
| Critère | Plutôt un programme classique | Plutôt un modèle spécialisé | Plutôt un grand modèle de base |
|---|---|---|---|
| L’entrée est-elle structurée ? | Champs fixes, format explicite | Texte semi-structuré | Langage naturel ouvert |
| La sortie est-elle unique ? | Une seule réponse correcte | Nombre limité de catégories | Plusieurs réponses plausibles |
| Peut-on énumérer toutes les règles ? | Peut s’écrire en if/else | Nombreuses règles, mais schémas stables | Impossible d’énumérer toutes les règles |
| Coût d’une erreur | Aucune erreur acceptable | Quelques erreurs acceptables avec vérification | Nécessite de peser plusieurs facteurs |
| Fréquence d’appel | Très élevée, à chaque exécution | Élevée | Faible, déclenchement à la demande |
Les tâches de « serrage de vis » à confier à un programme classique
Les tâches suivantes relèvent généralement du « serrage de vis » : elles sont très déterministes et répétitives. Faire appel à un grand modèle de langage risque au contraire de réduire leur fiabilité :
- Validation et nettoyage des formats : adresses e-mail, numéros de téléphone, structure JSON et champs obligatoires peuvent être vérifiés avec des expressions régulières et une validation de schéma.
- Consultation et calcul des données : pour connaître le statut d’une commande, la quantité en stock ou le total d’un montant, interrogez directement la base de données ou l’interface métier. Ne demandez pas au grand modèle de langage de les « déduire ».
- Production à partir de modèles fixes : pour les SMS de notification, les accusés de réception standard ou les en-têtes de rapports, un moteur de modèles suffit à remplir les variables.
- Contrôle du flux et nouvelles tentatives : branchements, nouvelles tentatives après expiration du délai et mise en file d’attente pour limiter le débit relèvent de la couche d’orchestration et ne nécessitent pas de modèle.
- Réponses fréquentes présentes dans le cache : lorsqu’une même question revient régulièrement, consultez d’abord le cache ou la base de FAQ et renvoyez directement la réponse si elle s’y trouve.
Les étapes qui nécessitent vraiment le jugement d’un grand modèle de langage
À l’inverse, les tâches qui justifient réellement l’appel à un grand modèle de base ressemblent aux « questions auxquelles seule maman au bout du fil peut répondre » : clarifier une intention ambiguë, synthétiser plusieurs documents pour en tirer une conclusion, traiter une exception non couverte par les règles ou créer du contenu original. Leur point commun : il n’existe pas de réponse unique, les règles ne peuvent pas être toutes énumérées et ces situations sont relativement peu fréquentes.
Les modèles spécialisés se situent entre les deux. Pour la classification des intentions, l’extraction d’entités, l’analyse des sentiments ou la vectorisation de texte, un modèle plus petit suffit souvent. On peut le voir comme la version logicielle d’un « modèle incarné » : il accomplit lui-même ce qu’il sait faire et transmet les cas qu’il ne peut pas traiter au niveau supérieur sous forme de questions claires.
Exemple de conception en couches d’un workflow IA : filtrer d’abord les étapes qui ne nécessitent pas de grand modèle de langage
Prenons l’exemple courant d’un workflow de traitement automatique des tickets de support pour voir comment définir concrètement les limites d’invocation du modèle à chaque étape. Il s’agit d’un exemple de conception, et non de données mesurées sur un projet réel.
| Étape du workflow | Couche responsable | Méthode de traitement | Consommation de tokens |
|---|---|---|---|
| Validation des champs du ticket | Programme déterministe | Validation du schéma, rejet immédiat si un champ manque | Non |
| Consultation du statut de la commande et de la livraison | Programme déterministe | Appel à l’interface de la base de données métier | Non |
| Recherche de questions fréquentes | Programme déterministe / modèle spécialisé | Règles par mots-clés en priorité, recherche vectorielle en dernier recours | Faible |
| Classification de l’intention | Modèle spécialisé | Un petit modèle choisit parmi un nombre limité de catégories | Faible |
| Traitement des réclamations complexes et des cas exceptionnels | Grand modèle de langage généraliste | Génération de recommandations à partir du contexte de la commande | Oui |
| Remplissage du modèle de réponse | Programme déterministe | Le moteur de modèles produit le texte final | Non |
Comme on le voit, une seule des six étapes nécessite l’invocation d’un grand modèle de langage généraliste. Les économies de tokens, l’éventuelle baisse du taux de réussite et l’évolution de la latence dépendent de la structure de votre trafic et de la couverture de vos règles. Il faut les évaluer à partir des journaux réels.
Exemple minimaliste : priorité aux règles, recours au modèle en dernier ressort
Ce code illustre un routage par étapes : les règles traitent d’abord les requêtes routinières, puis un petit modèle classe les autres. Le grand modèle de langage n’intervient que pour les cas complexes. Les noms de modèles sont donnés à titre d’exemple : consultez la liste des modèles disponibles sur la plateforme.
import re
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface APIYI compatible avec OpenAI
)

def handle(query: str) -> str:
    # Première étape : traitement par règles, sans invoquer de modèle
    if re.search(r"(订单号|单号)\s*[::]?\s*\d{8,}", query):
        return "已为您查询订单状态(走业务接口,不消耗 token)"
    # Deuxième étape : classification de l’intention par un petit modèle
    intent = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[{"role": "user", "content": f"只输出类别(咨询/投诉/其他):{query}"}],
        max_tokens=5,
    ).choices[0].message.content.strip()
    if intent != "投诉":
        return f"已归类为:{intent},转入标准流程"
    # Troisième étape : invocation du grand modèle de base uniquement pour les réclamations complexes
    return client.chat.completions.create(
        model="claude-sonnet-4",
        messages=[{"role": "user", "content": f"请给出投诉处理建议:{query}"}],
    ).choices[0].message.content
Voir le code complet avec suivi de l’utilisation
import re
import time
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SMALL_MODEL = "gpt-4o-mini"       # Exemple : petit modèle pour la classification et l'extraction
LARGE_MODEL = "claude-sonnet-4"   # Exemple : grand modèle pour le raisonnement complexe

@dataclass
class UsageLog:
    records: list = field(default_factory=list)

    def add(self, layer: str, tokens: int, latency: float):
        self.records.append({"layer": layer, "tokens": tokens, "latency": latency})

    def summary(self):
        result = {}
        for r in self.records:
            s = result.setdefault(r["layer"], {"count": 0, "tokens": 0, "latency": 0.0})
            s["count"] += 1
            s["tokens"] += r["tokens"]
            s["latency"] += r["latency"]
        return result

log = UsageLog()

RULES = [
    (re.compile(r"(订单号|单号)\s*[::]?\s*\d{8,}"), "order_lookup"),
    (re.compile(r"(营业时间|几点开门)"), "faq_hours"),
]

def rule_layer(query: str):
    for pattern, action in RULES:
        if pattern.search(query):
            return action
    return None

def call_model(model: str, prompt: str, layer: str, max_tokens: int = 512) -> str:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=max_tokens,
    )
    tokens = resp.usage.total_tokens if resp.usage else 0
    log.add(layer, tokens, time.time() - start)
    return resp.choices[0].message.content.strip()

def handle(query: str) -> str:
    start = time.time()
    action = rule_layer(query)
    if action:
        log.add("rule", 0, time.time() - start)
        return f"[规则层] 执行动作:{action}"

    intent = call_model(
        SMALL_MODEL,
        f"只输出一个类别(咨询/投诉/其他),不要解释:{query}",
        layer="small",
        max_tokens=5,
    )
    if "投诉" not in intent:
        return f"[专用模型层] 归类为:{intent}"

    return call_model(
        LARGE_MODEL,
        f"你是资深客服主管,请针对以下投诉给出处理建议:{query}",
        layer="large",
    )

if __name__ == "__main__":
    for q in ["订单号:2026110612345 到哪了", "你们营业时间是?", "收到的商品破损,客服一直不回复"]:
        print(handle(q))
    print(log.summary())
🚀 Conseil pour démarrer : pour tirer des conclusions fiables du routage par couches, utilisez la même interface pour changer de modèle d’une couche à l’autre et consignez la consommation. Avec APIYI apiyi.com, vous pouvez invoquer un petit et un grand modèle de langage avec une seule clé API, puis comparer la consommation de tokens de chaque couche grâce aux statistiques de la plateforme. Les nouveaux utilisateurs peuvent commencer par valider leur prototype avec le crédit de test gratuit.
Analyse de l’impact : « Ne me facturez pas des tokens pour chaque vis serrée »
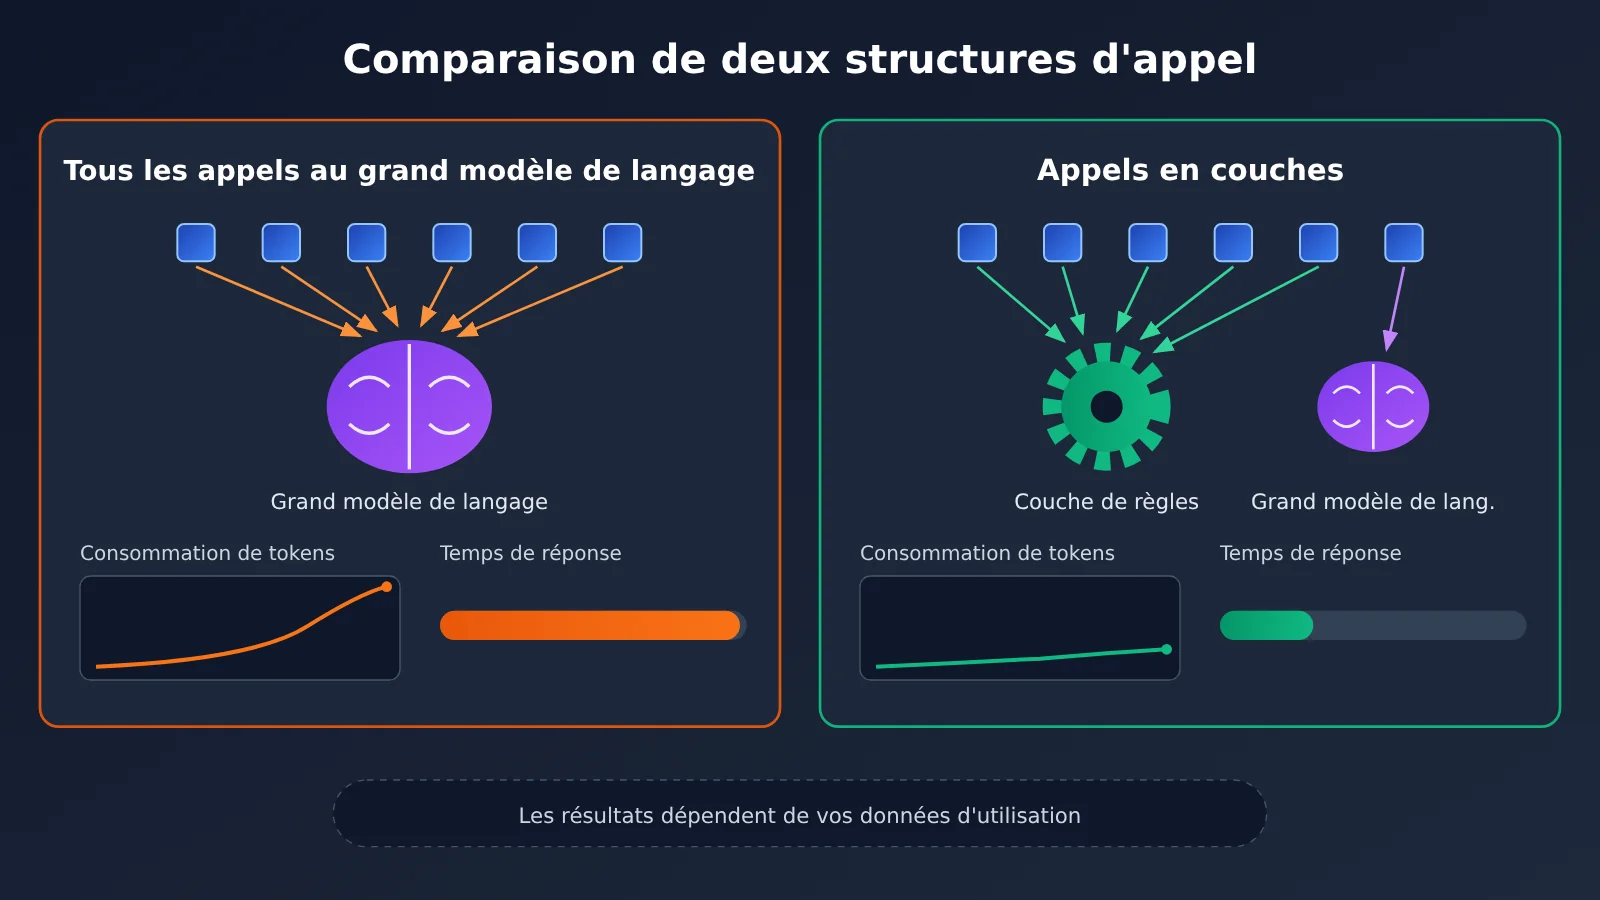
Le schéma ci-dessus illustre la différence de structure entre les deux approches, et non des résultats mesurés. Pour obtenir des données comparables, il est conseillé de tester les deux solutions sur APIYI apiyi.com avec le même ensemble de requêtes, puis d’analyser les relevés d’utilisation.
| Critère | Invocation systématique du grand modèle de langage | Invocation par couches | Plateformes utilisables |
|---|---|---|---|
| Vitesse de développement | Prototypage plus rapide : il suffit de rédiger des invites | Nécessite de définir les règles et le routage | APIYI apiyi.com, API officielles des différents fournisseurs |
| Consommation de tokens | Chaque étape est facturée | La facturation concerne principalement les étapes complexes | Idem |
| Déterminisme des résultats | Des écarts aléatoires peuvent survenir même pour les tâches déterministes | Les résultats de la couche de règles sont prévisibles | Idem |
| Latence | Chaque étape attend la génération du modèle | La couche de règles répond presque instantanément | Idem |
| Coût de maintenance | Les invites s’allongent à mesure qu’on les enrichit | Les règles doivent évoluer avec les besoins métier | Idem |
Impact pour les concepteurs de workflows et les développeurs
- L’ordre de conception s’inverse : au lieu de « brancher d’abord un grand modèle de langage, puis chercher à réduire les coûts », on liste toutes les étapes, on repère les « vis », puis on décide où placer le modèle.
- La place des modèles spécialisés gagne en importance : tout comme un modèle d’IA incarnée traduit l’état physique en langage naturel, la couche intermédiaire transforme des entrées floues en problèmes structurés. Chaque invocation du grand modèle de langage peut ainsi être mieux ciblée.
- L’observabilité devient indispensable : une fois les couches mises en place, il faut enregistrer pour chacune le nombre d’appels, les tokens et la latence. Sans cela, impossible de savoir si une tâche doit être confiée à une couche supérieure ou inférieure.
Impact pour les responsables produit
- Le modèle de coûts devient plus prévisible : les étapes déterministes ne consomment pas de tokens ; les dépenses se concentrent surtout sur les requêtes complexes, dont le volume peut être estimé.
- Il faut accepter que « plus intelligent » ne signifie pas toujours « mieux » : confier la consultation d’une commande à un grand modèle de langage peut sembler plus intelligent, mais l’utilisateur veut avant tout une réponse exacte et rapide.
- Les indicateurs de validation doivent être définis à l’avance : la consommation de tokens, le taux de réussite des tâches et la latence de bout en bout doivent servir de référence pour comparer les approches avant la mise en production.
Impact sur le secteur
Le point de vue de Laijie illustre une approche : les grands modèles de langage fondamentaux sont de plus en plus puissants, mais cela ne signifie pas qu’il faille réunir toutes les capacités dans un seul modèle. Il s’agit plutôt de laisser des « agents » aux compétences différentes remplir chacun leur rôle. Dans le logiciel, cette approche rejoint l’évolution des appels d’outils et de l’orchestration d’agents. Cela dit, l’entretien porte sur la robotique : on manque encore de données publiques pour mesurer les bénéfices de cette approche dans les workflows logiciels. Il faudra que davantage d’équipes la mettent en pratique pour les évaluer.
Questions fréquentes (FAQ)
Q1 : Que signifie « Ne me facturez pas des tokens pour chaque vis serrée » ?
C’est une formule de Lai Jie, fondateur de Stardust Intelligence, dans une interview accordée à Aifaner en novembre 2026. Selon lui, les tâches répétitives, comme serrer des vis en usine, devraient être confiées à des programmes prédéfinis fonctionnant 24 h/24, plutôt que d’invoquer un modèle et de payer des tokens à chaque action. Dans les applications d’IA, cela signifie qu’il n’est pas nécessaire de faire appel à un grand modèle de langage pour les étapes déterministes et fréquentes.
Q2 : Peut-on appliquer directement l’approche par couches des robots aux workflows logiciels ?
Pas directement. La robotique implique le contrôle en temps réel, la perception tactile et la bande passante des communications, tandis que les workflows logiciels sont surtout limités par la facturation des tokens, la latence et la stabilité. On peut toutefois reprendre la logique de répartition : « la couche d’exécution traite elle-même les tâches et transmet les problèmes difficiles à la couche supérieure ». Les gains concrets doivent être vérifiés sur des cas réels.
Q3 : Comment savoir si une étape nécessite un petit modèle ou un grand modèle de langage ?
Examinez si les résultats possibles sont limités et si les règles sont stables. Pour les tâches aux résultats limités et aux schémas stables, comme la classification d’intentions ou l’extraction de champs, essayez d’abord un petit modèle. Réservez le grand modèle de langage aux tâches qui demandent un raisonnement global, une génération ouverte ou le traitement de cas exceptionnels. Sur APIYI apiyi.com, testez différents modèles avec le même jeu d’échantillons, puis comparez leur précision et leur consommation avant de choisir.
Q4 : Une architecture par couches réduit-elle toujours les coûts ?
Pas forcément. Si la plupart des requêtes métier sont complexes et que la couche de règles en filtre peu, les gains seront limités. À l’inverse, des règles trop larges risquent de filtrer des requêtes à tort et de réduire le taux de réussite. La bonne approche consiste à mesurer d’abord la situation initiale, puis à comparer la consommation de tokens, le taux de réussite et la latence avant et après la mise en place des couches.
Q5 : Comment créer rapidement un prototype d’invocation par couches ?
Vous pouvez suivre ces étapes :
1. Listez toutes les étapes du workflow, repérez les tâches répétitives « de type vissage » et implémentez-les avec des règles
2. Rendez-vous sur APIYI apiyi.com pour vous inscrire et obtenir une clé API, puis connectez un petit modèle et un grand modèle de langage via une interface compatible OpenAI
3. Inspirez-vous du code de cet article pour implémenter le routage et mesurer les tokens et la latence à chaque couche
L’avantage d’une interface unifiée : il suffit de modifier le paramètre `model` pour changer de modèle, ce qui facilite les comparaisons.
Q6 : Quels sont les pièges courants d’une conception par couches ?
– **Prolifération des règles** : à force d’en ajouter, elles finissent par être plus difficiles à maintenir que les invites. Il faut les nettoyer régulièrement.
– **Perte d’information entre les couches** : si le contexte n’est pas transmis au grand modèle de langage après la classification par le petit modèle, le grand modèle doit refaire le travail de compréhension.
– **Absence de solution de repli** : si les règles et le petit modèle ne parviennent pas à trancher, il faut prévoir un transfert vers un grand modèle de langage ou un humain.
« Ne me facturez pas des tokens pour chaque vis serrée » : points clés
- Origine du propos : cette idée vient d’une interview de Lai Jie, de Stardust Intelligence, publiée par 爱范儿 en novembre 2026. Il s’agit d’un point de vue de fondateur.
- Répartition des tâches : la couche d’exécution réalise les actions elle-même et ne consulte le Grand modèle de langage de base que pour obtenir du contexte sur les problèmes difficiles.
- 5 étapes comparables au serrage d’une vis : validation des formats, interrogation des données, sortie à partir de modèles, contrôle des processus et résultats trouvés dans le cache ne devraient pas nécessiter l’invocation d’un Grand modèle de langage.
- Structure en trois couches : des programmes fixes à la base, des modèles spécialisés au milieu et un Grand modèle de langage de base réservé aux questions ouvertes et aux cas exceptionnels.
- Une analogie à nuancer : les conclusions tirées de la robotique ne s’appliquent pas directement aux logiciels. Les gains doivent être vérifiés avec vos propres données.
- Trois indicateurs à suivre : comparez la consommation de tokens, le taux de réussite des tâches et la latence de bout en bout avant et après la mise en place des couches.
- Pour démarrer : l’interface unifiée d’APIYI apiyi.com permet de changer de modèle à chaque couche et de suivre la consommation.
Conclusion
L’idée « Ne me facturez pas des tokens pour chaque vis serrée » nous invite avant tout à revoir les limites d’utilisation des modèles dans nos workflows d’IA :
- Repérez d’abord les vis : confiez aux programmes fixes les étapes très déterministes, fréquentes et qui n’ont qu’une seule réponse.
- Ajoutez ensuite des modèles spécialisés : utilisez de petits modèles pour les tâches aux catégories limitées et aux schémas stables, ainsi que pour structurer les questions.
- Réservez enfin le Grand modèle de langage : le raisonnement ouvert, les décisions face aux exceptions et la génération créative sont les tâches pour lesquelles il vaut la peine de payer des tokens.
Cette méthode ne dépend ni d’un modèle précis ni d’une publication particulière : elle peut servir durablement de liste de vérification pour concevoir des agents. Au moment de la mise en œuvre, vérifiez les différences avant et après la mise en place des couches à l’aide de vos propres journaux d’activité, plutôt que de supposer que les coûts vont forcément baisser.
Si vous concevez un workflow à plusieurs couches, APIYI apiyi.com vous permet d’accéder à des modèles de différentes tailles avec une seule clé API. Vous pouvez ainsi changer de modèle à chaque couche, comparer les statistiques d’utilisation et décider, chiffres à l’appui, à qui confier chaque « vis ».
📚 Références
- 爱范儿 – Entretien avec 来杰 de 星尘智能 : 15e entretien de la rubrique « Entreprises de la diversité »
- Lien :
ifanr.com/1687805 -
Description : Source originale de la métaphore « serrer des vis et payer les tokens » et de la répartition des rôles entre modèles incarnés et grands modèles de langage de base
-
Documentation de l’API OpenAI Chat Completions : description des paramètres des interfaces compatibles avec OpenAI
- Lien :
platform.openai.com/docs/api-reference/chat - Description : Pour comprendre les champs
model,max_tokensetusage, entre autres, et faciliter le suivi de l’utilisation par couche
Auteur : Équipe technique APIYI
Échanges techniques : Contactez-nous depuis la page d’accueil du site APIYI. Consultez également le centre de documentation APIYI pour en savoir plus sur l’intégration des modèles et les statistiques d’utilisation.