Note de l’auteur : une fois qu’un nouveau modèle sort, comment vérifier avec vos propres tâches longues s’il vaut la peine de changer ? Cet article décompose la question en un processus exécutable en 5 étapes.
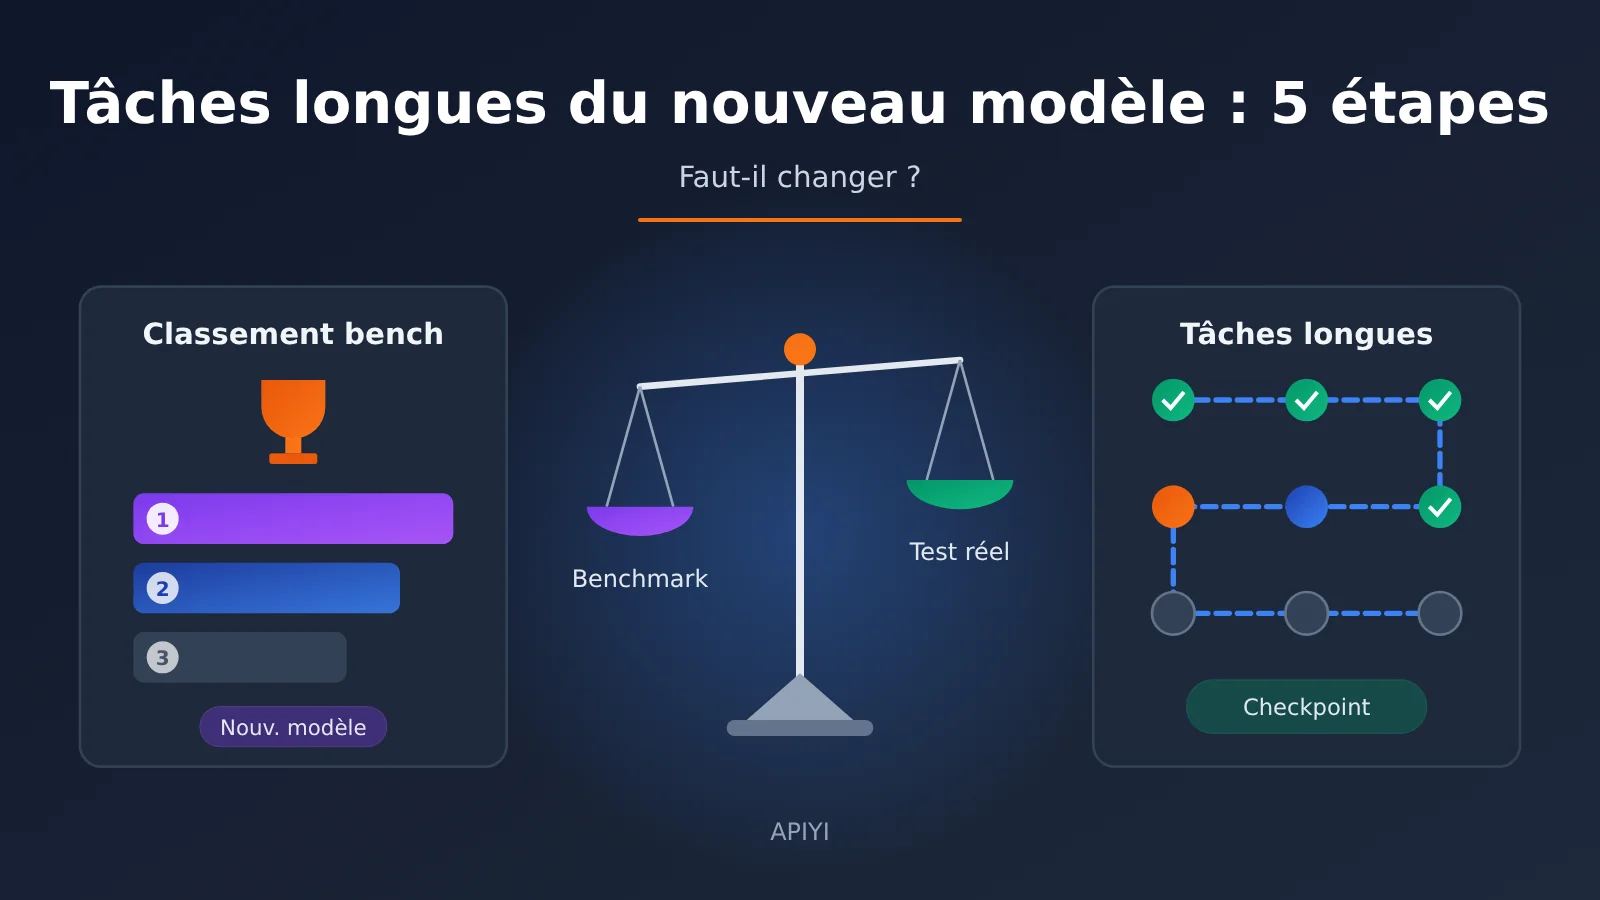
Les nouveaux modèles sortent quasiment chaque mois, et les classements de benchmarks sont sans cesse rebattus. Prenons l’exemple de Hy4, le modèle de Tencent Hunyuan officiellement publié en novembre 2026 : l’éditeur indique qu’il a été spécifiquement optimisé sur les capacités Agent et les tâches longues par rapport à la version preview, et qu’il se hisse parmi les meilleurs modèles open source sur plusieurs benchmarks. Mais pour un développeur, il n’y a en réalité qu’une seule question : est-il meilleur que le modèle que j’utilise aujourd’hui, sur mes propres tâches ? Cet article présente une méthode de validation comparative d’un nouveau modèle basée sur vos propres tâches longues, pour vous aider à aboutir en un ou deux jours à une conclusion étayée par des données.
Ce n’est pas un énième décryptage de scores de benchmark. Les classements mesurent des capacités génériques ; votre activité, elle, mesure tout autre chose : mener une tâche en plusieurs étapes du début à la fin, savoir se rattraper seul après une erreur, et combien coûte chaque livraison.
L’essentiel : à la fin de cet article, vous saurez construire un jeu de validation de tâches longues petit mais pertinent, comparer l’ancien et le nouveau modèle sur 6 indicateurs, calculer le « coût par livraison réussie » à partir de la facturation réelle, puis prendre la décision de changer — ou non.
Les points clés de la validation des tâches de longue haleine pour un nouveau modèle
Avant de se lancer, il faut bien distinguer la validation sur tâche longue du test classique à un seul tour. Un test à un seul tour juge « si une réponse est belle », alors que la validation longue durée vérifie « si l’objectif tient encore après des dizaines d’étapes ».
| Point clé | Explication | Valeur |
|---|---|---|
| Utiliser ses propres tâches | Extraire 3 à 5 tâches multi-étapes du métier réel, plutôt que de reprendre des énoncés publics | Les conclusions se traduisent directement en bénéfice métier |
| Figer le groupe de contrôle | Le modèle en production et le nouveau modèle tournent sur la même tâche, avec la même chaîne d’outils | Éliminer les écarts dus à l’invite et à l’environnement |
| Priorité aux indicateurs de processus | Noter la tenue de l’objectif, l’autocorrection, le nombre d’interventions humaines | Repérer les problèmes de stabilité que les benchmarks ne montrent pas |
| Calculer le coût par livraison | Raisonner en « coût en tokens par livraison réussie » | Éviter de se tromper en ne regardant que le prix unitaire |
| Fixer un seuil de changement de modèle | Écrire à l’avance le critère « quel gain justifie de changer » | Ne pas se laisser influencer par un seul cas impressionnant |
Pourquoi la validation sur tâche longue est plus fiable que les benchmarks
Les sujets des classements publics sont en général fermés et à chaîne courte, alors qu’un vrai travail d’Agent est exactement l’inverse. L’évaluation citée en référence confie à Hy4 une tâche longue : enchaîner recherche, développement, revue, corrections, jusqu’à un jeu 3D jouable, avec en plus, en cours de route, une vidéo de référence et de nouvelles exigences. Ce type de tâche met à l’épreuve la capacité du modèle, à mesure que les étapes s’accumulent, à se souvenir du plan initial, à distinguer ce qui est terminé de ce qui reste à faire, et à ajuster son plan quand un résultat intermédiaire ne correspond pas aux attentes.
Un autre phénomène mérite attention : l’effet de synergie « modèle + chaîne d’outils ». Dans la même évaluation, Hy4 a généré en une demi-heure, dans WorkBuddy, 14 PPT, un fichier Excel et un document Word de 19 pages. Les évaluateurs précisent d’ailleurs que le modèle se charge de comprendre, planifier et juger, tandis que la chaîne d’outils se charge de lire, calculer, rendre et écrire. Autrement dit, pour valider un nouveau modèle, il faut impérativement le faire tourner dans votre propre chaîne d’outils : des conclusions hors contexte ont une valeur de référence limitée.
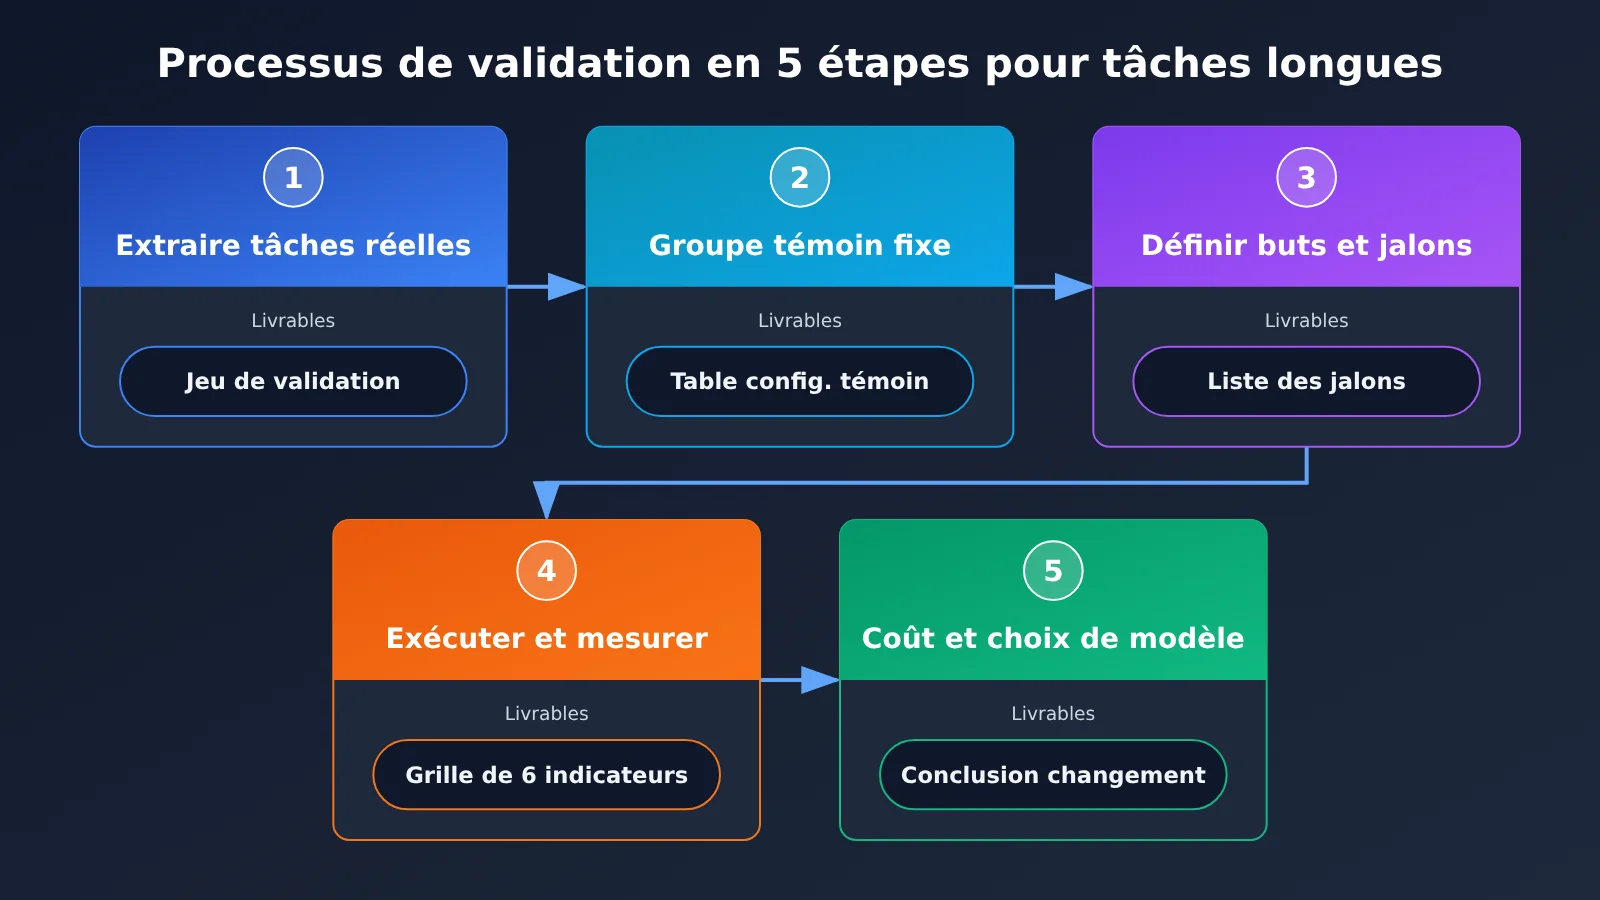
Prise en main rapide de la validation des tâches à long horizon pour les nouveaux modèles : un processus en 5 étapes
La procédure ci-dessous ne dépend d’aucun framework particulier. Tant que vos appels de modèle passent par une interface unifiée, vous pouvez changer de modèle à faible coût pour effectuer des comparaisons.
Étape 1 : extraire des tâches à long horizon à partir de cas métier réels
L’ensemble de validation n’a pas besoin d’être volumineux : il doit surtout être représentatif. Je vous conseille de choisir 3 à 5 tâches couvrant les trois types de scénarios les plus fréquents, les plus gourmands en main-d’œuvre et les plus sujets à erreurs dans votre activité. Chaque tâche doit idéalement remplir trois conditions : comporter au moins 10 étapes, nécessiter l’appel d’outils et aboutir à un livrable clair.
Vous pouvez vous inspirer des types de tâches à long horizon suivants pour concevoir votre propre version :
- Traitement documentaire par lots : à partir d’un dossier contenant une dizaine de documents, demander un résumé de chacun, produire des supports de reporting, puis tout consolider dans un tableau et un rapport.
- Développement d’applications : à partir d’une description du besoin, réaliser le développement, les tests et les corrections, puis livrer au final un produit exécutable.
- Reproduction multimodale : envoyer une capture d’écran ou un enregistrement d’écran, demander au modèle de comprendre le contenu, puis de reproduire l’interface ou les interactions correspondantes.
- Opérations sur ordinateur : demander au modèle de regarder l’écran, de trouver les boutons, de cliquer et de saisir des informations pour mener à bien un processus impliquant plusieurs logiciels.
Étape 2 : Fixer le groupe de contrôle et l’environnement d’exécution
La clé d’une expérience contrôlée, c’est de « ne changer qu’une seule variable ». L’ancien et le nouveau modèle doivent utiliser la même invite système, le même ensemble de définitions d’outils et les mêmes documents d’entrée. Je vous recommande d’exécuter chaque tâche au moins 3 fois, puis de prendre la moyenne et la pire valeur, car la variabilité des tâches longues est bien plus élevée que celle d’un simple échange question-réponse.
| Élément de configuration | Réglage recommandé | Explication |
|---|---|---|
model |
Modèle actuel vs nouveau modèle | Le seul paramètre autorisé à varier |
temperature |
Identique dans les deux groupes, plutôt basse | Réduit l’impact du hasard sur les conclusions |
max_tokens |
Prévoir une marge selon la sortie la plus longue de la tâche | Évite de sous-estimer le modèle à cause d’une troncature |
Définition des outils tools |
Liste de fonctions et descriptions strictement identiques | Une différence dans la description des outils influence nettement le comportement d’appel |
| Invite système | Même version, sans optimisation pour le nouveau modèle | On teste d’abord « tel quel », puis les performances après optimisation |
| Nombre de répétitions | Au moins 3 par tâche | Observer la stabilité plutôt que le meilleur score |
Si votre projet utilise à la fois des interfaces de style OpenAI et de style Anthropic, changer de modèle implique souvent de changer de SDK, d’authentification et de format de requête, ce qui complique sérieusement l’expérience contrôlée. En passant par une plateforme d’agrégation d’API unifiée, il suffit de modifier le champ model pour effectuer le changement.
🚀 Conseil pour démarrer rapidement : APIYI apiyi.com propose les appels API des principaux modèles évoqués dans cet article, et reste compatible avec les formats d’interface OpenAI et Anthropic. Pour une expérience contrôlée, il suffit de remplacer le paramètre
modelpour basculer entre l’ancien et le nouveau modèle. Pour le mode d’intégration, lebase_urlet la configuration de l’authentification, référez-vous au centre de documentation APIYI docs.apiyi.com.
Étape 3 : définir des ancrages d’objectif et des points de contrôle pour la tâche
Le mode d’échec le plus fréquent des tâches de longue haleine n’est pas « ne pas savoir faire », mais « oublier en cours de route ce qu’on était censé faire ». L’évaluation de référence utilise l’instruction /goal pour contraindre le modèle à garder en permanence un objectif concret ; cette approche se transpose à n’importe quel environnement de validation. Vous pouvez écrire clairement l’objectif final au début de la tâche, et découper les livrables en plusieurs jalons vérifiables.
Prenons l’exemple de la tâche « mini-jeu 3D réaliste » : l’évaluateur a découpé l’objectif en 5 éléments — scène de jeu, visuel et sensations, son et gameplay, flux de travail, livraison finale. Vos propres tâches devraient être découpées de la même manière, chaque jalon correspondant à un point de contrôle dont on peut juger objectivement s’il est « terminé / non terminé ». La notation n’en sera que plus simple par la suite.
Étape 4 : exécuter et enregistrer 6 indicateurs
À chaque exécution, conservez l’intégralité des journaux de conversation et d’appels d’outils, puis notez selon le tableau ci-dessous. Les 4 premiers mesurent « est-ce qu’on arrive à finir », les 2 derniers mesurent « est-ce que ça vaut le coup ».
| Indicateur | Comment le mesurer | Mode de notation |
|---|---|---|
| Taux d’achèvement de la tâche | Nombre de points de contrôle terminés / nombre total de points de contrôle | Pourcentage, moyenne sur 3 exécutions |
| Maintien de l’objectif | La seconde moitié de l’exécution progresse-t-elle toujours vers l’objectif initial, sans oubli ni hors-sujet ? | Note manuelle de 1 à 5 |
| Capacité d’auto-correction | Après une erreur en cours de route (message d’erreur, test échoué), le modèle parvient-il à corriger seul ? | Noter « nombre d’erreurs / nombre d’auto-rétablissements » |
| Nombre d’interventions humaines | Nombre de tours nécessitant un complément d’explication ou un recadrage humain | Moins il y en a, mieux c’est |
| Durée | Temps réel écoulé (wall clock) entre le lancement et la livraison | En minutes, temps d’exécution des outils inclus |
| Coût par livraison | Coût total en tokens / nombre de livraisons réussies | Calculé selon la facturation réelle |
Le « nombre d’interventions humaines » mérite une attention particulière. La conclusion de l’évaluation de référence est que Hy4 parvient globalement à livrer en une seule passe la plupart des tâches bureautiques quotidiennes et créatives, mais que dans les travaux impliquant de nombreuses manipulations d’ordinateur et des processus complexes, plusieurs tours d’interaction restent nécessaires pour l’aider à comprendre l’intention. C’est précisément l’écart que vous devez quantifier sur vos propres tâches : une intervention, c’est un coût humain en plus.
Étape 5 : calculer les coûts et prendre la décision de changer de modèle
Le calcul des coûts doit se faire à l’échelle de « chaque livraison réussie », et non en comparant simplement les prix unitaires d’entrée et de sortie. Un modèle dont le prix unitaire est faible, mais qui nécessite deux réexécutions, peut en réalité coûter plus cher. Les tâches de longue durée ont aussi une particularité : le contexte transporte répétitivement l’historique, et le taux de réussite du cache a donc un impact important sur le coût total.
La logique de calcul est la suivante : coût d’une tâche = tokens d’entrée sans cache × prix unitaire d’entrée + tokens d’entrée avec cache × prix du cache + tokens de sortie × prix unitaire de sortie ; puis on divise le coût total de plusieurs exécutions par le nombre de livraisons réussies. Pour les prix d’entrée, les prix de sortie, les prix du cache et la base de facturation de chaque modèle, il faut se référer aux données réelles de la page de tarifs APIYI docs.apiyi.com/models. Cet article ne donne pas de chiffres précis afin d’éviter toute confusion liée aux variations de prix.
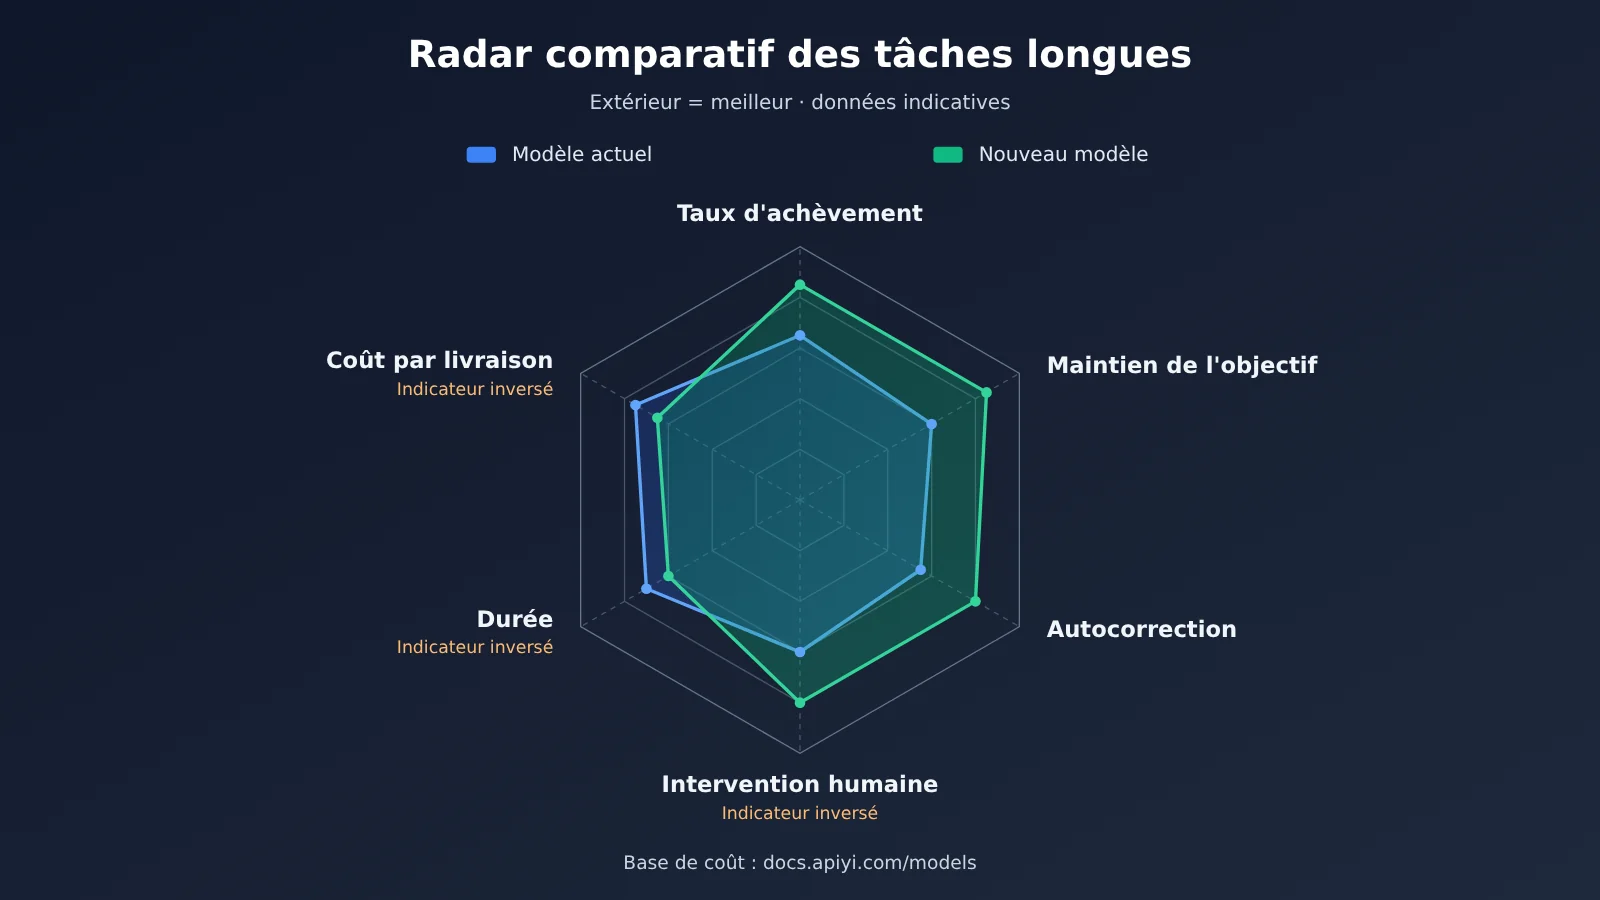
💰 Conseil pour le calcul des coûts : lors de la comparaison, il est recommandé d’appeler les anciens et les nouveaux modèles sur la même plateforme, afin que les statistiques d’utilisation et la base de facturation soient identiques ; le « coût par livraison réussie » calculé sera alors réellement comparable. La page de tarifs APIYI docs.apiyi.com/models indique les prix d’entrée, de sortie et de cache de chaque modèle, et peut servir directement de base au calcul.
Critères de décision pour valider un nouveau modèle sur des tâches de longue durée
Une fois les données collectées, la pire situation est de se retrouver face à un « chacun a ses atouts, impossible de trancher ». Je vous conseille d’écrire les règles de décision avant même de lancer l’expérience. Le tableau ci-dessous peut servir de point de départ, puis vous ajustez les seuils selon la sensibilité de votre activité.
| Résultat de la comparaison | Décision recommandée | Raison |
|---|---|---|
| Taux d’achèvement nettement amélioré, coût de livraison par tâche stable ou en baisse | Basculer directement | La qualité et le coût progressent en même temps |
| Taux d’achèvement nettement amélioré, coût en hausse | Basculer selon le scénario | Utiliser le nouveau modèle uniquement pour les tâches à forte valeur et difficiles |
| Taux d’achèvement stable, coût nettement en baisse | Bascule progressive | Remplacer d’abord sur les tâches à faible risque, puis observer pendant un certain temps |
| Taux d’achèvement stable, nombre d’interventions réduit | Envisager le basculement en priorité | Le temps de travail économisé vaut souvent plus que le coût en tokens |
| Taux d’achèvement en baisse ou stabilité moins bonne | Ne pas basculer pour l’instant | Attendre la version suivante ou retester après avoir ajusté l’invite |
Il existe aussi une dimension souvent négligée : la refonte des tâches rendue possible par les nouvelles capacités. Par exemple, Hy4 ajoute cette fois la compréhension visuelle : il peut lire directement un enregistrement d’écran et l’analyser image par image, mais aussi prendre régulièrement des captures de ses propres productions et s’auto-évaluer pour s’améliorer. Si votre ancien processus demandait à une personne de convertir manuellement des captures d’écran en descriptions textuelles, le nouveau modèle n’apporte peut-être pas seulement un « meilleur résultat sur la même tâche », mais aussi « une étape en moins dans tout le processus ». Ce type de gain doit être consigné séparément : ne le mesurez pas uniquement avec les scores des anciennes tâches.
Repères de choix lors d’une comparaison entre modèles courants
Pour une comparaison, on teste généralement le nouveau modèle face au modèle en production, mais aussi face à d’autres candidats du même niveau. Le tableau ci-dessous donne une logique de sélection ; les capacités précises doivent être vérifiées avec vos propres tests sur des tâches de longue durée.
| Type de candidat | Tâches longues adaptées | Points de validation | Plateformes disponibles |
|---|---|---|---|
| Nouveau modèle open source ou domestique récemment publié | Traitement par lots de documents bureautiques, agents pour scénarios en chinois | Capacité à tenir l’objectif, rapport qualité-prix | APIYI apiyi.com, etc. |
| Modèle propriétaire principal actuellement en production | Programmation complexe, raisonnement difficile | Comme référence de qualité | APIYI apiyi.com, etc. |
| Modèle doté de capacités multimodales | Reproduction de captures d’écran ou d’enregistrements d’écran, compréhension des interfaces | Précision de la compréhension visuelle, autocorrection | APIYI apiyi.com, etc. |
| Modèle léger et rapide | Distribution de sous-tâches, mise en forme | Durée et coût | APIYI apiyi.com, etc. |
💡 Conseil de choix : ne comparez pas un seul candidat au modèle en production. En plaçant deux ou trois candidats supplémentaires dans le même jeu de validation via une interface unifiée, on découvre souvent une meilleure solution : une combinaison adaptée à chaque scénario. APIYI prend en charge l’appel unifié de plusieurs modèles courants, ce qui facilite la mise en œuvre rapide de ce type de combinaison.
FAQ – Questions fréquentes
Q1 : Qu’est-ce que la validation sur tâches longues d’un nouveau modèle ?
La validation sur tâches longues consiste à tester un modèle avec de vraies tâches comportant plusieurs étapes, nécessitant l’appel d’outils et aboutissant à un livrable clair. Ce qui compte, c’est la capacité du modèle à garder son objectif au fil des étapes, à se corriger après une erreur, et le coût final de la livraison — pas la qualité d’une réponse isolée.
Q2 : Quelle différence entre la validation sur tâches longues et les benchmarks publics ?
Les benchmarks sont précieux pour comparer les capacités générales de façon transversale, mais leurs énoncés sont assez éloignés de votre métier et il s’agit souvent de tâches courtes. La validation sur tâches longues, elle, s’exécute directement sur votre chaîne d’outils et vos données : elle révèle l’oubli d’objectif, le mauvais usage des outils, les corrections humaines à répétition, etc. Le plus sûr est de combiner les deux : filtrer les candidats avec les classements, puis décider avec vos propres tâches.
Q3 : Combien de temps après la sortie d’un nouveau modèle faut-il commencer à tester ?
Mieux vaut lancer une première salve de tests « prêts à l’emploi » dès que possible après la publication : beaucoup de nouveaux modèles offrent une période gratuite limitée ou une phase d’essai. Dans les sources citées, Hy4 proposait par exemple une période gratuite du 4 au 15 novembre sur WorkBuddy. Si les premiers résultats sont bons, prenez ensuite le temps d’ajuster vos invites pour le nouveau modèle et de faire un deuxième tour de tests.
Q4 : Combien de tâches faut-il dans un jeu de validation ?
Trois à cinq tâches très proches de votre activité suffisent généralement pour tirer une conclusion sur la direction à prendre, en répétant chaque tâche trois fois pour observer la stabilité. Plutôt que d’empiler les volumes, mieux vaut couvrir vos scénarios les plus fréquents, les plus gourmands en main-d’œuvre et les plus sujets à erreurs, avec des points de contrôle clairs pour chaque tâche.
Q5 : Comment comparer plusieurs modèles à moindre coût ?
Le plus simple est de passer par une plateforme d’API unifiée. APIYI apiyi.com est compatible avec les formats d’API d’OpenAI et d’Anthropic : changer de modèle revient à modifier le paramètre `model`, sans toucher à la définition des outils ni aux invites. Les étapes d’intégration détaillées se trouvent dans le centre de documentation docs.apiyi.com.
Q6 : Comment calculer correctement le coût d’une tâche longue ?
Il faut raisonner en « coût par livraison réussie », c’est-à-dire le total des frais de tokens sur plusieurs exécutions divisé par le nombre de livraisons réussies, en distinguant la part d’entrée avec et sans cache. Pour les tarifs unitaires et les prix du cache de chaque modèle, référez-vous aux données réelles de la page tarifs d’APIYI docs.apiyi.com/models : une facturation unifiée sur une même plateforme rend la comparaison plus équitable.
Q7 : Quelles sont les limites de la validation sur tâches longues ?
Premièrement, l’échantillon est restreint : un succès ou un échec isolé peut être accidentel, d’où la nécessité de répéter les exécutions. Deuxièmement, la notation humaine est subjective : mieux vaut faire noter deux personnes indépendamment et faire la moyenne. Troisièmement, les résultats dépendent fortement de la chaîne d’outils : après un changement de framework d’agent, il faut retester. Enfin, le plafond de capacité évalué dépend souvent de la difficulté des tâches de test : il faut donc enrichir régulièrement le jeu de validation avec des tâches plus difficiles.
Validation des tâches longue durée des nouveaux modèles : points clés
- Parlez avec vos propres tâches : 3 à 5 tâches réelles à plusieurs étapes valent mieux que n’importe quel classement pour estimer le gain réel d’un changement de modèle.
- Ne changez qu’une seule variable : ancien et nouveau modèles partagent les mêmes invites, outils et entrées, avec au moins 3 exécutions par tâche.
- Un point d’ancrage d’objectif est indispensable : inspirez-vous de l’approche
/goalpour découper les jalons ; plus les points de contrôle sont objectifs, plus la notation est juste. - Six indicateurs pour une vue complète : taux de réussite, maintien de l’objectif, autocorrection, nombre d’interventions, durée, coût de livraison.
- Calculez le coût à la livraison : distinguez les hits de cache, en vous appuyant sur la page tarifaire APIYI docs.apiyi.com/models.
- Pensez à la refonte des processus : de nouvelles capacités comme la compréhension visuelle peuvent supprimer directement des étapes manuelles de l’ancien flux.
En résumé
Les points essentiels de la validation des tâches longue durée d’un nouveau modèle :
- Des tâches réelles : le jeu de validation vient du métier et couvre les scénarios fréquents, chronophages et propices aux erreurs.
- Une comparaison rigoureuse : environnement figé, exécutions répétées et seuil de bascule défini à l’avance par écrit.
- Un calcul carré : mesurez le gain réel avec le coût d’une livraison réussie et le nombre d’interventions manuelles.
Chaque sortie d’un nouveau modèle est une occasion de réexaminer son flux de travail. Plutôt que de se laisser guider par les classements et les vidéos de démonstration, mieux vaut consacrer un jour ou deux à obtenir une réponse claire avec ses propres tâches longue durée. Je recommande de passer par APIYI apiyi.com pour placer ancien et nouveau modèles sous la même interface et comparer rapidement ; les instructions d’intégration sont sur docs.apiyi.com, et les données de facturation font foi sur docs.apiyi.com/models.
📚 Références
- ifanr – Test réel de Tencent Hy4 : cas concrets sur les tâches longues, le multimodal et le pilotage d’ordinateur de Hy4
- Lien :
ifanr.com/1687613 -
Description : propose une conception de test réutilisable — contrainte d’objectif via
/goal, développement de jeu sur tâche longue, traitement par lots de documents, etc. -
Centre de documentation APIYI : intégration des modèles et format des interfaces
- Lien :
docs.apiyi.com -
Description : voir comment configurer les interfaces compatibles OpenAI et Anthropic
-
Page des tarifs des modèles APIYI : prix d’entrée, de sortie et de cache de chaque modèle
- Lien :
docs.apiyi.com/models - Description : la seule référence tarifaire pour le calcul des coûts
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil d’APIYI apiyi.com ; d’autres ressources sur l’intégration des modèles sont disponibles dans le centre de documentation docs.apiyi.com