Note de l’auteur : cet article explique, à travers trois dimensions — la difficulté de la tâche, le coût d’une erreur et la taille du contexte — comment router les grands modèles de langage par niveaux de tâches, afin de réserver le modèle phare aux requêtes qui en ont réellement besoin.
Pour beaucoup d’équipes, la première étape de l’intégration d’un grand modèle de langage consiste à envoyer toutes les requêtes au modèle phare le plus puissant du moment. Au stade du prototype, cela ne pose aucun problème. Mais dès que le volume de requêtes augmente, la facture grimpe vite — alors que la majorité de ces requêtes pourraient très bien être traitées par un modèle de taille petite ou moyenne. Cet article présente une méthode concrète pour router les grands modèles par niveaux de tâches, afin de vous aider à déterminer quelles requêtes méritent vraiment le modèle phare.
Il ne s’agit pas d’un article militant pour « les modèles bon marché sont tout aussi bons ». Le modèle phare conserve un avantage net sur le raisonnement complexe, les modifications de code à longue chaîne et les sorties à haut risque. Le routage par niveaux vise à « confier la bonne requête au bon modèle », et non à réduire les coûts à tout prix.
L’essentiel : à la fin de cet article, vous disposerez d’une grille de classification des tâches en 3 niveaux, d’une liste de contrôle pour configurer vos règles de routage, ainsi que d’une méthode pour calibrer votre stratégie de routage à partir des données une fois le service en production.
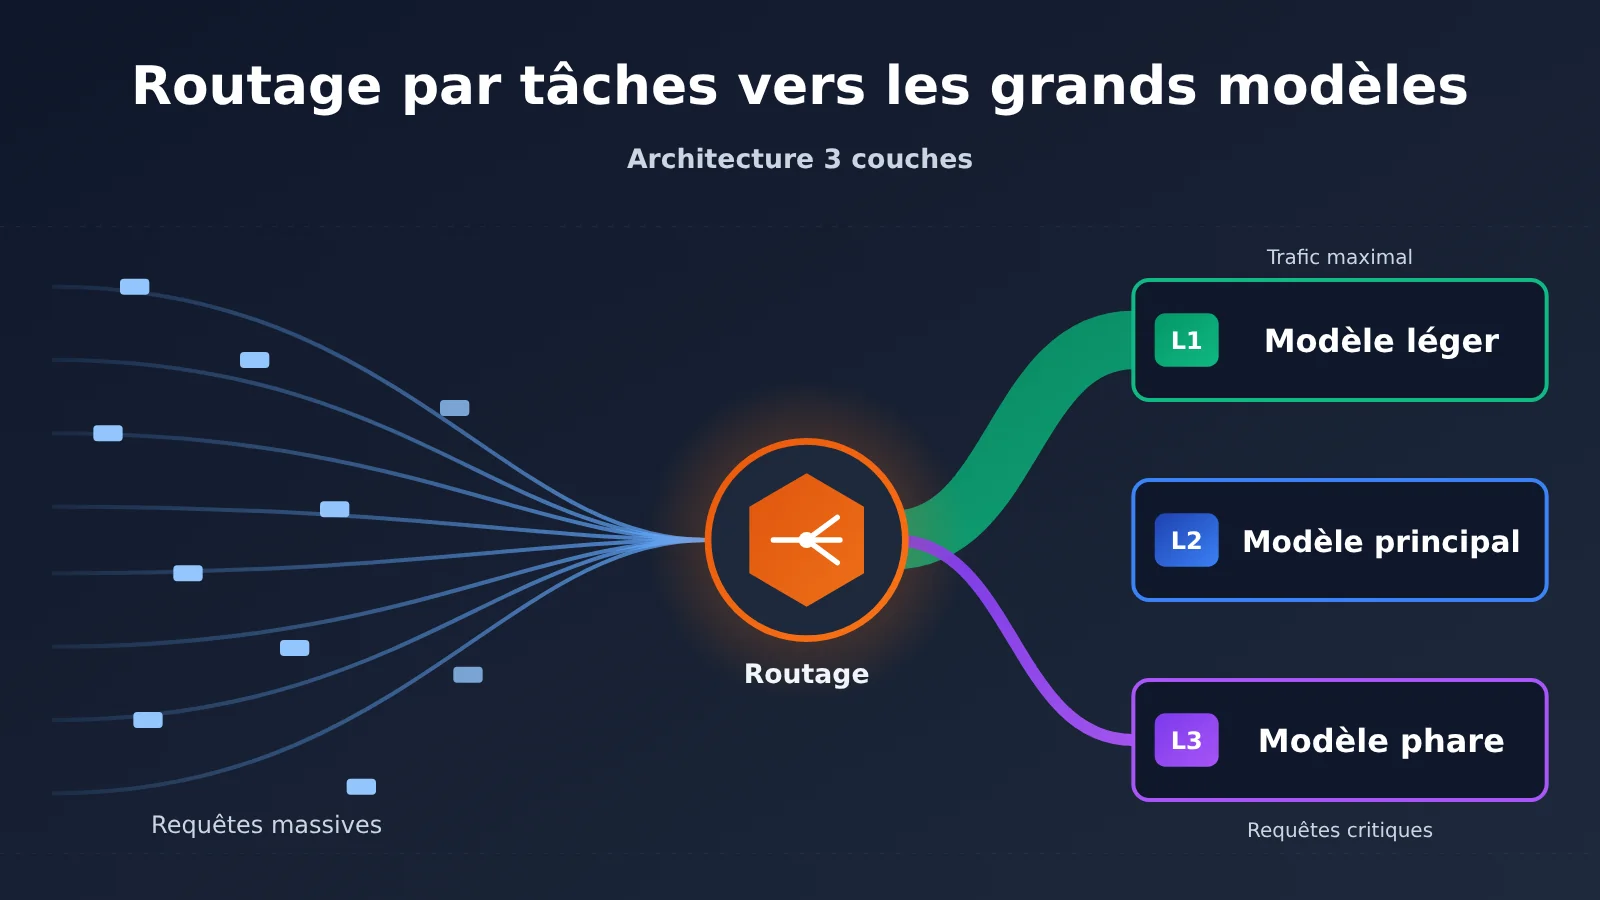
Points clés du routage des grands modèles de langage par niveau de tâche
Avant d’entrer dans la configuration concrète, posons les principaux critères de décision du routage par niveaux. Ce sont eux qui déterminent à quel niveau une requête doit être traitée, et qui conditionnent la maintenabilité de la stratégie de routage.
| Point clé | Explication | Valeur |
|---|---|---|
| Segmenter par tâche, pas par utilisateur | Les requêtes d’un même utilisateur peuvent avoir des niveaux de difficulté très différents ; il faut donc se baser sur les caractéristiques de chaque tâche pour router | Évite le gaspillage lié au principe « tous les utilisateurs VIP passent par le modèle phare » |
| Le coût d’une erreur prime sur la difficulté de la tâche | Une tâche simple mais dont une erreur a de lourdes conséquences peut nécessiter un modèle phare ou une double vérification | Limite les risques d’incident en production |
| Par défaut, passer par la couche intermédiaire, puis monter ou descendre selon les signaux | Le modèle principal absorbe la majorité du trafic ; on monte ou descend seulement lorsque certaines conditions sont remplies | Peu de règles, maintenance et retour arrière faciles |
| En cas d’échec, montée de niveau possible | Si la sortie d’un modèle de niveau inférieur ne passe pas la validation, on réessaie automatiquement avec un niveau supérieur | Échange un faible coût de nouvelles tentatives contre une meilleure qualité globale |
| Calibrer à partir des données | Consigner le taux de réussite, le taux de nouvelle tentative et le coût par tâche de chaque niveau, puis ajuster régulièrement les seuils | Garde la stratégie de routage pertinente au fil des itérations des modèles |
Zoom sur le routage par niveaux : pourquoi ne pas tout confier au modèle phare
En 2026, le paysage des modèles rend le routage par niveaux encore plus nécessaire. Prenons l’exemple des informations publiques citées dans les sources : OpenAI a publié GPT-5.5 le 24 avril 2026, avec une fenêtre de contexte de l’ordre du million de tokens ; le même jour, DeepSeek a lancé la série V4, déclinée en Pro et Flash, également compatible avec un contexte de 1M et publiée en poids ouverts sous licence Apache 2.0. En parallèle, les séries Claude Opus, Gemini 3.1 Pro et Kimi K2.6 continuent de réduire l’écart sur les tâches de code et de raisonnement.
Quand les scores des modèles leaders sur les benchmarks courants se rapprochent, le « coût par tâche » devient l’indicateur clé pour les distinguer. Un article d’évaluation tiers indique que les scores de plusieurs modèles sur les benchmarks de code sont désormais très proches, et que la véritable différence se fait sur le coût nécessaire pour accomplir chaque tâche. Un autre article analyse que, dans des scénarios d’agent de code comme Claude Code, la majeure partie des tokens consommés n’a pas besoin d’être traitée par le modèle le plus haut de gamme. Il s’agit là d’opinions de tiers ; les proportions exactes varient selon l’activité, mais la direction est claire : réserver le modèle phare aux cas où il apporte vraiment de la valeur est plus rentable que de l’utiliser partout.
Un autre point souvent négligé est la latence. Les modèles phares réfléchissent généralement plus profondément et produisent des réponses plus longues ; pour des tâches instantanées comme la classification, l’extraction ou la réécriture, le temps d’attente de l’utilisateur augmente donc. Les sources mentionnent qu’après que GPT-5.5 Instant est devenu le modèle par défaut de ChatGPT, la longueur des réponses a nettement diminué et le taux d’hallucination a baissé, ce qui montre que les versions allégées pensées pour les « questions-réponses rapides » sont elles-mêmes une direction produit assumée par les éditeurs.
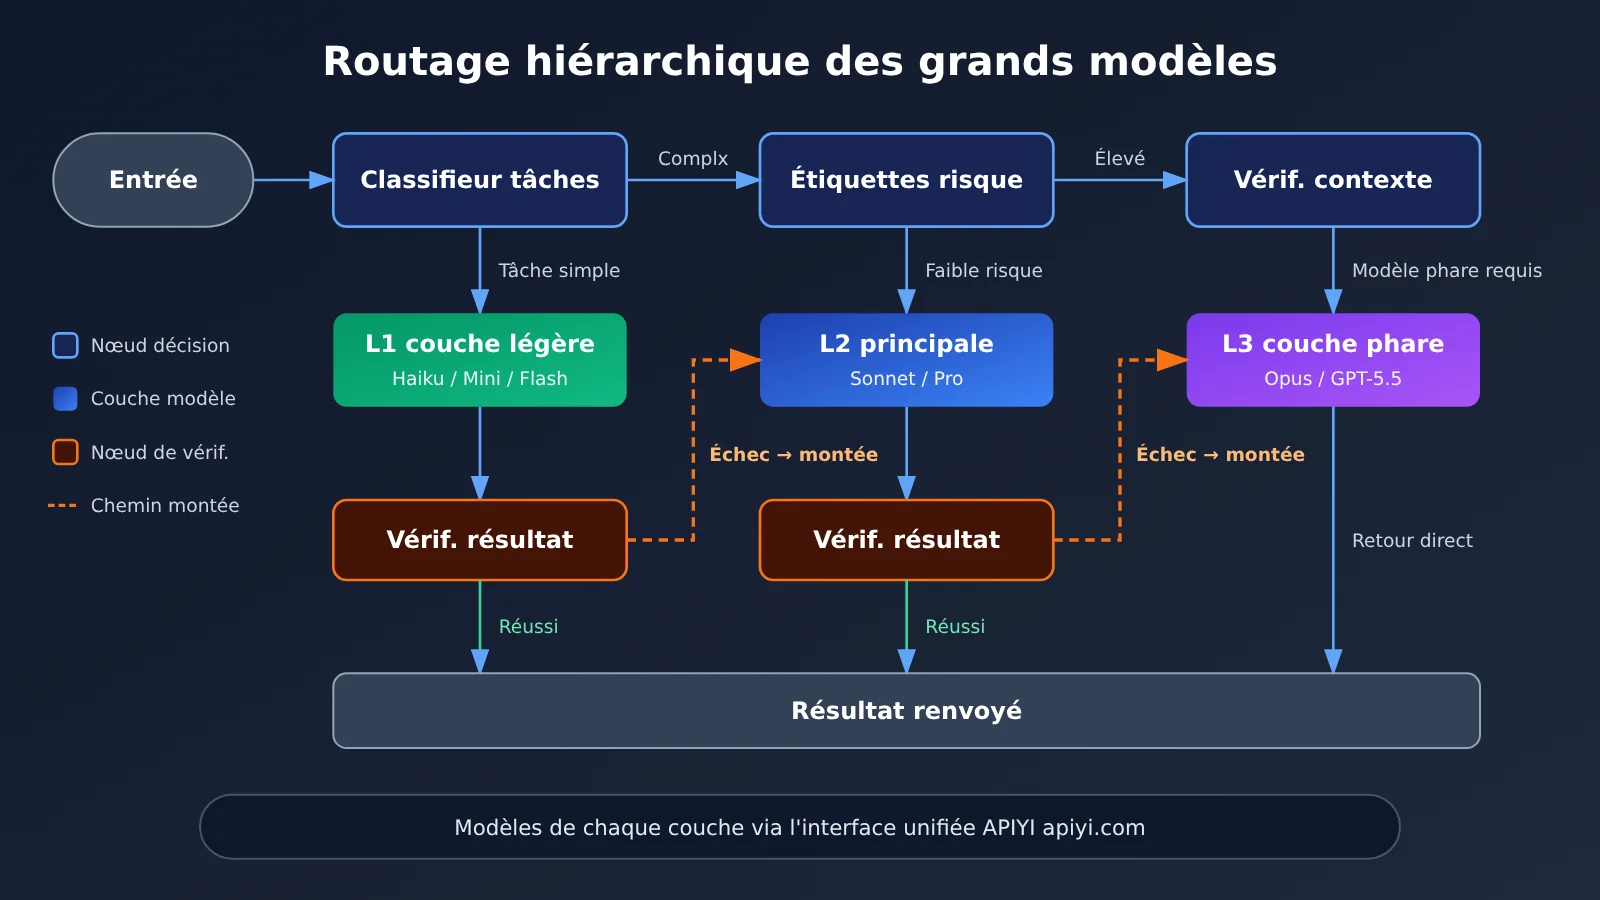
Comment répartir le routage par couches d’un grand modèle de langage en 3 niveaux de tâches
Le principe du routage par couches, c’est de trouver pour chaque type de tâche le modèle « juste assez puissant ». Le tableau ci-dessous récapitule une méthode de découpage générique que nous avons dégagée au fil de plusieurs projets ; libre à vous d’ajouter ou de retirer des lignes selon votre activité.
| Niveau | Tâches typiques | Signaux de décision | Type de modèle recommandé |
|---|---|---|---|
| L1 Couche légère | Classification d’intention, extraction de mots-clés, conversion de format, réécriture de textes courts, questions-réponses simples | Entrée courte, sortie structurée fixe, règles de validation explicites | Modèles de niveau Haiku, Mini, Flash |
| L2 Couche principale | Dialogue courant, résumé de documents, génération de code de complexité moyenne, questions-réponses RAG | Nécessite une certaine capacité de compréhension et d’organisation, mais les erreurs peuvent être détectées et corrigées | Modèles de niveau Sonnet, grands modèles open source à beaucoup de paramètres, modèles généralistes de niveau Pro |
| L3 Couche phare | Raisonnement en plusieurs étapes, refactorisation de code multi-fichiers, conception d’architecture, productions à haut risque (juridique, financier, etc.) | Dépendances en plusieurs étapes, erreurs discrètes et coûteuses, analyse synthétique sur un contexte très long | Modèles phares de niveau Opus, GPT-5.5, etc. |
Comment identifier les tâches de la couche L1 (légère)
La caractéristique clé de la couche L1, c’est que « la sortie peut être vérifiée par un programme ». Par exemple, une classification d’intention ne peut choisir qu’une seule étiquette parmi un ensemble fixe, une extraction JSON peut être validée par un schéma, et une conversion de format peut être contrôlée par la complétude des champs. Tant que les règles de validation sont suffisamment strictes, les erreurs du modèle léger peuvent être interceptées automatiquement et traitées par escalade.
Dans les documents de référence, des articles comparatifs indiquent que de petits modèles comme Claude Haiku 4.5 et GPT-5.4 Mini ont chacun leurs points forts : le premier est meilleur en qualité de code, le second est plus rapide. Ces modèles conviennent bien au trafic à haute fréquence et à faible complexité ; ils constituent la principale source d’économies dans un routage par niveaux.
Comment identifier les tâches de la couche L2 (principale)
La couche L2 prend en charge la majorité des requêtes « qui demandent de la réflexion, sans être vraiment difficiles », et c’est aussi la cible de routage par défaut recommandée. Placer la valeur par défaut au niveau intermédiaire présente deux avantages : éviter qu’une erreur de classification ne fasse rétrograder un grand nombre de requêtes complexes vers la couche légère, et garder les règles d’escalade et de rétrogradation simples.
Les performances des modèles open source à ce niveau méritent l’attention. Des évaluations tierces citées dans les documents de référence estiment que DeepSeek V4 Flash n’est pas très loin de V4 Pro sur les tâches de codage aux contours bien définis, et que l’écart entre Kimi K2.6 et Claude Opus 4.6 sur les principaux benchmarks de codage ne se compte qu’en quelques points. Autrement dit, beaucoup de tâches de codage qui étaient auparavant confiées par défaut au modèle phare peuvent d’abord être tentées sur la couche principale.
Comment déterminer si une tâche relève de la couche L3 (modèles phares)
Les requêtes qui méritent vraiment un modèle phare remplissent généralement au moins deux des conditions suivantes :
- Chaîne de raisonnement longue : nécessite une planification en plusieurs étapes et une vérification répétée des conclusions intermédiaires, par exemple localiser un bug complexe, prouver un théorème mathématique ou planifier sous de nombreuses contraintes.
- Erreur difficile à repérer et coûteuse : la sortie semble plausible, mais une erreur de détail est très difficile à détecter, par exemple analyser des clauses contractuelles, effectuer un calcul selon une convention comptable précise ou écrire du code lié à la sécurité.
- Synthèse contextuelle complexe : il faut relier des informations entre paragraphes dans des centaines de milliers de tokens, et pas seulement retrouver un extrait.
- Échec des couches inférieures : la sortie de la couche L2 n’a pas passé la validation, ou l’utilisateur a clairement indiqué que le résultat n’était pas utilisable.
🎯 Conseil technique : le routage par couches suppose de se connecter à plusieurs modèles. Si chaque fournisseur impose son propre contrat et sa propre adaptation du SDK, les coûts de maintenance finissent par annuler les bénéfices du routage. APIYI apiyi.com propose l’accès API aux séries de modèles abordées dans cet article — GPT, Claude, Gemini, DeepSeek, etc. — et reste compatible avec les deux formats d’interface OpenAI et Anthropic. En général, il suffit de modifier le paramètre du nom du modèle pour passer de l’un à l’autre.
Routage par niveaux des grands modèles de langage : prise en main rapide
Nous présentons ci-dessous une solution de routage par niveaux minimale et opérationnelle sous forme de liste de configuration. Cet article ne contient pas d’extraits de code : les principaux éléments de configuration sont décrits dans des tableaux, à vous de les implémenter avec le framework que vous utilisez.
Étape 1 : couche d’accès unifiée
Le routage par niveaux repose sur un principe simple : changer de modèle sans changer de code. Toutes les requêtes de modèle passent par une fonction d’appel unifiée. Cette fonction reçoit uniquement le type de tâche, le contenu du message et un paramètre facultatif de remplacement du niveau. En interne, les règles de routage déterminent ensuite le modèle réellement appelé.
Côté intégration, si votre projet utilise déjà le SDK OpenAI, vous pouvez continuer avec l’interface de style chat completions. Si vous utilisez le SDK Anthropic, vous pouvez conserver l’interface de style messages. APIYI prend en charge ces deux formats. Pour l’adresse d’accès, l’authentification et la liste des noms de modèles, reportez-vous aux indications du centre de documentation APIYI docs.apiyi.com.
Étape 2 : définir les règles de routage
Le tableau ci-dessous présente les éléments de configuration les plus courants d’un ensemble de règles de routage. Il est conseillé de les placer dans un fichier de configuration séparé, afin de pouvoir les ajuster sans redémarrer le service.
| Élément de configuration | Signification | Piste de valeur recommandée |
|---|---|---|
task_type |
Étiquette du type de tâche, comme classify, extract, summarize, code, reason | À définir directement depuis le point d’entrée métier ; c’est plus stable qu’une classification par modèle |
default_tier |
Niveau utilisé lorsqu’aucune règle ne correspond | Conseillé : L2, le niveau principal |
risk_level |
Étiquette de risque métier : low, medium, high | high est routé directement vers L3 ou déclenche une étape de validation supplémentaire |
context_threshold |
Seuil du nombre de tokens d’entrée déclenchant une montée de niveau | À définir selon la fenêtre de contexte et le comportement sur les longs textes de chaque modèle |
validator |
Méthode de validation de la sortie : schéma JSON, expression régulière, test unitaire, revue par un second modèle | Obligatoire pour L1, recommandé pour L2 |
max_escalation |
Nombre maximal de montées de niveau après un échec de validation | Généralement 1 à 2, pour éviter les nouvelles tentatives infinies |
tier_model_map |
Nom du modèle et modèle de secours associés à chaque niveau | Les noms de modèles sont ceux de la liste de modèles de la documentation APIYI |
Étape 3 : configurer la montée et la descente de niveau
Les règles de routage sont évaluées dans l’ordre suivant ; plus une règle est haute dans la liste, plus elle est prioritaire :
- Si l’appelant spécifie explicitement un paramètre de remplacement du niveau, utiliser directement ce niveau, pour faciliter le débogage et l’intervention manuelle.
- Si
risk_levelvaut high, router vers L3, le niveau phare. - Si la longueur d’entrée dépasse
context_threshold, router au moins vers L2, puis décider selon le type de tâche s’il faut monter vers L3. - Consulter la table selon
task_type: les tâches de classification, d’extraction et de conversion de format vont vers L1. - Si aucune règle ne correspond, utiliser
default_tier. - Si la sortie échoue à la validation
validator, monter d’un niveau et réessayer, jusqu’à la limitemax_escalation.
Étape 4 : enregistrer les indicateurs clés de chaque niveau
Après la mise en production du routage, il faut au minimum journaliser pour chaque requête le niveau, le nom du modèle, le nombre de tokens d’entrée et de sortie, si le cache a été touché, si une montée de niveau avec nouvelle tentative a eu lieu et si la validation a réussi. Ces données constituent la seule base pour ajuster ensuite les seuils ; une stratégie de routage sans journaux ne peut être réglée qu’à l’instinct.
🚀 Démarrage rapide : nous vous conseillons de commencer par exécuter les trois niveaux L1, L2 et L3 sur le même lot de requêtes réelles dans un environnement de test, puis de comparer le taux de réussite et le coût par tâche. Avec APIYI apiyi.com, vous pouvez passer d’un modèle à l’autre via la même interface, ce qui facilite ce type d’expérimentation comparative.
Comparaison des modèles phares et des modèles principaux dans le routage par couches
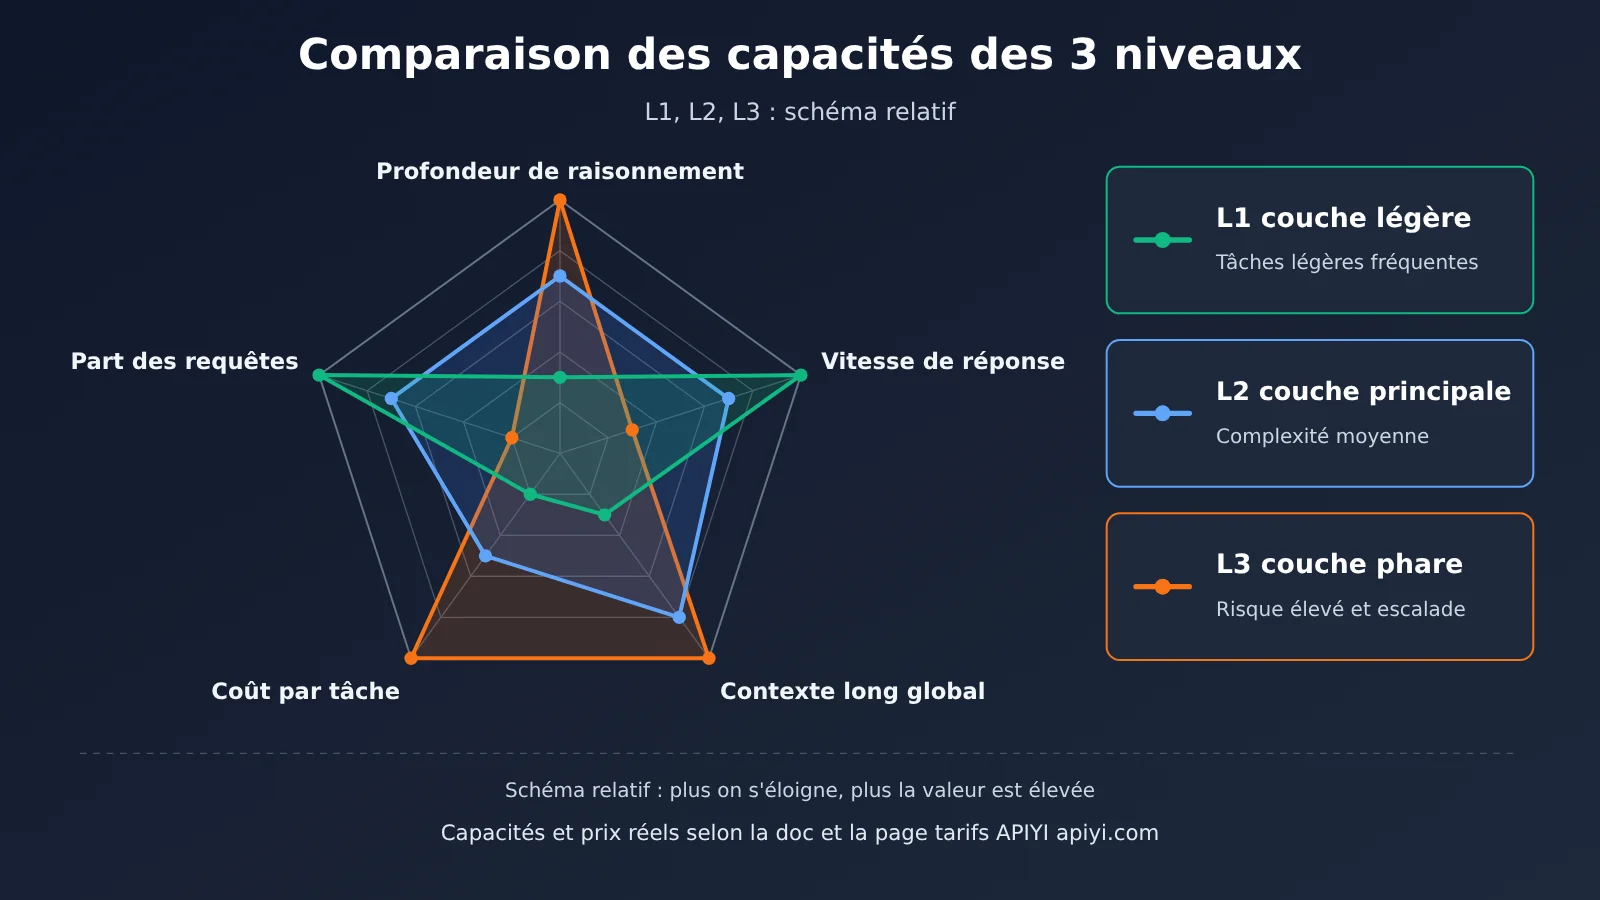
Le tableau ci-dessous classe les principaux modèles mentionnés dans les références par niveau, pour vous aider à choisir les candidats de chaque couche. Les positionnements indiqués proviennent de sources publiques et d’évaluations tierces ; les performances concrètes évoluent avec les versions, il est donc conseillé de refaire les tests avec vos propres données métier.
| Modèle | Positionnement habituel | Couche adaptée | Plateforme disponible |
|---|---|---|---|
| Claude Opus 4.7 / 4.6 | Codage complexe et raisonnement multi-étapes | Couche phare L3 | APIYI apiyi.com, API officielle |
| GPT-5.5 | Modèle phare généraliste, contexte 1M | Couche phare L3 | APIYI apiyi.com, API officielle |
| Gemini 3.1 Pro | Raisonnement et contexte long, excellent rapport qualité-prix | L2 à L3 | APIYI apiyi.com, API officielle |
| DeepSeek V4 Pro | Open source à grands paramètres, contexte 1M | Couche principale L2 | APIYI apiyi.com, API officielle |
| Kimi K2.6 | Capacités de codage proches des modèles phares | Couche principale L2 | APIYI apiyi.com, API officielle |
| DeepSeek V4 Flash | Faible coût, adapté aux tâches bien délimitées | L1 à L2 | APIYI apiyi.com, API officielle |
| Claude Haiku 4.5 / GPT-5.4 Mini | Tâches légères à haute fréquence | Couche légère L1 | APIYI apiyi.com, API officielle |
Analyse comparative des modèles phares et des modèles principaux
Analyse comparative des modèles phares : les modèles phares comme Claude Opus et GPT-5.5 conservent une longueur d’avance sur le raisonnement multi-étapes, la modification de code multi-fichiers et la détection d’erreurs subtiles. Mais leur prix unitaire et leur latence de réponse sont nettement plus élevés ; les utiliser pour des tâches simples comme la classification ou la reformulation constitue un gaspillage évident de ressources. En comparaison, les modèles phares sont surtout adaptés à la couche L3, où ils ne traitent que les requêtes à haut risque et les escalades après échec aux couches inférieures.
Analyse comparative des modèles principaux open source : DeepSeek V4 et Kimi K2.6 se distinguent sur le codage courant et le traitement de documents, et les évaluations tierces montrent que l’écart avec les modèles phares est déjà faible sur de nombreuses tâches. Mais l’écart subsiste sur les tâches nécessitant un raisonnement en chaîne longue et comportant de nombreuses contraintes implicites. Pour la majorité des requêtes de complexité moyenne, les modèles de la couche principale restent le choix par défaut le plus sûr et le plus économique.
💡 Conseil de sélection : le choix du modèle pour chaque couche dépend principalement de la répartition de vos tâches et de vos exigences de qualité. Il est recommandé de faire une comparaison croisée des modèles candidats sur un même jeu d’échantillons via APIYI apiyi.com, avant de décider du modèle principal et du modèle de secours de chaque couche.
Méthode de calcul des coûts du routage par niveaux
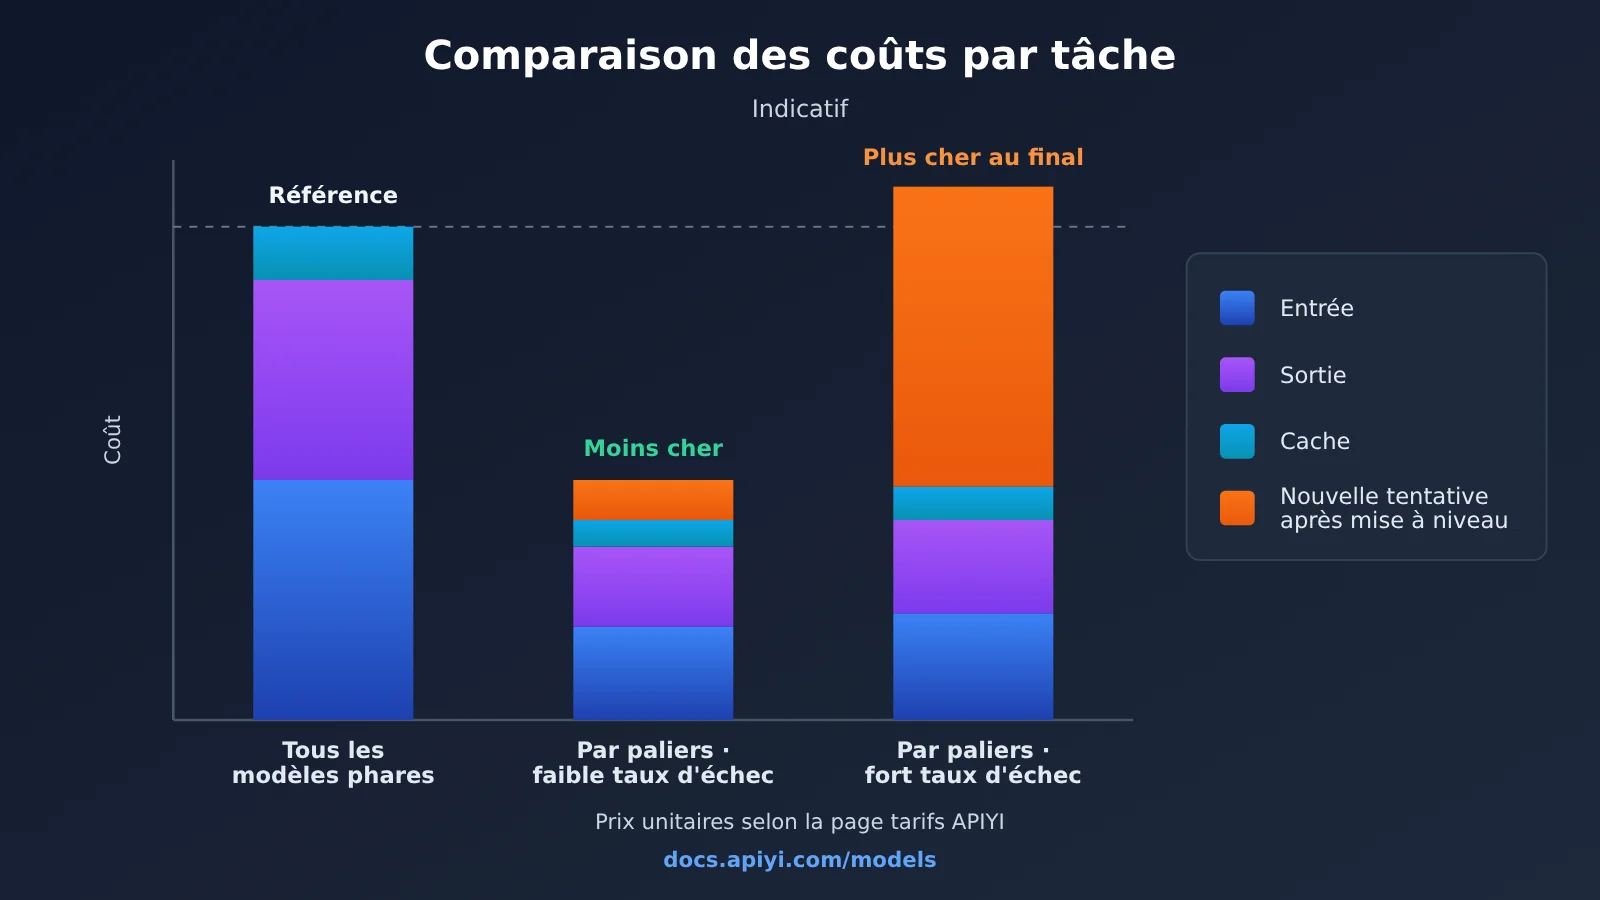
Pour savoir si le routage par niveaux permet d’économiser, il ne suffit pas de regarder le prix unitaire : il faut considérer le « coût total par tâche ». Le coût total d’une tâche se compose généralement de plusieurs postes de facturation, et une erreur sur un seul d’entre eux fausse la conclusion.
| Poste de facturation | Description | Base tarifaire |
|---|---|---|
| Tokens d’entrée | Volume total des invites, du contexte et de l’historique des messages | Selon les données réelles de la page tarifaire APIYI docs.apiyi.com/models |
| Tokens de sortie | Contenu généré par le modèle ; les modèles de raisonnement peuvent inclure des tokens de réflexion | Selon les données réelles de la page tarifaire APIYI docs.apiyi.com/models |
| Lecture du cache | Partie de l’entrée qui bénéficie du cache d’invites | Selon les données réelles de la page tarifaire APIYI docs.apiyi.com/models |
| Écriture du cache | Partie de l’entrée écrite pour la première fois dans le cache ; certains modèles la facturent séparément | Selon les données réelles de la page tarifaire APIYI docs.apiyi.com/models |
| Réessai après escalade | Ensemble des frais générés par une réexécution au niveau supérieur après un échec au niveau inférieur | Calculé en cumulant les appels selon le niveau réellement utilisé |
Erreurs fréquentes lors du calcul du coût par tâche d’un routage par niveaux
La première erreur consiste à compter deux fois les tokens de cache. Des articles de référence le rappellent spécifiquement : pour calculer le coût du cache, il faut compter séparément la lecture, l’écriture, l’entrée normale, la sortie et les réessais, sinon on risque facilement de compter deux fois le même lot de tokens. La deuxième erreur est d’ignorer le coût des réessais après escalade. Si le taux d’échec de validation du niveau L1 est élevé, « essayer d’abord le modèle bon marché » peut coûter plus cher que d’utiliser directement le modèle principal.
Je recommande donc une formule simple pour évaluer si un type de tâche peut être placé au niveau inférieur : coût d’une exécution au niveau inférieur + (taux d’échec × coût d’une exécution au niveau supérieur). Si cette valeur est nettement inférieure au coût d’une utilisation directe du niveau supérieur, et que la qualité finale reste acceptable, alors ce type de tâche peut être délégué au niveau inférieur. Pour le prix unitaire exact, le tarif du cache et les modalités de facturation de chaque modèle, référez-vous aux données en temps réel de la page tarifaire APIYI docs.apiyi.com/models ; cet article ne donne pas de chiffres tarifaires précis.
💰 Optimisation des coûts : lors d’une estimation de coûts, je vous conseille de lire directement les prix unitaires d’entrée, de sortie et de cache de chaque modèle sur la page tarifaire APIYI, puis de calculer le coût par tâche à partir de vos propres données de journalisation. Sur une même plateforme, les modalités de facturation sont cohérentes, ce qui limite les erreurs lors de comparaisons entre modèles.
FAQ — Questions fréquentes
Q1 : Qu’est-ce que le routage par paliers d’un grand modèle de langage selon la tâche ?
Il s’agit d’affecter chaque requête à un modèle d’un niveau de capacité et de coût différent, en fonction du type de tâche, du niveau de risque et de la taille du contexte. Les tâches simples vont aux modèles légers, les tâches courantes au modèle principal, et seules les tâches complexes ou à haut risque sont confiées au modèle phare.
Q2 : Quelle différence entre le routage par paliers et une simple « rétrogradation vers un modèle moins cher » ?
La rétrogradation simple est généralement un remplacement global, ce qui fait baisser la qualité sur l’ensemble. Le routage par paliers traite chaque type de tâche différemment, et s’accompagne d’un mécanisme de vérification et de remontée automatique : une requête qui échoue au niveau inférieur est renvoyée à un modèle plus puissant pour être refaite. On garde ainsi le contrôle des coûts tout en préservant un niveau de qualité minimal.
Q3 : Faut-il réajuster la stratégie de routage après la sortie des nouveaux modèles de 2026 ?
Oui. Au premier semestre 2026, les sorties s’enchaînent avec GPT-5.5, DeepSeek V4, les nouvelles versions de Claude Opus, et les frontières de capacité entre les paliers évoluent vite. Je recommande, après chaque mise à jour majeure d’un modèle, de refaire tourner un jeu de tests fixe sur chaque palier pour mesurer le taux de réussite, puis de décider s’il faut ajuster la correspondance des niveaux.
Q4 : Quelles requêtes méritent le plus le modèle phare ?
Principalement les catégories suivantes :
– **Refactorisation de code multi-fichiers et localisation de bugs complexes** : il faut comprendre les dépendances entre de nombreux éléments de contexte.
– **Sorties dans des domaines à haut risque** : relecture de contrats, vérification de règles comptables, génération de politiques de sécurité.
– **Tâches de raisonnement à contraintes multiples** : planification complexe, arbitrage entre options, démonstrations mathématiques.
– **Requêtes déjà échouées sur un palier inférieur** : en guise de filet de sécurité par remontée.
Q5 : Comment monter rapidement un environnement de test pour le routage par paliers via API ?
Je recommande une plateforme d’agrégation d’API multi-modèles :
1. Rendez-vous sur APIYI apiyi.com pour créer un compte et récupérer une clé API.
2. Consultez le centre de documentation APIYI sur docs.apiyi.com pour l’adresse d’accès et les noms de modèles disponibles.
3. Choisissez un modèle pour L1, L2 et L3 selon la liste de configuration de cet article, puis comparez les taux de réussite sur le même lot d’échantillons.
APIYI est compatible avec les formats d’interface OpenAI et Anthropic, donc les projets existants s’y connectent généralement sans grosse modification.
Q6 : Utiliser un modèle pour la classification des tâches elle-même, est-ce que ça augmente les coûts ?
Cela ajoute un léger surcoût. Je conseille donc de privilégier un étiquetage direct à l’entrée du parcours métier : par exemple, l’« entrée du service client » correspond par défaut à un certain type de tâche. Ce n’est que lorsque l’entrée ne permet pas de distinguer qu’on fait appel à un modèle léger L1 pour classifier — ce coût reste généralement bien inférieur au gâchis d’un mauvais usage du modèle phare.
Q7 : Quelles sont les limites connues du routage par paliers ?
Il y en a trois principales : d’abord, les règles demandent une maintenance continue, car les seuils peuvent devenir obsolètes après une mise à jour de modèle ; ensuite, la remontée et la nouvelle tentative ajoutent de la latence sur certaines requêtes, ce qui impose un arbitrage pour les cas exigeant une réactivité extrême ; enfin, les styles de sortie diffèrent d’un modèle à l’autre, et un produit grand public peut avoir besoin d’un post-traitement unifié. Face à ces problèmes, on peut relever le palier par défaut ou réduire le nombre de paliers.
Q8 : Où faut-il se renseigner sur les tarifs du routage par paliers ?
Pour les prix d’entrée, de sortie et de cache de tous les modèles, ainsi que les règles de facturation, fiez-vous aux données réelles de la page tarifs d’APIYI : docs.apiyi.com/models. Les prix cités dans des articles tiers peuvent correspondre à un canal différent de celui que vous utilisez réellement ; mieux vaut ne pas s’en servir directement pour bâtir un budget.
Points clés du routage par niveaux des grands modèles selon la tâche
- Le critère de niveau, c’est la tâche, pas l’utilisateur : les requêtes d’un même utilisateur peuvent être très inégales en difficulté, il faut juger au cas par cas.
- Le coût d’une erreur compte plus que la difficulté : une tâche simple mais à fort risque mérite aussi un modèle phare.
- Rester par défaut sur la couche principale est le plus sûr : la couche intermédiaire rattrape les cas, on monte ou descend selon les signaux, avec des règles simples et faciles à maintenir.
- La couche basse doit être assortie de contrôles : seules les sorties vérifiables par programme conviennent à un modèle léger.
- On raisonne en coût total par tâche : entrée, sortie, cache et nouvelles tentatives doivent être comptabilisés séparément.
- Chaque mise à jour de modèle impose de retester : en 2026, les modèles évoluent vite, la correspondance des niveaux doit être recalibrée régulièrement.
- Une interface unifiée réduit le coût des bascules : via APIYI apiyi.com, on appelle plusieurs modèles avec un seul jeu d’interfaces.
Récapitulatif
Les points clés du routage des grands modèles de langage par niveaux de tâches :
- Trois niveaux : le L1 traite les tâches légères et vérifiables, le L2 absorbe le trafic par défaut, le L3 ne reçoit que les requêtes complexes, à haut risque et les escalades.
- Priorité des règles : on évalue dans l’ordre la surcharge manuelle, les étiquettes de risque, la longueur du contexte, le type de tâche, puis le niveau par défaut ; en cas d’échec, l’escalade est automatique.
- Pilotage par les données : on enregistre le taux de réussite, le taux de nouvelle tentative et le coût par tâche de chaque niveau, et on ajuste les seuils à partir de données réelles plutôt qu’à l’intuition.
Le routage par niveaux ne vise pas à « tout faire tourner sur le modèle le moins cher », mais à réserver les capacités du modèle phare là où elles sont réellement nécessaires. Je vous conseille de commencer par une ou deux tâches fréquentes, de valider toute la chaîne « classification, appel, vérification, escalade, journalisation », puis d’étendre progressivement à d’autres activités.
Pour valider rapidement votre schéma par niveaux, je vous recommande APIYI apiyi.com : la plateforme propose une interface unifiée pour plusieurs modèles. Les instructions d’intégration se trouvent sur docs.apiyi.com, et les tarifs font foi sur docs.apiyi.com/models.
📚 Références
- Liste d’articles du blog Ofox.ai (avril-mai 2026) : couvre les sorties et comparaisons de modèles comme GPT-5.5, DeepSeek V4, Claude Opus
- Lien :
ofox.ai/blog/page/35 -
Remarque : contient des analyses tierces sur le routage de modèles hybrides, le calcul des coûts de cache, etc. Cet article n’en reprend que les informations factuelles
-
Liste d’articles du blog Ofox.ai (sorties et évaluations de modèles) : couvre GPT-5.5 Instant, les benchmarks des principaux modèles et la comparaison des coûts par tâche
- Lien :
ofox.ai/blog/page/36 -
Remarque : utile pour comprendre le positionnement public des principaux modèles de 2026
-
Liste d’articles du blog Ofox.ai (petits modèles et modèles open source) : couvre Claude Haiku, GPT-5.4 Mini, Llama 4 et d’autres modèles légers ou open source
- Lien :
ofox.ai/blog/page/37 -
Remarque : utile pour choisir des modèles candidats pour les niveaux L1 et L2
-
Centre de documentation APIYI : adresses d’intégration, format des interfaces et description des noms de modèles
- Lien :
docs.apiyi.com -
Remarque : à consulter avant d’intégrer une interface compatible OpenAI ou Anthropic
-
Page des tarifs des modèles APIYI : données de facturation en entrée, en sortie et pour le cache de chaque modèle
- Lien :
docs.apiyi.com/models - Remarque : tous les calculs de coûts de cet article s’appuient sur les données réelles de cette page
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter via la page d’accueil du site APIYI apiyi.com ; d’autres ressources d’intégration sont disponibles dans le centre de documentation docs.apiyi.com