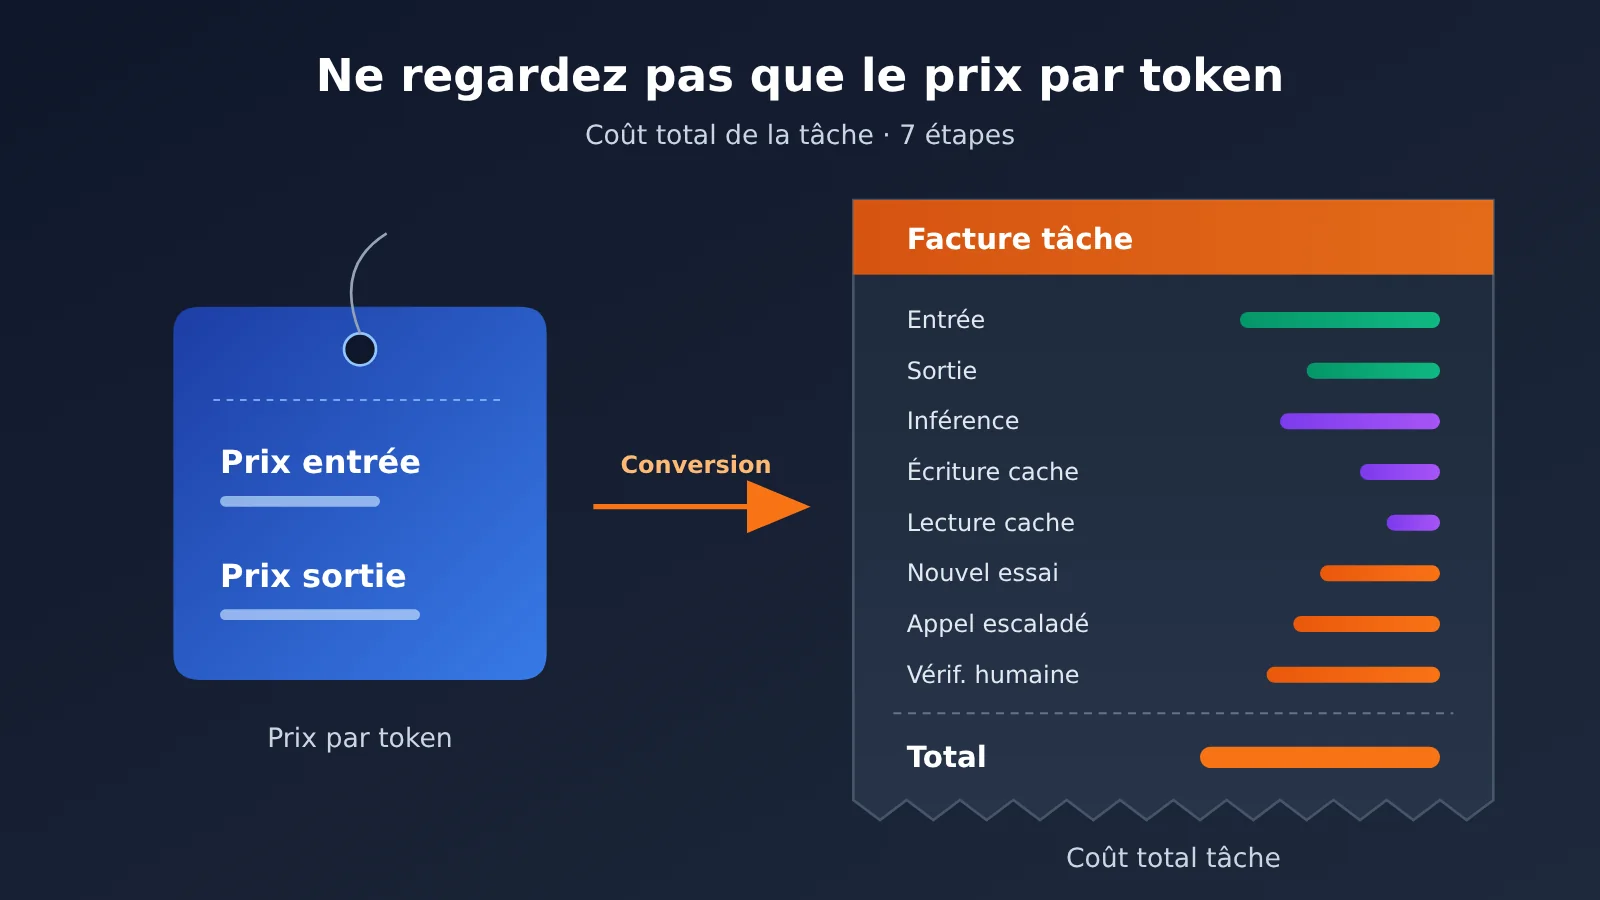
Note de l’auteur : de l’entrée à la sortie, en passant par l’inférence, le cache, les nouvelles tentatives et la montée en gamme de la vérification, sept étapes pour convertir « combien coûte un million de tokens » en « combien coûte une tâche menée à bien ».
Beaucoup d’équipes choisissent un modèle en jetant d’abord un œil aux tarifs d’entrée et de sortie de la grille tarifaire, puis concluent que « celui-là est deux fois moins cher ». Un mois après la mise en production, la facture arrive et l’on découvre que le modèle bon marché n’a rien fait économiser — parfois même qu’il coûte plus cher. Cet article présente une méthode d’estimation des coûts exprimée en « tâches acceptées », pour vous aider à voir clair dans tout ce qui se cache derrière le prix unitaire des tokens.
Ce n’est pas un article qui vous pousse à acheter un modèle cher : un modèle bon marché est effectivement plus avantageux dans bien des cas. Le tout est de savoir s’il le reste une fois qu’on a compté les nouvelles tentatives, les tokens d’inférence, le cache et la vérification humaine.
L’essentiel : à la fin de cet article, vous disposerez d’une feuille de calcul réutilisable pour le coût d’une tâche ; vous saurez quelles données collecter, comment appliquer les formules, et quelles étapes sont le plus souvent oubliées dans le calcul.
Coût complet d’une tâche : l’essentiel
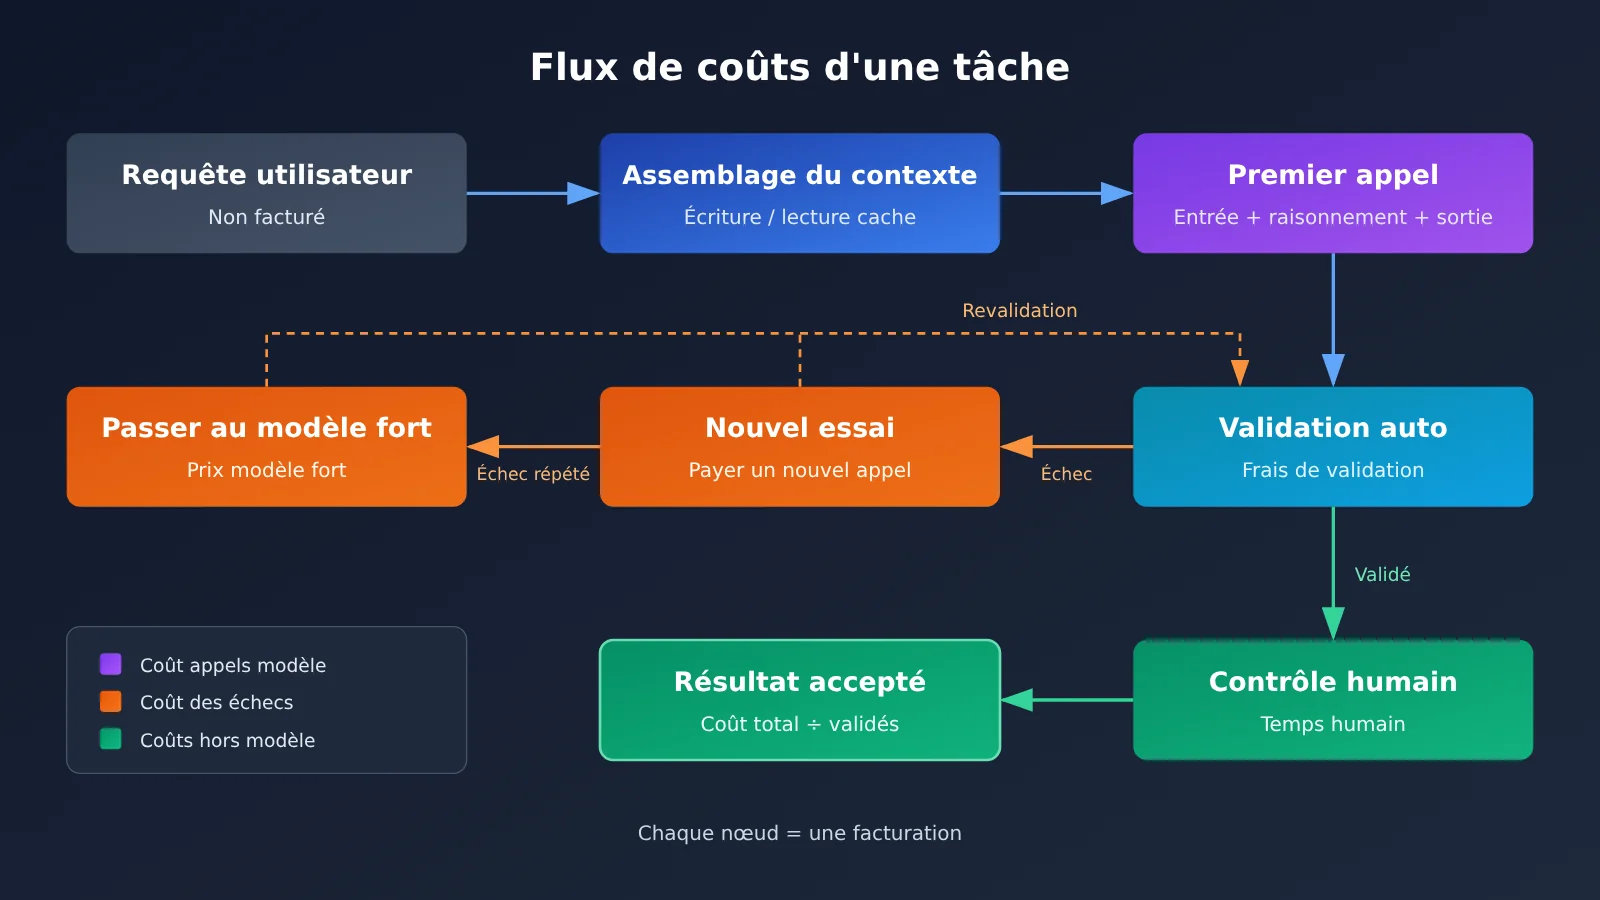
Pour estimer le coût complet d’une tâche, il faut d’abord admettre une chose : la grille tarifaire donne le « prix unitaire de la matière première », alors que ce qui vous intéresse vraiment, c’est le « prix unitaire du produit fini ». Une tâche se compose souvent de plusieurs appels, de plusieurs types de tokens et de divers coûts hors modèle. Le tableau ci-dessous récapitule les postes les plus fréquents.
| Poste de coût | Description | Raison fréquente d’omission |
|---|---|---|
| Tokens d’entrée standard | Invite système, saisie utilisateur, contexte de récupération, historique de conversation | Dans un dialogue multi-tour, l’historique est recompté à chaque fois |
| Tokens de sortie | Contenu visible finalement renvoyé par le modèle | Les sorties structurées sont souvent plus longues que prévu |
| Tokens de raisonnement | Réflexion interne consommée par les modèles de raisonnement, généralement facturée comme des tokens de sortie | Invisible pour l’utilisateur, mais bien présente sur la facture |
| Écriture et lecture du cache | Création et récupération en cache de préfixes répétés | Les règles de facturation de l’écriture et de la lecture diffèrent de celles des tokens d’entrée standard |
| Appels de nouvelle tentative | Nouvelles requêtes après expiration du délai, erreur de format ou échec de validation | Rares en phase de test, elles apparaissent à grande échelle en production |
| Appels d’escalade | Transfert vers un modèle plus puissant après l’échec d’un petit modèle | La stratégie de routage cumule les coûts de deux appels |
| Paliers de contexte long | Le prix unitaire change au-delà d’un certain seuil de contexte | Ne se déclenche que sur quelques requêtes à entrée longue, donc facile à oublier |
| Coût de vérification humaine | Les résultats doivent être contrôlés ou retravaillés | Absent de la facture API, mais bien réel |
Coût complet d’une tâche : pourquoi le prix unitaire induit en erreur
Le premier piège vient des tokens de raisonnement. Avant de répondre, les modèles de raisonnement consomment une phase de réflexion interne. Celle-ci est généralement facturée au prix des tokens de sortie, et sa longueur varie avec le niveau de raisonnement configuré. Dans les discussions publiques, plusieurs articles comparent justement les niveaux high et xhigh d’un même modèle. Tous arrivent à la même conclusion : pour savoir si le supplément de raisonnement en vaut la peine, il faut regarder de combien le taux de réussite de la tâche progresse, pas seulement si le prix unitaire est identique.
Le deuxième piège, c’est que « un format correct ne signifie pas un résultat correct ». Pour de l’extraction de texte, obtenir un JSON valide est facile pour le modèle, mais il faut encore vérifier que les valeurs des champs proviennent réellement du texte source et qu’elles ne sont pas attribuées au mauvais endroit. Si un modèle bon marché produit une proportion élevée de résultats à retravailler manuellement, l’économie réalisée sur la facture API risque fort d’être annulée, et même doublée, par le coût humain.
Le troisième piège vient du discours marketing des fournisseurs. Certains modèles sont annoncés avec, en même temps, une baisse du prix unitaire des tokens et une baisse du coût des tâches. Or les deux ne sont pas équivalents. La baisse du coût d’une tâche peut venir d’une sortie plus courte, de moins de nouvelles tentatives, ou encore d’un usage particulier du cache. Votre charge de travail ne reproduira pas forcément le même ratio.
Comment estimer le coût complet d’une tâche — prise en main rapide
Ce processus ne nécessite pas d’écrire du code : une simple feuille de calcul suffit. L’idée centrale est de calculer d’abord la structure de tokens d’un appel unique, puis de la multiplier par les différentes probabilités, et enfin de diviser par le nombre de résultats acceptés.
Les 7 étapes pour estimer le coût complet d’une tâche
- Définir les limites d’une « tâche » : par exemple « traiter un ticket et produire des champs structurés stockables en base », et non « appeler une API une fois ». Selon les limites retenues, le périmètre du coût est complètement différent.
- Décomposer la structure de tokens d’un appel unique : enregistrez séparément la longueur moyenne de l’invite système, du contexte de récupération, de l’entrée utilisateur, de la sortie visible et des tokens de raisonnement, idéalement avec les valeurs P50 et P95.
- Identifier les parties pouvant être mises en cache : l’invite système fixe, les définitions d’outils et les exemples few-shot peuvent généralement passer par le cache. Enregistrez la fréquence d’écriture du cache et le taux de succès estimé.
- Clarifier les règles de facturation : le prix unitaire de l’entrée, de la sortie, de l’écriture du cache et de la lecture du cache, ainsi que l’existence éventuelle d’un palier de contexte long. Tous les prix unitaires se basent sur les données réelles de la page de tarifs APIYI : docs.apiyi.com/models.
- Mesurer le taux d’échec avec de vrais échantillons : exécutez au moins une série d’échantillons représentatifs, comptez les proportions d’échecs de format, d’échecs de validation et de timeouts, puis convertissez-les en taux de nouvelle tentative et en taux d’escalade.
- Ajouter les coûts non liés au modèle : la proportion d’inspection manuelle, le temps de validation par élément, à convertir en montant si nécessaire.
- Calculer le coût « par résultat accepté » : divisez le coût total par le nombre de résultats ayant passé l’acceptation finale. C’est l’indicateur qui permet vraiment de comparer les modèles.
Champs d’une feuille de travail complète sur le coût des tâches
Une fois les étapes ci-dessus transposées dans un tableau, je vous conseille d’y inclure au minimum les champs suivants. Vous pouvez adapter les noms de champs aux habitudes de votre équipe ; l’essentiel est que chaque élément ait une source de données.
| Champ | Signification | Source des données |
|---|---|---|
in_cached |
Nombre de tokens d’entrée ayant touché le cache | champ usage des journaux d’appels |
in_uncached |
Nombre de tokens d’entrée standard n’ayant pas touché le cache | journaux d’appels |
cache_write |
Nombre de tokens écrits dans le cache lors de cet appel | journaux d’appels |
out_visible |
Nombre de tokens de sortie visibles | journaux d’appels |
out_reasoning |
Nombre de tokens de raisonnement | journaux d’appels (uniquement pour les modèles de raisonnement) |
retry_rate |
Proportion nécessitant une nouvelle tentative | statistiques issues des tests sur échantillons |
escalate_rate |
Proportion nécessitant une escalade vers un modèle plus puissant | journaux de la stratégie de routage |
accept_rate |
Proportion finalement acceptée | validation automatique et contrôle manuel par échantillonnage |
| Prix unitaires | Prix unitaires des entrées, des sorties, des écritures dans le cache et des lectures du cache | données réelles de la page tarifs d’APIYI |
🚀 Conseil pour démarrer rapidement : si vous souhaitez comparer en même temps le coût d’une tâche pour plusieurs modèles, je vous conseille de les exécuter séparément sur le même lot d’échantillons sur APIYI apiyi.com. La plateforme propose les appels API des principaux modèles abordés dans cet article, compatibles avec les deux formats d’interface OpenAI et Anthropic. Pour changer de modèle, il suffit de modifier le nom du modèle, ce qui facilite la comparaison dans une même feuille de travail. Pour l’intégration et base_url, référez-vous à la documentation APIYI docs.apiyi.com.
Exemple de calcul complet du coût d’une tâche
Voici une démonstration avec une tâche d’extraction de champs sur des tickets. Pour éviter d’utiliser des chiffres de prix non vérifiés, l’exemple ne donne que les volumes de tokens et les formules : reportez-vous à la page de tarifs APIYI docs.apiyi.com/models pour renseigner les prix réels du modèle concerné.
| Étape | Composition des tokens (moyenne) | Probabilité d’occurrence | Formule de coût |
|---|---|---|---|
| Premier appel | 6 000 en cache (cache hit) + 2 000 en entrée normale + 800 en sortie visible + 1 500 de raisonnement | 100 % | 6 000 × prix de lecture du cache + 2 000 × prix d’entrée + 2 300 × prix de sortie |
| Écriture en cache | 6 000 (réécriture après expiration du cache) | Amorti selon la fréquence d’écriture | 6 000 × prix d’écriture du cache ÷ nombre de requêtes couvertes par chaque écriture |
| Appel en cas de nouvelle tentative | Identique au premier appel | 10 % | Coût du premier appel × 0,1 |
| Appel d’escalade | 8 000 en entrée sur un modèle plus puissant + 2 000 en sortie et raisonnement cumulés | 5 % | Après substitution du prix du modèle plus puissant, × 0,05 |
| Contrôle manuel par échantillonnage | Aucun token consommé | 5 % d’échantillonnage | Coût humain de vérification par ligne × 0,05 |
Additionnez ces cinq lignes pour obtenir le « coût attendu par ticket ». Divisez ensuite par le taux d’acceptation final, par exemple 95 %, pour obtenir le « coût par résultat accepté ». Notez que la nouvelle tentative est ici calculée au coût complet du premier appel, car en pratique le contexte est renvoyé tel quel lors d’une nouvelle tentative.
Un phénomène intéressant apparaît dans cet exemple : la sortie visible ne fait que 800 tokens, mais les tokens de raisonnement en représentent 1 500. Facturés au prix de sortie, ces tokens de raisonnement constituent donc la majeure partie du côté sortie. Si l’on estime uniquement à partir de la sortie visible, le coût côté sortie est sous-estimé de plus de la moitié.
Coût total d’une tâche : comparaison des idées reçues courantes
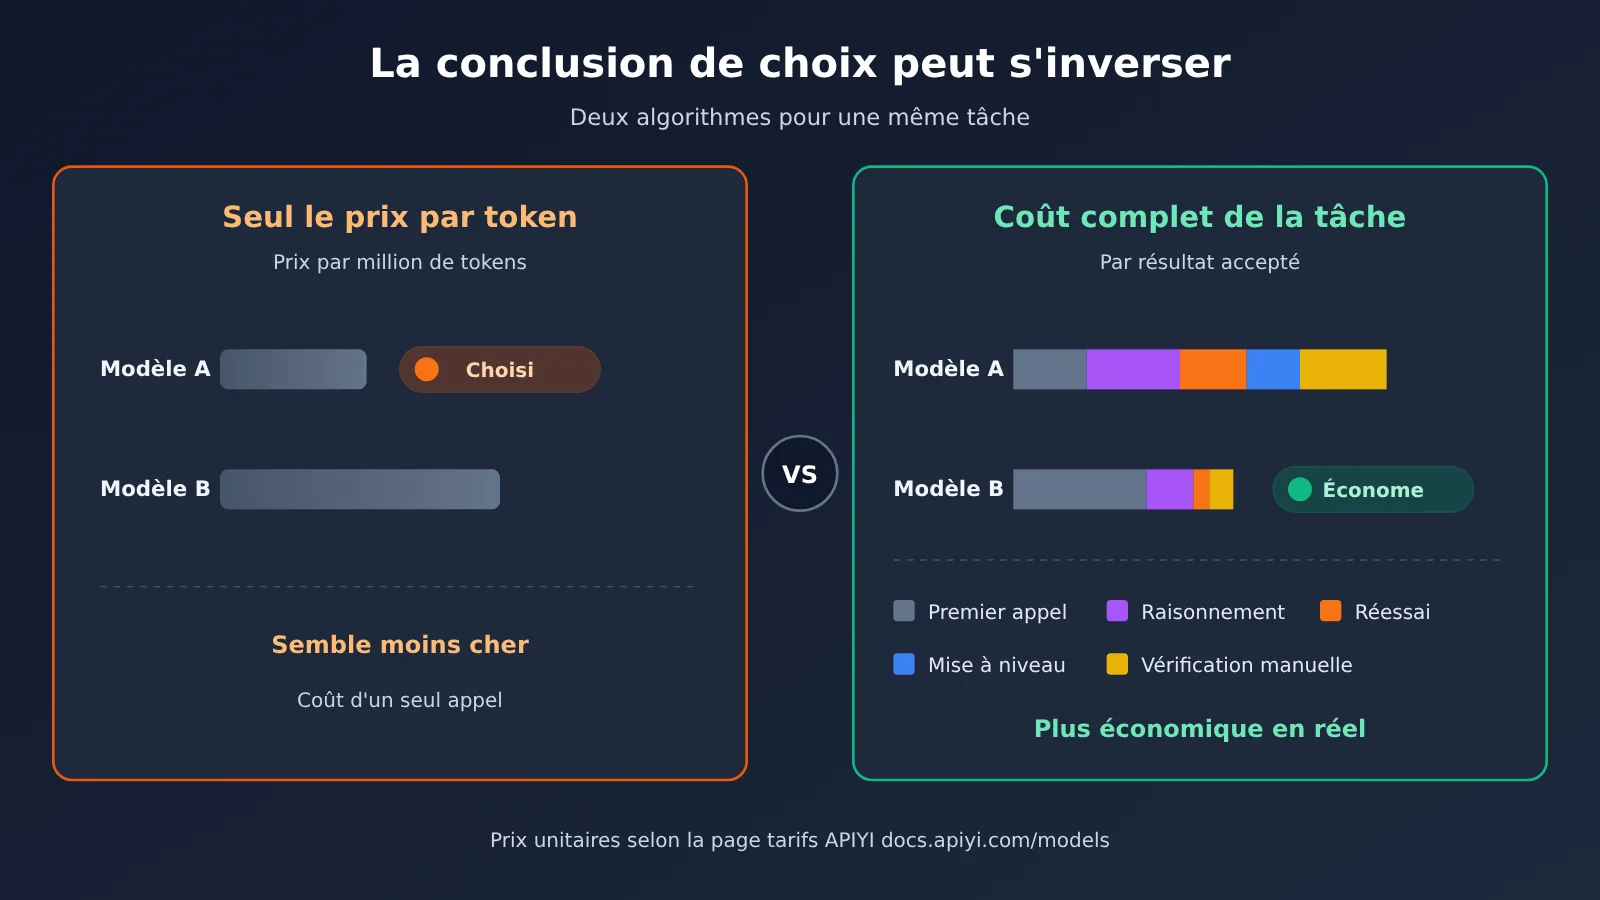
Pour un même besoin, les deux approches — ne regarder que le prix unitaire ou considérer le coût total de la tâche — aboutissent souvent à des conclusions de choix opposées. Le tableau ci-dessous résume quelques scénarios typiques.
| Scénario | Conclusion en ne regardant que le prix unitaire | Conclusion en considérant le coût total de la tâche | Variables clés |
|---|---|---|---|
| Extraction structurée | Choisir le modèle léger le moins cher | Si le taux d’erreur sur les champs est élevé, un modèle plus puissant peut être plus économique | Taux d’acceptation, retouches manuelles |
| Agent de codage | Choisir le modèle dont le prix de sortie est le plus bas | Les appels d’outils à plusieurs tours font gonfler le contexte ; la stratégie de cache devient plus déterminante | Taux de succès du cache, nombre de tours |
| Analyse de documents longs | Estimer à partir de la longueur d’entrée moyenne | Quelques requêtes très longues déclenchent le tarif par paliers du contexte long | Seuil de contexte, longueur P95 |
| Choix de l’intensité de raisonnement | À prix unitaire identique pour un même modèle, choisir le niveau le plus élevé | Un raisonnement de niveau élevé génère plus de tokens ; il faut vérifier si le taux de réussite progresse | Tokens de raisonnement, taux de réussite |
| Tâches par lots hors ligne | Calculer d’après le prix des appels en temps réel | Le canal de traitement par lots peut appliquer une tarification différente | Prise en charge de Batch |
💡 Note de comparaison : Les conclusions du tableau relèvent d’un raisonnement méthodologique ; le modèle le plus avantageux dépend de votre échantillon. Nous vous conseillons d’exécuter plusieurs modèles sur le même échantillon via APIYI apiyi.com, de compléter le tableau avec les prix unitaires réels de la page des tarifs, puis de décider.
Détails sur le contexte long et le cache dans le coût total d’une tâche
Le palier de contexte long est le poste où le risque de « faible probabilité, gros montant » est le plus élevé. Des sources publiques indiquent que certains modèles appliquent un prix unitaire différent lorsque l’entrée dépasse un certain seuil (par exemple, un article évoque le seuil de 272K pour GPT-6 Sol). Si la distribution de longueur de vos requêtes a une longue traîne, comptez séparément les requêtes qui dépassent le seuil, au lieu de vous contenter d’une longueur moyenne.
Le cache est une arme à double tranchant. La lecture du cache est généralement moins chère qu’une entrée classique, mais chez certains fournisseurs, le prix unitaire de l’écriture dans le cache peut être supérieur à celui d’une entrée classique, et le cache a une durée d’expiration. Si vos requêtes sont très espacées et que le préfixe change souvent, le coût d’écriture peut annuler les économies réalisées à la lecture. Pour les prix exacts d’écriture et de lecture du cache, ainsi que les règles de facturation, référez-vous aux indications de la page des tarifs APIYI : docs.apiyi.com/models.
5 moyens pratiques pour réduire le coût total d’une tâche
Une fois les calculs faits, les axes d’optimisation apparaissent généralement plus clairement. Les méthodes ci-dessous sont efficaces dans la plupart des cas, mais il faut vérifier leur impact avec la feuille de calcul, pas au feeling.
| Moyen | Poste de coût concerné | Points d’attention |
|---|---|---|
| Préfixe fixe et cache activé | tokens d’entrée | Placer le contenu variable à la fin de l’invite pour améliorer le taux de hit du cache |
| Limiter le format et la longueur de la sortie | tokens de sortie | Utiliser une sortie structurée pour contraindre les champs et éviter les explications superflues |
| Router selon la difficulté de la tâche | appels d’escalade, tokens de raisonnement | Les règles doivent être explicites, et il faut auditer les « résultats erronés acceptés » |
| Validation automatique en amont | vérification humaine, reprise du travail | Vérifier la provenance des preuves, et pas seulement le format JSON |
| Contrôler l’intensité du raisonnement | tokens de raisonnement | Définir le niveau selon le taux de réussite, sans activer le niveau le plus élevé par défaut |
À propos du routage, il y a un risque souvent négligé : les résultats « réussis » renvoyés par un petit modèle peuvent contenir des erreurs, et ces erreurs ne déclenchent pas d’escalade. Donc, lorsqu’on évalue une stratégie de routage, il faut non seulement regarder le taux d’escalade, mais aussi contrôler par échantillonnage les résultats validés directement par le petit modèle, puis intégrer les erreurs passées inaperçues dans le coût.
FAQ — Questions fréquentes
Q1 : Qu’est-ce que le coût complet d’une tâche ?
Le coût complet d’une tâche désigne la totalité des dépenses engagées pour mener à bien une tâche au sens métier, et pour que son résultat soit accepté. Il englobe les coûts d’entrée, de sortie, d’inférence et de cache de tous les appels, ainsi que les frais liés aux nouvelles tentatives, aux escalades vers un modèle supérieur et à la vérification humaine. Il reflète donc bien mieux la facture réelle que le simple prix unitaire des tokens.
Q2 : Quelle différence entre le coût complet d’une tâche et le prix unitaire des tokens ?
Le prix unitaire des tokens, c’est le prix de la matière première ; le coût complet d’une tâche, c’est le prix du produit fini. Un modèle au prix unitaire bas peut coûter plus cher au final s’il exige davantage de nouvelles tentatives, une réflexion plus longue ou plus de reprises humaines. À l’inverse, un modèle plus cher mais qui réussit du premier coup peut s’avérer plus économique.
Q3 : Combien d’échantillons faut-il au minimum pour estimer le coût complet d’une tâche ?
Il n’existe pas de chiffre universel : l’essentiel est que les échantillons couvrent la distribution réelle, en particulier les entrées longues, les cas difficiles et les situations limites. Avec trop peu d’échantillons, le taux de nouvelle tentative et le taux d’acceptation varient énormément. Mieux vaut commencer par une estimation sur un petit lot, puis corriger avec les journaux réels des premières semaines de mise en production.
Q4 : Quels cas d’usage ont le plus besoin de ce calcul ?
Principalement les catégories suivantes :
– **Extraction de données structurées** : lorsqu’une erreur de champ doit être corrigée à la main, la part du coût humain devient très élevée
– **Agents de codage** : les appels d’outils en plusieurs tours font grimper la fenêtre de contexte très vite
– **Questions-réponses sur documents longs** : les requêtes de longue traîne peuvent déclencher des tarifs dégressifs par paliers de contexte
– **Routage multi-modèles** : une escalade cumule deux fois les frais
Q5 : Comment obtenir rapidement les prix unitaires et les règles de facturation de chaque modèle ?
Le plus simple est de consulter directement la page tarifs d’APIYI, docs.apiyi.com/models : elle indique les prix unitaires d’entrée, de sortie et de cache des modèles pris en charge par la plateforme. Pour vos estimations, fiez-vous aux données réelles de cette page. APIYI est compatible avec les formats d’interface d’OpenAI et d’Anthropic ; une fois l’intégration réalisée selon la documentation docs.apiyi.com, vous pouvez tester plusieurs modèles sur le même lot d’échantillons et reporter directement les données `usage` des journaux d’appels dans votre tableur.
Q6 : Peut-on comparer directement l’usage d’un produit par abonnement et la facturation API ?
Mieux vaut éviter de comparer frontalement. Un produit par abonnement est généralement limité par un quota ou un nombre d’utilisations, alors que l’API facture au token : les unités de mesure et les contextes d’usage diffèrent. Si vous voulez vraiment comparer, il faut d’abord convertir le volume réel de tâches réalisables avec l’abonnement, sans partir du principe d’un nombre fixe de messages.
Q7 : Quelles sont les limites de l’estimation du coût complet d’une tâche ?
Elle dépend de la représentativité des échantillons : un échantillon trop simple sous-estime le coût. La conversion du coût de vérification humaine reste subjective et varie beaucoup d’une équipe à l’autre. Enfin, les prix unitaires et les règles de facturation des modèles peuvent évoluer : la feuille de calcul doit être mise à jour régulièrement avec les tarifs et les journaux les plus récents, plutôt que d’être figée une fois pour toutes.
Coût complet d’une tâche — les points clés à retenir
- Changer d’unité de comparaison : comparez les modèles sur « le coût par résultat accepté », et non sur le prix au million de tokens
- Les tokens de raisonnement se comptent à part : ils sont généralement facturés comme de la sortie, et peuvent dépasser la sortie visible
- Le cache se compte en écriture et en lecture : l’écriture peut coûter plus cher qu’une entrée classique, et c’est le taux de succès du cache qui décide de la rentabilité
- Les nouvelles tentatives et les escalades, c’est le gros poste caché : une fois en production, le taux d’échec est souvent plus élevé que ce qu’on observe en phase de test
- Un JSON valide ne signifie pas des données correctes : vérifiez la provenance des preuves et intégrez la reprise manuelle dans le coût
- Contexte long : surveillez la queue de distribution : utilisez la longueur P95 pour voir si vous déclenchez un palier tarifaire
- Pour les prix unitaires, fiez-vous à la page tarifs : pour vos estimations, consultez systématiquement les données réelles de la page tarifs APIYI, docs.apiyi.com/models
En résumé
Les points essentiels pour estimer le coût complet d’une tâche :
- Définir d’abord le périmètre de la tâche : raisonnez en résultat métier, pas en appel unitaire
- Décomposer tous les postes de coût : entrée, sortie, raisonnement, cache, nouvelles tentatives, escalades et vérification humaine — rien ne doit manquer
- Mesurer les probabilités sur de vrais échantillons : le taux de nouvelle tentative, le taux d’escalade et le taux d’acceptation déterminent le multiplicateur du coût final
« Ne regardez pas seulement le prix au token » ne veut pas dire que le prix unitaire n’a pas d’importance : il veut dire que ce n’est qu’une variable parmi d’autres dans la formule. Montez votre feuille de calcul, remplissez-la avec vos propres échantillons et vos journaux, et votre conclusion de choix de modèle sera plus fiable que n’importe quel classement.
Nous vous recommandons de passer par APIYI apiyi.com pour comparer plusieurs modèles sur un même lot d’échantillons, en combinant avec les prix unitaires réels de la page tarifs docs.apiyi.com/models pour calculer le coût de vos tâches. La plateforme est compatible avec les formats d’API OpenAI et Anthropic, ce qui rend le changement de modèle très peu coûteux.
📚 Références
- Série d’articles du blog Ofox.ai sur la tarification des modèles et le coût des tâches : plusieurs articles y traitent de la facturation du cache, du seuil de contexte long, de l’intensité de raisonnement et de leur lien avec le coût des tâches.
- Lien :
ofox.ai/blog/page/12 -
Description : utile pour comprendre la différence entre une « baisse du prix unitaire » et une « baisse du coût des tâches ».
-
Articles du blog Ofox.ai sur le routage de modèles et l’extraction structurée : ils abordent les règles de passage d’un petit modèle à un modèle plus puissant, ainsi que l’idée qu’« un JSON valide ne signifie pas que les données sont correctes ».
- Lien :
ofox.ai/blog/page/11 -
Description : à consulter pour concevoir une stratégie de routage et un processus de validation.
-
Page de tarification des modèles APIYI : prix unitaires d’entrée, de sortie et liés au cache pour les modèles pris en charge par la plateforme.
- Lien :
docs.apiyi.com/models -
Description : toutes les informations de prix et de modalités de facturation de cet article se fondent sur les données réelles de cette page.
-
Centre de documentation APIYI : modes d’intégration, formats d’interface et descriptions des paramètres.
- Lien :
docs.apiyi.com - Description : contient les instructions d’intégration aux formats compatibles OpenAI et Anthropic.
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site officiel APIYI apiyi.com. Vous trouverez davantage de ressources d’intégration dans le centre de documentation docs.apiyi.com.