Note de l’auteur : en prenant Meta Muse comme cas d’école, cet article explique ce qu’il faut réellement peaufiner dans un agent IA. L’accent est mis sur le réglage du comportement et la visibilité de l’état, avec des étapes que vous pouvez suivre.
Beaucoup d’équipes qui développent des agents IA rencontrent la même situation : les capacités du modèle sont suffisantes, la démo se passe bien, mais après quelques jours d’utilisation réelle, les utilisateurs s’en vont. Le problème vient rarement du modèle lui-même ; il se situe plutôt dans deux couches qui n’ont pas été assez travaillées : le réglage du comportement et la visibilité de l’état. Cet article prend Meta Muse comme cas d’étude pour décomposer ce que l’on peaufine vraiment quand on peaufine un agent IA.
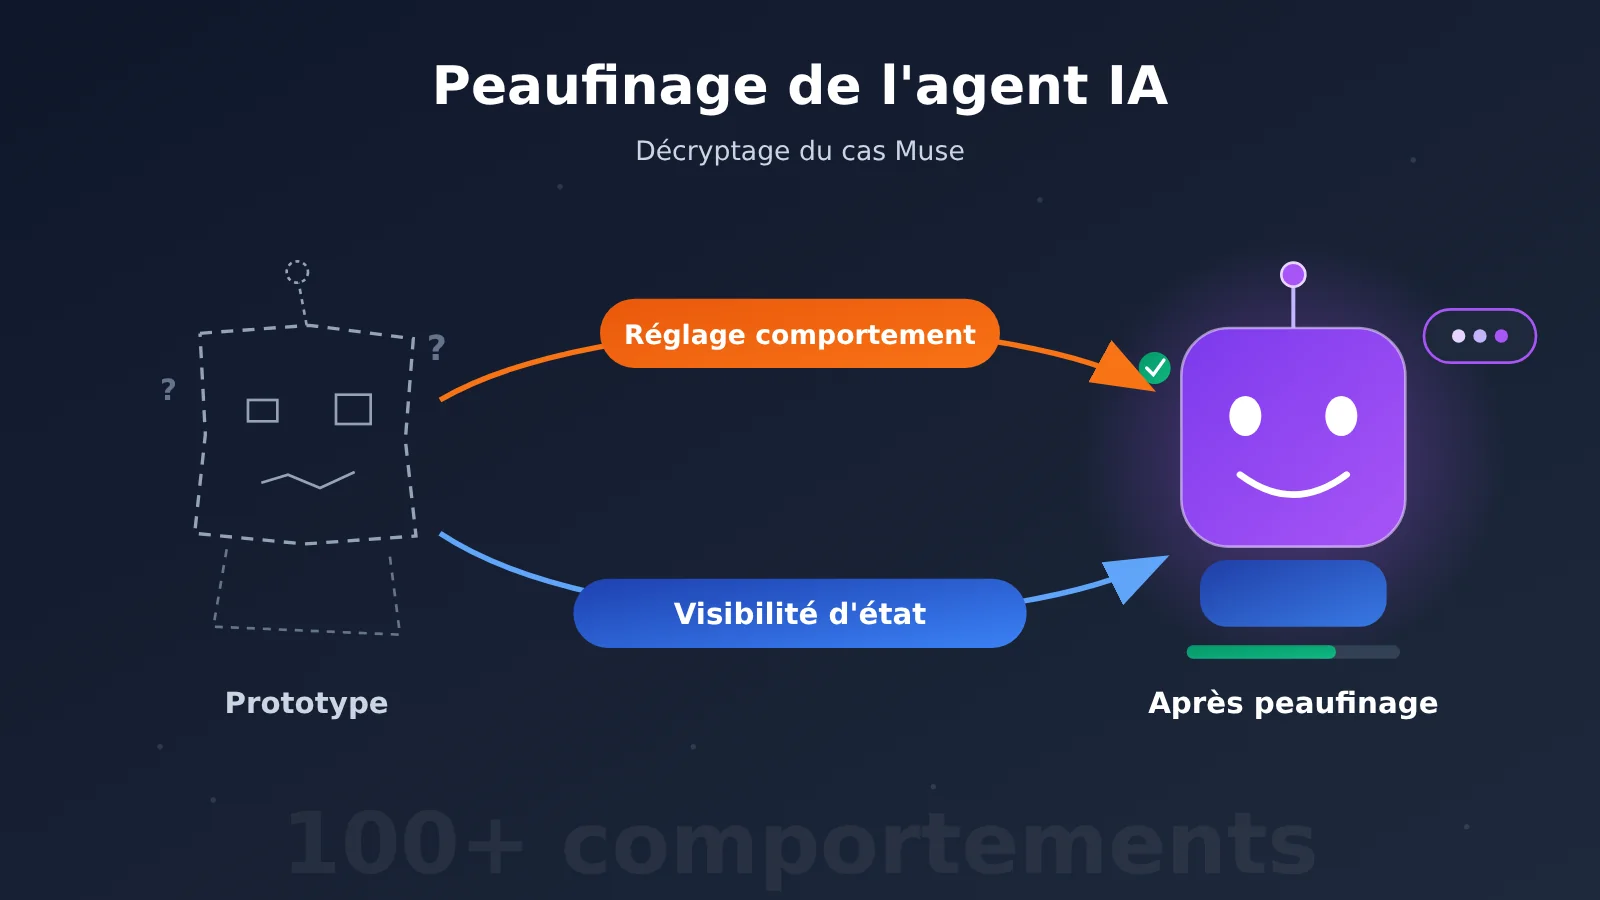
Ce n’est pas un énième texte vague du genre « les détails font la différence ». D’après des informations publiques, l’équipe de Muse a testé et ajusté plus d’une centaine de comportements précis du modèle avant le lancement, et a fait en sorte que l’avatar affiche directement, par des expressions et des mouvements, ce que l’agent est en train de faire. Ces deux aspects peuvent être découpés en tâches d’ingénierie concrètes.
Valeur clé : après avoir lu cet article, vous pourrez transformer le « peaufinage » en une liste de comportements, un tableau des signaux d’état et un processus de test, puis les appliquer directement à votre propre produit d’agent.
Le contexte du peaufinage des agents IA : pourquoi Muse mérite qu’on s’y attarde
Commençons par le contexte. Selon les informations disponibles, la division Reality Labs de Meta, en charge de la VR/AR, aurait perdu environ 19,2 milliards de dollars rien qu’en 2025, et la voie du métavers est globalement perçue de l’extérieur comme un échec coûteux. Zuckerberg ne s’est pourtant pas replié sur son activité publicitaire : il a continué à investir dans les agents IA. Environ six semaines après son lancement, Muse aurait déjà atteint 10 millions d’utilisateurs.
Deux détails de ce projet concernent directement le « peaufinage ». Premièrement, l’équipe est dirigée par Alexander Wang et Nat Friedman, issus de Scale AI, et selon Wang lui-même, les deux axes — modèle et produit — réunissent moins de 200 personnes. Cette petite taille est un choix assumé : il s’agit d’éviter les compromis et les incohérences d’expérience qu’entraînent les décisions prises par consensus dans les grandes équipes. Deuxièmement, Muse n’a pas été positionné comme « le modèle le plus intelligent du marché » : son atout réside dans la réduction de l’écart entre « ce que le modèle sait techniquement faire » et « ce que ressent réellement Monsieur Tout-le-Monde quand il l’utilise », sur des tâches du quotidien comme résilier un abonnement ou suivre ses factures.
Pour les développeurs, le chiffre d’affaires et l’échelle de Muse n’ont pas grand intérêt comme référence. Ce qui vaut la peine d’être étudié, c’est sa conception du « peaufinage » : le peaufinage est un ensemble de comportements concrets et testables, pas un argument marketing.
L’essentiel pour peaufiner un agent IA
Si l’on résume l’approche de Muse, le travail de peaufinage d’un agent IA peut se répartir dans les directions suivantes :
| Point clé | Explication | Bénéfice pour l’utilisateur |
|---|---|---|
| Réglage comportemental | Tester et ajuster un par un les comportements concrets du modèle avant la mise en ligne (plus de cent chez Muse) | Les réactions de l’agent sont prévisibles, sans variations imprévisibles |
| Limites de décision | Définir clairement dans quels cas il agit seul et dans quels cas il demande d’abord à l’utilisateur | Moins de sollicitations, sans sortir de son périmètre |
| Visibilité de l’état | Afficher par un signal visuel ou textuel ce que l’agent est en train de faire | L’utilisateur n’a pas à deviner « est-ce qu’il a compris ? est-ce qu’il travaille ? » |
| Cohérence de l’expérience | Garder un comportement homogène entre les différents points d’entrée et pages | Les petites frictions ne finissent pas par représenter un coût d’usage évident |
| Cas limites | Traiter sérieusement les erreurs, les interruptions, le deuxième et le troisième onglet | L’usage quotidien et répété reste fluide |
Premier point clé du peaufinage d’un agent IA : le réglage comportemental ne signifie pas « un modèle plus intelligent »
« Le modèle est très intelligent » et « l’agent est agréable à utiliser » sont deux choses différentes. Un modèle très performant peut rester agaçant à l’usage s’il ne sait pas quand s’arrêter pour demander confirmation, quand agir directement ou comment rendre compte de sa progression. Les plus de cent comportements ajustés par l’équipe de Muse portent justement sur ces aspects.
Le réglage comportemental porte sur la façon de réagir dans une situation donnée, pas sur les paramètres du modèle. Par exemple, si l’utilisateur dit « aide-moi à résilier cet abonnement », l’agent doit-il d’abord lister les abonnements qu’il a trouvés et demander confirmation, ou bien exécuter directement ? Arrivé à la page de paiement, faut-il confirmer une nouvelle fois ? Chacun de ces points de décision correspond à un comportement à tester et à figer.
Deuxième point clé du peaufinage d’un agent IA : la visibilité de l’état relève de la conception
L’avatar de Muse signale par une petite animation qu’il s’occupe de la tâche en cours ; l’utilisateur n’a pas besoin de lire des messages d’état techniques. Cela répond à la question que se pose toute personne qui confie une tâche à une IA : a-t-elle bien compris ce que je veux ? Est-elle vraiment en train de le faire ?
Faire disparaître cette incertitude relève du travail de conception, et cela doit couvrir chaque recoin du produit, pas seulement le parcours de démonstration. D’après les informations rapportées, Meta avait déjà développé, avant la sortie de son application mobile, une technologie de génération d’expressions faciales et de mouvements synchronisés avec la voix, en préparation d’une expérience vocale en temps réel et de futurs appareils portables. La plupart des entreprises repoussent cette couche à « après la validation de l’idée centrale » ; Muse l’a fait plus tôt.
Affiner un agent IA : 6 étapes pratiques pour bien démarrer
Voici comment réécrire l’approche de Muse sous forme de processus exécutable même par une petite équipe. Pas besoin de centaines de personnes, ni d’un budget à cent milliards : ce qu’il faut, c’est la patience de refaire « une deuxième passe, puis une troisième ».
Étape 1 : établir une liste de comportements de l’agent IA
Commencez par lister les points de décision que l’agent rencontrera dans des tâches réelles, en précisant pour chacun « la condition de déclenchement, le comportement attendu, le contre-exemple ». Pour démarrer, 30 à 50 éléments suffisent ; ensuite, complétez la liste au fil des retours de test. Voici une référence de catégorisation :
| Catégorie de comportement | Point de décision typique | Critère d’affinage |
|---|---|---|
| Confirmation de l’intention | Instruction ambiguë, par exemple « résilie cet abonnement » | En cas de plusieurs candidats, les présenter à l’utilisateur pour qu’il choisisse, sans deviner à sa place |
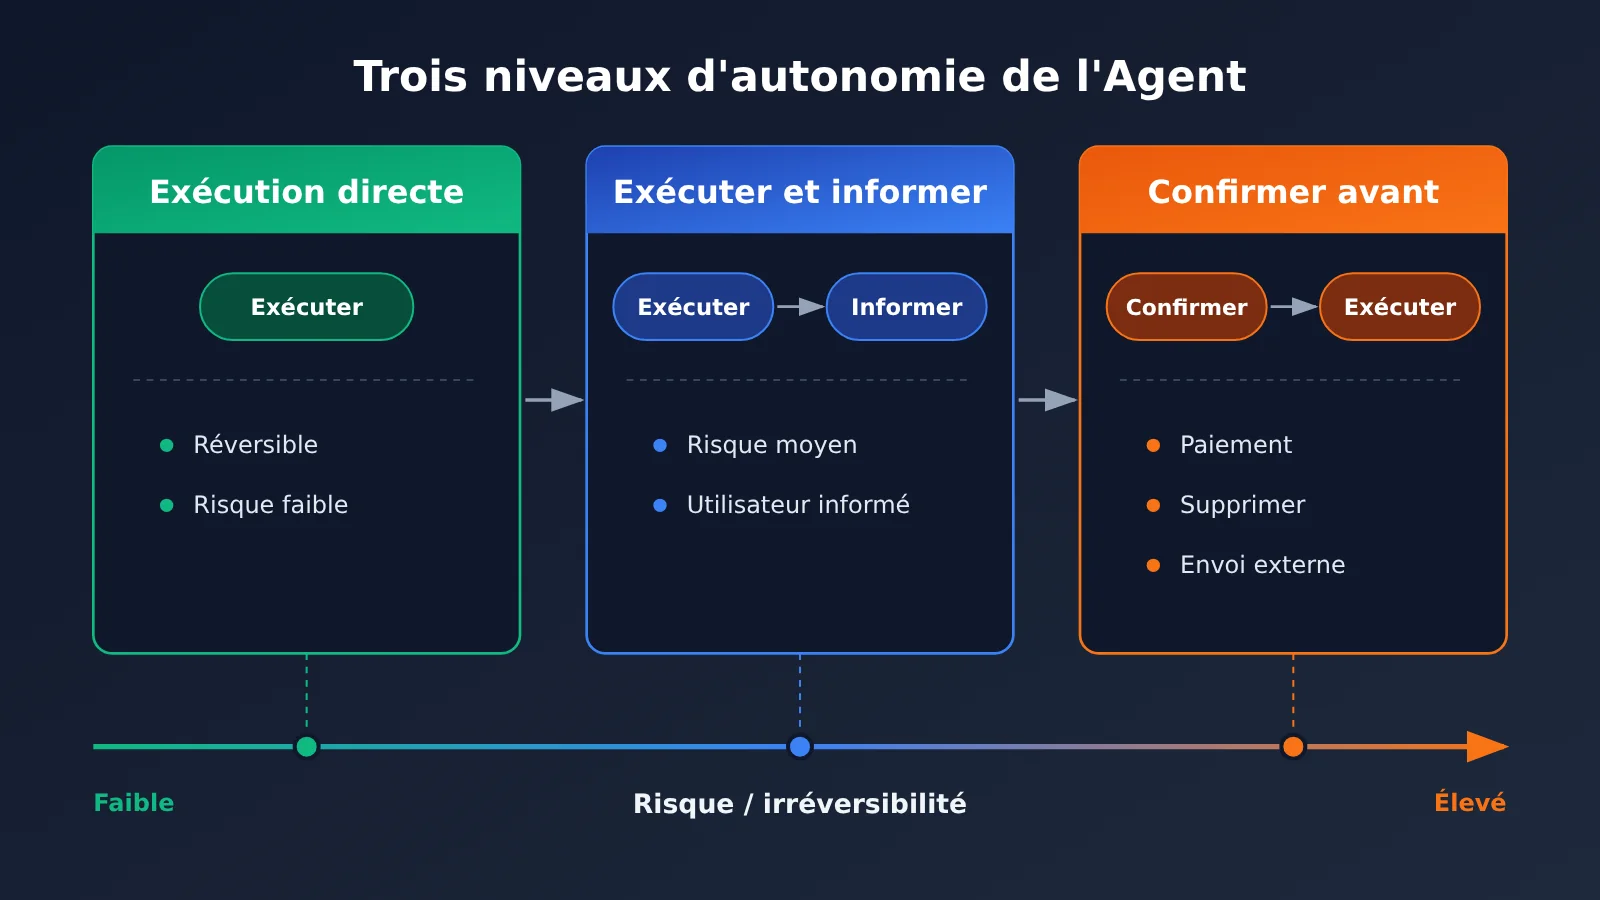
| Exécution autonome | Opération à faible risque et réversible | Exécuter directement, puis faire un bref compte rendu une fois terminé |
| Blocage à haut risque | Paiement, suppression, envoi vers l’extérieur | Double confirmation obligatoire, en expliquant les conséquences |
| Reporting de progression | Tâche en plusieurs étapes, longue à exécuter | Fournir un retour visible à chaque étape clé |
| Gestion des échecs | Site inaccessible, permissions insuffisantes | Expliquer la cause et proposer la suite à donner, jamais d’échec silencieux |
| Clôture de tâche | Tâche terminée | Émettre un signal clair de « terminé » et un résumé du résultat |
Étape 2 : délimiter la frontière entre autonomie et confirmation de l’agent IA
Une fois la liste établie, il faut définir un « niveau d’autonomie » pour chaque type d’opération. La répartition courante se fait en trois niveaux : exécution directe, exécution puis notification, confirmation avant exécution. Le jugement repose principalement sur deux critères : l’opération est-elle réversible, et quel est le coût d’un échec.
C’est à cette étape que les divergences d’opinion au sein de l’équipe apparaissent le plus facilement. C’est précisément pour cela que Muse fonctionne avec une petite équipe : les questions de frontière exigent qu’une personne soit responsable de l’expérience globale et tranche, plutôt que de laisser chaque module décider de manière « localement raisonnable ». Sinon, on arrive à la situation où la même opération demande une confirmation sur la page A mais s’exécute directement sur la page B.
Étape 3 : mapper les états internes de l’agent IA sur des signaux visibles par l’utilisateur
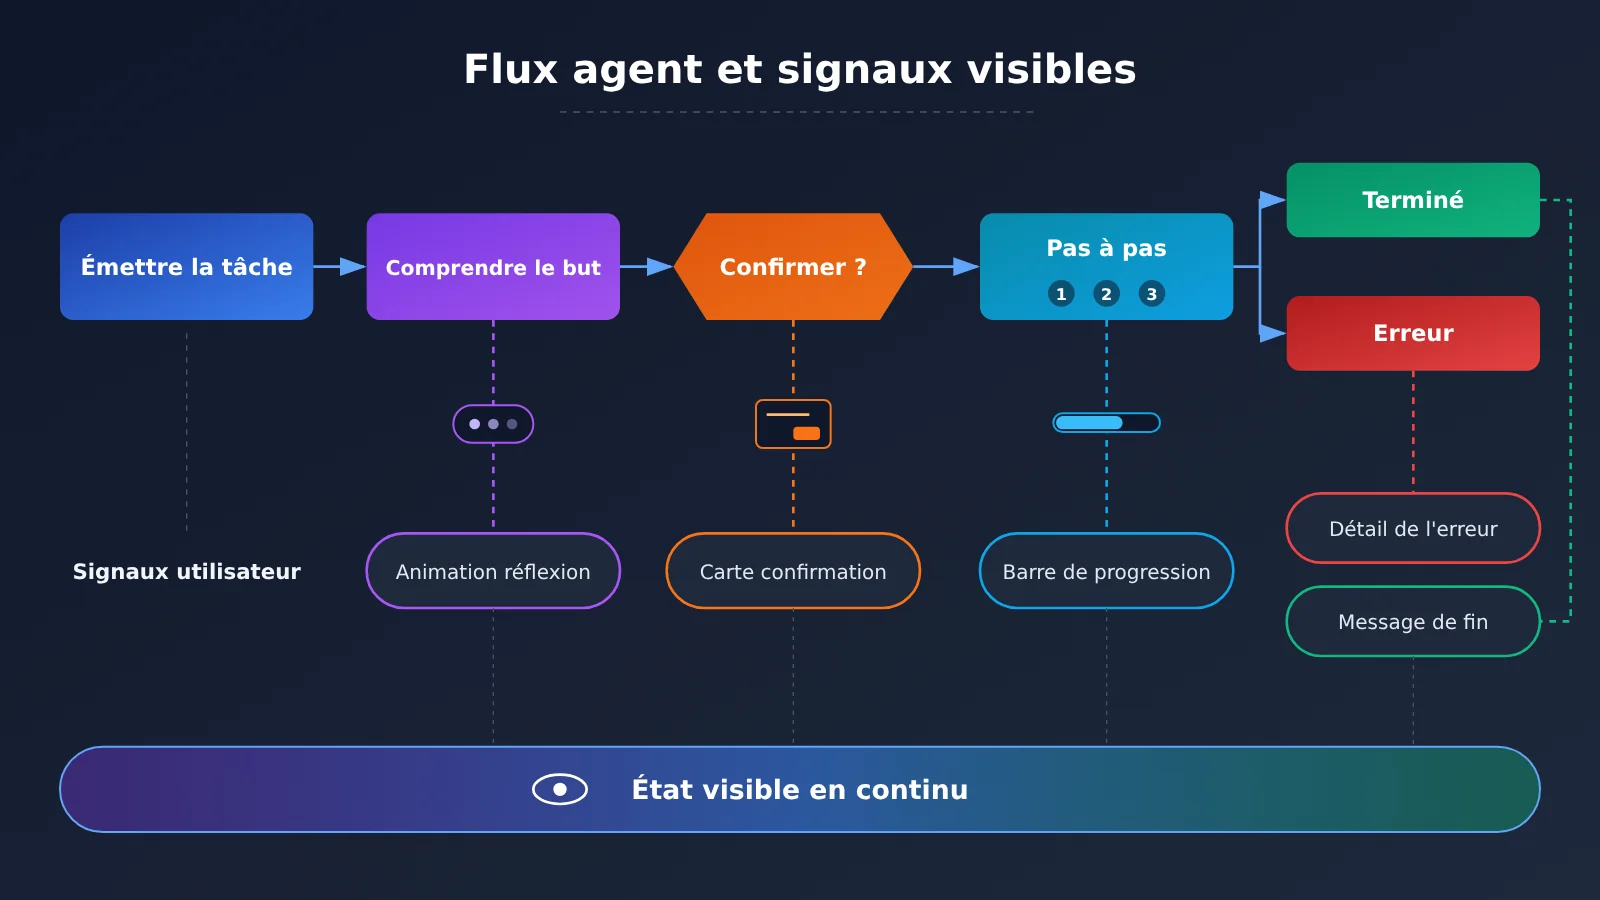
L’agent possède de nombreux états internes, mais l’utilisateur ne s’intéresse qu’à quelques-uns. En pratique, on regroupe les états internes en 5 à 6 états compréhensibles par l’utilisateur, puis on associe à chacun un signal fixe :
| État interne de l’agent | Signal visible par l’utilisateur | Contre-exemple courant |
|---|---|---|
| Analyse de l’intention / planification | Animation de réflexion ou « je comprends votre besoin » | Écran blanc pendant plusieurs secondes, l’utilisateur croit que c’est bloqué |
| Appel d’outil / accès à un service externe | Afficher le nom de l’étape en cours, par ex. « ouverture de la page d’abonnement » | Afficher directement le nom brut de l’outil ou le JSON |
| En attente de confirmation utilisateur | Mettre en évidence la carte de confirmation, en précisant les conséquences | Cacher la question de confirmation dans une longue réponse |
| En cours d’exécution (multi-étapes) | Progression par étapes, avec indication de ce qui est terminé et en cours | Une seule icône de chargement circulaire |
| Terminé | Marqueur d’achèvement clair et résumé du résultat | La réponse se termine, mais on ne sait pas si la tâche a réussi |
| Erreur / interruption | Expliquer la cause en langage courant et les actions possibles | Erreur technique, ou absence totale de retour |
Côté ingénierie, on peut exploiter la sortie en streaming de l’interface du modèle pour piloter ces signaux. Avec le format compatible OpenAI, activer stream renvoie le contenu et les appels d’outils par segments ; les événements de streaming du format Anthropic Messages distinguent les blocs de texte des blocs tool_use. Le front-end écoute ces événements et bascule vers l’état visible correspondant, sans attendre la fin de la réponse complète.
Étape 4 : Concevoir un jeu de tests comportementaux pour l’agent IA
Chaque comportement doit avoir son cas de test correspondant, en couvrant au minimum trois situations : « entrée normale, entrée ambiguë, environnement anormal ». Lors des tests, il ne suffit pas de vérifier si la réponse est correcte, il faut aussi regarder :
- Si l’agent demande confirmation là où il le faut, et s’il ne pose pas de questions inutiles là où il ne devrait pas déranger ;
- Si les signaux d’état apparaissent bien à chaque étape, au bon moment ;
- Si le comportement reste cohérent quand la même tâche est lancée depuis différentes entrées ;
- Si, en cas d’erreur, l’utilisateur comprend ce qui s’est passé et sait quoi faire ensuite.
Je vous conseille de figer ce jeu de tests et de le rejouer intégralement à chaque modification d’invite, changement de modèle ou ajustement d’outil, pour éviter de réparer un point et d’en casser trois.
Étape 5 : Faire des comparaisons sur différents modèles de base pour l’agent IA
Muse le dit bien : la valeur de la couche de peaufine ne dépend pas du « modèle le plus puissant ». Une même liste de comportements donnera des résultats différents selon le modèle, il faut donc comparer en parallèle pour trouver la combinaison qui respecte les standards comportementaux à un coût raisonnable.
| Étape de peaufine | Besoin principal vis-à-vis du modèle | Piste de sélection | Plateformes disponibles |
|---|---|---|---|
| Analyse d’intention et planification | Raisonnement stable, respect des instructions | Privilégier un modèle phare ou de type raisonnement | APIYI apiyi.com, API officielle |
| Exécution des appels d’outils | Format d’appel de fonction stable | Choisir un modèle fiable sur l’appel d’outils | APIYI apiyi.com, API officielle |
| Textes de progression / annonces d’état | Réponse rapide, coût faible | Choisir un modèle léger et rapide | APIYI apiyi.com, API officielle |
| Évaluation par lots du jeu de tests | Volume important, reproductible | Choisir un modèle au bon rapport qualité-prix pour l’évaluation | APIYI apiyi.com, API officielle |
🎯 Conseil technique : pour les comparaisons multi-modèles, vous pouvez passer par un appel unifié via APIYI apiyi.com. APIYI fournit les API des principaux grands modèles de langage évoqués dans cet article, et reste compatible avec les deux formats d’interface OpenAI et Anthropic : le même code d’agent peut comparer en changeant simplement le paramètre
model, sans écrire de couche d’adaptation spécifique pour chaque fournisseur. Pour les modalités d’accès et les adresses d’interface, référez-vous au centre de documentation d’APIYI : docs.apiyi.com.
Étape 6 : Continuer à travailler les « deuxième et troisième passes » de l’expérience des agents IA
Dans les ressources de référence, une métaphore revient : refaire la façade d’un restaurant ne suffit pas, il faut aussi nettoyer les toilettes. Les outils d’IA actuels permettent de produire très vite une belle première version, ce qui pousse paradoxalement à enchaîner les nouvelles premières versions au lieu de corriger ce qui, dans le produit existant, « fonctionne mais reste désagréable à utiliser ».
Je vous conseille de choisir chaque semaine, dans les traces d’utilisation réelles, des moments où l’utilisateur hésite, repose la même question ou abandonne en cours de route, puis de revenir à l’étape 1 pour enrichir la liste de comportements. Les produits que l’on réutilise se construisent justement dans ces deuxième et troisième passes, peu visibles.
💰 Note sur les coûts : le jeu de tests comportementaux doit être exécuté encore et encore, et le volume d’appels est conséquent. Pour les prix unitaires d’entrée et de sortie de chaque modèle ainsi que les règles de facturation du cache, fiez-vous aux données réelles de la page de tarifs APIYI https://docs.apiyi.com/models ; cet article ne donne pas de prix précis.
Comparaison des approches pour peaufiner un agent IA
| Approche | Principe de base | Cas d’usage | Limites principales |
|---|---|---|---|
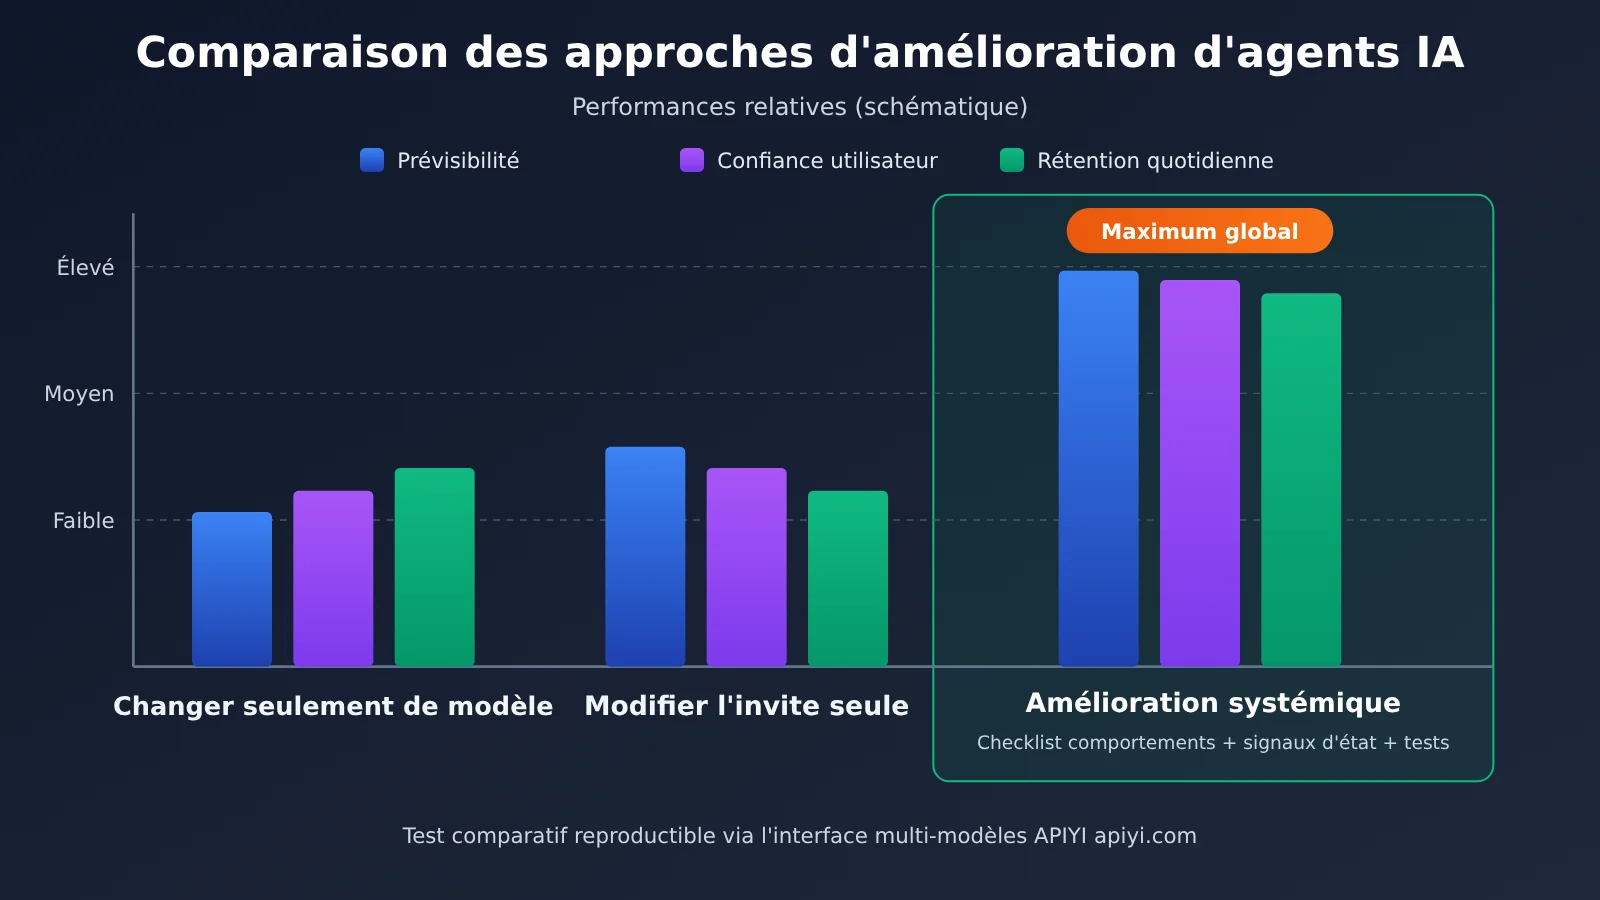
| Remplacer uniquement par un modèle plus puissant | Mettre à niveau le modèle de base en espérant que l’expérience s’améliore d’elle-même | Prototypes précoces aux capacités clairement insuffisantes | Coûts plus élevés ; les problèmes de comportement (confirmations, comptes rendus, etc.) persistent |
| Modifier uniquement les invites | Empiler des règles dans l’invite système | Retouches ciblées de problèmes isolés | Les règles s’accumulent et deviennent confuses ; sans tests, elles entrent facilement en conflit |
| Peaufiner systématiquement | Liste de comportements + limites d’autonomie + signaux d’état + jeu de tests | Agents orientés tâches quotidiennes pour de vrais utilisateurs | Investissement initial important ; il faut une personne dédiée responsable de l’expérience globale |
Analyse comparative des approches de peaufinage d’un agent IA
Analyse comparative : remplacer uniquement le modèle : un modèle plus puissant est certes plus performant sur les raisonnements complexes, mais il ne sait pas de lui-même quelles opérations de votre produit doivent être confirmées avant exécution, ni comment afficher la progression. À l’inverse, le peaufinage systématique s’attaque directement aux frictions ressenties par les utilisateurs. Muse en est un exemple : sans s’appuyer sur le modèle le plus puissant, il a réussi une belle croissance initiale.
Analyse comparative : modifier uniquement les invites : retoucher les invites donne des résultats rapides et convient aux problèmes ponctuels. Mais sans liste de comportements ni jeu de tests, les règles entrent facilement en conflit : on corrige un point et on en casse un autre. Pour un agent destiné à fonctionner sur la durée, le peaufinage systématique est plus fiable.
💡 Note comparative : je vous conseille de vérifier ces différences entre approches sur vos propres données métier. Vous pouvez utiliser APIYI apiyi.com pour faire tourner le même jeu de tests sur plusieurs modèles et comparer, puis croiser avec les données de la page de tarifs pour évaluer le retour sur investissement.
FAQ sur le peaufinage des agents IA
Q1 : Qu’entend-on précisément par « peaufinage » d’un agent IA ?
Il s’agit de tester, d’ajuster puis de figer, point par point, le comportement de l’agent dans des tâches réelles : quand il demande confirmation, quand il agit de façon autonome, comment il rend compte de sa progression, comment il explique une erreur — le tout en veillant à ce que l’utilisateur puisse voir à tout instant l’état courant de l’agent. C’est un travail d’ingénierie testable, pas une vague « optimisation de l’expérience ».
Q2 : Quelle différence entre le réglage comportemental et l’ingénierie des invites ?
L’ingénierie des invites n’est qu’un moyen parmi d’autres ; le réglage comportemental est à la fois l’objectif et la méthodologie. On commence par définir une « liste des comportements attendus » et un jeu de tests, puis on les implémente via les invites, la conception des outils, l’interaction côté front-end, etc., en validant en continu par régression. Se contenter de modifier les invites sans construire de jeu de tests rend la cohérence très difficile à garantir.
Q3 : Quelles sont la taille d’audience et la taille d’équipe de Muse ?
D’après les informations rapportées, Muse a atteint 10 millions d’utilisateurs environ six semaines après son lancement. Selon Alexander Wang, les équipes modèle et produit réunies comptent moins de 200 personnes. Rapporté à l’échelle habituelle de Meta — plusieurs milliards d’utilisateurs —, ce n’est qu’un début : il reste à réduire le coût du service et à passer à l’échelle.
Q4 : À quels scénarios d’agents la visibilité de l’état convient-elle le mieux ?
Elle convient principalement aux cas suivants :
– **Tâches de type démarche** : résiliation d’abonnements, suivi de factures, remplissage de formulaires et autres opérations en plusieurs étapes ;
– **Tâches longues** : lorsqu’il faut visiter plusieurs sites ou appeler plusieurs outils, l’exécution dure longtemps ;
– **Opérations à risque élevé** : paiements, suppressions, envois vers l’extérieur, tous les flux qui exigent une confirmation explicite de l’utilisateur.
Q5 : Comment monter rapidement un environnement de test multi-modèles pour le peaufinage d’agents ?
Voici les étapes :
1. Créez un compte sur APIYI apiyi.com et récupérez votre clé API ;
2. Consultez le centre de documentation docs.apiyi.com et intégrez-vous au format compatible OpenAI ou Anthropic ;
3. Avec le même jeu de tests comportementaux, faites tourner les comparaisons en changeant successivement le paramètre `model` ;
4. En vous appuyant sur les données de facturation réelles de la page de tarifs https://docs.apiyi.com/models, choisissez la combinaison de modèles adaptée.
Q6 : Quels sont les coûts et les limites d’un peaufinage systématique ?
– **Investissement initial** : construire la liste des comportements et le jeu de tests prend du temps, et on ne voit aucune « nouvelle fonctionnalité » à court terme ;
– **Coût des appels** : les tests de régression appellent le modèle de façon répétée ; la facturation suit la page de tarifs de la plateforme utilisée ;
– **Exigences d’organisation** : il faut quelqu’un pour trancher sur l’expérience globale, faute de quoi les règles de périmètre deviennent incohérentes à force de compromis entre les parties ;
– **Limites** : le peaufinage ne comble pas les lacunes profondes de capacité du modèle ; quand les capacités sont manifestement insuffisantes, il faut changer de modèle.
L’essentiel pour peaufiner un agent IA
- Le peaufinage peut être testé : avant le lancement de Muse, plus d’une centaine de comportements précis du modèle ont été ajustés ;
- Être utile ne signifie pas être le plus intelligent : l’avantage de Muse est de réduire les frictions d’usage, pas d’être le modèle le plus capable ;
- Les limites doivent être tranchées par quelqu’un : les règles sur l’exécution autonome et la confirmation préalable doivent être unifiées, et non décidées module par module ;
- L’état doit être visible : utiliser des signaux pour répondre à l’utilisateur : « a-t-il compris ? est-il en train de faire ? a-t-il terminé ? » ;
- Les cas limites comptent tout autant : les erreurs, les interruptions, le deuxième onglet et le parcours de démonstration méritent le même soin ;
- Comparer plusieurs modèles est plus fiable : via l’interface unifiée d’APIYI, comparer différents modèles sur le même jeu de tests.
Conclusion
Les points clés pour peaufiner un agent IA :
- Réglage comportemental : transformer les points de décision en une liste de contrôle, en précisant pour chacun les conditions de déclenchement, le comportement attendu et un contre-exemple, puis faire des tests de régression en continu avec un jeu de tests ;
- Visibilité de l’état : regrouper les états internes en quelques signaux compréhensibles par l’utilisateur, tout au long du parcours : compréhension, exécution, confirmation, achèvement et erreur ;
- Itération continue : repérer les points de friction dans les traces d’usage réel, et persévérer pour faire une deuxième, puis une troisième passe, plutôt que de refaire sans cesse la première version.
L’expérience de Muse s’applique aussi aux petites et moyennes équipes : l’équipe réduite prend les décisions clés, traite les détails ennuyeux avec sérieux, et après un échec, change ce qui compte vraiment avant de réessayer. Tout cela sans devoir d’abord perdre des dizaines de milliards.
Si vous préparez un jeu de tests comportementaux pour votre agent, vous pouvez comparer rapidement plusieurs modèles via APIYI apiyi.com. La plateforme est compatible avec les formats d’API OpenAI et Anthropic ; les instructions d’intégration sont sur docs.apiyi.com, et la facturation est décrite sur la page des tarifs https://docs.apiyi.com/models.
📚 Références
- MindStudio – Analyse de cas de Muse de Meta : contexte, équipe et détails de peaufinage de Muse
- Lien :
mindstudio.ai/blog/meta-muse-ai-companion-lessons -
Description : principale source des faits de cette étude de cas, publiée le 4 novembre 2026
-
Centre de documentation APIYI : instructions d’accès unifié multi-modèles
- Lien :
docs.apiyi.com -
Description : méthodes d’accès aux formats compatibles OpenAI et Anthropic
-
Page de tarification des modèles APIYI : base de facturation et prix unitaires de chaque modèle
- Lien :
docs.apiyi.com/models - Description : les prix unitaires d’entrée, de sortie et de cache sont basés sur les données réelles de cette page
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter sur le site officiel APIYI apiyi.com pour échanger sur les pratiques de peaufinage d’agents. Pour plus de ressources, consultez le centre de documentation docs.apiyi.com