Note de l’auteur : un utilisateur d’opencode a découvert que « la mémoire ne fonctionne qu’au sein d’une session ». Cet article explique ce que cela signifie, ses limites et les 6 critères à examiner pour choisir une solution de mémoire entre sessions.
Si vous utilisez régulièrement des outils de programmation IA comme opencode, cette situation vous parlera peut-être : hier, vous avez passé des heures à discuter des conventions du projet avec l’IA. Aujourd’hui, vous ouvrez une nouvelle session et elle vous repose les mêmes questions, comme si vous ne vous étiez jamais rencontrés. En novembre 2026, un utilisateur de V2EX a expliqué dans un message qu’après avoir lu une autre discussion, il avait découvert que la mémoire d’opencode était limitée à la session. Il a donc demandé quel plugin de mémoire installer.
Ce n’est ni une impression isolée, ni un problème propre à un seul outil. La mémoire limitée à la session est le fonctionnement par défaut de nombreux outils de programmation IA. Précisons toutefois que le message d’origine ne contient qu’une phrase : la discussion qu’il cite ne fait pas partie des sources dont nous disposons, et pour une description complète du fonctionnement de la mémoire d’opencode, mieux vaut consulter la documentation officielle. Cet article ne recommande donc aucun plugin en particulier. Il présente plutôt les questions à se poser pour choisir une solution de mémoire entre sessions.
L’essentiel : après cette lecture, vous pourrez déterminer si vous avez vraiment besoin d’une mémoire entre sessions et évaluer n’importe quel plugin de mémoire ou solution alternative selon 6 critères, pour éviter qu’un plugin ne vienne compliquer votre contexte au lieu de l’améliorer.
Qu’est-ce que la mémoire de session des outils de programmation IA ?
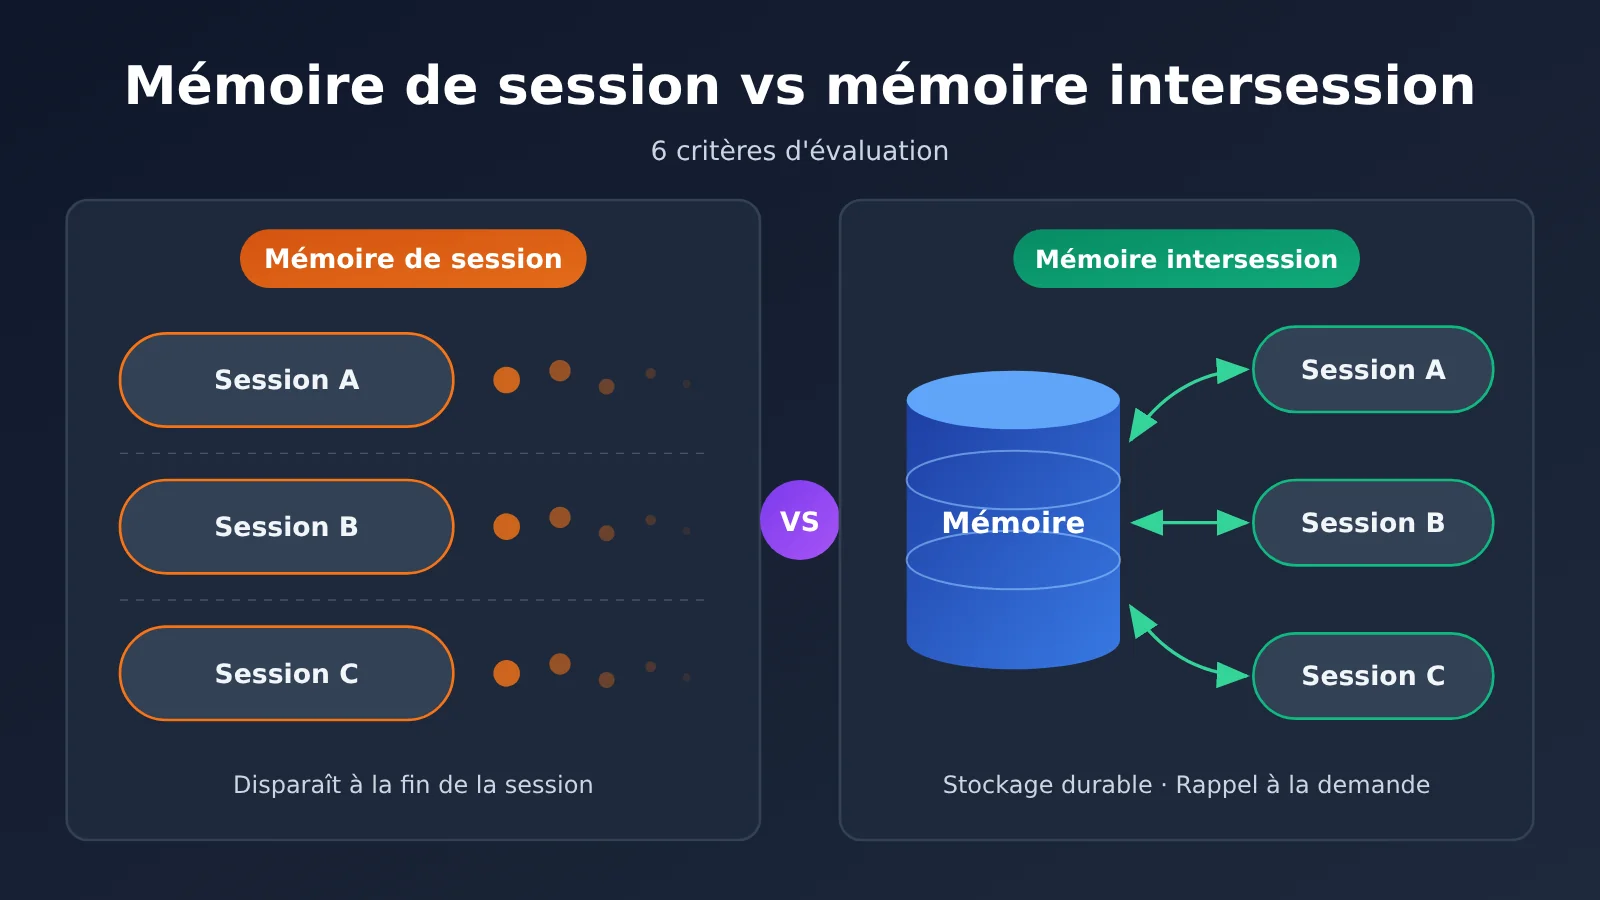
L’expression « mémoire de session » n’est pas un terme technique strict. La communauté l’utilise généralement pour décrire un phénomène : l’IA se souvient de ce que vous avez dit au cours d’une conversation, mais ne reprend pas automatiquement ces informations dans une nouvelle session. Pour bien comprendre, il faut d’abord distinguer plusieurs types de « mémoire » souvent confondus.
| Niveau de mémoire | Description | Ce que cela signifie pour l’utilisateur |
|---|---|---|
| Fenêtre de contexte | Ensemble du contenu accessible au modèle pour une requête, y compris les messages précédents et les fichiers lus | C’est ce qui permet à l’IA de « se souvenir » pendant une session, mais sa taille est limitée |
| Historique de session | Messages d’une même session enregistrés par l’outil, que l’on peut consulter ou reprendre | Permet de retrouver une session, sans influencer automatiquement les nouvelles |
| Instructions au niveau du projet | Fichiers de règles présents dans le projet et lus au démarrage de l’outil | La forme la plus stable de « convention à long terme », mais qui demande une maintenance manuelle |
| Mémoire intersessions | Informations extraites, stockées et rappelées automatiquement ou de façon semi-automatique | Permet aux nouvelles sessions de profiter des expériences passées, mais demande de choisir et de gérer une solution adaptée |
Comment fonctionne la mémoire de session
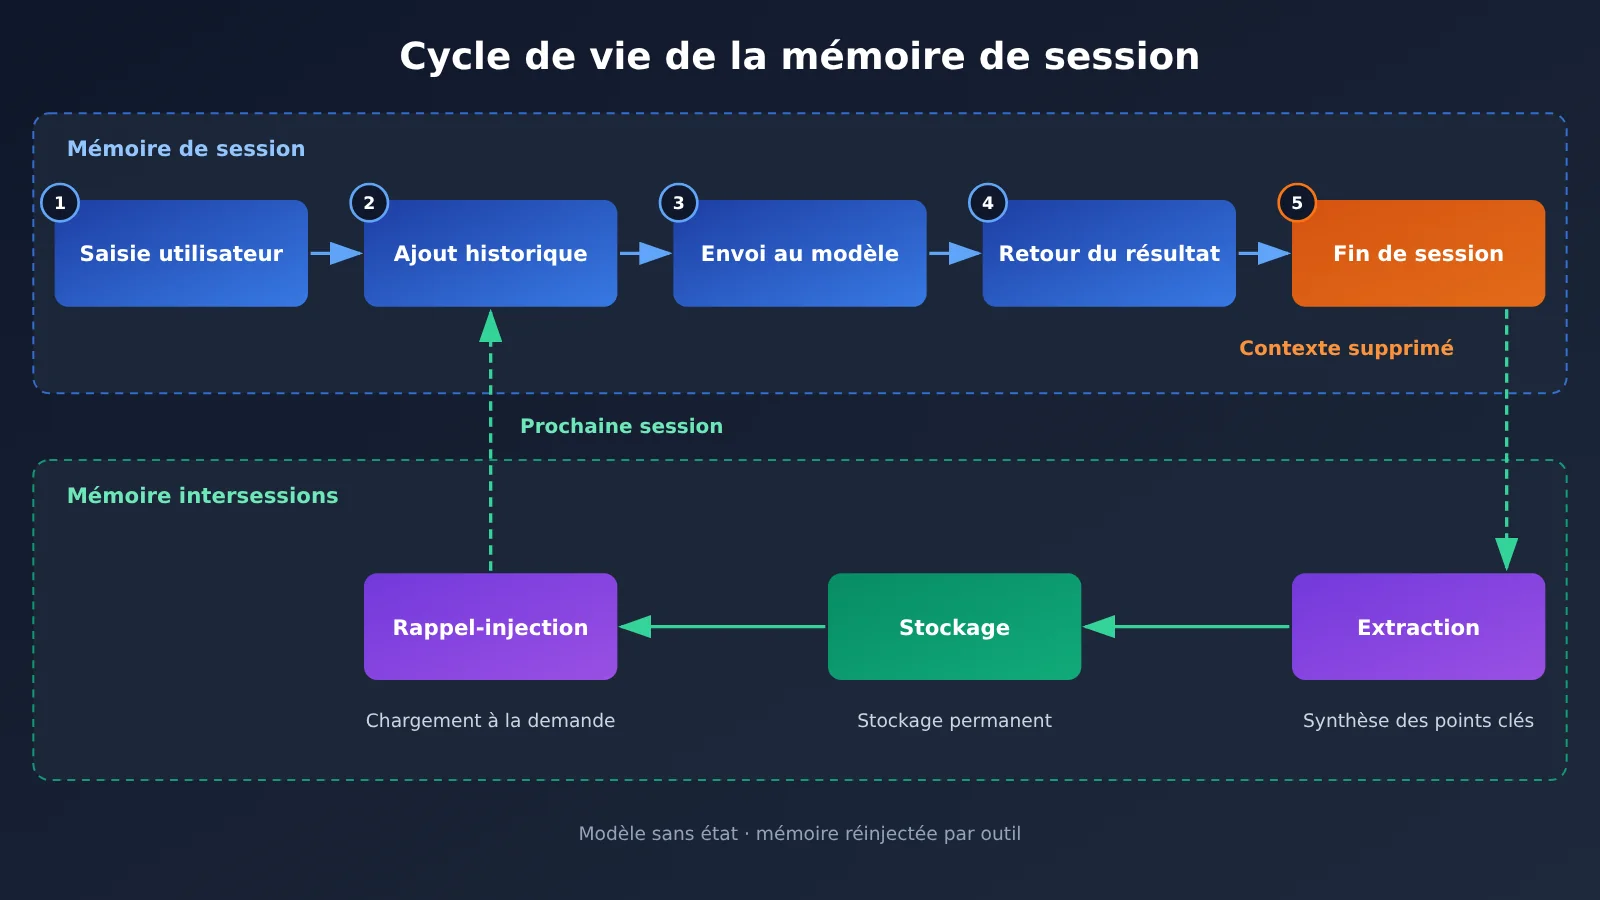
Un grand modèle de langage est lui-même sans état. À chaque requête, l’outil doit envoyer au modèle l’historique de la conversation, les instructions système et le contenu des fichiers pertinents pour qu’il « sache » ce qui s’est passé auparavant. Autrement dit, si l’IA se souvient de quelque chose pendant une session, c’est essentiellement parce que l’outil réinjecte continuellement l’historique dans la fenêtre de contexte.
Cela signifie qu’une fois la session terminée, la suivante repart de zéro, sauf si l’outil a enregistré certaines informations ailleurs et les récupère au prochain démarrage. Plus une session est longue et son historique volumineux, plus l’outil risque de le compresser ou de le tronquer. Des détails du début peuvent donc être « oubliés » au sein même d’une session.
Les limites de la mémoire de session
La mémoire de session présente trois limites principales. D’abord, il faut se répéter : à chaque nouvelle session, vous devez repréciser la pile technique, les conventions de nommage et les dépendances interdites. Ensuite, l’expérience ne s’accumule pas : si vous trouvez une solution après avoir rencontré un problème, l’IA ne la connaîtra pas la prochaine fois qu’un problème similaire se présentera. Enfin, passer d’une tâche à l’autre coûte plus de temps : si vous ouvrez plusieurs sessions pour travailler sur différents modules d’un même projet, elles ne partagent pas leur contexte.
La mémoire de session a toutefois ses avantages : le contexte reste propre, les anciennes hypothèses erronées ne viennent pas contaminer les nouvelles tâches et les limites de confidentialité sont plus claires. Ce sont ces compromis qu’il faudra évaluer au moment de choisir une solution.
Pourquoi utiliser une mémoire intersessions : commencez par vérifier si vous en avez vraiment besoin
Tout le monde n’a pas besoin d’un plugin de mémoire intersessions. Beaucoup en installent un dès qu’ils découvrent que la mémoire est limitée à une session, puis se retrouvent avec un système supplémentaire à entretenir pour un bénéfice peu évident. Avant de vous lancer, comparez votre situation aux cas ci-dessous.
| Situation | Mémoire intersessions nécessaire ? | Approche plus adaptée |
|---|---|---|
| Vous devez réexpliquer les conventions du projet à chaque nouvelle session | Pas forcément | Commencez par rédiger un fichier d’instructions au niveau du projet |
| Vous maintenez un même grand projet sur la durée et avez accumulé de nombreux retours d’expérience | Oui | Envisagez une solution de mémoire consultable |
| La plupart de vos tâches sont des scripts ponctuels ou de petits problèmes indépendants | Non | Contentez-vous d’une mémoire limitée à la session |
| Plusieurs membres de l’équipe partagent les mêmes conventions d’utilisation de l’IA | En partie | Placez les conventions dans le dépôt et soumettez-les au contrôle de version |
| Vous manipulez des informations sensibles, comme du code client ou des clés | Prudence | Privilégiez le stockage local ou ne consignez que des informations anonymisées |
| Vous souhaitez que l’IA retienne vos préférences de code personnelles | Oui | Utilisez une mémoire au niveau utilisateur, distincte de celle du projet |
En pratique, devoir réexpliquer les conventions d’un projet est le problème le plus fréquent. Pourtant, un fichier d’instructions bien entretenu suffit à en résoudre une bonne partie. La mémoire intersessions automatisée devient surtout utile pour les connaissances éparses d’un projet de longue durée, difficiles à documenter à l’avance : le comportement étrange d’une interface, par exemple, ou la véritable cause d’un échec de compilation.
Autre point facile à négliger : plus la mémoire contient d’informations, plus le contexte injecté à chaque fois est volumineux, et plus il consomme de tokens. La recherche et la synthèse des souvenirs intersessions nécessitent souvent des invocations supplémentaires du modèle. Pour évaluer d’abord la qualité et le coût des résumés produits par différents modèles, vous pouvez comparer plusieurs modèles courants via l’interface unifiée d’APIYI apiyi.com, avec une même méthode d’invocation.
4 approches pour garder une mémoire entre les sessions
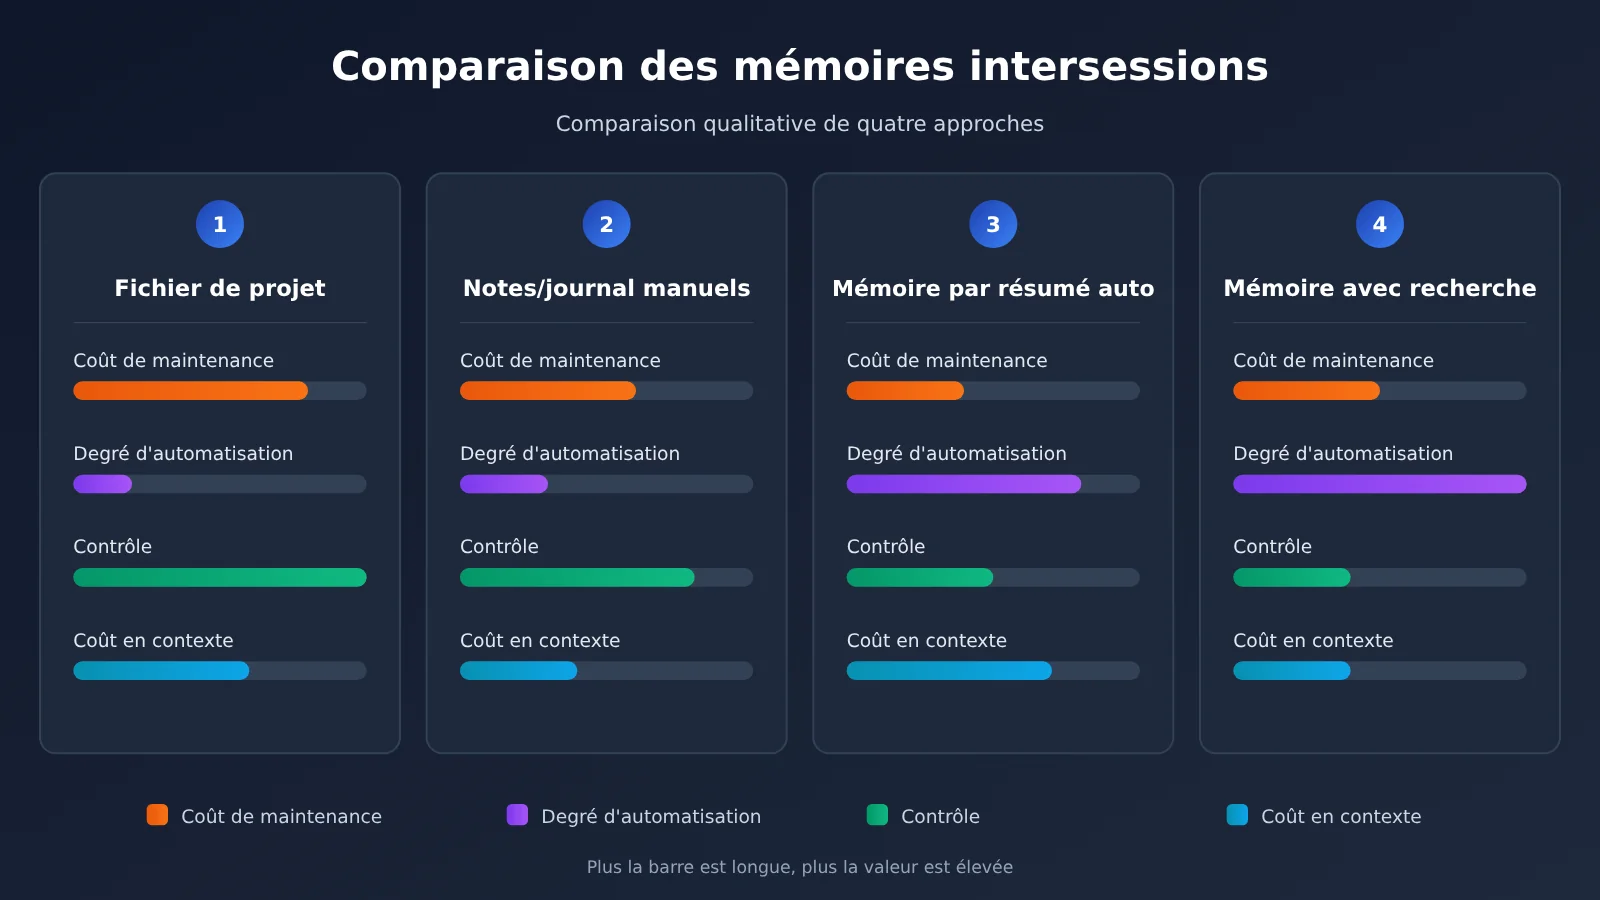
Les réponses de la communauté au message d’origine et les détails des plugins ne font pas partie des sources de cet article. Nous avons donc regroupé les solutions courantes en 4 catégories selon leur approche. Pour évaluer un plugin de mémoire, commencez par déterminer à quelle catégorie il appartient, puis examinez les compromis qu’il fait.
| Type de solution | Caractéristique principale | Cas d’utilisation | Capacités nécessaires |
|---|---|---|---|
| Fichiers d’instructions du projet | Règles rédigées manuellement et chargées en entier au démarrage | Règles stables, partage en équipe | Outil capable de lire les fichiers de règles |
| Notes manuelles / journal de travail | L’IA rédige un résumé en fin de session, puis l’utilisateur le fournit manuellement à la session suivante | Projets personnels, besoins légers | Capacité de synthèse du modèle |
| Mémoire par résumé automatique | Un outil ou un plugin extrait et conserve automatiquement les points importants | Utilisation fréquente, sans maintenance manuelle | Modèle de résumé, accessible notamment via APIYI |
| Base de mémoire avec recherche | Mémoires stockées sous forme vectorielle et retrouvées selon leur pertinence | Grands projets à long terme, volume important d’expérience accumulée | Modèle d’embedding et stockage, souvent accessibles via une extension comme MCP |
À propos du graphique : la comparaison ci-dessus est qualitative et porte sur les approches, pas sur les résultats de tests d’un plugin particulier. Pour tester concrètement les modèles utilisés pour le résumé automatique ou la recherche de souvenirs, vous pouvez passer d’un modèle à l’autre via APIYI apiyi.com et comparer leurs résultats.
Comparaison des solutions de mémoire entre sessions
Fichiers d’instructions du projet : ils offrent le plus de contrôle et de transparence. Leur contenu se trouve dans le dépôt : on peut l’examiner, revenir à une version précédente et le partager en équipe. En revanche, il faut les maintenir soi-même, et ils ne retiennent pas les expériences ponctuelles qu’on n’a pas pensé à y consigner. Les solutions de mémoire automatisée sont plus adaptées pour accumuler des informations qu’on n’aurait pas pensé à noter à l’avance.
Notes manuelles : demander à l’IA de rédiger un journal de travail en fin de session, puis le fournir à la session suivante, est la solution la moins coûteuse et ne nécessite aucune dépendance. Elle demande toutefois de la régularité, et les journaux doivent être organisés à mesure qu’ils s’accumulent. C’est le point de départ le plus sûr pour les personnes qui viennent de découvrir les limites de la mémoire propre à chaque session et qui ne savent pas encore à quel point elles ont besoin d’une solution plus avancée.
Mémoire par résumé automatique et base de mémoire avec recherche : ces deux approches sont plus automatisées et conviennent aux utilisateurs intensifs. La qualité des informations retrouvées varie toutefois, et elles peuvent injecter des souvenirs obsolètes ou erronés dans une nouvelle session. Ces problèmes sont aussi plus difficiles à diagnostiquer qu’avec des fichiers d’instructions. Pour choisir ce type de solution, la possibilité de consulter et de supprimer les souvenirs, abordée plus loin, est particulièrement importante.
Comment choisir une solution de mémoire intersession : 6 critères
Quel que soit le plugin recommandé par la communauté, vous pouvez l’évaluer à l’aide des 6 critères ci-dessous. L’écosystème des plugins évolue vite : consultez la documentation la plus récente de chaque projet pour connaître ses fonctionnalités.
| Critère | Questions à se poser | Situation idéale |
|---|---|---|
| 1. Emplacement du stockage | La mémoire est-elle stockée localement, dans le répertoire du projet ou sur un service distant ? | Stockage local possible pour les projets sensibles, destination des données clairement identifiée |
| 2. Mode d’enregistrement | Les informations sont-elles extraites automatiquement, enregistrées par l’IA via un outil ou confirmées manuellement ? | Les informations importantes peuvent être confirmées manuellement |
| 3. Mécanisme de rappel | Toute la mémoire est-elle injectée ou les informations sont-elles recherchées selon leur pertinence ? Peut-on contrôler le nombre d’éléments récupérés ? | Rappel à la demande pour éviter de saturer le contexte |
| 4. Observabilité | Peut-on consulter, modifier et supprimer les informations mémorisées ? | La mémoire est lisible et peut être corrigée à tout moment |
| 5. Portée | Les mémoires sont-elles distinguées selon l’utilisateur, le projet et la session ? | Les mémoires des différents projets ne se mélangent pas |
| 6. Coût et compatibilité | Y a-t-il des invocations supplémentaires du modèle ? Le plugin risque-t-il de cesser de fonctionner après une mise à jour de l’outil ? | Coûts estimables et maintenance active |
Stockage et enregistrement de la mémoire intersession
L’emplacement du stockage détermine le niveau de confidentialité. Si vous travaillez sur du code d’entreprise ou de client, la mémoire peut contenir de la logique métier, des chemins internes, voire des détails de configuration. La stocker sur un service distant sans savoir où vont les données présente donc un risque. Le mode d’enregistrement détermine quant à lui la qualité de la mémoire : l’automatisation complète est pratique, mais elle facilite aussi l’accumulation d’informations inutiles.
Rappel et gestion de la mémoire intersession
Le mécanisme de rappel joue un rôle essentiel dans l’expérience. L’injection de toute la mémoire fonctionne bien lorsqu’elle contient peu d’informations. Mais à mesure qu’elle grossit, elle occupe une part croissante de la fenêtre de contexte et peut perturber la tâche en cours. L’observabilité est indispensable pour bien gérer cette mémoire : si une information erronée ne peut être ni repérée ni supprimée, elle risque d’induire l’IA en erreur à chaque nouvelle session.
Le coût est souvent sous-estimé. La génération automatique de résumés et la recherche vectorielle peuvent entraîner des invocations supplémentaires du modèle. Pour les évaluer, vous pouvez commencer par un essai à petite échelle et mesurer la consommation supplémentaire de tokens sur une semaine. Avec une interface d’agrégation comme APIYI apiyi.com, vous pouvez comparer les coûts de différents modèles de résumé depuis un même compte et déterminer plus facilement quelle combinaison est la plus avantageuse.
Mémoire entre sessions : les étapes pour démarrer sans changer d’outil
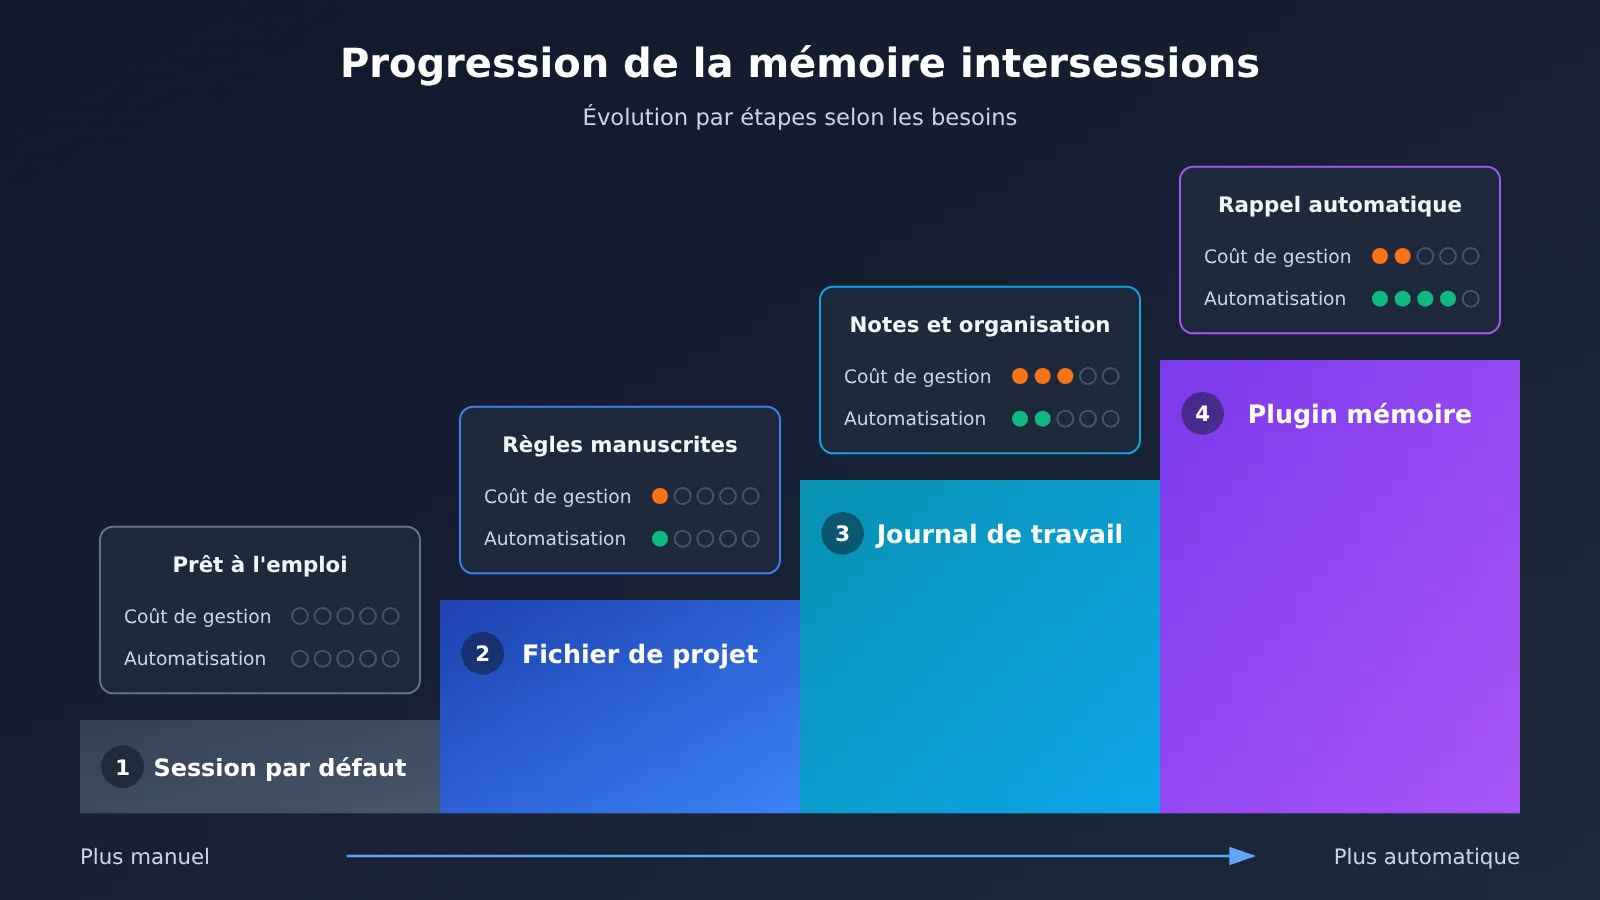
Avant de choisir un plugin de mémoire, essayez cette approche progressive. Elle ne demande pas de code et ne dépend d’aucun plugin particulier : elle fonctionne avec la plupart des outils de programmation assistée par IA.
- Vérifiez les capacités existantes de votre outil : consultez sa documentation officielle pour savoir s’il prend en charge les fichiers de règles au niveau du projet, la reprise de session, MCP ou d’autres extensions. Vous éviterez ainsi de réinventer la roue.
- Créez un fichier de documentation du projet : décrivez succinctement la pile technique, la structure des répertoires, les conventions de nommage et les pratiques à éviter. Placez ce fichier dans le projet et ajoutez-le au contrôle de version.
- Prenez l’habitude de conclure vos sessions : après chaque tâche importante, demandez à l’IA de résumer dans un format fixe les décisions prises, les difficultés rencontrées et les points en suspens, puis ajoutez ce résumé au journal de travail.
- Faites le tri régulièrement : de temps en temps, transférez dans le fichier de documentation les informations qui reviennent souvent et restent valables à long terme. Supprimez celles qui sont dépassées.
- Réévaluez le besoin d’un plugin : après une ou deux semaines d’essai, si la maintenance manuelle devient trop contraignante, utilisez les six critères présentés plus haut pour choisir un plugin de mémoire automatisée.
Vous pouvez structurer le journal de travail comme dans le tableau ci-dessous. Il sera facile à lire et permettra à l’IA d’en assimiler rapidement le contenu lors d’une nouvelle session.
| Élément | Exemple | À intégrer au fichier de documentation ? |
|---|---|---|
| Décision | Choix d’une solution de gestion d’état et raisons de ce choix | Oui, si elle reste valable à long terme |
| Difficulté rencontrée | Échec de compilation d’une dépendance dans une version donnée et solution | Selon le cas, une fois la solution stabilisée |
| Convention | Format uniforme des erreurs renvoyées par l’API | Oui |
| À faire | Tests unitaires d’un module encore incomplets | Non, à laisser dans le journal |
| Informations sensibles | Clés, adresses internes | Ne pas les consigner ; utiliser une description générique à la place |
🚀 Pour démarrer rapidement : le résumé de session à l’étape 3 et le tri du journal à l’étape 4 se prêtent bien à l’utilisation d’un modèle moins coûteux. Vous pouvez tester la qualité des résumés de plusieurs modèles via l’interface unifiée d’APIYI apiyi.com, puis choisir celui à configurer dans votre outil de programmation ou votre plugin de mémoire.
Questions fréquentes (FAQ)
Q1 : Qu’est-ce que la mémoire limitée à la session dans un outil de programmation IA ?
Cela signifie que l’IA ne se souvient des échanges précédents et des contenus lus que pendant la session en cours. Ces informations ne sont pas automatiquement reprises dans une nouvelle session. Le modèle lui-même étant sans état, l’outil lui donne l’impression de « se souvenir » en réinjectant l’historique dans sa fenêtre de contexte.
Q2 : Quelle différence entre mémoire limitée à la session et mémoire intersessions ?
La mémoire limitée à la session présente l’avantage de garder un contexte épuré et des limites claires en matière de confidentialité, mais elle ne permet pas de capitaliser sur l’expérience acquise. La mémoire intersessions permet de réutiliser cette expérience dans de nouvelles sessions. En contrepartie, il faut choisir et maintenir une solution, avec le risque que des souvenirs erronés soient rappelés à plusieurs reprises.
Q3 : La mémoire d’opencode est-elle vraiment limitée à la session ?
En novembre 2026, un utilisateur a publié sur V2EX qu’après avoir lu une autre discussion, il avait découvert que la mémoire d’opencode était limitée à la session. Toutefois, la discussion d’origine ne figure pas parmi les sources de cet article et l’outil continue d’évoluer. Il vaut donc mieux consulter la documentation officielle d’opencode et vérifier le comportement de votre version actuelle.
Q4 : Dans quels cas la mémoire intersessions est-elle la plus utile ?
Elle convient surtout aux situations suivantes :
– **Grands projets maintenus à long terme** : les leçons tirées des difficultés rencontrées sont nombreuses et dispersées, et difficiles à intégrer à l’avance dans des règles
– **Conservation des préférences personnelles** : vous souhaitez que l’IA retienne durablement votre style et vos habitudes de programmation
– **Développement en parallèle sur plusieurs sessions** : plusieurs modules d’un même projet avancent en même temps et ont besoin d’un contexte partagé
Les scripts ponctuels et les petits problèmes indépendants n’en ont généralement pas besoin.
Q5 : Comment tester et changer facilement les modèles de résumé ou d’embedding utilisés par les plugins de mémoire ?
De nombreuses solutions de mémoire nécessitent des modèles supplémentaires pour produire des résumés ou des représentations vectorielles. Une plateforme qui regroupe plusieurs modèles, comme APIYI apiyi.com, permet de comparer leurs résultats et leurs coûts avec une méthode d’invocation unifiée, avant de configurer le modèle retenu dans le plugin. Pour les paramètres de connexion, consultez la documentation de la plateforme sur docs.apiyi.com et celle du plugin.
Q6 : La mémoire intersessions augmente-t-elle sensiblement le coût en tokens ?
C’est possible. Les souvenirs rappelés occupent de l’espace dans le contexte à chaque utilisation, et les résumés automatiques entraînent des appels supplémentaires. Commencez par limiter le nombre de souvenirs rappelés et mesurez la consommation supplémentaire pendant la période d’essai. La vue de facturation unifiée d’APIYI apiyi.com permet de comparer plus facilement les coûts de différentes combinaisons de modèles.
Q7 : Quels sont les risques ou les limites connus de la mémoire intersessions ?
Il y en a trois principaux : des souvenirs erronés ou obsolètes peuvent continuer à induire les nouvelles sessions en erreur ; des informations sensibles, comme des clés ou des chemins internes, peuvent se retrouver dans la mémoire ; et les plugins peuvent cesser de fonctionner après une mise à jour de l’outil. Pour limiter ces risques, choisissez une solution dont les souvenirs peuvent être consultés et supprimés, nettoyez-les régulièrement et évitez d’y enregistrer des données sensibles.
Mémoire de session et mémoire intersession : points clés
- La nature de la mémoire de session : le modèle est sans état ; l’outil lui fait « retrouver » le fil en lui transmettant l’historique
- Évaluer avant d’installer : si vous devez souvent réexpliquer les mêmes règles, un fichier d’instructions peut suffire
- Quatre approches : fichier d’instructions, journal manuel, résumé automatique et base de mémoire avec recherche ont chacune leurs compromis
- Six critères de choix : stockage, écriture, récupération, observabilité, portée et compatibilité avec les coûts
- La suppression compte plus que l’automatisation complète : un souvenir erroné impossible à corriger risque de provoquer les mêmes erreurs à chaque nouvelle session
- Une mise en place progressive : commencez par un fichier d’instructions, ajoutez un journal de travail, puis passez à un plugin de mémoire si nécessaire
- Tester les modèles avant de choisir : l’interface unifiée d’APIYI apiyi.com permet de comparer les modèles de résumé et d’embedding
Conclusion
Voici les points essentiels à retenir sur la mémoire de session des outils de programmation IA :
- Comprendre ses limites : la mémoire de session n’est pas un défaut, mais un choix de conception par défaut. Elle garantit un contexte vierge, mais ne conserve pas automatiquement les acquis.
- Commencer par une solution peu coûteuse : un fichier d’instructions du projet et un journal de travail suffisent dans la plupart des cas où l’on doit « tout réexpliquer à chaque fois ».
- Choisir un plugin selon plusieurs critères : si vous avez vraiment besoin d’une mémoire intersession automatisée, évaluez le stockage, l’écriture, la récupération, l’observabilité, la portée et les coûts.
Si vous utilisez un outil comme opencode et vous demandez quel plugin de mémoire installer, commencez par déterminer ce que vous voulez mémoriser, où le stocker et comment le supprimer. C’est plus important qu’une liste de plugins. Leur écosystème évolue vite : avant de choisir, consultez la documentation officielle et les retours d’expérience de la communauté.
Si votre solution de mémoire nécessite un modèle de résumé ou d’embedding, vous pouvez commencer par des tests comparatifs à petite échelle via APIYI apiyi.com, puis choisir votre configuration définitive.
📚 Références
- Questions-réponses sur V2EX : quel plugin de mémoire utilisez-vous avec opencode ? : la question à l’origine de cet article
- Lien :
v2ex.com/t/1254245 -
Remarque : un utilisateur s’interroge sur le fait que la mémoire d’opencode soit limitée à une session. Le message initial ne contient que la question ; consultez la page pour lire les réponses de la communauté.
-
Documentation officielle d’opencode : explications sur la mémoire, les fichiers de règles et les possibilités d’extension
- Lien : consultez la dernière version de la documentation sur le site officiel d’opencode ou dans son dépôt open source
- Remarque : cet article ne couvre pas toutes les explications officielles sur le mécanisme de mémoire. Nous vous conseillons de les consulter avant de faire votre choix.
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site APIYI apiyi.com pour échanger sur les outils de programmation IA et le choix des modèles. Retrouvez d’autres ressources dans le centre de documentation docs.apiyi.com.