Note de l’auteur : cet article explique, code par code, les causes des erreurs 429, 401 et 500 des API d’IA et la façon de les traiter. Il précise quelles erreurs justifient une nouvelle tentative, lesquelles demandent une correction de configuration, et dans quels cas utiliser le backoff exponentiel, le repli sur plusieurs modèles ou le disjoncteur.
En production, beaucoup de développeurs ont déjà vu apparaître une série d’erreurs 429, 401 et 500 dans leur canal d’alertes au beau milieu de la nuit, lors de l’invocation de grands modèles de langage. Une réaction courante consiste à réessayer toutes les requêtes échouées, mais cela aggrave souvent la situation. Cet article présente, code par code, comment diagnostiquer les erreurs 429, 401 et 500 des API d’IA et concevoir une gestion des pannes adaptée, pour remplacer les « tentatives à l’aveugle » par un traitement au cas par cas.
Ce n’est pas une introduction aux codes d’état HTTP, mais un guide pratique pour l’exploitation en production. Il couvre les causes typiques de chaque erreur, la pertinence d’une nouvelle tentative, la logique de traitement côté application et la répartition de la gestion des pannes entre la passerelle et l’application.
L’essentiel : après lecture, vous pourrez déterminer en quelques minutes s’il faut réessayer, passer à une solution de repli ou corriger immédiatement la configuration. Vous saurez aussi quand utiliser le backoff exponentiel, le repli sur plusieurs modèles et le disjoncteur.
L’essentiel sur les erreurs 429, 401 et 500 des API d’IA
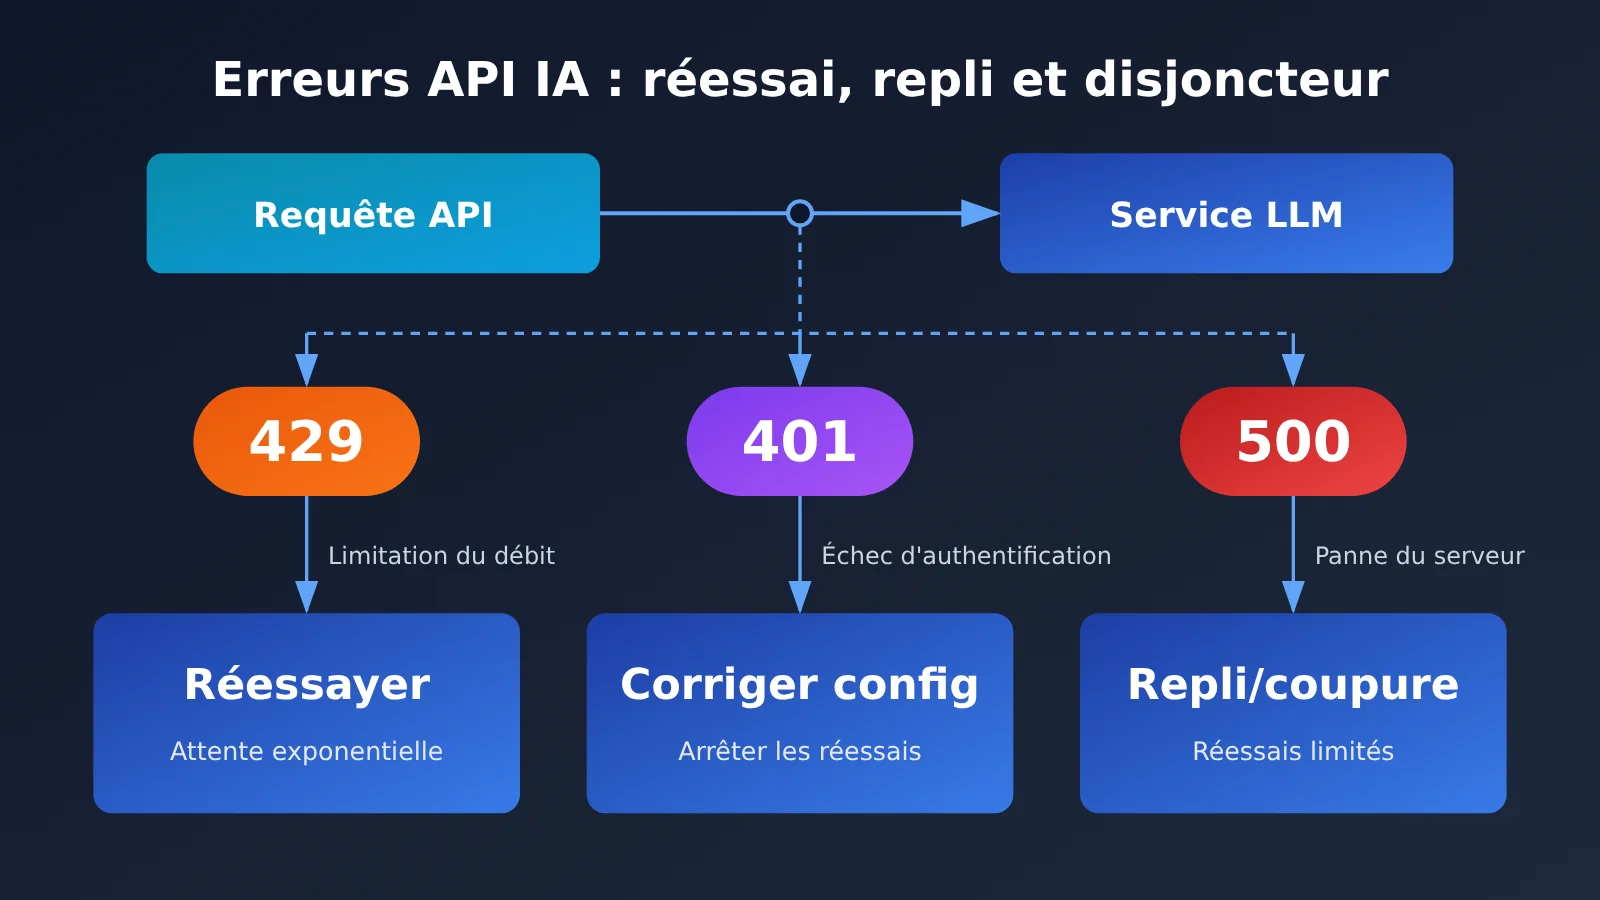
Face à une erreur d’API d’IA, commencez par la classer avant d’envisager une nouvelle tentative. Les codes d’erreur correspondent à des problèmes de nature différente : certains se résolvent après un peu d’attente, tandis que d’autres persisteront quel que soit le nombre de tentatives. Le tableau ci-dessous donne une vue d’ensemble des principales catégories.
| Catégorie d’erreur | Codes d’état typiques | Nature du problème | Nouvelle tentative possible ? | Solution principale |
|---|---|---|---|---|
| Limitation de débit | 429 | Requêtes trop rapides ou quota épuisé | Selon la cause | Lire Retry-After, appliquer un délai exponentiel et distinguer la limitation de débit d’un quota insuffisant |
| Authentification | 401、403 | Clé invalide ou autorisations insuffisantes | Non | Arrêter immédiatement les tentatives, déclencher une alerte et corriger la configuration |
| Serveur | 500、502、503、504 | Panne ou surcharge du service en amont | Oui, dans une limite définie | Réessayer un nombre limité de fois avec un délai croissant, puis utiliser un mode dégradé ou un disjoncteur si les échecs persistent |
| Requête | 400、404、413、422 | Paramètres, nom de modèle ou longueur incorrects | Non | Consigner le corps de la requête et corriger les paramètres avant de la renvoyer |
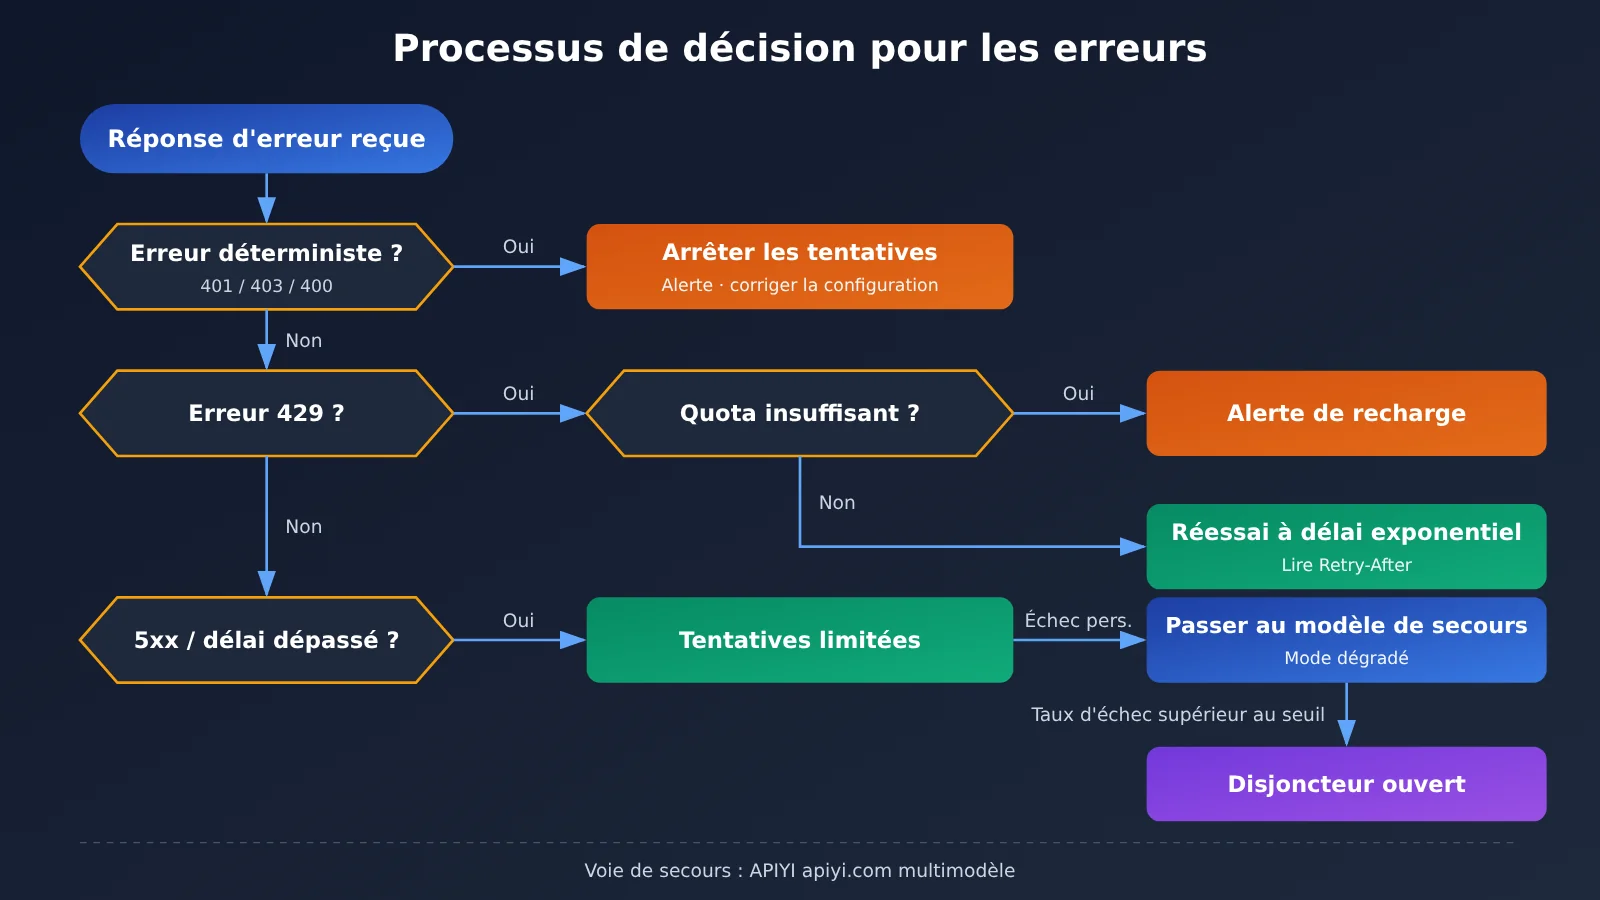
En résumé, l’intérêt d’une nouvelle tentative dépend du caractère temporaire ou déterministe de l’erreur. Réessayer peut être utile pour une erreur temporaire, comme une limitation de débit ou une instabilité du service en amont. Pour une erreur déterministe, comme une clé ou des paramètres incorrects, cela ne fait que gaspiller du quota, ralentir la réponse et risque même de déclencher une limitation de débit plus stricte.
Tableau de décision pour les codes d’erreur des API d’IA
Pour diagnostiquer une erreur, le code de statut ne suffit pas : il faut aussi examiner le champ du type d’erreur dans le corps de la réponse et les en-têtes. Voici un tableau utilisable directement pour concevoir la logique applicative.
| Signal observé | Cause probable | Action recommandée | À comptabiliser pour le circuit breaker ? |
|---|---|---|---|
429 avec l’en-tête Retry-After |
Limite de débit atteinte | Attendre le délai indiqué par l’en-tête avant de réessayer | Non |
| 429 avec un corps d’erreur indiquant un quota ou un solde insuffisant | Quota du compte épuisé | Ne pas réessayer ; déclencher une alerte pour recharger le compte ou changer de compte | Non |
| 401 | Clé incorrecte, expirée ou mal formatée | Ne pas réessayer ; vérifier la clé et les variables d’environnement | Non |
| 403 | La clé n’autorise pas l’accès à ce modèle ou à cette région | Ne pas réessayer ; vérifier les autorisations et l’activation du modèle | Non |
| 500 / 502 | Erreur interne du service en amont ou échec de transmission par la passerelle | Réessayer 2 à 3 fois avec un délai progressif | Oui |
| 503 | Service surchargé ou en maintenance | Réessayer avec un délai progressif, puis passer en mode dégradé en cas d’échec | Oui |
| 504 ou expiration du délai côté client | Génération trop longue ou réponse lente du service en amont | Décider de réessayer selon l’idempotence ; envisager d’augmenter le délai d’expiration | Oui |
La distinction entre les deux significations du code 429 est facile à manquer. Certains fournisseurs renvoient aussi ce code lorsque le quota est épuisé, mais le champ de type dans le corps de l’erreur diffère de celui d’une limitation de débit classique. Si l’application ne tient compte que du code de statut, elle risque de réessayer indéfiniment une requête rejetée pour « solde insuffisant », avec des 429 plein les journaux et aucune chance de rétablissement.
Erreur 429 : les points essentiels sur la limitation de débit
L’erreur 429 se produit lorsque le nombre de requêtes ou de tokens dépasse la limite autorisée sur une période donnée. Les API de grands modèles de langage appliquent généralement plusieurs limites : requêtes par minute, tokens par minute et parfois nombre de requêtes simultanées. Ainsi, même avec peu de requêtes, une fenêtre de contexte très longue peut déclencher une erreur 429.
Pour gérer les erreurs 429 au niveau de l’application, suivez trois principes. Premièrement, respectez en priorité l’en-tête Retry-After ou un en-tête similaire indiquant le délai de réinitialisation, plutôt que de deviner le temps d’attente. Deuxièmement, en l’absence de ces indications, utilisez un délai exponentiel avec une variation aléatoire pour éviter qu’un grand nombre de clients ne réessaient simultanément et n’épuisent à nouveau le quota. Troisièmement, contrôlez le débit à la source avec un algorithme de jetons ou une file d’attente pour limiter les requêtes simultanées : c’est plus efficace que de multiplier les tentatives après coup.
Erreur 401 : les points essentiels sur l’authentification
L’erreur 401 est celle qu’il faut le moins chercher à résoudre en réessayant. Elle provient presque toujours d’un problème de configuration : espaces ou retours à la ligne ajoutés lors de la copie de la clé, variable d’environnement mal injectée dans le conteneur, clé de l’environnement de test utilisée en production, clé remplacée ou révoquée, ou encore format incorrect de l’en-tête d’authentification.
Avec une API compatible OpenAI, une autre cause fréquente est une incompatibilité entre base_url et la clé : par exemple, utiliser la clé de la plateforme A pour envoyer une requête à l’adresse de la plateforme B. En cas d’erreur 401, l’application doit donc arrêter immédiatement les tentatives, déclencher une alerte prioritaire et consigner dans les journaux les premiers caractères de la clé ainsi que l’adresse de la requête pour faciliter le diagnostic, sans jamais enregistrer la clé complète.
Les erreurs serveur 500 en détail
Les erreurs de la série 500 indiquent un problème côté serveur ou sur le chemin de la requête : une défaillance interne du service de modèle en amont, une charge trop élevée ou un échec de transmission par une passerelle intermédiaire. Ces erreurs sont généralement temporaires : un nombre limité de tentatives est donc adapté. Mais si elles persistent, le service en amont est probablement défaillant. Continuer à réessayer ne ferait qu’accumuler les requêtes et saturer les threads. Mieux vaut alors passer à une solution de repli ou activer un disjoncteur.
Attention aussi aux erreurs 504 et aux délais d’expiration côté client. La génération de textes longs par un grand modèle de langage prend naturellement du temps. Si le délai est trop court, une requête lente mais normale peut être considérée à tort comme un échec, puis relancée. Cela risque d’entraîner une double facturation et, si une sortie en streaming est interrompue, le front-end recevra un contenu tronqué.
Bien démarrer avec les nouvelles tentatives, le repli et le coupe-circuit pour les API d’IA
Une fois les erreurs classées, il reste à mettre la logique de traitement en pratique. Comme demandé, cette section ne contient pas de bloc de code : elle présente les paramètres et les étapes à suivre pour implémenter chaque mécanisme dans le langage de votre choix.
Implémenter les nouvelles tentatives avec attente exponentielle
Le principe est simple : après chaque échec, le délai d’attente augmente de façon exponentielle, avec une variation aléatoire. Voici comment organiser la logique :
- Définissez les erreurs qui autorisent une nouvelle tentative, par exemple
429(sauf en cas de quota épuisé),500,502,503,504et les délais d’attente réseau dépassés. - Après chaque échec, vérifiez d’abord l’en-tête de réponse
Retry-After. S’il est présent, respectez le délai indiqué ; sinon, calculez-le avec la formule d’attente exponentielle. - La formule prend généralement la forme « intervalle de base × 2 à la puissance du nombre de tentatives », à laquelle on ajoute une variation aléatoire. Fixez aussi un plafond pour chaque attente.
- Définissez un nombre maximal de tentatives et un budget de temps total. Dès que l’une de ces limites est dépassée, abandonnez et transmettez l’erreur à la logique de repli.
- Consignez chaque nouvelle tentative dans les journaux : code d’erreur, nombre de tentatives, durée d’attente et nom du modèle. Ces informations faciliteront l’analyse a posteriori.
Si vous utilisez un SDK officiel, vérifiez ses paramètres : beaucoup proposent déjà max_retries et timeout. Évitez d’ajouter une couche de nouvelles tentatives identique par-dessus : les tentatives se multiplieraient, ce qui amplifierait le volume de requêtes en cas de panne.
Le tableau ci-dessous présente des valeurs empiriques pour démarrer. Ajustez-les selon les exigences de latence de votre application et les limites de votre fournisseur.
| Paramètre | Signification | Valeur de départ courante | Critère d’ajustement |
|---|---|---|---|
max_retries |
Nombre maximal de nouvelles tentatives | 2 à 5 | Une valeur basse pour les conversations en temps réel, plus élevée pour les traitements par lots hors ligne |
| Intervalle de base | Attente avant la première nouvelle tentative | Environ 1 seconde | À augmenter pour les services qui limitent strictement le débit |
| Plafond par attente | Durée maximale d’une attente exponentielle | Plusieurs dizaines de secondes | Éviter qu’une attente trop longue ne pénalise la requête |
| Variation aléatoire | Répartir les tentatives dans le temps | Une fraction aléatoire de la durée d’attente | D’autant plus utile que le nombre de clients simultanés est élevé |
| Budget de temps total | Durée maximale d’un appel | Selon le SLA de l’application | Passer directement au repli une fois le délai dépassé |
🚀 Pour commencer : pour simuler le comportement des nouvelles tentatives selon différents codes d’erreur pendant les tests, vous pouvez accéder à plusieurs modèles via APIYI apiyi.com et son interface unifiée compatible avec OpenAI. Vous pourrez ainsi observer leurs réponses et leurs erreurs avec une même logique de nouvelles tentatives, sans devoir l’adapter séparément à chaque fournisseur.
Concevoir une stratégie de repli multimodèle
Les nouvelles tentatives répondent au cas où « un même modèle est temporairement indisponible ». Le repli intervient lorsque « ce modèle ne sera pas rétabli rapidement ». Une stratégie de repli multimodèle consiste à prévoir une chaîne de modèles de secours : après plusieurs échecs consécutifs du modèle principal, l’application passe aux modèles de secours dans l’ordre prévu. Elle peut ainsi continuer à répondre, au prix d’une éventuelle baisse de qualité ou d’une hausse des coûts.
Lors de la conception de cette chaîne, vérifiez que les capacités des modèles sont équivalentes. Si le modèle principal utilise l’appel de fonctions, les sorties structurées ou les contextes longs, les modèles de secours doivent aussi prendre en charge ces fonctionnalités. Sinon, le basculement risque de provoquer de nouvelles erreurs 400 ou des échecs d’analyse du format de sortie. Le tableau ci-dessous propose une approche adaptée à différents scénarios.
| Scénario | Rôle du modèle principal | Premier modèle de secours | Solution de dernier recours | Plateformes disponibles |
|---|---|---|---|---|
| Dialogue avec le service client en ligne | Modèle généraliste de haute qualité | Modèle équivalent d’un autre fournisseur | Modèle léger et rapide + réponse simplifiée | APIYI apiyi.com, API officielles des différents fournisseurs |
| Génération et revue de code | Modèle phare performant en programmation | Modèle phare d’un autre fournisseur | Afficher un message invitant à réessayer plus tard | APIYI apiyi.com, API officielles des différents fournisseurs |
| Traitement de contenu par lots | Modèle offrant un bon rapport qualité-prix | Autre modèle dans la même gamme de prix | Mettre les tâches en file d’attente pour un traitement ultérieur | APIYI apiyi.com, API officielles des différents fournisseurs |
| Extraction d’informations structurées | Modèle prenant en charge la sortie JSON | Autre modèle prenant en charge les sorties structurées | Moteur de règles en dernier recours | APIYI apiyi.com, API officielles des différents fournisseurs |
Quelques détails méritent une attention particulière lors du repli :
- Adaptation des invites : les modèles réagissent différemment aux invites système. Chaque modèle de secours devrait avoir sa propre version d’invite, préalablement validée.
- Longueur du contexte : avant le basculement, vérifiez que la longueur des messages ne dépasse pas la fenêtre de contexte du modèle de secours. Tronquez l’historique si nécessaire.
- Marquage des résultats : indiquez dans les journaux et les outils de surveillance qu’une réponse provient d’un modèle de secours, afin d’évaluer l’impact du repli sur la qualité.
- Pas de repli en cas d’erreur d’authentification : une erreur 401 indique un problème de configuration. Changer de modèle ne ferait que le masquer ; il faut déclencher une alerte immédiatement.
Comment fonctionne un circuit breaker et quand l’utiliser
Un circuit breaker évite qu’une dépendance en panne persistante mette tout le système à terre. Il comporte généralement trois états : en état fermé, les requêtes passent normalement et le taux d’échec est mesuré ; lorsque ce taux ou le nombre d’échecs consécutifs dépasse un seuil, il passe à l’état ouvert et rejette directement les requêtes ou active une solution de repli, sans contacter le service en amont défaillant ; après un délai d’attente, il passe à l’état semi-ouvert et laisse passer quelques requêtes de test. Si elles réussissent, il se referme ; si elles échouent, il s’ouvre à nouveau.
L’essentiel est de ne comptabiliser que les erreurs qui reflètent l’état du service en amont. Les erreurs 5xx et les délais d’attente dépassés doivent entrer dans le calcul du taux d’échec, contrairement aux erreurs côté client comme 401 et 400. Sinon, une erreur de configuration pourrait ouvrir le circuit breaker et entraîner le rejet de toutes les requêtes normales. Une erreur 429 due à un quota insuffisant ne doit pas non plus être comptabilisée : elle reflète l’état du compte, pas celui du service.
Multiplier les circuit breakers n’est pas toujours une bonne idée. Pour un outil interne peu sollicité, l’échantillon est trop réduit pour calculer un taux d’échec fiable, ce qui augmente le risque de faux positifs. Dans ce cas, de simples tentatives répétées associées à une solution de repli suffisent. Le circuit breaker convient mieux aux services en production qui traitent de nombreuses requêtes simultanées : il permet de limiter rapidement les dégâts lors d’une panne généralisée en amont, en évitant que les requêtes lentes saturent les pools de threads et de connexions.
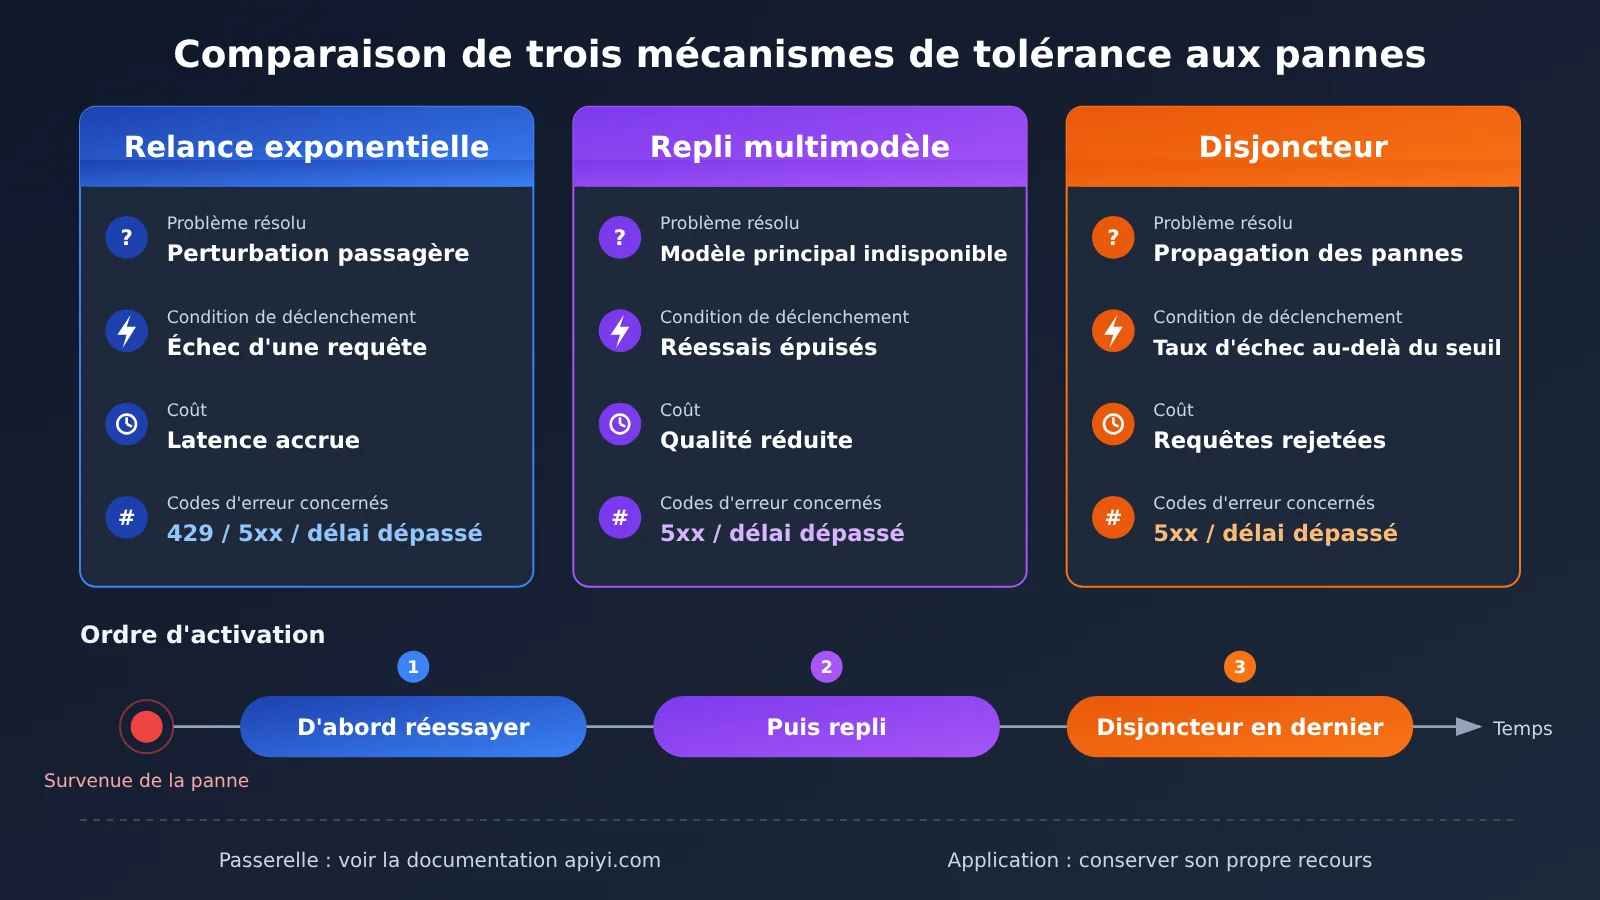
Répartition de la tolérance aux pannes entre la passerelle et l’application
De plus en plus d’équipes utilisent une passerelle API ou une plateforme d’agrégation pour invoquer des grands modèles de langage. Une question revient souvent : si la passerelle gère déjà la dégradation automatique, l’application doit-elle aussi prévoir des tentatives et un disjoncteur ? Oui, mais les rôles sont différents. La passerelle gère mieux les problèmes liés aux canaux en amont, tandis que l’application connaît mieux les besoins métier.
| Responsabilité | Couche passerelle | Couche application |
|---|---|---|
| Basculement entre canaux | Changement de canal pour un même modèle, équilibrage de charge | Inutile de le réimplémenter |
| Dégradation vers un autre modèle | Peut proposer le routage entre modèles | Décide si une baisse de qualité est acceptable et s’il faut modifier l’invite |
| Nouvelles tentatives | Tentatives rapides au niveau des canaux | Budget de tentatives métier, adapté au délai d’attente acceptable pour l’utilisateur |
| Disjoncteur | Vérification de l’état des canaux en amont | Disjoncteur et solution de repli si la passerelle entière est inaccessible |
| Erreurs d’authentification et de quota | Renvoie des types d’erreur explicites | Déclenche une alerte, bloque les nouvelles tentatives et demande une intervention humaine |
| Surveillance | Taux de réussite et latence au niveau des canaux | Taux de réussite métier, proportion de requêtes dégradées et impact sur les utilisateurs |
APIYI, par exemple, mentionne dans sa présentation des fonctionnalités de stabilité comme la dégradation automatique, l’équilibrage de charge et la surveillance en temps réel. Ces fonctions peuvent prendre en charge le basculement entre canaux, ce qui permet à l’application de se concentrer sur les solutions de repli métier. Cela dit, les conditions de déclenchement de la dégradation, les codes d’erreur renvoyés et le format du corps des erreurs ne sont pas nécessairement identiques à ceux du service officiel : vérifiez-les dans la documentation de la plateforme et par des tests. De même, la mention « concurrence illimitée » ne signifie pas qu’une erreur 429 ne se produira jamais : les limites propres aux modèles en amont restent en vigueur. Par prudence, l’application devrait toujours gérer les erreurs 429 et 5xx et disposer de sa propre solution de repli si la passerelle devient inaccessible.
🎯 Conseil technique : après avoir intégré une passerelle, déclenchez volontairement plusieurs types d’erreurs dans un environnement de test : utilisez une clé incorrecte, demandez un nom de modèle inexistant ou envoyez un contexte trop long. Notez les codes d’état et les champs du corps des erreurs réellement renvoyés par APIYI apiyi.com, puis ajustez les règles de classification des erreurs de l’application en conséquence, plutôt que de reprendre telles quelles celles de la documentation officielle.
Questions fréquentes (FAQ)
Q1 : Quelle est la différence fondamentale entre une erreur 429 et une erreur 500 d’une API d’IA ?
Une erreur 429 signifie que vos requêtes dépassent une limite : le problème vient du rythme des appels ou du quota du compte. Une erreur 500 indique une erreur côté serveur : le problème se situe en amont. Dans le premier cas, commencez par ralentir et respectez le délai d’attente ; dans le second, réessayez un nombre limité de fois, puis passez à un modèle de secours si les échecs persistent. Dans les deux cas, attendre un peu peut suffire, mais la stratégie de gestion diffère.
Q2 : Pourquoi ne faut-il jamais réessayer automatiquement après une erreur 401 ?
Une erreur 401 est déterministe : si la clé est incorrecte, le résultat sera le même, même après dix mille tentatives. Les nouvelles tentatives automatiques gaspillent des ressources, mais risquent aussi de masquer le problème et de retarder l’alerte. La bonne approche consiste à interrompre immédiatement l’opération et à vérifier la clé, l’injection des variables d’environnement et la correspondance avec l’adresse de requête.
Q3 : Pourquoi une erreur 429 persiste-t-elle malgré les nouvelles tentatives ?
La cause la plus fréquente est l’épuisement du quota ou du solde. Certains fournisseurs renvoient aussi une erreur 429 dans ce cas, mais le champ de type dans le corps de l’erreur diffère de celui d’une limitation de débit classique. Autre possibilité : vos tentatives n’intègrent pas de délai aléatoire, si bien qu’un grand nombre de requêtes repartent en même temps et atteignent continuellement la limite. Examinez d’abord le corps de l’erreur, puis vérifiez la répartition des tentatives dans le temps.
Q4 : Le recours à plusieurs modèles de secours peut-il affecter la qualité des résultats ?
Oui. Le basculement vers un modèle de secours privilégie la disponibilité, parfois au détriment de la qualité. Il faut donc définir, au niveau métier, les situations dans lesquelles ce compromis est acceptable. Préparez des invites vérifiées séparément pour les modèles de secours et suivez la proportion de requêtes concernées dans votre supervision. Si cette proportion reste élevée, vérifiez le quota et la stabilité du modèle principal.
Q5 : Comment tester à moindre coût une chaîne de basculement entre différents modèles ?
Vous pouvez utiliser une plateforme qui propose une interface unifiée pour plusieurs modèles afin de créer un environnement de test. Par exemple, avec APIYI apiyi.com, la même méthode d’appel compatible OpenAI permet de passer d’un fournisseur à l’autre. Il suffit de modifier le nom du modèle pour comparer les résultats et les erreurs des modèles principal et de secours avec une même invite. C’est une bonne façon de tester le basculement avant la mise en production.
Q6 : Faut-il encore un disjoncteur au niveau de l’application si la passerelle assure déjà un basculement automatique ?
Oui. Le basculement de la passerelle gère les problèmes des services en amont, mais la passerelle elle-même peut aussi devenir inaccessible à cause d’un problème réseau ou d’une indisponibilité générale. Le disjoncteur et la solution de repli au niveau de l’application servent à gérer ce cas. Avec une passerelle comme APIYI, vous pouvez configurer le disjoncteur de l’application pour surveiller la « passerelle dans son ensemble » plutôt que chaque canal de modèle : les deux couches ont ainsi des rôles distincts.
Q7 : Quels sont les effets secondaires connus des nouvelles tentatives, du basculement et des disjoncteurs ?
Les nouvelles tentatives peuvent entraîner une double facturation et, dans les opérations non idempotentes, comme les écritures faisant appel à des outils, provoquer l’exécution répétée d’une action. Le basculement peut entraîner des variations de qualité et des différences de format des résultats. Un disjoncteur trop sensible risque de rejeter des requêtes normales. Il faut donc surveiller les indicateurs et ajuster régulièrement les paramètres de ces trois mécanismes, plutôt que de les configurer une fois pour toutes.
Les points clés de la gestion des erreurs d’API d’IA
- Classer avant d’agir : corrigez immédiatement les erreurs déterministes ; réservez les tentatives répétées aux erreurs temporaires.
- Pour une erreur 429, examinez le corps de la réponse : distinguez une limitation de débit d’un quota épuisé. Dans le second cas, réessayer ne sert à rien.
- Ne jamais réessayer une erreur 401 : déclenchez une alerte et vérifiez surtout la clé API, les variables d’environnement et la correspondance avec l’adresse de l’API.
- Limiter les tentatives : utilisez un délai exponentiel avec une variation aléatoire, et fixez une limite à la fois au nombre de tentatives et au temps total.
- Aligner les capacités en cas de repli : le modèle de secours doit prendre en charge les mêmes fonctionnalités et disposer de ses propres invites.
- Ne compter que les erreurs serveur dans le disjoncteur : incluez les erreurs 5xx et les délais d’attente dépassés dans le taux d’échec, mais pas les erreurs client.
- Répartir les responsabilités entre passerelle et application : APIYI apiyi.com peut gérer la tolérance aux pannes au niveau des canaux, tandis que l’application assure le repli métier.
En résumé
Face aux erreurs 429, 401 et 500 d’une API d’IA, le plus important est d’abandonner les tentatives systématiques et de traiter chaque erreur selon sa nature :
- Erreurs de limitation de débit : respectez
Retry-After, réessayez avec un délai exponentiel et une variation aléatoire, tout en contrôlant en amont la concurrence et la consommation de tokens. - Erreurs d’authentification et de requête : interrompez immédiatement le traitement, déclenchez une alerte et corrigez la configuration. Ne réessayez jamais automatiquement et ne masquez pas l’erreur par un repli.
- Erreurs serveur : réessayez un nombre limité de fois, puis basculez vers un modèle de secours si les échecs persistent. En cas de forte concurrence, utilisez aussi un disjoncteur pour limiter rapidement les dégâts.
- Séparation entre passerelle et application : la passerelle gère le basculement entre canaux et la charge ; l’application maîtrise la logique métier, le budget de tentatives et le repli final.
Commencez par transformer le tableau de décision de cet article en règles internes de gestion des erreurs. Organisez ensuite un exercice de simulation de panne pour vérifier que chaque type d’erreur suit le chemin prévu.
Si vous préparez une chaîne de repli multimodèle, APIYI apiyi.com vous permet de comparer les performances et les comportements d’erreur de plusieurs modèles via une interface unifiée. Validez d’abord votre stratégie de tolérance aux pannes dans un environnement de test, puis déployez-la en production.
📚 Ressources
- Blog Ofox.ai – Articles sur la gestion des erreurs d’API IA : pistes pour gérer les erreurs 429 de limitation du débit, 401 d’authentification et 500 côté serveur, ainsi que le recul exponentiel, le basculement entre modèles et les disjoncteurs
- Lien :
ofox.ai/blog/page/41/ -
À noter : une source de référence pour le sujet de cet article, utile pour consulter les ressources en anglais
-
Blog Ofox.ai – Articles sur les passerelles d’API LLM : choix d’une passerelle LLM et contexte des défaillances touchant plusieurs fournisseurs
- Lien :
ofox.ai/blog/page/40/ -
À noter : pour comprendre le rôle de la tolérance aux pannes au niveau de la passerelle dans une architecture multimodèle
-
Centre de documentation APIYI : instructions d’intégration et documentation d’utilisation de la plateforme
- Lien :
docs.apiyi.com - À noter : pour les détails sur le format des codes d’erreur et le comportement en cas de basculement, référez-vous à la documentation de la plateforme et aux résultats de vos tests
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site APIYI pour discuter des pratiques de fiabilité des API IA. Pour plus de ressources sur l’intégration, consultez le centre de documentation docs.apiyi.com.