Commençons par la conclusion. Pour l’instant, Qwen4 n’a fait l’objet que de déclarations publiques et de traces dans des dépôts ; la position écrite d’Alibaba reste « en cours d’entraînement ». Le modèle le plus avancé que vous pouvez utiliser dès maintenant est Qwen3.8. L’intégration de Qwen par Apple en décembre dans les iPhone destinés au marché chinois relève d’un accord de distribution : elle n’apporte pas de nouvelle fonctionnalité API aux développeurs.
Il ne s’agit pas de dénigrer Qwen4. Cet article classe les informations connues en quatre niveaux de fiabilité pour distinguer ce qui peut entrer dans votre planning de ce qui reste indicatif. Il présente ensuite les quatre versions de Qwen3.8 et leurs tarifs, ainsi que les 3 champs à modifier lors de la migration.
En pratique : à la fin de cet article, vous saurez si votre projet d’agent, de rédaction, de service client ou de modération doit attendre Qwen4 ou adopter Qwen3.8 dès maintenant. Vous connaîtrez aussi le coût par million de tokens pour chaque version.
Ce qu’Apple a intégré : Qwen arrive dans Apple Intelligence en Chine
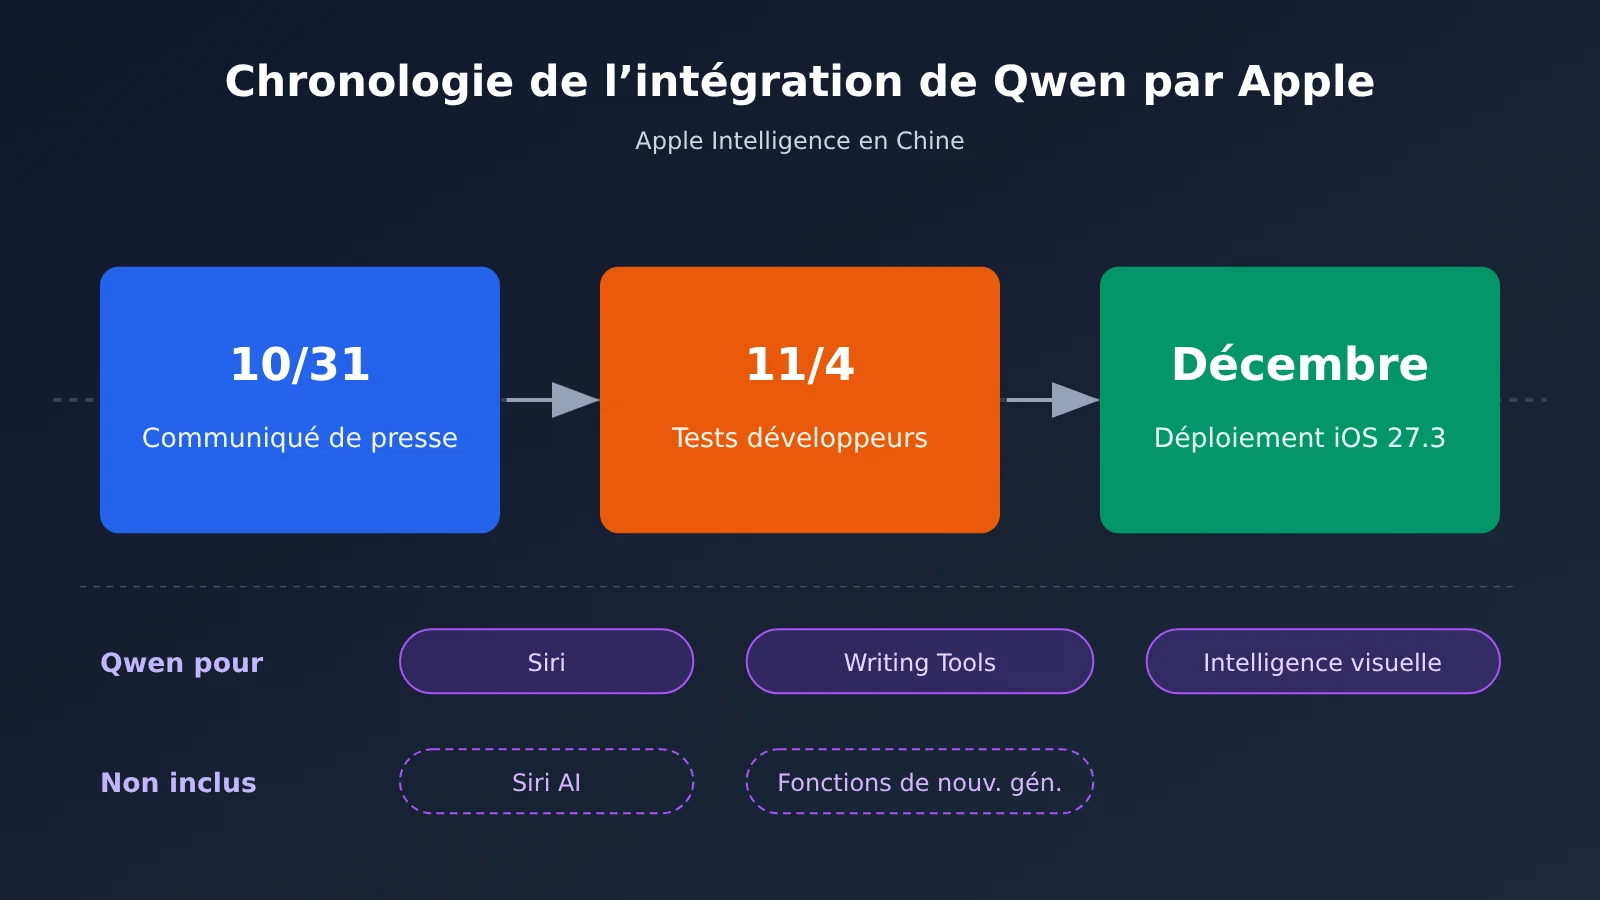
Apple a intégré les capacités de Qwen destinées au grand public, sans ouvrir de nouvelle API Qwen aux développeurs. Selon un communiqué de la salle de presse Apple Chine daté du 2026-10-31, repris par Tech Wire Asia le 2026-11-02, les premières fonctions Apple Intelligence arriveront en décembre avec iOS 27.3 pour les utilisateurs d’iPhone en Chine continentale. Les développeurs pourront les tester à partir du 4 novembre. À ce jour, le 3 novembre, ces fonctions sont encore annoncées pour plus tard et ne sont pas disponibles.
| Élément | Contenu du communiqué Apple du 2026-10-31 |
|---|---|
| Calendrier | Lancement en décembre avec iOS 27.3, tests ouverts aux développeurs à partir du 4 novembre |
| Premières fonctions | Traduction en direct dans Messages, FaceTime et Téléphone ; réécriture, correction et résumé avec Writing Tools ; intelligence visuelle via l’appareil photo ; Clean Up dans Photos ; résumés des e-mails et des notifications, messages prioritaires, transcription et résumé des appels |
| Rôle de Qwen | Apple utilise ses propres modèles génératifs et collabore avec Alibaba. Les utilisateurs peuvent faire appel directement à Qwen dans Siri, Writing Tools et l’intelligence visuelle pour comprendre du texte et des images ; Siri peut lui transférer certaines requêtes |
| Connexion | Compte Qwen ou compte Apple |
| Non inclus | Siri AI et les fonctions de nouvelle génération d’Apple Intelligence présentées à la WWDC 2026 ; selon Bloomberg, Image Playground ne fera pas non plus partie du premier déploiement |
| Appareils compatibles | iPhone compatibles achetés en Chine, ou appareils dont la région et celle du compte Apple sont toutes deux réglées sur la Chine |
| Engagement sur les données | Alibaba affirme que les requêtes des utilisateurs et les contenus générés par Qwen ne seront pas utilisés pour entraîner les modèles |
Pour situer le contexte, Apple Intelligence figure parmi les 7 services d’IA générative enregistrés le 15 juillet auprès de l’administration chinoise du cyberespace. Selon le FT, Apple avait aussi envisagé de collaborer avec Tencent et ByteDance. D’après Counterpoint, Apple se classait deuxième avec 19.5% des livraisons de smartphones en Chine au Q3 2026, derrière Huawei à 21.3%. Le marché dans son ensemble était en baisse de 10% sur un an.
Pour les développeurs, l’intérêt de cette annonce concerne surtout les utilisateurs : davantage de personnes découvriront Qwen directement dans le système et se familiariseront avec son style de réponse. En revanche, le partenariat d’Apple ne changera rien au modèle appelé par votre backend, à vos coûts ou à votre latence.
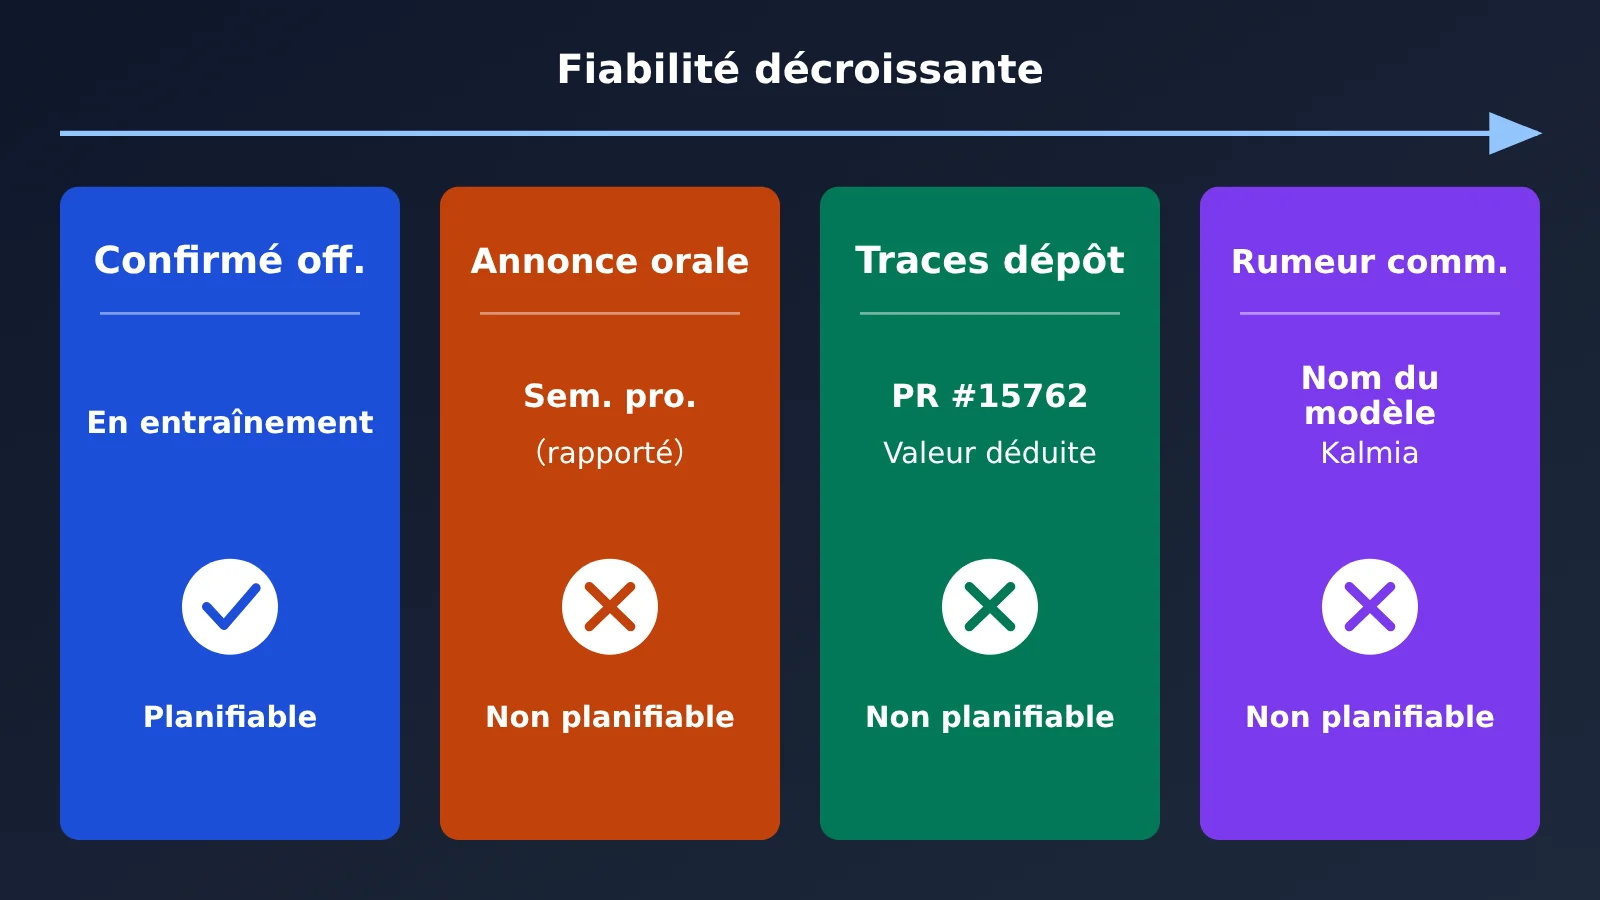
Les quatre niveaux de preuve sur Qwen4 : auxquels se fier pour planifier ?
Seules les communications écrites officielles peuvent servir de base à une planification. Pour l’instant, elles indiquent que le modèle est « en cours d’entraînement ». Dans les quatre niveaux de preuve ci-dessous, la fiabilité diminue de gauche à droite.
| Critère | Confirmation officielle | Déclaration sur place | Indices dans le dépôt | Rumeurs de la communauté |
|---|---|---|---|---|
| Contenu | Communiqué de la conférence Yunqi du 2026-09-22 : Qwen 4 est « currently in training » ; la page de l’événement d’Amsterdam du 2026-10-29 mentionne seulement les « Qwen foundation models », sans parler de Qwen4 | Xudong Guo, chercheur chez Qwen, aurait déclaré sur place à Amsterdam le 2026-10-29 que la série Qwen4 sortirait « la semaine prochaine ». Ses propos ont été rapportés par John T Davies, un participant, puis repris par EOGEE le 2026-10-30 | Le 2026-10-28, qwen-code a fusionné la PR #15762, qui reconnaît par défaut une fenêtre de contexte de 1M de tokens pour les ID de modèles commençant par qwen4 | Quatre noms de modèles : Qwen4-Max / Flash / Plus / 27B ; le modèle anonyme Kalmia sur Arena a été attribué à Qwen4 sur la base de l’empreinte de son tokenizer |
| Nature de la source | Documents écrits d’Alibaba | Déclaration orale individuelle rapportée par un tiers | Dépôt officiel, mais valeur issue des explications de la revue | Sites tiers et déductions sur des forums |
| Confirmation officielle ? | Oui | Non, EOGEE précise qu’aucune annonce n’a été publiée par les canaux officiels | Non, la PR indique que ni models.dev ni le catalogue intégré ne comportaient alors d’entrée qwen4 : la valeur est déduite | Non |
| Peut servir à planifier ? | Oui, mais la seule conclusion possible est que le modèle n’est pas encore sorti | Non, c’est seulement un signal à surveiller | Non, cela montre que les outils s’y préparent, pas qu’il s’agit d’une spécification officielle | Non |
Attention : une publication de la communauté TRAE datée du 2026-10-29 présente cette déclaration comme une « annonce du CTO ». Cela ne correspond pas au témoignage d’origine, qui parle d’un « chercheur ». C’est cette dernière désignation qu’il faut retenir.
La vérification d’OmniaKey du 2026-11-01 apporte des éléments plus concrets : au 2026-11-01 à 00:21 UTC, aucun ID de modèle, poids ou tarif qwen4 n’était disponible sur la page de l’organisation Qwen sur Hugging Face, dans Model Studio d’Alibaba Cloud Bailian ou sur OpenRouter. La page des modèles de Bailian avait été mise à jour pour la dernière fois le 10-28 et recommandait les modèles textuels qwen3.8-max, qwen3.7-plus et qwen3.8-flash. L’historique des versions avait été mis à jour le 10-30 ; sa dernière entrée concernait qwen-audio-3.1-realtime-flash, le 10-27.
Référence officielle pour l’architecture Qwen4 : Qwen3.8-Flash-Next
Pour se faire une idée de l’orientation de l’architecture Qwen4, Qwen3.8-Flash-Next est actuellement la seule référence officielle. Sa fiche de modèle Hugging Face a été créée le 2026-08-24. Présenté officiellement comme un « aperçu expérimental de l’architecture Qwen4 », le modèle porte le type qwen4_exp dans sa configuration. Depuis la version v0.6.0, llama.cpp prend aussi en charge l’architecture Qwen4Exp. Attention : il s’agit d’un modèle de préversion. Ses caractéristiques ne permettent pas de déduire la fenêtre de contexte, le nombre de paramètres ou la licence de la version finale de Qwen4.
Les quatre niveaux de Qwen3.8 : choisir selon la tâche
Pour un nouveau projet, choisissez en priorité entre qwen3.8-flash et qwen3.8-27b ; réservez qwen3.8-max aux agents complexes. Qwen3.8-Max a été annoncé le 2026-08-03 sur le blog officiel d’Alibaba Cloud. C’est le modèle phare MoE, avec 2,4 billions de paramètres. Des billets officiels ultérieurs ont également annoncé Qwen3.8-27B et publié en open source les poids du modèle phare Qwen3.8.
| Niveau | Positionnement | Cas d’usage | Conseil de choix | Plateformes disponibles |
|---|---|---|---|---|
| qwen3.8-max | Modèle phare officiel, MoE de 2,4 billions de paramètres | Agents à plusieurs étapes, rédaction de textes longs, raisonnement complexe | À privilégier quand la qualité prime et que le volume d’appels reste modéré | APIYI apiyi.com, Alibaba Cloud Bailian |
| qwen3.8-2.4t-a95b | Nom correspondant aux caractéristiques des poids open source du modèle phare | Équipes qui doivent aligner le comportement sur une version auto-hébergée | À utiliser comme point de comparaison si un déploiement privé est prévu | APIYI apiyi.com |
| qwen3.8-27b | Modèle de taille intermédiaire, publié officiellement | Service client, modération de contenu, extraction structurée | Choix par défaut pour un compromis entre qualité et coût | APIYI apiyi.com |
| qwen3.8-flash | Niveau léger et rapide | Service client à forte concurrence, classification, résumés, premier filtrage | Premier choix pour les volumes élevés et les tâches sensibles à la latence | APIYI apiyi.com, Alibaba Cloud Bailian |
Le niveau adapté dépend des besoins métier. La modération et le service client combinent généralement un volume élevé et des tâches simples : flash peut traiter la majorité du trafic, puis transmettre les cas difficiles à 27b ou max pour réduire le coût global. Pour la rédaction et les agents, la stabilité sur de longues séquences compte davantage. Vous pouvez commencer par établir une référence de qualité avec max, puis vérifier si 27b suffit.
🎯 Conseil de choix : avec la même clé API, lancez un test A/B sur les mêmes tâches avec qwen3.8-max, qwen3.8-flash et qwen3.8-27b. C’est plus rapide que d’éplucher les classements. Sur APIYI apiyi.com, il suffit de modifier le champ model, sans toucher au reste du code. Les écarts mesurés sur vos propres échantillons métier seront bien plus utiles.
Prix et gammes : comparaison des coûts de Qwen3.8 et Qwen3.5
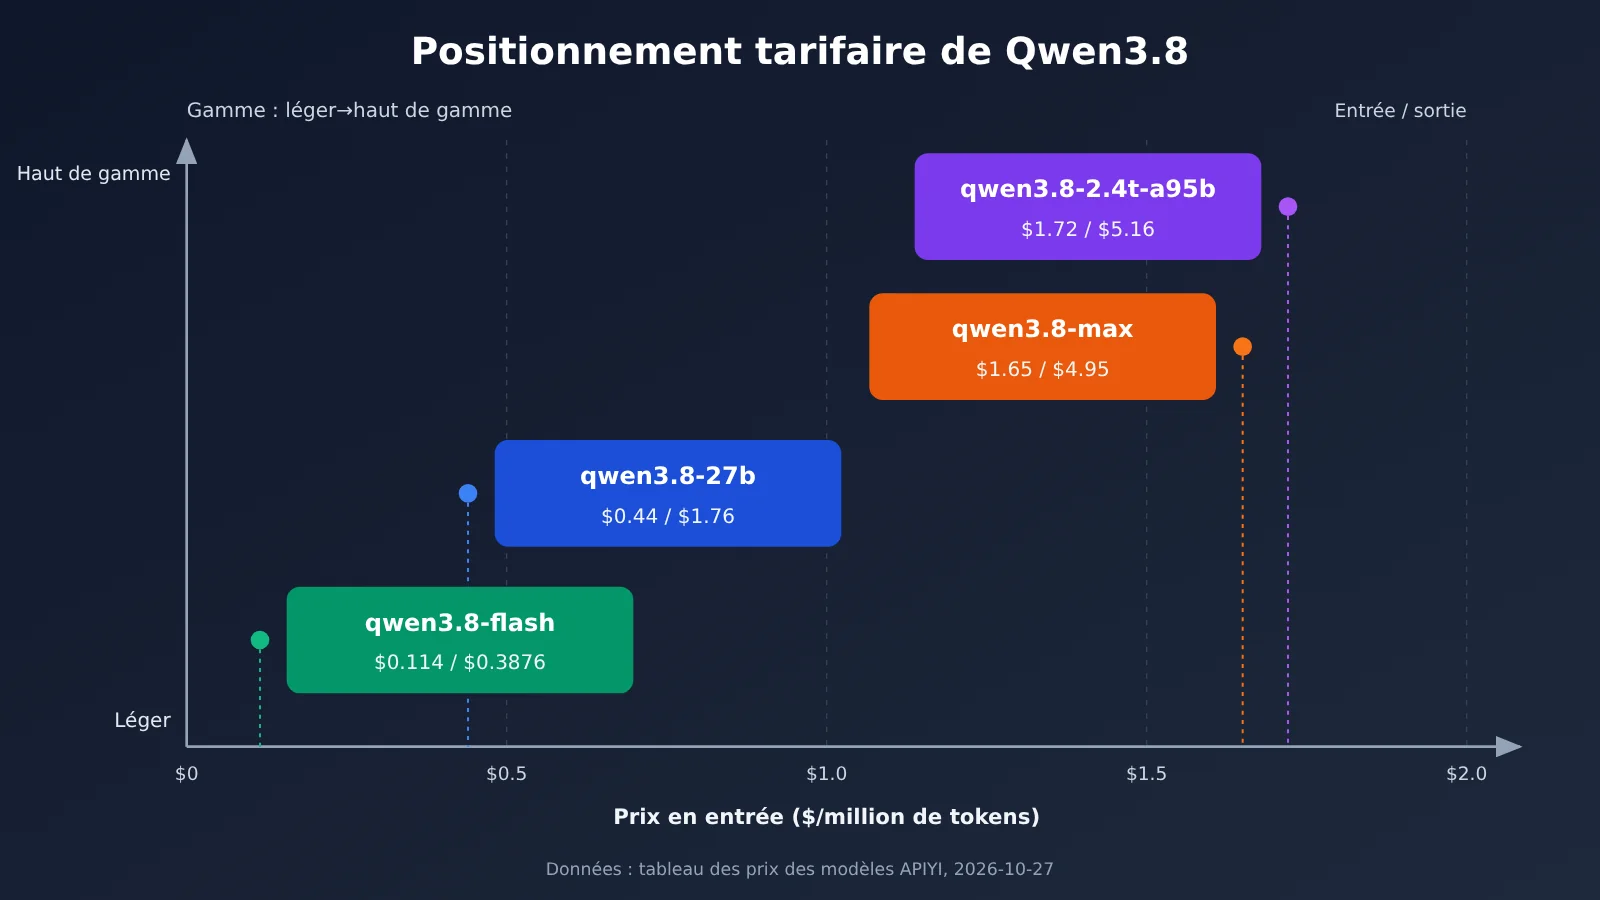
Parmi les quatre variantes de Qwen3.8, le prix en entrée de flash représente environ 1/14 de celui de max : c’est un écart essentiel à chiffrer au moment de choisir un modèle. Le tableau ci-dessous présente les prix de 9 modèles Qwen sur APIYI.
| Modèle | Entrée | Sortie | Lecture du cache |
|---|---|---|---|
| qwen3.8-max | $1.65 | $4.95 | $0.20625 |
| qwen3.8-2.4t-a95b | $1.72 | $5.16 | $0.215 |
| qwen3.8-27b | $0.44 | $1.76 | $0.088 |
| qwen3.8-flash | $0.114 | $0.3876 | $0.01425 |
| qwen3.5-plus | $0.114 | $0.684 | — |
| qwen3.5-flash | $0.03 | $0.3 | — |
| qwen3.5-397b-a17b | $0.18 | $1.08 | — |
| qwen3.5-122b-a10b | $0.12 | $0.96 | — |
| qwen3.5-35b-a3b | $0.06 | $0.48 | — |
Données relevées le 2026-10-27 à 14:50 UTC+8, en dollars par million de tokens, issues du tableau général des prix des modèles APIYI (docs.apiyi.com/models).
[Emplacement de capture d’écran : tableau général des prix des modèles APIYI, filtré sur qwen3.8]
La comparaison est plus parlante rapportée à un volume de travail concret. Pour « 1 million de tokens en entrée + 300 000 en sortie », le coût estimé est d’environ $3.14 pour qwen3.8-max, $3.27 pour qwen3.8-2.4t-a95b, $0.97 pour qwen3.8-27b et $0.23 pour qwen3.8-flash. Si l’invite système est longue et réutilisée, le tarif de lecture du cache peut réduire davantage le coût en entrée. Les quatre variantes de Qwen3.8 proposent ce tarif.
Un détail mérite attention : qwen3.8-flash et qwen3.5-plus affichent le même prix en entrée, soit $0.114, mais qwen3.8-flash coûte moins cher en sortie et prend en charge la lecture du cache. Pour les tâches qui produisent beaucoup de texte, comme la rédaction ou les résumés, passer de qwen3.5-plus à qwen3.8-flash est donc moins coûteux sur le papier. La différence de qualité reste à vérifier avec vos propres échantillons.
Les 3 champs à modifier pour migrer vers Qwen3.8
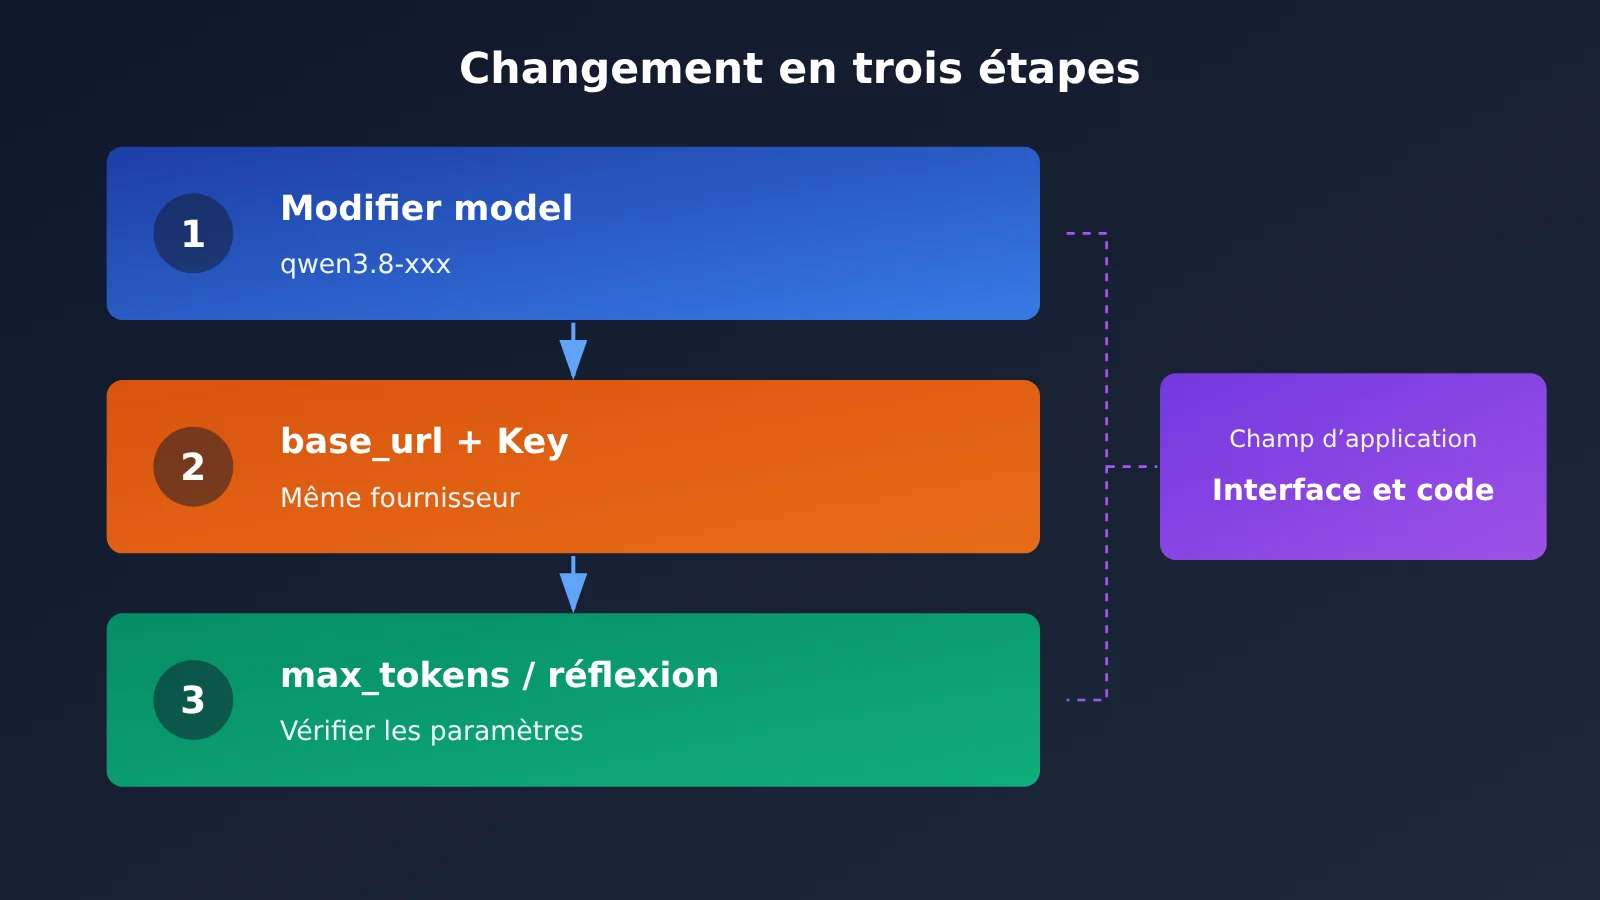
Pour passer d’un autre modèle ou de Qwen3.5 à Qwen3.8, il suffit généralement de vérifier trois paramètres. La démarche est la même dans les outils graphiques, comme Cherry Studio, Dify et les clients de chat, que dans les projets de code.
| Ordre | Champ | Modification | Où le trouver dans l’interface graphique |
|---|---|---|---|
| 1 | model | Remplacer par qwen3.8-flash, qwen3.8-27b ou qwen3.8-max |
Liste déroulante « Modèle » ou champ « ID du modèle » |
| 2 | base_url + API Key | Vérifier qu’ils correspondent au même fournisseur | Champs « Adresse API / adresse de l’interface » et « Clé » |
| 3 | Longueur de sortie et paramètres de réflexion | Vérifier max_tokens et les options liées au raisonnement | Panneau « Sortie maximale » ou « Paramètres avancés » |
Première étape : modifier le nom du model. Le nom doit correspondre exactement à celui de la liste de la plateforme, y compris les minuscules et les points. Une erreur entraînera directement un message « modèle inexistant ». Mieux vaut le copier depuis la liste des modèles de la plateforme plutôt que de le saisir à la main.
Deuxième étape : vérifier que base_url et la clé proviennent du même fournisseur. Si vous utilisez APIYI, renseignez https://api.apiyi.com/v1 comme adresse d’API et utilisez la clé générée dans le tableau de bord APIYI sur apiyi.com. Beaucoup d’erreurs « 401 non autorisé » viennent d’une adresse modifiée alors que la clé appartient encore à l’ancienne plateforme, ou inversement. Pour vérifier les modèles accessibles avec votre clé actuelle, vous pouvez récupérer la liste avec curl https://api.apiyi.com/v1/models -H "Authorization: Bearer 你的Key".
Troisième étape : vérifier la longueur de sortie et les paramètres de réflexion. La longueur de sortie par défaut et le comportement de raisonnement peuvent varier d’une génération de modèle à l’autre. Une valeur max_tokens définie en dur dans un ancien projet risque donc de tronquer les réponses longues. Pour les modèles dotés de capacités de raisonnement, activer la réflexion augmente la latence et le nombre de tokens en sortie. Pour les usages sensibles à la latence, comme le service client ou la modération, commencez par un test sans réflexion, puis activez-la si nécessaire. Consultez la documentation de la plateforme pour connaître les noms exacts des paramètres.
Dans quels cas vaut-il la peine d’attendre Qwen4 ?
Pour la plupart des projets, il n’est pas nécessaire d’attendre. Qwen4 mérite d’être suivi si la mise en production est déjà prévue dans un ou deux mois et si le projet impose une génération précise de modèle.
Voici les cas où il vaut mieux commencer avec Qwen3.8 :
- Le projet doit être mis en production ce trimestre : le calendrier ne peut pas dépendre d’un modèle sans date de sortie officielle.
- Les usages concernent principalement le service client, la modération ou la synthèse, et flash ou 27b répond déjà aux besoins.
- L’interface est compatible avec le format OpenAI : il suffira de modifier le champ
modelpour changer de modèle plus tard. L’intégration actuelle n’engendre donc pas de coûts irrécupérables.
Voici les cas où il peut être intéressant de suivre Qwen4 :
- Le produit est encore en phase d’étude technique et sa mise en production reste lointaine.
- Vous avez besoin de poids ouverts pour un déploiement privé : vous pourrez examiner les conditions de licence après la sortie de Qwen4.
- Vous utilisez déjà Qwen3.8-Flash-Next pour étudier l’architecture.
En attendant, une approche pragmatique consiste à préparer le jeu d’évaluation et les indicateurs métier avec Qwen3.8, puis à comparer Qwen4 sur les mêmes échantillons après sa sortie officielle avant de décider s’il faut changer de modèle. Au 2026-11-03, la gamme Qwen4 n’est pas encore disponible sur APIYI. Nous l’ajouterons dès que possible ; elle apparaîtra alors directement dans la liste des modèles sur APIYI, apiyi.com.
Questions fréquentes FAQ
Q1 : Quand Qwen4 sera-t-il publié ?
Il n’y a pas encore de date officielle. La déclaration écrite la plus claire d’Alibaba figure dans le communiqué de presse de la conférence Apsara du 2026-09-22 : le modèle est « en cours d’entraînement ». L’annonce d’une « sortie la semaine prochaine » vient d’une déclaration faite sur place par un chercheur, puis rapportée par des participants ; aucune annonce officielle ne l’a confirmée. Mieux vaut suivre les mises à jour de la page de l’organisation Qwen sur Hugging Face et du journal des publications de Bailian.
Q2 : Quelle version de Qwen3.8 choisir pour un nouveau projet ?
Pour des tâches simples avec un grand nombre de requêtes simultanées, commencez par qwen3.8-flash. Pour le service client, la modération ou l’extraction, où la qualité compte aussi, choisissez qwen3.8-27b. Pour les agents à plusieurs étapes et la rédaction de textes longs, utilisez qwen3.8-max comme référence de qualité. Consultez la liste des modèles de la plateforme pour connaître les versions et les prix. Sur APIYI apiyi.com, vous pouvez tester les trois niveaux avec une seule clé API avant de faire votre choix.
Q3 : Quel intérêt pour les développeurs de l’intégration de Qwen à la version chinoise d’Apple ?
L’effet direct est limité. La déclaration d’Apple du 2026-10-31 concerne des fonctionnalités utilisateur intégrées au système, prévues en décembre avec iOS 27.3. Les développeurs peuvent les tester à partir du 4 novembre, mais aucune nouvelle API n’a été ouverte. Indirectement, davantage d’utilisateurs d’iPhone se familiariseront avec le style de réponse de Qwen : les produits qui s’adressent à eux peuvent donc inclure Qwen parmi les modèles à envisager.
Q4 : Faut-il remplacer tous les modèles Qwen3.5 déjà utilisés par Qwen3.8 ?
Inutile de tout remplacer d’un coup : évaluez plutôt chaque tâche séparément. Le prix d’entrée de qwen3.5-flash reste le plus bas de la série, à $0.03 ; vous pouvez donc continuer à l’utiliser pour les tâches très légères. Pour les projets de rédaction ou de résumé qui utilisent qwen3.5-plus, comparez d’abord avec qwen3.8-flash : leur prix d’entrée est identique, mais le prix de sortie du second est plus bas. Sur APIYI apiyi.com, il suffit de modifier le champ model pour changer de modèle. Vous pouvez commencer par un déploiement progressif sur 10 % du trafic.
Q5 : Faudra-t-il changer de clé API après la sortie de Qwen4 ?
Non. Sur une plateforme d’agrégation, une seule clé API permet d’appeler tous les modèles proposés ; il suffit de modifier le nom du modèle dans model lorsqu’un nouveau modèle devient disponible. Au 2026-11-03, la série Qwen4 n’est pas encore disponible sur APIYI, mais nous l’ajouterons dès que possible. Vous pourrez alors l’utiliser directement avec votre clé APIYI apiyi.com actuelle.
Qwen4 ou Qwen3.8 : les points clés pour choisir
- Position officielle sur Qwen4 : le communiqué du 2026-09-22 indique que le modèle est « en cours d’entraînement ». Aucune date, aucun ID ni aucun tarif n’ont été annoncés.
- « Sortie la semaine prochaine » : il s’agit de propos tenus par un chercheur lors d’un événement et rapportés indirectement. Ils ne constituent pas une base fiable pour planifier un projet.
- Indices dans le dépôt : la fenêtre de contexte de 1M mentionnée dans la PR #15762 de qwen-code est une estimation, pas une spécification officielle.
- Partenariat avec Apple : lancement en décembre avec iOS 27.3, tests ouverts aux développeurs le 4 novembre. Aucune nouvelle API n’est concernée.
- Modèle le plus avancé disponible aujourd’hui : Qwen3.8. Le prix d’entrée de flash représente environ 1/14 de celui de max.
- Coût de migration : modifier le paramètre model, vérifier base_url et la clé API, puis contrôler la longueur des réponses et les paramètres de raisonnement.
Conclusion
Les dernières annonces autour de Qwen se comprennent à trois niveaux :
- Intégration de Qwen par Apple en décembre : une avancée côté distribution, qui touche à la notoriété auprès des utilisateurs, sans offrir de nouvelles capacités accessibles aux développeurs.
- Qwen4 : malgré des déclarations faites lors d’un événement et des indices dans un dépôt, la position officielle écrite reste « en cours d’entraînement ». Mieux vaut ne pas l’intégrer à un calendrier de projet.
- Qwen3.8 : déjà lancé officiellement, avec des tarifs connus et quatre versions qui couvrent les principaux usages, des charges à forte concurrence aux agents complexes.
L’approche la plus prudente consiste à mettre Qwen3.8 en production dès maintenant et à conserver les échantillons d’évaluation, puis à utiliser les mêmes échantillons pour comparer Qwen4 dès sa sortie officielle. Pour tester les différentes versions de Qwen3.8 avec une seule clé API, vous pouvez passer par APIYI apiyi.com. Les nouveaux utilisateurs disposent d’un crédit de test gratuit, ce qui permet d’effectuer des tests A/B avant de choisir une version.
📚 Références
- Tech Wire Asia : reprise de la déclaration du service de presse d’Apple en Chine du 2026-10-31
- Lien :
techwireasia.com/2026/11/apple-intelligence-china-alibaba-qwen-december/ -
Détails : fonctionnalités prévues par Apple en décembre, rôle de Qwen et appareils compatibles
-
OmniaKey : « Quand Qwen 4 sera-t-il lancé ? Ce qu’Alibaba a confirmé officiellement à ce jour », 2026-11-01
- Lien :
omniakey.com/zh/blog/qwen-4-release-date -
Détails : vérification des déclarations officielles et résultats de recherche sur trois plateformes
-
EOGEE : « Qwen annonce la sortie de Qwen4 la semaine prochaine », 2026-10-30
- Lien :
eogee.com/article/289 -
Détails : source rapportant la déclaration faite à Amsterdam
-
Blog officiel d’Alibaba Cloud : lancement de Qwen3.8-Max, 2026-08-03
- Lien :
alibabacloud.com/blog/alibaba-unveils-qwen3-8-max-its-largest-and-most-capable-flagship-model-to-date_603420 -
Détails : annonce officielle du lancement du modèle phare Qwen3.8
-
Blog officiel d’Alibaba Cloud : lancement de Qwen3.8-27B et publication en open source des poids du modèle phare
- Lien :
alibabacloud.com/blog/alibaba-unveils-qwen3-8-27b-and-releases-weights-of-qwen3-8-flagship-model_603463 -
Détails : informations sur le modèle 27B et sa publication en open source
-
Tableau complet des prix des modèles APIYI
- Lien :
docs.apiyi.com/models - Détails : source des données du tableau des prix de cet article