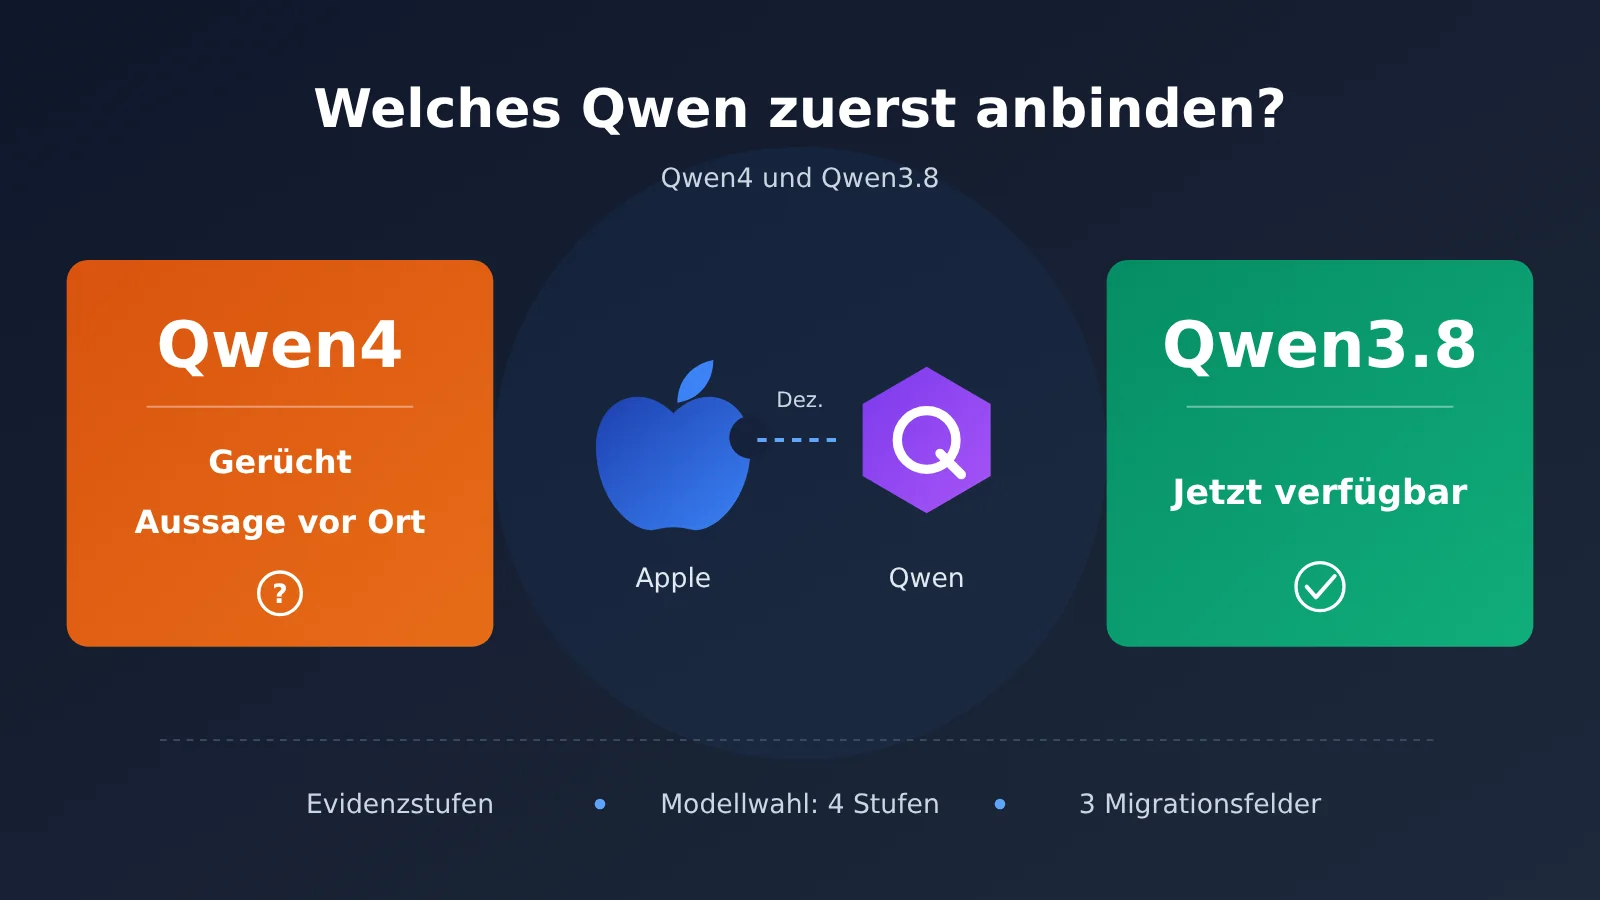
Das Wichtigste vorweg: Zu Qwen4 gibt es bislang nur öffentliche Aussagen bei Veranstaltungen und Spuren in Repositories. Schriftlich hält Alibaba weiterhin fest, dass das Modell „gerade trainiert wird“. Das leistungsstärkste Modell, das sich derzeit direkt einsetzen lässt, ist Qwen3.8. Dass Apple Qwen im Dezember in die chinesische iPhone-Version integriert, ist eine Vertriebsnachricht – für Entwickler entsteht dadurch keine zusätzliche API-Funktion.
Das soll Qwen4 nicht schlechtreden. Dieser Artikel ordnet die bekannten Informationen nach ihrer Verlässlichkeit in vier Stufen ein. So wird klar, was sich in die Projektplanung aufnehmen lässt und was lediglich als Orientierung dient. Anschließend geht es um die Auswahl und Preise der vier Qwen3.8-Stufen sowie um drei Felder, die bei der Migration angepasst werden müssen.
Das bringt Ihnen der Artikel: Sie können einschätzen, ob Sie bei Ihrem Agent-, Schreib-, Kundendienst- oder Moderationsprojekt auf Qwen4 warten oder zunächst Qwen3.8 anbinden sollten. Außerdem kennen Sie die Kosten pro Million Tokens für jede Stufe.
Was Apple integriert: Qwen kommt zu Apple Intelligence in China
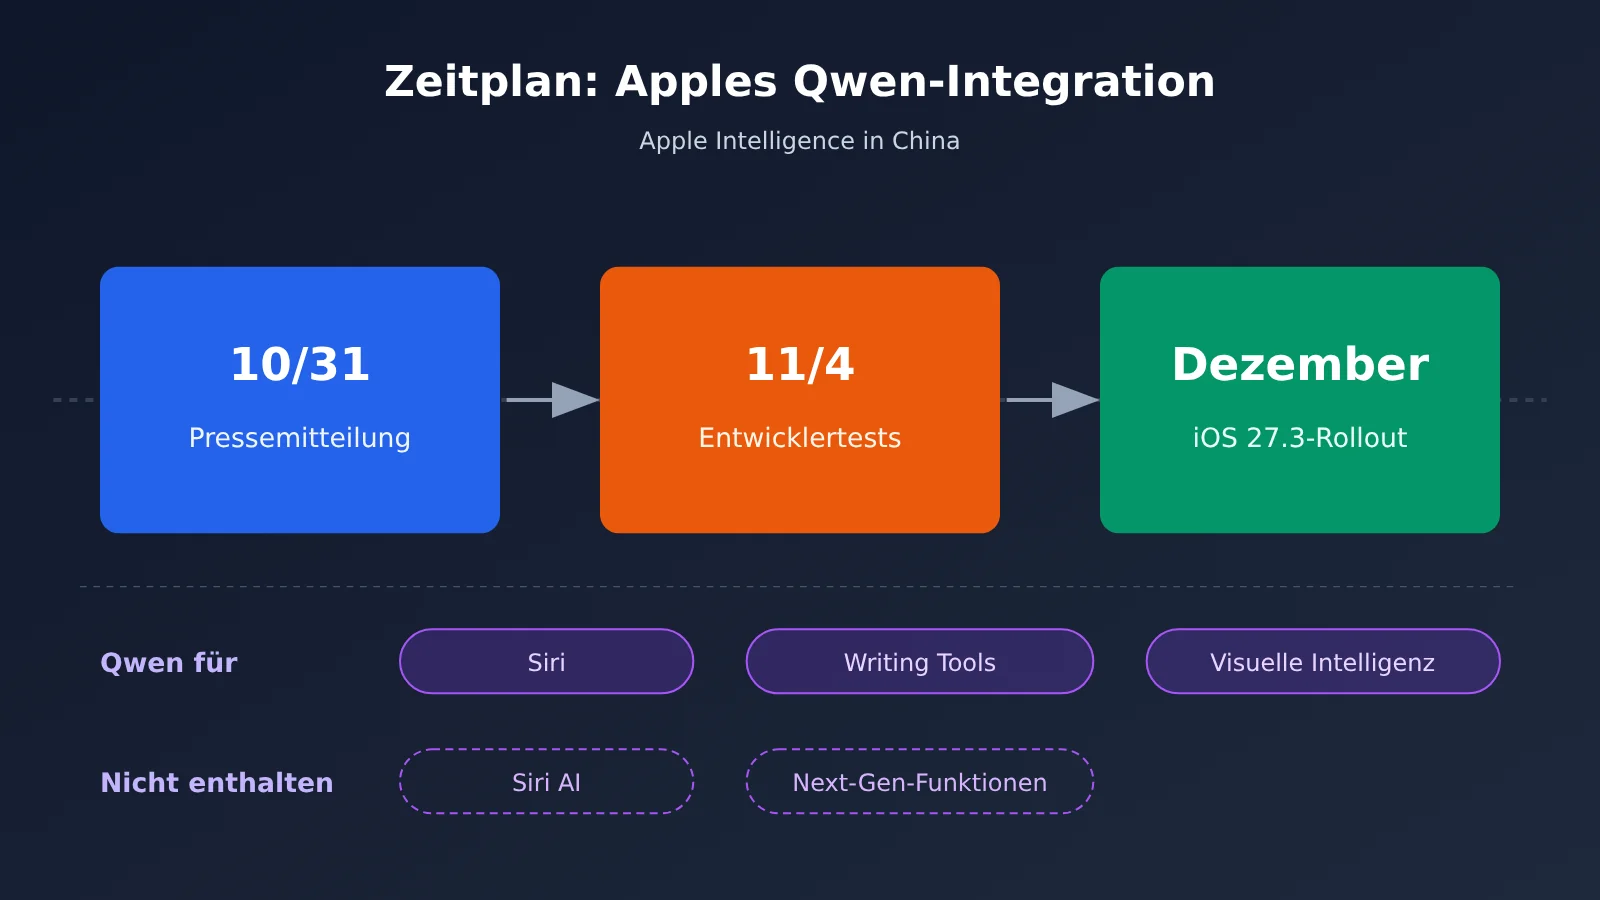
Apple integriert Qwen-Funktionen für Endnutzer, stellt Entwicklern aber keine neue Qwen-API zur Verfügung. Laut einer Erklärung des Apple Newsroom China vom 31. Oktober 2026, über die Tech Wire Asia am 2. November berichtete, sollen die ersten Apple-Intelligence-Funktionen im Dezember mit iOS 27.3 für iPhone-Nutzer auf dem chinesischen Festland erscheinen. Entwickler können sie ab dem 4. November testen. Stand heute, dem 3. November, sind die Funktionen also noch nicht verfügbar.
| Punkt | Inhalt der Apple-Erklärung vom 31. Oktober 2026 |
|---|---|
| Zeitplan | Veröffentlichung im Dezember mit iOS 27.3; Entwickler können ab dem 4. November testen |
| Erste Funktionen | Live-Übersetzung für Nachrichten, FaceTime und Telefon; Writing Tools zum Umschreiben, Korrekturlesen und Zusammenfassen; visuelle Intelligenz über die Kamera; Clean Up in Fotos; Zusammenfassungen für E-Mails und Mitteilungen, priorisierte Nachrichten sowie Zusammenfassungen von Anruftranskripten |
| Rolle von Qwen | Apple betreibt eigene generative Modelle und arbeitet zugleich mit Alibaba zusammen. Nutzer können Qwen direkt in Siri, Writing Tools und der visuellen Intelligenz einsetzen, um Texte und Bilder zu verstehen; Siri kann bestimmte Anfragen an Qwen weiterleiten |
| Anmeldung | Qwen-Account oder Apple-Account |
| Nicht enthalten | Siri AI und die auf der WWDC 2026 vorgestellten Apple-Intelligence-Funktionen der nächsten Generation; laut Bloomberg gehört auch Image Playground nicht zur ersten Veröffentlichung |
| Unterstützte Geräte | Unterstützte iPhones, die in China gekauft wurden, oder Geräte, bei denen sowohl die Geräteregion als auch die Region des Apple-Accounts auf China eingestellt sind |
| Datenzusage | Laut Alibaba werden Nutzeranfragen und von Qwen erzeugte Inhalte nicht zum Training der Modelle verwendet |
Zum Hintergrund: Apple Intelligence gehörte zu sieben generativen KI-Diensten, deren Registrierung bei der chinesischen Internetaufsicht am 15. Juli abgeschlossen wurde. Die FT berichtete, Apple habe zuvor auch Tencent und ByteDance in Betracht gezogen. Laut Counterpoint lag Apples Anteil an den Smartphone-Auslieferungen in China im dritten Quartal 2026 bei 19,5 % und damit auf Platz zwei. Huawei belegte mit 21,3 % den ersten Platz; insgesamt gingen die Auslieferungen gegenüber dem Vorjahr um 10 % zurück.
Für Entwickler liegt der Wert dieser Nachricht vor allem auf der Nutzerseite: Mehr Menschen werden auf Systemebene mit Qwen in Berührung kommen und dessen Ausgabestil kennenlernen. Welches Modell Ihr Backend aufruft, was das kostet und wie hoch die Latenz ist, ändert sich durch Apples Partnerschaft dagegen nicht.
Vier Evidenzstufen zu Qwen4: Was ist glaubwürdig, was taugt für die Planung?
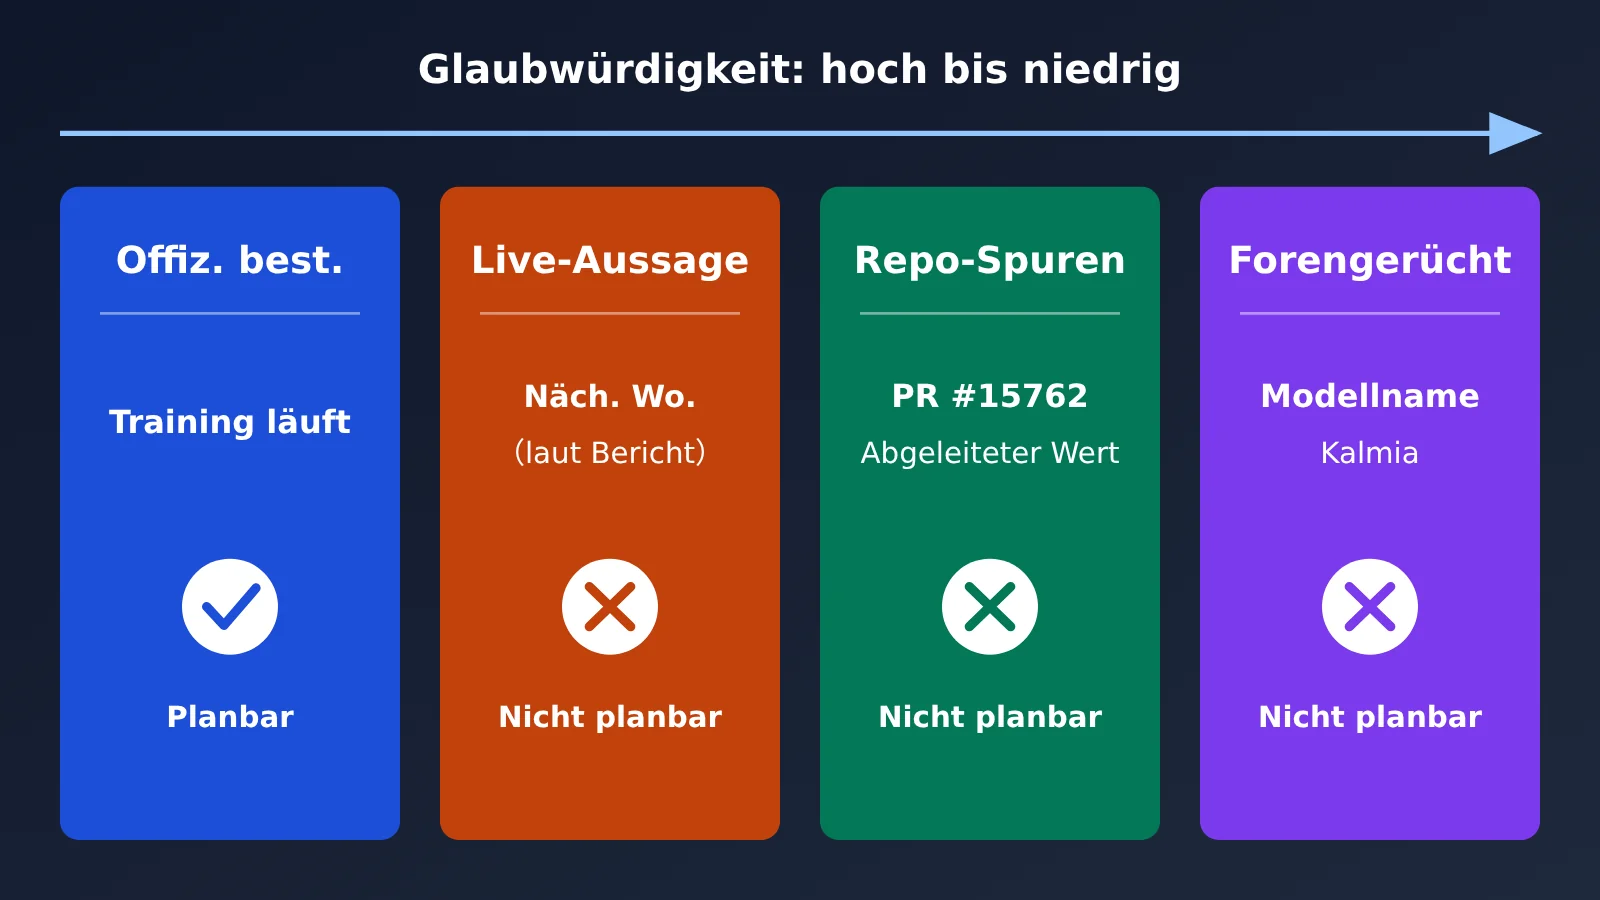
Als Planungsgrundlage dienen nur schriftliche offizielle Aussagen. Und dort steht derzeit: „wird trainiert“. Von den vier Evidenzstufen in der Tabelle nimmt die Zuverlässigkeit nach rechts ab.
| Aspekt | Offiziell bestätigt | Aussage vor Ort | Spuren im Repository | Gerüchte aus der Community |
|---|---|---|---|---|
| Inhalt | Pressemitteilung zur Yunqi Conference vom 22.09.2026: Qwen 4 „currently in training“; die Veranstaltungsseite für Amsterdam am 29.10.2026 nennt nur „Qwen foundation models“, nicht Qwen4 | Der Qwen-Forschungswissenschaftler Xudong Guo sagte am 29.10.2026 vor Ort in Amsterdam, die Qwen4-Serie erscheine „nächste Woche“. Der Teilnehmer John T Davies gab die Aussage weiter; EOGEE berichtete am 30.10.2026 darüber | qwen-code hat am 28.10.2026 PR #15762 zusammengeführt. Damit wird für Modell-IDs, die mit qwen4 beginnen, standardmässig ein Kontextfenster von 1M Token angenommen | Vier Modellnamen: Qwen4-Max / Flash / Plus / 27B; das anonyme Arena-Modell Kalmia wird anhand seines Tokenizer-Fingerabdrucks Qwen4 zugeordnet |
| Art der Quelle | Schriftliche Materialien von Alibaba | Mündliche Aussage einer Einzelperson, von Dritten weitergegeben | Offizielles Repository, der Wert stammt jedoch aus den Erläuterungen zum Review | Websites Dritter, Schlussfolgerungen aus Foren |
| Offiziell bestätigt? | Ja | Nein, EOGEE schreibt ausdrücklich, dass über offizielle Kanäle keine Ankündigung veröffentlicht wurde | Nein, laut PR-Beschreibung gab es damals weder auf models.dev noch im integrierten Katalog einen qwen4-Eintrag; der Wert war eine Annahme | Nein |
| Als Planungsgrundlage geeignet? | Ja, aber nur für die Schlussfolgerung „noch nicht veröffentlicht“ | Nein, lediglich ein Hinweis, den man im Auge behalten sollte | Nein, zeigt eine frühzeitige Anpassung der Toolchain, ist aber keine offizielle Spezifikation | Nein |
Ein wichtiger Hinweis: Ein Beitrag in der TRAE-Community vom 29.10.2026 bezeichnete die Aussage als „Ankündigung des CTO“. Das widerspricht der ursprünglichen Weitergabe, in der von einem „Forschungswissenschaftler“ die Rede ist. Beim Zitieren sollte daher „Forschungswissenschaftler“ verwendet werden.
Die Überprüfung von OmniaKey vom 01.11.2026 lieferte belastbarere Daten: Bis zum 01.11.2026 um 00:21 UTC waren weder auf der Qwen-Organisationsseite von Hugging Face noch in Alibaba Cloud Model Studio oder auf OpenRouter qwen4-Modell-IDs, Gewichte oder Preise zu finden. Die Modellseite von Model Studio wurde zuletzt am 28.10. aktualisiert und empfahl die Textmodelle qwen3.8-max, qwen3.7-plus und qwen3.8-flash. Das Veröffentlichungsprotokoll wurde zuletzt am 30.10. aktualisiert; der neueste Eintrag war qwen-audio-3.1-realtime-flash vom 27.10.
Offizielle Orientierung zur Qwen4-Architektur: Qwen3.8-Flash-Next
Wer sich früh ein Bild von der Architektur von Qwen4 machen möchte, findet derzeit nur ein offizielles Referenzmodell: Qwen3.8-Flash-Next. Die Hugging-Face-Modellkarte wurde am 2026-08-24 erstellt. Offiziell gilt das Modell als „experimentelle Vorschau auf die Qwen4-Architektur“. In der Konfiguration ist der Modelltyp als qwen4_exp angegeben, und auch llama.cpp v0.6.0 unterstützt bereits die Qwen4Exp-Architektur. Wichtig: Es handelt sich um ein Vorschaumodell. Aus seinen Spezifikationen lassen sich weder Kontextfenster und Parameterumfang noch die Lizenz der finalen Qwen4-Version ableiten.
Die vier Qwen3.8-Varianten: das passende Modell für jede Aufgabe
Für neue Projekte empfiehlt es sich derzeit, zunächst zwischen qwen3.8-flash und qwen3.8-27b zu wählen und für komplexe Agenten qwen3.8-max einzusetzen. Qwen3.8-Max wurde am 2026-08-03 im offiziellen Blog von Alibaba Cloud vorgestellt und ist das MoE-Flaggschiff mit 2,4 Billionen Parametern. In späteren Blogbeiträgen stellte das Unternehmen auch Qwen3.8-27B vor und veröffentlichte die Gewichte des Qwen3.8-Flaggschiffs als Open Source.
| Variante | Positionierung | Geeignete Szenarien | Empfehlung | Verfügbare Plattformen |
|---|---|---|---|---|
| qwen3.8-max | Offizielles Flaggschiff, 2,4 Billionen Parameter, MoE | Mehrstufige Agenten, lange Texte, komplexes Reasoning | Wenn Qualität Vorrang hat und das Aufrufvolumen überschaubar ist | APIYI apiyi.com, Alibaba Cloud Bailian |
| qwen3.8-2.4t-a95b | Modellname entspricht den Spezifikationen der quelloffenen Flaggschiff-Gewichte | Teams, die dasselbe Verhalten wie bei einer selbst gehosteten Version benötigen | Als Vergleich nutzen, wenn ein privates Deployment geplant ist | APIYI apiyi.com |
| qwen3.8-27b | Mittelgrosses Modell, offiziell veröffentlicht | Kundenservice, Inhaltsmoderation, strukturierte Extraktion | Standardwahl für einen Kompromiss zwischen Qualität und Kosten | APIYI apiyi.com |
| qwen3.8-flash | Leichte, schnelle Variante | Kundenservice mit vielen parallelen Anfragen, Klassifizierung, Zusammenfassungen, erste Filterung | Erste Wahl bei hohem Aufrufvolumen und niedrigen Latenzanforderungen | APIYI apiyi.com, Alibaba Cloud Bailian |
Je nach Anwendung fallen die Unterschiede zwischen den Varianten unterschiedlich ins Gewicht. Bei Inhaltsmoderation und Kundenservice gibt es meist viele einfache Einzelaufgaben: Flash kann den Grossteil der Anfragen übernehmen, während schwierige Fälle an 27b oder max weitergeleitet werden. So lassen sich die Gesamtkosten senken. Beim Schreiben und bei Agenten ist dagegen die Stabilität über längere Abläufe wichtiger. Hier kann man zunächst mit max eine Qualitätsbasis festlegen und dann prüfen, ob auch 27b ausreicht.
🎯 Empfehlung zur Modellauswahl: Mit demselben API-Schlüssel qwen3.8-max, qwen3.8-flash und qwen3.8-27b jeweils mit denselben Aufgaben in einem A/B-Test vergleichen – das geht schneller, als Bestenlisten zu studieren. Auf APIYI apiyi.com muss dafür nur das Feld model geändert werden; der übrige Code bleibt unverändert. Aussagekräftig sind vor allem die Unterschiede bei den eigenen Praxisbeispielen.
Preise und Modellvarianten: Qwen3.8 und Qwen3.5 im Kostenvergleich
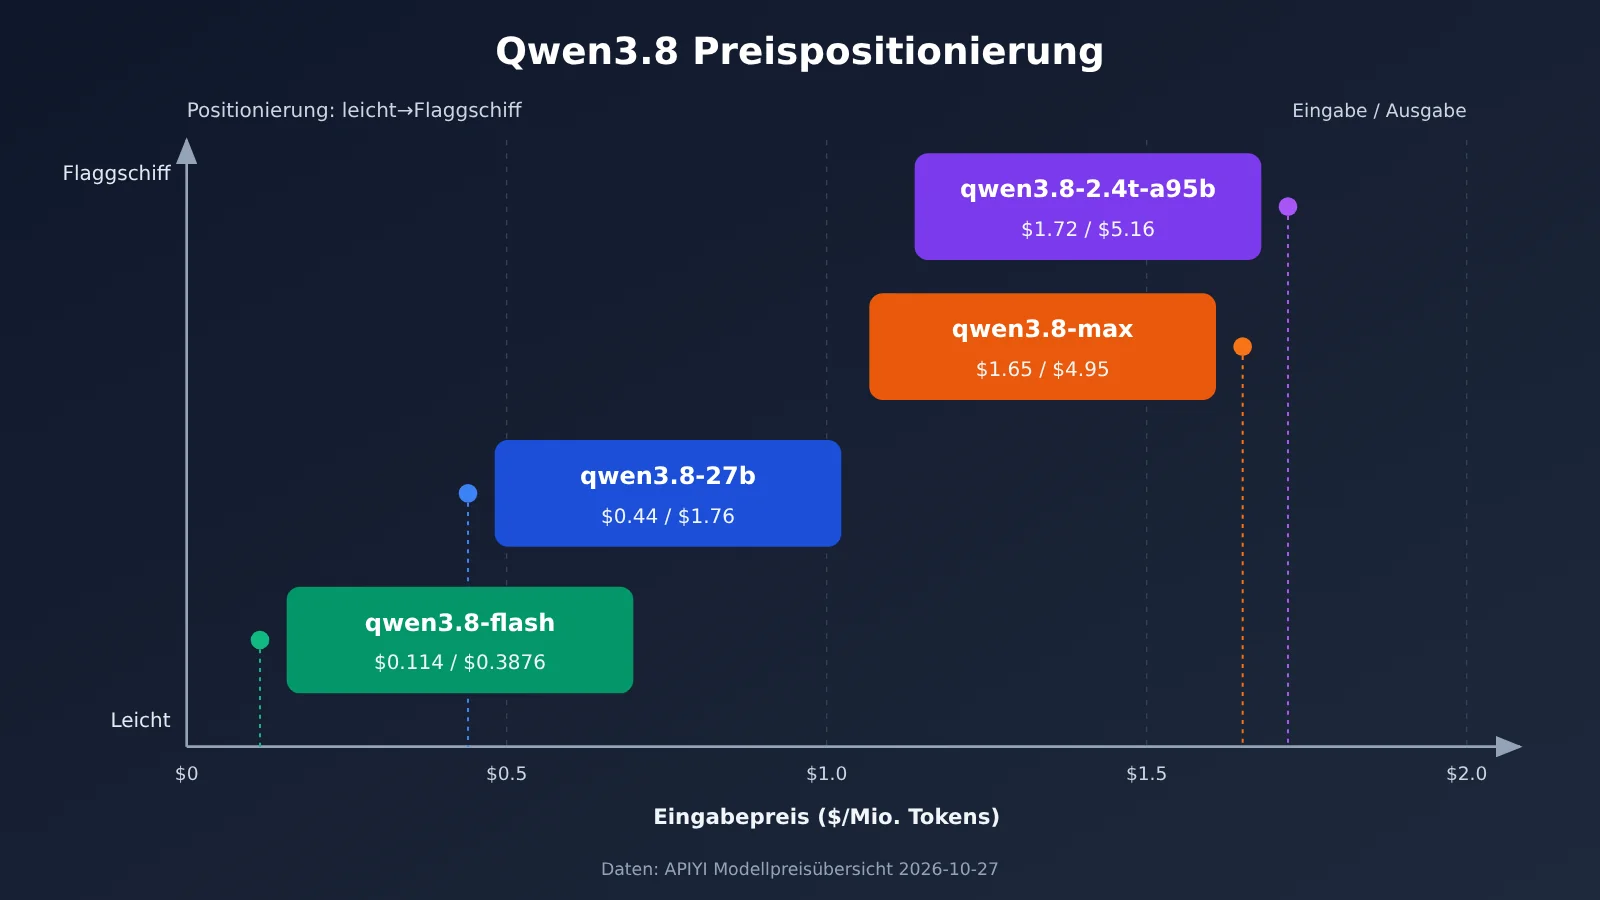
Unter den vier Qwen3.8-Varianten liegt der Eingabepreis von flash bei etwa einem Vierzehntel des Preises von max. Diesen Unterschied sollten Sie bei der Modellwahl berücksichtigen. Die folgende Tabelle zeigt die Preise für neun Qwen-Modelle auf APIYI.
| Modell | Eingabe | Ausgabe | Cache-Lesezugriff |
|---|---|---|---|
| qwen3.8-max | $1.65 | $4.95 | $0.20625 |
| qwen3.8-2.4t-a95b | $1.72 | $5.16 | $0.215 |
| qwen3.8-27b | $0.44 | $1.76 | $0.088 |
| qwen3.8-flash | $0.114 | $0.3876 | $0.01425 |
| qwen3.5-plus | $0.114 | $0.684 | — |
| qwen3.5-flash | $0.03 | $0.3 | — |
| qwen3.5-397b-a17b | $0.18 | $1.08 | — |
| qwen3.5-122b-a10b | $0.12 | $0.96 | — |
| qwen3.5-35b-a3b | $0.06 | $0.48 | — |
Datenstand: 2026-10-27 14:50 UTC+8, US-Dollar pro Million Tokens, aus der Modellpreisübersicht von APIYI (docs.apiyi.com/models).
[Platzhalter für Screenshot: Modellpreisübersicht von APIYI, gefiltert nach qwen3.8]
Anschaulicher wird es anhand einer konkreten Arbeitslast: Bei einer Million Eingabe- und 300.000 Ausgabe-Tokens kostet qwen3.8-max etwa $3.14, qwen3.8-2.4t-a95b etwa $3.27, qwen3.8-27b etwa $0.97 und qwen3.8-flash etwa $0.23. Wenn eine längere System-Eingabeaufforderung wiederholt verwendet wird, kann der Preis für Cache-Lesezugriffe die Eingabekosten weiter senken. Alle vier Qwen3.8-Varianten bieten einen solchen Preis.
Ein Detail ist besonders interessant: qwen3.8-flash und qwen3.5-plus haben mit $0.114 denselben Eingabepreis. qwen3.8-flash hat jedoch einen niedrigeren Ausgabepreis und unterstützt Cache-Lesezugriffe. Bei Schreib- und Zusammenfassungsaufgaben mit umfangreicher Ausgabe ist der Wechsel von qwen3.5-plus zu qwen3.8-flash rechnerisch günstiger. Ob es Qualitätsunterschiede gibt, sollten Sie anhand eigener Beispiele prüfen.
Diese 3 Felder bei der Migration prüfen: Checkliste für Qwen3.8
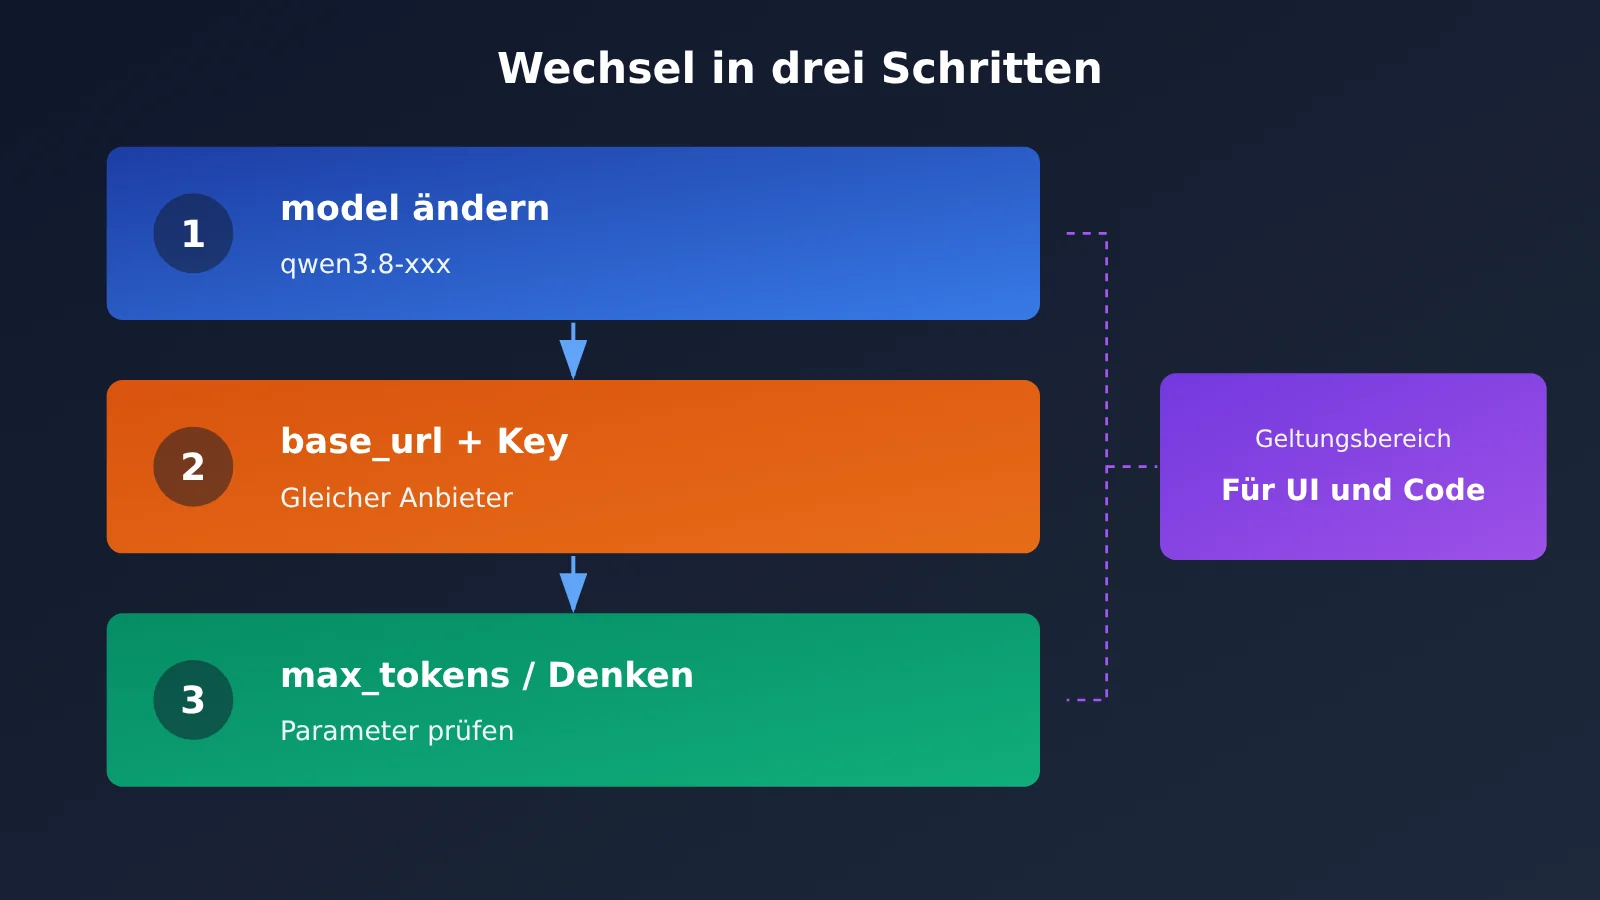
Beim Wechsel von einem anderen Modell oder von Qwen3.5 zu Qwen3.8 müssen Sie normalerweise nur drei Einstellungen prüfen. Das gilt sowohl für grafische Oberflächen wie Cherry Studio, Dify und verschiedene Chat-Clients als auch für Codeprojekte.
| Reihenfolge | Feld | Was ändern? | Wo in der grafischen Oberfläche? |
|---|---|---|---|
| 1 | model | Auf qwen3.8-flash, qwen3.8-27b oder qwen3.8-max ändern |
Dropdown „Modell“ oder Eingabefeld „Modell-ID“ |
| 2 | base_url + API Key | Prüfen, ob beide zum selben Anbieter gehören | Felder „API-Adresse / Schnittstellenadresse“ und „Schlüssel“ |
| 3 | Ausgabelänge und Denkparameter | max_tokens und Einstellungen für die Schlussfolgerung prüfen | Bereiche „Maximale Ausgabe“ und „Erweiterte Parameter“ |
Schritt 1: Modellnamen ändern. Der Modellname muss exakt mit dem Eintrag in der Modellliste der Plattform übereinstimmen, einschließlich Kleinschreibung und Punkten. Andernfalls erscheint die Fehlermeldung „Modell nicht vorhanden“. Kopieren Sie den Namen am besten aus der Modellliste, statt ihn von Hand einzugeben.
Schritt 2: Prüfen, ob base_url und Key zum selben Anbieter gehören. Wenn Sie APIYI nutzen, tragen Sie als Schnittstellenadresse https://api.apiyi.com/v1 ein und verwenden den API-Schlüssel, den Sie im Dashboard von APIYI auf apiyi.com erstellt haben. Viele „401 – nicht autorisiert“-Fehler entstehen, weil die Adresse geändert wurde, der Schlüssel aber noch vom alten Anbieter stammt – oder umgekehrt. Um zu prüfen, auf welche Modelle der aktuelle Schlüssel Zugriff hat, können Sie mit curl https://api.apiyi.com/v1/models -H "Authorization: Bearer 你的Key" die Liste abrufen.
Schritt 3: Ausgabelänge und Denkparameter prüfen. Standardwerte für die Ausgabelänge und das Verhalten bei der Schlussfolgerung können sich zwischen Modellgenerationen unterscheiden. Ein in einem älteren Projekt fest eingestellter max_tokens-Wert kann lange Antworten abschneiden. Wenn bei Modellen mit Schlussfolgerungsfähigkeit das Denken aktiviert ist, steigen sowohl die Latenz als auch die Zahl der Ausgabe-Tokens. Für latenzempfindliche Anwendungen wie Kundenservice oder Moderation empfiehlt es sich, zunächst einen Testlauf ohne Denken durchzuführen und die Funktion erst bei Bedarf zu aktivieren. Die genauen Parameternamen finden Sie in der Dokumentation der Plattform.
Wann lohnt es sich, auf Qwen4 zu warten?
Für die meisten Projekte lohnt sich das Warten nicht. Qwen4 sollte man nur im Blick behalten, wenn der Start ohnehin erst in ein bis zwei Monaten geplant ist und es feste Anforderungen an die Modellgeneration gibt.
Wann Qwen3.8 die bessere Wahl ist:
- Das Projekt muss noch in diesem Quartal starten. Die Planung kann nicht von einem Modell ohne offiziellen Veröffentlichungstermin abhängen.
- Kundensupport, Moderation und Zusammenfassungen stehen im Mittelpunkt, und flash oder 27b erfüllt die Anforderungen bereits.
- Die Schnittstelle ist OpenAI-kompatibel. Ein späterer Wechsel erfordert nur eine Änderung des Feldes
model, sodass durch die jetzige Integration keine versunkenen Kosten entstehen.
Wann es sich lohnt, Qwen4 im Auge zu behalten:
- Das Produkt befindet sich noch in der technischen Vorentwicklung, und bis zum Start ist noch viel Zeit.
- Für eine private Bereitstellung werden offen verfügbare Modellgewichte benötigt. In diesem Fall lohnt sich ein Blick auf die Lizenzbedingungen nach der Veröffentlichung von Qwen4.
- Qwen3.8-Flash-Next wird bereits für die Architekturvorbereitung eingesetzt.
Ein pragmatischer Ansatz für die Wartezeit: Erstellen Sie mit Qwen3.8 zunächst einen Evaluierungsdatensatz und legen Sie die relevanten Geschäftskennzahlen fest. Nach der offiziellen Veröffentlichung von Qwen4 können Sie beide Modelle anhand derselben Beispiele vergleichen und dann über einen Wechsel entscheiden. Die Qwen4-Serie ist bei APIYI zum Stand 2026-11-03 noch nicht verfügbar. Wir werden das Modell so bald wie möglich bereitstellen; danach ist es direkt in der Modellliste auf APIYI apiyi.com zu finden.
Häufig gestellte Fragen (FAQ)
F1: Wann erscheint Qwen4?
Ein offizielles Datum gibt es bisher nicht. Die eindeutigste schriftliche Aussage von Alibaba stammt aus der Pressemitteilung zur Yunqi Conference vom 22.09.2026: Das Modell werde „gerade trainiert“. Die Aussage „Veröffentlichung nächste Woche“ geht auf eine Äußerung eines Research Scientists vor Ort zurück, die von Teilnehmenden weitergegeben wurde. Eine offizielle Ankündigung gibt es dazu nicht. Am besten orientieren Sie sich an den Updates auf der Qwen-Organisationsseite bei Hugging Face und in den Veröffentlichungsprotokollen von Bailian.
F2: Welche Qwen3.8-Variante eignet sich für ein neues Projekt?
Für einfache Aufgaben bei hoher Parallelität ist qwen3.8-flash ein guter Ausgangspunkt. Für Aufgaben wie Kundenservice, Moderation und Datenextraktion, bei denen auch die Qualität zählt, bietet sich qwen3.8-27b an. Für mehrstufige Agenten und das Schreiben langer Texte kann qwen3.8-max als Qualitätsmaßstab dienen. Welche Modelle verfügbar sind und was sie kosten, entnehmen Sie der Modellliste der jeweiligen Plattform. Bei APIYI auf apiyi.com können Sie alle drei Varianten mit demselben API-Schlüssel testen, bevor Sie sich entscheiden.
F3: Was bringt die Qwen-Integration in Apples China-Version für Entwickler?
Die direkten Auswirkungen sind gering. Apples Erklärung vom 31.10.2026 betrifft Nutzerfunktionen auf Systemebene, die im Dezember mit iOS 27.3 eingeführt werden. Entwickler können sie ab dem 4. November testen; eine neue API wurde nicht freigegeben. Indirekt werden mehr iPhone-Nutzer mit dem Ausgabestil von Qwen vertraut. Produkte für diese Nutzergruppe können Qwen daher als mögliches Modell berücksichtigen.
F4: Sollte man bestehende Qwen3.5-Projekte komplett auf Qwen3.8 umstellen?
Ein vollständiger Wechsel auf einmal ist nicht nötig. Bewerten Sie die Modelle am besten Aufgabe für Aufgabe. Der Eingabepreis von qwen3.5-flash ist mit $0.03 weiterhin der niedrigste der Serie; für sehr einfache Aufgaben können Sie es problemlos weiterverwenden. Bei Projekten, die qwen3.5-plus zum Schreiben oder Zusammenfassen einsetzen, lohnt sich zunächst ein Vergleich mit qwen3.8-flash: Der Eingabepreis ist gleich, der Ausgabepreis bei letzterem niedriger. Auf APIYI apiyi.com müssen Sie für den Wechsel nur das Feld model ändern. Sie können zunächst 10 % des Datenverkehrs schrittweise umstellen.
F5: Muss ich meinen bisherigen API-Schlüssel austauschen, sobald Qwen4 verfügbar ist?
Nein. Auf einer Aggregationsplattform können Sie mit demselben API-Schlüssel alle dort verfügbaren Modelle aufrufen. Sobald ein neues Modell hinzugefügt wurde, müssen Sie nur den model-Namen ändern. Die Qwen4-Serie war am 03.11.2026 noch nicht auf APIYI verfügbar. Wir werden das Modell so schnell wie möglich hinzufügen. Danach können Sie es mit Ihrem bestehenden API-Schlüssel von APIYI apiyi.com direkt aufrufen.
Qwen4 oder Qwen3.8: Das Wichtigste zur Modellauswahl
- Offizieller Stand zu Qwen4: Laut Pressemitteilung vom 22.09.2026 wird das Modell „gerade trainiert“. Ein Datum, eine Modell-ID und Preise gibt es bisher nicht.
- „Veröffentlichung nächste Woche“: Diese Aussage stammt von einem Forschungswissenschaftler vor Ort und wurde weitergegeben. Sie ist keine verlässliche Grundlage für die Planung.
- Hinweise im Repository: Das Kontextfenster von 1 Mio. Tokens in qwen-code PR #15762 ist ein Schätzwert, keine offizielle Spezifikation.
- Zusammenarbeit mit Apple: Die Integration kommt im Dezember mit iOS 27.3; Entwickler können sie ab dem 4. November testen. Eine neue API ist damit nicht verbunden.
- Aktuell höchste verfügbare Modellgeneration: Qwen3.8. Der Eingabepreis von flash liegt bei etwa einem Vierzehntel des Preises von max.
- Migrationsaufwand:
modeländern,base_urlund API-Schlüssel prüfen sowie Ausgabelänge und Thinking-Parameter kontrollieren.
Fazit
Die aktuellen Qwen-Nachrichten lassen sich auf drei Ebenen einordnen:
- Apple integriert Qwen im Dezember: Das erweitert die Reichweite und beeinflusst, wie Nutzer Qwen wahrnehmen. Neue Funktionen, die Entwickler aufrufen können, entstehen dadurch nicht.
- Qwen4: Es gibt Aussagen vor Ort und Hinweise im Repository. Offiziell heißt es schriftlich aber weiterhin, das Modell werde „gerade trainiert“. Für eine Zeitplanung ist das keine belastbare Grundlage.
- Qwen3.8: Das Modell ist offiziell veröffentlicht, die Preise stehen fest. Vier Varianten decken die wichtigsten Einsatzszenarien ab – von hoher Parallelität bis zu komplexen Agenten.
Ein pragmatischer Weg: Jetzt mit Qwen3.8 produktiv gehen und Testbeispiele sammeln. Sobald Qwen4 offiziell erscheint, lässt es sich mit denselben Beispielen vergleichen. Über APIYI apiyi.com können Sie alle Qwen3.8-Varianten mit einem einzigen API-Schlüssel testen. Neue Nutzer erhalten kostenloses Testguthaben und können damit zunächst einen A/B-Test durchführen, bevor sie sich für eine Variante entscheiden.
📚 Quellen
- Tech Wire Asia: Wiedergabe der Erklärung des chinesischen Apple Newsroom vom 31.10.2026
- Link:
techwireasia.com/2026/11/apple-intelligence-china-alibaba-qwen-december/ -
Inhalt: Apples Funktionsumfang für Dezember, die Rolle von Qwen und unterstützte Geräte
-
OmniaKey: „Wann erscheint Qwen 4? Was hat Alibaba offiziell bestätigt?“, 01.11.2026
- Link:
omniakey.com/zh/blog/qwen-4-release-date -
Inhalt: Überprüfung offizieller Aussagen und Rechercheergebnisse auf drei Plattformen
-
EOGEE: „Qwen kündigt Qwen4 für nächste Woche an“, 30.10.2026
- Link:
eogee.com/article/289 -
Inhalt: Quelle für die Wiedergabe der Aussage vor Ort in Amsterdam
-
Offizieller Blog von Alibaba Cloud: Veröffentlichung von Qwen3.8-Max, 03.08.2026
- Link:
alibabacloud.com/blog/alibaba-unveils-qwen3-8-max-its-largest-and-most-capable-flagship-model-to-date_603420 -
Inhalt: Offizielle Informationen zur Veröffentlichung des Flaggschiffmodells Qwen3.8
-
Offizieller Blog von Alibaba Cloud: Veröffentlichung von Qwen3.8-27B und Freigabe der Gewichte des Flaggschiffmodells als Open Source
- Link:
alibabacloud.com/blog/alibaba-unveils-qwen3-8-27b-and-releases-weights-of-qwen3-8-flagship-model_603463 -
Inhalt: Informationen zur 27B-Modellvariante und zur Open-Source-Freigabe
-
APIYI Modellpreisübersicht
- Link:
docs.apiyi.com/models - Inhalt: Datenquelle für die Preistabelle in diesem Artikel