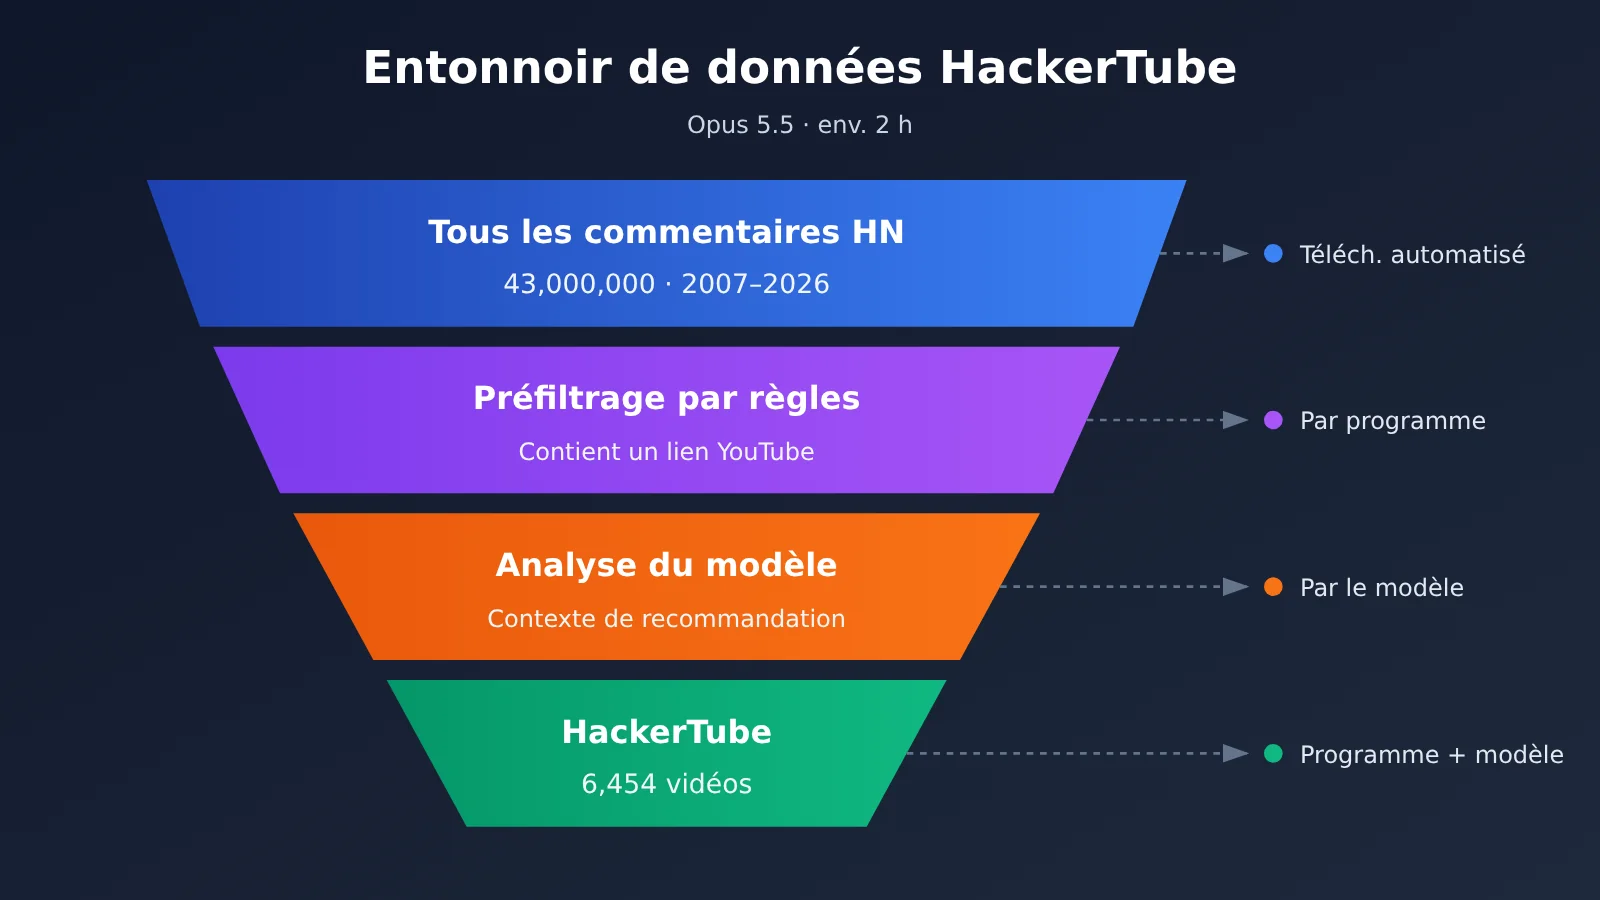
Andrej Karpathy a consacré environ deux heures de son week-end à créer HackerTube, un site de vidéos. Avec l’aide de Claude, il a extrait 6 454 vidéos YouTube recommandées à plusieurs reprises parmi les quelque 43 millions de commentaires publiés sur Hacker News en 20 ans. L’essentiel du travail s’est fait au fil d’une conversation avec Claude. Sur X, Karpathy a résumé l’expérience ainsi, le 1er novembre 2026 : « ~2 hours with Opus 5.5 ».
À partir du message de Karpathy, du site HackerTube et des informations partagées publiquement par la communauté, cet article décompose la démarche en 6 étapes accessibles aux développeurs et présente les 3 obstacles les plus courants.
L’essentiel : vous trouverez ici une méthode en 6 étapes qui précise le rôle de la personne, du programme et du modèle, une estimation des coûts avec ses hypothèses, ainsi que le chemin le plus court pour accéder à Claude Code via APIYI, sur apiyi.com.
Qu’a fait Karpathy avec HackerTube ?
En une phrase : il a rassemblé 20 ans de recommandations « il faut absolument voir cette vidéo » de la communauté HN dans un site vidéo où l’on peut naviguer librement.
Voici la traduction intégrale de son message sur X (2026-11-01 18:14 UTC) :
« Petit projet du week-end : HackerTube. Les recommandations de YouTube m’agaçaient, alors j’ai demandé à Claude de filtrer 43 millions de commentaires publiés sur HN en 20 ans pour en extraire 6,454 vidéos régulièrement recommandées. Une expérience de visionnage nettement meilleure, en environ 2 heures avec Opus 5.5. »
Le site hackertube.org se décrit ainsi : « Les vidéos YouTube que les membres de Hacker News se recommandent sans cesse. » Son cœur n’est donc pas un algorithme de recommandation, mais un filtrage sémantique des discussions existantes de la communauté.
| Point | Informations publiques | Nature de la source |
|---|---|---|
| Volume de données | Environ 43 millions de commentaires HN sur 20 ans, pour 6,454 vidéos retenues | Message original de Karpathy (2026-11-01) |
| Temps et modèle | Environ 2 heures avec Opus 5.5 | Message original de Karpathy (2026-11-01) |
| Environnement de travail | Application de bureau Claude Code | Selon la communauté |
| Actions manuelles | Trois actions seulement : demander une clé API YouTube, préparer le serveur et acheter un nom de domaine | Selon la communauté |
| Format du site | Environ 150 thèmes couvrant la période 2007-2026, sans connexion nécessaire | Selon les statistiques de la communauté |
Comment fonctionne HackerTube
Selon la communauté, Karpathy aurait dit : « Je parle uniquement à Claude et je lui fais tout faire. » Autrement dit, Claude a réalisé l’essentiel du travail dans Claude Code : téléchargement des données, écriture des scripts de filtrage, invocation du modèle pour prendre les décisions et génération des pages. L’humain s’est surtout chargé de formuler les demandes et de gérer les étapes nécessitant un compte ou un paiement.
Ce n’est pas la même chose que de demander à une IA de créer un modèle de page web. La vraie difficulté se trouve dans les données : on ne peut pas faire entrer 43 millions de commentaires d’un coup dans la fenêtre de contexte, et la présence d’un lien ne signifie pas forcément qu’il s’agit d’une recommandation. Le projet ressemble donc davantage à un pipeline de données doté d’une interface légère.
Recréer HackerTube avec Opus 5.5 en 6 étapes
Pour aller droit au but : l’essentiel est de laisser d’abord le programme réduire le volume de données, puis de réserver au modèle les décisions qui demandent une véritable compréhension. Les 6 étapes ci-dessous suivent l’ordre d’exécution et précisent qui fait quoi et comment vérifier le résultat.
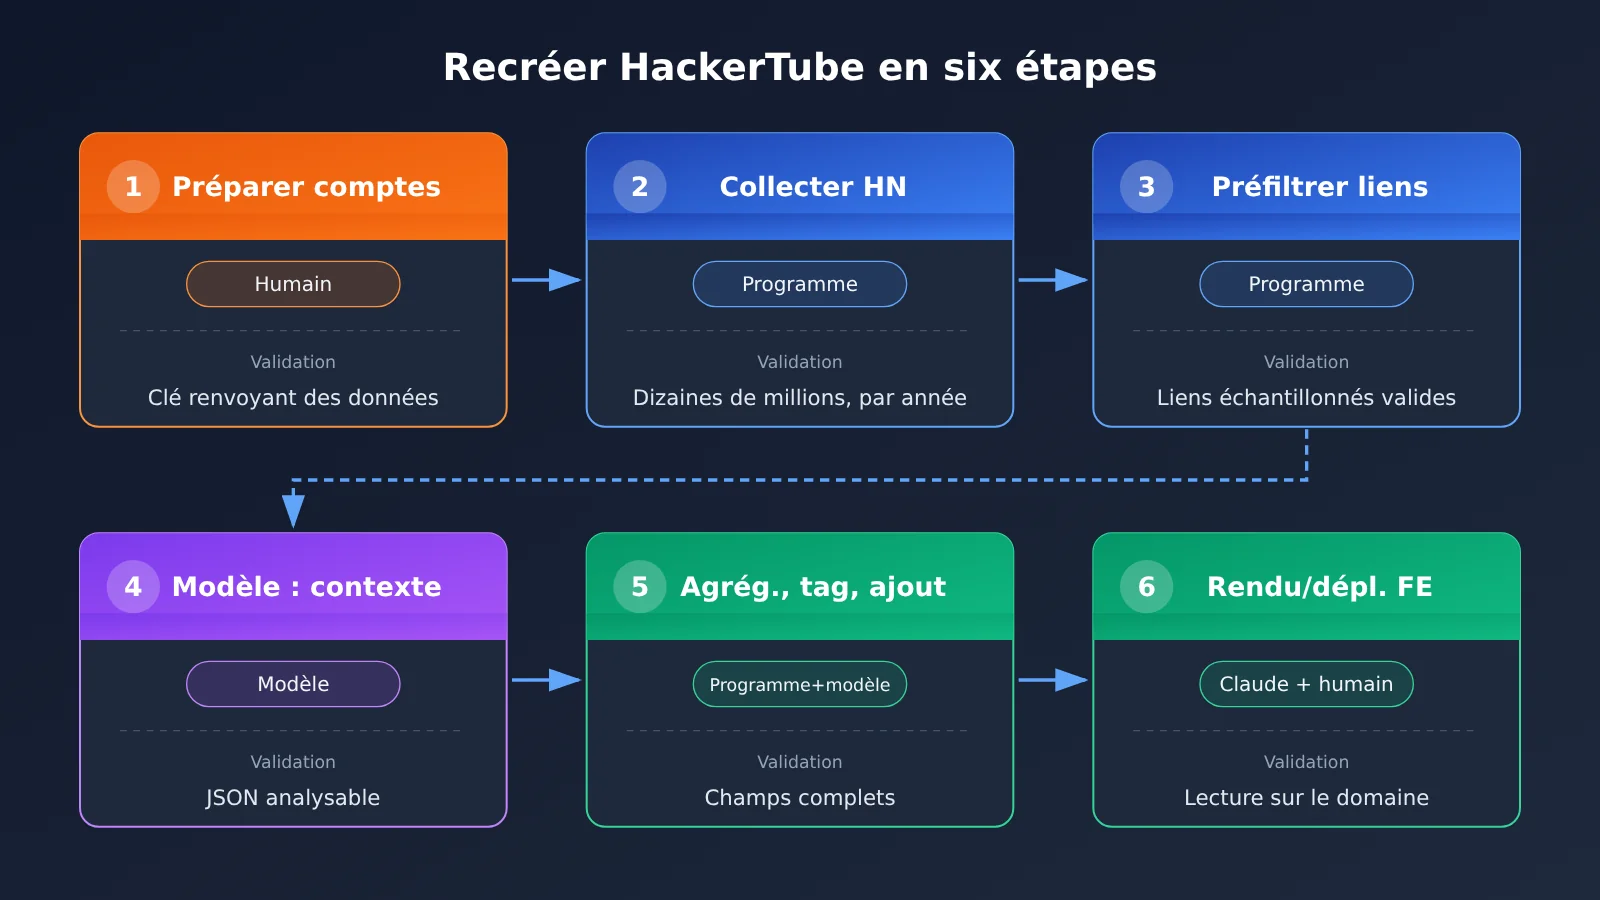
| Étape | À faire | Responsable | Comment valider le résultat |
|---|---|---|---|
| 1 | Obtenir une clé API YouTube, préparer un serveur et acheter un nom de domaine | Humain | Les trois sont accessibles et la clé renvoie les informations d’une vidéo |
| 2 | Récupérer tous les commentaires HN | Programme (écrit par Claude) | Les fichiers locaux sont répartis par année et le nombre de commentaires correspond à l’ordre de grandeur attendu |
| 3 | Extraire par expression régulière les commentaires contenant des liens YouTube | Programme | Vérifier sur un échantillon de 50 commentaires que chacun contient un lien vidéo valide |
| 4 | Demander au modèle de déterminer par lots si le contexte correspond à une recommandation, puis produire du JSON | Modèle | Le JSON peut être analysé directement et un contrôle manuel sur échantillon confirme les résultats |
| 5 | Agréger et compter par videoId, ajouter des étiquettes thématiques et compléter les titres et les chaînes | Programme + modèle | Chaque vidéo possède tous les champs requis et le nombre de thèmes reste maîtrisable |
| 6 | Générer l’interface et la déployer | Claude écrit le code, un humain configure le domaine | Le domaine s’ouvre dans le navigateur et permet de parcourir les thèmes et de lire les vidéos |
Étapes 1 et 2 : préparer les ressources et récupérer les données HN
L’étape 1 est réalisée par une personne. Créez un projet dans la console Google Cloud, activez l’API YouTube Data et générez une clé API. Le serveur peut être n’importe quelle instance cloud ou un service d’hébergement statique ; achetez aussi un nom de domaine auprès d’un registrar pour l’utiliser plus tard. Ces trois démarches nécessitent un compte ou un paiement : d’après les récits relayés par la communauté, c’est la partie dont Karpathy s’est occupé lui-même.
À l’étape 2, Claude écrit le programme. Les données HN sont accessibles via deux sources publiques : l’API Firebase officielle permet de récupérer les éléments un par un à partir de leur ID, tandis que le jeu de données public HN sur BigQuery peut être interrogé directement en SQL. Pour un téléchargement complet, privilégiez BigQuery et exportez les données par année. Pour valider le résultat, vérifiez simplement que les fichiers sont répartis par période et que le nombre total d’entrées se compte en dizaines de millions.
Étapes 3 et 4 : préfiltrage par règles et analyse sémantique avec Opus 5.5
L’étape 3 est essentielle pour réduire les coûts et peut être entièrement confiée à un programme. Utilisez des expressions régulières pour repérer les formats de liens comme youtube.com/watch et youtu.be/. Ne conservez que les commentaires contenant un lien vidéo, avec l’ID du commentaire, sa date et le titre du fil parent pour le contexte. Il suffit de décrire le besoin dans Claude Code, par exemple : « Écris un script qui extrait les commentaires contenant des liens YouTube et les enregistre au format JSONL. »
C’est seulement à l’étape 4 que le modèle intervient pour prendre une décision. Envoyez à Opus 5.5 des lots de quelques milliers de commentaires et demandez-lui de produire uniquement des résultats structurés, avec les champs videoId, recommandation ou non, sujet et extrait représentatif du commentaire. Précisez dans l’invite que « cette vidéo est nulle » ou « ne regardez pas ça » ne sont pas des recommandations : seules les formulations exprimant que la vidéo « vaut le coup d’être regardée » comptent. Pour valider le résultat, vérifiez manuellement un échantillon aléatoire afin de déterminer si le taux d’erreur est acceptable.
Étapes 5 et 6 : agrégation, étiquetage et déploiement du frontend
À l’étape 5, utilisez d’abord des règles, puis un modèle. Le programme compte le nombre de recommandations par videoId, puis appelle l’API YouTube Data pour récupérer les titres et les chaînes. Le modèle regroupe les étiquettes thématiques afin d’éviter une fragmentation excessive, avec des catégories comme « apprentissage automatique », « ML » et « introduction au deep learning ». Selon les statistiques de la communauté, HackerTube compte environ 150 thèmes au final : un bon repère pour choisir le niveau de détail.
À l’étape 6, séparez les données de la page. Le résultat se compose d’un fichier de données JSON et d’un frontend statique qui le lit. Les vidéos sont intégrées via des iframes YouTube et classées par thème et par popularité. Pour mettre à jour les données, il suffit de régénérer le JSON, sans toucher au code de la page. Le site peut être déployé sur un service d’hébergement statique ou sur votre serveur ; il reste ensuite à faire pointer le nom de domaine vers celui-ci.
🚀 Pour commencer rapidement : les étapes 4 et 5 nécessitent des appels fréquents au modèle. En accédant à Claude Code via APIYI apiyi.com, vous pouvez utiliser la même clé API pour passer d’Opus à Sonnet. Testez d’abord le processus sur un petit lot de données, puis choisissez le modèle à utiliser pour le traitement complet.
Trois pièges qui peuvent vraiment bloquer la reproduction de HackerTube
La conclusion d’abord : les blocages se situent presque tous du côté des données, pas du développement web. Voici les trois pièges, dans l’ordre où vous risquez de les rencontrer.
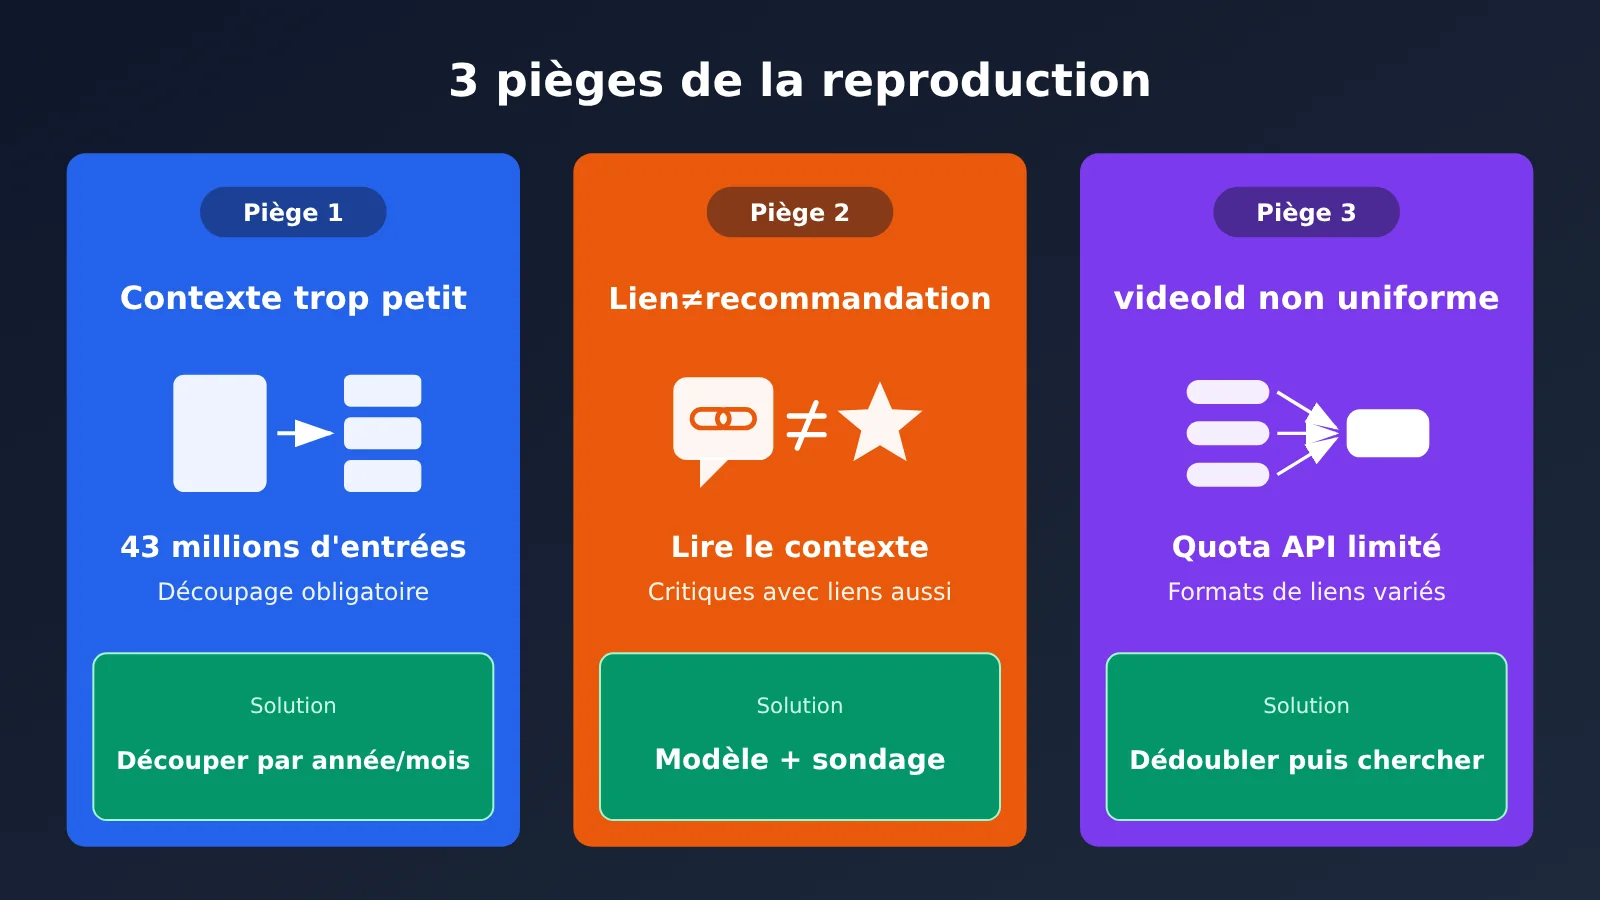
| Piège | Symptôme typique | Solution |
|---|---|---|
| Contexte insuffisant | On demande au modèle de « lire tous les commentaires » : erreur de dépassement de longueur ou réponse tronquée | Découper par année ou par mois, en lots de quelques milliers de commentaires, et ne demander que du JSON structuré |
| Lien ≠ recommandation | Les liens dans les critiques, les commentaires ironiques ou les corrections sont pris pour des recommandations | Demander au modèle de lire le contexte, puis vérifier un échantillon manuellement |
| ID incohérents et quota | Plusieurs formats de liens pour une même vidéo, vidéos supprimées, quota API épuisé | Uniformiser les videoId avant l’agrégation et ne récupérer les métadonnées que pour les ID dédupliqués |
Piège 1 : la fenêtre de contexte d’Opus 5.5 ne peut pas contenir 43 millions de commentaires
L’erreur la plus courante quand on débute consiste à formuler la demande ainsi : « Lis tous les commentaires HN et trouve les vidéos recommandées. » Quelle que soit la taille de sa fenêtre de contexte, aucun modèle ne peut contenir d’un coup un texte de plus d’un milliard de tokens. La bonne approche consiste à demander d’abord à Claude d’écrire un script de découpage par année ou par mois, avec quelques milliers de commentaires par lot, puis de ne renvoyer que du JSON, sans explication.
Prévoyez aussi un mécanisme de reprise : enregistrez séparément les résultats de chaque lot et consignez les numéros déjà traités. Si une erreur survient en cours de route, il suffira de relancer le lot concerné au lieu de tout recommencer.
Piège 2 : un lien YouTube n’est pas forcément une recommandation
Dans les commentaires HN, un lien YouTube peut renvoyer à une recommandation, mais aussi à un contre-exemple, à une critique ou à une vidéo dont le contenu est jugé erroné. Une simple recherche d’URL ajoutera beaucoup de bruit aux résultats. Il faut confier la lecture du contexte au modèle : c’est l’étape du processus qui nécessite réellement l’intervention d’un grand modèle de langage.
Incluez des exemples positifs et négatifs dans l’invite, et demandez un court extrait à l’appui de chaque décision. Lors d’une vérification manuelle par échantillonnage, vous pourrez ainsi comprendre rapidement pourquoi le modèle a choisi cette catégorie. L’interface peut aussi reprendre directement cet extrait dans la section « Ce qu’en dit HN » de la carte vidéo.
Piège 3 : videoId non uniformisés et quota de l’API YouTube
Une même vidéo peut apparaître sous plusieurs formes : youtube.com/watch?v=, youtu.be/, lien mobile, lien avec un paramètre d’horodatage, etc. Sans normalisation préalable en videoId de 11 caractères, les recommandations d’une même vidéo seront comptabilisées séparément et le classement sera faussé. Par ailleurs, en 20 ans, de nombreuses vidéos ont été supprimées ou rendues privées : il faut les signaler et les filtrer.
L’API YouTube Data impose un quota quotidien. Dédupliquez donc les ID avant de récupérer les métadonnées par lots, plutôt que d’effectuer une requête par commentaire. L’interface de traitement par lots permet d’interroger plusieurs ID à la fois et réduit ainsi considérablement la consommation de quota.
Combien coûte la reproduction de HackerTube ? (estimation)
En bref : confier l’ensemble du traitement à Opus 5.5 coûterait plusieurs milliers de dollars ; un préfiltrage par règles pourrait ramener le coût à quelques dizaines ou centaines de dollars. Tous les chiffres ci-dessous sont des estimations, pas des factures réelles.
Commençons par les tarifs unitaires. Le tableau ci-dessous provient de la grille tarifaire des modèles d’APIYI, relevée le 27 octobre 2026 à 14 h 50 (UTC+8). Les prix sont indiqués en dollars par million de tokens.
| Modèle | Entrée | Sortie | Lecture du cache | Plateformes disponibles |
|---|---|---|---|---|
| opus-5-5 | $4 | $20 | $0.2 | APIYI apiyi.com, API officielle |
| sonnet-5-5 | $2 | $10 | $0.1 | APIYI apiyi.com, API officielle |
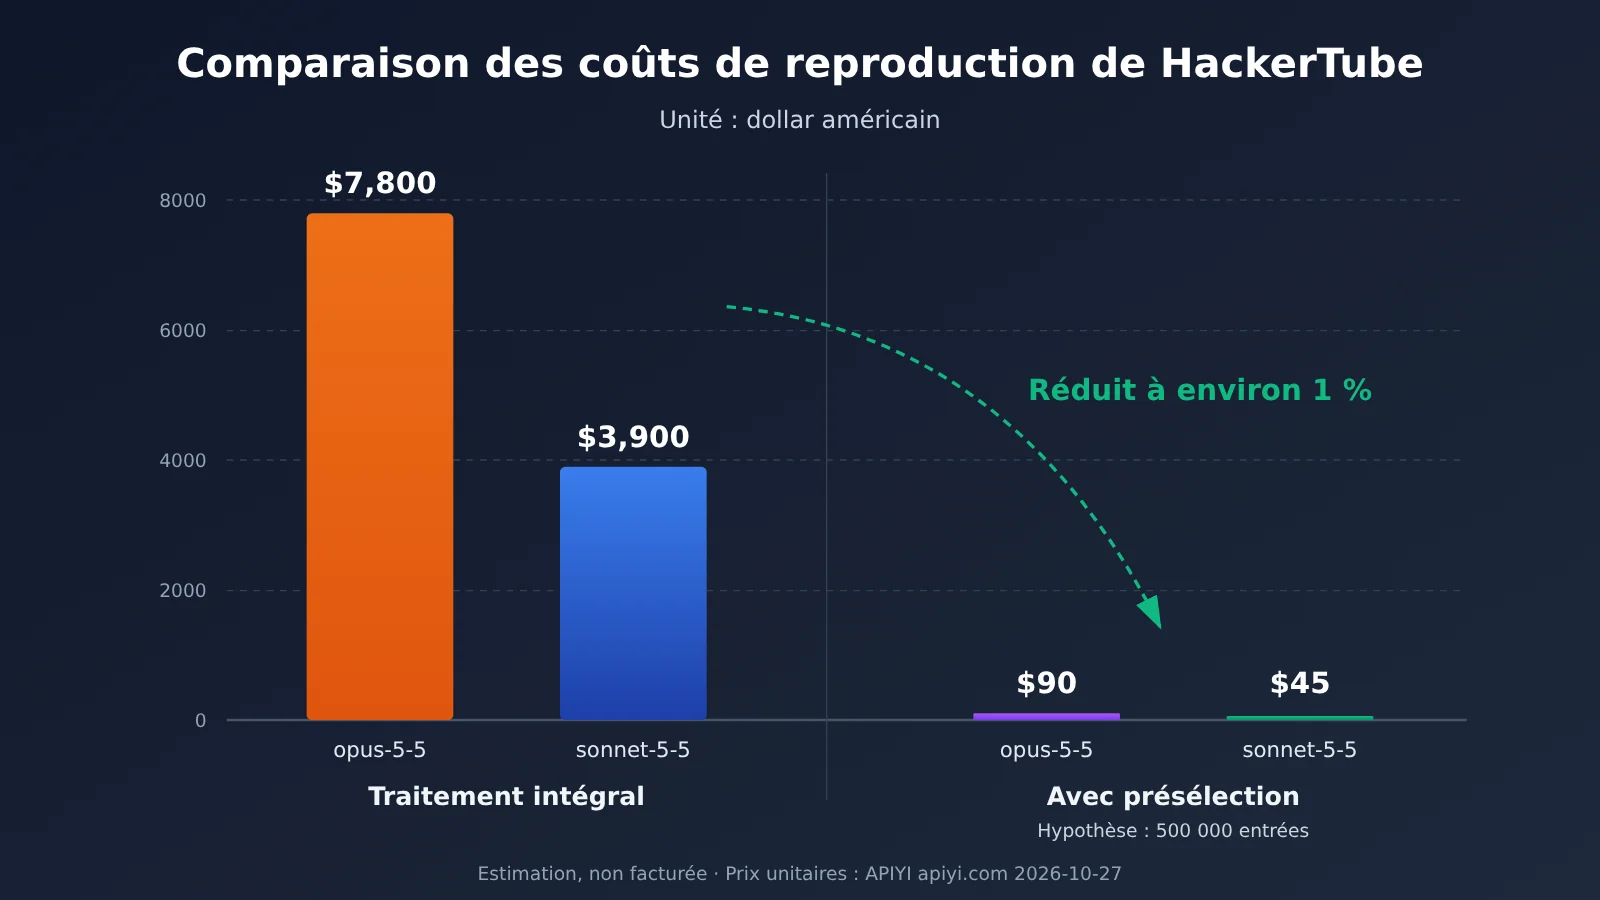
Les hypothèses de calcul sont les suivantes : 43 millions de commentaires, à raison de 30 tokens en moyenne par commentaire, soit environ 1,3 milliard de tokens au total ; 50 000 tokens en entrée et 5 000 en sortie par lot, soit environ 26 000 lots. Dans le scénario avec préfiltrage, les « 500 000 commentaires restants » sont une hypothèse choisie pour illustrer le calcul, et non une statistique réelle de HN. Vous ne connaîtrez le nombre réel qu’après avoir exécuté l’étape 3.
| Scénario | Tokens en entrée | Tokens en sortie | Estimation opus-5-5 | Estimation sonnet-5-5 |
|---|---|---|---|---|
| Traitement complet directement par le modèle | Environ 1,3 milliard | Environ 130 millions | Environ $5,200 + $2,600 ≈ $7,800 | Environ $2,600 + $1,300 ≈ $3,900 |
| Préfiltrage par règles (hypothèse : 500 000 commentaires restants) | Environ 15 millions | Environ 1,5 million | Environ $60 + $30 ≈ $90 | Environ $30 + $15 ≈ $45 |
Ce tableau montre que le préfiltrage par règles de l’étape 3 détermine l’ordre de grandeur du coût du projet. Par ailleurs, l’invite système et les exemples positifs et négatifs sont répétés à chaque requête. Le tarif de lecture du cache permet donc de réduire encore cette partie des frais. Un exemple partagé dans la communauté donne aussi un point de repère : l’utilisateur X @thisiskp_ affirme avoir créé une démo de site vidéo Show HN avec Opus 5.5 en environ 19 minutes, pour environ 2 dollars. Il ne s’agit toutefois que d’un cas isolé : l’échelle et le volume de données sont différents, donc la comparaison directe n’est pas possible.
💰 Conseil pour maîtriser les coûts : avant le traitement complet, testez le processus sur un mois de données, notez la consommation réelle de tokens, puis multipliez-la par le nombre de mois pour estimer le total. Sur APIYI apiyi.com, la facturation se fait à l’usage, sans abonnement mensuel fixe : c’est adapté à une approche où l’on teste d’abord un petit lot avant de décider de l’échelle.
Utiliser APIYI avec Claude Code pour le workflow HackerTube
L’essentiel : il suffit de définir deux variables d’environnement pour que Claude Code puisse appeler Opus 5.5 via APIYI. Une même clé permet de basculer entre opus-5-5 et sonnet-5-5.
[Emplacement pour une capture d’écran : documentation APIYI sur la connexion à Claude Code]
Selon la documentation APIYI pour Claude Code (docs.apiyi.com/scenarios/programming/claude-code), définissez ces deux variables dans le terminal :
ANTHROPIC_BASE_URL=https://api.apiyi.comANTHROPIC_AUTH_TOKEN=<你的 APIYI Key>
Lancez ensuite Claude Code et choisissez opus-5-5 ou sonnet-5-5 dans les options de modèle. En pratique, vous pouvez confier la planification au modèle le plus puissant et l’exécution au plus économique :
- Planification et rédaction du code avec opus-5-5 : demandez-lui de concevoir la stratégie de découpage en lots, d’écrire les scripts de collecte et de présélection, puis de générer l’interface. Cette étape consomme relativement peu de tokens, mais exige une grande qualité.
- Comparaison des deux modèles pour l’évaluation en masse : faites passer le même échantillon de quelques centaines d’éléments dans opus-5-5 et sonnet-5-5, puis comparez manuellement la précision de leurs évaluations. Vous pourrez ensuite choisir lequel utiliser pour les 26 000 lots ou pour les lots obtenus après présélection.
- Retour à opus-5-5 pour regrouper les thèmes : regrouper environ 150 thèmes demande une vision d’ensemble. Comme cette étape nécessite peu d’appels, le modèle le plus puissant est un choix plus sûr.
🎯 Conseil technique : après avoir créé une clé dans la console APIYI sur apiyi.com, définissez un plafond de dépenses propre à ce projet. Vous éviterez ainsi que les coûts dérapent si le script de traitement par lots effectue des appels en boucle. Le crédit de test gratuit offert aux nouveaux utilisateurs suffit pour traiter un mois de données d’échantillon.
À quels autres types de données appliquer la méthode HackerTube de Karpathy ?
En bref : cette méthode fonctionne dès lors que de nombreuses discussions communautaires contiennent des recommandations pour un type de ressource donné.
- Forums techniques de Reddit : repérez les livres, cours ou dépôts open source recommandés à plusieurs reprises. Le pipeline reste presque identique : il suffit de remplacer l’expression régulière qui filtre les liens.
- Issues et espaces de discussion GitHub : extrayez les liens vers des articles de blogue ou des solutions cités plusieurs fois pour créer une liste de lectures incontournables pour un projet.
- Messagerie interne ou commentaires de documents : les équipes de contenu peuvent retrouver les ressources que leurs collègues ont partagées à plusieurs reprises, à condition de vérifier qu’elles ont le droit d’utiliser ces données.
- Recommandations de balados et d’articles scientifiques : remplacez l’expression régulière par un format correspondant à arXiv ou aux plateformes de balados pour obtenir les articles ou les épisodes que la communauté recommande vraiment.
Pour adapter la méthode, deux éléments seulement doivent changer : les règles de présélection de l’étape 3 et les exemples positifs et négatifs dans l’invite de l’étape 4. Le pipeline de données, les appels par lots, la structure JSON et l’interface statique peuvent être réutilisés.
Questions fréquentes
Q1 : Peut-on créer un site comme HackerTube sans clé API YouTube ?
Oui, on peut en réaliser l’essentiel. Le videoId est extrait des liens dans les commentaires et la lecture se fait dans une iframe intégrée : ni l’un ni l’autre ne dépend d’une clé API. Ce qui manque, ce sont les métadonnées comme le titre et la chaîne. On peut d’abord demander au modèle de générer des descriptions à partir du contexte des commentaires HN, puis ajouter une clé plus tard.
Q2 : Comment récupérer les commentaires de Hacker News ?
Il existe deux possibilités : l’API Firebase officielle de HN (github.com/HackerNews/API) permet de récupérer les éléments par leur item ID et convient aux mises à jour incrémentales ; le jeu de données public HN sur BigQuery convient à un export complet en une seule fois. Pour reproduire l’ensemble du projet, mieux vaut privilégier la deuxième option.
Q3 : Pourquoi ne pas créer directement un algorithme de recommandation ?
Le point de départ du message original de Karpathy était justement son insatisfaction face aux recommandations de YouTube. HackerTube s’appuie sur 20 ans de jugement collectif de la communauté : il n’a pas besoin de données sur le comportement des utilisateurs, ne rencontre pas de problème de démarrage à froid et peut être réalisé en deux heures. Un algorithme de recommandation, lui, nécessite une accumulation de données à long terme et des ajustements continus.
Q4 : Les « 2 heures » correspondent-elles à un processus entièrement automatisé ?
Non. D’après les témoignages relayés par la communauté, Karpathy a demandé lui-même une clé API YouTube, préparé un serveur et acheté un nom de domaine. Le reste a été réalisé en échangeant avec Claude. L’humain reste responsable de définir les besoins, de valider le résultat et de gérer les étapes qui nécessitent un compte. Pour reproduire le projet, il faut aussi prévoir du temps pour ajuster les invites et vérifier manuellement un échantillon des résultats.
Q5 : Le coût de cette méthode risque-t-il de devenir incontrôlable ?
Si vous sautez la présélection et transmettez toutes les données directement au modèle, le coût estimé peut atteindre plusieurs milliers de dollars. Il peut donc effectivement déraper. Pour le maîtriser, trois mesures : commencez par une présélection fondée sur des règles, testez d’abord un échantillon d’un mois pour estimer les coûts, puis définissez un plafond pour votre clé sur APIYI apiyi.com. Consultez la liste des modèles de la plateforme pour connaître les modèles et leurs tarifs.
Résumé
Avec HackerTube, Karpathy a montré qu’une personne peut, en un week-end, transformer des discussions communautaires comptant des dizaines de millions de messages en un produit fonctionnel, grâce à Claude Code et Opus 5.5. Mais ce qui fait vraiment la différence, c’est la conception du pipeline de données, pas une « IA qui écrit automatiquement un site ».
- Processus : préparation des ressources → récupération des données → présélection par règles → évaluation par le modèle → agrégation et étiquetage → déploiement. Les rôles sont clairement répartis entre la personne, le programme et le modèle.
- Difficultés : découpage du contexte, interprétation du contexte des recommandations, normalisation des videoId et quotas d’API.
- Coût : le traitement complet se chiffre en milliers de dollars. Après présélection, il peut descendre de quelques dizaines à quelques centaines de dollars. Dans les deux cas, fiez-vous aux résultats obtenus sur votre propre échantillon.
- Pour commencer : deux variables d’environnement suffisent pour que Claude Code utilise APIYI afin d’invoquer opus-5-5 et sonnet-5-5.
Si vous voulez appliquer cette méthode à vos propres données, commencez par un petit échantillon d’un mois. Utilisez le crédit gratuit d’APIYI sur apiyi.com pour tester tout le processus, puis décidez de l’échelle à adopter.
Références
- Publication originale de Karpathy (2026-11-01) : annonce de HackerTube
- Lien :
x.com/karpathy/status/2116957135661945283 -
Détails : source primaire sur le volume de données, le temps nécessaire et les modèles utilisés
-
Site HackerTube : produit final
- Lien :
hackertube.org -
Détails : permet de consulter les catégories thématiques et la présentation des pages
-
Documentation APIYI pour Claude Code : configuration des variables d’environnement
- Lien :
docs.apiyi.com/scenarios/programming/claude-code -
Détails : étapes de connexion de Claude Code
-
Grille tarifaire des modèles APIYI : prix unitaires des modèles
- Lien :
docs.apiyi.com/models -
Détails : référence pour les modèles et leurs prix
-
Documentation officielle de l’API Hacker News : récupération des données
- Lien :
github.com/HackerNews/API - Détails : structure des éléments et méthode de récupération