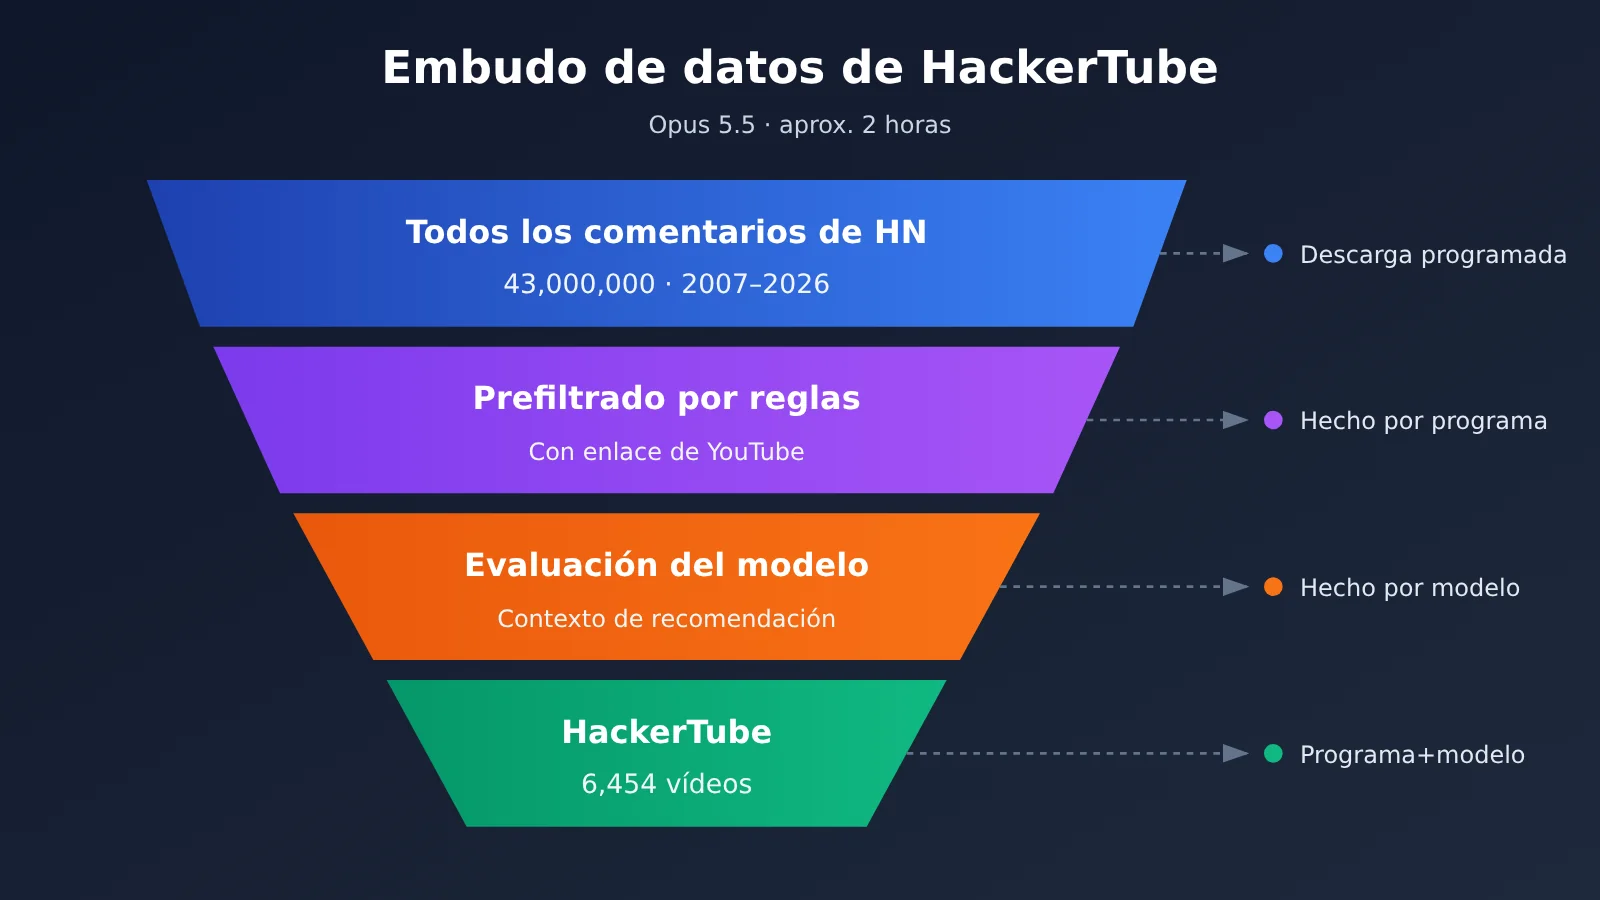
Andrej Karpathy dedicó unas dos horas de un fin de semana a crear HackerTube, un sitio de videos. Le pidió a Claude que buscara, entre unos 43 millones de comentarios publicados en Hacker News a lo largo de 20 años, los 6.454 videos de YouTube recomendados repetidamente. Casi todo el proceso consistió en conversar con Claude. En X, Karpathy lo resumió así (2026-11-01): «~2 hours with Opus 5.5» (unas 2 horas con Opus 5.5).
A partir de la publicación original de Karpathy, el sitio de HackerTube y los relatos públicos de la comunidad, desglosamos el proceso en 6 pasos que cualquier desarrollador puede seguir y señalamos los 3 puntos donde es más fácil quedarse atascado.
Valor principal: al terminar, tendrás un proceso de 6 pasos que explica qué corresponde a las personas, los programas y los modelos; una estimación de costos con sus supuestos; y la ruta más corta para conectar Claude Code mediante APIYI, apiyi.com.
¿Qué hizo exactamente Karpathy con HackerTube?
En una frase: recopiló 20 años de recomendaciones colectivas de la comunidad de HN —esas de «tienes que ver este video»— y las convirtió en un sitio de videos que se puede explorar.
Este es el texto completo que Karpathy publicó en X (2026-11-01 18:14 UTC):
«Proyecto de fin de semana: HackerTube. Estaba harto de las recomendaciones de YouTube, así que le pedí a Claude que filtrara 43 millones de comentarios de 20 años de HN hasta quedarse con 6,454 videos que se recomiendan una y otra vez. Una experiencia de visualización muchísimo mejor; unas 2 horas con Opus 5.5».
La descripción de la página de hackertube.org dice: «Los videos de YouTube que los usuarios de Hacker News no dejan de recomendarse entre sí». Como se ve, la clave no es un algoritmo de recomendación, sino el filtrado semántico de conversaciones que ya existen en la comunidad.
| Punto clave | Información pública | Naturaleza de la fuente |
|---|---|---|
| Volumen de datos | Unos 43 millones de comentarios de HN durante 20 años; se conservaron 6,454 videos | Publicación original de Karpathy (2026-11-01) |
| Tiempo y modelo | Unas 2 horas, con Opus 5.5 | Publicación original de Karpathy (2026-11-01) |
| Entorno de trabajo | Versión de escritorio de Claude Code | Según comentarios de la comunidad |
| Trabajo manual | Solo hizo tres cosas a mano: solicitar una clave API de YouTube, preparar el servidor y comprar el dominio | Según comentarios de la comunidad |
| Formato del sitio | Unos 150 temas, con contenido entre 2007 y 2026; no requiere iniciar sesión | Según recuentos de la comunidad |
Cómo funciona HackerTube: los puntos clave
Según comentarios de la comunidad, Karpathy dijo: «Solo hablo con Claude y dejo que haga todo». Es decir, Claude realizó en gran parte el trabajo dentro de Claude Code: descargar los datos, escribir los scripts de filtrado, invocar el modelo para que evaluara el contenido y generar las páginas. La persona se encargó principalmente de plantear los requisitos y gestionar los pasos que requerían una cuenta o un pago.
Esto no es lo mismo que «pedirle a la IA que escriba una plantilla web». La verdadera dificultad está en los datos: no se pueden meter 43 millones de comentarios de una sola vez en la ventana de contexto, y que aparezca un enlace no significa que sea una recomendación. Por eso, el proyecto se parece más a una canalización de datos con una interfaz muy ligera.
Proceso de 6 pasos para replicar HackerTube con Opus 5.5
La clave es dejar que primero el programa reduzca el volumen de datos y reservar para el modelo las decisiones que requieren comprensión. Los 6 pasos están ordenados según su ejecución e indican quién hace cada tarea y cómo comprobar el resultado.
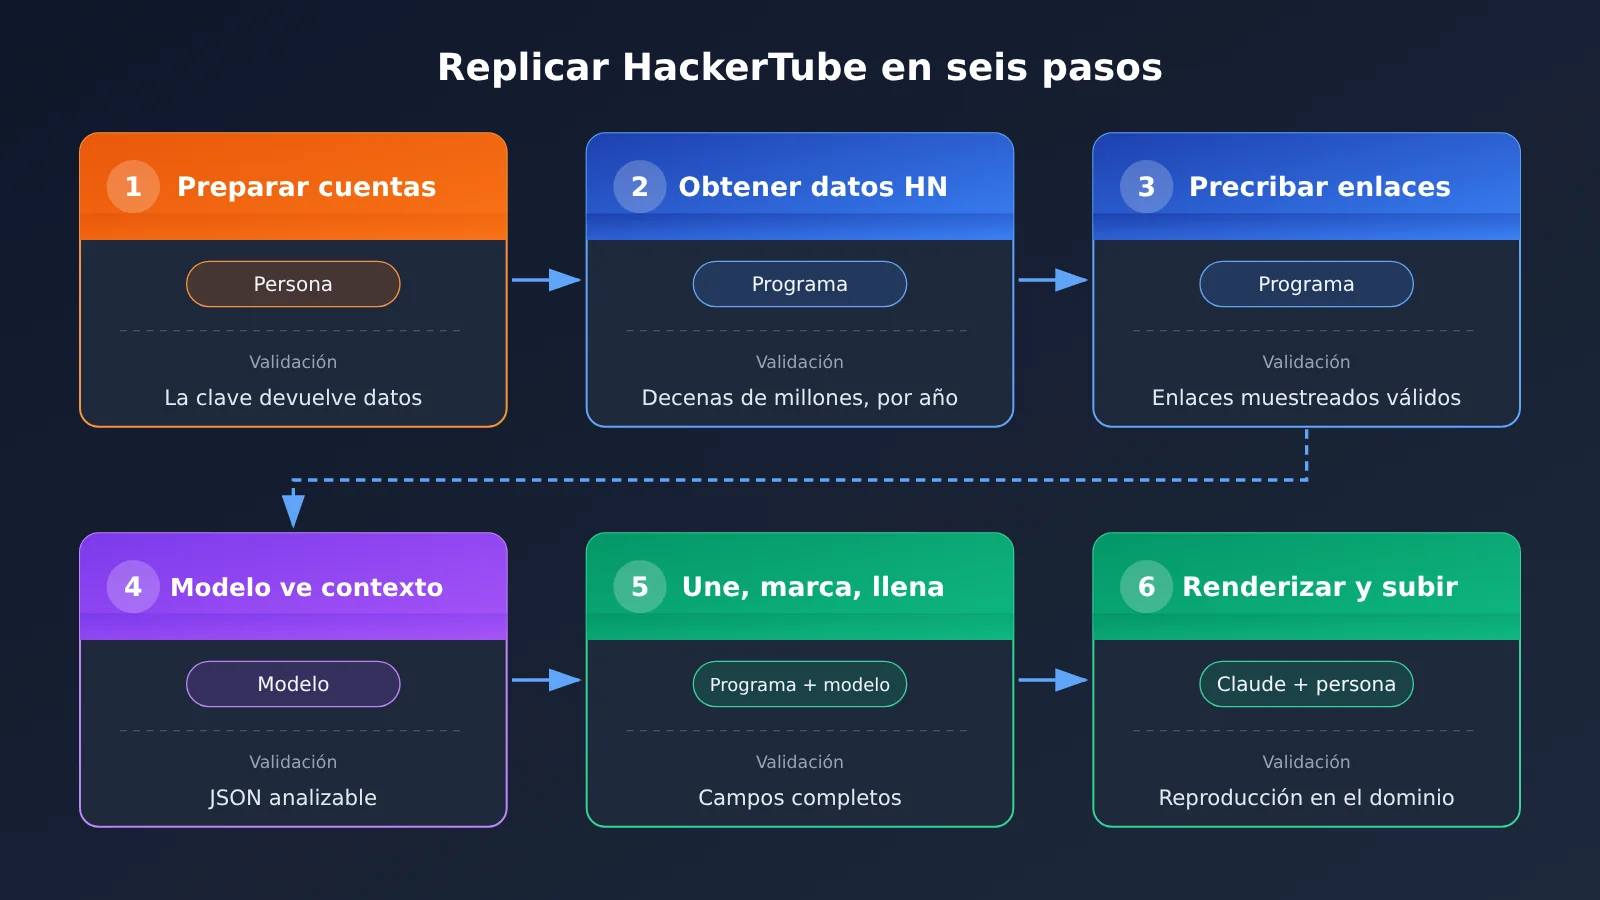
| Paso | Qué hacer | Quién lo hace | Cómo validar el resultado |
|---|---|---|---|
| 1 | Solicitar una clave API de YouTube, preparar un servidor y comprar un dominio | Persona | Se puede acceder a los tres y la clave devuelve información de un video |
| 2 | Obtener todos los comentarios de HN | Programa (escrito por Claude) | Hay archivos locales organizados por año y el número de comentarios coincide con el orden de magnitud esperado |
| 3 | Extraer con expresiones regulares los comentarios que contienen enlaces de YouTube | Programa | Revisar una muestra de 50 comentarios y confirmar que cada uno contiene un enlace válido a un video |
| 4 | Pedir al modelo que evalúe por lotes si el contexto es una recomendación y genere JSON | Modelo | El JSON se puede analizar directamente y una revisión manual de una muestra confirma que las decisiones son correctas |
| 5 | Agrupar y contar por videoId, añadir etiquetas temáticas y completar el título y el canal | Programa + modelo | Cada video tiene todos los campos y la cantidad de temas se mantiene en un rango manejable |
| 6 | Generar la interfaz y desplegarla | Claude escribe el código y una persona vincula el dominio | Al abrir el dominio en el navegador, se pueden explorar videos por tema y reproducirlos |
Pasos 1 y 2: preparar los recursos y obtener los datos de HN
El paso 1 lo realiza una persona. Crea un proyecto en la consola de Google Cloud, habilita YouTube Data API y genera una clave API. El servidor puede ser cualquier instancia en la nube o servicio de alojamiento estático; compra también un dominio para usarlo más adelante. Las tres cosas requieren una cuenta o un pago y, según los relatos de la comunidad, son la parte de la que se ocupó personalmente Karpathy.
Para el paso 2, Claude escribe el programa. Hay dos fuentes públicas de datos de HN: la API oficial de Firebase permite obtener los elementos uno por uno mediante su ID, y BigQuery cuenta con un conjunto de datos público de HN que se puede consultar directamente con SQL. Para una descarga completa, conviene priorizar BigQuery y exportar por año. Para comprobar el resultado, basta con revisar dos cosas: que los archivos estén divididos por fecha y que el total de registros sea del orden de decenas de millones.
Pasos 3 y 4: filtrado previo con reglas y evaluación semántica con Opus 5.5
El paso 3 es clave para ahorrar y se deja por completo en manos de un programa. Usa expresiones regulares para detectar formatos de enlace como youtube.com/watch y youtu.be/, y conserva solo los comentarios que contengan enlaces a videos. Incluye también el ID del comentario, la fecha y el título de la publicación a la que pertenece como contexto. Basta con describir lo que necesitas en Claude Code, por ejemplo: «Escribe un script que extraiga los comentarios con enlaces de YouTube y los guarde en JSONL».
En el paso 4 le toca evaluar al modelo. Entrega a Opus 5.5 lotes de varios miles de comentarios y pídele que devuelva solo resultados estructurados, con campos como videoId, si lo recomiendan, tema y un extracto representativo del comentario. La indicación debe aclarar que «este video es malísimo» o «no veas esto» no son recomendaciones; solo cuentan las expresiones que indican que «vale la pena verlo». Para comprobar el resultado, selecciona una muestra aleatoria y revísala manualmente para determinar si la tasa de error es aceptable.
Pasos 5 y 6: agregación, etiquetado y despliegue del frontend
En el paso 5, primero se aplican reglas y después se usa el modelo. El programa cuenta cuántas veces se ha recomendado cada videoId y luego consulta la API de datos de YouTube para obtener el título y el canal. El modelo se encarga de agrupar las etiquetas temáticas, para evitar que queden demasiado dispersas, como «aprendizaje automático», «ML» e «introducción al aprendizaje profundo». Según estadísticas de la comunidad, HackerTube terminó con unos 150 temas, una cifra que puede servir como referencia para definir el nivel de detalle.
En el paso 6, se separan los datos de la página. El resultado es un archivo de datos JSON y un frontend estático que lo lee. Los videos se insertan mediante iframes de YouTube y se ordenan por tema y popularidad. Cuando se actualizan los datos, solo hay que volver a generar el JSON; no es necesario modificar el código de la página. Puedes desplegarlo en un servicio de alojamiento estático o en tu propio servidor y, por último, configurar manualmente el dominio para que apunte allí.
🚀 Inicio rápido: los pasos 4 y 5 requieren invocar el modelo con frecuencia. Al conectar Claude Code a través de APIYI apiyi.com, puedes usar la misma clave para alternar entre Opus y Sonnet. Prueba primero el flujo con un pequeño lote de datos y después decide qué modelo usar para el procesamiento completo.
Tres obstáculos que realmente pueden frenarte al replicar HackerTube
La conclusión primero: los problemas están casi todos en los datos, no en la creación de la página web. Estos son los tres obstáculos, en el orden en que suelen aparecer.
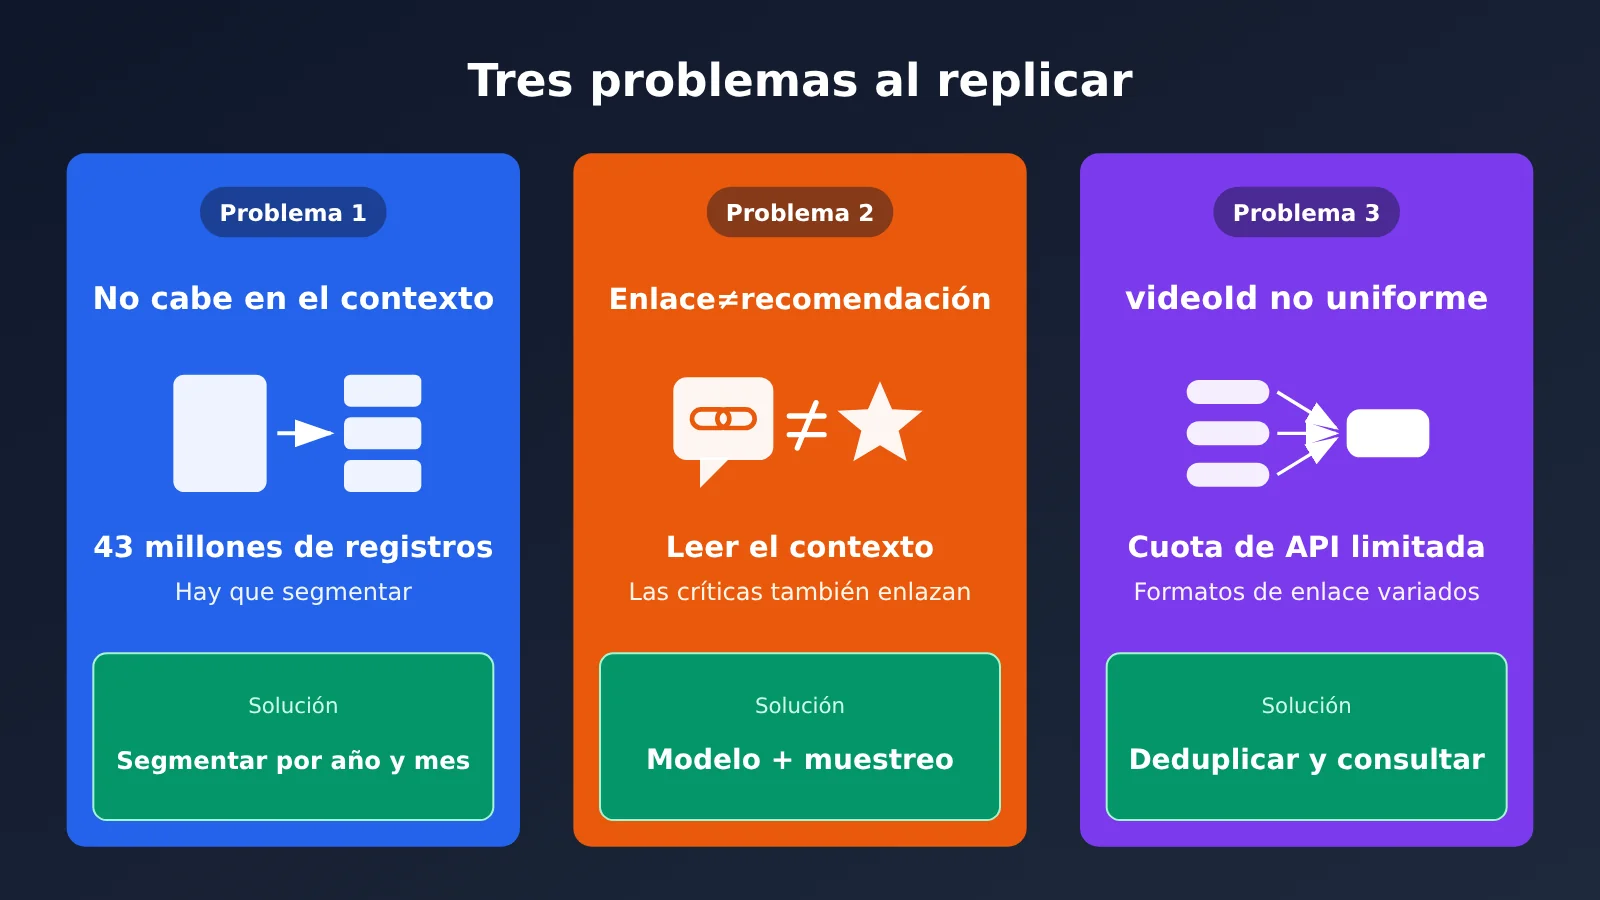
| Obstáculo | Cómo se manifiesta | Solución |
|---|---|---|
| No cabe en el contexto | Se le pide al modelo que «lea todos los comentarios» y devuelve un error por exceso de longitud o una respuesta truncada | Dividir por año o mes, procesar miles de comentarios por lote y devolver solo JSON estructurado |
| Enlace ≠ recomendación | Los enlaces en quejas, comentarios sarcásticos o correcciones se interpretan como recomendaciones | Pedir al modelo que lea el contexto del comentario y revisar manualmente una muestra |
| ID inconsistentes y cuota | Distintos formatos de enlace para un mismo video, videos eliminados y agotamiento de la cuota de API | Normalizar primero el videoId y luego agregar los resultados; consultar metadatos solo para los ID sin duplicados |
Obstáculo 1: Los 43 millones de comentarios no caben en la ventana de contexto de Opus 5.5
Un error habitual al empezar es plantear la tarea directamente así: «Lee todos los comentarios de HN y encuentra los videos recomendados». Por grande que sea la ventana de contexto del modelo, es imposible incluir de una sola vez un texto de más de mil millones de tokens. Lo adecuado es pedirle primero a Claude que escriba un script para dividir los comentarios por año o por mes, con unos miles por lote, y exigirle al modelo que devuelva solo JSON, sin explicaciones.
También conviene diseñar un mecanismo para reanudar el proceso: guardar por separado los resultados de cada lote y registrar cuáles ya se han procesado. Si ocurre un error a mitad de camino, solo tendrás que volver a ejecutar los lotes fallidos, sin empezar desde cero.
Obstáculo 2: Un enlace de YouTube no implica una recomendación
Un enlace de YouTube en un comentario de HN puede ser una recomendación, pero también un contraejemplo, una queja o una forma de decir «este video se equivoca». Si solo buscas coincidencias de URL, añadirás mucho ruido a los resultados. En esta etapa, el modelo debe leer el contexto: es el punto del proceso donde realmente hace falta un Modelo de Lenguaje Grande.
Conviene incluir ejemplos positivos y negativos en la indicación, y pedir un fragmento como evidencia para cada decisión. Así, al revisar una muestra manualmente, podrás entender rápidamente por qué el modelo hizo esa clasificación. Además, el frontend puede usar directamente ese fragmento como texto de «Qué dice HN» en la tarjeta del video.
Obstáculo 3: videoId inconsistentes y cuota de la API de YouTube
Un mismo video puede aparecer como youtube.com/watch?v=, youtu.be/, un enlace móvil o un enlace con parámetros de marca de tiempo, entre otras formas. Si no los normalizas primero a un videoId de 11 caracteres, el número de recomendaciones quedará repartido y la clasificación será incorrecta. Además, a lo largo de 20 años, muchos videos se han eliminado o configurado como privados, por lo que hay que marcarlos y filtrarlos por separado.
La API de datos de YouTube tiene una cuota diaria. Por eso, primero debes eliminar los duplicados y después consultar los metadatos por lotes, en lugar de hacer una consulta por cada comentario. La interfaz de consulta por lotes permite consultar varios ID a la vez y reduce considerablemente el consumo de la cuota.
¿Cuánto costaría replicar HackerTube? Una estimación
La conclusión: procesar todo con Opus 5.5 costaría miles de dólares; con un filtrado previo basado en reglas, el costo podría bajar a decenas o cientos de dólares. Todas las cifras son estimaciones, no facturas reales.
Primero, los precios unitarios. La siguiente tabla procede de la lista de precios de modelos de APIYI, con datos del 2026-10-27 a las 14:50 (UTC+8). Los importes están expresados en dólares por millón de tokens.
| Modelo | Entrada | Salida | Lectura de caché | Plataformas disponibles |
|---|---|---|---|---|
| opus-5-5 | $4 | $20 | $0.2 | APIYI apiyi.com, API oficial |
| sonnet-5-5 | $2 | $10 | $0.1 | APIYI apiyi.com, API oficial |
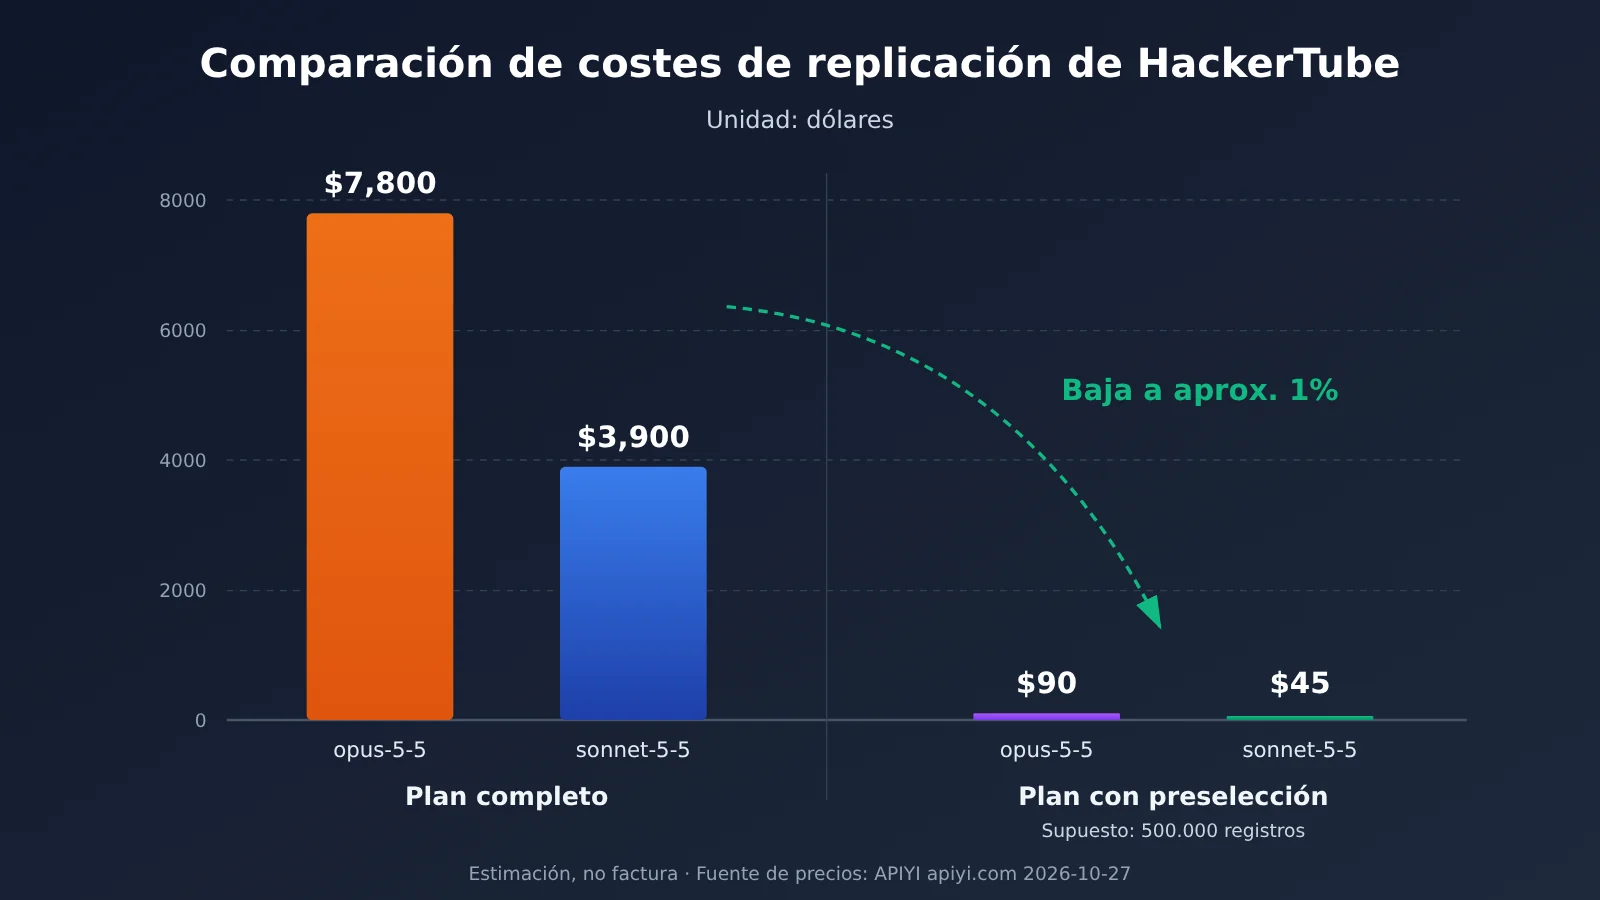
Supuestos de la estimación: 43 millones de comentarios, con un promedio de 30 tokens por comentario, para un total aproximado de 1.300 millones de tokens. Cada lote contiene 50.000 tokens de entrada y 5.000 de salida, con un total de unos 26.000 lotes. Los «500.000 comentarios restantes» del escenario con filtrado previo son solo una hipótesis para ilustrar el cálculo, no una estadística real de HN. Para conocer la cantidad real, tendrás que completar el paso 3.
| Estrategia | Tokens de entrada | Tokens de salida | Estimación con opus-5-5 | Estimación con sonnet-5-5 |
|---|---|---|---|---|
| Enviar todo directamente al modelo | Aproximadamente 1.300 millones | Aproximadamente 130 millones | Aproximadamente $5,200 + $2,600 ≈ $7,800 | Aproximadamente $2,600 + $1,300 ≈ $3,900 |
| Filtrar primero con reglas (suponiendo que quedan 500.000 comentarios) | Aproximadamente 15 millones | Aproximadamente 1,5 millones | Aproximadamente $60 + $30 ≈ $90 | Aproximadamente $30 + $15 ≈ $45 |
Como muestra la tabla, el filtrado previo con reglas del paso 3 determina el orden de magnitud del costo de todo el proyecto. Además, la indicación de sistema y los ejemplos positivos y negativos se repiten en cada solicitud, así que el precio de lectura de caché permite reducir aún más esa parte del gasto. También hay una referencia en la comunidad: el usuario de X @thisiskp_ afirma haber creado una demo de un sitio de videos de Show HN con Opus 5.5 en unos 19 minutos y por unos 2 dólares. Es solo un caso, con una escala y un volumen de datos diferentes, así que no se puede comparar directamente.
💰 Consejo para calcular el costo: antes de procesar todos los datos, prueba el flujo con los de un mes, registra el consumo real de tokens y multiplícalo por el número de meses para estimar el total. APIYI apiyi.com cobra por uso, sin cuota mensual fija, lo que viene bien para probar primero con un lote pequeño y decidir después la escala.
Ejecutar el flujo de HackerTube con Claude Code a través de APIYI
En resumen: solo necesitas configurar dos variables de entorno para que Claude Code invoque Opus 5.5 a través de APIYI. Con la misma clave puedes alternar entre opus-5-5 y sonnet-5-5.
[Espacio para captura: documentación de integración de Claude Code con APIYI]
Según la documentación de integración de Claude Code con APIYI (docs.apiyi.com/scenarios/programming/claude-code), configura estas dos variables en la terminal:
ANTHROPIC_BASE_URL=https://api.apiyi.comANTHROPIC_AUTH_TOKEN=<你的 APIYI Key>
Después, inicia Claude Code y selecciona opus-5-5 o sonnet-5-5 en las opciones de modelo. En la práctica, puedes usar un modelo más potente para planificar y uno más económico para ejecutar:
- Usa opus-5-5 para planificar y escribir código: pídele que diseñe la estrategia de fragmentación, escriba los scripts de extracción y prefiltrado, y genere el frontend. Esta fase consume relativamente pocos tokens, pero exige resultados de calidad.
- Compara ambos modelos para la evaluación por lotes: procesa la misma muestra de varios cientos de registros con opus-5-5 y sonnet-5-5, compara manualmente la precisión de sus evaluaciones y decide cuál usar para los 26.000 lotes o para los lotes que queden tras el prefiltrado.
- Vuelve a opus-5-5 para agrupar los temas: agrupar unos 150 temas requiere una visión global y pocas invocaciones, así que es más seguro usar el modelo más potente.
🎯 Consejo técnico: después de crear una clave en la consola de APIYI apiyi.com, puedes establecer un límite de gasto específico para este proyecto. Así evitarás que los costos se disparen si un script de procesamiento por lotes entra en un bucle de llamadas. El saldo gratuito de prueba para usuarios nuevos alcanza para procesar un mes de datos de muestra.
¿En qué otros datos se puede aplicar el método HackerTube de Karpathy?
En pocas palabras: la misma canalización sirve para cualquier conjunto de datos que contenga muchas conversaciones de comunidad con recomendaciones de algún tipo de recurso.
- Comunidades técnicas de Reddit: identifica libros, cursos o repositorios de código abierto recomendados repetidamente. La canalización es casi idéntica; solo hay que cambiar la expresión regular de los enlaces.
- Issues y debates de GitHub: extrae enlaces a artículos de blogs o soluciones citados varias veces y organízalos en una «lista de lecturas imprescindibles» para un proyecto.
- Mensajería interna o comentarios en documentos del equipo: los equipos de contenido pueden encontrar referencias que sus colegas han compartido repetidamente en conversaciones anteriores, siempre que hayan confirmado los permisos de uso de los datos.
- Recomendaciones de pódcast y artículos académicos: sustituye la expresión regular de los enlaces por el formato de arXiv o de plataformas de pódcast para obtener los «artículos o episodios que la comunidad realmente recomienda».
Al adaptar el método, solo hay que cambiar dos cosas: las reglas de filtrado previo del paso 3 y los ejemplos positivos y negativos de la indicación del paso 4. La canalización de datos, las invocaciones por lotes, la estructura JSON y el frontend estático se pueden reutilizar.
Preguntas frecuentes
Pregunta 1: ¿Se puede crear un sitio como HackerTube sin una clave API de YouTube?
Sí, se puede crear la parte principal. El videoId se extrae de los enlaces en los comentarios y la reproducción se integra mediante un iframe; ninguna de las dos cosas depende de una clave API. Lo que faltan son metadatos como el título y el canal. Puedes empezar usando el contexto de los comentarios de HN para que el modelo genere descripciones y añadir la clave más adelante.
Pregunta 2: ¿Cómo se obtienen los comentarios de Hacker News?
Hay dos opciones: la API oficial de Firebase de HN (github.com/HackerNews/API) permite recuperar datos por ID de elemento y es adecuada para actualizaciones incrementales; el conjunto de datos público de HN en BigQuery sirve para una exportación completa de una sola vez. Para replicar el proyecto completo, conviene priorizar la segunda opción.
Pregunta 3: ¿Por qué no crear directamente un algoritmo de recomendación?
El punto de partida de la publicación original de Karpathy era su insatisfacción con las recomendaciones de YouTube. HackerTube aprovecha 20 años de criterio colectivo de la comunidad: no necesita datos de comportamiento de usuarios, no tiene problemas de arranque en frío y se puede terminar en dos horas. Un algoritmo de recomendación, en cambio, requiere acumular datos a largo plazo y ajustarlo continuamente.
Pregunta 4: ¿Las «2 horas» incluyen un proceso totalmente automático?
No fue totalmente automático. Según comentaron miembros de la comunidad, Karpathy solicitó manualmente una clave API de YouTube, preparó un servidor y compró un dominio; el resto lo hizo conversando con Claude. La persona sigue encargándose de definir los requisitos, validar el resultado y gestionar los pasos que requieren una cuenta. Al replicarlo, también conviene reservar tiempo para ajustar las indicaciones y revisar manualmente una muestra de resultados.
Pregunta 5: ¿Pueden descontrolarse los costos de este método?
Si se omite el filtrado previo y se envían todos los datos directamente al modelo, el costo estimado podría alcanzar varios miles de dólares y, efectivamente, descontrolarse. Hay tres formas de evitarlo: aplicar primero un filtrado basado en reglas, procesar una muestra de un mes para calcular el costo y establecer un límite de gasto para la clave en APIYI apiyi.com. Consulta la lista de modelos de la plataforma para conocer los modelos y precios vigentes.
Resumen
HackerTube, de Karpathy, demuestra que una sola persona puede convertir decenas de millones de debates de una comunidad en un producto funcional durante un fin de semana con Claude Code y Opus 5.5. Pero la clave está en el diseño del pipeline de datos, no en que «la IA escriba el sitio web automáticamente».
- Proceso: preparación de recursos → extracción de datos → filtrado preliminar por reglas → evaluación del modelo → agregación y etiquetado → despliegue. Las tareas se reparten claramente entre personas, programas y modelos.
- Retos: segmentar el contexto, interpretar si hay una recomendación, normalizar los
videoIdy gestionar las cuotas de la API. - Costo: procesar todos los datos cuesta del orden de varios miles de dólares; con un filtrado preliminar, puede bajar a decenas o cientos. En ambos casos, conviene basarse en los resultados de una muestra propia.
- Primeros pasos: bastan dos variables de entorno para que Claude Code invoque opus-5-5 y sonnet-5-5 a través de APIYI.
Si quieres aplicar este método a tus propios datos, empieza con una muestra de un mes y usa el crédito gratuito de APIYI en apiyi.com para probar todo el proceso. Después podrás decidir a qué escala ejecutarlo.
Referencias
- Publicación original de Karpathy (2026-11-01): anuncio de HackerTube
- Enlace:
x.com/karpathy/status/2116957135661945283 -
Descripción: fuente directa sobre el volumen de datos, el tiempo empleado y los modelos utilizados
-
Sitio de HackerTube: producto final
- Enlace:
hackertube.org -
Descripción: permite consultar las categorías temáticas y el diseño de las páginas
-
Documentación de APIYI para conectar Claude Code: configuración de variables de entorno
- Enlace:
docs.apiyi.com/scenarios/programming/claude-code -
Descripción: pasos para conectar Claude Code
-
Lista completa de precios de modelos de APIYI: precio por modelo
- Enlace:
docs.apiyi.com/models -
Descripción: fuente de referencia para modelos y precios
-
Documentación oficial de la API de Hacker News: obtención de datos
- Enlace:
github.com/HackerNews/API - Descripción: estructura de los elementos y métodos de extracción