Andrej Karpathy 周末花了大约两小时做出一个视频站 HackerTube。他让 Claude 从 Hacker News 20 年、约 4300 万条评论里,筛出 6,454 个被反复推荐的 YouTube 视频,整个过程主要是在和 Claude 对话。Karpathy 在 X 上说的原话(2026-11-01)是:「~2 hours with Opus 5.5」。
下面的内容根据 Karpathy 原帖、HackerTube 站点和社区公开转述整理,把这件事拆成普通开发者可以照着做的 6 个步骤,并列出 3 个最容易卡住的地方。
核心价值:读完本文,你会得到一条写清楚「人、程序、模型」各自负责什么的 6 步流程,一份标明假设的成本估算,以及用 API易 apiyi.com 接入 Claude Code 的最短路径。
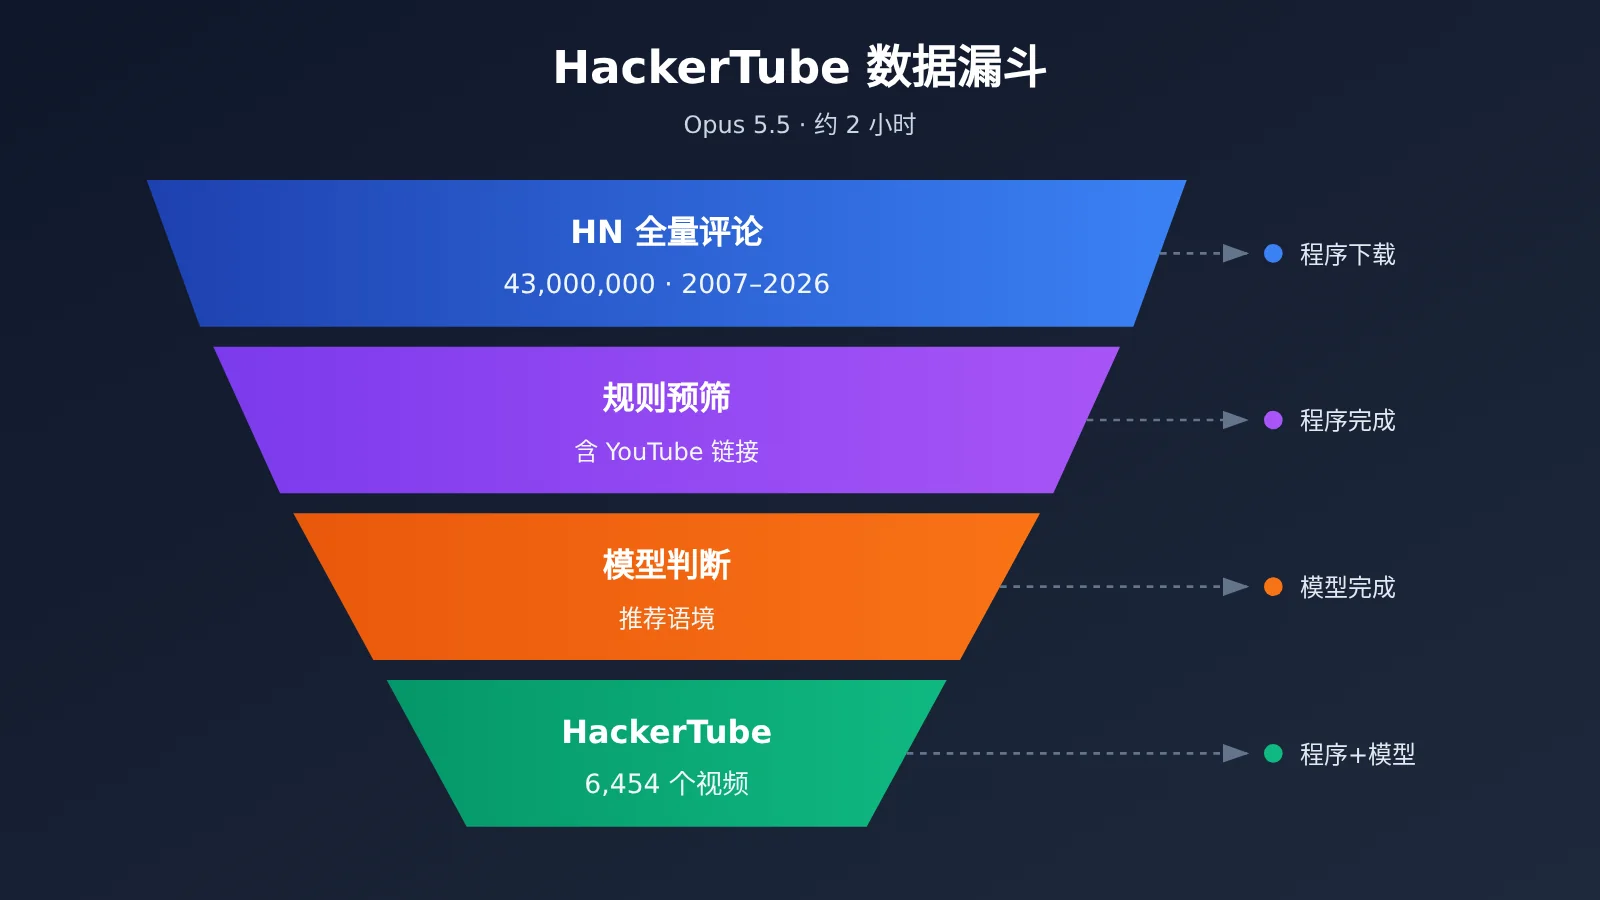
Karpathy 的 HackerTube 到底做了什么
一句话概括:他把 HN 社区 20 年里「你一定要看这个视频」的集体推荐,整理成了一个可以浏览的视频站。
Karpathy 在 X 上说的完整原文(2026-11-01 18:14 UTC)如下:
「Weekend hack: HackerTube. I was annoyed with YouTube’s recommendations so I had Claude filter down 43M comments over 20 years of HN to 6,454 videos that keep being recommended. Significantly better viewing experience, ~2 hours with Opus 5.5」
站点 hackertube.org 的页面描述是「The YouTube videos that Hacker News keeps telling each other to watch.」。可以看出,它的核心不是推荐算法,而是对已有社区讨论做语义筛选。
| 要点 | 公开信息 | 来源性质 |
|---|---|---|
| 数据规模 | HN 20 年约 4300 万条评论,最终保留 6,454 个视频 | Karpathy 原帖(2026-11-01) |
| 耗时与模型 | 约 2 小时,使用 Opus 5.5 | Karpathy 原帖(2026-11-01) |
| 工具环境 | Claude Code 桌面端 | 据社区转述 |
| 人工动作 | 只手动做三件事:申请 YouTube API key、准备服务器、买域名 | 据社区转述 |
| 站点形态 | 约 150 个主题,时间跨度 2007-2026,无需登录 | 据社区统计 |
HackerTube 工作方式重点详解
据社区转述,Karpathy 说过「I only talk to Claude and have it do everything」。也就是说,下载数据、写筛选脚本、调用模型做判断、生成页面这些工作,大部分由 Claude 在 Claude Code 里完成,人主要负责提需求和处理需要账号或付费的环节。
这和「AI 写一个网页模板」不是一回事。真正有难度的部分在数据:4300 万条评论不可能一次塞进上下文,「链接出现」也不等于「被推荐」。所以这个项目更像一条数据管道,加上一个很薄的前端。
Opus 5.5 复刻 HackerTube 的 6 步流程
结论先行:照做的关键是先让程序把数据量砍下来,再让模型只做必须靠理解完成的判断。下面 6 步按执行顺序排列,每一步都写明谁来做、做完怎么验收。
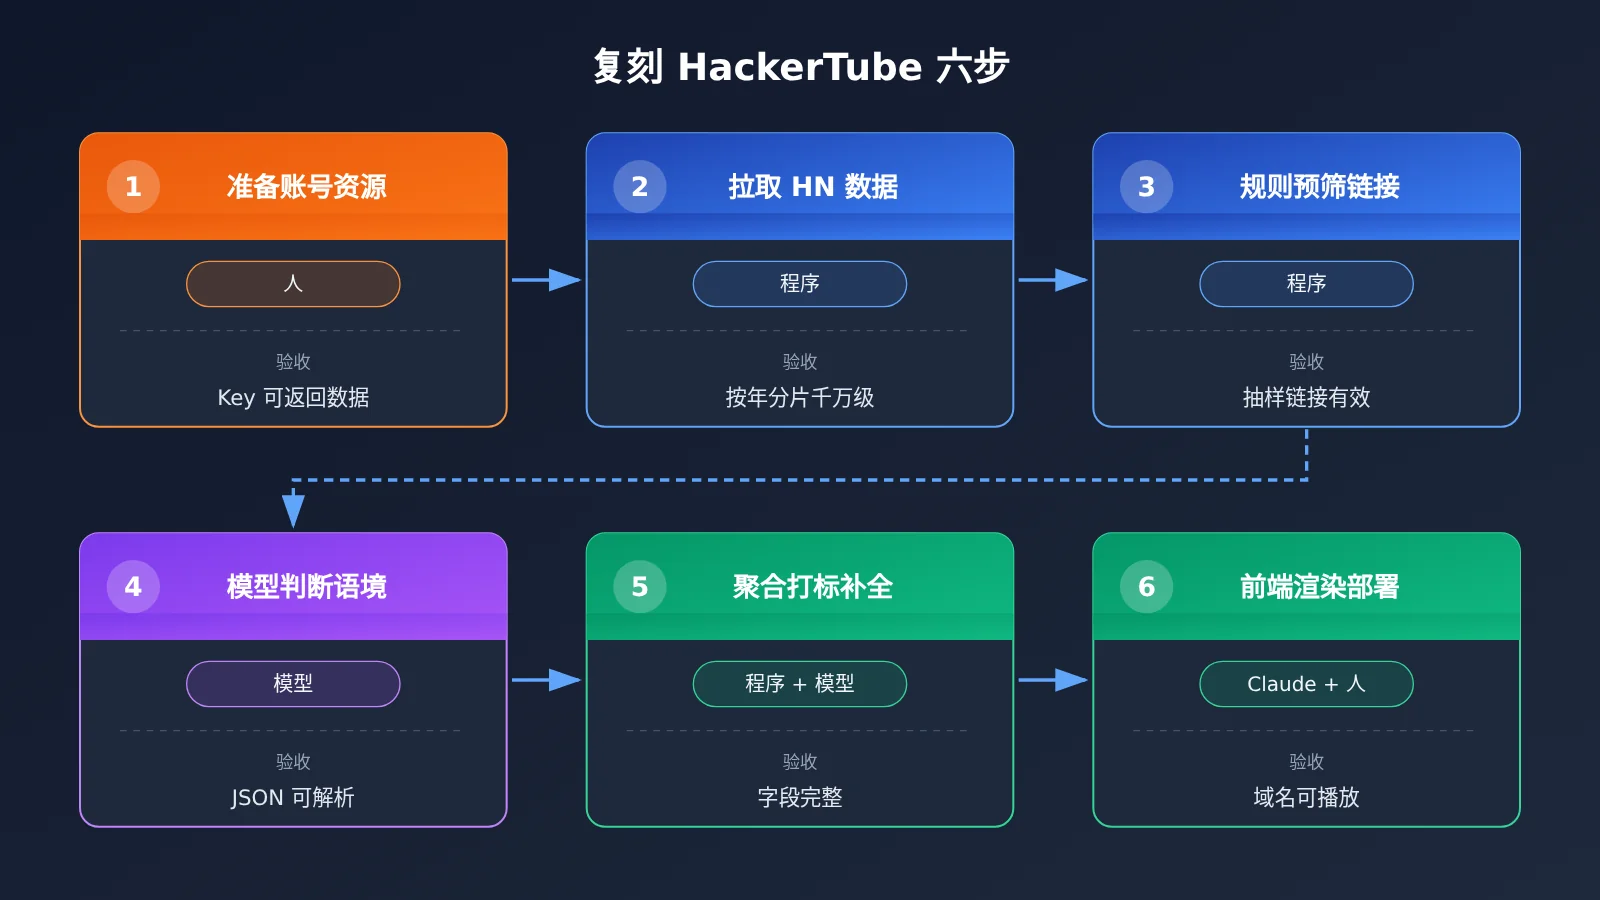
| 步骤 | 做什么 | 谁来做 | 做完怎么验收 |
|---|---|---|---|
| 1 | 申请 YouTube API key、准备服务器、买域名 | 人 | 三样东西都能登录,Key 能返回一条视频信息 |
| 2 | 拉取 HN 全量评论 | 程序(由 Claude 编写) | 本地有按年份分好的文件,条数与预期量级一致 |
| 3 | 正则抽取含 YouTube 链接的评论 | 程序 | 抽样 50 条,确认每条都含有效视频链接 |
| 4 | 分批让模型判断是否为推荐语境,输出 JSON | 模型 | JSON 能直接解析,抽样人工核对正误 |
| 5 | 按 videoId 聚合计数、打主题标签、补标题频道 | 程序 + 模型 | 每个视频都有完整字段,主题数量在可控范围 |
| 6 | 生成前端页面并部署 | Claude 写代码,人绑定域名 | 浏览器打开域名,能按主题浏览并播放视频 |
第 1-2 步:准备资源与拉取 HN 数据
第 1 步由人完成。 在 Google Cloud 控制台创建项目并启用 YouTube Data API,生成 API key;服务器可以是任意云主机或静态托管服务;域名在注册商购买后备用。这三件事都需要账号或付款,正是社区转述中 Karpathy 亲自处理的部分。
第 2 步由 Claude 编写程序完成。 HN 数据有两个公开来源:官方 Firebase API 可以按 item ID 逐条拉取,BigQuery 上也有 HN 公开数据集可以直接用 SQL 查询。全量下载建议优先考虑 BigQuery,按年份导出。验收时只看两点:文件按时间切好了,总条数在千万级。
第 3-4 步:规则预筛与 Opus 5.5 语义判断
第 3 步是省钱的关键,完全交给程序。 用正则匹配 youtube.com/watch、youtu.be/ 等链接格式,只保留含视频链接的评论,同时带上评论 ID、时间和父帖标题作为上下文。在 Claude Code 里直接描述需求即可,例如「写一个脚本,把含 YouTube 链接的评论抽出来存成 JSONL」。
第 4 步才轮到模型做判断。 每批交给 Opus 5.5 几千条评论,要求只输出结构化结果,字段包括 videoId、是否推荐、主题、代表性评论摘录。提示词里要写清楚:「这个视频很烂」「别看这个」属于不推荐,只有表达「值得看」的才算。验收方式是随机抽取一批结果人工核对,判断错误率是否可以接受。
第 5-6 步:聚合打标与前端部署
第 5 步先用规则,再用模型。 程序按 videoId 统计被推荐次数,然后调用 YouTube Data API 补齐标题和频道。主题标签交给模型统一归并,避免出现「机器学习」「ML」「深度学习入门」这类拆得过散的标签。据社区统计,HackerTube 最终约有 150 个主题,可以作为参考粒度。
第 6 步把数据和页面分开。 最终产物是一份 JSON 数据文件,加上一个读取它的静态前端;视频用 YouTube iframe 嵌入,按主题和热度排序。数据更新时只需要重新生成 JSON,页面代码不用动。部署可以放在静态托管服务或你的服务器上,最后由人把域名解析过去。
🚀 快速开始:第 4、5 步需要频繁调用模型。通过 API易 apiyi.com 接入 Claude Code 后,可以用同一个 Key 在 Opus 和 Sonnet 之间切换,先用小批量数据跑通流程,再决定正式跑数时用哪个模型。
复刻 HackerTube 时三个真会卡住的坑
结论先行:卡住的地方几乎都在数据侧,而不在写网页。下面三个坑按踩到的先后顺序排列。
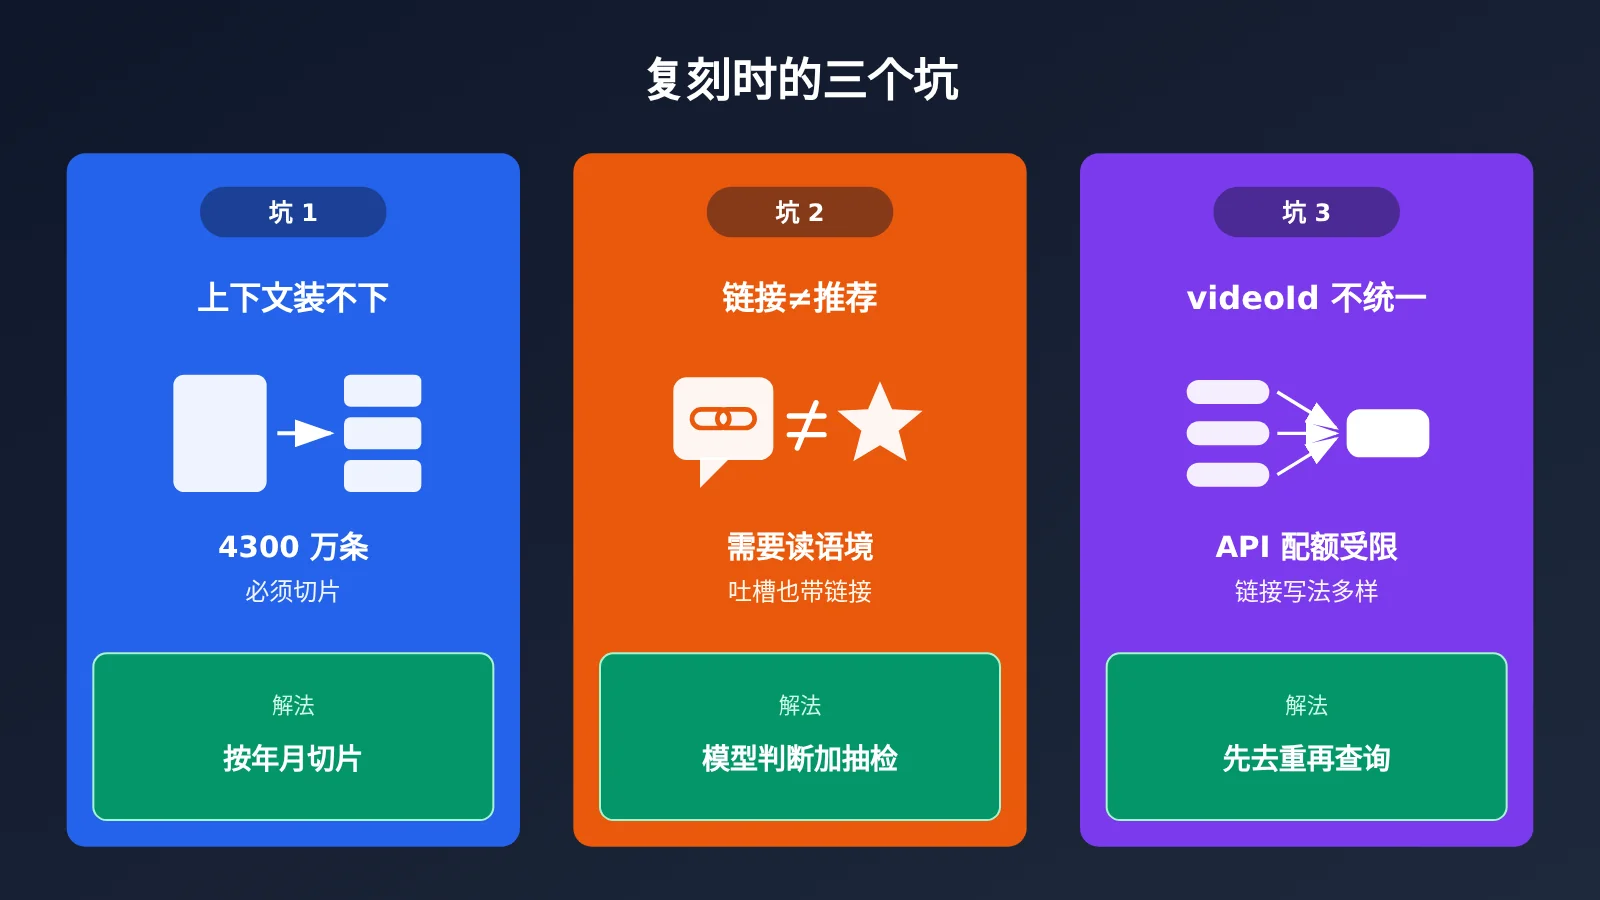
| 坑 | 典型表现 | 解法 |
|---|---|---|
| 上下文装不下 | 让模型「读完所有评论」,结果超长报错或输出被截断 | 按年月切片,每批数千条,只输出结构化 JSON |
| 链接≠推荐 | 吐槽、反讽、纠错里的链接被当成推荐 | 让模型读评论上下文判断,并人工抽检 |
| ID 混乱与配额 | 同一视频多种链接写法、已删除视频、API 额度耗尽 | 先统一 videoId 再聚合,元数据只查去重后的 ID |
坑 1:Opus 5.5 上下文装不下 4300 万条评论
新手最常见的错误是把需求直接写成「读完 HN 所有评论,找出被推荐的视频」。无论模型上下文多大,都不可能一次装下十几亿 tokens 的文本。正确做法是让 Claude 先写分片脚本,按年或按月切开,每批控制在几千条,并要求模型只返回 JSON,不写解释性文字。
还要设计断点续跑机制:每批结果单独落盘,并记录已处理的批次号。跑到一半出错时,只需要重跑失败的批次,不必从头开始。
坑 2:出现 YouTube 链接不等于被推荐
HN 评论里的 YouTube 链接可能是推荐,也可能是反例、吐槽,或者「这个视频讲错了」。只做 URL 匹配会把大量噪声带进结果。这一步必须交给模型阅读上下文,这也是整个流程中真正需要大模型参与的环节。
建议在提示词里给出正反例,并为每条判断附上一句依据摘录。这样人工抽检时可以快速判断模型为什么这样分类,前端也可以直接用这段摘录作为视频卡片上的「HN 怎么说」。
坑 3:videoId 不统一与 YouTube API 配额
同一个视频可能以 youtube.com/watch?v=、youtu.be/、移动端链接、带时间戳参数等多种形式出现。如果不先归一化成 11 位 videoId,推荐次数会被拆散,排序也会失真。另外,20 年间不少视频已经被删除或设为私享,需要单独标记并过滤。
YouTube Data API 有每日配额限制,应该先完成去重,再批量查询元数据,不要每条评论查一次。批量接口一次可以查询多个 ID,能大幅减少消耗。
HackerTube 复刻成本大概多少(估算)
结论先行:全量交给 Opus 5.5 处理是数千美元量级;先做规则预筛,可以降到几十到上百美元量级。 以下全部是估算,不是实际账单。
先看单价。下表来自 API易 型号价格表,数据时间为 2026-10-27 14:50(UTC+8),单位是美元 / 百万 tokens。
| 模型 | 输入 | 输出 | 缓存读 | 可用平台 |
|---|---|---|---|---|
| opus-5-5 | $4 | $20 | $0.2 | API易 apiyi.com、官方 API |
| sonnet-5-5 | $2 | $10 | $0.1 | API易 apiyi.com、官方 API |
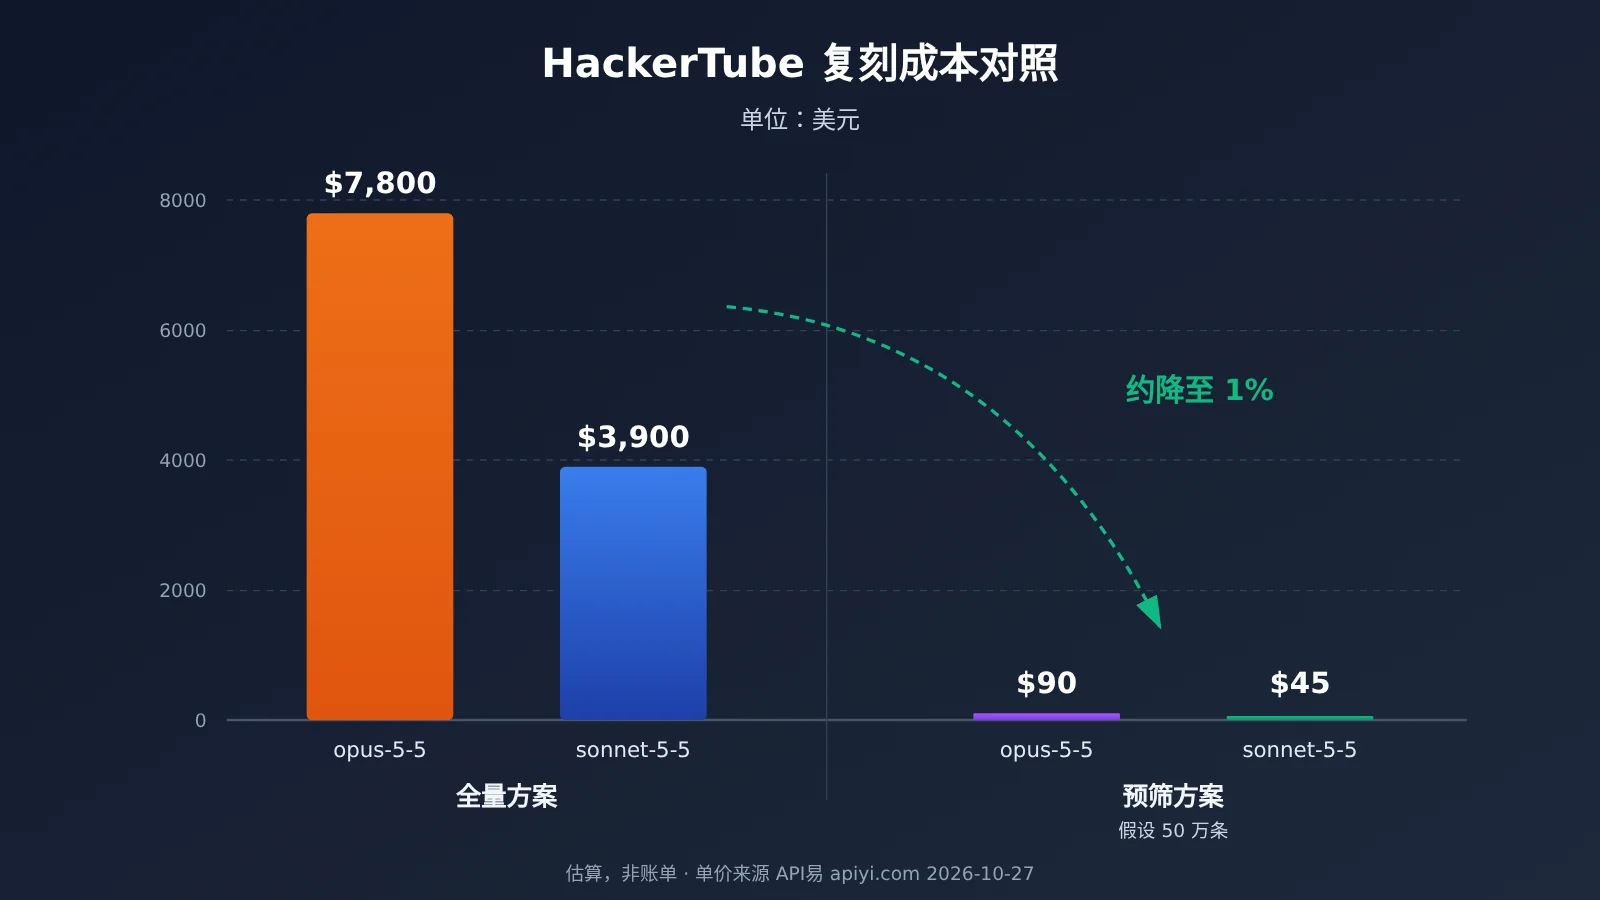
估算假设如下:4300 万条评论,平均每条 30 tokens,合计约 13 亿 tokens;每批输入 5 万 tokens、输出 5 千 tokens,共约 2.6 万批。预筛方案中的「剩余 50 万条」只是为了演示计算方法而设定的假设,不是 HN 的真实统计,实际条数需要你跑完第 3 步才能知道。
| 方案 | 输入 tokens | 输出 tokens | opus-5-5 估算 | sonnet-5-5 估算 |
|---|---|---|---|---|
| 全量直接交给模型 | 约 13 亿 | 约 1.3 亿 | 约 $5,200 + $2,600 ≈ $7,800 | 约 $2,600 + $1,300 ≈ $3,900 |
| 先规则预筛(假设剩 50 万条) | 约 1500 万 | 约 150 万 | 约 $60 + $30 ≈ $90 | 约 $30 + $15 ≈ $45 |
从这张表可以看出,第 3 步规则预筛决定了整个项目的成本量级。另外,每一批请求的系统提示词和正反例都是重复内容,配合缓存读取单价,这部分费用可以进一步压低。社区里也有一个参照:X 用户 @thisiskp_ 称用 Opus 5.5 约 19 分钟、约 2 美元做了一个 Show HN 视频站 demo。这只是单个案例,规模和数据量都不同,不能直接类比。
💰 成本建议:正式跑数之前,先用一个月的数据跑通流程,记下实际 token 消耗,再乘以月份数估算总量。在 API易 apiyi.com 按量计费,没有固定月费,适合这种「先试小批量,再决定规模」的用法。
用 API易 接 Claude Code 跑 HackerTube 流程
结论先行:只需要设置两个环境变量,Claude Code 就能通过 API易 调用 Opus 5.5,同一把 Key 可以在 opus-5-5 和 sonnet-5-5 之间切换。
[截图位:API易 Claude Code 接入文档]
按照 API易 Claude Code 接入文档(docs.apiyi.com/scenarios/programming/claude-code),在终端设置以下两项:
ANTHROPIC_BASE_URL=https://api.apiyi.comANTHROPIC_AUTH_TOKEN=<你的 API易 Key>
设置完成后启动 Claude Code,在模型选项中选择 opus-5-5 或 sonnet-5-5 即可。实际操作中,可以采用「强模型规划、经济模型执行」的分工:
- 规划与写代码阶段用 opus-5-5:让它设计分片方案、编写抓取与预筛脚本、生成前端,这部分 token 量不大,但对质量要求高。
- 批量判断阶段对比两个模型:用同一批几百条样本分别跑 opus-5-5 和 sonnet-5-5,人工比较判断准确率,再决定 2.6 万批或预筛后的批次用哪个。
- 主题归并阶段回到 opus-5-5:150 个左右的主题归并需要全局视角,调用次数少,用强模型更稳妥。
🎯 技术建议:在 API易 apiyi.com 控制台创建 Key 后,可以为这个项目单独设置额度上限,避免批处理脚本出现循环调用时费用失控。新用户的免费测试额度足够把一个月的样本数据跑一遍。
Karpathy 这套 HackerTube 方法还能用在哪些数据上
结论先行:只要数据满足「大量社区讨论里夹杂着对某类资源的推荐」,就可以套用同一条管道。
- Reddit 技术版块:筛选被反复推荐的书、课程或开源仓库,管道结构几乎相同,只需替换链接正则。
- GitHub Issues 与讨论区:提取被多次引用的博客文章或解决方案链接,整理成某个项目的「必读清单」。
- 团队内部 IM 或文档评论:内容团队可以从历史讨论中找出被同事反复转发的参考资料,前提是确认数据使用权限。
- 播客与论文推荐:把链接正则换成 arXiv 或播客平台格式,就能得到「社区真正推荐的论文 / 节目」。
迁移时只有两处需要调整:第 3 步的预筛规则和第 4 步提示词里的正反例。数据管道、分批调用、JSON 结构和静态前端都可以复用。
常见问题 FAQ
Q1:没有 YouTube API key 能不能做 HackerTube 这类站?
可以做出主体。videoId 从评论链接中提取,播放用 iframe 嵌入,都不依赖 API key;缺少的是标题、频道等元数据。可以先用 HN 评论中的上下文让模型生成描述,之后再补上 Key。
Q2:Hacker News 的评论数据怎么拿?
有两个途径:HN 官方 Firebase API(github.com/HackerNews/API)可以按 item ID 拉取,适合增量更新;BigQuery 上的 HN 公开数据集适合一次性全量导出。全量复刻建议优先使用后者。
Q3:为什么不直接做一个推荐算法?
Karpathy 原帖的出发点就是对 YouTube 推荐不满意。HackerTube 用的是 20 年社区集体判断,不需要用户行为数据,也没有冷启动问题,两小时内就能做完;推荐算法则需要长期积累和持续调优。
Q4:「2 小时」是全自动完成的吗?
不是全自动。据社区转述,Karpathy 手动申请了 YouTube API key、准备了服务器、买了域名,其余工作通过和 Claude 对话完成。人仍然负责提需求、做验收和处理需要账号的环节。普通人复刻时还要预留调提示词和人工抽检的时间。
Q5:这套方法成本会不会失控?
如果跳过预筛直接把全量数据交给模型,估算会达到数千美元,确实可能失控。控制方法有三个:先做规则预筛,先跑一个月的样本测算,再在 API易 apiyi.com 为 Key 设置额度上限。型号与价格以平台型号列表为准。
总结
Karpathy 的 HackerTube 证明了一件事:在 Claude Code 加 Opus 5.5 的组合下,一个人周末就能把千万级的社区讨论变成一个可用的产品。不过,真正起作用的是数据管道的设计,而不是「AI 自动写网站」。
- 流程:资源准备 → 拉数据 → 规则预筛 → 模型判断 → 聚合打标 → 部署,人、程序、模型分工明确。
- 难点:上下文切片、推荐语境判断、videoId 归一与 API 配额。
- 成本:全量是数千美元量级,预筛后可降到几十到上百美元量级,都需要以自己跑出的小样本数据为准。
- 上手:两个环境变量即可让 Claude Code 通过 API易 调用 opus-5-5 与 sonnet-5-5。
如果你想把这套方法用到自己的数据上,建议先从一个月的小样本开始,通过 API易 apiyi.com 用免费额度跑通全流程,再决定正式规模。
参考资料
- Karpathy 原帖(2026-11-01):HackerTube 发布说明
- 链接:
x.com/karpathy/status/2116957135661945283 -
说明: 数据规模、耗时和模型信息的一手来源
-
HackerTube 站点:项目成品
- 链接:
hackertube.org -
说明: 可以查看主题分类和页面形态
-
API易 Claude Code 接入文档:环境变量配置
- 链接:
docs.apiyi.com/scenarios/programming/claude-code -
说明: Claude Code 接入步骤
-
API易 型号价格总表:模型单价
- 链接:
docs.apiyi.com/models -
说明: 型号与价格以此为准
-
Hacker News 官方 API 说明:数据获取
- 链接:
github.com/HackerNews/API - 说明: item 结构与拉取方式