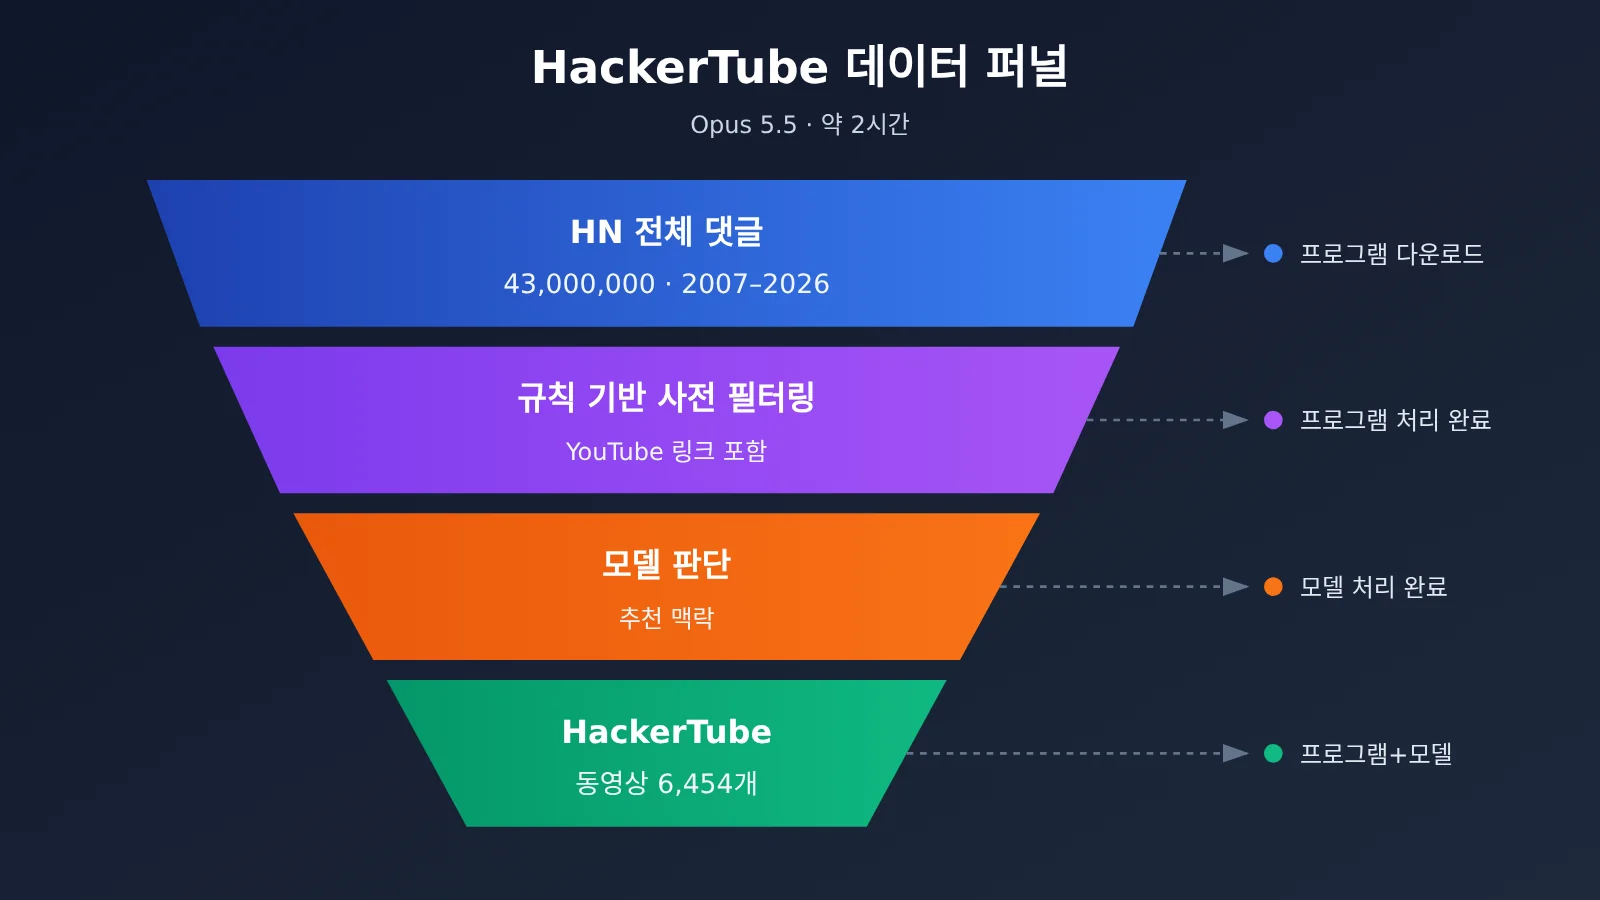
Andrej Karpathy가 주말에 약 두 시간을 들여 영상 사이트 HackerTube를 만들었어요. Claude를 활용해 20년간 쌓인 Hacker News 댓글 약 4,300만 개에서 반복적으로 추천된 YouTube 영상 6,454개를 골라냈죠. 작업의 대부분은 Claude와 대화하는 방식으로 진행됐어요. Karpathy가 X에 올린 글(2026-11-01)의 원문은 이렇습니다. 「~2 hours with Opus 5.5」
이 글은 Karpathy의 원글, HackerTube 사이트, 커뮤니티에 공개된 내용을 바탕으로 작업 과정을 정리했어요. 일반 개발자도 따라 할 수 있도록 6단계로 나누고, 가장 막히기 쉬운 지점 3가지도 짚어볼게요.
핵심 내용: 이 글에서는 ‘사람, 프로그램, 모델’의 역할을 구분한 6단계 작업 흐름과 전제를 명시한 비용 추정, APIYI apiyi.com으로 Claude Code에 연결하는 가장 간단한 방법을 살펴봅니다.
Karpathy의 HackerTube는 무엇을 만들었을까요?
한마디로, HN 커뮤니티에서 20년 동안 “이 영상은 꼭 봐야 해요”라며 추천한 영상들을 모아 둘러볼 수 있는 사이트로 만든 거예요.
Karpathy가 X에 올린 글의 전문(2026-11-01 18:14 UTC)은 다음과 같아요.
「Weekend hack: HackerTube. I was annoyed with YouTube’s recommendations so I had Claude filter down 43M comments over 20 years of HN to 6,454 videos that keep being recommended. Significantly better viewing experience, ~2 hours with Opus 5.5」
hackertube.org의 페이지 설명은 “Hacker News 이용자들이 서로에게 계속 추천하는 YouTube 영상”이에요. 핵심은 추천 알고리즘이 아니라 기존 커뮤니티 토론을 의미에 따라 선별하는 데 있어요.
| 항목 | 공개된 정보 | 출처 성격 |
|---|---|---|
| 데이터 규모 | HN의 20년간 댓글 약 4,300만 개 중 영상 6,454개를 최종 선별 | Karpathy의 원문 게시글(2026-11-01) |
| 소요 시간과 모델 | 약 2시간, Opus 5.5 사용 | Karpathy의 원문 게시글(2026-11-01) |
| 도구 환경 | Claude Code 데스크톱 앱 | 커뮤니티 전언 |
| 사람이 한 작업 | YouTube API 키 발급, 서버 준비, 도메인 구매 등 세 가지만 직접 처리 | 커뮤니티 전언 |
| 사이트 구성 | 약 150개 주제, 2007~2026년을 다루며 로그인 불필요 | 커뮤니티 집계 |
HackerTube의 작동 방식 살펴보기
커뮤니티 전언에 따르면 Karpathy는 “나는 Claude와 대화만 하고 모든 일을 Claude에게 맡긴다”고 말했어요. 데이터 다운로드, 선별 스크립트 작성, 모델을 호출해 판단하기, 페이지 생성 등의 작업을 대부분 Claude Code에서 Claude가 처리했다는 뜻이에요. 사람은 주로 요구사항을 전달하고 계정이나 결제가 필요한 부분을 맡았고요.
이는 “AI가 웹페이지 템플릿을 하나 작성했다”는 것과는 달라요. 진짜 어려운 부분은 데이터에 있어요. 댓글 4,300만 개를 한 번에 컨텍스트에 넣을 수도 없고, 링크가 등장했다고 해서 추천받은 영상이라고 볼 수도 없죠. 그래서 이 프로젝트는 얇은 프런트엔드를 덧붙인 데이터 파이프라인에 더 가까워요.
Opus 5.5로 HackerTube를 재현하는 6단계
먼저 결론부터 말하면, 핵심은 프로그램으로 데이터 양을 먼저 줄이고, 이해가 필요한 판단만 모델에 맡기는 것이에요. 아래 6단계는 실행 순서대로 정리했으며, 각 단계의 담당자와 완료 기준을 함께 적었어요.
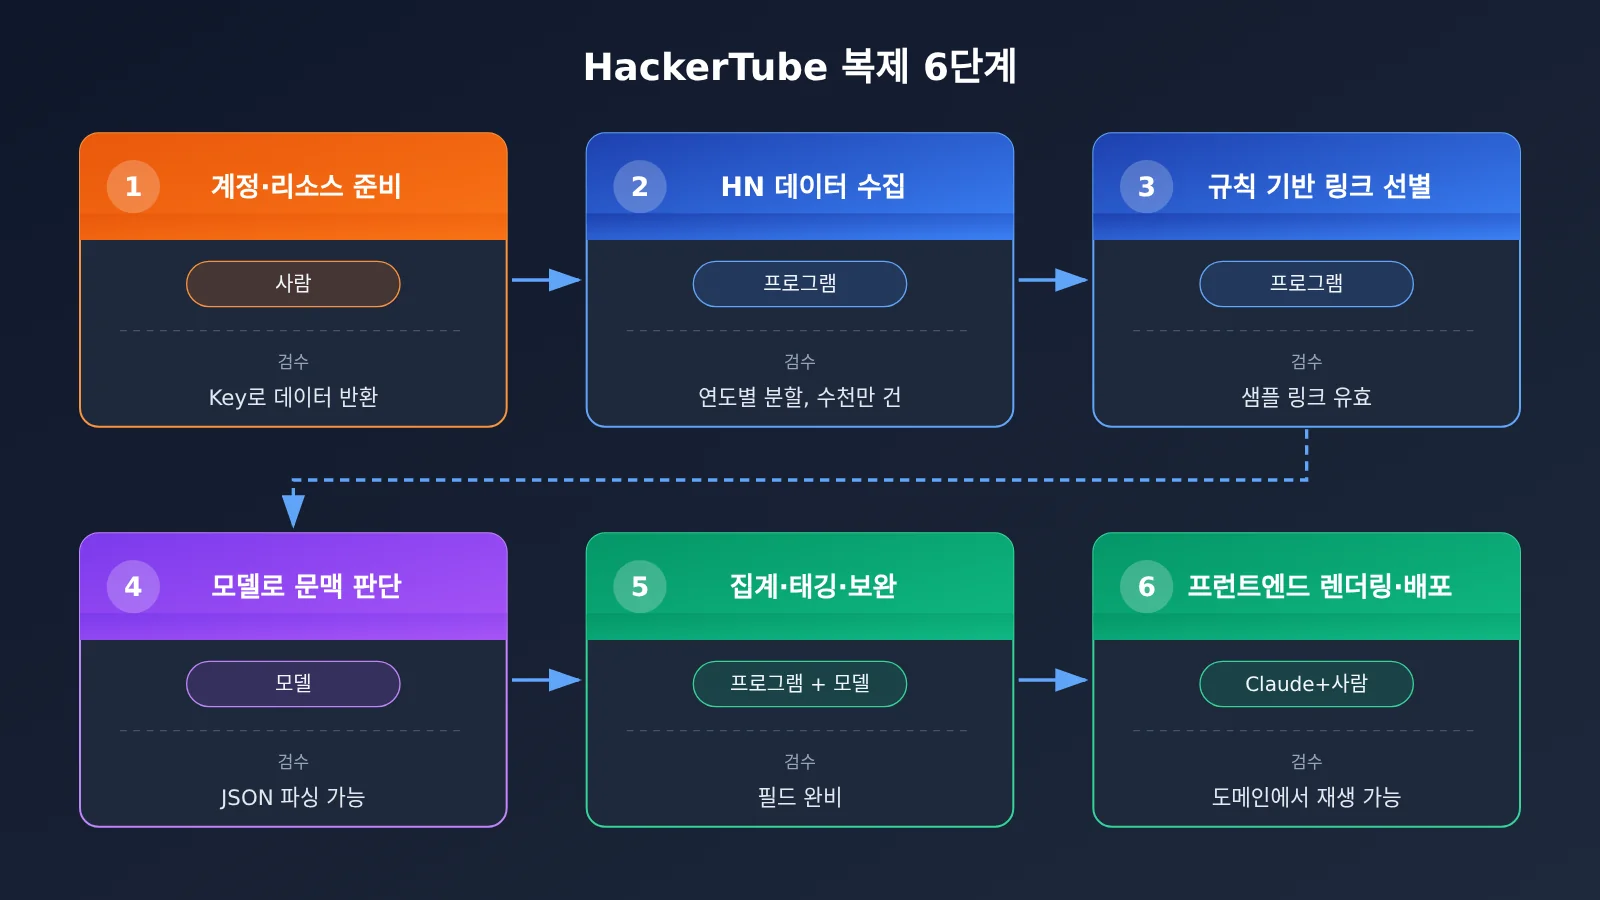
| 단계 | 할 일 | 담당 | 완료 기준 |
|---|---|---|---|
| 1 | YouTube API 키 발급, 서버 준비, 도메인 구매 | 사람 | 세 곳 모두 로그인할 수 있고, 키로 동영상 정보 한 건을 조회할 수 있음 |
| 2 | HN 전체 댓글 가져오기 | 프로그램(Claude가 작성) | 로컬에 연도별 파일이 있고, 항목 수가 예상 규모와 일치함 |
| 3 | 정규식으로 YouTube 링크가 포함된 댓글 추출 | 프로그램 | 50개를 표본 검사해 모두 유효한 동영상 링크를 포함하는지 확인 |
| 4 | 모델이 배치별로 추천 맥락인지 판단하고 JSON 출력 | 모델 | JSON을 바로 파싱할 수 있고, 표본을 사람이 검토해 정확성 확인 |
| 5 | videoId별로 집계하고 주제 태그, 제목, 채널 정보 추가 | 프로그램 + 모델 | 모든 동영상의 필드가 채워져 있고, 주제 수를 관리할 수 있는 수준으로 유지 |
| 6 | 프런트엔드 페이지 생성 및 배포 | Claude가 코드 작성, 사람이 도메인 연결 | 브라우저에서 도메인을 열어 주제별로 탐색하고 동영상을 재생할 수 있음 |
1~2단계: 리소스 준비와 HN 데이터 수집
1단계는 사람이 직접 해요. Google Cloud 콘솔에서 프로젝트를 만들고 YouTube Data API를 활성화한 뒤 API 키를 발급받아요. 서버는 클라우드 호스팅이나 정적 호스팅 서비스를 이용하면 되고, 도메인은 등록 대행업체에서 미리 구매해 둬요. 이 세 가지는 계정이나 결제가 필요해요. 커뮤니티에서 전한 내용에 따르면 Karpathy가 직접 처리한 부분이기도 해요.
2단계는 Claude가 프로그램을 작성해 처리해요. HN 데이터의 공개 출처는 두 곳이에요. 공식 Firebase API에서는 item ID로 항목을 하나씩 가져올 수 있고, BigQuery의 HN 공개 데이터세트는 SQL로 바로 조회할 수 있어요. 전체 데이터를 내려받을 때는 BigQuery를 우선 고려해 연도별로 내보내는 것이 좋아요. 확인할 것은 두 가지뿐이에요. 파일이 시간순으로 분할됐는지, 전체 항목 수가 천만 건 수준인지예요.
3~4단계: 규칙 기반 사전 필터링과 Opus 5.5 의미 판단
3단계는 비용 절감의 핵심으로, 전적으로 프로그램에 맡겨요. 정규식으로 youtube.com/watch, youtu.be/ 등의 링크 형식을 찾아 영상 링크가 포함된 댓글만 남겨요. 맥락을 파악할 수 있도록 댓글 ID, 시간, 상위 게시물 제목도 함께 저장해요. Claude Code에서 “YouTube 링크가 포함된 댓글을 추출해 JSONL로 저장하는 스크립트를 작성해 줘”처럼 요구사항을 설명하면 돼요.
4단계에서 비로소 모델이 판단해요. Opus 5.5에 댓글을 한 번에 수천 개씩 전달하고, videoId, 추천 여부, 주제, 대표 댓글 발췌문을 포함한 구조화된 결과만 출력하도록 요청해요. 프롬프트에는 “이 영상은 별로다”, “보지 마라”는 비추천이고, “볼 만하다”는 뜻을 표현한 경우만 추천으로 판단하라고 명확히 적어야 해요. 결과를 무작위로 일부 추출해 사람이 직접 확인하고, 오류율이 허용할 만한 수준인지 판단해요.
5~6단계: 집계·태그 지정과 프런트엔드 배포
5단계에서는 규칙을 먼저 적용하고, 그다음 모델을 사용해요. 프로그램이 videoId별 추천 횟수를 집계한 뒤 YouTube Data API를 호출해 제목과 채널 정보를 채워요. 주제 태그는 모델이 통합·정리해 「머신러닝」, 「ML」, 「딥러닝 입문」처럼 지나치게 세분화되는 것을 방지해요. 커뮤니티 통계에 따르면 HackerTube의 최종 주제 수는 약 150개로, 분류 수준을 정할 때 참고할 수 있어요.
6단계에서는 데이터와 페이지를 분리해요. 최종 결과물은 JSON 데이터 파일과 이를 읽는 정적 프런트엔드로 구성돼요. 영상은 YouTube iframe으로 삽입하고, 주제와 인기도순으로 정렬해요. 데이터를 업데이트할 때는 JSON만 다시 생성하면 되므로 페이지 코드는 수정할 필요가 없어요. 정적 호스팅 서비스나 자체 서버에 배포한 뒤, 사람이 도메인을 연결하면 돼요.
🚀 빠른 시작: 4, 5단계에서는 모델을 자주 호출해야 해요. APIYI apiyi.com을 통해 Claude Code를 연결하면 같은 Key로 Opus와 Sonnet을 전환할 수 있어요. 먼저 소량의 데이터로 전체 과정을 검증한 뒤, 본격적으로 데이터를 처리할 때 사용할 모델을 결정해 보세요.
HackerTube를 재현할 때 실제로 막히는 세 가지 문제
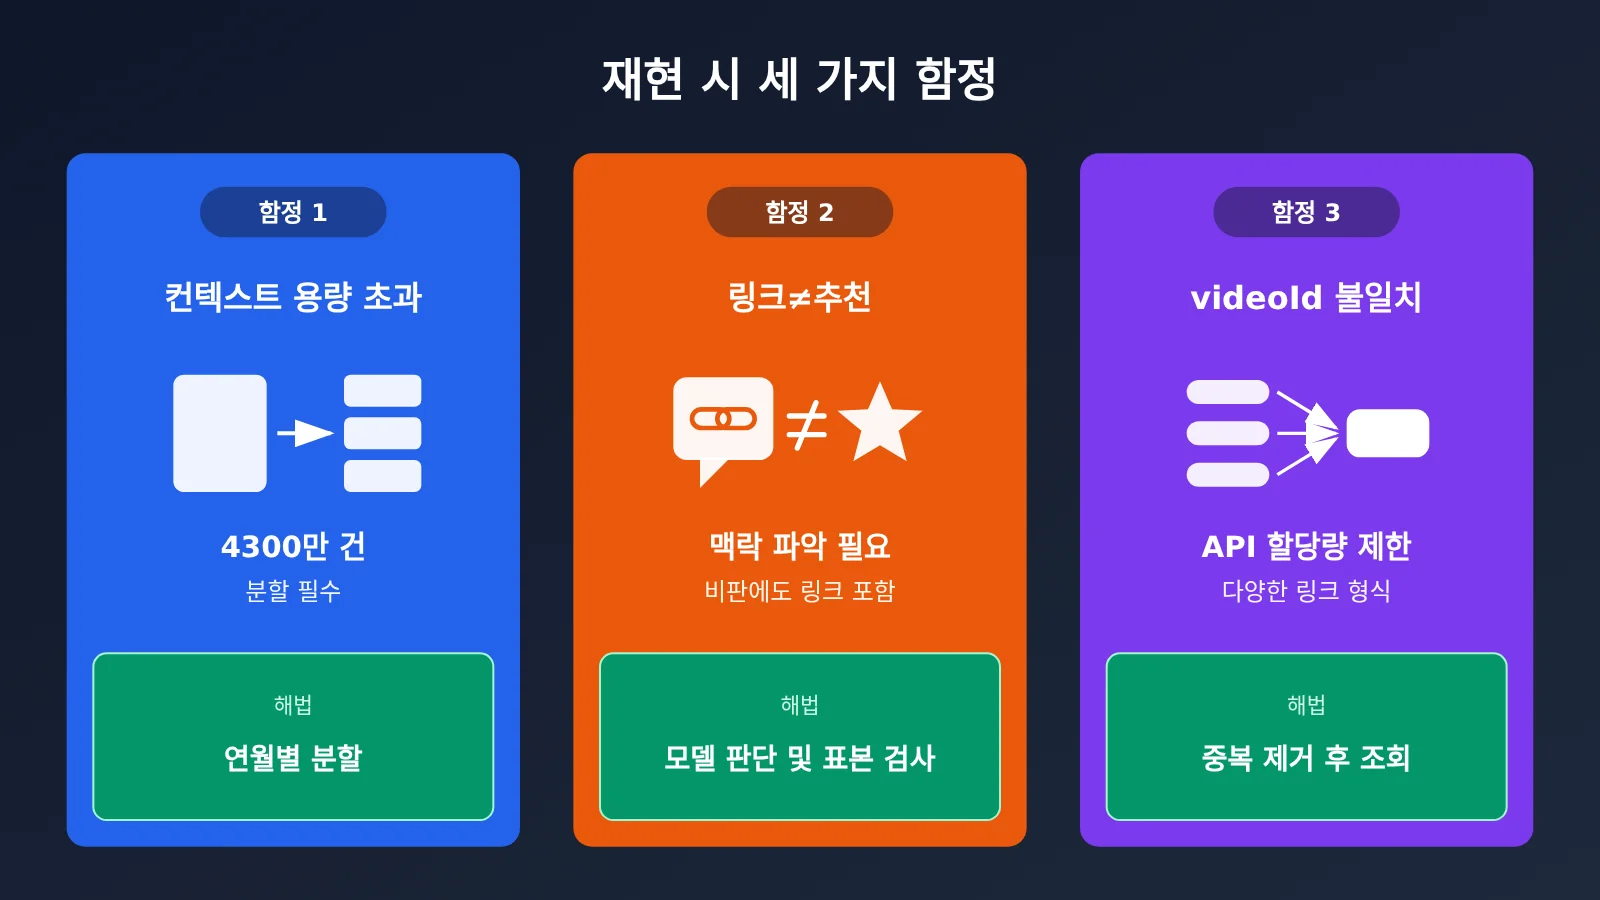
결론부터 말하면, 어려운 부분은 웹페이지를 만드는 일이 아니라 대부분 데이터를 다루는 일이에요. 아래 세 가지 문제를 마주치는 순서대로 정리했어요.
| 문제 | 대표적인 증상 | 해결책 |
|---|---|---|
| 컨텍스트에 다 들어가지 않음 | 모델에 「모든 댓글을 읽어 달라」고 하면 길이 초과 오류가 나거나 출력이 잘림 | 연월별로 나누고 배치당 수천 건씩 처리해 구조화된 JSON만 출력 |
| 링크≠추천 | 비판, 반어, 오류 지적에 쓰인 링크를 추천으로 분류 | 모델이 댓글의 맥락을 읽고 판단하게 한 뒤 사람이 표본 검사 |
| ID 혼란과 할당량 | 같은 영상의 링크 형식이 여러 가지이고, 삭제된 영상이 있으며, API 할당량이 소진됨 | 먼저 videoId를 통일해 집계하고, 중복을 제거한 ID의 메타데이터만 조회 |
문제 1: Opus 5.5의 컨텍스트에 댓글 4,300만 건이 들어가지 않음
초보자가 가장 자주 하는 실수는 「HN의 모든 댓글을 읽고 추천받은 영상을 찾아줘」라고 바로 요청하는 거예요. 모델의 컨텍스트가 아무리 커도 수십억 토큰에 달하는 텍스트를 한 번에 담을 수는 없어요. Claude가 먼저 분할 스크립트를 작성하도록 하고, 연도나 월별로 나눠 배치당 수천 건씩 처리하세요. 모델에는 설명 없이 JSON만 반환하도록 요청하면 돼요.
중단된 지점부터 다시 실행하는 방식도 필요해요. 배치별 결과를 각각 파일로 저장하고 처리한 배치 번호를 기록하세요. 중간에 오류가 나더라도 처음부터 다시 시작할 필요 없이 실패한 배치만 재실행할 수 있어요.
문제 2: YouTube 링크가 있다고 해서 추천은 아님
HN 댓글의 YouTube 링크는 추천일 수도 있지만, 반례나 비판에 쓰이거나 「이 영상은 잘못 설명하고 있다」는 지적에 포함될 수도 있어요. URL만 찾아내면 결과에 노이즈가 대량으로 섞여요. 이 단계에서는 모델이 맥락을 읽어야 하며, 전체 과정에서 대규모 언어 모델이 실제로 필요한 부분이기도 해요.
프롬프트에 긍정 사례와 부정 사례를 제시하고, 각 판단의 근거가 되는 문장도 발췌하도록 해보세요. 그러면 사람이 표본 검사할 때 분류 이유를 빠르게 확인할 수 있고, 프런트엔드에서도 해당 발췌문을 영상 카드의 「HN 반응」으로 바로 활용할 수 있어요.
문제 3: videoId 불일치와 YouTube API 할당량
같은 영상도 youtube.com/watch?v=, youtu.be/, 모바일 링크, 타임스탬프 매개변수가 붙은 링크 등 다양한 형태로 나타날 수 있어요. 먼저 11자리 videoId로 정규화하지 않으면 추천 횟수가 분산되고 순위도 왜곡돼요. 또 지난 20년 동안 삭제되거나 비공개로 설정된 영상도 많으므로 별도로 표시하고 걸러야 해요.
YouTube Data API에는 일일 할당량 제한이 있어요. 댓글마다 한 번씩 조회하지 말고, 먼저 중복을 제거한 뒤 메타데이터를 일괄 조회하세요. 일괄 조회 API는 한 번에 여러 ID를 조회할 수 있어 할당량 소모를 크게 줄여줘요.
HackerTube를 재현하는 데 드는 비용은? (추정)
결론부터 말하면, 전체 데이터를 Opus 5.5에 처리하도록 맡기면 수천 달러가 들지만, 규칙으로 먼저 걸러내면 수십~수백 달러 수준으로 줄일 수 있어요. 아래 금액은 모두 추정치이며 실제 청구 금액이 아닙니다.
먼저 단가를 살펴볼게요. 아래 표는 APIYI 모델 가격표를 기준으로 하며, 데이터 시점은 2026-10-27 14:50(UTC+8), 단위는 백만 토큰당 미국 달러입니다.
| 모델 | 입력 | 출력 | 캐시 읽기 | 이용 가능한 플랫폼 |
|---|---|---|---|---|
| opus-5-5 | $4 | $20 | $0.2 | APIYI apiyi.com, 공식 API |
| sonnet-5-5 | $2 | $10 | $0.1 | APIYI apiyi.com, 공식 API |
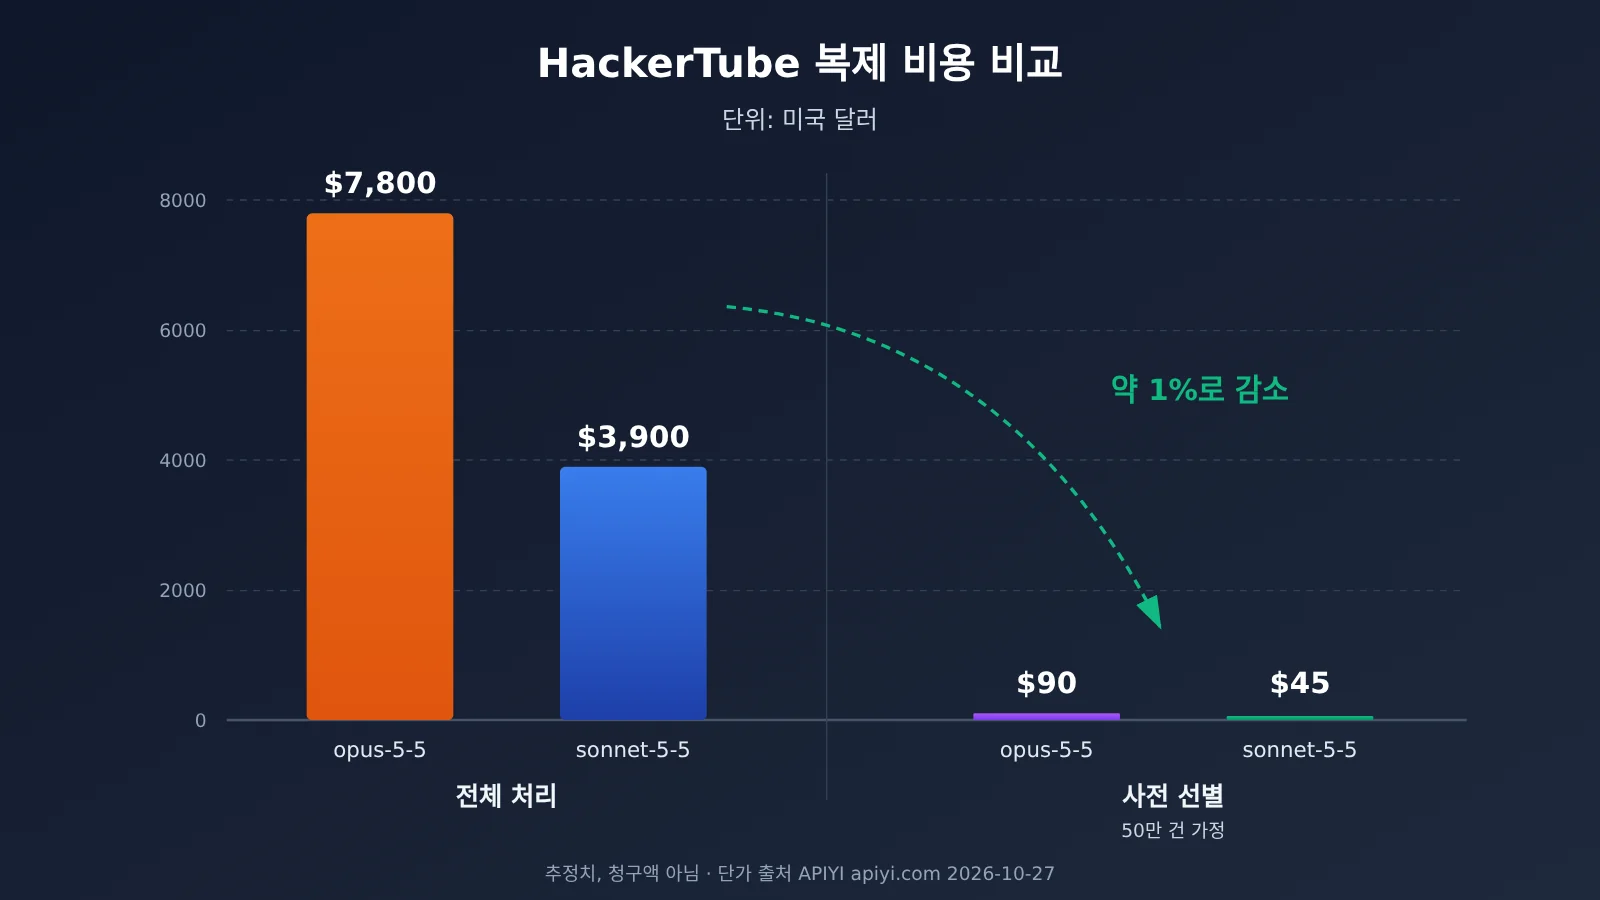
추정에 사용한 가정은 다음과 같아요. 댓글 4,300만 건, 건당 평균 30토큰으로 총 약 13억 토큰입니다. 배치당 입력은 5만 토큰, 출력은 5천 토큰이며 총 약 2.6만 배치예요. 사전 필터링 방식에서 ‘50만 건이 남는다’는 것은 계산 방법을 보여주기 위한 가정일 뿐, HN의 실제 통계가 아닙니다. 실제 건수는 3단계를 실행해야 알 수 있어요.
| 방식 | 입력 토큰 | 출력 토큰 | opus-5-5 추정 비용 | sonnet-5-5 추정 비용 |
|---|---|---|---|---|
| 전체를 모델에 바로 전달 | 약 13억 | 약 1.3억 | 약 $5,200 + $2,600 ≈ $7,800 | 약 $2,600 + $1,300 ≈ $3,900 |
| 규칙으로 먼저 필터링(50만 건이 남는다고 가정) | 약 1,500만 | 약 150만 | 약 $60 + $30 ≈ $90 | 약 $30 + $15 ≈ $45 |
표에서 볼 수 있듯이 3단계의 규칙 기반 사전 필터링이 전체 프로젝트의 비용 규모를 결정해요. 또한 배치마다 시스템 프롬프트와 긍정·부정 예시가 반복되므로, 캐시 읽기 단가를 활용하면 이 부분의 비용을 더 낮출 수 있어요. 커뮤니티의 참고 사례도 있습니다. X 사용자 @thisiskp_는 Opus 5.5로 약 19분, 약 2달러를 들여 Show HN 동영상 사이트 데모를 만들었다고 밝혔어요. 다만 단일 사례이고 규모와 데이터양이 다르므로 직접 비교할 수는 없습니다.
💰 비용 관련 조언: 전체 데이터를 처리하기 전에 한 달 치 데이터로 먼저 과정을 검증하고, 실제 토큰 사용량을 기록해 보세요. 여기에 개월 수를 곱하면 전체 비용을 추정할 수 있어요. APIYI apiyi.com은 고정 월 요금 없이 사용량에 따라 과금하므로, 이렇게 소량으로 먼저 테스트한 뒤 규모를 결정하는 방식에 적합해요.
APIYI로 Claude Code를 연결해 HackerTube 워크플로 실행하기
결론부터 말하면, 환경 변수 두 개만 설정하면 Claude Code에서 APIYI를 통해 Opus 5.5를 호출할 수 있어요. 하나의 키로 opus-5-5와 sonnet-5-5를 번갈아 사용할 수도 있습니다.
[스크린샷 위치: APIYI Claude Code 연동 문서]
APIYI Claude Code 연동 문서(docs.apiyi.com/scenarios/programming/claude-code)에 따라 터미널에서 다음 두 항목을 설정하세요.
ANTHROPIC_BASE_URL=https://api.apiyi.comANTHROPIC_AUTH_TOKEN=<你的 APIYI Key>
설정이 끝나면 Claude Code를 실행하고 모델 옵션에서 opus-5-5 또는 sonnet-5-5를 선택하면 됩니다. 실제로는 ‘강력한 모델로 계획하고, 경제적인 모델로 실행하는’ 방식으로 역할을 나눌 수 있어요.
- 계획 및 코드 작성 단계에서는 opus-5-5 사용: 데이터 분할 방식을 설계하고, 수집 및 사전 선별 스크립트를 작성하고, 프런트엔드를 생성합니다. 토큰 사용량은 적지만 높은 품질이 필요한 단계예요.
- 대량 판단 단계에서는 두 모델 비교: 동일한 수백 건의 샘플을 opus-5-5와 sonnet-5-5로 각각 처리하고, 판단 정확도를 직접 비교하세요. 그 결과를 바탕으로 2만 6천 개 배치 또는 사전 선별된 배치에 사용할 모델을 결정합니다.
- 주제 통합 단계에서는 다시 opus-5-5 사용: 약 150개 주제를 통합하려면 전체를 보는 시각이 필요해요. 호출 횟수도 적으므로 강력한 모델을 쓰는 편이 더 안정적입니다.
🎯 기술 팁: APIYI apiyi.com 콘솔에서 키를 만든 뒤 이 프로젝트의 사용 한도를 별도로 설정하세요. 배치 처리 스크립트가 반복 호출될 때 비용이 걷잡을 수 없이 늘어나는 일을 막을 수 있어요. 신규 사용자의 무료 테스트 크레딧이면 한 달치 샘플 데이터를 처리하기에 충분합니다.
Karpathy의 HackerTube 방식은 어떤 데이터에 활용할 수 있을까요?
결론부터 말하면, 대규모 커뮤니티 토론에 특정 자원에 대한 추천이 섞여 있는 데이터라면 같은 파이프라인을 적용할 수 있어요.
- Reddit 기술 게시판: 반복해서 추천되는 책, 강의 또는 오픈소스 저장소를 골라낼 수 있어요. 링크 정규식만 바꾸면 파이프라인 구조는 거의 그대로 쓸 수 있어요.
- GitHub Issues와 토론 게시판: 여러 번 인용된 블로그 글이나 해결책 링크를 추출해 프로젝트의 ‘필독 목록’으로 정리할 수 있어요.
- 팀 내부 메신저나 문서 댓글: 콘텐츠 팀이 과거 토론에서 동료들이 반복해서 공유한 참고 자료를 찾을 수 있어요. 단, 먼저 데이터 사용 권한을 확인해야 해요.
- 팟캐스트와 논문 추천: 링크 정규식을 arXiv나 팟캐스트 플랫폼 형식으로 바꾸면 ‘커뮤니티가 실제로 추천하는 논문이나 에피소드’를 찾을 수 있어요.
다른 데이터에 적용할 때는 두 가지만 조정하면 돼요. 3단계의 사전 필터링 규칙과 4단계 프롬프트의 긍정·부정 예시예요. 데이터 파이프라인, 배치 호출, JSON 구조와 정적 프런트엔드는 그대로 재사용할 수 있어요.
자주 묻는 질문 FAQ
Q1: YouTube API 키 없이도 HackerTube 같은 사이트를 만들 수 있나요?
핵심 기능은 만들 수 있어요. videoId는 댓글의 링크에서 추출하고, 영상은 iframe으로 임베드해 재생하므로 API 키가 필요 없어요. 다만 제목과 채널 같은 메타데이터는 가져올 수 없어요. 우선 HN 댓글의 맥락을 바탕으로 모델이 설명을 생성하게 하고, 나중에 키를 추가할 수 있어요.
Q2: Hacker News 댓글 데이터는 어떻게 가져오나요?
두 가지 방법이 있어요. HN 공식 Firebase API(github.com/HackerNews/API)는 item ID로 데이터를 가져올 수 있어 증분 업데이트에 적합해요. BigQuery의 HN 공개 데이터셋은 전체 데이터를 한 번에 내보내기에 좋아요. 전체를 재현한다면 후자를 우선 추천해요.
Q3: 왜 추천 알고리즘을 직접 만들지 않나요?
Karpathy의 원래 게시글은 YouTube 추천에 대한 불만에서 출발했어요. HackerTube는 20년간 쌓인 커뮤니티의 집단적 판단을 활용하므로 사용자 행동 데이터가 필요 없고 콜드 스타트 문제도 없어요. 두 시간 안에 만들 수도 있죠. 반면 추천 알고리즘은 장기간의 데이터 축적과 지속적인 조정이 필요해요.
Q4: ‘2시간’ 동안 모든 과정이 자동으로 완료됐나요?
완전 자동은 아니에요. 커뮤니티에 전해진 바에 따르면 Karpathy가 직접 YouTube API 키를 발급받고 서버를 준비하고 도메인을 구매했으며, 나머지 작업은 Claude와 대화하며 완료했어요. 사람은 여전히 요구사항을 전달하고 결과물을 검수하며 계정이 필요한 절차를 처리했어요. 직접 재현할 때는 프롬프트 조정과 수동 표본 검사 시간도 고려해야 해요.
Q5: 이 방식을 쓰면 비용이 통제 불가능해질 수 있나요?
사전 필터링 없이 전체 데이터를 모델에 넘기면 예상 비용이 수천 달러에 이를 수 있어요. 비용을 관리하는 방법은 세 가지예요. 먼저 규칙 기반 사전 필터링을 하고, 한 달 치 샘플을 실행해 비용을 추산한 다음, APIYI apiyi.com에서 키의 사용 한도를 설정하세요. 모델과 가격은 플랫폼의 모델 목록을 기준으로 확인하세요.
정리
Karpathy의 HackerTube는 Claude Code와 Opus 5.5를 조합하면 혼자서도 주말 동안 수천만 건의 커뮤니티 토론을 활용 가능한 제품으로 만들 수 있음을 보여줬어요. 핵심은 ‘AI가 웹사이트를 자동으로 작성하는 것’이 아니라 데이터 파이프라인 설계예요.
- 흐름: 리소스 준비 → 데이터 수집 → 규칙 기반 사전 선별 → 모델 판단 → 집계 및 태그 지정 → 배포. 사람, 프로그램, 모델의 역할이 명확하게 나뉘어요.
- 주요 과제: 컨텍스트 분할, 추천 맥락 판단, videoId 정규화, API 할당량 관리.
- 비용: 전체 데이터를 처리하면 수천 달러 수준이고, 사전 선별 후에는 수십~수백 달러 수준으로 줄일 수 있어요. 실제 비용은 직접 실행한 소규모 샘플 데이터를 기준으로 판단해야 해요.
- 시작하기: 환경 변수 두 개만 설정하면 Claude Code에서 APIYI를 통해 opus-5-5와 sonnet-5-5를 호출할 수 있어요.
이 방법을 자신의 데이터에 적용하고 싶다면 한 달치 소규모 샘플부터 시작해 보세요. APIYI apiyi.com의 무료 크레딧으로 전체 과정을 실행해 본 뒤 본격적인 처리 규모를 결정하는 것이 좋아요.
참고 자료
- Karpathy 원문 게시물(2026-11-01): HackerTube 출시 안내
- 링크:
x.com/karpathy/status/2116957135661945283 -
설명: 데이터 규모, 소요 시간, 모델 정보의 원출처
-
HackerTube 사이트: 완성된 프로젝트
- 링크:
hackertube.org -
설명: 주제별 분류와 페이지 구성을 확인할 수 있어요
-
APIYI Claude Code 연동 문서: 환경 변수 설정
- 링크:
docs.apiyi.com/scenarios/programming/claude-code -
설명: Claude Code 연동 절차
-
APIYI 모델 가격표: 모델별 단가
- 링크:
docs.apiyi.com/models -
설명: 모델과 가격은 이 문서를 기준으로 확인하세요
-
Hacker News 공식 API 문서: 데이터 수집
- 링크:
github.com/HackerNews/API - 설명: item 구조와 수집 방법