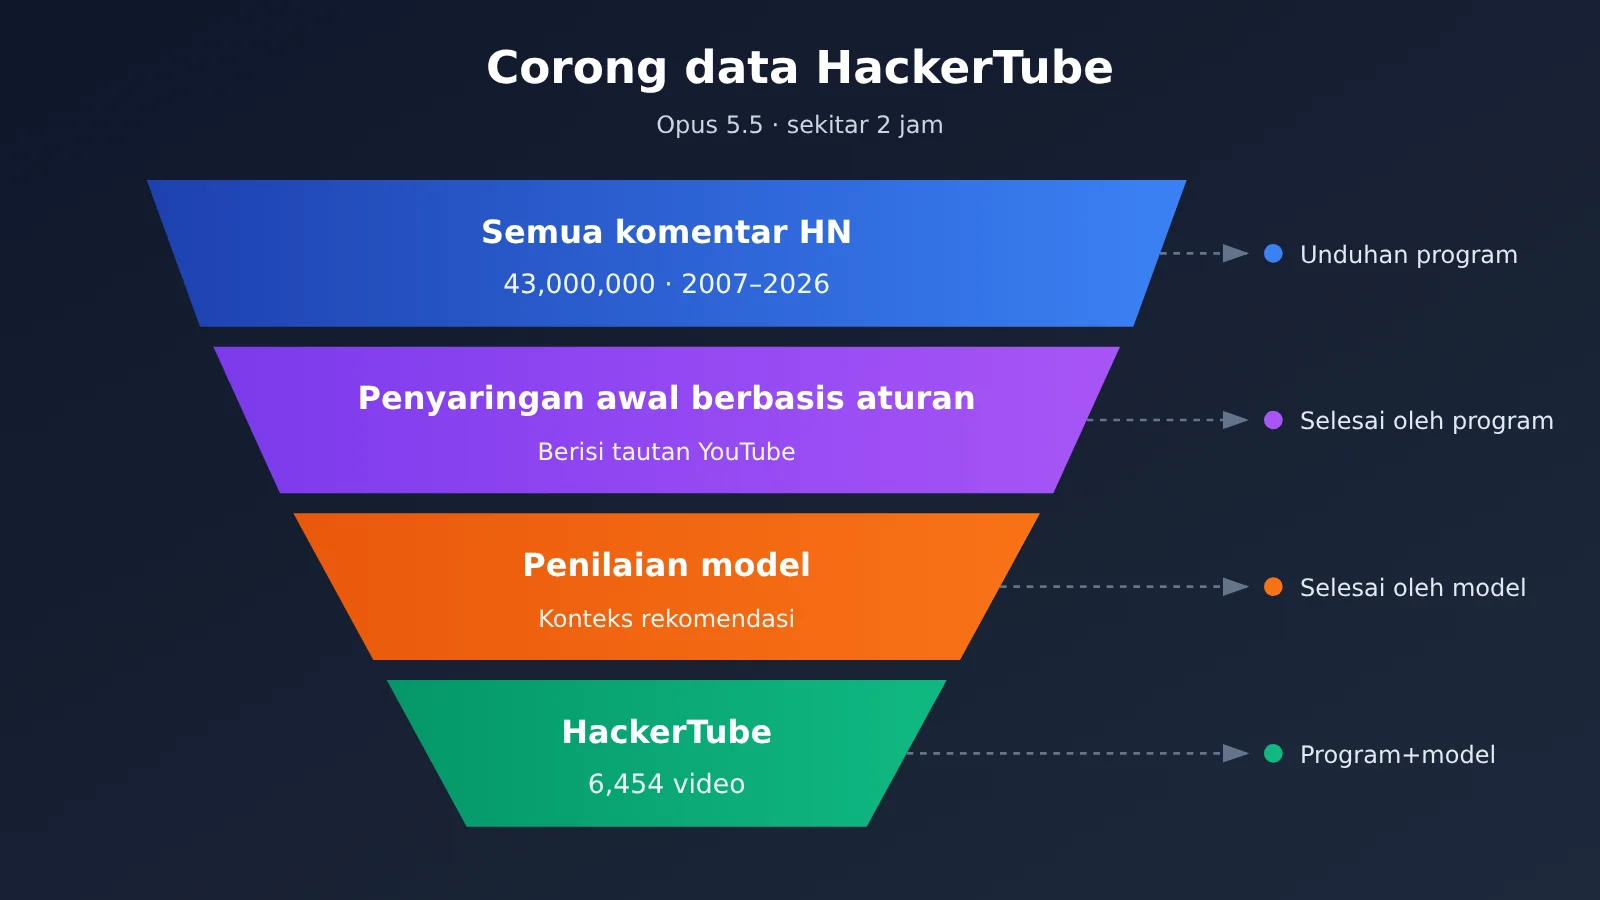
Andrej Karpathy menghabiskan sekitar dua jam pada akhir pekan untuk membuat situs video bernama HackerTube. Ia meminta Claude menyaring sekitar 43 juta komentar Hacker News selama 20 tahun dan menemukan 6.454 video YouTube yang direkomendasikan berulang kali. Sebagian besar prosesnya dilakukan lewat percakapan dengan Claude. Begini kata Karpathy di X pada 2026-11-01: “~2 hours with Opus 5.5”.
Artikel ini dirangkum berdasarkan unggahan asli Karpathy, situs HackerTube, dan penuturan publik dari komunitas. Prosesnya diuraikan menjadi 6 langkah yang bisa diikuti pengembang, beserta 3 kendala yang paling mungkin ditemui.
Manfaat utama: Setelah membaca artikel ini, kamu akan mendapatkan alur 6 langkah yang menjelaskan tugas manusia, program, dan model; estimasi biaya beserta asumsi yang digunakan; serta cara tercepat menghubungkan Claude Code melalui APIYI apiyi.com.
Apa sebenarnya yang dilakukan Karpathy lewat HackerTube
Singkatnya, ia merangkum rekomendasi kolektif “video ini wajib ditonton” dari komunitas HN selama 20 tahun menjadi sebuah situs video yang bisa dijelajahi.
Berikut kutipan lengkap unggahan Karpathy di X (2026-11-01 18:14 UTC):
“Proyek akhir pekan: HackerTube. Saya kesal dengan rekomendasi YouTube, jadi saya meminta Claude menyaring 43 juta komentar selama 20 tahun di HN menjadi 6.454 video yang terus direkomendasikan. Pengalaman menontonnya jauh lebih baik, sekitar 2 jam dengan Opus 5.5.”
Deskripsi halaman situs hackertube.org berbunyi “Video YouTube yang terus direkomendasikan untuk ditonton oleh sesama anggota Hacker News.” Intinya bukan algoritma rekomendasi, melainkan penyaringan semantik terhadap diskusi komunitas yang sudah ada.
| Poin | Informasi publik | Sifat sumber |
|---|---|---|
| Skala data | Sekitar 43 juta komentar HN selama 20 tahun, menyisakan 6.454 video | Unggahan asli Karpathy (2026-11-01) |
| Waktu dan model | Sekitar 2 jam, menggunakan Opus 5.5 | Unggahan asli Karpathy (2026-11-01) |
| Lingkungan alat | Claude Code versi desktop | Menurut informasi yang dibagikan komunitas |
| Tindakan manual | Hanya tiga hal yang dilakukan secara manual: mengajukan kunci API YouTube, menyiapkan server, dan membeli domain | Menurut informasi yang dibagikan komunitas |
| Bentuk situs | Sekitar 150 topik, mencakup 2007-2026, tanpa perlu masuk | Menurut perhitungan komunitas |
Cara kerja HackerTube
Menurut informasi yang dibagikan komunitas, Karpathy pernah mengatakan, “Saya hanya berbicara dengan Claude dan memintanya melakukan semuanya.” Artinya, sebagian besar pekerjaan—mengunduh data, menulis skrip penyaringan, memanggil model untuk menilai data, hingga membuat halaman—dikerjakan Claude di Claude Code. Manusia terutama bertugas menyampaikan kebutuhan dan menangani bagian yang memerlukan akun atau pembayaran.
Ini berbeda dari sekadar “meminta AI membuat templat halaman web”. Tantangan sebenarnya ada pada datanya: 43 juta komentar tidak mungkin dimasukkan sekaligus ke dalam konteks, dan “tautan yang muncul” belum tentu berarti “direkomendasikan”. Jadi, proyek ini lebih mirip pipeline data dengan antarmuka depan yang sederhana.
Proses 6 Langkah Meniru HackerTube dengan Opus 5.5
Intinya: biarkan program memangkas volume data terlebih dahulu, lalu gunakan model hanya untuk penilaian yang membutuhkan pemahaman konteks. Enam langkah berikut disusun sesuai urutan pengerjaan, lengkap dengan penanggung jawab dan cara memverifikasi hasilnya.
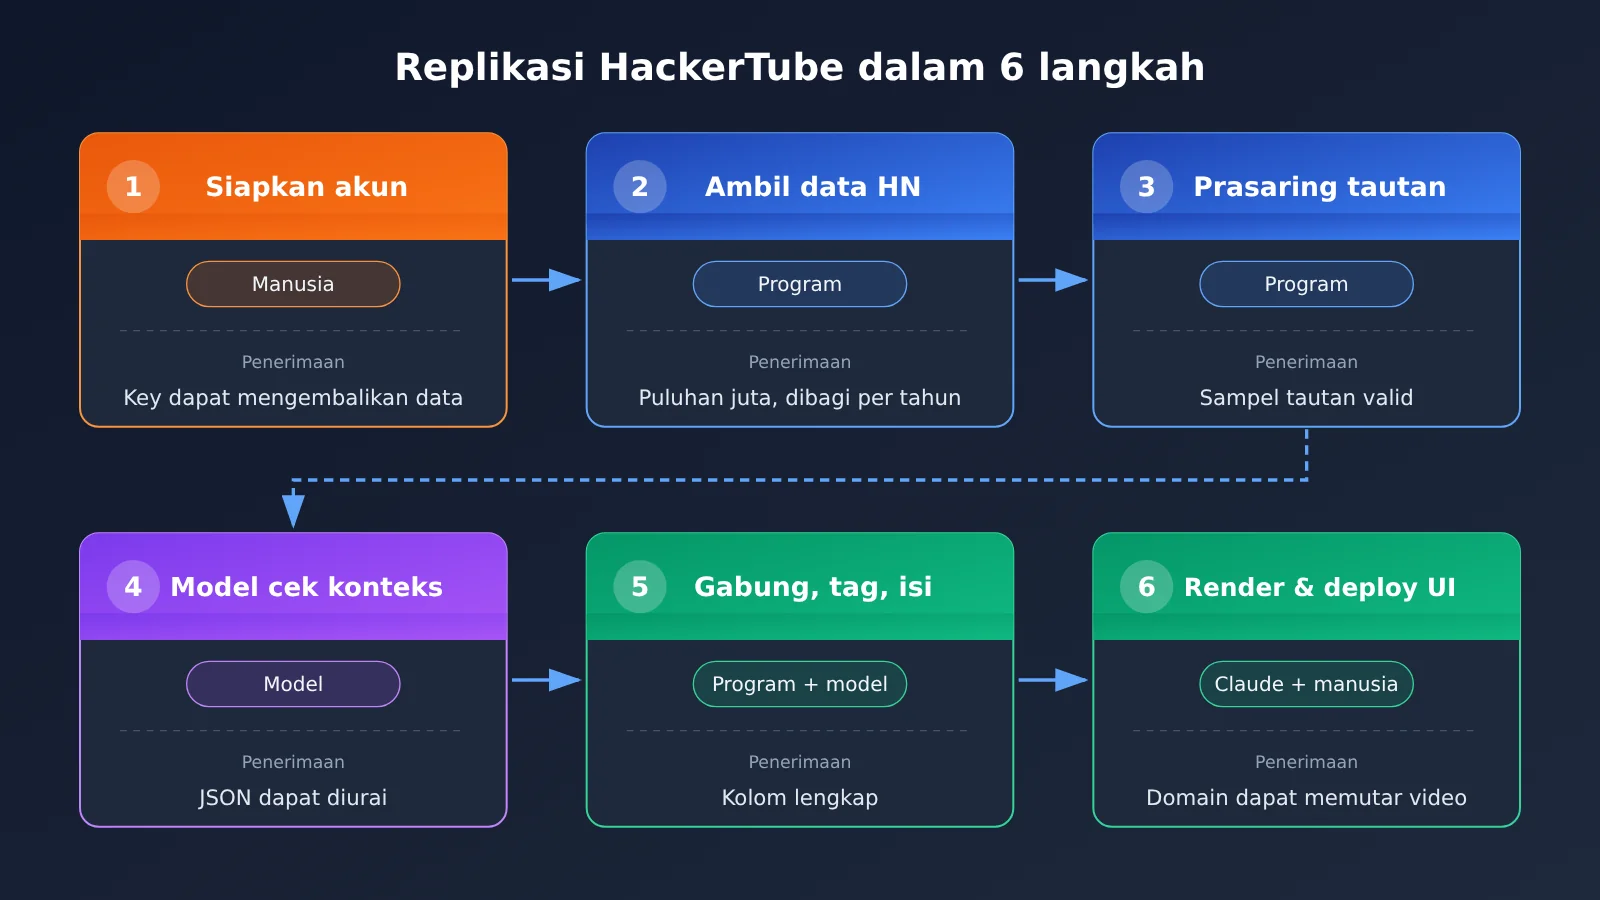
| Langkah | Yang dilakukan | Penanggung jawab | Cara memverifikasi |
|---|---|---|---|
| 1 | Mengajukan API key YouTube, menyiapkan server, dan membeli domain | Manusia | Ketiganya bisa diakses, dan key dapat mengembalikan informasi satu video |
| 2 | Mengambil seluruh komentar HN | Program (ditulis oleh Claude) | Ada file lokal yang dipisahkan berdasarkan tahun, dengan jumlah komentar sesuai perkiraan |
| 3 | Mengekstrak komentar yang berisi tautan YouTube menggunakan regex | Program | Periksa sampel 50 komentar dan pastikan masing-masing berisi tautan video yang valid |
| 4 | Meminta model menilai konteks rekomendasi secara bertahap dan menghasilkan JSON | Model | JSON dapat langsung di-parse, dan sampelnya diperiksa secara manual |
| 5 | Mengagregasi dan menghitung berdasarkan videoId, memberi label topik, serta melengkapi judul dan nama kanal | Program + model | Setiap video memiliki field lengkap dan jumlah topik tetap terkendali |
| 6 | Membuat halaman frontend dan men-deploy-nya | Claude menulis kode, manusia menghubungkan domain | Buka domain di browser dan pastikan video bisa dijelajahi berdasarkan topik serta diputar |
Langkah 1-2: Siapkan sumber daya dan ambil data HN
Langkah 1 dikerjakan oleh manusia. Buat proyek di konsol Google Cloud, aktifkan YouTube Data API, lalu buat kunci API. Server bisa menggunakan layanan cloud atau hosting statis apa pun. Beli juga domain dari registrar untuk digunakan nanti. Ketiga hal ini memerlukan akun atau pembayaran, dan menurut cerita yang beredar di komunitas, bagian inilah yang ditangani sendiri oleh Karpathy.
Langkah 2 dikerjakan oleh program yang ditulis Claude. Ada dua sumber data HN publik: Firebase API resmi dapat mengambil data satu per satu berdasarkan item ID, sedangkan dataset HN publik di BigQuery bisa langsung ditanyakan dengan SQL. Untuk mengunduh seluruh data, sebaiknya gunakan BigQuery dan ekspor berdasarkan tahun. Saat memeriksa hasilnya, cukup pastikan dua hal: file sudah dibagi berdasarkan waktu dan jumlah totalnya mencapai puluhan juta entri.
Langkah 3-4: Penyaringan awal dengan aturan dan penilaian semantik oleh Opus 5.5
Langkah 3 adalah kunci untuk menghemat biaya, dan sepenuhnya diserahkan ke program. Gunakan regex untuk mencocokkan format tautan seperti youtube.com/watch dan youtu.be/. Simpan hanya komentar yang berisi tautan video, beserta ID komentar, waktu, dan judul postingan induk sebagai konteks. Cukup jelaskan kebutuhan Anda langsung di Claude Code, misalnya: “Tulis skrip untuk mengekstrak komentar yang berisi tautan YouTube dan menyimpannya sebagai JSONL.”
Langkah 4 baru melibatkan penilaian model. Berikan beberapa ribu komentar per batch kepada Opus 5.5, dan minta model hanya menghasilkan data terstruktur dengan kolom videoId, status rekomendasi, topik, dan kutipan komentar yang mewakili. Dalam petunjuk, jelaskan bahwa “video ini jelek sekali” dan “jangan tonton ini” termasuk bukan rekomendasi; hanya komentar yang menyatakan “layak ditonton” yang dihitung sebagai rekomendasi. Untuk memeriksa hasilnya, ambil satu batch secara acak dan periksa secara manual apakah tingkat kesalahannya bisa diterima.
Langkah 5–6: Agregasi, Pelabelan, dan Deployment Frontend
Langkah 5: gunakan aturan terlebih dahulu, lalu model. Program menghitung jumlah rekomendasi berdasarkan videoId, lalu memanggil YouTube Data API untuk melengkapi judul dan nama kanal. Model kemudian menyatukan label topik agar tidak terlalu terpecah, seperti “machine learning”, “ML”, dan “pengantar deep learning”. Menurut statistik komunitas, HackerTube memiliki sekitar 150 topik yang bisa dijadikan acuan tingkat perincian.
Langkah 6: pisahkan data dari halaman. Hasil akhirnya berupa satu file data JSON dan frontend statis yang membacanya. Video disematkan menggunakan iframe YouTube, lalu diurutkan berdasarkan topik dan popularitas. Saat data diperbarui, kamu hanya perlu membuat ulang JSON tanpa mengubah kode halaman. Deployment bisa dilakukan di layanan hosting statis atau server sendiri, lalu domain diarahkan secara manual.
🚀 Mulai cepat: Langkah 4 dan 5 memerlukan pemanggilan model yang sering. Setelah menghubungkan Claude Code melalui APIYI apiyi.com, kamu bisa menggunakan Key yang sama untuk beralih antara Opus dan Sonnet. Jalankan alur dengan sedikit data terlebih dahulu, lalu tentukan model yang akan digunakan untuk pemrosesan penuh.
Tiga kendala nyata saat membuat ulang HackerTube
Kesimpulannya: kendalanya hampir selalu ada di sisi data, bukan saat membuat halaman web. Tiga kendala berikut disusun berdasarkan urutan kemunculannya.
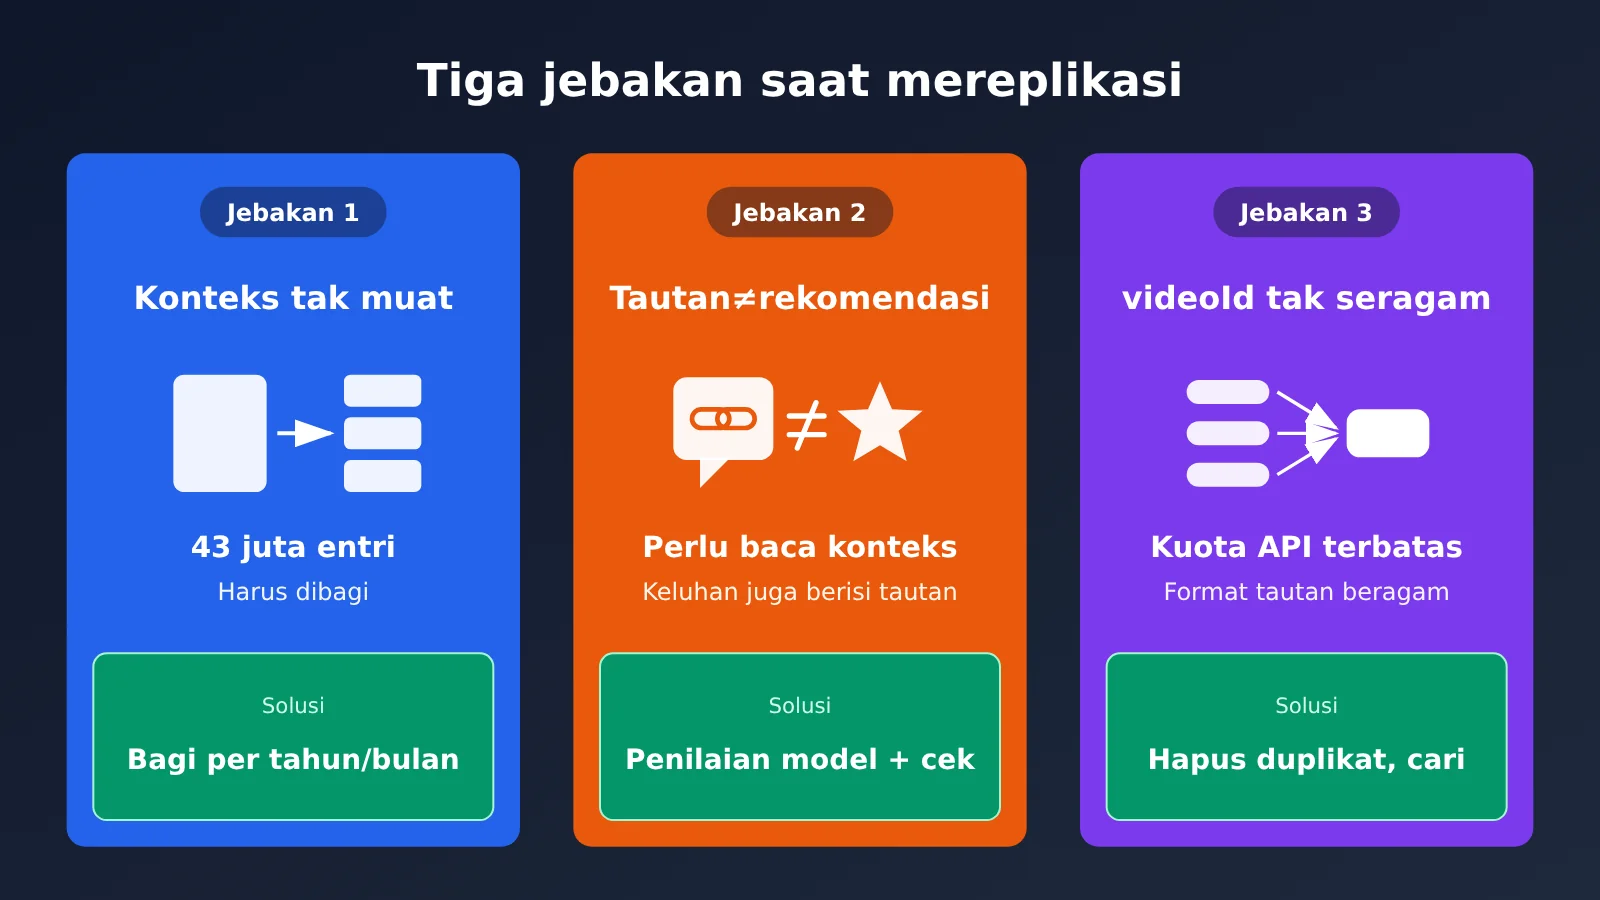
| Kendala | Gejala umum | Solusi |
|---|---|---|
| Konteks tidak cukup | Meminta model “membaca semua komentar”, lalu muncul kesalahan karena terlalu panjang atau output terpotong | Bagi berdasarkan tahun dan bulan, beberapa ribu komentar per batch, dan hasilkan hanya JSON terstruktur |
| Tautan ≠ rekomendasi | Tautan dalam keluhan, sindiran, atau koreksi dianggap sebagai rekomendasi | Minta model menilai konteks komentar, lalu periksa sampelnya secara manual |
| ID tidak seragam dan kuota | Video yang sama memiliki berbagai format tautan, video sudah dihapus, atau kuota API habis | Seragamkan videoId sebelum agregasi, lalu cari metadata hanya untuk ID yang sudah dideduplikasi |
Kendala 1: Konteks Opus 5.5 tidak cukup untuk 43 juta komentar
Kesalahan paling umum bagi pemula adalah langsung menulis permintaan seperti “baca semua komentar HN dan temukan video yang direkomendasikan”. Sebesar apa pun jendela konteks model, miliaran token teks tidak mungkin dimuat sekaligus. Cara yang tepat adalah meminta Claude menulis skrip pembagian data terlebih dahulu, membaginya berdasarkan tahun atau bulan dengan beberapa ribu komentar per batch, lalu meminta model hanya mengembalikan JSON tanpa penjelasan.
Mekanisme untuk melanjutkan proses dari titik terakhir juga perlu disiapkan: simpan hasil setiap batch secara terpisah dan catat nomor batch yang sudah diproses. Jika terjadi kesalahan di tengah jalan, cukup jalankan ulang batch yang gagal tanpa mengulang dari awal.
Kendala 2: Adanya tautan YouTube bukan berarti video direkomendasikan
Tautan YouTube dalam komentar HN bisa berupa rekomendasi, tetapi juga bisa menjadi contoh yang buruk, bahan keluhan, atau disertai komentar seperti “video ini menjelaskan hal yang salah”. Pencocokan URL saja akan memasukkan banyak data yang tidak relevan ke dalam hasil. Pada tahap ini, model harus membaca konteksnya. Inilah bagian alur kerja yang benar-benar membutuhkan Model Bahasa Besar.
Sebaiknya sertakan contoh positif dan negatif dalam petunjuk, lalu minta satu kutipan sebagai dasar untuk setiap penilaian. Dengan begitu, saat memeriksa sampel secara manual, Anda bisa segera memahami alasan klasifikasi model. Frontend juga bisa langsung menggunakan kutipan tersebut sebagai bagian “Apa kata HN” pada kartu video.
Kendala 3: videoId tidak seragam dan kuota YouTube API
Video yang sama dapat muncul dalam berbagai bentuk tautan, seperti youtube.com/watch?v=, youtu.be/, tautan versi seluler, atau tautan dengan parameter penanda waktu. Jika tidak dinormalisasi terlebih dahulu menjadi videoId 11 karakter, jumlah rekomendasi akan terpecah dan peringkat menjadi tidak akurat. Selain itu, selama 20 tahun terakhir, banyak video yang sudah dihapus atau diatur sebagai privat sehingga perlu ditandai dan difilter secara terpisah.
YouTube Data API memiliki batas kuota harian. Karena itu, lakukan deduplikasi terlebih dahulu, lalu cari metadata secara batch, bukan sekali untuk setiap komentar. Antarmuka batch dapat mencari beberapa ID dalam satu permintaan sehingga pemakaian kuota jauh lebih hemat.
Berapa perkiraan biaya membuat ulang HackerTube?
Kesimpulannya: memproses semua data dengan Opus 5.5 membutuhkan biaya sekitar beberapa ribu dolar; dengan penyaringan awal berbasis aturan, biayanya bisa turun menjadi puluhan hingga ratusan dolar. Semua angka di bawah ini adalah estimasi, bukan tagihan aktual.
Mari lihat harga per satuannya. Tabel berikut berasal dari daftar harga model APIYI, dengan data per 2026-10-27 14:50 (UTC+8), dalam dolar AS per satu juta token.
| Model | Input | Output | Pembacaan cache | Platform yang tersedia |
|---|---|---|---|---|
| opus-5-5 | $4 | $20 | $0.2 | APIYI apiyi.com, API resmi |
| sonnet-5-5 | $2 | $10 | $0.1 | APIYI apiyi.com, API resmi |
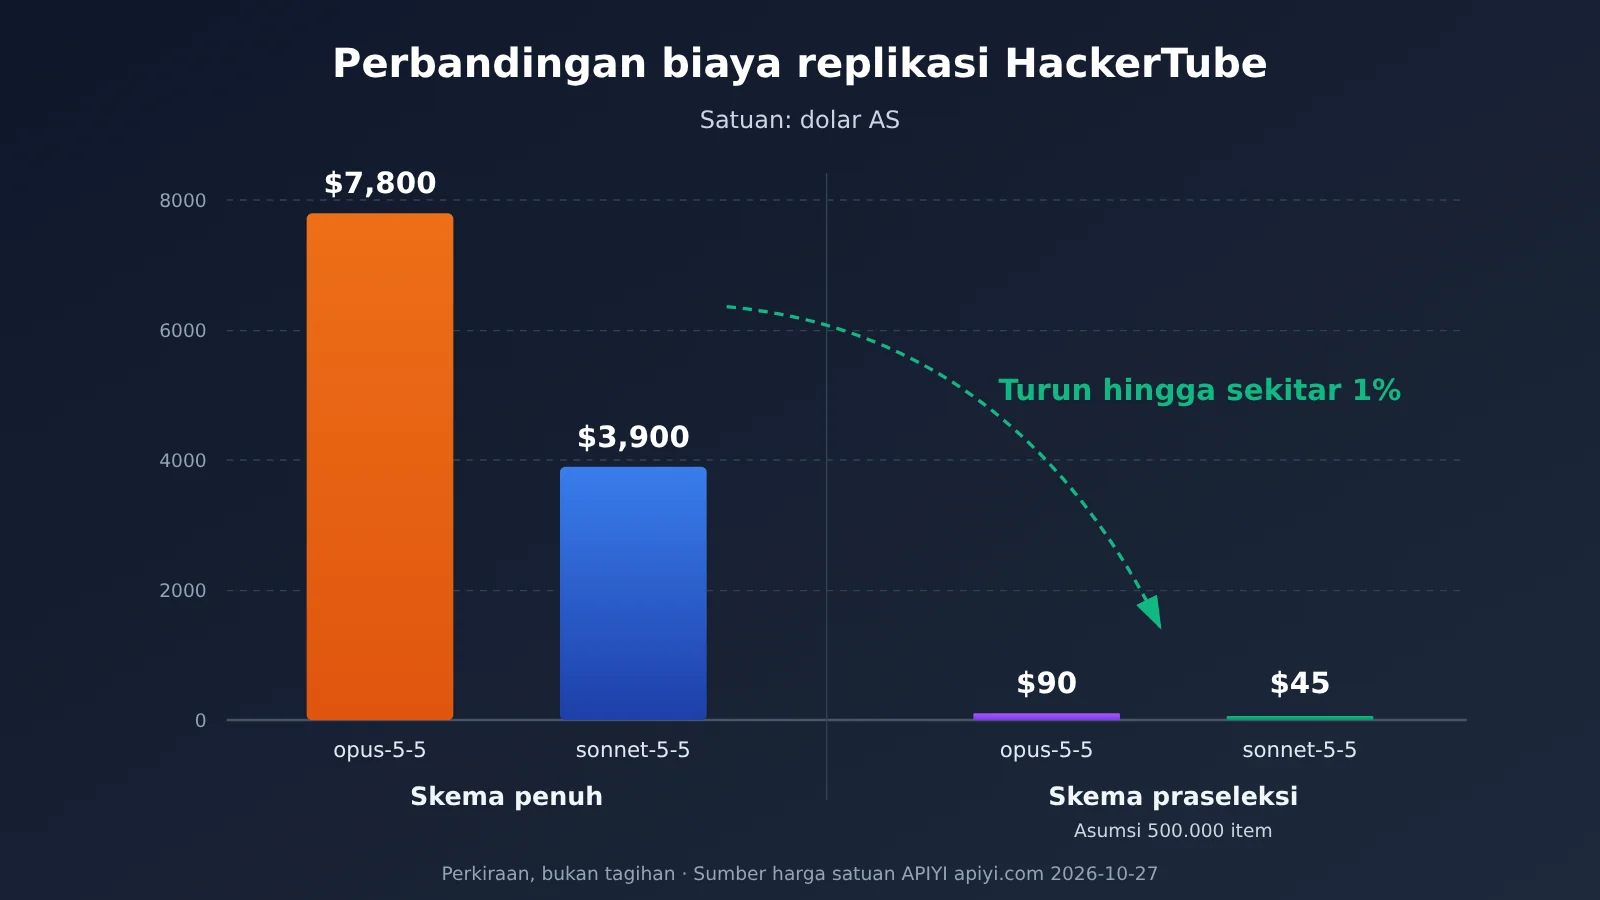
Asumsi estimasinya sebagai berikut: 43 juta komentar, rata-rata 30 token per komentar, total sekitar 1,3 miliar token; setiap batch terdiri dari 50 ribu token input dan 5 ribu token output, dengan total sekitar 26 ribu batch. Angka “tersisa 500 ribu komentar” dalam skenario penyaringan awal hanya asumsi untuk menunjukkan cara perhitungannya, bukan statistik HN yang sebenarnya. Jumlah aktualnya baru bisa diketahui setelah Anda menjalankan langkah 3.
| Skenario | Token input | Token output | Estimasi opus-5-5 | Estimasi sonnet-5-5 |
|---|---|---|---|---|
| Semua data langsung dikirim ke model | Sekitar 1,3 miliar | Sekitar 130 juta | Sekitar $5,200 + $2,600 ≈ $7,800 | Sekitar $2,600 + $1,300 ≈ $3,900 |
| Penyaringan awal berbasis aturan (asumsi tersisa 500 ribu komentar) | Sekitar 15 juta | Sekitar 1,5 juta | Sekitar $60 + $30 ≈ $90 | Sekitar $30 + $15 ≈ $45 |
Dari tabel ini terlihat bahwa penyaringan awal berbasis aturan pada langkah 3 menentukan kisaran biaya seluruh proyek. Selain itu, petunjuk sistem serta contoh positif dan negatif berulang di setiap permintaan batch. Dengan memanfaatkan harga pembacaan cache, biaya bagian ini bisa ditekan lebih jauh. Ada juga contoh dari komunitas: pengguna X @thisiskp_ menyebut bahwa ia membuat demo situs video Show HN dengan Opus 5.5 dalam sekitar 19 menit dengan biaya sekitar 2 dolar. Ini hanya satu kasus dengan skala dan jumlah data yang berbeda, jadi tidak bisa langsung dibandingkan.
💰 Saran biaya: Sebelum menjalankan pemrosesan penuh, coba jalankan seluruh alur menggunakan data satu bulan. Catat pemakaian token aktual, lalu kalikan dengan jumlah bulan untuk memperkirakan totalnya. APIYI apiyi.com menggunakan sistem bayar sesuai pemakaian tanpa biaya bulanan tetap, cocok untuk pendekatan “coba batch kecil dulu, lalu tentukan skalanya”.
Menjalankan alur HackerTube dengan Claude Code melalui APIYI
Singkatnya, cukup atur dua variabel lingkungan agar Claude Code dapat memanggil Opus 5.5 melalui APIYI. Key yang sama bisa digunakan untuk beralih antara opus-5-5 dan sonnet-5-5.
[Tempat tangkapan layar: dokumentasi integrasi Claude Code APIYI]
Sesuai dokumentasi integrasi Claude Code APIYI (docs.apiyi.com/scenarios/programming/claude-code), atur dua variabel berikut di terminal:
ANTHROPIC_BASE_URL=https://api.apiyi.comANTHROPIC_AUTH_TOKEN=<你的 APIYI Key>
Setelah itu, jalankan Claude Code dan pilih opus-5-5 atau sonnet-5-5 di opsi model. Dalam praktiknya, Anda bisa menggunakan model yang lebih kuat untuk perencanaan dan model yang lebih hemat untuk eksekusi:
- Gunakan opus-5-5 untuk perencanaan dan penulisan kode: minta model merancang pembagian batch, menulis skrip pengambilan dan penyaringan awal, serta membuat frontend. Tahap ini tidak membutuhkan banyak token, tetapi kualitasnya penting.
- Bandingkan kedua model pada tahap penilaian massal: jalankan opus-5-5 dan sonnet-5-5 pada sampel yang sama, terdiri dari beberapa ratus entri. Bandingkan akurasi penilaiannya secara manual, lalu tentukan model untuk memproses 26.000 batch atau batch yang sudah disaring.
- Kembali ke opus-5-5 untuk penggabungan topik: menggabungkan sekitar 150 topik membutuhkan perspektif menyeluruh. Karena jumlah pemanggilannya sedikit, model yang lebih kuat menjadi pilihan yang lebih aman.
🎯 Saran teknis: Setelah membuat Key di konsol APIYI apiyi.com, Anda bisa menetapkan batas pengeluaran khusus untuk proyek ini. Dengan begitu, biaya tidak membengkak jika skrip batch melakukan pemanggilan berulang. Kuota uji coba gratis untuk pengguna baru cukup untuk memproses sampel data selama satu bulan.
Data Apa Saja yang Bisa Diolah dengan Metode HackerTube Karpathy?
Singkatnya, selama ada banyak diskusi komunitas yang menyelipkan rekomendasi untuk jenis sumber tertentu, alur yang sama bisa digunakan.
- Forum teknologi Reddit: Pilih buku, kursus, atau repositori sumber terbuka yang berulang kali direkomendasikan. Struktur alurnya hampir sama, cukup ganti regex tautannya.
- GitHub Issues dan forum diskusi: Ambil tautan artikel blog atau solusi yang sering dikutip, lalu susun menjadi daftar bacaan wajib untuk proyek tertentu.
- IM internal tim atau komentar dokumen: Tim konten bisa mencari bahan rujukan yang berulang kali dibagikan oleh rekan kerja dalam diskusi terdahulu, asalkan izin penggunaan datanya sudah dipastikan.
- Rekomendasi podcast dan paper: Ganti regex tautan dengan format arXiv atau platform podcast untuk mendapatkan daftar paper atau episode yang benar-benar direkomendasikan komunitas.
Saat menerapkannya ke sumber lain, hanya ada dua hal yang perlu disesuaikan: aturan penyaringan awal pada langkah 3 serta contoh positif dan negatif dalam petunjuk pada langkah 4. Alur data, pemanggilan bertahap, struktur JSON, dan frontend statis semuanya bisa digunakan kembali.
Pertanyaan Umum (FAQ)
Q1: Bisakah membuat situs seperti HackerTube tanpa kunci API YouTube?
Bagian utamanya bisa dibuat. videoId diambil dari tautan dalam komentar, sedangkan video diputar melalui iframe; keduanya tidak memerlukan kunci API. Yang tidak tersedia adalah metadata seperti judul dan kanal. Sebagai langkah awal, gunakan konteks dari komentar HN agar model membuat deskripsi, lalu tambahkan kunci API nanti.
Q2: Bagaimana cara mendapatkan data komentar Hacker News?
Ada dua cara: Firebase API resmi HN (github.com/HackerNews/API) dapat mengambil data berdasarkan item ID dan cocok untuk pembaruan bertahap; sementara dataset publik HN di BigQuery cocok untuk ekspor seluruh data sekaligus. Jika ingin mereplikasi secara penuh, sebaiknya gunakan cara kedua.
Q3: Mengapa tidak langsung membuat algoritma rekomendasi?
Titik awal unggahan Karpathy adalah ketidakpuasannya terhadap rekomendasi YouTube. HackerTube memanfaatkan penilaian kolektif komunitas selama 20 tahun, tidak membutuhkan data perilaku pengguna, tidak menghadapi masalah cold start, dan bisa selesai dalam dua jam. Sebaliknya, algoritma rekomendasi membutuhkan pengumpulan data jangka panjang dan penyesuaian berkelanjutan.
Q4: Apakah proses “2 jam” itu sepenuhnya otomatis?
Tidak sepenuhnya otomatis. Menurut cerita yang dibagikan komunitas, Karpathy mengajukan kunci API YouTube, menyiapkan server, dan membeli domain secara manual. Pekerjaan lainnya diselesaikan melalui percakapan dengan Claude. Manusia tetap bertanggung jawab menyampaikan kebutuhan, memeriksa hasil, dan menangani langkah yang membutuhkan akun. Jika ingin mereplikasinya, sediakan juga waktu untuk menyempurnakan petunjuk dan memeriksa sampel secara manual.
Q5: Apakah biaya metode ini bisa menjadi tidak terkendali?
Jika penyaringan awal dilewati dan seluruh data langsung diserahkan ke model, perkiraan biayanya bisa mencapai ribuan dolar. Ada tiga cara untuk mengendalikannya: lakukan penyaringan awal berbasis aturan, jalankan sampel data selama satu bulan untuk memperkirakan biaya, lalu tetapkan batas kuota untuk kunci API di APIYI apiyi.com. Jenis model dan harganya mengacu pada daftar model di platform.
Kesimpulan
HackerTube buatan Karpathy membuktikan bahwa kombinasi Claude Code dan Opus 5.5 memungkinkan satu orang mengubah puluhan juta diskusi komunitas menjadi produk yang bisa digunakan hanya dalam satu akhir pekan. Namun, kunci keberhasilannya adalah desain pipeline data, bukan sekadar “AI otomatis membuat situs web”.
- Alur: siapkan sumber daya → ambil data → lakukan penyaringan awal berbasis aturan → minta model menilai → agregasikan dan beri label → deploy. Peran manusia, program, dan model dibagi dengan jelas.
- Tantangan: pemotongan konteks, penilaian konteks rekomendasi, normalisasi videoId, dan kuota API.
- Biaya: pemrosesan seluruh data membutuhkan biaya dalam kisaran ribuan dolar. Setelah penyaringan awal, biayanya bisa turun ke kisaran puluhan hingga ratusan dolar. Gunakan hasil sampel kecil Anda sendiri sebagai acuan.
- Memulai: cukup dengan dua variabel lingkungan, Claude Code dapat memanggil opus-5-5 dan sonnet-5-5 melalui APIYI.
Jika ingin menerapkan metode ini pada data Anda sendiri, mulailah dengan sampel kecil selama satu bulan. Gunakan kuota gratis dari APIYI di apiyi.com untuk menjalankan seluruh alur, lalu tentukan skala pemrosesan yang sebenarnya.
Referensi
- Postingan asli Karpathy (2026-11-01): pengumuman peluncuran HackerTube
- Tautan:
x.com/karpathy/status/2116957135661945283 -
Keterangan: sumber utama untuk skala data, waktu pemrosesan, dan informasi model
-
Situs HackerTube: hasil akhir proyek
- Tautan:
hackertube.org -
Keterangan: lihat kategori topik dan tampilan halaman
-
Dokumentasi integrasi Claude Code APIYI: konfigurasi variabel lingkungan
- Tautan:
docs.apiyi.com/scenarios/programming/claude-code -
Keterangan: langkah-langkah integrasi Claude Code
-
Daftar harga model APIYI: harga per model
- Tautan:
docs.apiyi.com/models -
Keterangan: rujukan untuk model dan harga terkini
-
Dokumentasi resmi API Hacker News: pengambilan data
- Tautan:
github.com/HackerNews/API - Keterangan: struktur item dan cara mengambilnya