Note de l’auteur : en décomposant les trois postes de la tarification de Gemini 4 Neon selon les prix officiels de Google — entrée, cache implicite et sortie —, cet article explique que les tokens de réflexion sont comptés dans la sortie, qu’il n’existe pas d’offre gratuite, que le cache explicite n’est pas pris en charge, et propose un exemple de calcul en tokens entiers ainsi qu’une méthode de comparaison avec le tableau récapitulatif APIYI.
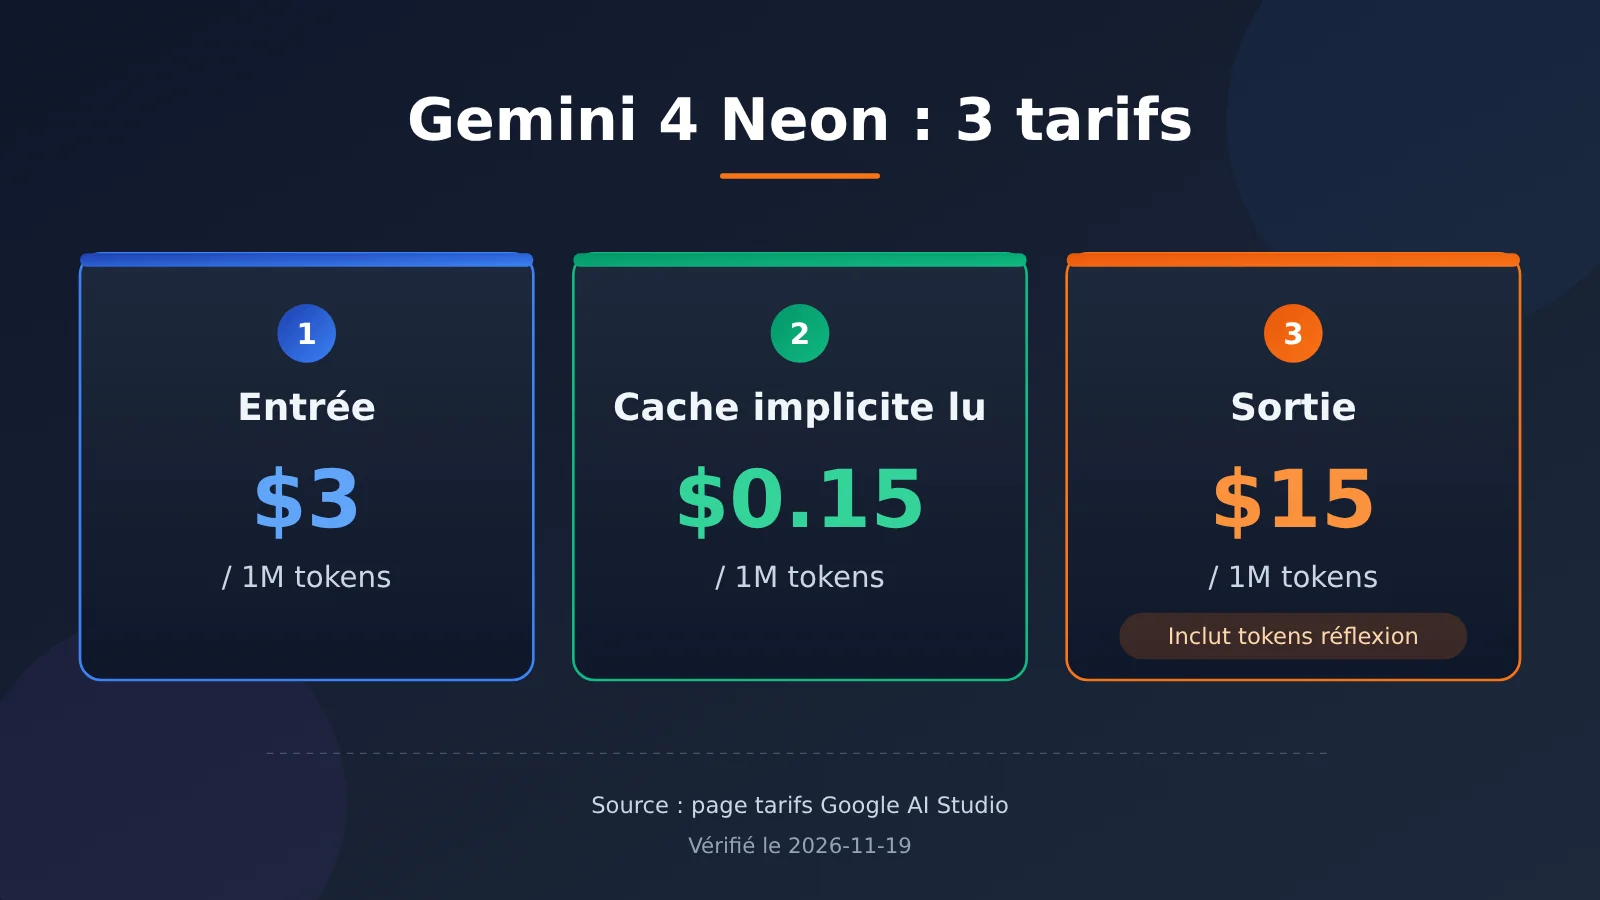
Après la sortie de Gemini 4 Neon le 2026-11-18, beaucoup de développeurs veulent d’abord savoir combien coûte un appel. Le « coût par tâche » affiché dans les classements est le résultat pondéré d’une série complète d’indices d’évaluation ; ce n’est pas la même chose qu’une requête sur votre facture. Cet article décompose, poste par poste, les trois cases de la tarification de Gemini 4 Neon : entrée à 3 $, lecture du cache implicite à 0.15 $, sortie à 15 $, et précise dans quelle case tombent les tokens de réflexion.
Les informations tarifaires de cet article proviennent de la page de tarification de Google AI Studio, du guide pour les développeurs de Google Cloud, de la fiche modèle de DeepMind, de l’article et de la page modèle d’Artificial Analysis, ainsi que du tableau récapitulatif APIYI et de l’interface de tarification. Date de vérification des données : 2026-11-19. Chaque chiffre est sourcé ; lorsque les périmètres ne concordent pas, les deux versions sont conservées.
Valeur clé : après lecture, vous pourrez calculer le coût d’un appel à Gemini 4 Neon avec votre propre nombre de tokens et la formule, savoir quel poste économise un cache hit, et savoir comment retrouver le prix affiché des modèles de la même famille dans le tableau récapitulatif d’APIYI sur apiyi.com.
Les points clés de la tarification de Gemini 4 Neon
Commençons par rassembler les conditions tarifaires officielles dans un tableau. Les prix et les règles de cache ci-dessous viennent de la page de tarification de Google AI Studio et du guide développeur Google Cloud ; les limites de contexte et de sortie viennent du guide développeur et de la fiche modèle.
| Point clé | Explication officielle | Ce que cela signifie pour votre facture |
|---|---|---|
| Entrée | 3,00 $ par million de tokens (page de tarification AI Studio) | Les invites, les documents et l’historique de conversation sont tous facturés à ce tarif |
| Entrée en cache | 0,15 $ par million de tokens, cache implicite uniquement (page de tarification AI Studio) | Le préfixe partagé qui trouve une correspondance est facturé 0,15 $, soit une remise de 95 % par rapport à 3 $ (blog Google, chiffre auto-déclaré) |
| Sortie | 15,00 $ par million de tokens, tokens de réflexion inclus (page de tarification AI Studio) | Plus la réflexion est profonde, plus cette ligne pèse lourd |
| Niveau gratuit | Pas de niveau gratuit (page de tarification AI Studio) | Facturation dès le premier appel |
| Cache explicite | Le cache de contexte explicite n’est pas pris en charge (guide développeur Google Cloud) | Impossible de créer manuellement un objet de cache : on dépend uniquement des correspondances automatiques |
| Seuil du cache implicite | Un préfixe partagé de plus de 4096 tokens déclenche le cache automatiquement, le cache persistant étant activé par défaut (guide développeur) | Les invites courtes ne profitent pratiquement jamais du tarif cache |
| Contexte | Plafond unifié de 1048576 tokens, entrée et sortie comprises (guide développeur) ; la fiche modèle indique une fenêtre unifiée de 1 million maximum | Sur les documents longs, la part de la ligne « entrée » sera très élevée |
Les tokens de réflexion dans la tarification de Gemini 4 Neon
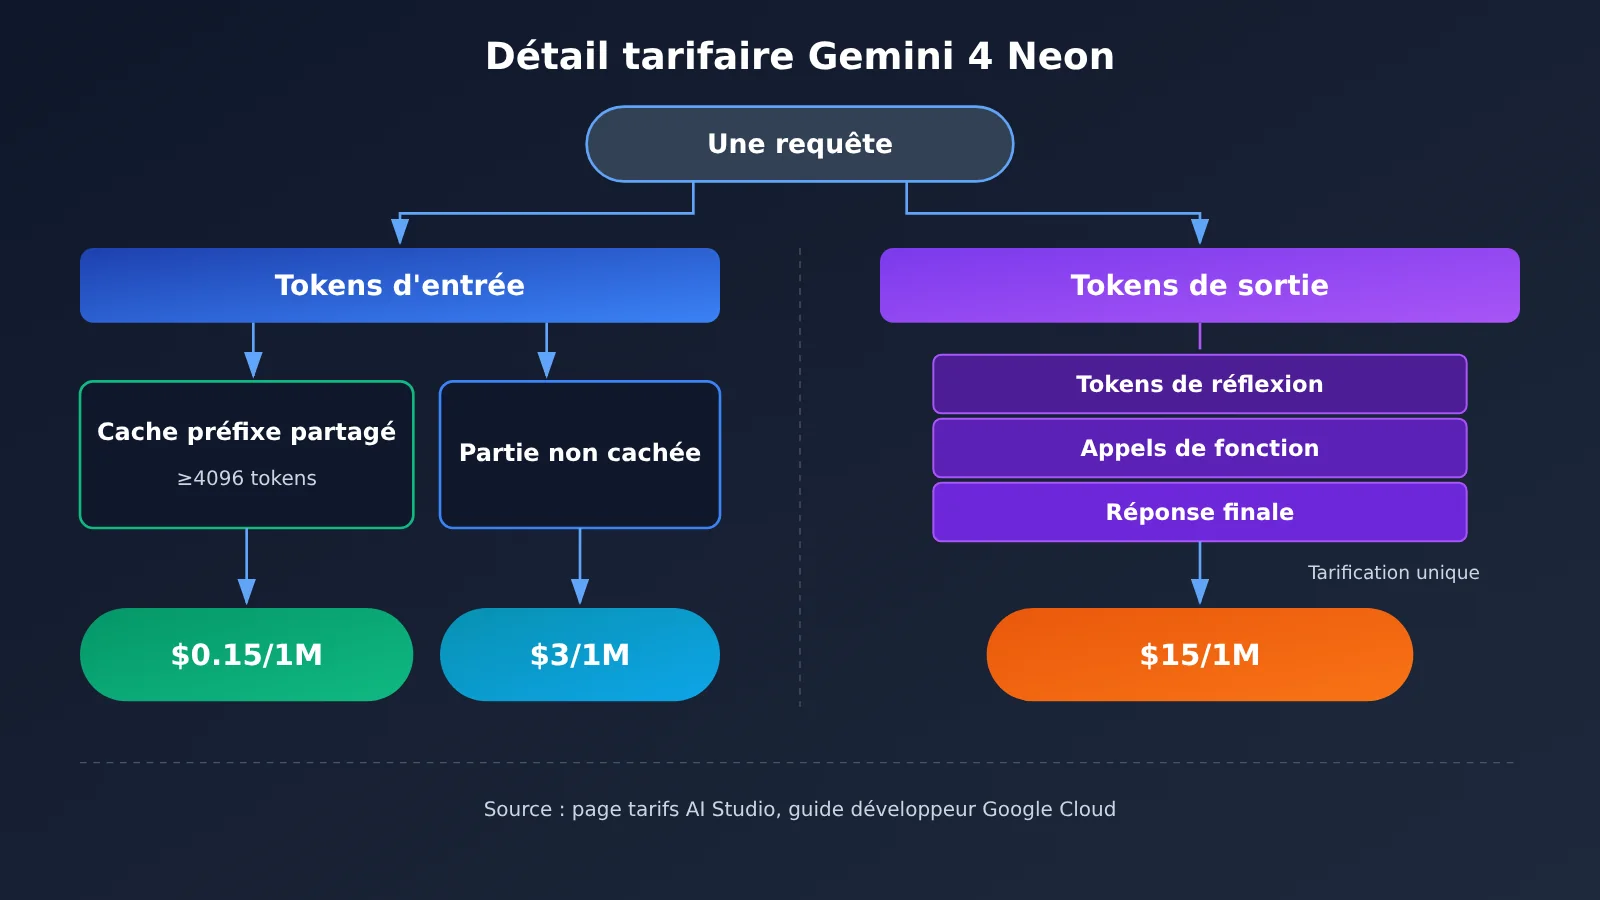
Le guide développeur Google Cloud précise que la sortie se compose de trois parties : la réflexion, les appels de fonction et la réponse finale, chaque segment étant plafonné par défaut à 65536 tokens. La page de tarification AI Studio compte elle aussi les tokens de réflexion dans la ligne « sortie » à 15 $ : le nombre de tokens de sortie que vous voyez sur votre facture est donc généralement bien plus élevé que la longueur apparente de la réponse à l’écran.
Neon ne propose que quatre niveaux de réflexion : low, medium, high et xhigh, high étant la valeur par défaut. Le guide développeur rappelle également que passer thinking_budget ou MINIMAL renvoie un HTTP 400. Le blog Google (auto-déclaré) résume la chose ainsi : plus le niveau est élevé, plus la réflexion est profonde et plus il y a de tokens — ce qui se répercute directement sur la ligne « sortie ».
Le cache implicite dans la tarification de Gemini 4 Neon
Le cache implicite vise les débuts de requête identiques d’un appel à l’autre : une invite système fixe, le même long document, le même jeu de définitions d’outils. Le seuil indiqué dans le guide développeur est un préfixe partagé de plus de 4096 tokens ; une fois atteint, la facturation se fait automatiquement au tarif cache, sans appel d’API supplémentaire.
Cela donne un conseil de rédaction très concret : placez le contenu stable et inchangé tout au début du message, et la question de l’utilisateur, qui change à chaque fois, tout à la fin. Plus le préfixe est long et stable, plus la proportion facturée à 0,15 $ est importante. La remise du cache ne s’applique qu’à la ligne « entrée » ; la ligne « sortie » reste toujours à 15 $.
Tarification de Gemini 4 Neon et écarts de prix unitaires avec Carbon et Hydrogen
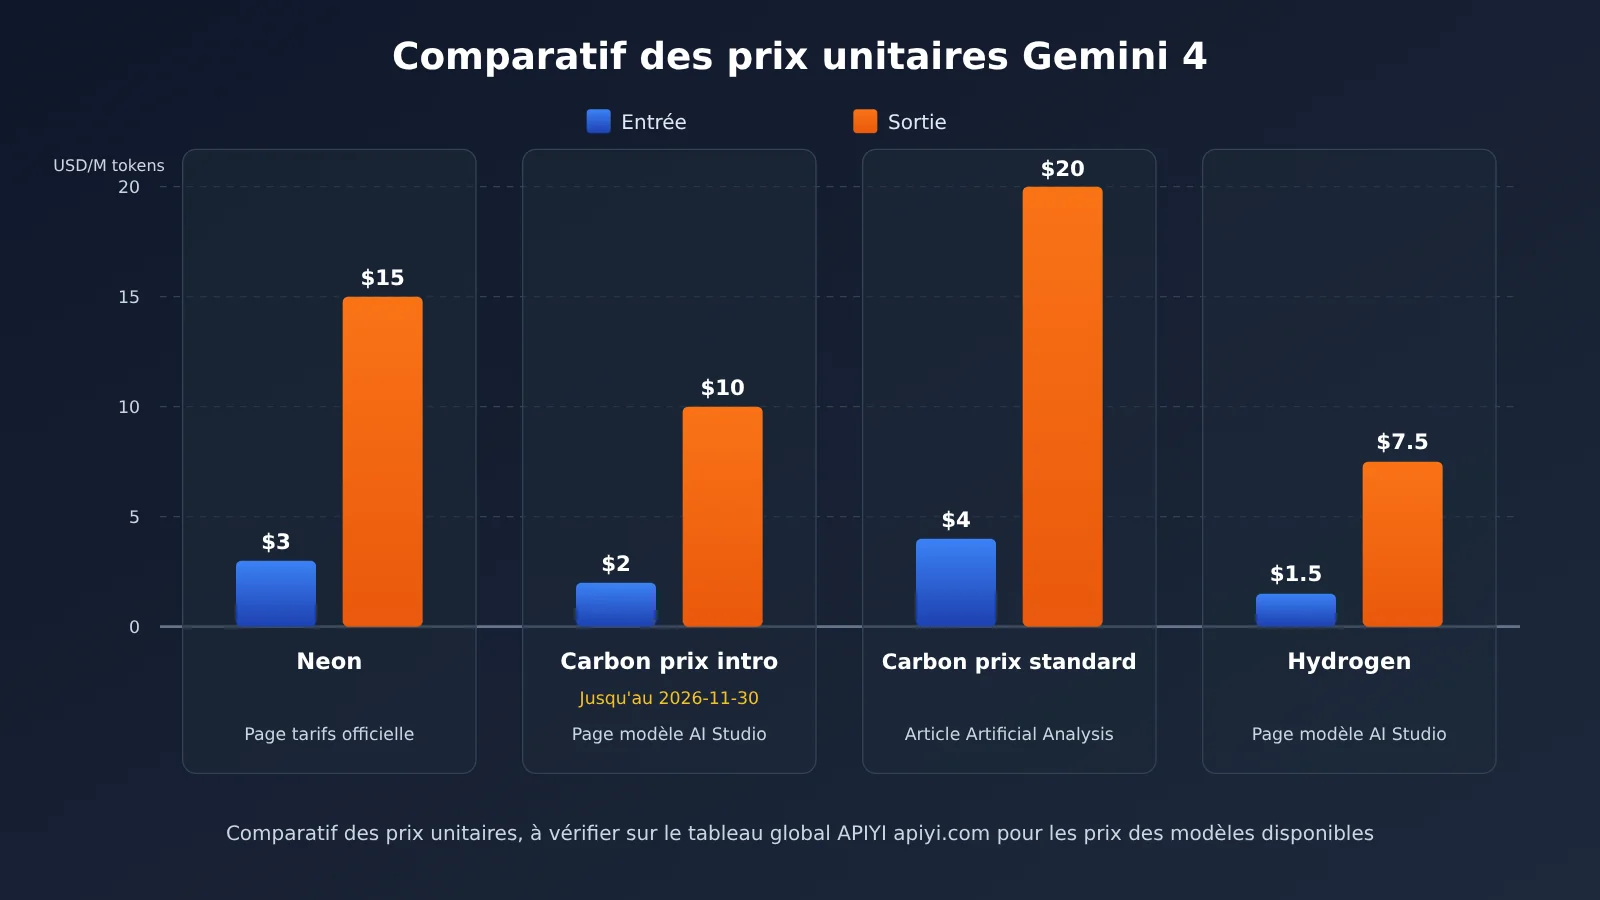
Neon se situe entre Hydrogen et Carbon dans la famille. D’après le blog de Google, Carbon prend en charge les tâches longues les plus difficiles, Hydrogen l’exécution rapide au quotidien, et Neon se place à mi-chemin, pour les processus complexes à haute fréquence. Les prix unitaires suivent cet ordre, mais Carbon dispose d’un tarif de lancement et d’un tarif standard, qu’il faut distinguer.
| Modèle | Entrée / 1M | Sortie / 1M | Base tarifaire et source |
|---|---|---|---|
| Gemini 4 Neon | 3.00 USD | 15.00 USD | Page de tarification AI Studio, prix officiel affiché |
| Gemini 4 Carbon (tarif de lancement) | 2.00 USD | 10.00 USD | Page des derniers modèles AI Studio, mentionné jusqu’au 2026-11-30 |
| Gemini 4 Carbon (tarif standard) | 4 USD | 20 USD | Tarif standard cité dans l’article Artificial Analysis |
| Gemini 4 Hydrogen | 1.50 USD | 7.50 USD | Page des derniers modèles AI Studio |
À partir de ces chiffres, l’article d’Artificial Analysis donne deux ratios : le 3/15 de Neon est inférieur de 25 % au tarif standard 4/20 de Carbon ; par rapport au tarif promotionnel 2/10 de Carbon valable jusqu’au 30 novembre, le prix unitaire de Neon est supérieur de 50 %. Les deux ratios sont valables ; la différence tient seulement au jeu de tarifs Carbon utilisé pour la comparaison.
Les remises de cache ont aussi deux versions. La page modèle d’Artificial Analysis indique une remise de cache de 95 % pour Neon et de 90 % pour Carbon. Dans le tableau récapitulatif APIYI, la lecture de cache de gemini-4-carbon est à 0.1 USD, ce qui correspond à 5 % d’une entrée à 2 USD. Ces deux chiffres viennent de pages différentes ; cet article les reprend tels quels, sans les convertir ni les uniformiser.
Prise en main rapide du tarif de Gemini 4 Neon
Voici comment procéder en quatre étapes : appliquer d’abord les trois grilles officielles, estimer ensuite l’impact du niveau de réflexion sur la sortie, comparer ensuite avec le tableau récapitulatif d’APIYI pour les modèles de la même famille déjà disponibles, et enfin vérifier le statut de disponibilité de Neon lui-même.
Première étape : calculer un appel avec les trois grilles officielles
Le calcul est simple : coût d’entrée = tokens d’entrée non mis en cache ÷ 1000000 × 3 ; coût du cache = tokens d’entrée mis en cache ÷ 1000000 × 0.15 ; coût de sortie = tokens de sortie (réflexion incluse) ÷ 1000000 × 15. La somme des trois termes donne le coût de cette requête.
- Exemple sans cache : 1000000 tokens en entrée, 100000 tokens en sortie. Entrée 1000000 ÷ 1000000 × 3 = 3 dollars, sortie 100000 ÷ 1000000 × 15 = 1.5 dollar, soit 4.5 dollars au total.
- Exemple avec cache touché : toujours 1000000 tokens en entrée, dont 800000 tokens correspondent à un préfixe partagé déjà en cache. La partie en cache : 800000 ÷ 1000000 × 0.15 = 0.12 dollar ; les 200000 tokens non mis en cache : 0.6 dollar ; la sortie reste à 1.5 dollar, soit 2.22 dollars au total.
- Même volume de tokens avec le tarif de lancement de Carbon : 1000000 × 2 plus 100000 × 10, soit 3 dollars au total ; avec le tarif standard de Carbon 4/20, 6 dollars au total ; avec Hydrogen 1.5/7.5, 2.25 dollars au total.
À noter que, pour une même tâche, le nombre de tokens produits par les différents modèles n’est pas identique. L’article d’Artificial Analysis indique que la sortie de Neon sur une tâche unique dépasse d’environ 15 % celle de Carbon. Une comparaison à volume de tokens égal ne montre donc que l’écart de prix unitaire ; la facture réelle doit encore être multipliée par la consommation de tokens propre à chaque modèle.
Étape 2 : estimer l’effet du niveau de réflexion sur le palier de sortie
Le niveau de réflexion détermine la taille du palier de sortie. Le blog de Google (auto-déclaré) indique seulement que plus le niveau est élevé, plus il y a de tokens, sans donner le nombre exact de tokens par niveau. La page modèle d’Artificial Analysis fournit le temps par tâche pour terminer l’indice à chaque niveau, ce qui constitue une preuve indirecte du principe « plus la réflexion est profonde, plus le processus est long ».
| Niveau de réflexion | Par défaut ? | Durée par tâche (page modèle Artificial Analysis) | Vitesse de sortie |
|---|---|---|---|
low |
Non | 3.7 minutes | 97 token/s |
medium |
Non | 8.3 minutes | 101 token/s |
high |
Oui (guide développeur) | 14.8 minutes | 101 token/s |
xhigh |
Non | 21.5 minutes | 110 token/s |
Dans l’exemple de calcul de la première étape, si le niveau de réflexion plus élevé fait passer la sortie de 100000 tokens à 200000 tokens, le palier de sortie passe alors de 1.5 dollar à 3 dollars. L’augmentation réelle dépend de votre tâche ; je vous conseille de tester plusieurs niveaux sur vos propres invites, puis de regarder le champ usage renvoyé avant de fixer le niveau par défaut.
Étape 3 : comparer les modèles de la même famille dans le tableau récapitulatif APIYI
Ouvrez le tableau récapitulatif APIYI docs.apiyi.com/models.md (page indiquée comme mise à jour le 2026-11-16 09:39, UTC+8), ou interrogez l’API de tarification api.apiyi.com/api/pricing (requête du 2026-11-19, version shell-api-modelmak-v1, 285 modèles au total) pour voir les prix catalogue des modèles déjà disponibles de la famille Gemini 4.
| ID du modèle | Entrée / 1M | Lecture cache / 1M | Sortie / 1M | Point de terminaison | Plateforme disponible |
|---|---|---|---|---|---|
gemini-4-carbon |
2 dollars | 0.1 dollar | 10 dollars | chat, gemini | APIYI apiyi.com |
gemini-4-hydrogen |
1.5 dollar | 0.075 dollar | 7.5 dollars | chat, gemini | APIYI apiyi.com |
gemini-4-neon |
— | — | — | — | Absent du tableau récapitulatif et de l’API de tarification |
Dans le tableau récapitulatif APIYI, les 2/0.1/10 de gemini-4-carbon correspondent au prix catalogue actuel : ils tombent bien sur le prix de lancement annoncé par Google jusqu’au 2026-11-30, et non sur le tarif standard 4/20. Côté groupes, le tableau récapitulatif indique Default et SVIP, tandis que l’API de tarification écrit default et svip. La page du modèle précise aussi une fenêtre de contexte de 1048576, une sortie maximale de 65536 et une date de coupure des connaissances en 2026-03.
L’API de tarification exprime les prix sous forme de ratios : model_ratio égal à 1 correspond à 2 dollars par million de tokens en entrée, et completion_ratio égal à 5 signifie que la sortie coûte 5 fois l’entrée. Avec cette conversion, un modèle à 2 en entrée et 10 en sortie donne bien 1 et 5, ce qui correspond au premier palier du tableau récapitulatif.
Quatrième étape : vérifier la disponibilité de Gemini 4 Neon
gemini-4-neon n’apparaît ni dans le tableau récapitulatif d’APIYI ni dans l’API de tarification, et il n’a pas non plus de page modèle dédiée. Il n’est pas encore disponible ; nous allons le mettre en ligne dès que possible. Pour les modèles et les tarifs applicables, référez-vous à la liste des modèles de la plateforme.
En attendant, vous pouvez utiliser gemini-4-carbon ou gemini-4-hydrogen, déjà disponibles, pour valider la chaîne d’appel. Voici comment procéder :
- Interface compatible OpenAI : définissez
base_urlsurhttps://api.apiyi.com/v1et renseignezmodelavecgemini-4-carbon. - API native Gemini : utilisez l’adresse
https://api.apiyi.com, avec la version d’APIv1beta. - Lisez la clé API depuis une variable d’environnement, par exemple
api_key=os.environ["APIYI_API_KEY"], et ne mettez jamais la clé en clair dans le code. - Une fois la réponse reçue, consultez les nombres de tokens d’entrée, de cache hit et de sortie dans
usage, puis vérifiez le coût avec la formule de la première étape.
🚀 Démarrage rapide : après votre inscription sur APIYI apiyi.com, vous pouvez recevoir un crédit de test gratuit. Commencez par faire tourner
gemini-4-carbonsurhttps://api.apiyi.com/v1et vérifiez l’appel ainsi que les statistiquesusage; quand Neon sera disponible, il suffira de changer le champmodel.
Les trois comptes du tarif de Gemini 4 Neon
Au-delà du prix unitaire, Google et Artificial Analysis ont chacun publié une comparaison du « coût par tâche ». Ces pourcentages reposent sur des bases différentes et ne sont pas convertibles entre eux.
| Formulation | Chiffre | Source et base de calcul |
|---|---|---|
| Coût par tâche de Neon en high par défaut inférieur à celui de Carbon | 32 % | Blog de Google, chiffre officiel auto-déclaré ; ne précise pas si Carbon est au prix de lancement ou au prix standard |
| Coût par tâche de Neon en xhigh inférieur à celui de Carbon hors remise | environ 17 % | Article d’Artificial Analysis, Carbon au prix standard de 7.76 dollars |
| Coût par tâche de Neon en high comparé à Carbon en high | moins de la moitié | Article d’Artificial Analysis, Carbon au prix standard |
| Coût par tâche de Carbon en high | 4.90 dollars | Page modèle d’Artificial Analysis, selon le prix de lancement actuel affiché sur la page |
Ces quatre chiffres proviennent de trois bases de calcul différentes : les niveaux d’effort et le prix de référence de Carbon ne sont pas les mêmes. Cet article ne fait pas la moyenne de 32 % et 17 %, et ne soustrait pas 4.90 de 7.76. Pour votre projet, la méthode la plus fiable reste d’utiliser vos propres nombres de tokens dans la formule de la première étape.
💡 Conseil de choix : un tableau de prix unitaires vous dit seulement combien coûte chaque token ; la consommation réelle d’une tâche doit être mesurée avec vos propres requêtes. Sur APIYI apiyi.com, vous pouvez appeler Carbon et Hydrogen, déjà disponibles, avec le même jeu d’invites, noter les valeurs
usage, puis estimer la fourchette de coût de Neon.
FAQ – questions fréquentes
Q1 : En combien de lignes se décompose la tarification de Gemini 4 Neon ?
D’après la page de tarification de Google AI Studio, Gemini 4 Neon comporte trois lignes : entrée à 3.00 USD par million de tokens, entrée mise en cache à 0.15 USD, sortie à 15.00 USD. Les tokens de réflexion sont comptés dans la ligne de sortie, et il n’existe pas d’offre gratuite.
Q2 : Comment faire fonctionner le cache de Gemini 4 Neon ?
Le guide développeur de Google Cloud précise que seul le cache implicite est pris en charge : il s’active automatiquement pour les préfixes partagés de plus de 4096 tokens. Le cache persistant est activé par défaut, et le cache de contexte explicite n’est pas pris en charge. Placez vos invites système fixes et vos longs documents au début du message pour améliorer le taux de correspondance.
Q3 : Les 6.44 USD affichés dans le classement correspondent-ils au prix d’une seule requête ?
Les 6.44 USD correspondent au coût moyen pondéré par tâche calculé par Artificial Analysis après avoir exécuté son index d’intelligence au niveau xhigh ; un passage de cet index comprend de nombreuses tâches longues. Pour un échange dans le chat ou une requête API, il faut appliquer les trois lignes officielles à vos propres nombres de tokens d’entrée, de cache et de sortie.
Q4 : Dans quelle mesure les niveaux de réflexion augmentent-ils le prix de Gemini 4 Neon ?
La documentation officielle ne fournit pas le nombre de tokens par niveau. Le guide développeur confirme quatre niveaux : `low`, `medium`, `high` (par défaut) et `xhigh`. Un billet de blog Google indique que plus le niveau est élevé, plus le nombre de tokens augmente. Nous recommandons de tester les différents niveaux sur vos propres tâches et de vous fier aux tokens de sortie indiqués dans `usage`.
Q5 : Comment consulter les prix de la famille Gemini 4 et appeler les modèles via APIYI ?
Ouvrez le tableau principal d’APIYI apiyi.com `docs.apiyi.com/models.md`, ou interrogez l’API de tarification : vous y verrez `gemini-4-carbon` (2/0.1/10) et `gemini-4-hydrogen` (1.5/0.075/7.5). Pour les appels, utilisez l’adresse compatible OpenAI `https://api.apiyi.com/v1`. `gemini-4-neon` n’est pas encore disponible ; nous ajouterons ce modèle dès que possible. Les modèles et les prix affichés dans la liste des modèles de la plateforme font foi.
Q6 : Comment lire le prix de Carbon sur APIYI après le 30 novembre ?
Le prix actuel de Carbon dans le tableau principal d’APIYI, 2/0.1/10, correspond au tarif de lancement de Google jusqu’au 2026-11-30. Le tableau principal ne précise aucun ajustement après cette date. À ce moment-là, fiez-vous aux données en temps réel du tableau principal et de l’API de tarification d’APIYI apiyi.com.
Q7 : Quelles limites faut-il garder en tête pour la tarification de Gemini 4 Neon ?
Il y a surtout quatre points :
– **Pas d’offre gratuite** : la page de tarification d’AI Studio précise que la facturation commence dès le premier appel.
– **Pas de cache explicite** : seul le cache implicite sur les préfixes de plus de 4096 tokens peut être utilisé.
– **Réflexion comptée dans la sortie** : un segment est limité par défaut à 65536 tokens, et la réflexion puise dans ce budget.
– **Limites de paramètres** : transmettre `thinking_budget` ou `MINIMAL` renvoie une erreur HTTP `400`.
Q8 : Pourquoi certaines pages indiquent un prix mixte de 2.21 USD pour Neon ?
Il s’agit d’un prix unique calculé par la page modèle d’Artificial Analysis selon sa méthode de prix mixte, pour faciliter les comparaisons. La facture réelle reste calculée séparément selon les trois lignes entrée, cache et sortie. Pour estimer vos propres coûts, mieux vaut utiliser directement les trois prix unitaires.
Points clés du tarif de Gemini 4 Neon
- Trois cases officielles : entrée à 3 $, lecture du cache implicite à 0,15 $, sortie à 15 $, le tout par million de tokens.
- Rattachement de la réflexion : les tokens de réflexion, les appels de fonction et la réponse finale sont tous comptés dans la case sortie.
- Règles de cache : uniquement du cache implicite ; les préfixes partagés de plus de 4096 tokens s’activent automatiquement.
- Aucun palier gratuit : la page de tarification d’AI Studio indique clairement que Neon n’a pas de palier gratuit.
- Exemple en nombres entiers : 1 million d’entrées plus 100 000 de sortie donnent 4,5 $ ; avec 800 000 en cache, on retombe à 2,22 $.
- Deux grilles pour Carbon : le tarif de lancement 2/10 est valable jusqu’au 2026-11-30, le tarif standard 4/20 provient d’un article d’Artificial Analysis.
- Vérification sur le catalogue : consultez le tableau récapitulatif d’APIYI apiyi.com pour confirmer les prix déjà en ligne de
gemini-4-carbonetgemini-4-hydrogen.
Résumé
Les points essentiels du tarif de Gemini 4 Neon :
- Trois cases calculées séparément : entrée non mise en cache à 3 $, entrée en cache à 0,15 $, sortie incluant la réflexion à 15 $.
- Le niveau de réflexion détermine la case sortie : par défaut
high; plus le niveau est élevé, plus les tokens de sortie augmentent et plus le coût grimpe. - Des bases de calcul à distinguer : les 32 % de Google, les quelque 17 % d’Artificial Analysis et les 4,90 $ proviennent de trois comptabilités différentes ; il faut aussi comprendre séparément le coût par tâche et la facture de votre requête individuelle.
Si vous voulez estimer votre propre coût, le plus simple est de lancer un jeu d’invites réelles pour obtenir l’usage, puis d’appliquer les trois tarifs unitaires. gemini-4-neon n’est pas encore disponible sur APIYI ; nous mettrons ce modèle en ligne dès que possible. Les modèles et les prix font foi selon la liste des modèles de la plateforme. Pour l’instant, nous recommandons de passer par APIYI apiyi.com pour valider le pipeline avec Carbon et Hydrogen, déjà en ligne ; il suffira ensuite de changer l’ID du modèle quand Neon sera disponible.
📚 Références
-
Pages de tarification et des derniers modèles de Google AI Studio : trois paliers tarifaires de Neon, offre gratuite et informations sur le cache, tarif de lancement de Carbon et prix de Hydrogen
- Lien :
aistudio.google.com/docs/pricing - Lien :
aistudio.google.com/docs/latest-model - Description : principale source des prix unitaires officiels utilisés dans cet article
- Lien :
-
Guide pour les développeurs Google Cloud – Gemini 4 Neon : ID du modèle, limite de contexte, niveaux de réflexion, seuil de mise en cache implicite
- Lien :
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - Description : source pour la structure des sorties et les limites des paramètres
- Lien :
-
Blog Google – Introducing Gemini 4 Neon : informations de lancement et comparaison des coûts annoncée par Google
- Lien :
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - Description : source pour la remise de 95 % sur le cache et le coût par tâche inférieur de 32 %
- Lien :
-
Fiche modèle DeepMind – Gemini 4 Neon : fenêtre de contexte, limite de sortie et date d’arrêt des connaissances
- Lien :
deepmind.google/models/model-cards/gemini-4-neon - Description : référence pour les spécifications du modèle
- Lien :
-
Article et page de modèle Artificial Analysis : coût par tâche mesuré par un tiers, temps d’exécution par niveau et prix standard de Carbon
- Lien :
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - Lien :
artificialanalysis.ai/models/gemini-4-neon - Description : l’article et la page du modèle ne reposent pas sur la même méthodologie ; il faut les citer séparément
- Lien :
-
Tableau récapitulatif et API de tarification APIYI : prix de vente et multiplicateurs des modèles disponibles
- Lien :
docs.apiyi.com/models.md - Description : pour consulter les modèles et les prix de la famille Gemini 4
- Lien :
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil d’APIYI (apiyi.com). Pour en savoir plus sur l’intégration, consultez le centre de documentation sur docs.apiyi.com.