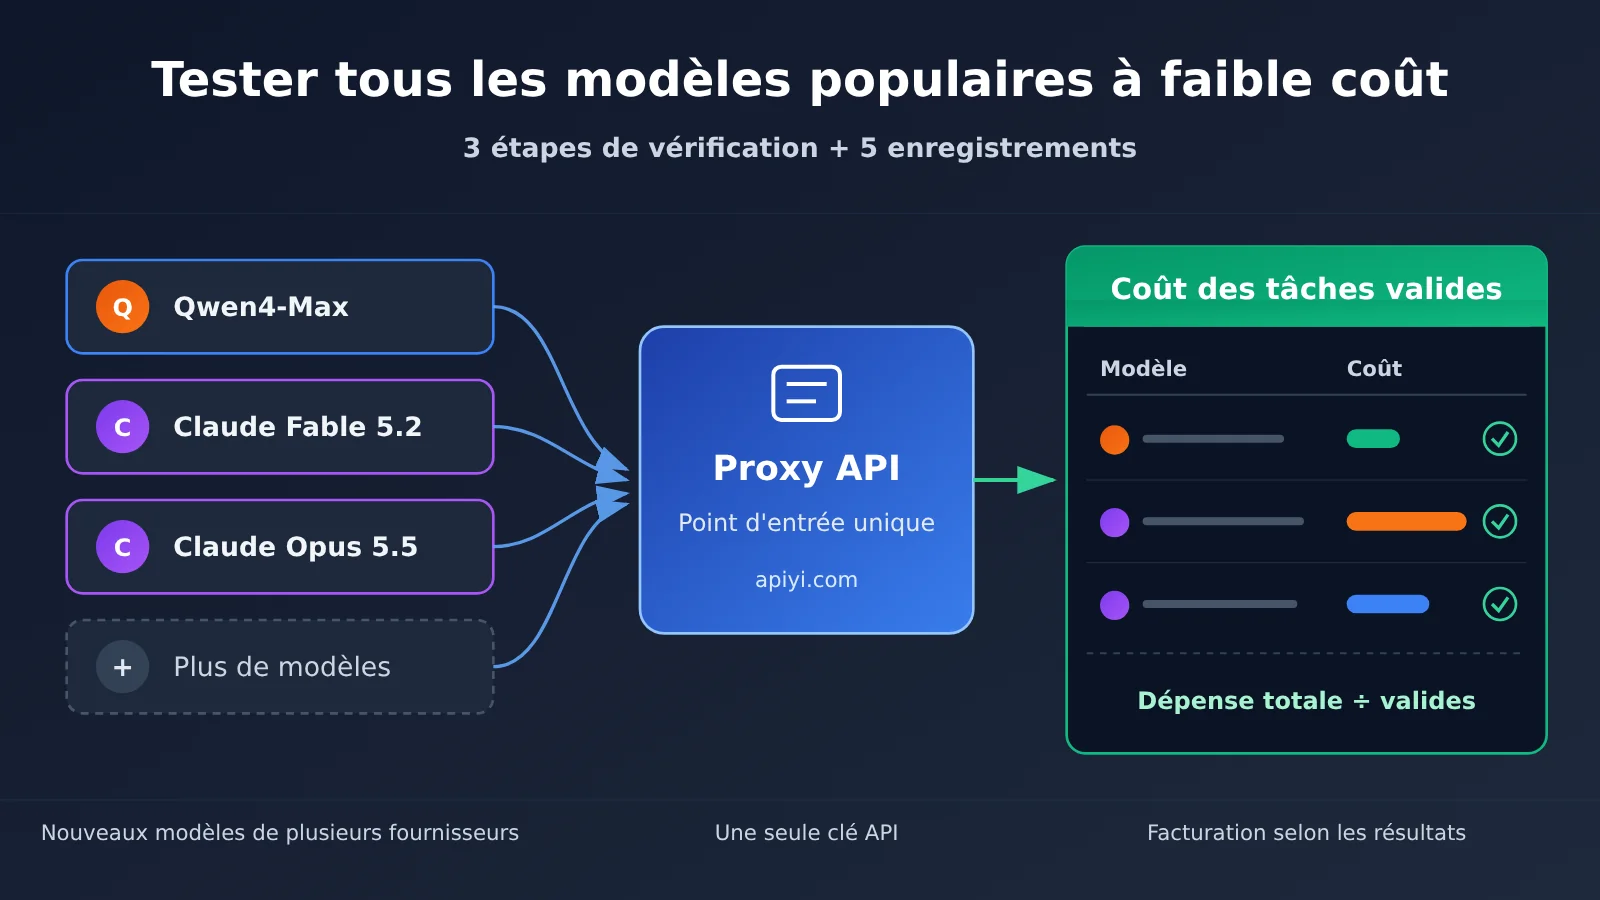
Quand les nouveaux modèles arrivent en masse, pour tester à moindre coût tous les modèles populaires, la solution la plus simple consiste à tout brancher via un point d’entrée unique de service proxy API. On évite ainsi les inscriptions chez chaque fournisseur et la configuration d’un SDK par modèle. Mais un point d’entrée unifié ne répond qu’à la question « comment se connecter », pas à celle « qui choisir ». Le bon ordre : vérifier d’abord le catalogue de modèles, les permissions de la clé et les endpoints, puis comparer, sur un même lot de tâches réelles, la qualité des sorties validées et le coût total. Cet article prend APIYI apiyi.com comme exemple pour illustrer cette procédure d’essai à petit budget, avec des critères d’acceptation.
Que retiendrez-vous de cet article ?
- Les ID exacts des modèles Qwen4-Max et Claude Fable 5.2 dans le catalogue actuel, ainsi que les endpoints et groupes disponibles.
- Un jeu de code d’intégration de base réutilisable, et la méthode pour vérifier d’abord « quels modèles cette clé peut voir ».
- Comment maîtriser le coût d’essai avec de petites tâches échantillon, l’enregistrement
usageet la facturation, puis arbitrer selon le « coût par tâche validée ».
Sommaire : la partie « Faits objectifs » liste d’abord les entrées du catalogue arrêtées au 2026-11-17, les conditions d’accès et la politique d’essai, en précisant à qui appartiennent les tarifs et les scores cités dans des sources tierces. La partie « Analyse et jugement » traite trois points : comment concevoir un échantillon à sujet identique, comment enregistrer les coûts, et l’écart entre « visible dans le catalogue », « appel réussi » et « sortie validée ». Enfin, un tableau de suivi à remplir par le lecteur.
À savoir : les notions à maîtriser avant de tester les modèles populaires via un service proxy API
| Concept | Explication rapide |
|---|---|
| Service proxy API | une passerelle qui regroupe les requêtes vers les modèles de plusieurs fournisseurs derrière un même point d’entrée de service |
| ID de modèle | la chaîne utilisée dans la requête pour désigner précisément un modèle, par exemple qwen4-max |
| Endpoint | le chemin de requête concret par lequel le service expose une capacité, comme chat, responses, messages |
| Groupe de jetons | la configuration qui définit quels canaux de modèles une clé peut emprunter et avec quel coefficient de facturation le règlement se fait |
| usage | l’enregistrement de consommation présent dans la réponse, qui sert à vérifier les tokens réellement consommés lors de l’appel |
| Lecture du cache | la réutilisation d’un préfixe d’entrée déjà traité, dont le tarif peut différer de celui d’une nouvelle entrée |
| Coût d’une tâche conforme | le total des dépenses de toutes les tentatives ÷ le nombre de tâches ayant finalement satisfait aux critères d’acceptation |
Aperçu des impacts : ce que tester des modèles via un service proxy API change selon les profils
- Développeurs qui se connectent pour la première fois : une Base URL et une clé API suffisent pour changer de modèle, sans avoir à reconfigurer comptes et SDK sur plusieurs plateformes.
- Équipes ayant déjà une activité en production : elles peuvent tester de nouveaux modèles avec leurs propres critères de conformité, sans dépendre des conclusions des classements publiés par d’autres ; mais l’appel d’outils, la vision, le raisonnement et les autres paramètres doivent tout de même être adaptés séparément.
- Utilisateurs individuels sensibles au budget : commencez par limiter le nombre de tâches et la longueur des entrées, puis faites vos comptes en fonction des « sorties utilisables ». Ne vous fiez pas au seul prix par million de tokens.
Faits objectifs : le catalogue actuel des modèles populaires du service proxy API et ses conditions d’accès
Ce que contient le catalogue : les entrées qwen4-max et claude-fable-5-2
Le registre de modèles lisible par machine publié par APIYI (docs.apiyi.com/model-registry.json) déclare comme source de données l’interface de tarification de la plateforme, avec une date de génération du 2026-11-17T07:54:33Z. Ce tableau contient 285 enregistrements de modèles. À noter : il s’agit du nombre d’entrées du catalogue, et non du nombre de modèles réellement disponibles pour un compte donné. Les trois entrées concernées par cet article sont les suivantes :
| ID exact du modèle | Point de terminaison du catalogue | Groupes (ID machine) | Prix catalogue : entrée / sortie / lecture du cache (USD par million de tokens) |
|---|---|---|---|
claude-fable-5-2 |
chat / messages | ClaudeCode / ClaudeCodeReverse / ClaudeOfficial / default / svip | 8 / 40 / 0,2 |
claude-opus-5-5 |
chat / messages | ClaudeCode / ClaudeCodeReverse / ClaudeOfficial / default / svip | 4 / 20 / 0,2 |
qwen4-max |
chat / responses / messages | ClaudeCode / CodexResponses / default / svip | 1,5 / 4,5 / 0,075 |
Les prix ci-dessus sont ceux du catalogue au 2026-11-17 ; ils ne correspondent pas à ce qu’un compte paie réellement, car le règlement effectif dépend aussi de facteurs comme le groupe de jetons. Par ailleurs, des blogs et d’anciennes annonces ont affirmé que ces deux modèles « n’étaient pas encore disponibles ». Ce type de propos ne reflète que l’état au moment de leur publication et ne permet pas de conclure sur la possibilité de les appeler aujourd’hui.
Le registre liste pour Fable un groupe inversé (ClaudeCodeReverse), mais les premières annonces et la FAQ ne mentionnaient pas l’ouverture de ce groupe. Cet article prend donc comme exemple le groupe default ou ClaudeCode, sans garantir que le groupe inversé soit disponible. Si vous avez besoin du canal de relais officiel, prêtez attention au groupe ClaudeOfficial de l’entrée Fable.
Comment se connecter : Base URL et vérification de la visibilité
Le guide de démarrage rapide (docs.apiyi.com/getting-started, consulté le 2026-11-17) donne la configuration de base suivante :
- Base URL du SDK compatible OpenAI :
https://api.apiyi.com/v1 - Base URL du SDK Anthropic :
https://api.apiyi.com - Première étape : appeler
GET /v1/modelspour vérifier quels modèles sont visibles avec la clé actuelle, puis choisir un endpoint compatible.
Les deux modèles prennent en charge l’endpoint chat, donc tous les exemples ci-dessous passent par les Chat Completions compatibles OpenAI. On vérifie d’abord que le modèle est visible, puis on envoie une requête minimale et on affiche le usage :
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # Point d'entrée compatible OpenAI d'APIYI
)

visible = {m.id for m in client.models.list().data}
for model in ["qwen4-max", "claude-fable-5-2"]:
    if model not in visible:
        print(f"{model}: 本密钥不可见,检查令牌分组")
        continue
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "用一句话解释什么是API中转站。"}],
        max_tokens=100,
    )
    print(model, r.usage, r.choices[0].message.content)
Quota d’essai : la page de démarrage rapide actuelle fait foi
La page de démarrage rapide actuelle précise qu’un compte enregistré bénéficie d’un crédit d’essai de 0,05 USD, ce qui permet de valider un premier appel sans recharger. La mention « 3 millions de tokens offerts à l’inscription » qui apparaissait sur d’anciennes cartes n’est plus d’actualité : ce sont les règles affichées sur la page du compte qui font foi. À noter également qu’aucun appel de modèle payant n’a été effectué pendant la rédaction de cet article, et que tous les « coûts » cités ici sont des estimations basées sur les prix du catalogue, pas des factures réellement constatées.
Ce que l’interface unifiée partage — et ce qu’elle ne partage pas
D’après la documentation d’APIYI sur les capacités de génération de texte, l’interface de chat unifiée est adaptée pour comparer la partie commune d’entrée et de sortie de texte. L’historique des conversations multi-tours est organisé par l’appelant lui-même. Les capacités, les paramètres de raisonnement et les paramètres optionnels varient encore d’un modèle à l’autre : les besoins comme l’appel d’outils, l’entrée visuelle ou l’intensité du raisonnement doivent être adaptés séparément. Remplacer simplement le champ model ne dispense pas de ce travail.
Comment lire les sources tierces : tarifs et scores de classement d’OrcaRouter
Les documents en anglais consacrés récemment à ces deux modèles proviennent pour l’essentiel du blog d’OrcaRouter, un autre fournisseur de routage (publié le 16 novembre 2026). Voici les informations clés qu’on y trouve :
- Dates de disponibilité : Qwen4-Max est officiellement disponible depuis le 16 novembre 2026 ; Claude Fable 5.2 est sorti le 9 novembre 2026 ; le prétendu « Claude Fable 5.5 » n’existe pas dans la liste officielle des modèles d’Anthropic.
- Scores de classement et coût par tâche : les données d’Artificial Analysis citées dans l’article (relevées le 17 novembre 2026) indiquent que Qwen4-Max atteint un indice global d’environ 42,9, pour un coût mesuré de 3,27 dollars par tâche d’indice ; Fable 5.2, au niveau medium par défaut, obtient un indice de 56,4 pour un coût de 3,80 dollars par tâche. L’article note aussi que Qwen4-Max tend à produire un volume de tokens en sortie plutôt élevé lors des évaluations.
- Retrait des versions de préversion : les ID de préversion tels que
qwen4-max-previewcesseront d’être servis le 25 novembre 2026 à 24 h 00 (UTC+8) ; l’ID officiel conservé ensuite estqwen4-max.
Ces chiffres relèvent de ce fournisseur et des évaluations tierces correspondantes : ce ne sont ni les tarifs d’APIYI, ni les conclusions de nos propres tests. Leur intérêt est surtout méthodologique : un prix unitaire bas ne signifie pas un coût par tâche bas.
Analyser et trancher : comment tester à moindre coût les modèles populaires avec un service proxy API
D’abord définir la tâche et les critères d’acceptation, ensuite lancer un mini-échantillon sur une même question
Une entrée unifiée a fait tomber le coût d’intégration à presque zéro : le vrai coût s’est donc déplacé vers la question « quoi tester ? ». Nous conseillons de retirer de vos besoins réels 3 à 5 petites tâches, et de figer pour chacune la version de l’entrée, le critère de réussite et la base de jugement. Par exemple : « la sortie doit être un JSON analysable et contenir 5 champs », ou bien « le résumé ne doit omettre aucun des 3 chiffres du texte source ». Sans critères écrits à l’avance, on finit le plus souvent avec une seule impression en main : « celui-là a l’air meilleur ».
Ensuite, envoyez la même entrée à tour de rôle aux modèles candidats, avec une règle de jugement identique : une réponse vide, un format incorrect ou une sortie tronquée comptent comme un échec. Côté paramètres, commencez par le jeu minimal commun : seulement model, messages et max_tokens. Les besoins comme l’appel d’outils, la vision ou l’intensité de raisonnement méritent une série de tests séparée, histoire de ne pas prendre un « paramètre mal réglé » pour un « modèle qui ne tient pas la route ».
🚀 Conseil pour démarrer : le premier mini-échantillon peut se faire directement avec le crédit d’essai offert à l’inscription sur APIYI apiyi.com. Vérifiez d’abord que deux ou trois modèles candidats sont visibles et appelables avec votre clé API, puis décidez si vous rechargez pour élargir le périmètre de test.
Compter toutes les tentatives : le coût par tâche validée
Pour chaque requête, notez les tokens d’entrée, de sortie et les lectures de cache présents dans usage (si la réponse renvoie ce champ), et enregistrez aussi les nouvelles tentatives et les requêtes échouées. L’indicateur central est le suivant : coût par tâche validée = dépense totale de toutes les tentatives ÷ nombre de tâches validées. Ne compter que le coût de la tentative réussie sous-estime systématiquement les modèles « pas chers mais qui demandent plusieurs essais ».
Voici une estimation purement arithmétique basée sur les tarifs catalogue (ce n’est pas la facturation réelle : les coefficients de regroupement changent le résultat). On suppose une requête avec 2 000 tokens en entrée et 500 tokens en sortie :
| Modèle | Coût d’entrée | Coût de sortie | Estimation par requête | Environ combien de requêtes avec 0,05 $ |
|---|---|---|---|---|
qwen4-max (1,5 / 4,5) |
0,003 $ | 0,00225 $ | environ 0,0053 $ | environ 9 |
claude-fable-5-2 (8 / 40) |
0,016 $ | 0,02 $ | environ 0,036 $ | environ 1 |
Deux conclusions découlent de ce tableau. Premièrement, le crédit d’essai suffit pour vérifier « que la connexion passe », mais comparer sérieusement la qualité demande un budget plus conséquent. Deuxièmement, si un modèle produit en réalité des sorties plus longues, ou s’il faut deux tentatives pour valider une tâche, l’avantage de son prix unitaire est mangé — c’est exactement le phénomène évoqué plus haut dans les sources tierces. Il faut donc contrôler le budget à deux niveaux : plafonner d’abord avec le solde du compte et le max_tokens de chaque requête, lancer d’abord des textes courts, puis passer aux contextes longs une fois le taux de réussite confirmé.
Voici un script d’enregistrement directement réutilisable, qui écrit chaque tentative dans un CSV pour faciliter le calcul du coût par tâche validée :
Voir le script d’enregistrement d’un petit échantillon de tâches identiques
import csv, time
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

MODELS = ["qwen4-max", "claude-fable-5-2"]
TASKS = [
    {"id": "t1", "prompt": "把下面的会议记录整理为 JSON:...", "check": lambda s: s.strip().startswith("{")},
    # ajoutez 2 à 4 vraies tâches, chacune avec sa fonction de validation
]

with open("trial_log.csv", "w", newline="", encoding="utf-8") as f:
    w = csv.writer(f)
    w.writerow(["model", "task", "attempt", "prompt_tokens", "completion_tokens",
                "cached_tokens", "passed", "latency_s", "error"])
    for model in MODELS:
        for t in TASKS:
            for attempt in range(1, 3):  # une seule nouvelle tentative au maximum, les échecs sont aussi enregistrés
                start = time.time()
                try:
                    r = client.chat.completions.create(
                        model=model,
                        messages=[{"role": "user", "content": t["prompt"]}],
                        max_tokens=800,
                    )
                    text = r.choices[0].message.content or ""
                    u = r.usage
                    details = getattr(u, "prompt_tokens_details", None)
                    cached = getattr(details, "cached_tokens", 0) if details else 0
                    ok = bool(text) and t["check"](text)
                    w.writerow([model, t["id"], attempt, u.prompt_tokens,
                                u.completion_tokens, cached, ok,
                                round(time.time() - start, 2), ""])
                    if ok:
                        break
                except Exception as e:
                    w.writerow([model, t["id"], attempt, 0, 0, 0, False,
                                round(time.time() - start, 2), str(e)[:120]])
Ce que l’entrée unifiée permet d’éviter — et ce qu’elle ne permet pas d’éviter
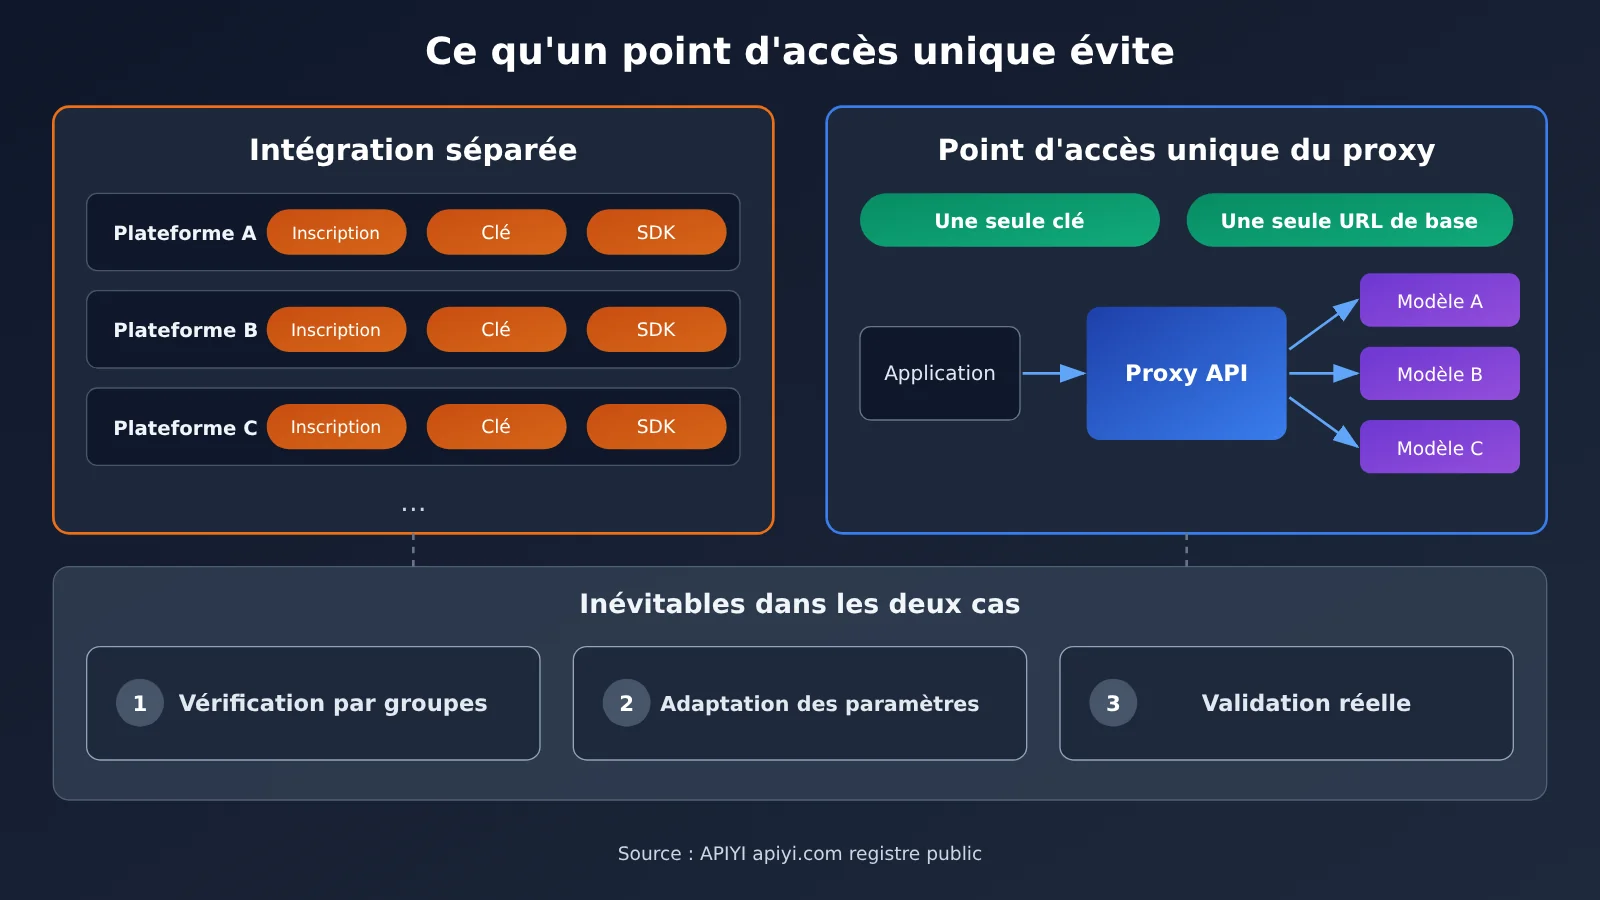
L’entrée unifiée évite de dupliquer les comptes, les clés et les configurations SDK. En revanche, elle ne permet pas d’éviter trois choses :
- Groupes et visibilité : le fait qu’un modèle figure au catalogue ne signifie pas que votre clé peut le voir ;
- Adaptation des paramètres : les paramètres non publics doivent être traités modèle par modèle ;
- Validation des résultats : voir le modèle ne signifie pas non plus que l’appel réussit ni que le résultat est conforme.
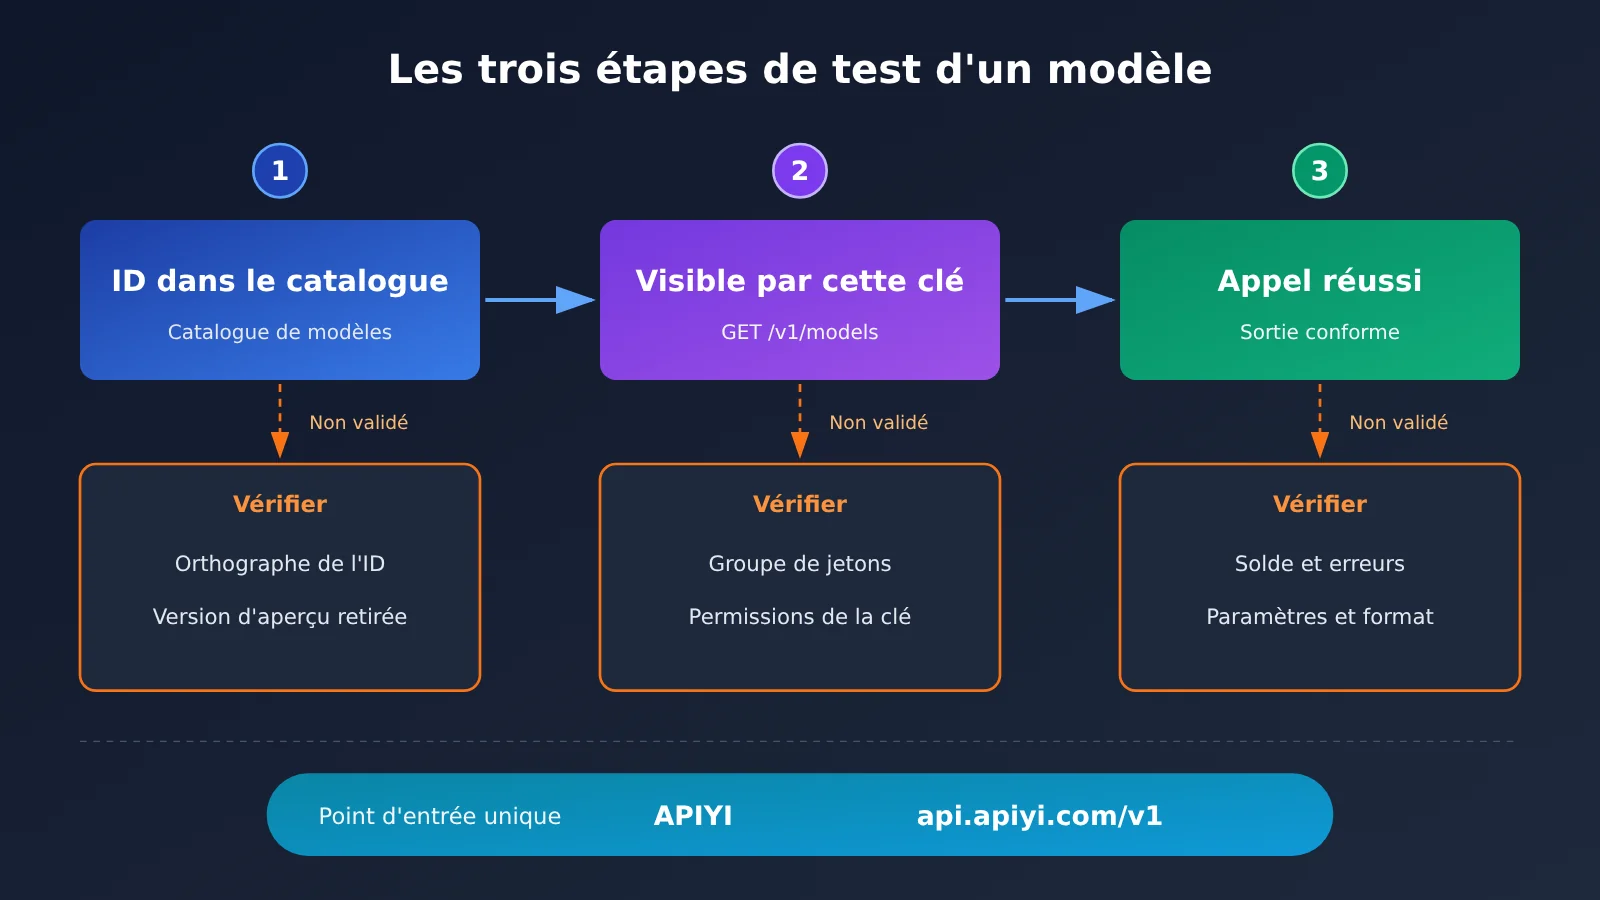
La visibilité au catalogue, la visibilité avec la clé, la réussite de l’appel et la conformité du résultat sont quatre étapes successives, et chacune doit être vérifiée séparément. Le tableau ci-dessous peut servir de liste de contrôle pendant les tests :
| Élément à vérifier | Comment vérifier | Causes fréquentes en cas d’échec |
|---|---|---|
| L’ID du modèle figure dans le catalogue | Consultez le registre public et vérifiez l’orthographe exacte de l’ID | Un ID de préversion ou un alias a été utilisé |
| Visible avec cette clé | Appelez GET /v1/models |
Le groupe de jetons n’inclut pas ce canal |
| Le point de terminaison est compatible | Comparez avec la colonne des points de terminaison du catalogue | Vous avez utilisé chat pour une capacité uniquement disponible via responses |
| L’appel aboutit | Envoyez réellement la requête la plus courte | Solde insuffisant ou paramètres non pris en charge |
| Le résultat est conforme | Vérifiez avec les règles de validation prédéfinies | Format incorrect, troncature ou réponse vide |
💡 Conseil de sélection : dans la console APIYI (apiyi.com), créez un jeton dédié aux tests et ne cochez que les groupes dont les tests ont besoin. Ainsi, la facturation et l’usage restent séparés du trafic de production, et le calcul du coût des tâches conformes après coup n’en est que plus clair.
Le tableau de conclusions qu’il vous reste à remplir
Cet article ne donne pas de classement de qualité entre qwen4-max et claude-fable-5-2, parce que nous n’avons pas fait d’expériences sur votre tâche, et les classements de tiers ne représentent pas non plus votre activité. La démarche plus fiable consiste à remplir vous-même le tableau ci-dessous après avoir fait tourner un petit échantillon, puis à décider :
| Modèle | Nombre d’essais | Nombre de résultats conformes | Coût total (selon la facture) | Coût par tâche conforme | Paramètres nécessitant une adaptation supplémentaire |
|---|---|---|---|---|---|
| qwen4-max | |||||
| claude-fable-5-2 | |||||
| Votre modèle actuel |
Deux conseils à titre indicatif, qui relèvent du jugement et non de conclusions déjà vérifiées. Premièrement, mettez aussi votre modèle actuel dans le même tableau : un nouveau modèle ne mérite un changement que s’il l’emporte nettement sur le « coût par tâche conforme » ou sur le « taux de conformité ». Deuxièmement, au début de la mise en service d’un nouveau modèle, l’ID, le prix et les limites de paramètres peuvent tous changer — l’exemple de l’ID de préversion mentionné plus haut, qui sera retiré le 25 novembre, en est une illustration. Je vous conseille d’écrire les ID de modèle dans un fichier de configuration plutôt que de les coder en dur, et de conserver une voie de repli. Si vous voulez élargir l’éventail des candidats, vous pouvez continuer à ajouter de nouveaux modèles via le point d’entrée unifié d’APIYI apiyi.com, et simplement relancer la même série de tâches avec les mêmes règles de jugement.
Les classements et les catalogues ne peuvent que vous dire quels modèles méritent un essai ; quel modèle convient vraiment à votre activité, c’est le tableau que vous aurez rempli de vos propres mains qui vous le dira. Comme l’écrivait Lu You dans « Lire de nuit en hiver pour instruire mon fils Ziyu » : « Ce qu’on apprend sur le papier reste toujours superficiel ; pour connaître vraiment une chose, il faut la pratiquer soi-même. »