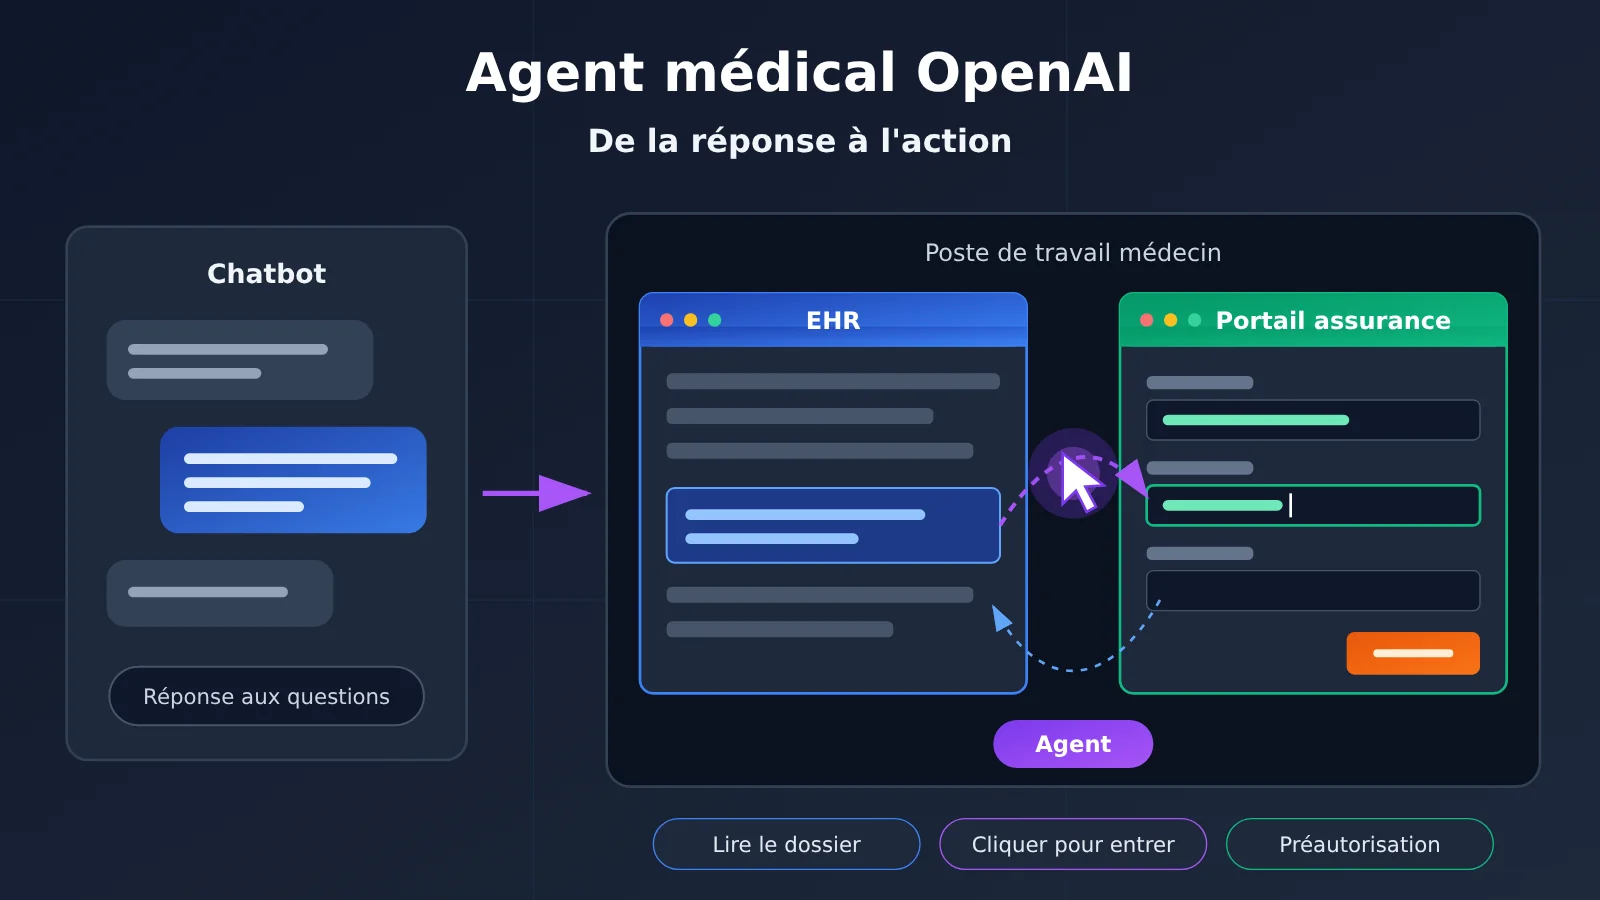
Le progrès décisif de l’Agent médical Computer-use d’OpenAI, c’est sa capacité à entrer dans les systèmes logiciels déjà utilisés par les établissements de santé, à lire le dossier médical longitudinal d’un patient et, à partir de là, à préparer des comptes rendus médicalux, des brouillons d’ordonnance, des réponses aux patients et des documents de préautorisation d’assurance. La valeur de l’IA s’étend désormais de la réponse à des questions spécialisées à l’exécution de véritables processus métier. Le point de concurrence de l’IA médicale évolue lui aussi : il ne se limite plus au questions-réponses médicales, mais pénètre le flux de travail clinique et administratif lui-même. Il faut souligner que, dans les démonstrations et les cas publics, ces documents passent toujours par la validation d’un médecin ou d’un membre du personnel ; l’IA ne dispose pas, de manière autonome, du droit de prescrire ni du pouvoir de décision médicale.
Que vous apprendrez en lisant cet article ?
- Dans la démonstration MRI, la chaîne complète d’opérations de l’Agent, de la lecture du dossier médical à la préparation de la demande de préautorisation.
- Les critères d’évaluation propres à chacun des trois chiffres — 99% de sécurité, 93% d’approbation forte des médecins, 94.3% de rubric points — ainsi que leur différence avec les résultats de l’article Stanford HealthAdminBench.
- À quelle étape se situent respectivement CVS Health, Cigna, Abridge et Ambience : démonstration synthétique, déploiement en production ou développement.
- Comment séparer le pouvoir de validation clinique du pouvoir d’exécution de l’Agent, et comment les développeurs doivent calculer le coût complet d’un Agent.
Sommaire
La partie factuelle suit l’ordre suivant : d’abord restituer ce qu’OpenAI a fait faire à l’IA cette fois-ci ; ensuite comparer les différences entre Chatbot et Computer-use Agent ; puis décomposer le sens des scores d’évaluation ; ensuite passer en revue les modalités de déploiement d’entreprises comme CVS, Cigna, Abridge et Ambience ; enfin présenter les mécanismes de contrôle des risques de l’Agent médical. La partie analyse et jugement abordera pourquoi le secteur médical a particulièrement besoin de cette capacité, comment développeurs et établissements de santé doivent arbitrer, et ce que Computer Use signifie pour l’ensemble de l’industrie des applications d’IA.
À savoir : mémo des concepts liés aux agents médicalux
| Concept | Brève explication |
|---|---|
| Computer Use | Capacité à accomplir une tâche en observant et en manipulant l’interface d’un logiciel (captures d’écran, clics, saisie de texte) |
| EHR | Système de dossier de santé électronique, le logiciel central où les hôpitaux stockent les informations sur les consultations, les médicaments, l’imagerie, etc. |
| Payer Portal | Portail de l’assureur payeur, où les établissements de santé soumettent les préautorisations et vérifient l’éligibilité à l’assurance |
| Prior Authorization | Préautorisation : certains examens ou traitements doivent être approuvés par l’assureur avant d’être réalisés |
| MCP | Protocole standard servant à découvrir et à appeler des outils externes |
| RPA | Automatisation de processus répétitifs au moyen de règles ou de scripts préconfigurés |
| Rubric points | Points de notation découpés selon les règles d’évaluation, mesurant la réalisation de certaines exigences |
| Taux de réussite de bout en bout | Proportion de tâches complètes qui satisfont à toutes les conditions de succès |
| Trace | Preuves de trajectoire enregistrant le déroulement de l’exécution, les actions effectuées et l’état de l’interface |
| BAA | Business Associate Agreement (accord de partenaire commercial), qui précise la responsabilité du prestataire dans le traitement des informations de santé protégées (PHI) |
| RBAC | Contrôle d’accès basé sur les rôles, qui attribue selon le poste les données et les opérations accessibles |
Aperçu rapide de l’impact des agents médicaux
- Développeurs et responsables techniques : l’enjeu n’est plus de savoir si le modèle sait répondre correctement à des questions médicales, mais de valider, tâche par tâche, le mécanisme d’exécution, le taux de réussite de bout en bout et le coût complet. Les captures d’écran comptent comme des entrées d’images, et les appels multi-tours, les outils et l’environnement d’exécution sont tous facturés : on ne peut donc pas se contenter de regarder le prix unitaire des Token de texte.
- Établissements de santé et responsables de workflows : il faut savoir distinguer ce qui relève d’une démo sur données synthétiques, d’une évaluation fournisseur, d’un pilote en entreprise ou d’un cas réel en production. Au moment du déploiement, il faut aussi mettre en place une validation humaine, une configuration des droits et des journaux d’audit. On ne peut pas prendre l’effet d’une démo comme base d’achat.
- Personnel clinique : à court terme, ce qu’il ressentira le plus probablement, c’est une baisse de la charge administrative, par exemple la préparation des dossiers de préautorisation ou la recherche d’informations entre plusieurs systèmes. Le jugement clinique et la responsabilité de la signature restent entre les mains du médecin.
Les faits : qu’a réellement publié OpenAI avec son agent médical cette fois-ci ?
Qu’a fait l’agent médical d’OpenAI avec l’IA cette fois-ci ?
Le 16 novembre 2026, OpenAI a publié de nouvelles avancées sur son agent informatique destiné aux équipes de santé. L’entreprise a aussi dévoilé les résultats d’évaluation de workflows cliniques et administratifs, ainsi que des retours d’expérience menés avec CVS Health, Abridge, Ambience et Cigna Healthcare. Pendant HLTH 2026, Karan Singhal, responsable de l’IA santé chez OpenAI, a également présenté ces évolutions.
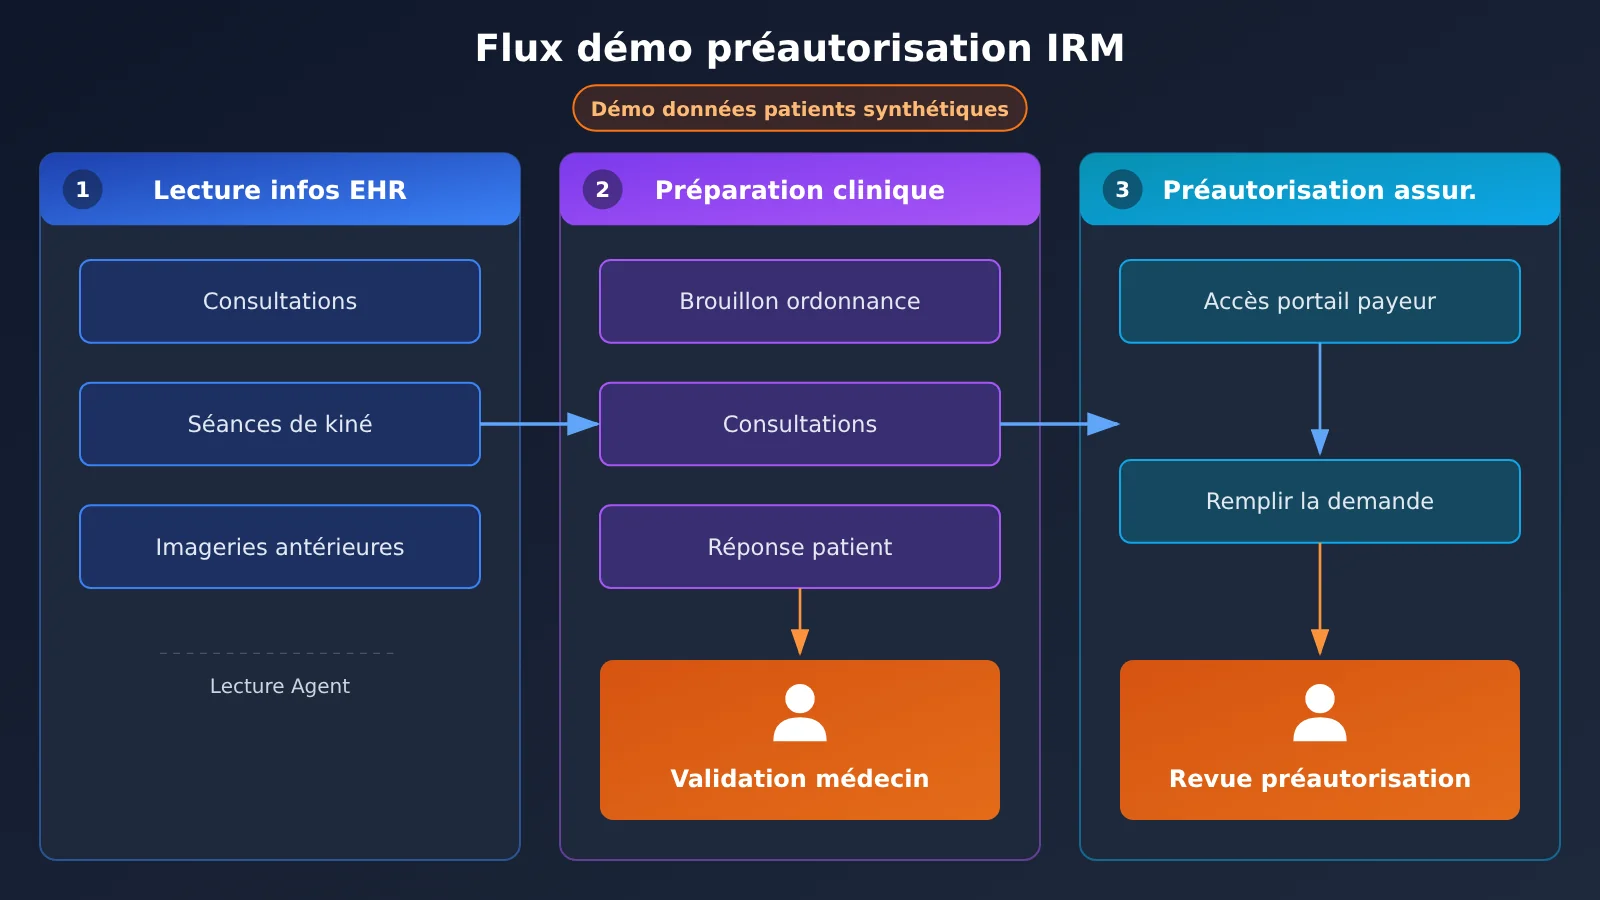
L’exemple le plus parlant de ce changement reste le workflow IRM présenté par OpenAI. Un patient écrit à son médecin pour une douleur au bas du dos ; le médecin envisage de faire passer une IRM. L’agent réalise ensuite trois étapes entre le EHR et le portail de l’assureur :
- Lecture des informations du EHR : consulter l’historique des consultations du patient, les notes de physiothérapie et les examens d’imagerie antérieurs.
- Préparation des documents cliniques : rédiger la demande d’IRM, le compte rendu de la consultation et la réponse au patient, en laissant le médecin valider l’ensemble.
- Préautorisation d’assurance : repartir du même dossier patient, se connecter au portail de l’assureur et préparer la demande de préautorisation de l’IRM, puis la confier au personnel chargé des préautorisations pour validation.
À noter : cette démonstration s’appuie sur des données de patients synthétiques (Synthetic Patient Data), et non sur des opérations menées en production sur de vrais patients. Elle illustre une chaîne de capacités, pas le processus qu’un hôpital aurait déjà appliqué à de vrais dossiers.
L’équipe a aussi présenté un cas de conseil sur les médicaments après une fracture chez un enfant. La famille demande la posologie de l’ibuprofène pour l’enfant ; l’agent consulte les notes de consultation et les examens d’imagerie, lit le poids inscrit dans le dossier médical ainsi que la dose administrée au cabinet, puis rédige à partir de là une notice de prise du médicament, des consignes pour les soins du plâtre et les symptômes d’alerte qui doivent conduire à une consultation en urgence. Il enregistre le compte rendu médical comme non signé et la réponse à la famille comme brouillon non envoyé, avant la validation finale du médecin. Le PSA élevé et le renouvellement de digoxine (Digoxin refill) figurent aussi parmi les types de tâches de l’EHR Inbox, mais l’équipe n’a pas publié le déroulé complet des opérations ni de score indépendant pour ces deux catégories.
Du Chatbot à l’Agent médical Computer-use : qu’est-ce qui change ?
Le chatbot médical traditionnel répond avec des connaissances générales ; la génération de documents médicaux peut produire un brouillon, mais il faut encore qu’un humain copie son contenu dans le système. Ce qui distingue un Agent Computer-use, c’est qu’il entre directement dans les logiciels existants au moyen d’une boucle « capture d’écran → planification → clic ou saisie → nouvelle capture pour vérifier », et qu’il accomplit des tâches en plusieurs étapes en traversant différentes applications, avec la possibilité de modifier l’état métier dans le logiciel.
| Forme de capacité | Sortie principale | Touche les systèmes métier ? | Scénarios médicaaux typiques | Principaux points de risque |
|---|---|---|---|---|
| Chatbot de Q&R médicales | Réponse textuelle | Non | Recherche de connaissances médicales, récupération de preuves | Exactitude du contenu |
| Génération de documents médicaaux | Comptes rendus, brouillons de lettres | Indirect, saisie manuelle requise | Consignes de sortie, lettres de préautorisation | Contenu incohérent avec le dossier médical |
| Agent Computer-use | Opérations d’interface et changement d’état du système | Oui, opère directement sur les dossiers médicaaux électroniques (EHR) et les portails | Remplissage de préautorisation, mise à jour du statut d’adressage, extraction de données entre systèmes | Clics erronés, confusion de patients, propagation d’erreurs |
Dans l’API OpenAI, Computer Use est principalement implémenté via l’API Responses, avec prise en charge d’actions telles que click, type, scroll, keypress, drag, screenshot, etc. La documentation officielle présente deux approches : d’une part Computer Tool, où le modèle renvoie des actions souris/clavier structurées que l’application exécute ; d’autre part Code Execution, où le modèle génère du code appelant des outils comme Playwright, PyAutoGUI. Pour GPT-6 Astra, la méthode Code Execution est actuellement recommandée par la documentation officielle. Celle-ci souligne aussi un point essentiel : le fait que le modèle génère des instructions d’opération ne signifie pas que l’opération a réussi ; l’application doit exécuter l’action, puis confirmer le résultat, par exemple au moyen d’une nouvelle capture d’écran.
Que disent les résultats d’évaluation de l’agent médical d’OpenAI ?
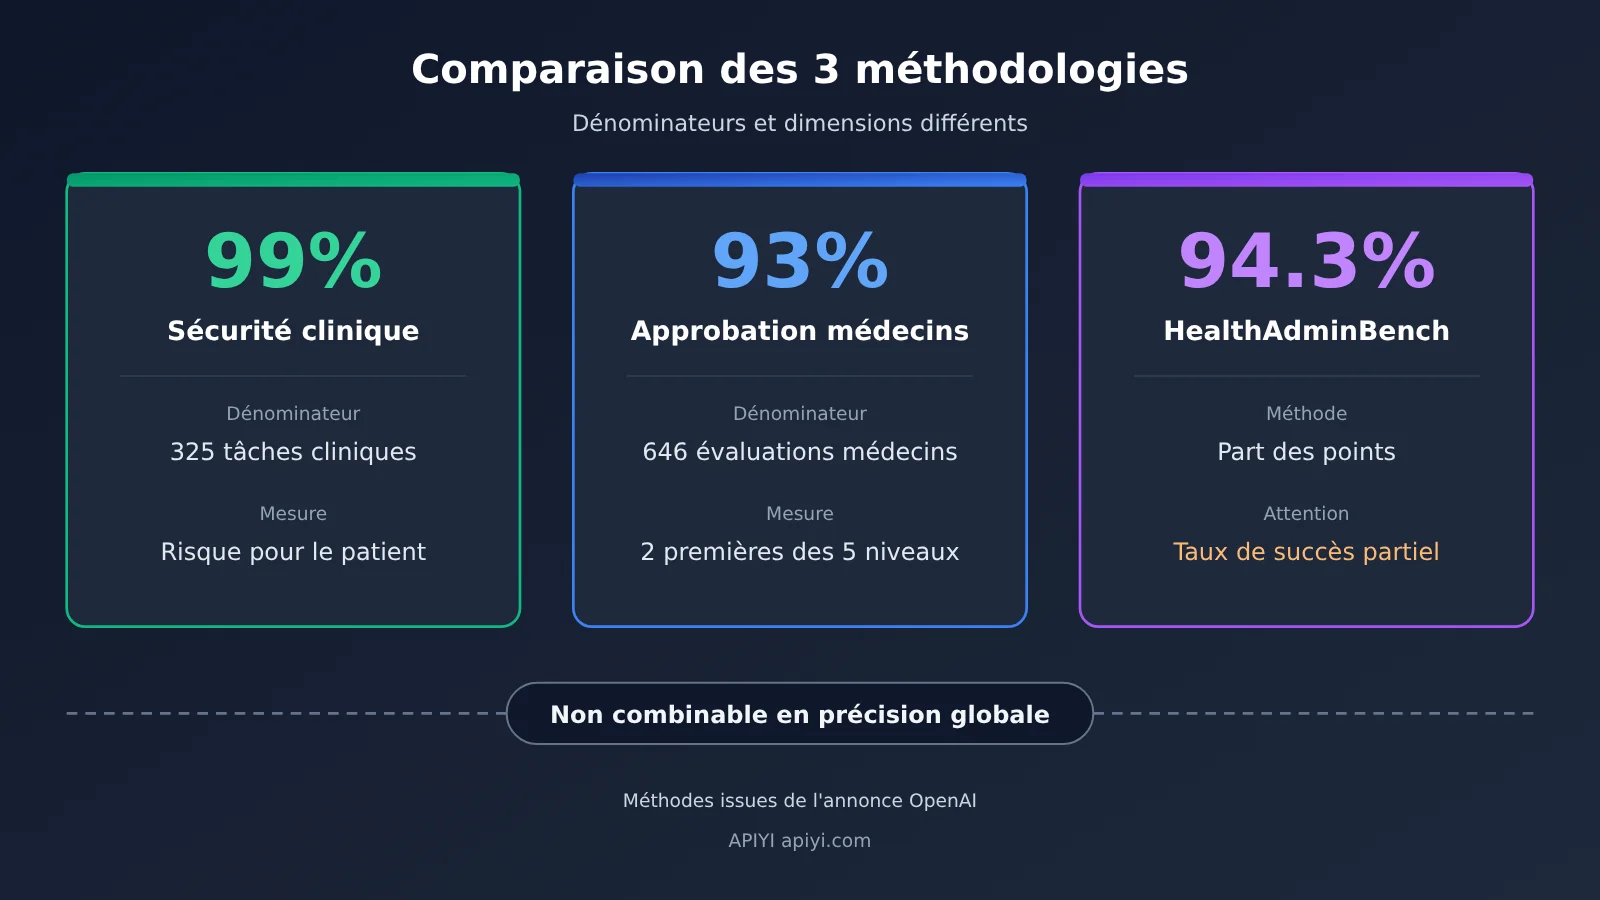
OpenAI a publié trois séries de données clés. Leurs dénominateurs et leurs dimensions d’évaluation diffèrent, on ne peut pas les fusionner en un « taux de précision global », et aucune ne correspond à un taux de précision du diagnostic médical.
| Indicateur | Valeur | Modèle évalué | Dénominateur / base de calcul | Ne pas interpréter comme |
|---|---|---|---|---|
| Sécurité des tâches cliniques | 99% | GPT-6 Astra | 325 tâches examinées ; évalue le risque de préjudice pour le patient lié à une erreur, une omission ou une action | Taux de précision du diagnostic, zéro erreur |
| Forte approbation des médecins | 93% | GPT-6 Astra | 646 évaluations ; part cumulée des mentions Very / Extremely Helpful sur une échelle à cinq niveaux | Taux de réussite des tâches, 646 médecins |
| HealthAdminBench | 94.3% | GPT-6 Astra | Part des points de la grille d’évaluation, effort de raisonnement maximal | Taux de réussite de tâches complètes |
| HealthAdminBench | 91.8% | GPT-6 Luna | Part des points de la grille d’évaluation, effort de raisonnement maximal | Taux de réussite de tâches complètes |
| Coût par tâche | $0.085 | GPT-6 Luna | Conditions d’évaluation spécifiques ; 98 % de moins qu’Astra | Tarif de déploiement en production |
L’évaluation clinique ne se limite pas au texte final généré : elle examine aussi les actions réellement exécutées par l’agent, les dossiers médicalx générés, les ordonnances et les messages destinés aux patients. Autrement dit, l’évaluation couvre à la fois la qualité du contenu et le processus d’exploitation du logiciel. Toutefois, l’annonce officielle ne précise pas le nombre de médecins distincts derrière les 646 évaluations, et son texte ne fournit ni intervalle de confiance, ni résultats tâche par tâche, ni exemples d’échec complet.
HealthAdminBench est un benchmark d’agents administratifs de santé proposé par le Shah Lab de Stanford. D’après l’article 2604.09937v1, ce benchmark comprend 135 tâches et 1698 sous-tâches, dont 1177 sous-tâches font l’objet d’une évaluation déterministe et 521 d’une évaluation par un modèle-juge ; dans l’article, le taux de réussite le plus élevé sur des tâches complètes revient à Claude Opus 4.6 CUA, avec 36.3 %, et le taux de réussite le plus élevé sur les sous-tâches revient à GPT-5.4 CUA, avec 82.8 %. La première version web du Shah Lab comptait 70 tâches et 947 points de notation ; le taux de réussite le plus élevé alors rapporté pour des tâches complètes était de 22.9 %, ce qui peut servir de point de comparaison historique.
Ces chiffres proviennent de versions, de modèles, de dates, de conditions d’exécution et d’indicateurs différents : on ne peut pas les placer dans un même classement. Les 94.3 % d’OpenAI relèvent d’une mesure en points de la grille d’évaluation, tandis que les 36.3 % de l’article correspondent à un taux de réussite de bout en bout sur des tâches complètes. Cet écart à lui seul indique que, pour un agent médical, « réussir des étapes locales » et « venir à bout de la tâche entière » peuvent être très éloignés.
Comment CVS, Cigna, Abridge et Ambience mettent-ils en œuvre les agents IA dans le secteur de la santé ?
Le degré de maturité des cas d’entreprise varie fortement. Ci-dessous, ils sont classés selon l’état publiquement divulgué. Ces chiffres proviennent principalement des déclarations des entreprises et d’OpenAI ; les médias servent à les recouper, mais cela ne équivaut pas à un audit par un tiers.
| Entreprise | Cas d’usage | Statut divulgué | Faits clés |
|---|---|---|---|
| CVS Health | Envoi de documents, orientations et consultations spécialisées entre systèmes cliniques | Flux de production | Un week-end a suffi pour résorber un arriéré de documents qui durait depuis plusieurs mois ; un autre agent traite chaque jour des dizaines de milliers d’étapes d’opérations système liées aux consultations |
| Cigna Healthcare | Intégration d’informations entre systèmes avant la gestion des soins | Déployé | Le personnel soignant devait auparavant consulter plus de 10 systèmes ; moins de 8 semaines entre le concept et le déploiement |
| Abridge | Coordination des obstacles à la sortie d’hôpital | En développement | Les médecins demandent à l’agent, via Abridge Assistant, de coordonner en parallèle l’accès aux médicaments et les soins à domicile |
| Ambience Healthcare | Demandes d’autorisation préalable auprès de l’assurance | Présentation du dispositif de gouvernance | S’arrête pour interroger le médecin lorsque le dossier médical est ambigu, et ne soumet qu’après approbation |
| Assort | Boucle complète d’orientation | Cas officiel | L’API écrit les informations d’orientation, Computer Use complète la mise à jour du statut dans l’interface Athena |
Le « dizaines de milliers de fois » chez CVS désigne la charge de travail liée aux étapes d’opérations système, et non le fait que des dizaines de milliers de décisions cliniques auraient été prises en autonomie par l’IA. CVS a également open-sourcé CUA Agent Kit (licence Apache-2.0), avec une architecture en deux phases : d’abord, un Computer-use Agent explore le workflow en langage naturel et enregistre des preuves de trace telles que captures d’écran, actions et positions cibles ; ensuite, Codex Skill fige les trajectoires réussies en code déterministe, qui est réexécuté après revue par les ingénieurs. D’après le README, la phase d’exécution déterministe ne nécessite pas de clé API du modèle.
Le cas d’Assort illustre bien le positionnement de Computer Use : Assort sait déjà écrire les informations d’orientation dans le dossier médical via l’API Athena, mais il manque encore une étape d’interface pour boucler complètement le processus. L’agent sélectionne directement le médecin d’orientation dans l’interface Athena, renseigne les détails et met à jour le statut en « Visit Scheduled » ; cette orientation disparaît alors de la liste de suivi du personnel. L’API prend en charge les opérations structurées, tandis que Computer Use complète ce que l’API ne couvre pas.
Comment un agent médical peut-il maîtriser les risques ?
Les capacités de gouvernance publiées par OpenAI comprennent le RBAC, les journaux d’audit, la configuration du périmètre d’accès des applications, l’approbation humaine avant les opérations critiques, ainsi que des mécanismes de contrôle qui cantonnent l’agent à des workflows déterminés. Les établissements de santé peuvent à tout moment suspendre l’agent et consulter le journal détaillé de ses opérations, étape par étape.
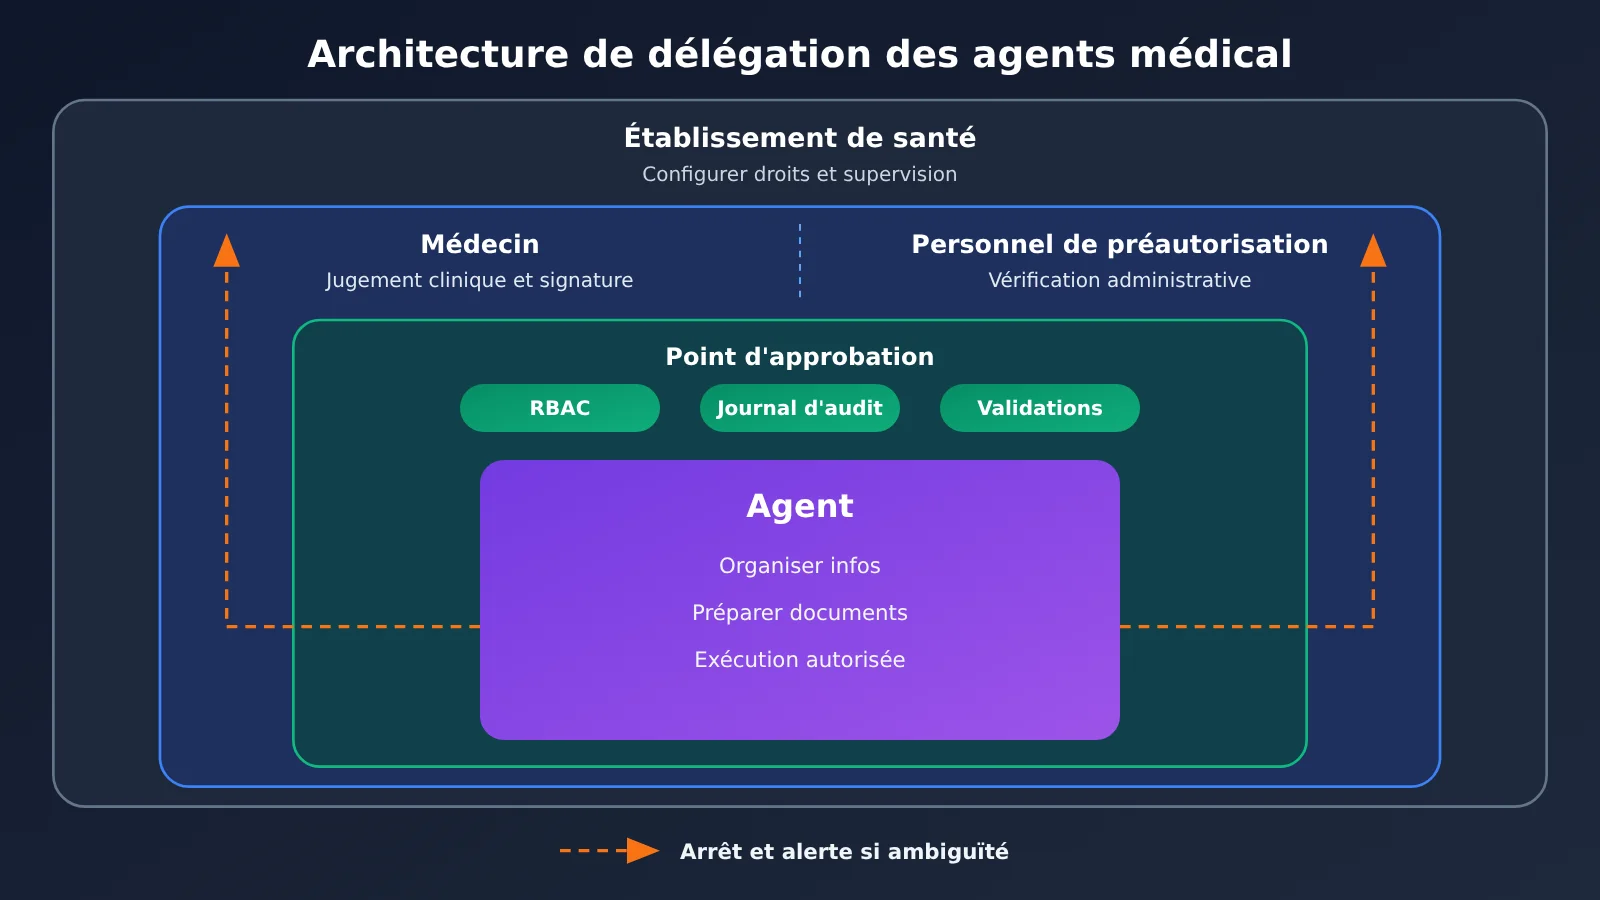
Il s’agit en réalité d’une conception de séparation des pouvoirs : l’IA se charge d’organiser les informations, de préparer les dossiers et d’exécuter les opérations dans le périmètre autorisé ; le médecin assume le jugement clinique ; le personnel de pré-autorisation assure la vérification administrative ; et l’établissement de santé définit les permissions et les processus de supervision. Les permissions de l’agent doivent être alignées sur les frontières de la responsabilité clinique.
Côté conformité des données, OpenAI indique que les données organisationnelles de ChatGPT for Healthcare ne servent pas à entraîner les modèles de base, et CVS précise de son côté que les données de production concernées restent hébergées dans son infrastructure propre. Mais pour prendre en charge des workflows conformes HIPAA impliquant des PHI, les organisations de santé doivent recourir à des services éligibles, vérifier que ces services sont couverts par un BAA signé avec OpenAI, configurer les paramètres de sécurité et les politiques de conservation des données, et restreindre par les permissions organisationnelles les enregistrements et les opérations auxquels l’agent peut accéder. Autrement dit, « prendre en charge des workflows HIPAA » ne signifie pas que « tous les appels à l’API OpenAI sont automatiquement conformes ».
Côté canaux disponibles, ces capacités sont accessibles via l’API OpenAI, ChatGPT for Healthcare, ChatGPT for Clinicians, ChatGPT Work et Codex. Les professionnels cliniques américains éligibles peuvent demander gratuitement ChatGPT for Clinicians, cette gratuité étant soumise à des restrictions géographiques et d’éligibilité. ChatGPT for Healthcare n’a pas de tarif d’abonnement fixe public et uniforme.
Analyse et évaluation : les compromis d’un agent médical et leur portée industrielle
Pourquoi le secteur médical a-t-il particulièrement besoin d’agents de type Computer Use ?
La fragmentation de l’information dans le domaine médical est particulièrement frappante. Une seule consultation peut mobiliser simultanément le DSE (dossier de santé électronique), le système d’imagerie, le système de prescription, le portail de l’assurance, le système d’orientation vers un spécialiste et la plateforme de gestion des sorties d’hospitalisation. Ces systèmes viennent souvent de fournisseurs différents et leurs interfaces sont incomplètes. La préautorisation d’une IRM en est un exemple parlant : le médecin n’a posé qu’un jugement clinique, mais le personnel doit ensuite basculer sans cesse entre le dossier médical, les comptes rendus de kinésithérapie, les données d’imagerie et le portail de l’assurance, en copiant et en téléversant des informations à répétition.
Vu sous cet angle, ce que règle Computer Use, ce n’est pas la question de savoir « si l’IA comprend la médecine », mais celle de savoir « si l’information peut circuler d’un système à l’autre ». Mon avis est que l’automatisation des tâches administratives médicales pourrait bien atteindre une échelle commerciale plus tôt que l’automatisation du diagnostic clinique. La raison : les tâches administratives sont volumineuses, très répétitives, bien délimitées, leurs résultats peuvent être vérifiés via des formulaires et l’état du système, et le risque de responsabilité reste relativement maîtrisé. Le cas de Cigna, qui a compressé en quelques secondes la recherche d’informations réparties sur plus de dix systèmes, illustre bien cette approche : « d’abord alléger la charge, sans remplacer ».
Le benchmark de Stanford met toutefois en lumière la véritable difficulté. Des travaux antérieurs ont montré que le transfert de données entre applications et le traitement de documents figurent parmi les principales sources d’échec des agents : même lorsqu’ils comprennent les informations du patient, ils peuvent se tromper au moment de téléverser un fichier, de remplir un champ ou de mettre à jour un statut. Dans un contexte médical, une erreur commise dans un système peut en outre se propager vers plusieurs systèmes en aval : c’est précisément pourquoi la validation humaine et la vérification de l’état après l’opération ne peuvent pas être omises.
Comment les développeurs évaluent-ils le coût et la faisabilité d’un agent médical ?
Pour les développeurs, la première étape ne consiste pas nécessairement à se lancer directement dans Computer Use. L’approche la plus sûre consiste à commencer par décomposer le flux de travail : pour les étapes purement textuelles comme l’extraction d’informations ou la rédaction de documents, on peut d’abord valider la qualité avec une interface de modèle standard ; pour les étapes de manipulation de l’interface, on évalue ensuite séparément le taux de réussite. L’exemple ci-dessous utilise des documents synthétiques pour valider l’étape textuelle « extraction des champs nécessaires à la préautorisation » ; il ne s’agit que d’une démonstration technique et ne constitue en aucun cas un avis médical :
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatible OpenAI d’APIYI
)

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # Se référer à la liste des modèles réellement disponibles sur la plateforme
    messages=[{"role": "user", "content": "从以下合成病历中列出影像检查预授权需要核对的字段清单:……"}]
)
print(resp.choices[0].message.content)
Voir le code complet avec le calcul des coûts en tokens
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Prix unitaire : USD / million de tokens, à adapter au modèle que vous utilisez réellement
PRICE = {"input": 0.10, "output": 0.50, "cached_input": 0.01}

def run_step(prompt: str, model: str = "gpt-4o-mini") -> dict:
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": "你只做字段抽取,不给出任何诊疗建议,信息不明确时输出 NEED_HUMAN。"},
            {"role": "user", "content": prompt},
        ],
    )
    u = resp.usage
    cached = getattr(getattr(u, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    cost = ((u.prompt_tokens - cached) * PRICE["input"]
            + cached * PRICE["cached_input"]
            + u.completion_tokens * PRICE["output"]) / 1_000_000
    return {"text": resp.choices[0].message.content, "cost_usd": round(cost, 6)}

steps = ["合成病历片段 A ……", "合成病历片段 B ……"]
total = 0.0
for s in steps:
    r = run_step(s)
    total += r["cost_usd"]
    print(r["text"])
print("模型 Token 成本合计(不含工具、环境与维护):", round(total, 6))
🚀 Conseil pour une validation rapide : avant d’intégrer officiellement un système médical, vous pouvez comparer, via APIYI (apiyi.com) et avec une seule clé API, les performances de plusieurs modèles sur des étapes textuelles telles que l’extraction de champs ou la rédaction de documents. Les nouveaux utilisateurs bénéficient d’un crédit de test gratuit, idéal pour commencer par faire tourner de bout en bout vos scripts d’évaluation et accumuler des données au niveau des tâches.
Côté coûts, voici les tarifs Standard en contexte court relevés le 17 novembre 2026 (USD/million de tokens) : GPT-6 Astra — entrée 10, sortie 50, entrée en cache 1 ; GPT-6 Luna — entrée 0.10, sortie 0.50, entrée en cache 0.01. La vitesse de traitement, la longueur du contexte et la région influencent la facturation réelle. En partant de 0.085 USD par tâche pour Luna et d’un ratio « 98 % moins cher », on peut estimer Astra à environ 4.25 USD par tâche. Ce n’est toutefois qu’une estimation, et un coût valable dans des conditions de référence uniquement : il ne doit pas être pris pour un tarif de production.
Le calcul complet des coûts doit comptabiliser séparément, à chaque tour, les entrées visuelles et textuelles ainsi que les sorties facturées, puis ajouter les appels d’outils, l’environnement d’exécution et la maintenance d’ingénierie. Si les tokens générés par les nouvelles tentatives sont déjà inclus dans le total, ne les ajoutez pas une seconde fois. L’écart de prix d’un facteur proche de 50 entre les deux gammes de modèles suggère aussi une approche par couches : confier les raisonnements complexes aux modèles les plus performants, les étapes structurées et à haute fréquence aux modèles à faible coût, et figer les processus déjà stables et éprouvés en code déterministe, comme dans CVS.
💰 Conseil d’optimisation des coûts : pour mettre en place une stratification des modèles, vous pouvez d’abord utiliser le même code compatible OpenAI sur APIYI apiyi.com pour basculer entre des modèles de prix différents, mesurer la qualité et la consommation de tokens de chaque type de sous-tâche, puis décider quelles étapes méritent un modèle à forte capacité.
| Étape de validation | Question à laquelle répondre | Preuves recommandées | Outils de référence |
|---|---|---|---|
| Partie textuelle | La qualité de l’extraction et de la rédaction est-elle stable ? | Comparaison avec des annotations manuelles, taux de déclenchement de NEED_HUMAN | Comparaison multi-modèles sur APIYI apiyi.com |
| Opérations d’interface | Quel est le taux de réussite de bout en bout ? | Captures d’écran et traces, vérification de l’état après opération | Documentation OpenAI Computer Use et environnement sandbox |
| Standardisation du processus | Quelles étapes peuvent être converties en code déterministe ? | Taux de reproduction des trajectoires réussies | Architecture à deux phases de type CUA Agent Kit |
| Gouvernance de la mise en production | Les permissions et approbations couvrent-elles les actions critiques ? | Configuration RBAC, contrôle par échantillonnage des journaux d’audit | Système de permissions et de conformité propre à l’organisation |
Agent médical et RPA : substitution ou fusion ?
Le RPA traditionnel repose sur des règles fixes et un positionnement d’interface : dès que l’interface change, le script peut devenir inopérant. Un agent computer-use, lui, sait comprendre le langage naturel, observer l’interface du moment et s’adapter aux changements, mais chaque nouvelle inférence entraîne des coûts et une variabilité des résultats. Dans une étude comparant les deux familles de technologies (DOI : 10.1080/23311975.2026.2724760), les deux processus P2 et P3 ont été exécutés 10 fois avec chaque technologie ; sur le processus P1, l’agent ne présente qu’un seul échec enregistré, écarté des statistiques ultérieures — on ne peut donc pas affirmer de façon générale que toutes les tâches ont été exécutées 10 fois. Cette étude utilise une configuration d’outils de 2025 et ne peut pas représenter directement les performances des modèles de 2026.
À mon sens, le modèle de CVS — « exploration par l’IA, consolidation en code, exécution répétée » — a le plus de chances de devenir la forme d’ingénierie dominante : l’agent se charge de découvrir et de comprendre les processus inconnus, le code déterministe répète de manière stable les processus déjà maîtrisés, l’API continue d’assurer les interactions à haute fréquence et structurées, et la validation humaine protège les points critiques. Combiner API, Computer Use, code déterministe et validation humaine est plus réaliste que de parier sur une seule de ces technologies.
Que signifie un agent médical pour toute l’industrie de l’IA ?
Le médical n’est qu’un terrain d’essai particulièrement exigeant. La fragmentation des systèmes, les exigences de conformité et les périmètres de responsabilité y sont plus stricts que dans la plupart des entreprises. Si un agent d’exécution parvient à y établir un mode de fonctionnement auditable, interruptible et aligné sur les autorisations, cette méthode pourra être transposée à l’assurance, à la finance, au secteur public et à d’autres industries tout aussi dépendantes de systèmes anciens.
Cela signifie aussi que les dimensions de la concurrence changent. Auparavant, on comparait les modèles sur leur capacité à produire de bons contenus. Demain, on les comparera plutôt sur leur capacité à aller au bout d’une tâche dans de vrais systèmes, à s’arrêter à temps en cas d’erreur et à tracer chaque étape. Pour les éditeurs de logiciels, Computer Use permet aux entreprises d’IA de participer aux workflows sans contrôler entièrement les logiciels sous-jacents. Cela abaisse le seuil d’intégration et met sous pression l’ancien modèle consistant à « attendre que les éditeurs ouvrent leurs interfaces ». Mais les interactions très fiables et à haute fréquence restent mieux adaptées aux API. Computer Use ressemble davantage à un complément qu’à un remplaçant.
Plusieurs points méritent maintenant notre attention : OpenAI publiera-t-il des données d’évaluation tâche par tâche et une configuration expérimentale complète ? La version publiée sous forme d’article de HealthAdminBench deviendra-t-elle un référentiel commun de comparaison entre acteurs ? La solution de coordination des sorties d’hôpital d’Abridge passera-t-elle du développement au déploiement ? Et davantage de données de production hospitalières pourront-elles prouver que le taux d’achèvement de bout en bout est réellement exploitable ? Tant que ces preuves ne sont pas disponibles, les démonstrations et les scores ne sont qu’un point de départ, pas une conclusion.
L’agent médical a déjà prouvé qu’il pouvait « passer à l’action ». Mais pour savoir s’il peut réellement alléger la charge clinique et administrative, il faudra examiner son taux d’achèvement de bout en bout dans de vrais workflows, sa capacité à s’arrêter en cas d’erreur et son coût à long terme. Comme le dit le proverbe anglais : The proof of the pudding is in the eating. (L’effet réel se vérifie par la pratique.)
Références
- Annonce officielle OpenAI : Advancing computer-use agents for healthcare teams
- Lien :
openai.com/index/advancing-computer-use-for-healthcare-teams
- Lien :
- Documentation d’aide ChatGPT for Healthcare : capacités du produit, BAA et plugins
- Lien :
help.openai.com/en/articles/20001046-chatgpt-for-healthcare
- Lien :
- Documentation développeur OpenAI Computer Use : Computer Tool et le parcours Code Execution
- Lien :
developers.openai.com/api/docs/guides/tools-computer-use
- Lien :
- Article HealthAdminBench : tâches et métriques de la version 2604.09937v1
- Lien :
arxiv.org/html/2604.09937v1
- Lien :
- Kit d’agent CUA de CVS Health : architecture en deux phases, exploration puis consolidation
- Lien :
github.com/cvs-health/cua-agent-kit
- Lien :
- Reportage de Fierce Healthcare : partenaires et cas d’usage de HLTH26
- Lien :
fiercehealthcare.com/ai-and-machine-learning/hlth26-cvs-health-cigna-and-ambience-collaborating-openai-test-computer-use
- Lien :
- Cambridge Dictionary : vérification de la citation du proverbe
- Lien :
dictionary.cambridge.org/us/dictionary/english/proof-of-the-pudding-is-in-the-eating
- Lien :
Auteur : équipe technique APIYI
Échanges techniques : si vous souhaitez comparer les performances de plusieurs grands modèles de langage sur la partie texte d’un agent, n’hésitez pas à visiter APIYI apiyi.com pour obtenir un quota de test. Pour plus de détails sur l’intégration, consultez le centre de documentation docs.apiyi.com.