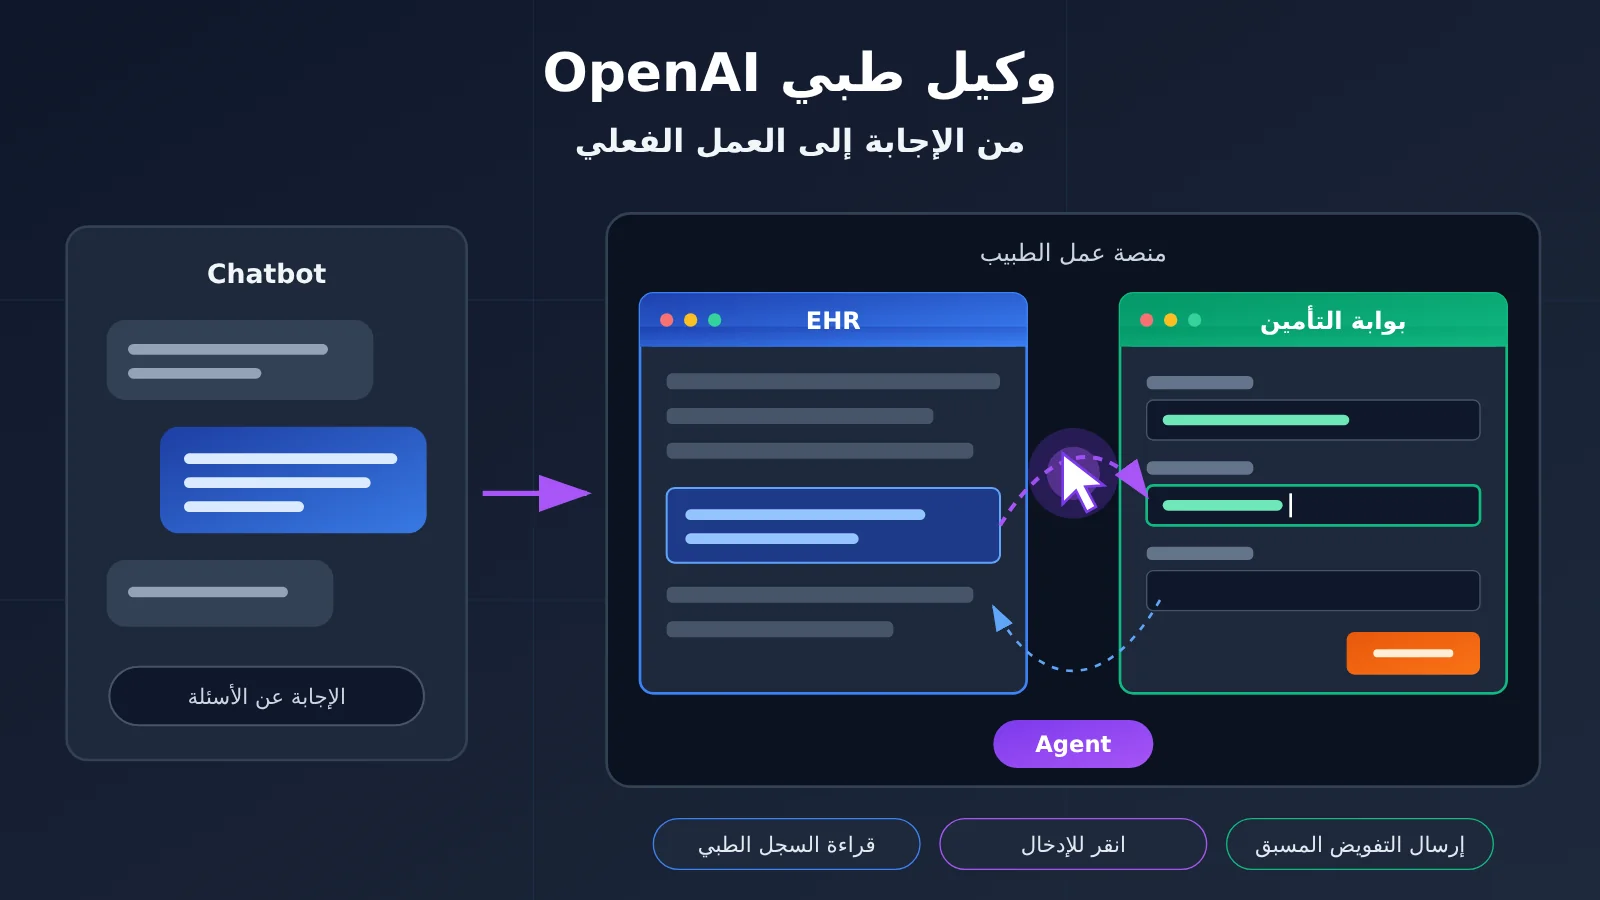
التقدم المحوري في الوكيل الطبي القادر على استخدام الحاسوب (Computer-use Agent) من OpenAI هو قدرته على الدخول إلى أنظمة البرمجيات التي تستخدمها المؤسسات الصحية بالفعل، وقراءة معلومات السجل الطبي الطويلة للمريض، ثم إعداد السجلات الطبية ومسودات الأوامر الطبية وردود المرضى ومواد التفويض المسبق من شركة التأمين بناءً على تلك المعلومات. هكذا تنتقل قيمة الذكاء الاصطناعي من الإجابة عن الأسئلة التخصصية إلى تنفيذ عمليات الأعمال الحقيقية. وبالتالي يتغيّر محور المنافسة في الذكاء الاصطناعي الطبي، فلم يبقَ محصورًا في الأسئلة والأجوبة المعرفية، بل انتقل إلى سير العمل السريري والإداري نفسه. ومن المهم التأكيد على أن هذه المواد، في العروض التوضيحية والحالات المنشورة على حد سواء، تمرّ جميعها بمراجعة طبيب أو موظف، وأن الذكاء الاصطناعي لا يملك بشكل مستقل حق وصف الأدوية أو اتخاذ القرار الطبي.
ماذا ستتعرف بعد قراءة هذا المقال؟
- في عرض MRI، سلسلة العمليات الكاملة التي ينفذها الوكيل من قراءة السجل الطبي إلى إعداد طلب التفويض المسبق.
- المعايير التي تقيسها كل مجموعة من مجموعات البيانات الثلاث: 99% للأمان، و93% لدرجة القبول العالية من الأطباء، و94.3% في rubric points، والفرق بينها وبين النتائج المنشورة في ورقة Stanford HealthAdminBench.
- أين تقف CVS Health وCigna وAbridge وAmbience: في عرض اصطناعي، أم نشر إنتاجي، أم مرحلة تطوير.
- كيف يُفصل حق الموافقة السريرية عن حق التنفيذ لدى الوكيل، وكيف ينبغي للمطورين حساب التكلفة الكاملة للوكيل.
الفهرس
تُعرض الوقائع الموضوعية بالترتيب التالي: أولاً نستعيد ما طلبت OpenAI من الذكاء الاصطناعي فعله هذه المرة؛ ثم نقارن بين روبوت المحادثة (Chatbot) والوكيل القادر على استخدام الحاسوب؛ بعدها نفكّك معنى نتائج التقييم؛ ثم نراجع طرق التطبيق لدى شركات مثل CVS وCigna وAbridge وAmbience؛ وأخيرًا نعرّف بآليات التحكم في مخاطر الوكيل الطبي. أما قسم التحليل والاستنتاج فيناقش لماذا تحتاج صناعة الرعاية الصحية تحديدًا إلى هذه القدرة، وكيف يوازن المطورون والمؤسسات الصحية بين الخيارات، وماذا يعني Computer Use بالنسبة لصناعة تطبيقات الذكاء الاصطناعي بأكملها.
للمعرفة: مرجع سريع للمفاهيم المتعلقة بالوكيل الطبي
| المفهوم | شرح موجز |
|---|---|
| Computer Use | القدرة على إنجاز المهام من خلال مراقبة واجهة البرنامج والتعامل معها (لقطات الشاشة، النقر، الإدخال). |
| EHR | نظام السجلات الصحية الإلكترونية؛ البرنامج الأساسي في المستشفى الذي يحفظ معلومات المرضى مثل الزيارات والوصفات والصور الطبية. |
| Payer Portal | بوابة جهة الدفع/التأمين، حيث تقدم المؤسسات الصحية طلبات التصريح المسبق وتتحقق من أهلية التأمين. |
| Prior Authorization | التصريح المسبق؛ بعض الفحوصات أو العلاجات تحتاج إلى موافقة جهة التأمين قبل تنفيذها. |
| MCP | بروتوكول قياسي لاكتشاف الأدوات الخارجية واستدعائها. |
| RPA | أسلوب أتمتة ينفذ العمليات المتكررة عبر قواعد أو نصوص برمجية مُعدّة مسبقًا. |
| Rubric points | نقاط تقييم مقسمة حسب قواعد التقييم، تقيس مدى تحقق بعض المتطلبات. |
| معدل النجاح من طرف إلى طرف | نسبة المهام الكاملة التي تستوفي جميع شروط النجاح. |
| Trace | دليل التتبع الذي يسجل عملية التنفيذ وخطوات العمل وحالات الواجهة. |
| BAA | اتفاقية شريك الأعمال، تحدد مسؤولية مزود الخدمة في التعامل مع المعلومات الصحية المحمية (PHI). |
| RBAC | التحكم في الوصول القائم على الأدوار؛ توزيع البيانات والعمليات المتاحة حسب الوظيفة. |
نظرة سريعة على تأثير الوكيل الطبي
- المطورون والمسؤولون التقنيون: لم يعد التركيز على ما إذا كان النموذج يستطيع الإجابة الصحيحة عن الأسئلة الطبية، بل على التحقق من آلية التنفيذ ومعدل الإنجاز من البداية إلى النهاية والتكلفة الكاملة وفقًا لمهام محددة. تُعدّ لقطات الشاشة إدخالًا صوريًا، كما أن الاستدعاءات متعددة الجولات والأدوات وبيئة التشغيل كلها تُحتسب في الفاتورة، لذا لا يصح النظر إلى سعر وحدة الـ Token النصي فقط.
- المؤسسات الطبية ومسؤولو سير العمل: يحتاجون إلى التمييز بين ما هو عرض تجريبي ببيانات اصطناعية، وتقييم من قِبل المورد، وبرنامج تجريبي داخل مؤسسة، وحالة إنتاج فعلية. وعند الإطلاق، يجب أيضًا تفعيل الموافقة البشرية وإعداد الصلاحيات وسجلات التدقيق، ولا يمكن اعتبار نتائج العرض التجريبي أساسًا مباشرًا للشراء.
- الكوادر السريرية: على المدى القصير، من المرجّح أن يشعروا بانخفاض العبء الإداري، مثل تجهيز مواد التفويض المسبق والبحث عن المعلومات عبر الأنظمة المختلفة. أما الحكم السريري ومسؤولية التوقيع فتبقى بيد الطبيب.
حقائق موضوعية: ما الذي أطلقه الوكيل الطبي من OpenAI هذه المرة
ماذا فعل وكيل OpenAI الطبي هذه المرة؟
في 16 نوفمبر 2026، أعلنت OpenAI عن تقدم جديد في وكيل يعمل مباشرة على الحاسوب، موجّه للفرق الطبية، وكشفت في الوقت نفسه عن نتائج تقييم لمسارات العمل السريرية والإدارية، وعن تجارب تعاون مع شركات مثل CVS Health وAbridge وAmbience وCigna Healthcare. وخلال فعالية HLTH 2026، قدّم كاران سينغال، مسؤول قسم الذكاء الاصطناعي الصحي (Health AI) في OpenAI، شرحًا للتقدم ذي الصلة.
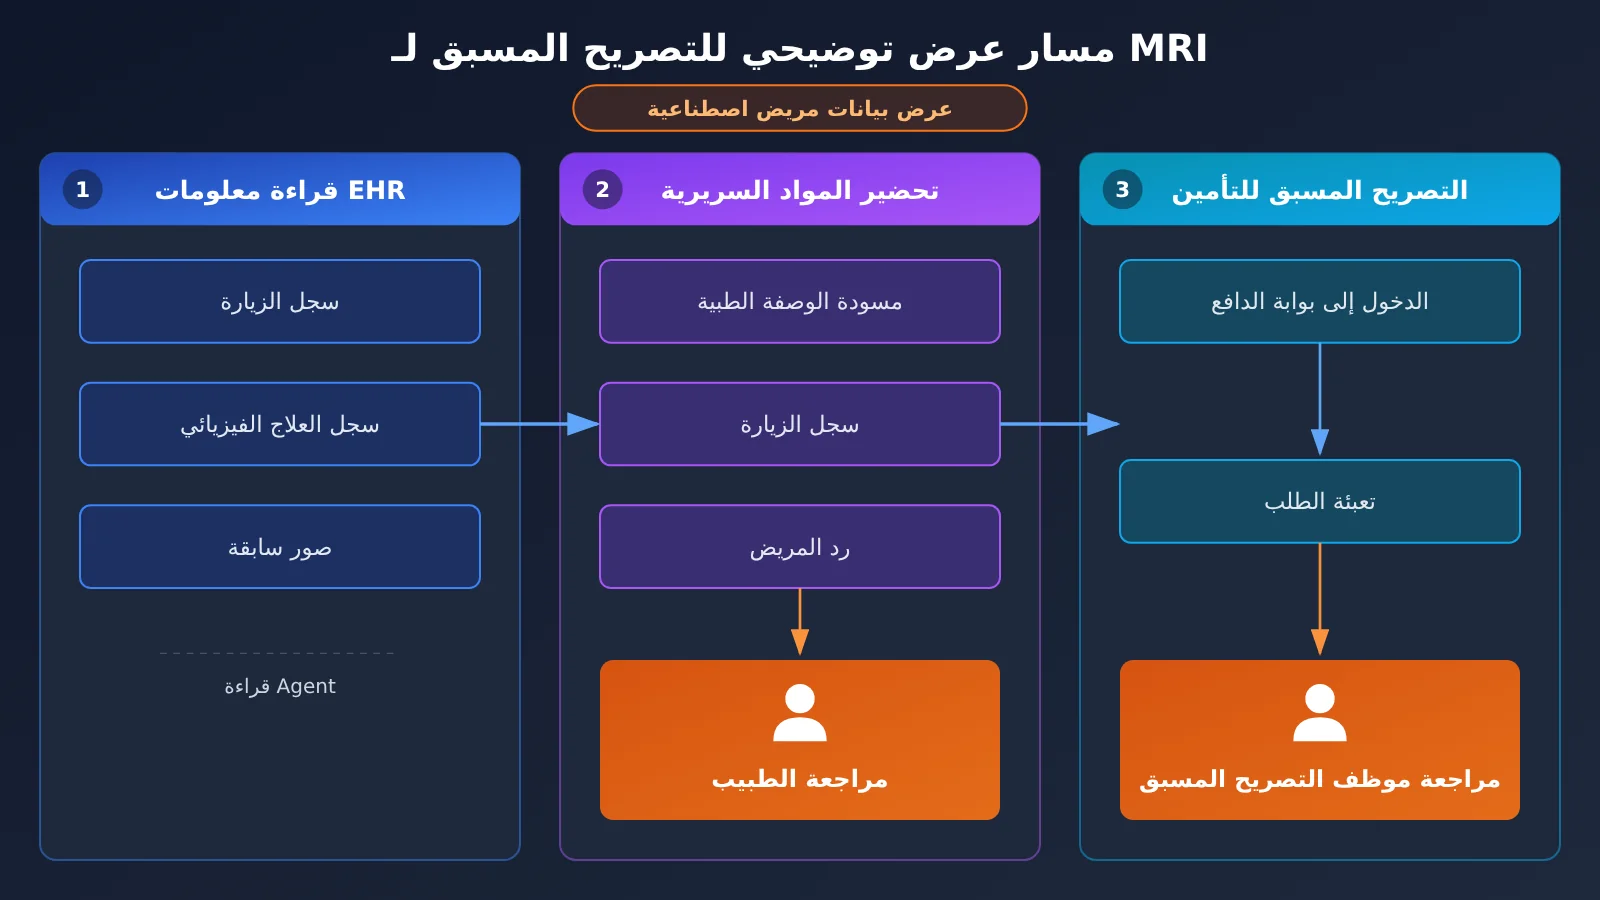
أكثر ما يوضح هذا التحول هو سير عمل MRI الذي عرضته الشركة رسميًا. أرسل مريض رسالة إلى طبيبه بسبب ألم أسفل الظهر، وكان الطبيب يفكر في طلب تصوير بالرنين المغناطيسي. بعد ذلك، أنجز الوكيل ثلاث مراحل عمل بين السجل الصحي الإلكتروني (EHR) وبوابة التأمين:
- قراءة معلومات EHR: مراجعة سجلات زيارة المريض، وسجلات العلاج الطبيعي، وبيانات التصوير السابقة.
- إعداد المواد السريرية: صياغة طلب فحص MRI، وسجل الزيارة الحالية، وردّ على المريض، وتُترك جميعها للطبيب كي يراجعها.
- التفويض المسبق للتأمين: بالاستناد إلى سجل المريض نفسه، الدخول إلى بوابة جهة دفع التأمين لإعداد طلب تفويض مسبق لفحص MRI، ثم تركه لموظف التفويض المسبق كي يراجعه.
يجدر التوضيح أن هذا العرض يستخدم بيانات مرضى اصطناعية (Synthetic Patient Data)، وليس عملية إنتاجية على مرضى حقيقيين. وهو يوضح سلسلة القدرات، ولا يعني أن أي مستشفى يعالج حالات حقيقية بهذا المسار.
عرضت الشركة أيضًا حالة استشارة دوائية بعد إصابة طفل بكسر. سأل أفراد الأسرة عن جرعة الإيبوبروفين للطفل، فاطّلع الوكيل على سجلات الزيارة وبيانات التصوير، وقرأ وزن الطفل والجرعة التي أعطتها العيادة كما هما مسجلان في الملف الطبي، ثم صاغ بناءً على ذلك تعليمات الدواء، وتعليمات العناية بالجبس، وأعراضًا تحذيرية تستدعي رعاية طبية عاجلة. وقد حفظ السجل الطبي بحالة غير موقّع، وحفظ الردّ الموجه إلى الأسرة كـمسودة غير مرسلة، ليعتمده الطبيب في النهاية. كما أُدرجت مهمتا «Elevated PSA» و«Digoxin refill» (تجديد وصفة الديجوكسين) ضمن أنواع المهام في EHR Inbox، لكن الشركة لم تنشر السجلات الكاملة لهاتين المهمتين ولا تقييمًا مستقلًا لهما.
من Chatbot إلى وكيل طبي يستخدم الحاسوب: أين يكمن الفرق؟
في نمط الأسئلة والأجوبة الطبي التقليدي، تُقدَّم إجابات عن معرفة عامة؛ وفي توليد الوثائق الطبية يمكن كتابة مسودة، لكن المحتوى يظل بحاجة إلى نسخه يدويًا إلى النظام. يكمن اختلاف وكيل استخدام الحاسوب (Computer-use Agent) في أنه يدخل مباشرة إلى البرمجيات القائمة من خلال حلقة “مراقبة عبر لقطة شاشة ← تخطيط ← نقر أو إدخال ← التحقق بلقطة شاشة جديدة”، وينفّذ مهامًا متعددة الخطوات عبر التطبيقات، وقد يغيّر حالة الأعمال داخل البرمجيات.
| شكل القدرة | المخرجات الأساسية | هل يتعامل مع أنظمة الأعمال | سيناريوهات طبية نموذجية | نقاط الخطر الرئيسية |
|---|---|---|---|---|
| Chatbot للأسئلة والأجوبة الطبية | إجابات نصية | لا | الاستعلام عن المعرفة الطبية، واسترجاع الأدلة | دقة المحتوى |
| توليد الوثائق الطبية | السجلات، ومسودات الرسائل | بشكل غير مباشر، ويتطلب إدخالًا يدويًا | تعليمات الخروج من المستشفى، وخطابات التصريح المسبق | عدم تطابق المحتوى مع السجل الطبي |
| وكيل استخدام الحاسوب | عمليات الواجهة وتغيّر حالة النظام | نعم، يتعامل مباشرة مع EHR والبوابات | ملء طلبات التصريح المسبق، وتحديث حالة الإحالة، وجلب البيانات عبر الأنظمة | النقر الخاطئ، والخلط بين المرضى، وانتشار الأخطاء |
في OpenAI API، يتحقق Computer Use بشكل أساسي عبر Responses API، ويدعم إجراءات مثل click وtype وscroll وkeypress وdrag وscreenshot. وتقدّم الوثائق الرسمية مسارين: الأول هو Computer Tool، حيث يعيد النموذج إجراءات منظمة للفأرة ولوحة المفاتيح تنفّذها التطبيقات؛ والثاني هو Code Execution، حيث يولّد النموذج شفرة تستدعي أدوات مثل Playwright وPyAutoGUI. وبالنسبة إلى GPT-6 Astra، فإن الطريقة الموصى بها رسميًا حاليًا هي Code Execution. وتشدّد الوثائق أيضًا على أن النموذج يولّد تعليمات تشغيل لا يعني أن العملية قد نجحت بالفعل؛ إذ يجب على التطبيق تنفيذ الإجراء، ثم تأكيد النتيجة عبر وسائل مثل لقطة شاشة جديدة.
ماذا تعني نتائج تقييم وكيل OpenAI الطبي؟
أعلنت OpenAI ثلاث مجموعات من البيانات الأساسية، تختلف مقاماتها وأبعاد التقييم فيها، ولا يمكن دمجها في «دقة شاملة» واحدة، كما أنها ليست دقة تشخيص طبي.
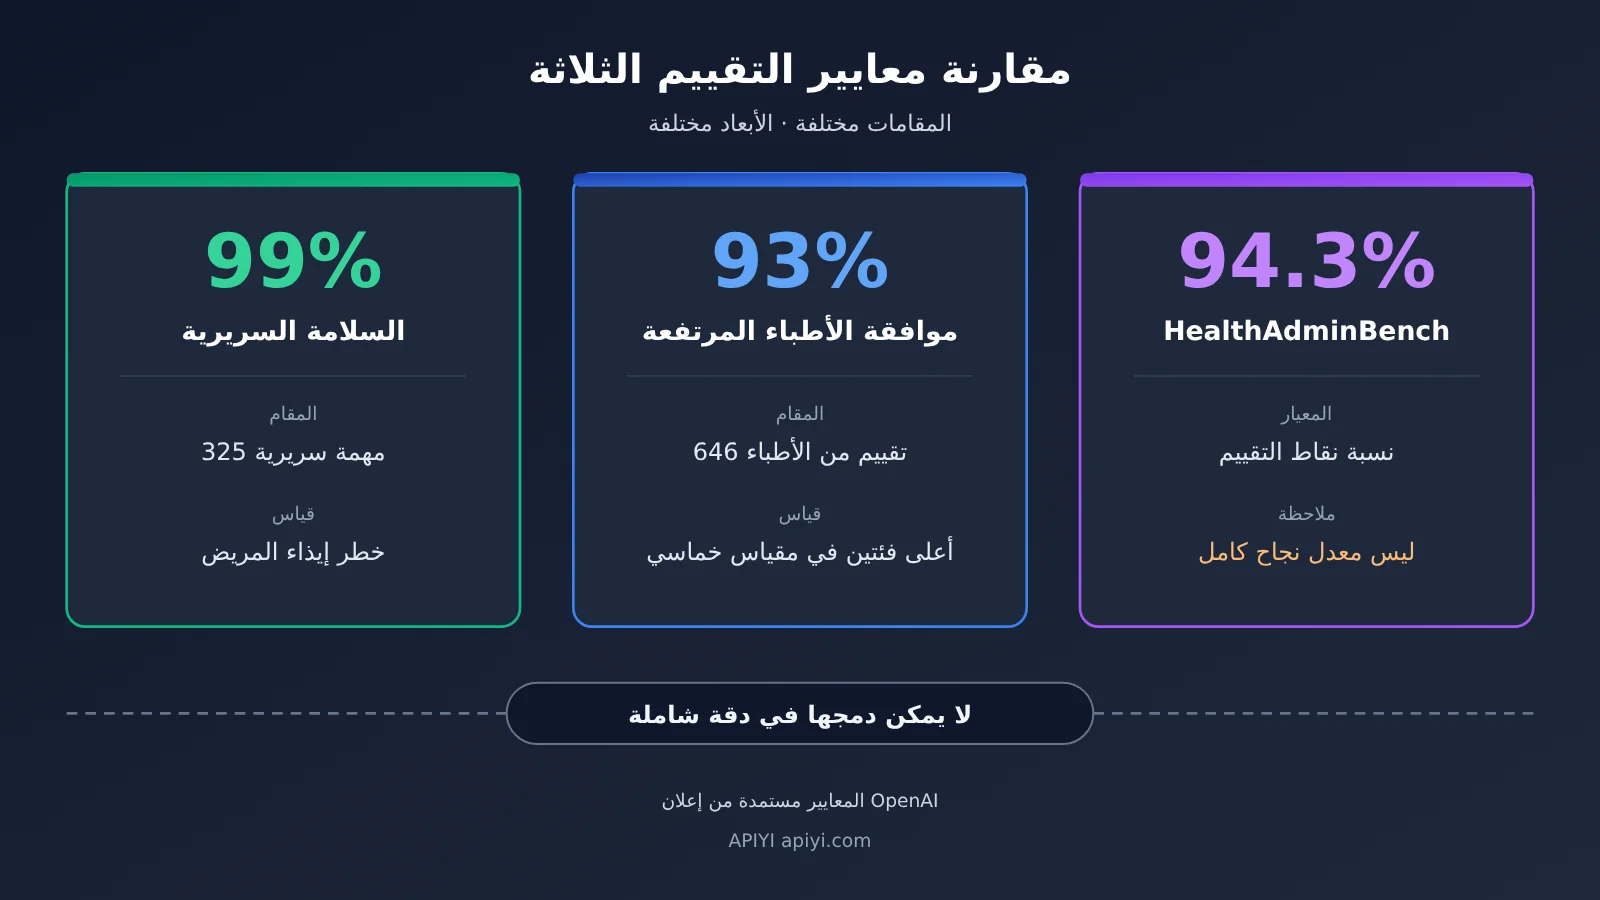
| المقياس | القيمة | النموذج المُقيَّم | المقام / أساس القياس | لا يُفهم على أنه |
|---|---|---|---|---|
| سلامة المهام السريرية | 99% | GPT-6 Astra | 325 مهمة مدققة، مع تقييم ما إذا كان الخطأ أو الإغفال أو الإجراء قد يتسبب في ضرر للمريض | دقة التشخيص، أو انعدام الأخطاء |
| قبول مرتفع من الأطباء | 93% | GPT-6 Astra | 646 تقييمًا، نسبة فئتي Very / Extremely Helpful في مقياس من خمس درجات | معدل نجاح المهمة، أو 646 طبيبًا |
| HealthAdminBench | 94.3% | GPT-6 Astra | نسبة نقاط المعيار (rubric points)، مع maximum reasoning effort | معدل نجاح المهام الكاملة |
| HealthAdminBench | 91.8% | GPT-6 Luna | نسبة نقاط المعيار (rubric points)، مع maximum reasoning effort | معدل نجاح المهام الكاملة |
| تكلفة المهمة الواحدة | $0.085 | GPT-6 Luna | ظروف تقييم محددة، أقل بنسبة 98% من Astra | عرض سعر للنشر في الإنتاج |
لا يكتفي التقييم السريري بالنص النهائي الذي يولّده النموذج، بل يفحص أيضًا الإجراءات التي نفّذها الوكيل فعليًا، والسجلات الطبية التي أنشأها، والأوامر الطبية، ورسائل المرضى. أي أن التقييم يغطي في الوقت نفسه جودة المحتوى وعملية التشغيل البرمجي. لكن الجهة الرسمية لم تنشر عدد الأطباء المستقلين الذين يقابلون التقييمات الـ646، كما لم يقدّم نص الإعلان فترات ثقة، ولا نتائج لكل مهمة، ولا حالات فشل كاملة.
HealthAdminBench هو معيار لتقييم وكلاء المهام الإدارية الطبية، اقترحه مختبر Shah Lab في جامعة ستانفورد. وفقًا للورقة 2604.09937v1، يضم المعيار 135 مهمة و1698 مهمة فرعية، منها 1177 مهمة فرعية تُحكَّم حكمًا حتميًا، و521 تُحكَّم بواسطة نموذج حَكَم. وفي الورقة، كان أعلى معدل نجاح للمهام الكاملة لدى Claude Opus 4.6 CUA بنسبة 36.3%، وأعلى معدل نجاح للمهام الفرعية لدى GPT-5.4 CUA بنسبة 82.8%. أما النسخة المبكرة على موقع Shah Lab فكانت 70 مهمة و947 نقطة تقييم، وبلغ أعلى معدل نجاح للمهام الكاملة المبلغ عنه حينها 22.9%، ويمكن اعتبار ذلك مرجعًا تاريخيًا للمقارنة.
تنتمي هذه المجموعات من الأرقام إلى إصدارات ونماذج وتواريخ وظروف تنفيذ ومقاييس مختلفة، ولا يمكن ترتيبها في قائمة تصنيف واحدة. فـ 94.3% لدى OpenAI محسوبة بمعيار rubric points، بينما 36.3% في الورقة البحثية هي معدل النجاح الكامل من البداية إلى النهاية. هذا الفارق في حد ذاته يشير إلى أن «إنجاز الخطوات الجزئية بشكل صحيح» و«إتمام المهمة كاملة» لدى الوكلاء الطبيين قد يكونان بعيدين جدًا عن بعضهما.
كيف تُطبّق CVS وCigna وAbridge وAmbience الوكلاء الطبيين في الواقع؟
تتفاوت درجة نضج حالات الشركات كثيرًا، وفيما يلي تصنيف حسب الحالة المعلنة علنًا. تأتي هذه الأرقام أساسًا من إفصاحات الشركات وOpenAI، وتلعب التقارير الإعلامية دور التحقق المتقاطع، لكنها لا تعادل تدقيقًا من طرف ثالث.
| الشركة | السيناريو | حالة الإفصاح | الحقائق الرئيسية |
|---|---|---|---|
| CVS Health | إرسال المستندات عبر الأنظمة السريرية، والإحالات، والاستشارات التخصصية | سير عمل في بيئة الإنتاج | أزال تراكم مستندات استمر لشهور خلال عطلة نهاية أسبوع واحدة؛ ويتعامل وكيل آخر يوميًا مع عشرات الآلاف من خطوات عمليات النظام المتعلقة بالاستشارات |
| Cigna Healthcare | دمج المعلومات عبر الأنظمة قبل إدارة التمريض | مُنشر | كان طاقم التمريض يحتاج إلى تصفح أكثر من 10 أنظمة؛ واستغرق الانتقال من الفكرة إلى النشر أقل من 8 أسابيع |
| Abridge | تنسيق عوائق الخروج من المستشفى | قيد التطوير | يطلب الأطباء عبر Abridge Assistant من الوكيل تنسيق الحصول على الأدوية والرعاية المنزلية بالتوازي |
| Ambience Healthcare | طلبات التفويض المسبق من التأمين | عرض خطة الحوكمة | يتوقف ليسأل الطبيب عند وجود غموض في السجل الطبي، ولا يقدّم الطلب إلا بعد الحصول على الموافقة |
| Assort | إغلاق حلقة الإحالة | حالة رسمية | يكتب API معلومات الإحالة، ويكمل Computer Use تحديث الحالة في واجهة Athena |
يشير «عشرات الآلاف» عند CVS إلى حجم العمل الذي تغطيه خطوات عمليات النظام، وليس إلى عشرات الآلاف من القرارات السريرية التي أنجزها الذكاء الاصطناعي بمفرده. كما أصدرت CVS مشروع CUA Agent Kit مفتوح المصدر (برخصة Apache-2.0)، ويعتمد بنية من مرحلتين: أولاً يستكشف Computer-use Agent سير العمل وفق اللغة الطبيعية، ويسجّل أدلة Trace مثل لقطات الشاشة والإجراءات والمواقع المستهدفة؛ ثم يحوّل Codex Skill المسارات الناجحة إلى شيفرة حتمية، تُراجع من المهندسين ثم تُنفّذ بشكل متكرر. وفقًا لـ README، لا تحتاج مرحلة التشغيل الحتمي إلى مفتاح API للنموذج.
توضح حالة Assort موقع Computer Use: بات بإمكان Assort كتابة معلومات الإحالة في السجل الطبي عبر Athena API، لكن الحلقة الكاملة لا تزال تحتاج إلى خطوة واحدة في الواجهة. يختار الوكيل مباشرةً في واجهة Athena طبيب الإحالة، ويملأ التفاصيل، ويحدّث الحالة إلى Visit Scheduled، فتخرج هذه الإحالة فورًا من قائمة متابعة الموظفين. يتولى API العمليات المهيكلة، بينما يتولى Computer Use استكمال الأجزاء التي لا يغطيها API.
كيف يمكن للوكيل الطبي أن يتحكم في المخاطر؟
تشمل قدرات الحوكمة التي أعلنتها OpenAI كلاً من RBAC، وسجلات التدقيق، وتكوين نطاق وصول التطبيقات، والموافقة البشرية قبل العمليات الحرجة، وآليات تحكم تقيّد الوكيل ضمن سير عمل محدد. ويمكن للمؤسسات الصحية إيقاف الوكيل في أي وقت ومراجعة سجلات العمليات خطوة بخطوة.
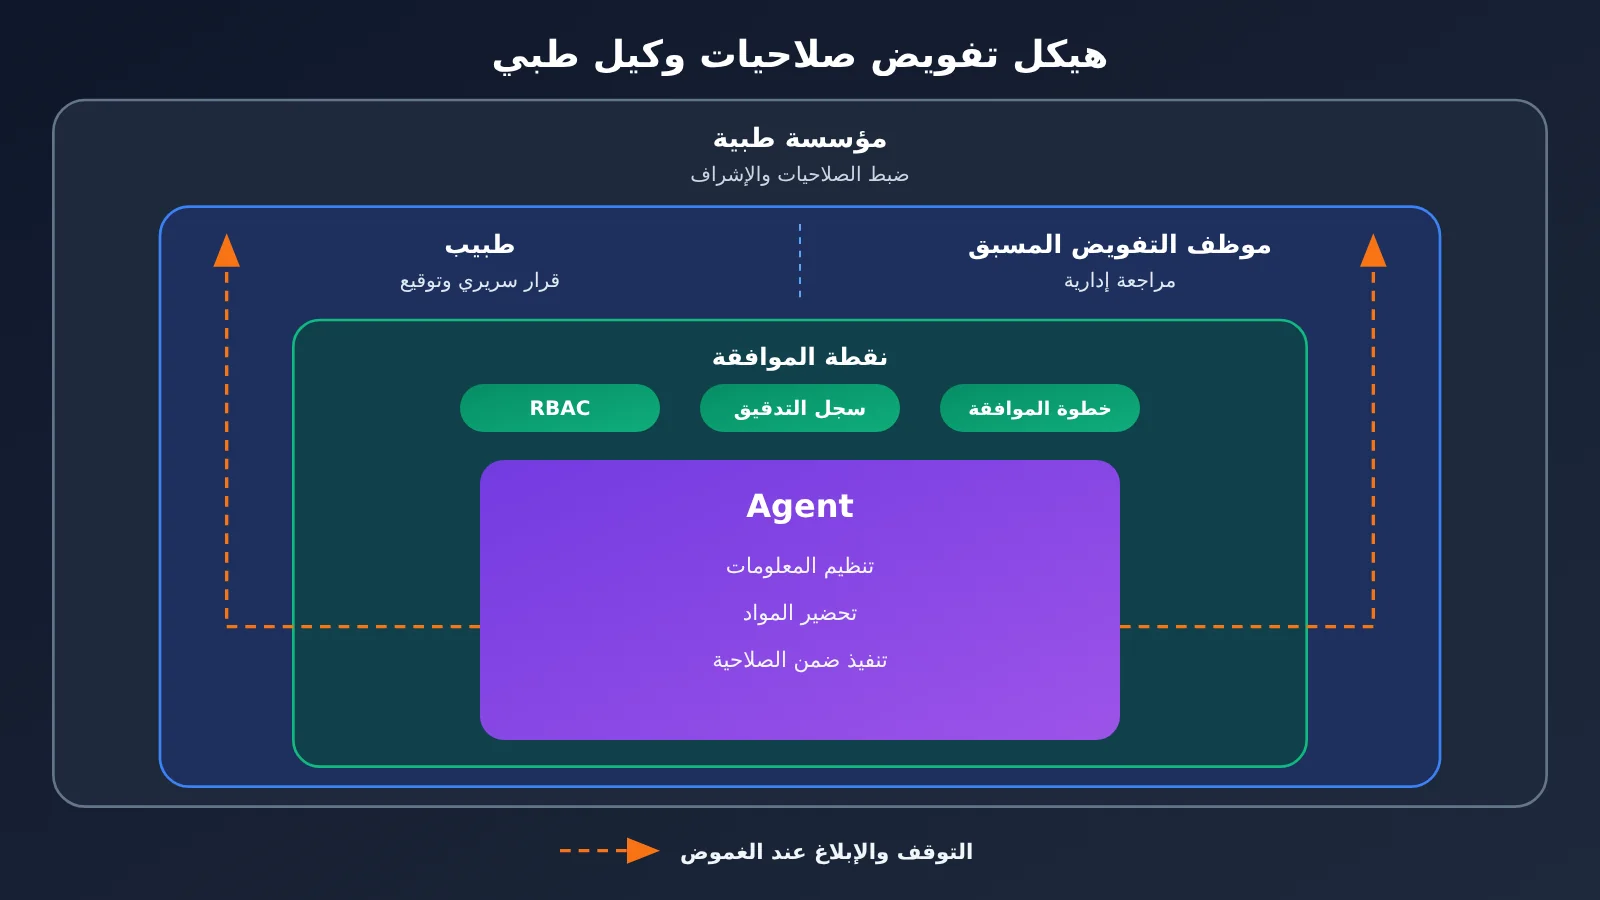
هذا في الواقع تصميم لتوزيع الصلاحيات: الذكاء الاصطناعي مسؤول عن تنظيم المعلومات وإعداد المواد وتنفيذ العمليات ضمن النطاق المصرح به، والأطباء مسؤولون عن التقييم السريري، وموظفو التفويض المسبق مسؤولون عن المراجعة الإدارية، والمؤسسة الصحية مسؤولة عن تكوين الصلاحيات وإجراءات الإشراف. ويجب أن تتوافق صلاحيات الوكيل مع حدود المسؤولية السريرية.
أما في جانب الامتثال للبيانات، فتقول OpenAI إن بيانات المؤسسة في ChatGPT for Healthcare لن تُستخدم لتدريب النماذج الأساسية، كما تقول CVS إن بيانات الإنتاج ذات الصلة تبقى في بنيتها التحتية الخاصة. ولكن لدعم سير عمل متوافق مع HIPAA يتضمن PHI، تحتاج المؤسسات الصحية إلى استخدام خدمة مؤهلة، والتأكد من أن الخدمة مغطاة باتفاقية BAA موقعة مع OpenAI، وتكوين إعدادات الأمان وسياسات الاحتفاظ بالبيانات، وتقييد السجلات والعمليات التي يمكن للوكيل الوصول إليها عبر صلاحيات المؤسسة. لذلك فإن «دعم سير عمل HIPAA» لا يعني أن «كل استدعاءات OpenAI API متوافقة تلقائيًا».
أما من حيث القنوات المتاحة، فيمكن استخدام القدرات ذات الصلة عبر OpenAI API وChatGPT for Healthcare وChatGPT for Clinicians وChatGPT Work وCodex. ويمكن للممارسين السريريين الأمريكيين المؤهلين التقدم مجانًا للحصول على ChatGPT for Clinicians، وتخضع هذه السياسة المجانية لقيود جغرافية وقيود على الأهلية. ولا يوجد لـ ChatGPT for Healthcare سعر اشتراك ثابت وموحد معلن للعموم.
تحليل واستنتاج: مقايضات الوكيل الطبي وأهميته الصناعية
لماذا يحتاج قطاع الرعاية الصحية تحديدًا إلى وكلاء من نوع Computer Use؟
تشتت المعلومات في الخدمات الصحية ظاهرة نموذجية. فقد تتضمن زيارة واحدة في الوقت نفسه أنظمة السجلات الصحية الإلكترونية (EHR)، وأنظمة التصوير، وأنظمة الوصفات، وبوابات التأمين، وأنظمة الإحالة، ومنصات إدارة الخروج من المستشفى. وغالبًا ما تأتي هذه الأنظمة من موردين مختلفين، ولا تكون واجهات الربط بينها مكتملة. والموافقة المسبقة لتصوير بالرنين المغناطيسي (MRI) ليست إلا مثالًا مصغرًا على ذلك: فالطبيب لا يصدر سوى حكم سريري واحد، بينما يضطر الموظف إلى التنقل بين السجلات الطبية وسجلات العلاج الطبيعي ومواد التصوير وبوابة التأمين، وينسخ ويرفع الملفات مرارًا.
من هذه الزاوية، فالمسألة التي يعالجها Computer Use ليست «هل يفهم الذكاء الاصطناعي الطب؟»، بل «هل تستطيع المعلومات أن تنتقل بين الأنظمة؟». وأرى أن أتمتة الأعمال الإدارية الطبية قد تسبق أتمتة التشخيص السريري في الوصول إلى حجم تجاري. والسبب أن المهام الإدارية كثيرة، وشديدة التكرار، وحدودها واضحة، ويمكن التحقق من نتائجها عبر النماذج وحالات النظام، كما أن مخاطر المسؤولية فيها أقل نسبيًا وقابلة للضبط. وتجسد قصة Cigna التي اختصرت البحث عن المعلومات عبر أكثر من 10 أنظمة إلى ثوانٍ هذا المسار: «تخفيف العبء أولًا، من دون استبدال».
ومع ذلك، يكشف معيار ستانفورد أيضًا الصعوبة الحقيقية. فقد وجدت دراسات مبكرة أن نقل البيانات بين التطبيقات ومعالجة المستندات من أهم أسباب فشل الوكيل؛ فحتى إن فهم معلومات المريض، فقد يخطئ عند رفع الملفات أو ملء الحقول أو تحديث الحالة. وفي السياق الطبي، قد ينتقل خطأ وقع في نظام واحد إلى عدة أنظمة لاحقة، ولهذا تحديدًا لا يمكن الاستغناء عن المراجعة البشرية والتحقق من الحالة بعد تنفيذ العملية.
كيف يمكن للمطورين تقييم تكلفة الوكيل الطبي وجدواه؟
بالنسبة للمطورين، لا يلزم أن تكون الخطوة الأولى هي استخدام Computer Use مباشرة. الطريقة الأكثر أمانًا هي تفكيك سير العمل أولًا: يمكن التحقق من الجودة في الخطوات النصية البحتة مثل استخراج المعلومات وصياغة المواد باستخدام واجهة نموذج عادية؛ ثم يتم تقييم معدل نجاح خطوات التعامل مع الواجهة بشكل منفصل. يستخدم المثال التالي بيانات اصطناعية للتحقق من الخطوة النصية «استخراج الحقول المطلوبة للتفويض المسبق»، وهو مجرد عرض تقني ولا يشكل أي نصيحة طبية أو علاجية:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة APIYI المتوافقة مع OpenAI
)

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # وفق قائمة النماذج المتاحة فعليًا على المنصة
    messages=[{"role": "user", "content": "从以下合成病历中列出影像检查预授权需要核对的字段清单:……"}]
)
print(resp.choices[0].message.content)
عرض الكود الكامل مع إحصاء تكلفة الرموز (Token)
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# سعر الوحدة: دولار / مليون Token، املأه وفق النموذج الذي تستخدمه فعليًا
PRICE = {"input": 0.10, "output": 0.50, "cached_input": 0.01}

def run_step(prompt: str, model: str = "gpt-4o-mini") -> dict:
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": "你只做字段抽取,不给出任何诊疗建议,信息不明确时输出 NEED_HUMAN。"},
            {"role": "user", "content": prompt},
        ],
    )
    u = resp.usage
    cached = getattr(getattr(u, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    cost = ((u.prompt_tokens - cached) * PRICE["input"]
            + cached * PRICE["cached_input"]
            + u.completion_tokens * PRICE["output"]) / 1_000_000
    return {"text": resp.choices[0].message.content, "cost_usd": round(cost, 6)}

steps = ["合成病历片段 A ……", "合成病历片段 B ……"]
total = 0.0
for s in steps:
    r = run_step(s)
    total += r["cost_usd"]
    print(r["text"])
print("模型 Token 成本合计(不含工具、环境与维护):", round(total, 6))
🚀 اقتراح للتحقق السريع: قبل الربط الرسمي بالنظام الطبي، يمكنك أولًا عبر APIYI apiyi.com استخدام مفتاح API واحد لمقارنة أداء عدة نماذج في الخطوات النصية مثل استخراج الحقول وصياغة المواد. يحصل المستخدمون الجدد على حصة اختبار مجانية، وهي مناسبة لتشغيل سكربت التقييم أولًا وجمع بيانات على مستوى المهمة.
أما من ناحية التكلفة، فإليك أسعار السياق القصير ضمن فئة Standard كما ظهرت عند الاستعلام بتاريخ 17 نوفمبر 2026 (بالدولار لكل مليون Token): GPT-6 Astra — الإدخال 10، الإخراج 50، الإدخال المخزّن مؤقتًا 1؛ GPT-6 Luna — الإدخال 0.10، الإخراج 0.50، الإدخال المخزّن مؤقتًا 0.01. وتؤثر سرعة المعالجة وطول السياق والمنطقة الجغرافية في الفاتورة الفعلية. وبالاستنتاج العكسي من كون Luna يكلّف 0.085 دولار للمهمة الواحدة ومن نسبة «أقل بنسبة 98%»، فإن Astra يكلّف نحو 4.25 دولار للمهمة، لكن هذه قيمة تقديرية، وهي تمثّل التكلفة في الظروف المرجعية فقط، ولا يصح اعتمادها كعرض سعر للإنتاج.
أما الحساب الكامل فينبغي أن يُحصي في كل جولة مدخلات الرؤية والنص ومخرجات الفوترة كلٌّ على حدة، ثم يضيف إليها استدعاءات الأدوات وبيئة التشغيل والصيانة الهندسية. وإذا كانت الـ Tokens الناتجة عن إعادة المحاولة قد دخلت بالفعل في الإجمالي، فلا تُضفها مرة أخرى. كما أن فارق السعر الذي يقارب 50 ضعفًا بين الفئتين يوحي بفكرة تقسيم طبقي: التفكير المعقد يُترك للنموذج عالي القدرة، والخطوات المهيكلة كثيرة التكرار تُترك للنموذج منخفض التكلفة، أما المسارات التي ثبت استقرارها بالاختبار فتُحوَّل إلى كود حتمي كما فعل CVS.
💰 نصيحة لتحسين التكلفة: عند تقسيم النماذج إلى طبقات، يمكنك أولًا أن تبدّل بين نماذج بأسعار مختلفة على APIYI (apiyi.com) باستخدام الشيفرة نفسها المتوافقة مع OpenAI، وتقيس جودة كل نوع من المهام الفرعية واستهلاكه من الـ Tokens، ثم تقرر أي المراحل تستحق استخدام نموذج عالي القدرة.
| مرحلة التحقق | السؤال المطلوب الإجابة عنه | الأدلة المقترحة | الأدوات المرجعية |
|---|---|---|---|
| مرحلة النص | هل جودة الاستخراج والصياغة مستقرة؟ | مقارنة بوسم يدوي، ومعدل تفعيل NEED_HUMAN | مقارنة متعددة النماذج على APIYI (apiyi.com) |
| عمليات الواجهة | ما معدل الإنجاز من طرف إلى طرف؟ | لقطات الشاشة وTrace، والتحقق من الحالة بعد العملية | وثائق OpenAI Computer Use وبيئة رملية |
| تثبيت المسار | أي الخطوات يمكن تحويلها إلى كود حتمي؟ | معدل إعادة إنتاج المسارات الناجحة | بنية على مرحلتين من نوع CUA Agent Kit |
| حوكمة الإطلاق | هل تغطي الصلاحيات والموافقات الإجراءات الحرجة؟ | إعدادات RBAC، وفحص عيّنة من سجلات التدقيق | نظام الصلاحيات والامتثال المؤسسي الخاص |
هل وكيل الذكاء الاصطناعي الطبي وRPA بديلان أم متكاملان؟
تعتمد RPA التقليدية على قواعد ثابتة وتحديد عناصر الواجهة، وقد يفشل السكربت بمجرد تغيّر الواجهة؛ بينما يستطيع وكيل استخدام الحاسوب (Computer-use Agent) فهم اللغة الطبيعية وملاحظة الواجهة الحالية والتكيف مع التغييرات، لكن إعادة الاستدلال في كل مرة تفرض تكلفة وتُحدث تقلّبًا في النتائج. وفي دراسة تقارن بين التقنيتين (DOI: 10.1080/23311975.2026.2724760)، نُفِّذت كل تقنية 10 مرات في كل من العمليتين P2 وP3؛ وفي العملية P1 لم يُسجَّل للوكيل سوى فشل واحد لم يُدرَج في الإحصاءات اللاحقة، لذلك لا يمكن القول بشكل عام إن جميع المهام نُفِّذت 10 مرات. واستخدمت الدراسة إعدادات أدوات من عام 2025، لذا لا يمكن أن تمثّل مباشرة أداء نماذج عام 2026.
أرى أن نمط «الاستكشاف بالذكاء الاصطناعي، وتثبيت الكود، والتنفيذ المتكرر» في CVS مرشّح أكثر ليصبح الشكل الهندسي السائد: يتولى الوكيل اكتشاف العمليات غير المألوفة وفهمها، ويتولى الكود الحتمي تكرار العمليات المعروفة بثبات، وتواصل API تحمّل التفاعلات عالية التردد والمنظمة، وتؤمّن الموافقة البشرية نقاط التحكم الحرجة. إن دمج API وComputer Use والكود الحتمي والموافقة البشرية معًا أكثر واقعية من المراهنة على أي تقنية واحدة.
ماذا يعني وكيل الرعاية الصحية للذكاء الاصطناعي بالنسبة لصناعة الذكاء الاصطناعي بأكملها؟
الرعاية الصحية مجرد ساحة اختبار عالية الحواجز. فأنظمتها مجزأة، ومتطلبات الامتثال وحدود المسؤولية فيها أكثر صرامة مما هي لدى الشركات العادية. وإذا استطاع وكيل تنفيذي أن يؤسس هنا طريقة تشغيل قابلة للتدقيق، وقابلة للإيقاف، ومتوافقة الصلاحيات، فإن هذه المنهجية يمكن نقلها إلى قطاعات التأمين والتمويل والخدمات الحكومية التي تعتمد أيضًا على أنظمة قديمة.
وهذا يعني أيضًا أن أبعاد المنافسة في الصناعة تتغير. في الماضي كانت المقارنة تدور حول ما إذا كان النموذج يستطيع كتابة محتوى جيد، أما الآن فالمقارنة ستكون أكبر على ما إذا كان يستطيع إنجاز المهام داخل أنظمة حقيقية، وما إذا كان يتوقف في الوقت المناسب عند وقوع خطأ، وما إذا كانت كل خطوة قابلة للتتبع عبر السجلات. وبالنسبة لموردي البرمجيات، يتيح Computer Use لشركات الذكاء الاصطناعي المشاركة في سير العمل دون الحاجة إلى السيطرة الكاملة على البرنامج الأساسي، ما يخفض عتبة التكامل ويضغط على النموذج القديم القائم على “انتظار المورد لفتح الواجهة”. لكن التفاعلات عالية الموثوقية وعالية التكرار تظل أنسب عبر API، وComputer Use أقرب إلى مكمل وليس بديلاً.
فيما يلي عدة أمور تستحق المتابعة: هل ستكشف OpenAI عن بيانات تقييم لكل مهمة وإعدادات تجربة كاملة؟ وهل يمكن أن تصبح نسخة ورقة HealthAdminBench مرجعًا موحدًا للمقارنة بين الجهات المختلفة؟ وهل يمكن لحل تنسيق الخروج من المستشفى الخاص بـ Abridge الانتقال من التطوير إلى النشر؟ وهل يمكن لمزيد من بيانات الإنتاج من المستشفيات أن تثبت أن معدل الإنجاز من طرف إلى طرف قابل للاستخدام فعلاً؟ قبل ظهور هذه الأدلة، فإن العروض التوضيحية والتقييمات ليست سوى نقطة بداية، وليست استنتاجًا.
لقد أثبت وكيل الرعاية الصحية بالفعل أنه قادر على “التصرف”، لكن ما إذا كان يمكنه فعلاً تخفيف الأعباء السريرية والإدارية يتوقف على معدل إنجازه من طرف إلى طرف في سير العمل الحقيقي، وقدرته على التوقف عند وقوع خطأ، والتكلفة على المدى الطويل. وكما يقول المثل الإنجليزي: The proof of the pudding is in the eating. (النتائج الفعلية تُختبر بالتطبيق العملي.)
المراجع
- إعلان OpenAI الرسمي: تعزيز وكلاء استخدام الحاسوب لفرق الرعاية الصحية (Advancing computer-use agents for healthcare teams)
- الرابط:
openai.com/index/advancing-computer-use-for-healthcare-teams
- الرابط:
- مستندات مساعدة ChatGPT for Healthcare: قدرات المنتج واتفاقية BAA والإضافات
- الرابط:
help.openai.com/en/articles/20001046-chatgpt-for-healthcare
- الرابط:
- مستندات تطوير OpenAI Computer Use: أداة Computer Tool ومسار Code Execution
- الرابط:
developers.openai.com/api/docs/guides/tools-computer-use
- الرابط:
- ورقة HealthAdminBench: المهام والمقاييس في الإصدار 2604.09937v1
- الرابط:
arxiv.org/html/2604.09937v1
- الرابط:
- مجموعة أدوات CVS Health CUA Agent Kit: بنية من مرحلتين: الاستكشاف ثم التثبيت
- الرابط:
github.com/cvs-health/cua-agent-kit
- الرابط:
- تقرير Fierce Healthcare: شركاء HLTH26 وسيناريوهات التطبيق
- الرابط:
fiercehealthcare.com/ai-and-machine-learning/hlth26-cvs-health-cigna-and-ambience-collaborating-openai-test-computer-use
- الرابط:
- قاموس Cambridge: التحقق من نص المثل الأصلي
- الرابط:
dictionary.cambridge.org/us/dictionary/english/proof-of-the-pudding-is-in-the-eating
- الرابط:
الكاتب: فريق APIYI التقني
التواصل التقني: إذا كنت ترغب في مقارنة أداء عدة نماذج لغة كبيرة في الجزء النصي من الوكيل (Agent)، فمرحبًا بك في زيارة APIYI على apiyi.com للحصول على رصيد اختباري، ولمزيد من إرشادات الوصول يمكنك مراجعة مركز المستندات docs.apiyi.com