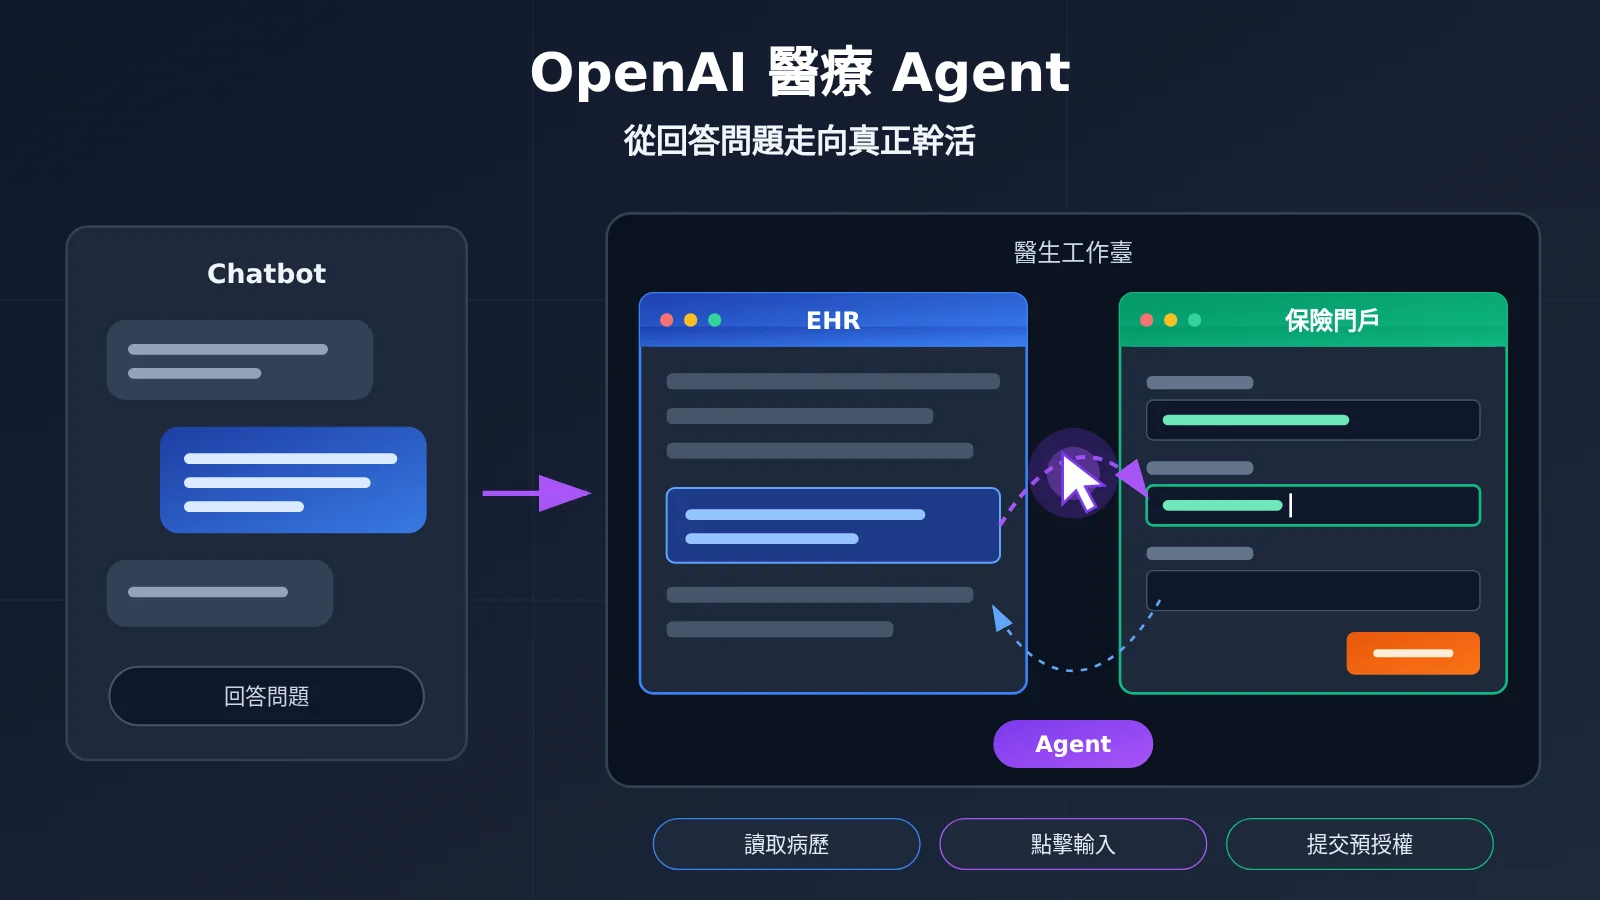
OpenAI 醫療 Computer-use Agent 的關鍵進展,是它能進入醫療機構已經在用的軟件系統,讀取患者的縱向病歷信息,並據此準備醫療記錄、醫囑草稿、患者回復和保險預授權材料。AI 的價值正在從回答專業問題延伸到執行實際業務流程。醫療 AI 的競爭重點也隨之變化,不再侷限於醫學知識問答,而是進入臨牀與行政工作流本身。需要強調的是,這些材料在演示和公開案例中都要經過醫生或工作人員審覈,AI 並不獨立擁有處方權或醫療決策權。
您讀完此文能瞭解到什麼?
- MRI 演示中,Agent 從讀取病歷到準備預授權申請的完整操作鏈。
- 99% 安全性、93% 醫生高度認可、94.3% rubric points 三組數據各自的評價口徑,以及它們與斯坦福 HealthAdminBench 論文成績的區別。
- CVS Health、Cigna、Abridge、Ambience 分別處在合成演示、生產部署還是開發階段。
- 臨牀審批權與 Agent 執行權如何分開,以及開發者應該怎樣覈算 Agent 的完整成本。
索引
客觀事實部分按以下順序展開:先還原 OpenAI 這次讓 AI 做了什麼;再對比 Chatbot 與 Computer-use Agent 的差異;然後拆解評測成績的含義;接着梳理 CVS、Cigna、Abridge 和 Ambience 等企業的落地方式;最後介紹醫療 Agent 的風險控制機制。分析判斷部分會討論醫療行業爲什麼特別需要這種能力,開發者與醫療機構該如何取捨,以及 Computer Use 對整個 AI 應用產業意味着什麼。
To Know:醫療 Agent 相關概念速查
| 概念 | 簡要解釋 |
|---|---|
| Computer Use | 通過觀察和操作軟件界面(截圖、點擊、輸入)來完成任務的能力 |
| EHR | 電子健康記錄系統,醫院存放患者就診、用藥、影像等信息的核心軟件 |
| Payer Portal | 保險支付方門戶,醫療機構在這裏提交預授權、覈驗保險資格 |
| Prior Authorization | 預授權,部分檢查或治療在實施前需要先獲得保險方批准 |
| MCP | 用於發現和調用外部工具的標準協議 |
| RPA | 通過預先配置的規則或腳本執行重複流程的自動化方式 |
| Rubric points | 按評測規則拆分的評分點,衡量部分要求的達成情況 |
| 端到端成功率 | 完整任務滿足全部成功條件的比例 |
| Trace | 記錄執行過程、操作動作和界面狀態的軌跡證據 |
| BAA | 業務夥伴協議,明確服務商處理受保護健康信息(PHI)的責任 |
| RBAC | 基於角色的訪問控制,按崗位分配可訪問的數據和操作 |
醫療 Agent 影響速覽
- 開發者與技術負責人:重點不再是模型能不能答對醫學問題,而是要按具體任務驗證執行機制、端到端完成率和完整成本。截圖屬於圖像輸入,多輪調用、工具和運行環境都會計費,不能只看文本 Token 單價。
- 醫療機構與工作流負責人:需要分清哪些是合成數據演示、廠商評測、企業試點和生產案例。上線時還要落實人工審批、權限配置和審計日誌,不能把演示效果直接當作採購依據。
- 臨牀人員:短期內更可能感受到的是行政負擔下降,例如預授權材料準備和跨系統查找信息。臨牀判斷和簽字責任仍然在醫生手中。
客觀事實:OpenAI 醫療 Agent 這次發佈了什麼
OpenAI 醫療 Agent 這次讓 AI 做了什麼?
2026 年 11 月 16 日,OpenAI 發佈了面向醫療團隊的計算機操作 Agent 新進展,同時披露了臨牀與行政工作流的評測結果,以及與 CVS Health、Abridge、Ambience、Cigna Healthcare 等企業的合作實踐。HLTH 2026 期間,OpenAI Health AI 負責人 Karan Singhal 也介紹了相關進展。
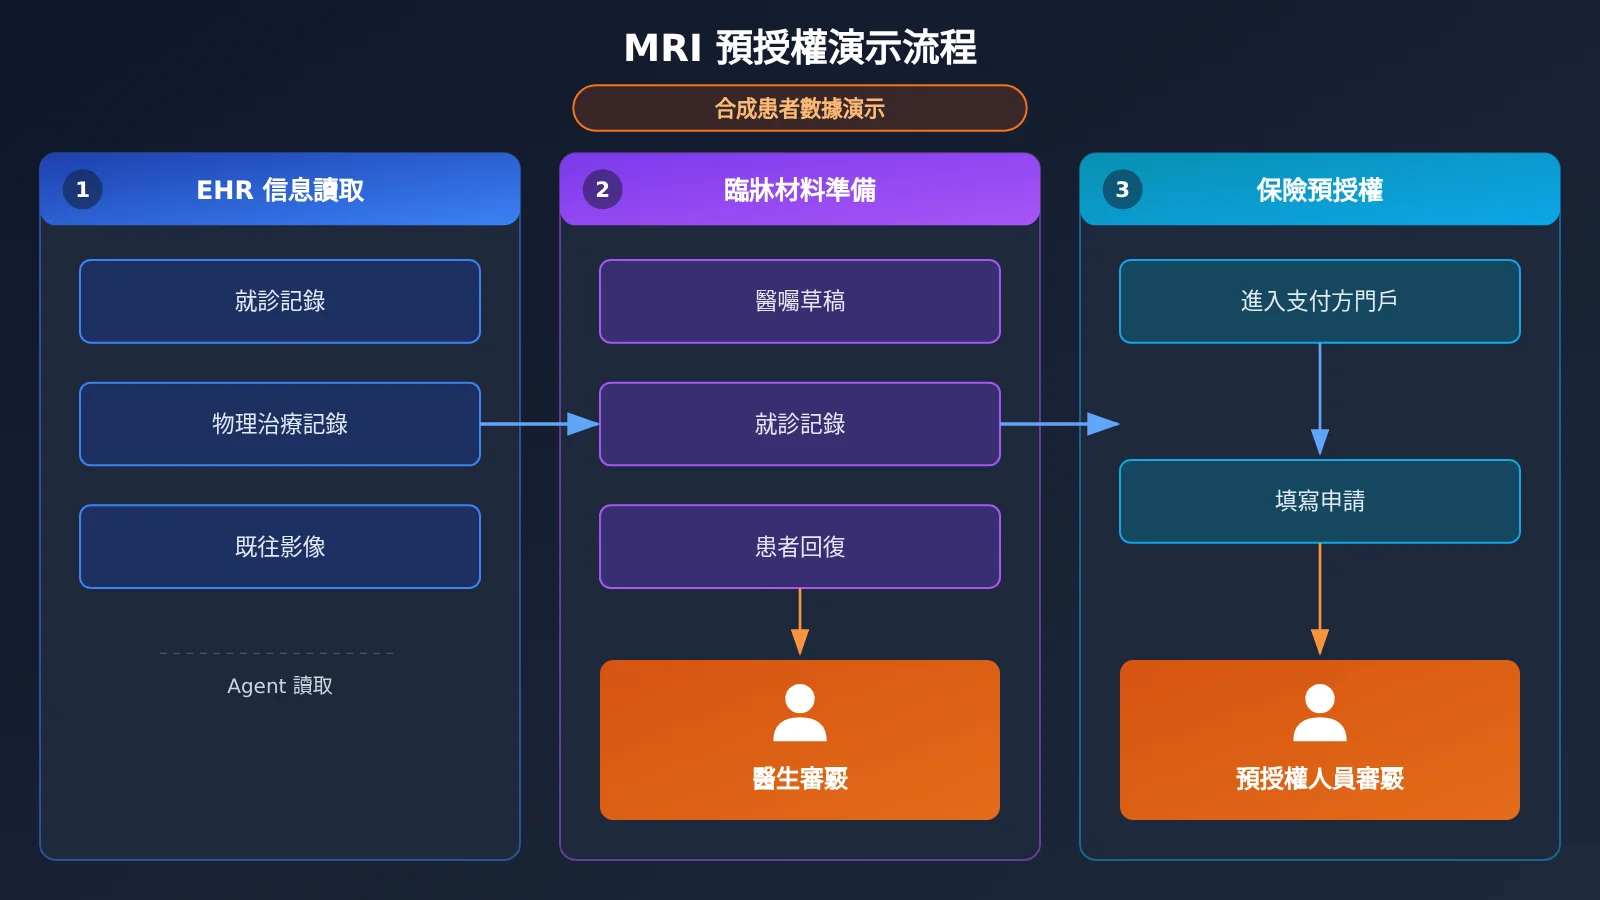
最能說明這次變化的是官方展示的 MRI 工作流。一位患者因爲下背部疼痛給醫生髮消息,醫生考慮做 MRI 檢查。隨後,Agent 在 EHR 和保險門戶之間完成了三個階段的工作:
- EHR 信息讀取:查看患者就診記錄、物理治療記錄和既往影像資料。
- 臨牀材料準備:起草 MRI 檢查醫囑、本次就診記錄和給患者的回覆,全部留給醫生審覈。
- 保險預授權:沿用同一份患者記錄,進入保險支付方門戶準備 MRI 預授權申請,交給預授權工作人員審覈。
需要說明,這個演示使用的是合成患者數據(Synthetic Patient Data),並非對真實患者的生產操作。它展示的是能力鏈路,不代表任何醫院已經按這個流程處理真實病例。
官方還展示了一個兒童骨折後的用藥諮詢案例。家屬詢問兒童布洛芬的用量,Agent 查看就診記錄和影像資料,讀取病歷中記錄的體重和診所給藥劑量,據此起草用藥說明、石膏護理說明和需要緊急就醫的警示症狀。它把醫療記錄保存爲未簽署狀態,把給家屬的回覆保存爲未發送草稿,最終由醫生審批。Elevated PSA 和 Digoxin refill(地高辛續藥)也被列爲 EHR Inbox 的任務類型,但官方沒有公開這兩類任務的完整操作記錄和獨立評分。
從 Chatbot 到 Computer-use 醫療 Agent,變化在哪裏?
傳統醫療問答回答的是一般性知識,醫療文檔生成能寫出草稿,但內容仍要靠人複製進系統。Computer-use Agent 的不同之處在於,它通過“截圖觀察→規劃→點擊或輸入→再截圖驗證”的循環直接進入現有軟件,跨應用完成多步驟任務,並可能改變軟件中的業務狀態。
| 能力形態 | 主要輸出 | 是否接觸業務系統 | 典型醫療場景 | 主要風險點 |
|---|---|---|---|---|
| 醫療問答 Chatbot | 文本回答 | 否 | 醫學知識查詢、證據檢索 | 內容準確性 |
| 醫療文檔生成 | 記錄、信函草稿 | 間接,需人工錄入 | 出院說明、預授權信函 | 內容與病歷不一致 |
| Computer-use Agent | 界面操作與系統狀態變化 | 是,直接操作 EHR 和門戶 | 預授權填寫、轉診狀態更新、跨系統取數 | 錯誤點擊、患者混淆、錯誤傳播 |
在 OpenAI API 中,Computer Use 主要通過 Responses API 實現,支持 click、type、scroll、keypress、drag、screenshot 等動作。官方文檔介紹了兩條路徑:一是 Computer Tool,模型返回結構化的鼠標鍵盤動作,由應用執行;二是 Code Execution,模型生成調用 Playwright、PyAutoGUI 等工具的代碼。對 GPT-6 Astra,官方當前推薦 Code Execution 方式。文檔還特別強調,模型生成了操作指令,並不等於操作已經成功,應用必須執行動作,再通過新截圖等方式確認結果。
OpenAI 醫療 Agent 的評測成績說明了什麼?
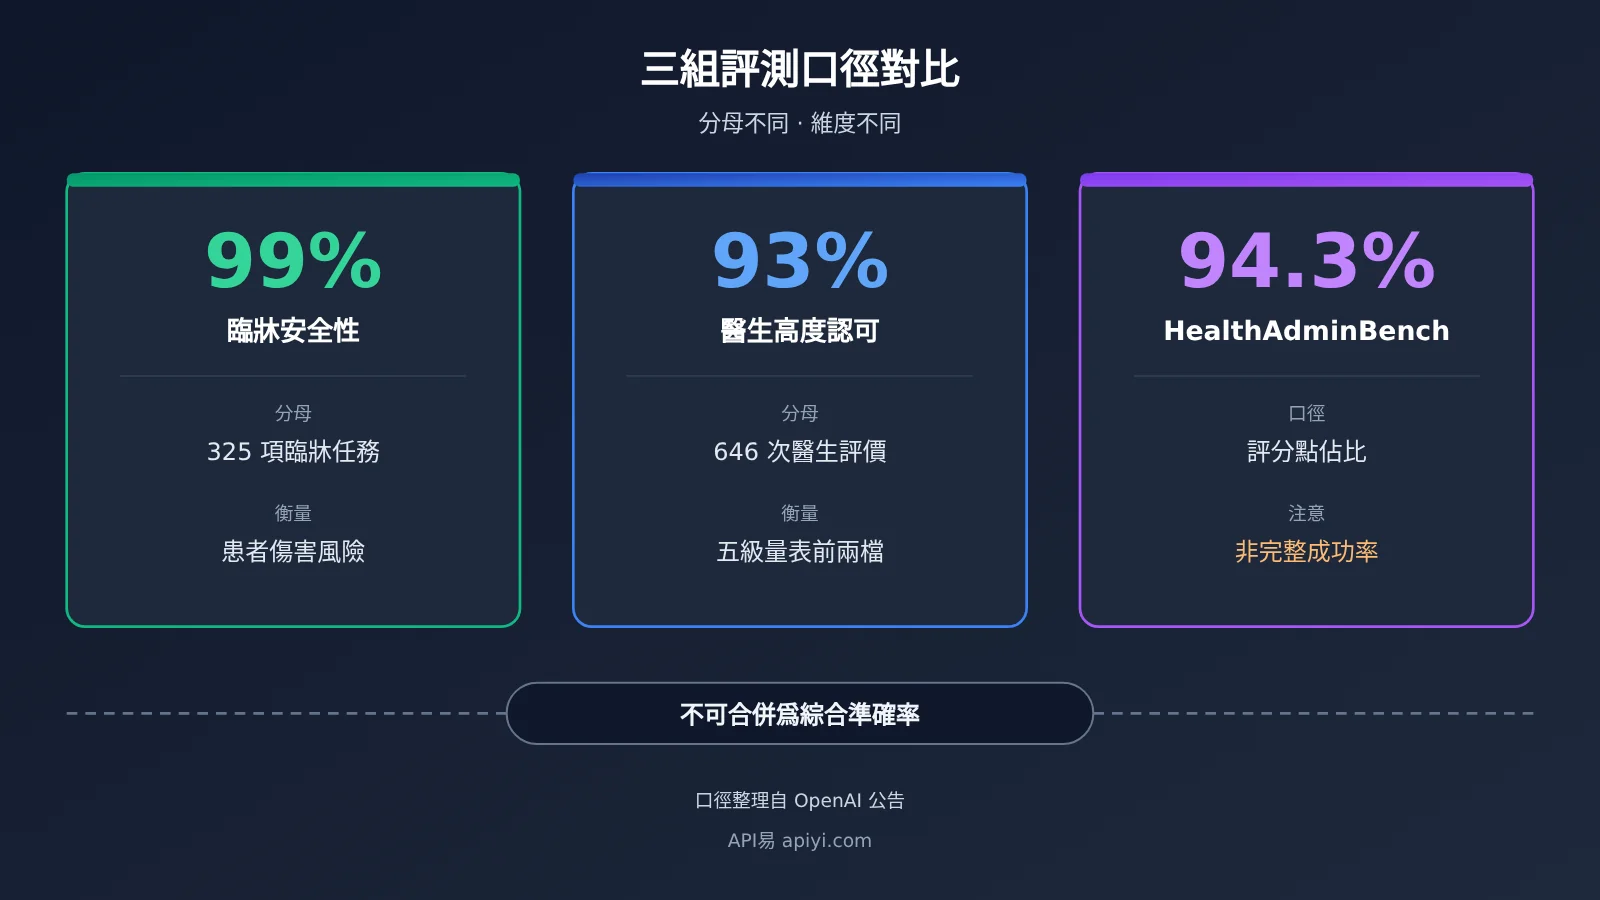
OpenAI 公佈了三組核心數據,它們的分母和評價維度各不相同,不能合併成一個“綜合準確率”,也都不是醫學診斷準確率。
| 指標 | 數值 | 評測對象 | 分母 / 口徑 | 不能理解爲 |
|---|---|---|---|---|
| 臨牀任務安全性 | 99% | GPT-6 Astra | 325 項經審覈任務,評估錯誤、遺漏或操作是否可能造成患者傷害 | 診斷準確率、零錯誤 |
| 醫生高度認可 | 93% | GPT-6 Astra | 646 次評價,五級量表中 Very / Extremely Helpful 合計佔比 | 任務成功率、646 名醫生 |
| HealthAdminBench | 94.3% | GPT-6 Astra | rubric points 佔比,maximum reasoning effort | 完整任務成功率 |
| HealthAdminBench | 91.8% | GPT-6 Luna | rubric points 佔比,maximum reasoning effort | 完整任務成功率 |
| 單任務成本 | $0.085 | GPT-6 Luna | 特定評測條件,較 Astra 低 98% | 生產部署報價 |
臨牀評審並不只看最後生成的文字,還會檢查 Agent 實際執行的動作、生成的醫療記錄、醫囑和患者消息。也就是說,評估同時覆蓋了內容質量和軟件操作過程。不過官方沒有公佈 646 次評價對應的獨立醫生人數,公告正文也沒有給出置信區間、逐任務結果和完整失敗案例。
HealthAdminBench 是斯坦福 Shah Lab 提出的醫療行政 Agent 基準。根據論文 2604.09937v1,該基準包含 135 項任務和 1698 個子任務,其中 1177 個子任務採用確定性判定,521 個採用模型裁判;論文中完整任務成功率最高的是 Claude Opus 4.6 CUA,爲 36.3%,子任務成功率最高的是 GPT-5.4 CUA,爲 82.8%。早期 Shah Lab 網頁版本是 70 項任務、947 個評分點,當時報告的完整任務成功率最高爲 22.9%,可作爲歷史對照。
這幾組數字分屬不同版本、不同模型、不同日期、不同執行條件和不同指標,不能排成同一張榜單。OpenAI 的 94.3% 是 rubric points 口徑,而論文的 36.3% 是端到端完整成功率,兩者差距本身就提示:醫療 Agent 的“局部步驟做對”和“整件事辦完”可能相去甚遠。
CVS、Cigna、Abridge 和 Ambience 如何落地醫療 Agent?
企業案例的成熟度差別很大,下面按公開披露的狀態歸類。這些數字主要來自企業和 OpenAI 的披露,媒體報道起到交叉印證作用,但不等於第三方審計。
| 企業 | 場景 | 披露狀態 | 關鍵事實 |
|---|---|---|---|
| CVS Health | 跨臨牀系統發送文件、轉診、專科會診 | 生產工作流 | 一個週末清理了持續數月的文件積壓;另一個 Agent 每天處理數萬次會診相關的系統操作步驟 |
| Cigna Healthcare | 護理管理前的跨系統信息整合 | 已部署 | 護理人員原需瀏覽 10 多套系統;從概念到部署不到 8 周 |
| Abridge | 出院障礙協調 | 開發中 | 醫生通過 Abridge Assistant 請求 Agent 並行協調藥物獲取和居家護理 |
| Ambience Healthcare | 保險預授權申請 | 治理方案展示 | 病歷有歧義時停下詢問醫生,獲批後才提交 |
| Assort | 轉診閉環 | 官方案例 | API 寫入轉診信息,Computer Use 在 Athena 界面補齊狀態更新 |
CVS 的“數萬次”指的是系統操作步驟涉及的工作量,不是數萬個臨牀決策都由 AI 獨立完成。CVS 還開源了 CUA Agent Kit(Apache-2.0 許可證),採用兩階段架構:先由 Computer-use Agent 按自然語言探索工作流,並記錄截圖、動作、目標位置等 Trace 證據;再由 Codex Skill 把成功軌跡固化爲確定性代碼,經工程師審查後重復執行。根據 README,確定性運行階段不需要模型 API Key。
Assort 的案例則說明了 Computer Use 的定位:Assort 已能通過 Athena API 把轉診信息寫入病歷,但完整閉環還差一步界面操作。Agent 直接在 Athena 界面選擇轉診醫生、填寫詳情,並把狀態更新爲 Visit Scheduled,這條轉診隨即從工作人員的跟進列表中移除。API 負責結構化操作,Computer Use 負責補齊 API 沒有覆蓋的部分。
醫療 Agent 如何控制風險?
OpenAI 公佈的治理能力包括 RBAC、審計日誌、應用訪問範圍配置、關鍵操作前的人工審批,以及把 Agent 限制在指定工作流內的控制機制。醫療機構可以隨時暫停 Agent,查看逐步操作日誌。
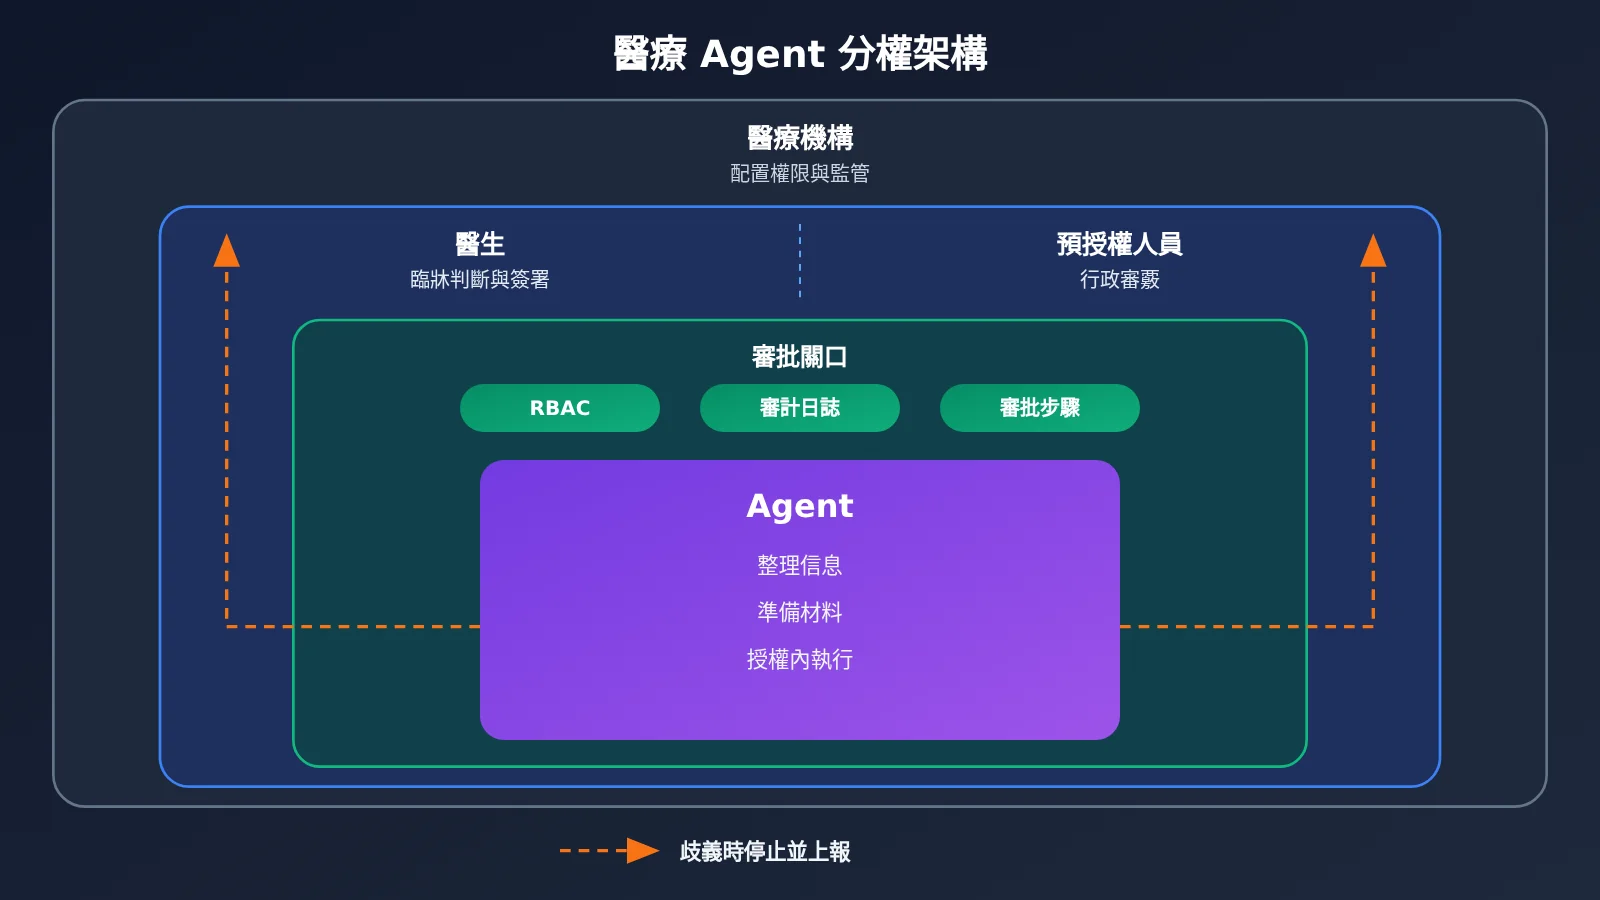
這實際上是一種分權設計:AI 負責整理信息、準備材料和執行授權範圍內的操作,醫生負責臨牀判斷,預授權人員負責行政審覈,醫療機構負責配置權限和監管流程。Agent 的權限必須和臨牀責任邊界對齊。
在數據合規方面,OpenAI 表示 ChatGPT for Healthcare 中的組織數據不會用於訓練基礎模型,CVS 也表示相關生產數據留在自有基礎設施中。但要支持涉及 PHI 的 HIPAA 合規工作流,醫療組織需要使用符合資格的服務,確保服務被與 OpenAI 簽署的 BAA 覆蓋,配置安全設置和數據保留策略,並通過組織權限限制 Agent 能訪問的記錄與操作。因此,“支持 HIPAA 工作流”不等於“所有 OpenAI API 調用自動合規”。
可用渠道方面,相關能力可以通過 OpenAI API、ChatGPT for Healthcare、ChatGPT for Clinicians、ChatGPT Work 和 Codex 使用。符合條件的美國臨牀人員可以免費申請 ChatGPT for Clinicians,這一免費政策有地域和資格限制。ChatGPT for Healthcare 沒有公開統一的固定訂閱價格。
分析判斷:醫療 Agent 的取捨與產業意義
爲什麼醫療行業特別需要 Computer Use 型 Agent?
醫療服務的信息割裂非常典型。一次就診可能同時涉及 EHR、影像系統、處方系統、保險門戶、轉診系統和出院管理平臺,這些系統往往來自不同廠商,接口並不完整。MRI 預授權就是一個縮影:醫生只做了一個臨牀判斷,工作人員卻要在病歷、物理治療記錄、影像資料和保險門戶之間反覆切換、複製和上傳。
從這個角度看,Computer Use 解決的並不是“AI 懂不懂醫學”,而是“信息能不能在系統之間流動”。筆者的判斷是,醫療行政自動化很可能比臨牀診斷自動化更早形成商業規模。原因在於行政任務量大、重複性高、邊界清晰,結果可以通過表單和系統狀態覈驗,責任風險也相對可控。Cigna 把跨 10 多套系統查找信息壓縮到數秒的案例,就體現了這種“先減負、不替代”的路徑。
不過,斯坦福基準也揭示了真正的難點。早期研究發現,跨應用數據傳輸和文檔處理是 Agent 失敗的重要來源,即使理解了患者信息,也可能在上傳文件、填寫字段或更新狀態時出錯。在醫療場景中,一個系統裏的錯誤還可能被複制到多個下游系統,這正是人工審批和操作後狀態驗證不可省略的原因。
開發者如何評估醫療 Agent 的成本與可行性?
對開發者來說,第一步不必直接上 Computer Use。較穩妥的做法是先把工作流拆開:信息抽取、材料起草這類純文本環節,可以先用普通模型接口驗證質量;界面操作環節再單獨評估成功率。以下示例用合成材料驗證“預授權所需字段抽取”這一文本環節,僅作技術演示,不構成任何診療建議:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # 以平臺實際可用模型列表爲準
    messages=[{"role": "user", "content": "從以下合成病歷中列出影像檢查預授權需要覈對的字段清單:……"}]
)
print(resp.choices[0].message.content)
查看帶 Token 成本統計的完整代碼
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 單價:美元 / 百萬 Token,按你實際使用的模型填寫
PRICE = {"input": 0.10, "output": 0.50, "cached_input": 0.01}

def run_step(prompt: str, model: str = "gpt-4o-mini") -> dict:
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": "你只做字段抽取,不給出任何診療建議,信息不明確時輸出 NEED_HUMAN。"},
            {"role": "user", "content": prompt},
        ],
    )
    u = resp.usage
    cached = getattr(getattr(u, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    cost = ((u.prompt_tokens - cached) * PRICE["input"]
            + cached * PRICE["cached_input"]
            + u.completion_tokens * PRICE["output"]) / 1_000_000
    return {"text": resp.choices[0].message.content, "cost_usd": round(cost, 6)}

steps = ["合成病歷片段 A ……", "合成病歷片段 B ……"]
total = 0.0
for s in steps:
    r = run_step(s)
    total += r["cost_usd"]
    print(r["text"])
print("模型 Token 成本合計(不含工具、環境與維護):", round(total, 6))
🚀 快速驗證建議:在正式接入醫療系統之前,可以先通過 API易 apiyi.com 用一個 API Key 對比多家模型在字段抽取、材料起草等文本環節的表現。新用戶有免費測試額度,適合先跑通評測腳本、積累任務級數據。
成本方面,2026 年 11 月 17 日查詢到的 Standard 短上下文價格(美元/百萬 Token)如下:GPT-6 Astra 輸入 10、輸出 50、緩存輸入 1;GPT-6 Luna 輸入 0.10、輸出 0.50、緩存輸入 0.01。處理速度、上下文長度和地域都會影響實際計費。按 Luna 每任務 0.085 美元和“低 98%”的比例反推,Astra 約爲每任務 4.25 美元,但這是估算值,而且只是基準條件下的成本,不能當作生產報價。
完整覈算應該把每一輪的視覺與文本輸入、計費輸出分別統計,再加上工具調用、運行環境和工程維護。如果重試產生的 Token 已經累計進總量,就不要再額外加一遍。兩檔模型之間接近 50 倍的價差也提示了一種分層思路:複雜推理交給高能力模型,結構化、高頻的步驟交給低成本模型,已經探索穩定的流程則像 CVS 那樣固化成確定性代碼。
💰 成本優化提示:做模型分層時,可以先在 API易 apiyi.com 上用同一套 OpenAI 兼容代碼切換不同價位的模型,跑出每類子任務的質量與 Token 消耗,再決定哪些環節值得用高能力模型。
| 驗證階段 | 要回答的問題 | 建議證據 | 參考工具 |
|---|---|---|---|
| 文本環節 | 抽取和起草質量是否穩定 | 人工標註對照、NEED_HUMAN 觸發率 | API易 apiyi.com 多模型對比 |
| 界面操作 | 端到端完成率是多少 | 截圖與 Trace、操作後狀態覈驗 | OpenAI Computer Use 文檔與沙箱環境 |
| 流程固化 | 哪些步驟可轉爲確定性代碼 | 成功軌跡復現率 | CUA Agent Kit 類兩階段架構 |
| 上線治理 | 權限和審批是否覆蓋關鍵動作 | RBAC 配置、審計日誌抽查 | 機構自有權限與合規體系 |
醫療 Agent 與 RPA 是替代還是融合?
傳統 RPA 依賴固定規則和界面定位,界面一變腳本就可能失效;Computer-use Agent 能理解自然語言、觀察當前界面並適應變化,但每次重新推理會帶來成本和結果波動。一項比較兩類技術的研究(DOI:10.1080/23311975.2026.2724760)中,P2、P3 兩個流程每種技術各執行 10 次;P1 流程中 Agent 只有 1 次失敗記錄,未納入後續統計,所以不能籠統地說所有任務都執行了 10 次。該研究使用的是 2025 年的工具配置,不能直接代表 2026 年模型的成績。
筆者認爲,CVS 的“AI 探索、代碼固化、重複執行”更可能成爲主流工程形態:Agent 負責發現和理解陌生流程,確定性代碼負責穩定地重複已知流程,API 繼續承擔高頻、結構化的交互,人工審批守住關鍵節點。API、Computer Use、確定性代碼和人工審批組合在一起,比單押任何一種技術都更現實。
醫療 Agent 對整個 AI 產業意味着什麼?
醫療只是一個高門檻的試驗場。它的系統碎片化、合規要求和責任邊界都比一般企業更嚴苛,如果執行型 Agent 能在這裏建立起可審計、可暫停、權限對齊的運行方式,這套方法就可以遷移到保險、金融、政務等同樣依賴老舊系統的行業。
這也意味着產業競爭維度在變化。過去比的是模型能不能寫出好內容,接下來更要比能不能在真實系統裏把事辦完、出錯時能否及時停下、每一步能否留痕追溯。對軟件廠商來說,Computer Use 讓 AI 公司無需完全控制底層軟件也能參與工作流,這會降低集成門檻,也會給“等廠商開放接口”的舊模式帶來壓力。但高可靠、高頻的交互仍然更適合 API,Computer Use 更像是補位者,而不是取代者。
接下來值得關注幾件事:OpenAI 是否會公開逐任務評測數據和完整實驗配置;HealthAdminBench 論文版本能否成爲各家統一對比的口徑;Abridge 的出院協調方案能否從開發進入部署;以及更多醫院的生產數據能否證明端到端完成率真正可用。在這些證據出現之前,演示與評分只是起點,而不是結論。
醫療 Agent 已經證明自己能“動手”,但它能否真正減輕臨牀和行政負擔,還要看它在真實工作流中的端到端完成率、出錯時的停止能力和長期成本。正如那句英文諺語所說:The proof of the pudding is in the eating.(實際效果要靠實踐檢驗。)
參考資料
- OpenAI 官方公告:Advancing computer-use agents for healthcare teams
- 鏈接:
openai.com/index/advancing-computer-use-for-healthcare-teams
- 鏈接:
- ChatGPT for Healthcare 幫助文檔:產品能力、BAA 與插件說明
- 鏈接:
help.openai.com/en/articles/20001046-chatgpt-for-healthcare
- 鏈接:
- OpenAI Computer Use 開發文檔:Computer Tool 與 Code Execution 路徑
- 鏈接:
developers.openai.com/api/docs/guides/tools-computer-use
- 鏈接:
- HealthAdminBench 論文:2604.09937v1 版本任務與指標
- 鏈接:
arxiv.org/html/2604.09937v1
- 鏈接:
- CVS Health CUA Agent Kit:兩階段探索與固化架構
- 鏈接:
github.com/cvs-health/cua-agent-kit
- 鏈接:
- Fierce Healthcare 報道:HLTH26 合作方與應用場景
- 鏈接:
fiercehealthcare.com/ai-and-machine-learning/hlth26-cvs-health-cigna-and-ambience-collaborating-openai-test-computer-use
- 鏈接:
- Cambridge Dictionary:諺語原文覈對
- 鏈接:
dictionary.cambridge.org/us/dictionary/english/proof-of-the-pudding-is-in-the-eating
- 鏈接:
作者:APIYI 技術團隊
技術交流:如需對比多家大模型在 Agent 文本環節的表現,歡迎訪問 API易 apiyi.com 獲取測試額度,更多接入說明可查看 docs.apiyi.com 文檔中心