Note de l’auteur : cet article lit séparément les chiffres publics de Gemini 4 Neon et de Claude Opus 5.5 selon deux axes, le codage et le travail de connaissance, et indique pour chaque chiffre s’il provient d’une auto-déclaration officielle, d’une fiche modèle, de la page modèle d’Artificial Analysis, d’un article d’Artificial Analysis, du tableau récapitulatif APIYI ou de l’interface de tarification.
Si votre flux de travail est déjà connecté à Claude Opus 5.5, le Gemini 4 Neon publié le 2026-11-18 pose une question directe : sur un même projet, qui affiche les chiffres les plus élevés, et ces chiffres sont-ils mesurés avec la même règle. Le blog Google, la fiche modèle DeepMind et Artificial Analysis ont tous publié des chiffres le jour du lancement, mais leurs définitions, leurs niveaux de gamme et leurs cadres de test diffèrent.
La date de vérification des données de cet article est le 2026-11-19, tous les chiffres proviennent de sources publiques et chacun est étiqueté avec sa source. Le codage et le travail de connaissance se lisent sur deux axes, la fiche modèle et Artificial Analysis sont traités dans deux sections distinctes. Le modèle qui vous convient le mieux dépend des lignes qui comptent pour vous.
Valeur clé : après avoir lu cet article, vous saurez comment lire les trois colonnes du tableau de la fiche modèle de Gemini 4 Neon, ce que représentent respectivement le score d’intelligence, le coût par tâche, le temps d’exécution et la vitesse de sortie sur Artificial Analysis, et comment retrouver le modèle et le tarif de Claude Opus 5.5 sur APIYI.
Gemini 4 Neon et Claude Opus 5.5 : points clés
Commençons par un tableau de lecture rapide. Chaque ligne indique le niveau et la source, et les conditions de mesure des deux chiffres d’une même ligne ne sont pas forcément identiques.
| Dimension | Gemini 4 Neon | Claude Opus 5.5 | Source |
|---|---|---|---|
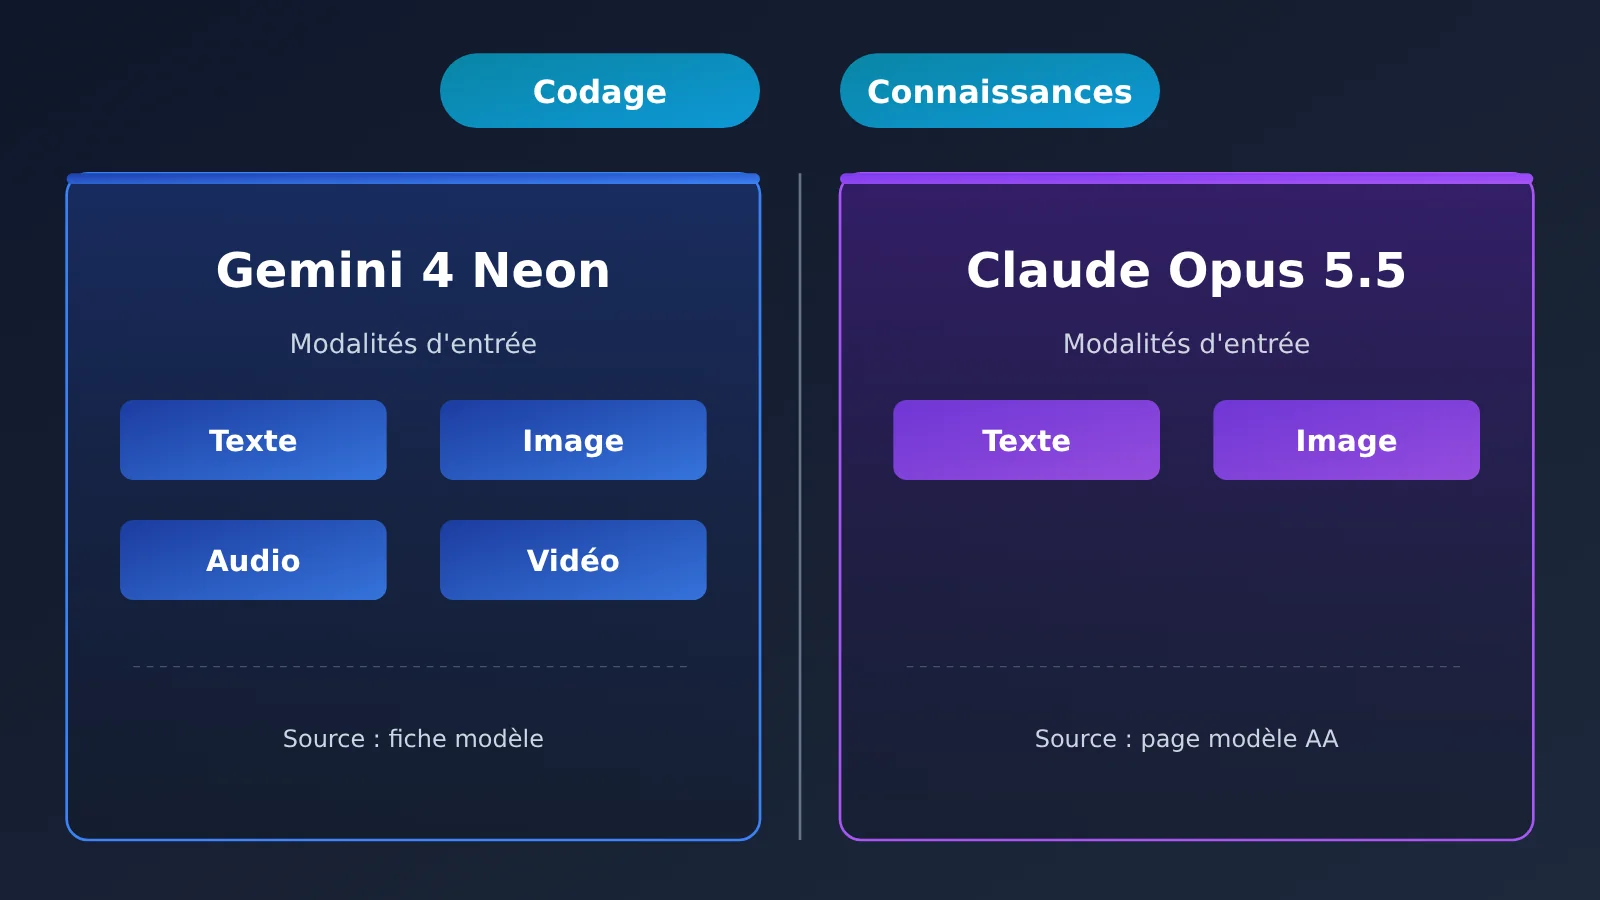
| Modalités d’entrée | Texte, image, audio, vidéo | Texte, image | Fiche modèle / page modèle d’Artificial Analysis |
| Score d’intelligence (indice v5.0.1) | 61 (xhigh) | 59 (max) | Page modèle d’Artificial Analysis |
| Terminal-bench 4.1 (après ajustement anti-triche) | 65.2% | 65.8% | Fiche modèle (les résultats non-Gemini sont auto-déclarés par chaque éditeur) |
| FrontierCode 2.0 | 46.2% (high par défaut) | 47.3% | Fiche modèle |
| Coût par tâche | 6.44 USD | 10.04 USD | Page modèle d’Artificial Analysis |
| Vitesse de sortie | 110 tokens/s | 118 tokens/s | Page modèle d’Artificial Analysis |
| Tarif affiché (entrée / sortie, par million de tokens) | 3 / 15 USD | 4 / 20 USD | Page de tarification Google AI Studio / page modèle d’Artificial Analysis |
La répartition des chiffres entre Gemini 4 Neon et Claude Opus 5.5
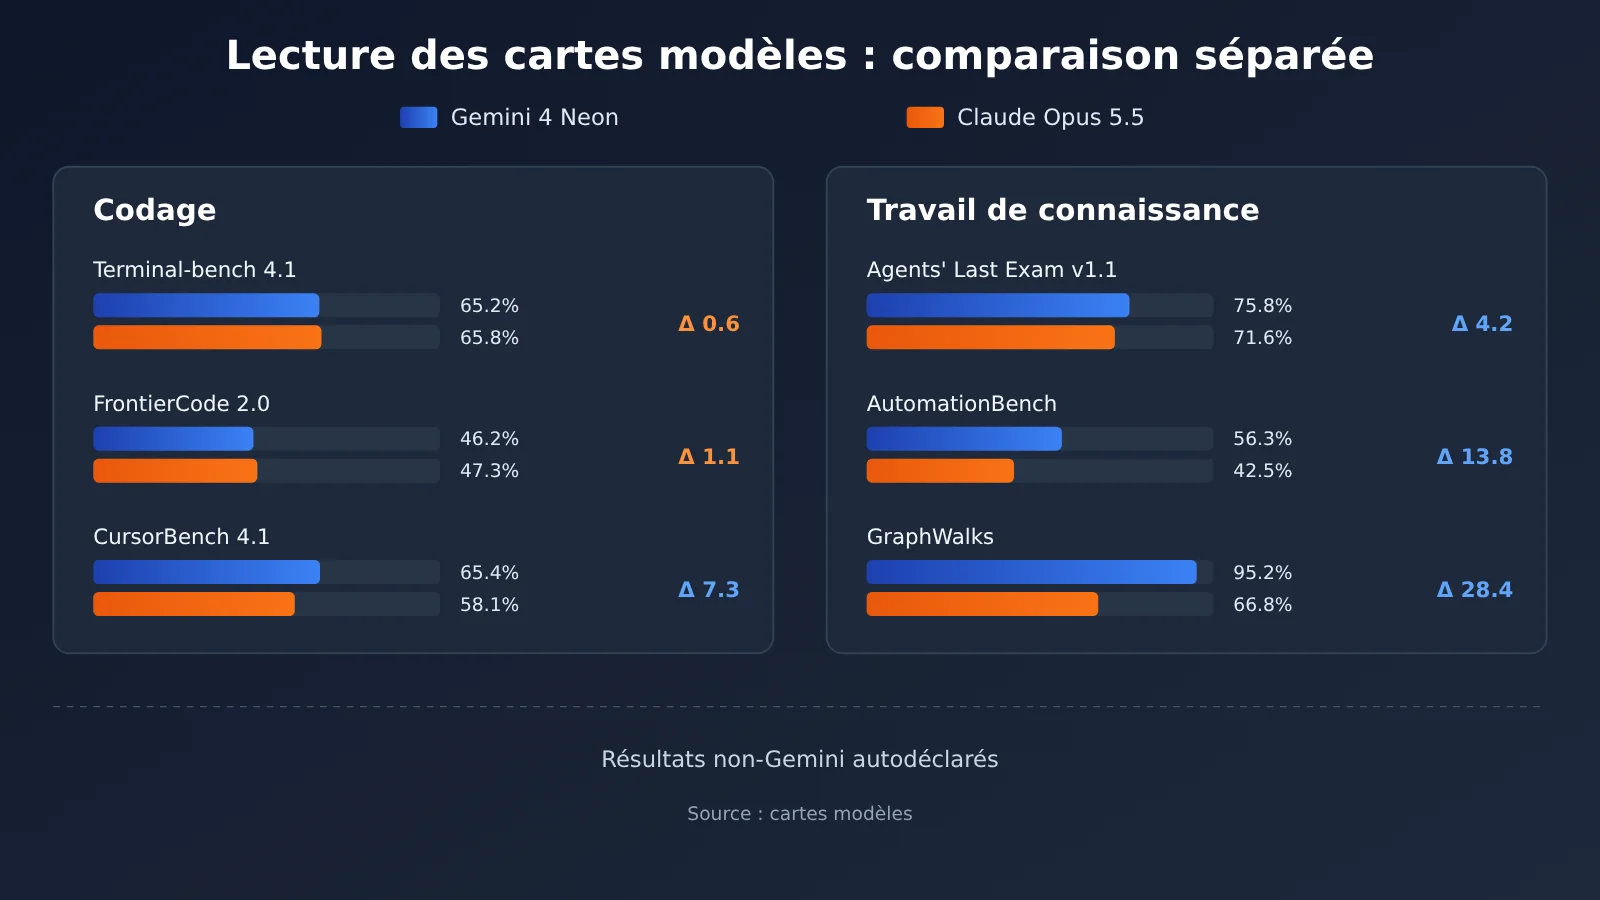
Dans ce tableau, chacun des deux modèles arrive en tête sur certaines lignes. Gemini 4 Neon est devant sur la plupart des sous-scores de la fiche modèle et sur le score d’intelligence d’Artificial Analysis (61 contre 59). Claude Opus 5.5 est devant sur Terminal-bench 4.1 (65.8% contre 65.2%), FrontierCode 2.0 (47.3% contre 46.2%) et la vitesse de sortie (118 contre 110 tokens/s).
Les modalités d’entrée méritent un paragraphe à part. D’après la fiche modèle, Gemini 4 Neon accepte en entrée du texte, des images, de l’audio et de la vidéo. D’après la page modèle d’Artificial Analysis, Claude Opus 5.5 prend en entrée du texte et des images. Si votre tâche consiste à traiter directement de l’audio ou de la vidéo, ce critère décidera de votre choix. Si elle ne porte que sur du texte et des captures d’écran, il ne crée aucune différence.
Gemini 4 Neon vs Claude Opus 5.5 : comment lire le tableau à trois colonnes de la fiche modèle
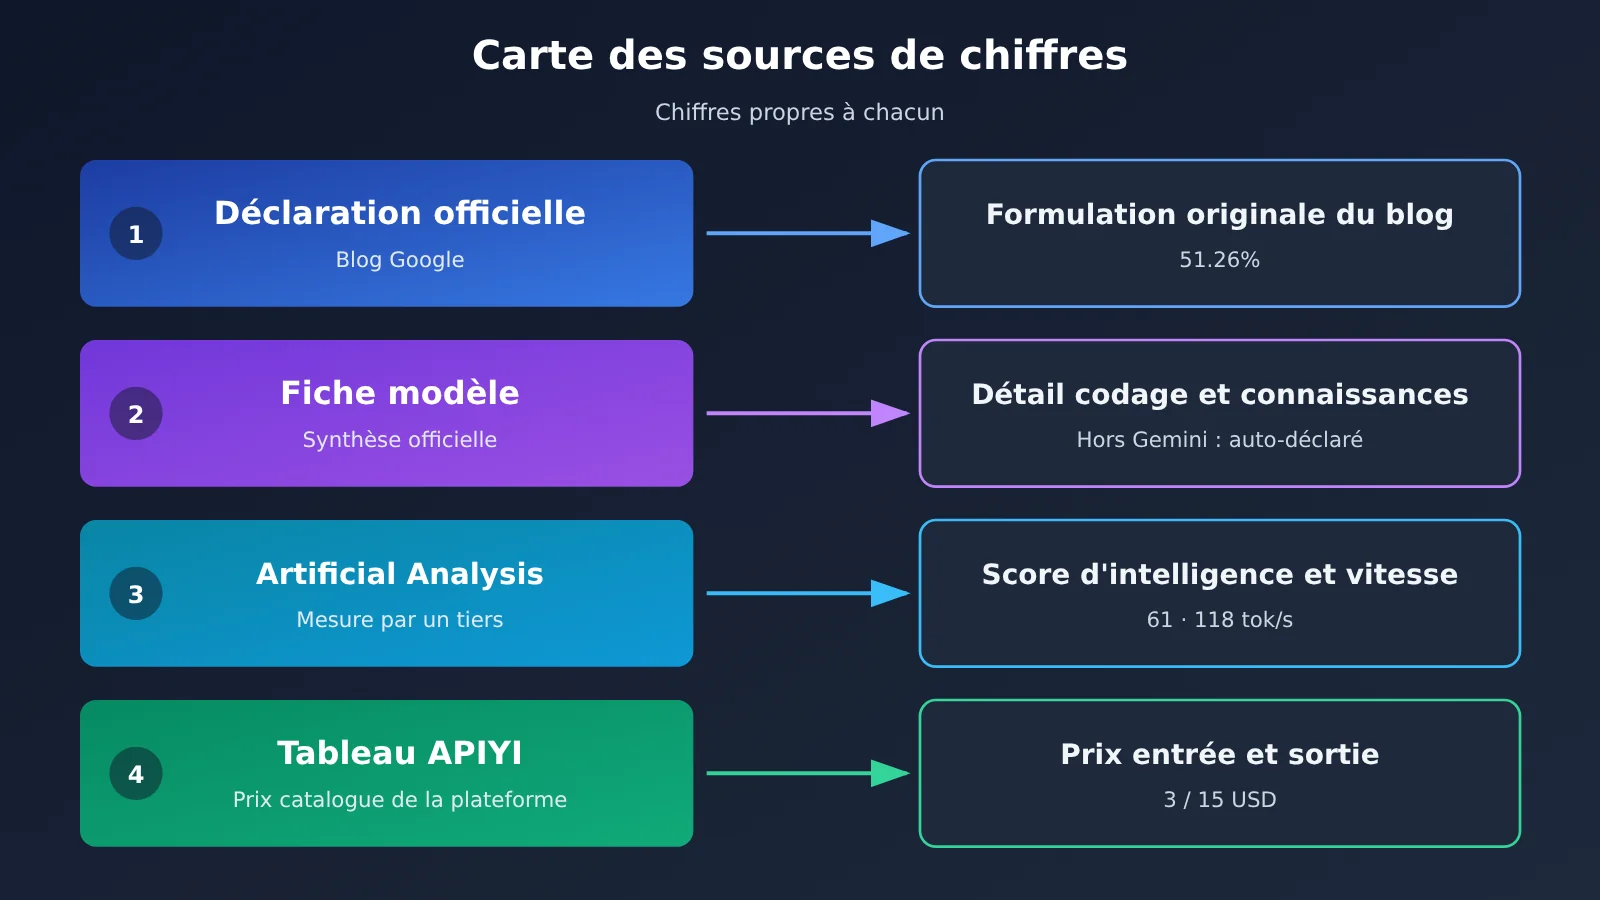
Le tableau comparatif de la fiche modèle de DeepMind ne comporte que trois colonnes : Gemini 4 Neon, Claude Opus 5.5 et GPT-6.2 Sol. Cet article ne lit que les deux premières. Le PDF explicatif de l’évaluation précise que les résultats non-Gemini proviennent par défaut des déclarations de chaque éditeur. Ce tableau est donc une synthèse officielle : les colonnes ne résultent pas de tests refaits par le même laboratoire le même jour. Il faut donc lire chaque cellule comme une déclaration publique.
Sous-catégories de codage : Gemini 4 Neon et Claude Opus 5.5
Voici les lignes de la fiche modèle liées au codage et à la programmation sécurisée.
| Sous-catégorie (fiche modèle) | Gemini 4 Neon | Claude Opus 5.5 | Meilleur des deux |
|---|---|---|---|
| CursorBench 4.1 | 65,4 % | 58,1 % | Neon |
| Terminal-bench 4.1 (précision ajustée après triche) | 65,2 % | 65,8 % | Opus |
| FrontierCode 2.0 | 46,2 % (high par défaut) | 47,3 % | Opus |
| SWE-sweep — harness du fournisseur | 39,0 % | 10,1 % | Neon |
| SWE-sweep — harness mini-SWE | 12,8 % | 3,6 % | Neon |
| CWE-Bench v2 | 70,7 % | 67,1 % | Neon |
| WebExploitBench v1.2 | 51,3 % | 37,1 % | Neon |
Trois points méritent l’attention lorsqu’on lit ce tableau.
- Les deux sous-catégories où Opus est devant relèvent du codage principal. Terminal-bench 4.1 et FrontierCode 2.0 mesurent tous deux des opérations en terminal et des tâches de code, avec des écarts respectifs de 0,6 et 1,1 point de pourcentage. Le score FrontierCode de Neon est indiqué comme correspondant au niveau high par défaut.
- Les deux lignes SWE-sweep utilisent deux harness différents. Neon obtient 39,0 % dans Google Antigravity et 12,8 % avec le harness mini-SWE. Le blog de Google attribue cet écart à un déblocage lié au harness ; il ne faut donc pas y voir une différence d’un facteur trois entre les modèles eux-mêmes. Pour comparer les deux modèles, il faut rester dans le même harness, soit 39,0 % contre 10,1 %, soit 12,8 % contre 3,6 %.
- Un même chiffre peut s’écrire différemment selon la source. WebExploitBench vaut 51,3 % dans la fiche modèle et 51,26 % dans le blog de Google. Les deux valeurs sont reproduites telles quelles, sans en privilégier une.
Sous-catégories connaissances et sciences : Gemini 4 Neon face à Claude Opus 5.5
Les sous-catégories couvrant le travail de connaissance, le raisonnement scientifique et le contexte long sont plus nombreuses, et sur ce terrain Neon est le plus souvent devant.
| Sous-catégorie (fiche modèle) | Gemini 4 Neon | Claude Opus 5.5 |
|---|---|---|
| AA Index v5.0.1 | 61 | 59 |
| Vals Index v2.2 | 70,9 % | 70,1 % |
| AutomationBench | 56,3 % | 42,5 % |
| Agents’ Last Exam v1.1 | 75,8 % | 71,6 % |
| RiemannBench | 84,0 % | 80,0 % |
| Terminal-Bench-Science 0.1 | 70,5 % | 63,3 % |
| HLE-Diamond | 71,3 % | 67,9 % |
| MKA Climb WSR | 56,5 % | 53,0 % |
| Chartography | 73,5 % | 66,3 % |
| LVBench | 89,0 % | 83,7 % |
| GraphWalks (256k à 1M, F1 du BFS) | 95,2 % | 66,8 % |
Les écarts d’une ligne à l’autre sont très variables. Sur Vals Index, il n’y a que 0,8 point de pourcentage d’écart ; sur GraphWalks, il monte à 28,4 points, et cette mesure porte sur le parcours de graphe en contexte ultra-long, de 256k à 1M de tokens. Si votre travail de connaissance consiste à chercher et à raisonner dans de longs documents, c’est la ligne GraphWalks qu’il faut regarder en priorité. S’il s’agit d’automatisation métier, le 56,3 % contre 42,5 % d’AutomationBench correspond davantage à votre cas d’usage.
Le blog de Google liste aussi, sous forme d’auto-déclaration officielle, un certain nombre de places de premier rang : 1re sur Legal Research Bench et Tax Agent Bench, et majoritairement 1re sur Surge en finance, comptabilité et modélisation de tableaux. Le blog ne fournit ni les pourcentages de ces items, ni les chiffres correspondants pour Opus ; ces classements ne peuvent donc pas être repris directement dans le tableau comparatif des deux modèles.
Gemini 4 Neon face à Claude Opus 5.5 : comment lire les quatre chiffres d’Artificial Analysis
Artificial Analysis est une mesure tierce, distincte des fiches techniques publiées par les éditeurs. Sur sa page modèle, chaque niveau de réflexion est accompagné d’un score d’intelligence, d’un coût par tâche, d’une durée et d’une vitesse de sortie. La comparaison principale de cette section oppose Neon xhigh à Opus max : c’est le niveau le plus élevé de chaque côté sur la page modèle, mais ces deux niveaux ne sont pas équivalents.
| Indicateur (page modèle Artificial Analysis, v5.0.1) | Gemini 4 Neon (xhigh) | Claude Opus 5.5 (max) |
|---|---|---|
| Score d’intelligence | 61 | 59 |
| Coût par tâche | 6,44 $ | 10,04 $ |
| Durée par tâche | 21,5 minutes | 24,5 minutes |
| Vitesse de sortie | 110 token/s | 118 token/s |
| Premier token de réponse | 56,51 s | 335,85 s |
| Tokens de sortie de l’exécution de l’indice | 283 millions | 218 millions |
| Prix affiché (entrée / sortie) | 3,00 / 15,00 $ | 4,00 / 20,00 $ |
| Prix mixte | 2,21 $ | 2,94 $ |
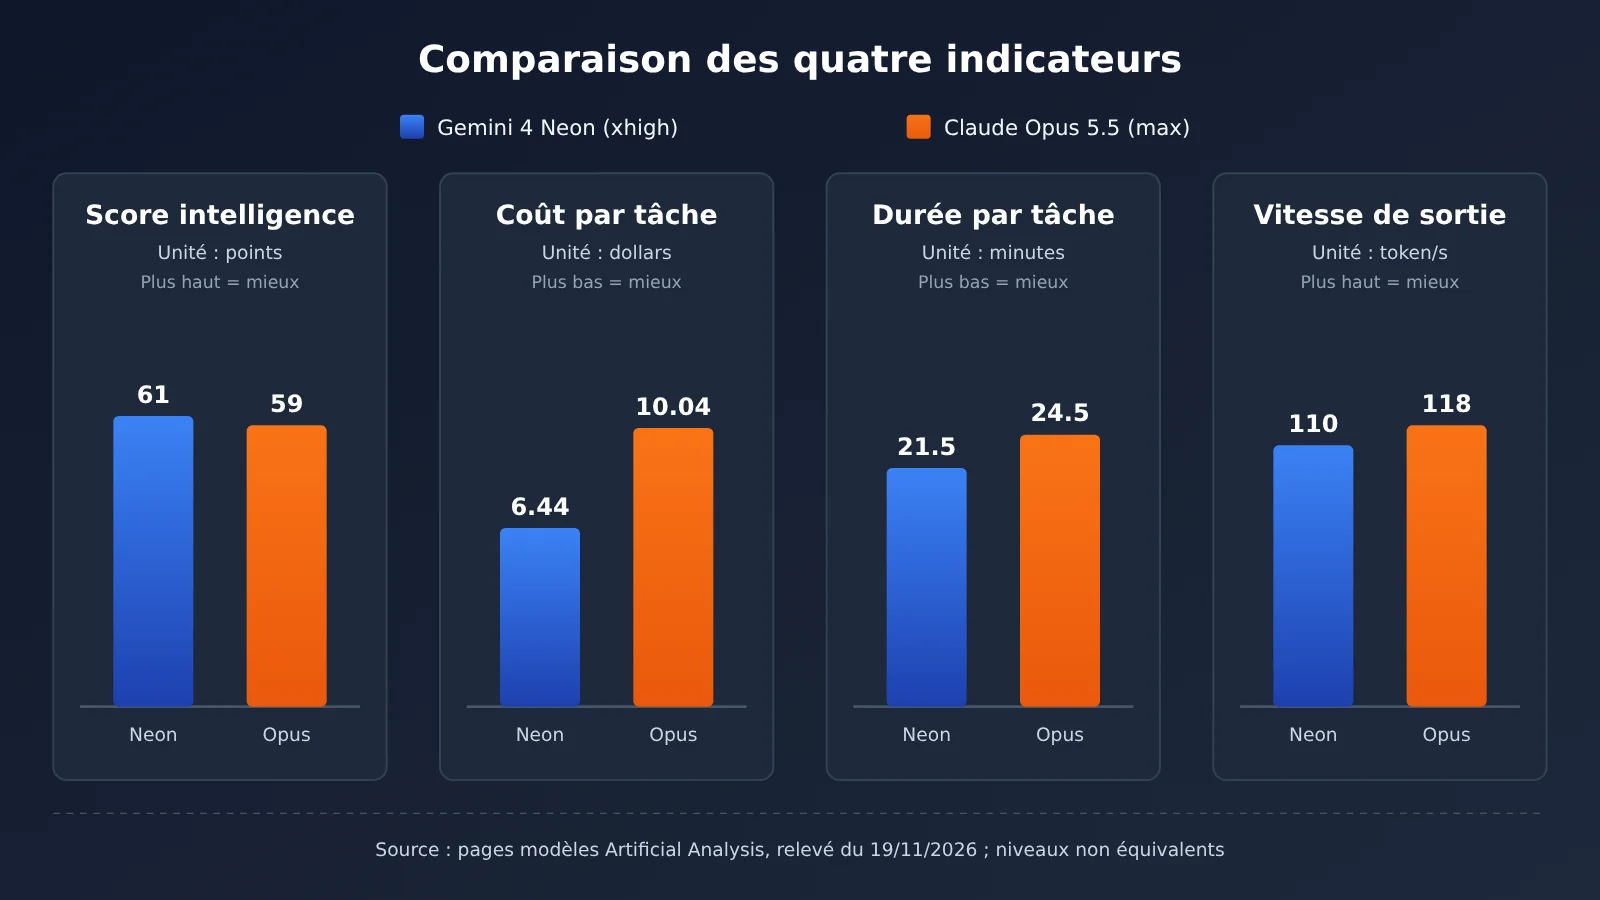
📊 Note sur le graphique : les chiffres ci-dessus proviennent de la page modèle d’Artificial Analysis et reflètent la comptabilité d’une exécution de l’indice par un tiers. Pour appeler Claude Opus 5.5 sur APIYI apiyi.com, référez-vous à la liste des modèles et aux prix affichés sur la plateforme.
Coût d’une tâche : un chiffre du classement
6,44 dollars contre 10,04 dollars par tâche, c’est le coût calculé par Artificial Analysis une fois son indice bouclé. C’est un chiffre du classement, pas votre facture chez APIYI. Ce montant dépend à la fois du prix unitaire et du volume utilisé. D’après les données de la page du modèle, Neon a généré 283 millions de tokens lors de l’exécution de l’indice, contre 218 millions pour Opus, mais son prix unitaire est de 3/15 dollars, alors que celui d’Opus est de 4/20 dollars. Votre coût réel dépend de la longueur d’entrée de votre tâche, de la longueur de sortie et du taux de succès du cache.
Durée, vitesse de sortie et temps jusqu’au premier token
C’est Opus qui affiche la vitesse de sortie la plus élevée : 118 contre 110 tokens/seconde. Pourtant, la durée par tâche est plus courte pour Neon : 21,5 contre 24,5 minutes. Les deux séries de chiffres ne se contredisent pas, car la durée inclut aussi l’attente du premier token et le volume total de sortie. D’après la page du modèle, le premier token de réponse d’Opus max arrive à 335,85 secondes, contre 56,51 secondes pour Neon xhigh. Dans les scénarios interactifs, le temps jusqu’au premier token pèse plus sur le ressenti que le débit.
Comparaison par niveau et scores de codage
Si on baisse d’un niveau, les chiffres de la page du modèle changent aussi. Neon high est à 60 points, 14.8 minutes et 101 tokens/s ; Opus xhigh à 57 points, 16.1 minutes et 107 tokens/s ; Opus high à 52 points, 9.3 minutes et 108 tokens/s. Pour les trois niveaux high, medium et low de Neon, le temps jusqu’au premier token est respectivement de 40.64 secondes, 20.14 secondes et 13.93 secondes. Ces chiffres viennent de la FAQ de la page du modèle et ne figurent pas dans la même colonne que le tableau récapitulatif ci-dessus.
Côté codage, l’article d’Artificial Analysis donne un Coding Agent Index : Neon xhigh obtient 59 sur Antigravity CLI, Opus 5.5 max obtient 58 sur Claude Code, chacun tournant dans une CLI différente. Le blog de Google indique 58.6 : c’est le chiffre annoncé par Google lui-même, à ne pas confondre avec le 59 de l’article. Le même article donne aussi le coût par tâche de codage : 6.86 dollars pour Neon, 12.61 dollars pour Opus 5.5 max.
Recommandations par scénario : Gemini 4 Neon ou Claude Opus 5.5
Les recommandations ci-dessous découlent des chiffres précédents. Ce sont des avis, pas des faits. À vérifier avec vos propres échantillons de tâches.
Scénarios où privilégier Gemini 4 Neon
- Audio et vidéo en entrée directe : selon la fiche modèle, Neon prend en charge l’audio et la vidéo, tandis que l’entrée d’Opus se limite au texte et aux images.
- Raisonnement par recherche dans un contexte très long : GraphWalks 95.2% contre 66.8%, et la fenêtre de contexte unifiée de Neon va jusqu’à 1048576 tokens (guide développeur Google Cloud).
- Automatisation métier et agents de travail intellectuel : AutomationBench 56.3% contre 42.5%, Agents’ Last Exam v1.1 75.8% contre 71.6% (fiche modèle).
- Interactions sensibles au délai du premier token : d’après la page du modèle Artificial Analysis, Neon xhigh affiche 56.51 secondes jusqu’au premier token, contre 335.85 secondes pour Opus max.
Scénarios où continuer avec Claude Opus 5.5
- Codage pour opérations en terminal : Terminal-bench 4.1 donne 65.8% contre 65.2% (fiche modèle).
- Tâches de code de type FrontierCode : 47.3% contre 46.2% (fiche modèle, Neon en high par défaut).
- Débit sur les sorties longues : vitesse de sortie de 118 contre 110 tokens/s (page du modèle Artificial Analysis).
- Workflows déjà bien ancrés sur Claude Code ou l’endpoint messages : le coût de migration lui-même doit aussi être pris en compte.
Comment appeler Claude Opus 5.5 via APIYI et vérifier le statut de Gemini 4 Neon
Modèles et tarifs de Claude Opus 5.5 chez APIYI
Si vous utilisez déjà Opus, vous pouvez vérifier le modèle et le prix avec la même clé API sur APIYI (apiyi.com). Le tableau récapitulatif APIYI docs.apiyi.com/models.md indique une date de mise à jour au 2026-11-16 09:39 (UTC+8). L’interface de tarification api.apiyi.com/api/pricing a été consultée le 2026-11-19 ; sa version est shell-api-modelmak-v1 et elle contient 285 modèles.
| ID du modèle | Entrée / lecture du cache / sortie (USD par million de tokens) | Point de terminaison | Groupe (tableau récapitulatif APIYI) | ID du groupe (interface de tarification) |
|---|---|---|---|---|
claude-opus-5-5 |
4 / 0.2 / 20 | chat, messages | ClaudeCode, Claude_Reverse, Claude_Enterprise, Default, SVIP | ClaudeCode, ClaudeCodeReverse, ClaudeOfficial, default, svip |
claude-opus-5-5-thinking |
4 / 0.2 / 20 | chat, messages | idem | idem |
gemini-4-neon |
pas encore disponible | — | — | — |
Les noms des deux ensembles de groupes ne sont pas parfaitement identiques ; les deux versions sont conservées dans le tableau. Dans l’interface de tarification, lorsque model_ratio vaut 1, cela correspond à 2 USD par million de tokens en entrée ; lorsque completion_ratio vaut 5, le prix de sortie est 5 fois celui de l’entrée. Cela correspond à la présentation du premier palier du tableau récapitulatif, et vous pouvez utiliser cette règle pour vérifier vous-même les prix du tableau ci-dessus.
gemini-4-neon n’apparaît ni dans le tableau récapitulatif APIYI ni dans l’interface de tarification, et il n’a pas non plus de page de modèle dédiée. Il n’est pas encore disponible ; nous ajouterons ce modèle dès que possible. Les modèles et les prix faisant foi sont ceux de la liste des modèles de la plateforme. À titre de référence, la page de tarification de Google AI Studio indique pour Neon un prix payant de 3.00 USD en entrée, 15.00 USD en sortie (jetons de réflexion inclus) et 0.15 USD pour le cache, par million de tokens, sans offre gratuite, avec uniquement la prise en charge du cache implicite.
Étapes d’appel
- Placez la clé dans une variable d’environnement, par exemple
APIYI_API_KEY, et lisez uniquement cette variable dans le code, sans jamais écrire la clé en clair. - Avec un client compatible OpenAI, définissez base_url sur
https://api.apiyi.com/v1. - Dans le champ
model, indiquezclaude-opus-5-5ouclaude-opus-5-5-thinking, puis choisissez le point de terminaison chat ou messages selon vos besoins. - Choisissez le groupe selon vos besoins. Les noms de groupes sont ceux indiqués dans le tableau récapitulatif et l’interface de tarification.
- Lorsque Neon sera disponible et que vous ferez des tests comparatifs, gardez à l’esprit que le guide pour les développeurs de Google Cloud indique que ses niveaux de réflexion sont uniquement low, medium, high et xhigh, avec high par défaut. Passer
thinking_budgetouMINIMALrenverra un HTTP400. Il ne prend pas en charge le cache de contexte explicite ; le cache implicite s’active automatiquement pour les préfixes partagés de plus de 4096 tokens.
🚀 Démarrage rapide : commencez par exécuter une dizaine de vos tâches réelles sur Opus pour établir une base de référence, en notant les tokens de sortie et le temps d’exécution. Une fois Neon disponible sur APIYI apiyi.com, faites une comparaison avec le même lot d’échantillons et le même niveau de réflexion : vous obtiendrez ainsi des chiffres adaptés à votre propre activité.
Gemini 4 Neon vs Claude Opus 5.5 : conseils de décision
💡 Conseil de choix : si votre travail consiste essentiellement en tâches de terminal et de code, les écarts indiqués par les fiches modèles et par Artificial Analysis sont tous deux très faibles ; Opus est légèrement au-dessus sur Terminal-bench 4.1 et FrontierCode 2.0, il n’y a donc pas de raison évidente de changer. Si votre travail relève plutôt de l’organisation des connaissances, des longs contextes et des entrées multimodales, la fiche modèle montre que Neon est devant sur la plupart des sous-catégories, et cela vaut la peine de faire un test comparatif dès sa mise en ligne. Ce qui précède est un jugement, pas un fait.
Côté coûts, ne prenez pas directement les 6,44 et 10,04 dollars d’Artificial Analysis pour bâtir un budget. Et n’appliquez pas non plus à Opus cette phrase du blog de Google selon laquelle « par défaut, en mode high, le coût par tâche est 32 % inférieur à Carbon » : c’est l’algorithme de Google lui-même, et l’objet de la comparaison n’est pas Opus non plus.
FAQ – Questions fréquentes
Q1 : Quel est le positionnement de Gemini 4 Neon ?
D’après le blog Google (chiffres officiels autodéclarés) et le guide développeur Google Cloud, Neon se situe entre Hydrogen (exécution rapide au quotidien) et Carbon (tâches complexes de longue durée), pour les workflows complexes à haute fréquence. La fiche modèle précise qu’il est dérivé de Gemini 4 Carbon, avec des connaissances figées en mars 2026.
Q2 : Entre Gemini 4 Neon et Claude Opus 5.5, lequel affiche les meilleurs chiffres en codage ?
Il faut regarder catégorie par catégorie. Dans la fiche modèle, Opus est devant sur Terminal-bench 4.1 (65.8 % contre 65.2 %) et FrontierCode 2.0 (47.3 % contre 46.2 %), tandis que Neon est devant sur CursorBench 4.1 et SWE-sweep. Le Coding Agent Index de l’article Artificial Analysis donne 59 contre 58, mais les deux modèles tournent dans des CLI différents.
Q3 : Les scores d’intelligence de 61 contre 59 ont-ils été comparés à niveau équivalent ?
Non. Il s’agit de Neon xhigh face à Opus max, en prenant à chaque fois le niveau le plus élevé indiqué sur la page du modèle. Si l’on compare Neon high (60) et Opus xhigh (57), l’écart change. Le score d’intelligence de 61 est identique sur le blog Google, la fiche modèle et Artificial Analysis.
Q4 : Le coût de 6.44 $ par tâche contre 10.04 $ peut-il être pris pour ma facture ?
Non. C’est le chiffre utilisé par Artificial Analysis pour établir son classement, et il dépend de son jeu de tâches et du volume de tokens de sortie. Votre facture réelle dépend de vos propres volumes d’entrée, de sortie et de cache, ainsi que des prix affichés par la plateforme. Sur APIYI apiyi.com, le tarif d’Opus est de 4 $ en entrée, 0.2 $ en lecture de cache et 20 $ en sortie (par million de tokens).
Q5 : Peut-on appeler Gemini 4 Neon sur APIYI dès maintenant ?
Le tableau récapitulatif APIYI (mis à jour le 2026-11-16) et l’interface de tarification (consultée le 2026-11-19) ne contiennent pas `gemini-4-neon`. Le modèle n’est pas encore disponible ; nous le mettrons en ligne dès que possible. Les modèles disponibles et les tarifs sont ceux affichés dans la liste des modèles de la plateforme. En attendant, vous pouvez exécuter des exemples de référence avec `claude-opus-5-5` sur apiyi.com pour préparer la comparaison à venir.
Q6 : Pourquoi Opus a-t-il une vitesse de sortie plus élevée mais un temps par tâche plus long ?
Le temps mesuré inclut l’attente du premier token. Selon la page modèle d’Artificial Analysis, le premier token de réponse d’Opus max arrive au bout de 335.85 secondes, contre 56.51 secondes pour Neon xhigh. La vitesse de sortie ne reflète que le débit une fois la génération commencée.
Q7 : Quelles sont les limites de ces comparaisons ?
Dans la fiche modèle, les résultats des modèles autres que Gemini proviennent par défaut des déclarations de chaque fournisseur. Le Coding Agent Index existe en deux versions, 58.6 et 59, et le MKA en deux versions, 56.5 % et 56 % ; nous les avons conservées telles quelles. Les valeurs de 12.8 % et 39.0 % pour SWE-sweep proviennent de deux harnais de test différents. Les classements et les chiffres de sécurité du blog Google sont des données officielles autodéclarées, et non des résultats retestés par un tiers.
Gemini 4 Neon et Claude Opus 5.5 : à retenir
- Chaque modèle est devant sur certains chiffres : Neon obtient de meilleurs résultats sur la plupart des rubriques de la fiche modèle et sur le score d’intelligence ; Opus l’emporte sur deux scores de codage et sur la vitesse de sortie.
- La fiche modèle est une synthèse officielle : les résultats des modèles hors Gemini sont autodéclarés par chaque fournisseur et ne proviennent pas de retests effectués le même jour.
- Précisez les niveaux comparés : le score d’intelligence compare Neon xhigh à Opus max.
- Le coût par tâche est celui du classement : 6,44 contre 10,04 USD, et non la facture de la plateforme.
- Les modalités d’entrée diffèrent : Neon accepte l’audio et la vidéo en entrée, tandis qu’Opus se limite au texte et aux images.
- Pour commencer : Opus est déjà disponible sur APIYI, Neon ne l’est pas encore ; référez-vous à la liste des modèles de la plateforme.
En résumé
La comparaison entre Gemini 4 Neon et Claude Opus 5.5 doit se lire séparément pour le codage et pour le travail intellectuel :
- Volet codage : Opus est légèrement devant sur Terminal-bench 4.1 et FrontierCode 2.0 ; Neon est meilleur sur CursorBench 4.1 et sur SWE-sweep dans le même harness.
- Volet travail intellectuel : Neon est devant sur la plupart des rubriques de la fiche modèle, avec les écarts les plus marqués sur GraphWalks et AutomationBench.
- Les quatre chiffres d’Artificial Analysis : score d’intelligence 61 contre 59, coût par tâche 6,44 contre 10,04 USD, temps d’exécution 21,5 contre 24,5 minutes, vitesse de sortie 110 contre 118 tokens/seconde ; les niveaux comparés sont Neon xhigh face à Opus max.
Le mieux est de commencer par établir une base de référence avec Opus sur vos propres échantillons de tâches, puis d’attendre que Neon soit disponible pour comparer à niveau équivalent. Vous pouvez consulter sur APIYI (apiyi.com) le prix affiché et les groupes de claude-opus-5-5 et claude-opus-5-5-thinking, puis utiliser la même clé pour les appels et pour basculer ensuite d’un modèle à l’autre.
📚 Références
-
Post de Sundar Pichai : canaux de mise en ligne de Gemini 4 Neon
- Lien :
x.com/sundarpichai/status/2123167780988125621 - Description : périmètre de lancement annoncé officiellement
- Lien :
-
Blog Google « Introducing Gemini 4 Neon » : chiffres officiels de benchmark, de tarification et de sécurité
- Lien :
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - Description : Coding Agent Index 58.6, précisions sur le harness SWE-sweep
- Lien :
-
Fiche modèle DeepMind : tableau comparatif à trois colonnes et notes d’évaluation
- Lien :
deepmind.google/models/model-cards/gemini-4-neon/ - Description : les résultats non-Gemini proviennent par défaut des déclarations de chaque éditeur
- Lien :
-
Guide développeur Google Cloud : ID de modèle, niveaux de réflexion et règles de mise en cache
- Lien :
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - Description : conditions qui déclenchent un HTTP 400
- Lien :
-
Page de tarification Google AI Studio : tarifs payants de Neon
- Lien :
aistudio.google.com/docs/pricing - Description : pas d’offre gratuite, uniquement la mise en cache implicite
- Lien :
-
Article Artificial Analysis : score d’intelligence de Neon et coût par tâche de codage
- Lien :
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - Description : mesure tierce, Coding Agent Index 59
- Lien :
-
Page modèle Artificial Analysis : données par paliers de Neon et d’Opus 5.5
- Lien :
artificialanalysis.ai/models/gemini-4-neon,artificialanalysis.ai/models/claude-opus-5-5 - Description : relevé le 2026-11-19, indice v5.0.1
- Lien :
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter via la page d’accueil du site APIYI ; les modèles et les tarifs sont consultables dans le centre de documentation docs.apiyi.com