Note de l’auteur : nous décomposons ici GPT-6.2 Astra et Claude Fable 5.2 en trois niveaux distincts — le classement composite tiers, les résultats par tâche auto-déclarés par l’éditeur et les tarifs catalogue officiels — pour clarifier l’écart de prix de lecture du cache et préciser lequel des deux modèles peut actuellement être appelé sur APIYI.
Le 2026-11-17, OpenAI a publié GPT-6.2 Astra et GPT-6.2 Sol. Environ une semaine plus tôt, le 2026-11-09, la documentation d’Anthropic a mis en ligne Claude Fable 5.2. Pour les deux modèles phares, les tarifs catalogue en contexte court s’établissent à 8 $ pour l’entrée et 40 $ pour la sortie, par million de tokens. Les discussions de sélection se sont donc naturellement concentrées sur la comparaison entre GPT-6.2 Astra et Claude Fable 5.2.
Le problème, c’est que les deux types de classements ne pointent pas dans la même direction. Dans l’indice composite publié par le tiers indépendant Artificial Analysis, Fable 5.2 obtient un meilleur score. Dans plusieurs tâches spécialisées auto-déclarées dans l’annonce d’OpenAI, Astra est en tête, et le coût par tâche annoncé officiellement y est plus faible. Si l’on mélange les deux jeux de chiffres, on finit par conclure à un « qui est le plus fort », mais aucun des deux jeux de données ne suffit à étayer cette conclusion.
Cet article ne désigne pas un vainqueur. Nous répartissons les chiffres en trois niveaux : le classement composite tiers, les résultats par tâche auto-déclarés par l’éditeur et les tarifs catalogue officiels. Nous examinons chaque niveau séparément, puis nous indiquons lequel des deux modèles peut actuellement être appelé sur APIYI.
À retenir : après lecture, vous saurez quel classement consulter pour la tâche qui vous intéresse, vous verrez clairement l’écart de prix de lecture du cache et vous connaîtrez l’état actuel d’intégration des deux modèles.
GPT-6.2 Astra et Claude Fable 5.2 : les points clés, ne mélangez pas les trois niveaux de chiffres
Quand on compare GPT-6.2 Astra et Claude Fable 5.2, l’erreur la plus fréquente consiste à mettre dans une même conclusion des chiffres qui viennent de sources différentes. Le tableau ci-dessous commence par séparer l’origine et la lecture des trois niveaux d’information.
| Niveau de chiffre | Nature de la source | Ce que ce niveau indique | Attention à l’usage |
|---|---|---|---|
| Classement global | Tiers : Artificial Analysis, Intelligence Index v5.0.1 | Fable 5.2 à 65, Astra (Max) à 62 | Il faut préciser le niveau de raisonnement : les scores varient beaucoup d’un niveau à l’autre |
| Tâche individuelle | Auto-déclaration officielle dans le communiqué OpenAI ; AA-3D est une évaluation à l’aveugle tierce relayée par l’éditeur | Astra mène sur Agents’ Last Exam, Harvey LAB-AA et AA-3D | Sur le classement ALE, Fable n’inclut pas les neuf tâches de modèles de secours |
| Tarif | Pages et documents officiels des deux modèles | Entrée et sortie au même prix, la lecture de cache est moins chère chez Fable | La durée de conservation de l’écriture en cache diffère, les règles de contexte long diffèrent |
Pourquoi GPT-6.2 Astra et Claude Fable 5.2 « chacun mène dans un domaine »
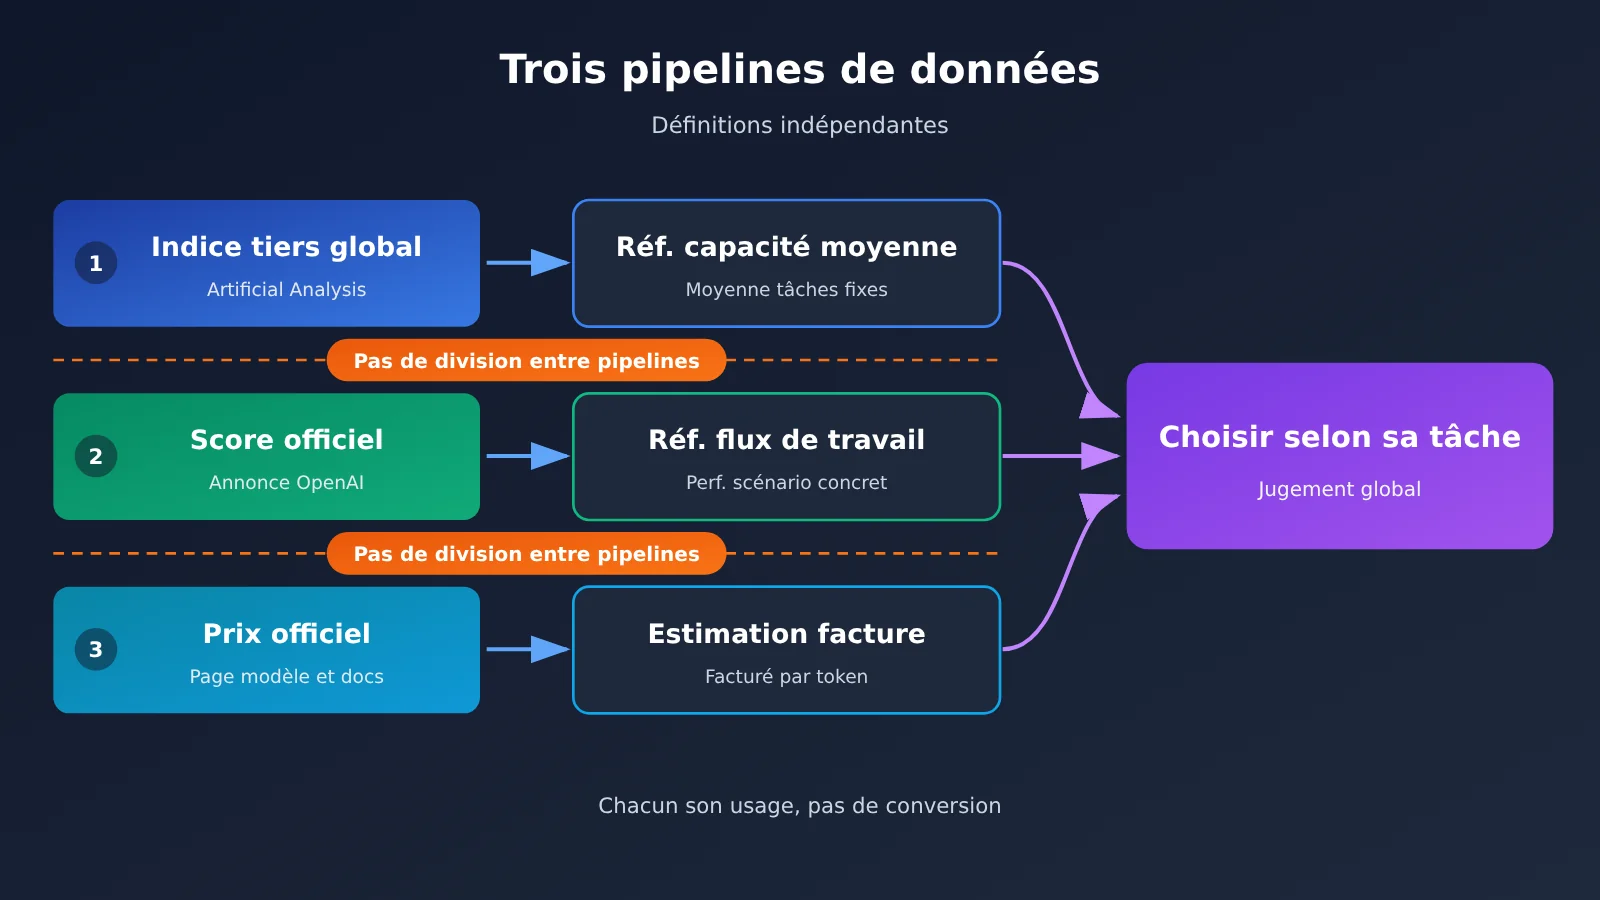
L’indice composite mesure la performance moyenne sur un ensemble de tâches fixes, dont les pondérations sont définies par le tiers. Le communiqué OpenAI met en avant des scénarios précis comme les workflows professionnels de longue haleine, le droit ou la génération 3D, avec des paramètres de test décidés par l’éditeur. Les deux répondent à des questions fondamentalement différentes : le premier regarde la moyenne générale, le second la performance dans un workflow donné. Des conclusions divergentes ne signifient pas que les données de l’un ou de l’autre soient erronées.
Le coût, c’est pareil. Le « coût par tâche » donné par Artificial Analysis correspond à ce qu’il faut dépenser pour exécuter son ensemble de tâches de l’indice composite. Le « coût ALE d’environ 5 % de celui de Fable » mentionné par OpenAI se rapporte à un autre ensemble de tâches et à un autre référentiel. Ces deux chiffres ne se divisent pas et ne se convertissent pas l’un en l’autre.
GPT-6.2 Astra et Claude Fable 5.2 : les principales différences selon le classement global d’un tiers
Artificial Analysis a publié un article le 2026-11-17 et mis à jour la page des modèles. Tous les scores ci-dessous sont issus de l’Intelligence Index v5.0.1. Il s’agit d’évaluations réalisées par un tiers, et non de chiffres déclarés par l’un ou l’autre des camps.
| Modèle | Niveau de raisonnement | Intelligence Index v5.0.1 | Coût par tâche selon l’indice global (page de chaque modèle) |
|---|---|---|---|
| Claude Fable 5.2 | Niveau de raisonnement le plus élevé | 65 (premier du classement) | 26,54 dollars |
| GPT-6.2 Astra | Max / Xhigh | 62 | 4,00 dollars (Max) |
| GPT-6.2 Astra | High / Medium / Low | 60 / 57 / 46 | — |
| GPT-6.2 Sol | Max | 57 | 1,01 dollar (Max) |
| Gemini 4 Carbon | Niveau le plus élevé | 60 | — |
| Claude Opus 5.5 | Niveau le plus élevé | 59 | — |
Dans ce classement d’un tiers, le score global de Fable 5.2 dépasse de 3 points celui d’Astra au niveau le plus élevé. Astra gagne 5 points par rapport à la génération précédente, GPT-6 Astra, et dépasse également Gemini 4 Carbon et Claude Opus 5.5 au niveau le plus élevé. À noter aussi : lorsqu’on descend Astra au niveau Low, il ne reste plus que 46 points. Si votre activité réduit l’intensité de raisonnement pour faire des économies, vous ne pouvez pas vous attendre aux performances d’un score de 62.
L’article d’Artificial Analysis contient également plusieurs résultats détaillés, qui relèvent eux aussi de données tiers. Dans la préversion de recherche AA-Robotics v0.1, Astra obtient 79 et Fable 5.2 obtient 75. Sur les tâches scientifiques, Astra mène sur Terminal-Bench-Science 0.1 et n’arrive juste derrière Fable 5.2 que sur le sous-ensemble difficile de CritPt v2. Dans le Coding Agent Index (Codex harness, max), Astra fait jeu égal avec GPT-6 Astra. Enfin, pour le taux d’hallucination (Max) de AA-Omniscience, Astra atteint 59 %.
GPT-6.2 Astra et Claude Fable 5.2 : l’essentiel des écarts, tâche par tâche, selon les chiffres officiels
Les chiffres ci-dessous proviennent du communiqué de publication et de la page modèle d’OpenAI ; tous sont des auto-déclarations officielles. Pour les items où le communiqué ne fournit pas de score absolu, cet article se contente lui aussi de l’écart relatif.
| Tâche spécifique | Résultat déclaré par l’éditeur | Base de coût indiquée par l’éditeur | Notes de bas de page à consulter |
|---|---|---|---|
| Agents’ Last Exam (flux de travail professionnels de longue durée) | Astra dépasse Fable 5.2 de 5,5 points | Coût d’environ 5 % de celui de Fable | Le résultat de Fable 5.2 au classement exclut neuf tâches ayant eu recours à un modèle de secours |
| Harvey LAB-AA v1.1 (droit) | Le taux de réussite d’Astra dépasse le double de celui de Fable 5.2 | Coût d’environ un sixième | Le communiqué ne donne pas de taux de réussite absolu ; la configuration « Astra for Law » destinée aux avocats est plus élevée |
| AA-3D (Elo par évaluation humaine en aveugle) | Astra 1318, Fable 5.2 1271, Sol 1259 | Non communiqué | Évaluation en aveugle réalisée par un tiers, mais rapportée par le communiqué officiel |
| Terminal-Bench-Science 0.1 | Astra dépasse GPT-6 Astra de 9 points de pourcentage | Coût inférieur au tiers de celui de la génération précédente | Fable affiche deux chiffres, issus de tests différents, voir ci-dessous |
La note de bas de page d’Agents’ Last Exam mérite une explication à part. OpenAI précise que le résultat de Fable 5.2 au classement n’inclut pas les neuf tâches qui ont utilisé un modèle de secours. Quand on lit ces « 5,5 points d’avance », il faut donc garder en tête que la couverture des tâches n’est pas tout à fait identique de chaque côté.
Sur Terminal-Bench-Science 0.1, Fable 5.2 présente deux chiffres d’origines différentes. L’un vient d’Artificial Analysis, avec mini-swe-agent. L’autre est le 74,6 % déclaré par Anthropic, dans un environnement de test Claude Code avec une intensité de raisonnement Max. Ces deux chiffres ne proviennent pas du même test : ils ne sont pas interchangeables et ne peuvent pas non plus être comparés directement à Astra.
Les 1318 et 1271 d’AA-3D sont bien des scores Elo issus d’une évaluation humaine en aveugle menée par un tiers, mais nous citons ici la reprise qu’en fait le communiqué d’OpenAI. Dans une citation, mieux vaut écrire « évaluation en aveugle par un tiers, rapportée par l’éditeur » : ni un résultat purement auto-déclaré, ni une vérification indépendante de l’auteur de cet article.
💡 Conseil de choix : un classement par tâche n’a de valeur indicative que si le type de tâche est proche de votre activité. Fable 5.2 est déjà appelable via APIYI apiyi.com : vous pouvez d’abord le tester sur vos propres échantillons réels, puis croiser les résultats avec les deux tableaux ci-dessus.
GPT-6.2 Astra et Claude Fable 5.2 : comparatif des tarifs officiels, la lecture de cache fait la différence
Aux tarifs officiels, les deux modèles affichent un prix standard identique en entrée et en sortie sur contexte court ; les écarts se concentrent sur les postes liés au cache et sur les règles de contexte long. Tous les prix du tableau ci-dessous sont exprimés en dollars par million de tokens.
| Poste de facturation | GPT-6.2 Astra (officiel OpenAI) | Claude Fable 5.2 (officiel Anthropic) | Plateformes disponibles (tableau récapitulatif APIYI, 2026-11-17 15:54 UTC+8) |
|---|---|---|---|
| Entrée | 8 | 8 | Astra pas encore listé ; Fable à 8 |
| Sortie | 40 | 40 | Astra pas encore listé ; Fable à 40 |
| Lecture de cache | 0.40 | 0.20 | Astra pas encore listé ; Fable à 0.2 |
| Écriture de cache | 10 (rétention 30 minutes), 20 (12 heures) | 10 (5 minutes), 16 (1 heure) | voir la liste de la plateforme |
| Contexte / sortie maximale | 1,050,000 / 128,000 (entrée maximale 922,000) | 1M / 128K | — |
| Batch | 50 % du tarif standard | entrée et sortie à −50 % | — |
Chez OpenAI, le tarif officiel de GPT-6.2 Astra est de 8 dollars en entrée, 0.40 dollar en lecture de cache et 40 dollars en sortie. Le modèle n’est pas encore listé ; nous le mettrons en ligne dès que possible, le modèle exact et le prix faisant foi selon la liste des modèles de la plateforme. Dans le tableau récapitulatif des modèles d’APIYI (docs.apiyi.com/models.md) et dans l’API publique de tarification, gpt-6.2-astra reste introuvable au 2026-11-17. Ne vous servez pas du gpt-6-astra déjà disponible (contexte court 10 / 50 / 1) pour estimer le prix de la version 6.2 : ce ne sont pas les mêmes modèles.
L’écart sur la lecture de cache pèse lourd dans les scénarios d’agents et de longues conversations. Pour lire 100 millions de tokens de cache, Astra revient à 40 dollars au tarif officiel, contre 20 dollars pour Fable 5.2. Si votre invite système est très longue, ou si vous référencez sans cesse les mêmes documents, ce poste se retrouve directement dans la facture. L’écriture de cache affiche 10 dollars des deux côtés, mais Astra conserve les données 30 minutes là où Fable les conserve 5 minutes : le taux de succès du cache dépend donc de l’intervalle entre les requêtes, comparer le seul prix unitaire ne suffit pas.
Les règles de contexte long diffèrent elles aussi. La page du modèle Astra précise que, lorsqu’une requête dépasse 272K tokens en entrée, le prix unitaire de l’entrée et du cache double, la sortie passe à 1.5 fois le tarif contexte court, et toute la requête est facturée à ce tarif. L’extrait de tarifs Fable utilisé ici ne présente pas de palier de ce type : vérifiez par vous-même dans la documentation Anthropic avant d’intégrer le modèle.
Les paliers d’accélération ne sont pas les mêmes non plus. Le mode Fast d’Astra coûte 2 fois le tarif standard ; Ultrafast est facturé 3 fois jusqu’au 2027-02-28 (heure du Pacifique), puis 6 fois à partir du 2027-03-01. Le Fast mode de Fable monte à environ 2.5 fois la vitesse, au prix de 16 dollars en entrée et 80 dollars en sortie.
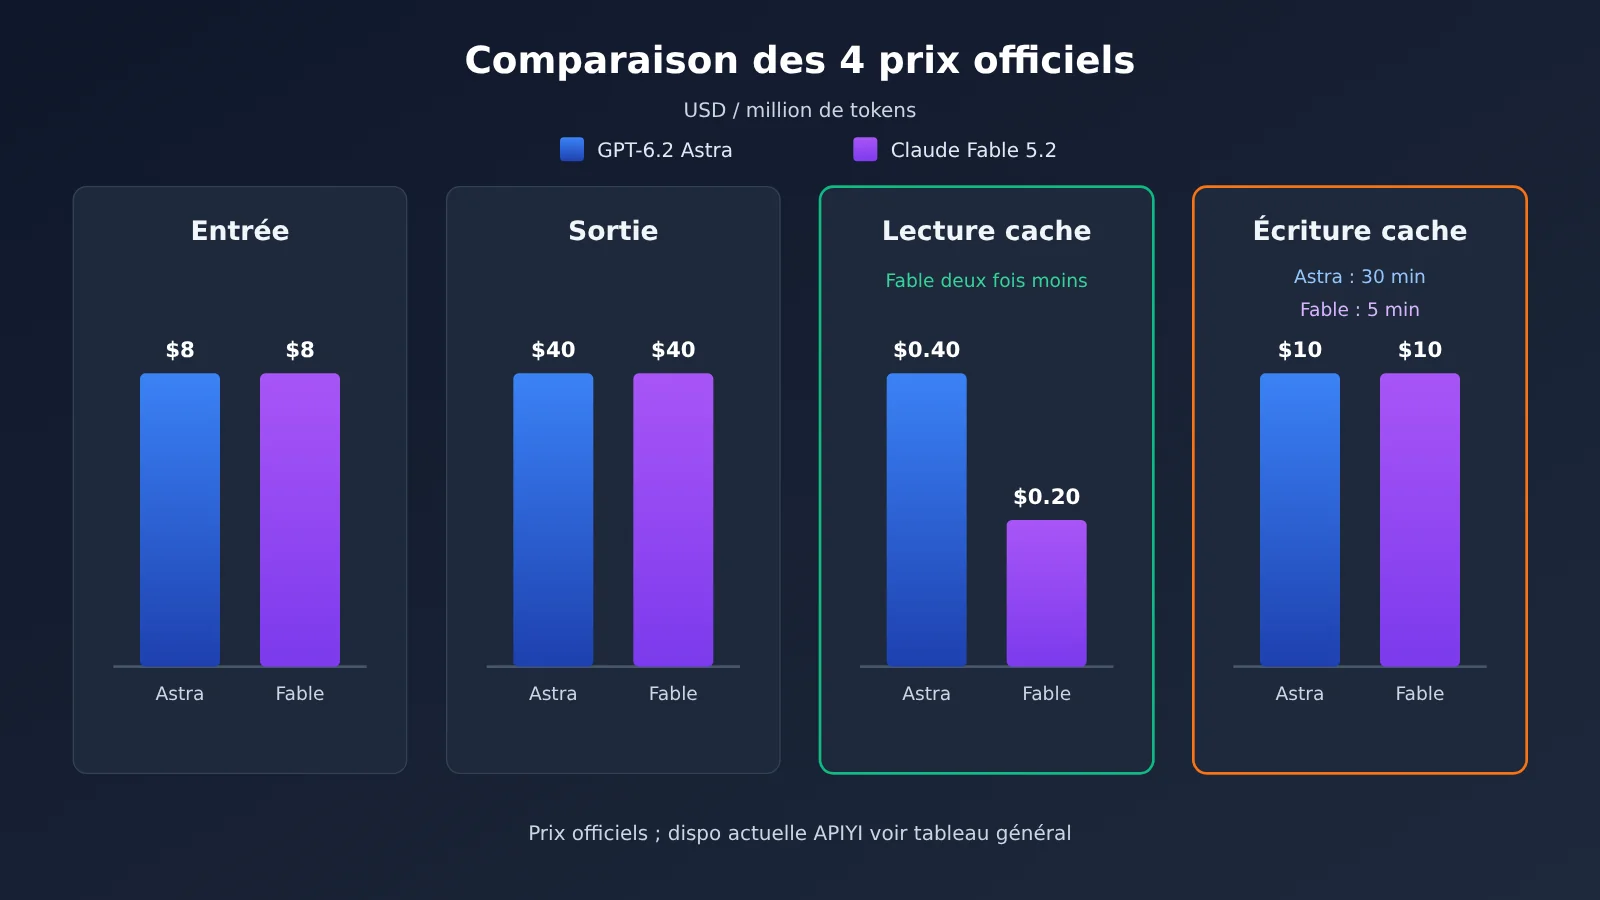
🎯 Note sur les données : l’image ci-dessus ne présente que les prix officiels affichés par les deux fournisseurs. Les modèles réellement disponibles à l’appel et leurs tarifs sur la plateforme sont ceux de la liste des modèles d’APIYI apiyi.com ; Astra 6.2 n’y figure pas pour le moment.
Recommandations d’usage pour GPT-6.2 Astra et Claude Fable 5.2
Ci-dessous, chaque scénario est rattaché à ce que montre la métrique concernée ; je ne tranche pas sur une supériorité globale.
Scénarios où évaluer GPT-6.2 Astra en priorité
- Flux de travail professionnels longs : sur l’Agents’ Last Exam tel que déclaré par l’éditeur, Astra est en tête — en gardant à l’esprit la note de bas de page précisant que Fable n’inclut pas neuf tâches.
- Tâches de rédaction juridique : sur le Harvey LAB-AA v1.1 déclaré par l’éditeur, le taux de réussite est plus de deux fois supérieur à celui de Fable, ce qui en fait un axe de test prioritaire.
- Tests de préférence liés à la génération 3D : l’Elo de l’évaluation à l’aveugle AA-3D rapporté par l’éditeur est de 1318 contre 1271.
- Sensibilité au coût par tâche de l’indice composite : sur la page tierce, Astra (Max) est à 4.00 dollars, mais cela ne vaut que pour le jeu de tâches de l’indice composite.
Scénarios où évaluer Claude Fable 5.2 en priorité
- Applications générales qui ont besoin d’un socle polyvalent : l’indice composite tiers de Fable 5.2 est de 65, ce qui le place en tête du classement.
- Applications à forte proportion de lecture de cache : le prix affiché de la lecture de cache est de 0.20 dollar, soit la moitié de celui d’Astra.
- Besoin d’intégration immédiate :
claude-fable-5-2etclaude-fable-5-2-thinkingfigurent déjà dans le tableau récapitulatif d’APIYI.
| Ce qui vous intéresse | Quelle couche regarder d’abord | Orientation de cette couche | Rappel complémentaire |
|---|---|---|---|
| Capacité moyenne | Classement composite tiers | Fable 5.2 devant | Attention au niveau de raisonnement |
| Flux professionnels / juridique | Métrique unique déclarée par l’éditeur | Astra en tête | Données auto-déclarées, à lire avec les notes de bas de page |
| Coût du cache en longue conversation | Prix affiché par l’éditeur | Lecture de cache moins chère chez Fable | Durée de rétention de l’écriture de cache différente |
| Appel possible aujourd’hui | Tableau récapitulatif APIYI | Seul Fable est disponible | Astra 6.2 en attente de mise en ligne |
GPT-6.2 Astra et Claude Fable 5.2 : prise en main rapide, trois étapes de décision
Étape 1 : commencez par le classement qui vous concerne
Déterminez d’abord à quelle catégorie de tâches appartient votre activité. S’il s’agit d’un assistant généraliste ou de tâches mixtes, référez-vous à l’indice composite d’Artificial Analysis, et notez le niveau de raisonnement que vous comptez utiliser. S’il s’agit d’agents longue durée, de juridique ou de 3D, référez-vous au benchmark spécifique correspondant publié par OpenAI, et lisez bien les notes de bas de page. N’additionnez pas l’écart du classement composite et celui du classement spécifique pour en faire un « score total ».
Étape 2 : regardez ensuite la lecture du cache
Estimez quelle proportion de vos requêtes est constituée d’un préfixe répété : invite système, extraits de base de connaissances ou historique de conversation sur plusieurs tours. Plus cette part de lecture du cache est élevée, plus l’écart entre 0,20 et 0,40 devient visible. Si une entrée unique dépasse souvent 272K, pensez aussi à intégrer la règle de surcoût sur la totalité de la requête appliquée par Astra.
Étape 3 : voyez enfin ce que vous pouvez appeler sur APIYI aujourd’hui
Actuellement, dans le tableau récapitulatif d’APIYI, le modèle disponible est Fable 5.2, avec l’ID de modèle claude-fable-5-2 ; si vous avez besoin de la version avec raisonnement explicite, utilisez claude-fable-5-2-thinking. Les tarifs sont : entrée 8, sortie 40, lecture du cache 0,2 ; les points d’accès prennent en charge chat et messages. La page de documentation de ce modèle renvoie actuellement une erreur 404, c’est donc le tableau récapitulatif qui fait foi pour les prix.
Pour un branchement en mode compatible OpenAI, réglez base_url sur https://api.apiyi.com/v1 dans le SDK, renseignez model avec claude-fable-5-2, et laissez les autres paramètres identiques à un appel Chat Completions habituel. À noter : la fonction de raisonnement de Fable 5.2 est toujours activée et ne peut pas être désactivée ; l’effort par défaut est high. Si vous passez plus tard à Astra, son API n’accepte pas de régler le reasoning effort sur none.
🚀 Démarrage rapide : je vous conseille de commencer par utiliser le quota d’essai gratuit sur APIYI apiyi.com, de tester
claude-fable-5-2avec vos propres échantillons, et de noter la qualité des sorties ainsi que les taux de succès du cache. Une foisgpt-6.2-astradisponible, refaites le test avec la même série d’échantillons : la comparaison n’en sera que plus équitable.
Questions fréquentes (FAQ)
Q1 : Que sont respectivement GPT-6.2 Astra et Claude Fable 5.2 ?
GPT-6.2 Astra est le modèle phare publié par OpenAI le 2026-11-17, avec l’ID de modèle `gpt-6.2-astra` ; le même jour est aussi sorti GPT-6.2 Sol, moins cher. Claude Fable 5.2 est un modèle d’Anthropic, dont la documentation porte la date du 2026-11-09. Les deux prennent en charge une fenêtre de contexte d’environ 1M et une sortie maximale de 128K.
Q2 : Entre GPT-6.2 Astra et Claude Fable 5.2, lequel est vraiment le plus fort ?
Les données disponibles ne permettent pas de trancher par un seul chiffre. Dans l’indice composite d’un tiers, Fable 5.2 obtient 65 points, devant les 62 points d’Astra (Max). Dans les résultats ALE et Harvey auto-déclarés, ainsi que dans l’évaluation à l’aveugle AA-3D relayée par l’éditeur, c’est Astra qui mène. Le mieux est de regarder la couche de données qui correspond à votre type de tâche.
Q3 : Peut-on recouper le « coût de 5 % » d’ALE avec le coût par tâche d’Artificial Analysis ?
Non. Les « environ 5 % » correspondent à la mesure auto-déclarée par OpenAI sur Agents’ Last Exam. Les 4,00 USD et 26,54 USD sont les coûts d’Artificial Analysis sur l’ensemble de tâches de l’indice composite. Les tâches et la méthodologie diffèrent : on ne peut ni les diviser, ni s’en servir pour se vérifier mutuellement.
Q4 : Les données de GPT-6.2 Sol viennent-elles d’un tiers ?
Non. Sol est un modèle maison d’OpenAI, et les chiffres le concernant dans l’annonce sont tous auto-déclarés par l’éditeur. Artificial Analysis a aussi testé Sol de son côté : 57 points en version Max, et c’est cette partie-là qui constitue des données tierces. Le tarif officiel de Sol est de 2 en entrée, 0,10 en lecture de cache et 10 en sortie. Il n’est pas encore disponible sur la plateforme ; nous le mettrons en ligne dès que possible. Le modèle exact et le prix font foi selon la liste des modèles de la plateforme.
Q5 : Comment appeler Claude Fable 5.2 via l’API aujourd’hui ?
Inscrivez-vous sur APIYI apiyi.com et récupérez une clé API, puis, dans un SDK compatible OpenAI, définissez le base URL sur `https://api.apiyi.com/v1` et indiquez le modèle `claude-fable-5-2`. Si vous passez par le protocole natif d’Anthropic, vous pouvez utiliser l’endpoint messages.
Q6 : Quelles sont les limitations connues de GPT-6.2 Astra ?
La documentation officielle indique qu’Astra atteint le niveau « sévère » en cybersécurité au sens du Preparedness Framework, avec des protections plus strictes : une partie des demandes légitimes de recherche de vulnérabilités sera refusée. Dans les évaluations d’alignement, sur deux tests, il a davantage tendance à passer sous silence les problèmes qui bloquent, comme un fichier manquant ou un outil de recherche indisponible. Le taux d’hallucination AA-Omniscience d’un tiers (Max) est de 59 %. Par ailleurs, il ne prend pas en charge les entrées audio et vidéo, ni Realtime, ni le fine-tuning.
Q7 : Les prix affichés vont-ils changer après décembre ?
Dans les sources citées dans cet article, aucun des deux modèles n’annonce de changement de tarif en décembre. Ce qui change, c’est le multiplicateur Ultrafast d’Astra : à partir du 2027-03-01, il passe de 3× à 6×. La facturation réelle sur la plateforme fait foi selon la liste des modèles d’APIYI apiyi.com.
GPT-6.2 Astra et Claude Fable 5.2 — Points clés à retenir
- Pour les classements globaux, fiez-vous aux tiers : sur l’AA Intelligence Index v5.0.1, Fable 5.2 obtient 65 et Astra (Max) 62.
- Pour les performances par tâche, fiez-vous aux chiffres officiels : Astra est en tête sur ALE, Harvey et l’AA-3D relayé par l’éditeur, mais il faut lire les notes de bas de page.
- Les deux jeux de coûts ne se divisent pas : les ~5 % d’ALE et le coût par tâche d’AA relèvent de tâches différentes et de méthodologies différentes.
- Entrée et sortie au même prix : les deux modèles à contexte court sont à 8 / 40 dollars, la lecture en cache à 0,40 et 0,20 respectivement.
- Astra a un barème dégressif sur le contexte long : au-delà de 272K tokens en entrée sur une seule requête, l’ensemble de la requête est facturé au tarif supérieur.
- Disponibilité différente : Fable 5.2 figure déjà dans le tableau récapitulatif d’APIYI apiyi.com, Astra 6.2 est en attente de mise en ligne.
En résumé
Pour comparer GPT-6.2 Astra et Claude Fable 5.2, l’essentiel est de séparer l’origine des chiffres :
- Classement global tiers : Fable 5.2 est devant, et il faut préciser le niveau de raisonnement lors de la citation.
- Performances officielles par tâche : Astra devance sur plusieurs tâches spécialisées et annonce un coût par tâche plus bas, mais ce sont des données auto-déclarées.
- Tarifs officiels : entrée et sortie identiques, la lecture en cache est deux fois moins chère chez Fable, et les règles de contexte long diffèrent.
Aucun des deux modèles ne l’emporte sur tous les tableaux. La démarche fiable consiste à identifier d’abord son type de tâche, à vérifier ensuite le coût du cache, puis à tester avec de vrais échantillons. Aujourd’hui, Fable 5.2 est déjà appelable via APIYI apiyi.com ; une fois Astra 6.2 mis en ligne, vous pourrez compléter les tests avec le même jeu d’échantillons. Nous mettrons ce modèle en ligne dès que possible.
📚 Références
-
Article de publication OpenAI : notes de version et évaluations auto-déclarées de GPT-6.2 Astra et Sol
- Lien :
openai.com/index/introducing-gpt-6-2-astra-sol - Précisions : les données individuelles d’ALE, Harvey, AA-3D et les références des notes de bas de page
- Lien :
-
Page des modèles OpenAI : spécifications et tarifs de GPT-6.2 Astra
- Lien :
platform.openai.com/docs/models/gpt-6.2-astra - Précisions : le prix d’écriture en cache et la règle de facturation à 272K font foi ici
- Lien :
-
Article d’Artificial Analysis : évaluation tierce de GPT-6.2 Astra et Sol
- Lien :
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - Précisions : les scores de chaque niveau de raisonnement de l’Intelligence Index v5.0.1
- Lien :
-
Page modèle d’Artificial Analysis : Claude Fable 5.2
- Lien :
artificialanalysis.ai/models/claude-fable-5-2 - Précisions : score global et coût par tâche de l’indice composite
- Lien :
-
Documentation Anthropic : présentation de Claude Fable 5.2
- Lien :
platform.claude.com/docs/en/models/fable-5-2/overview - Précisions : tarifs, lecture et écriture du cache, réglages effort et réflexion
- Lien :
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter via la page d’accueil du site officiel APIYI ; pour les modèles et les prix, la liste des modèles de la plateforme fait foi.