Note de l’auteur : cet article explique comment construire son propre agent IA personnel à partir d’une interface de modèle, d’outils, de mémoire, d’un ordonnanceur et d’un environnement d’exécution, en prenant pour exemple un workflow de veille sur l’actualité IA afin d’illustrer le rôle et le coût de chaque composant d’un système maison.
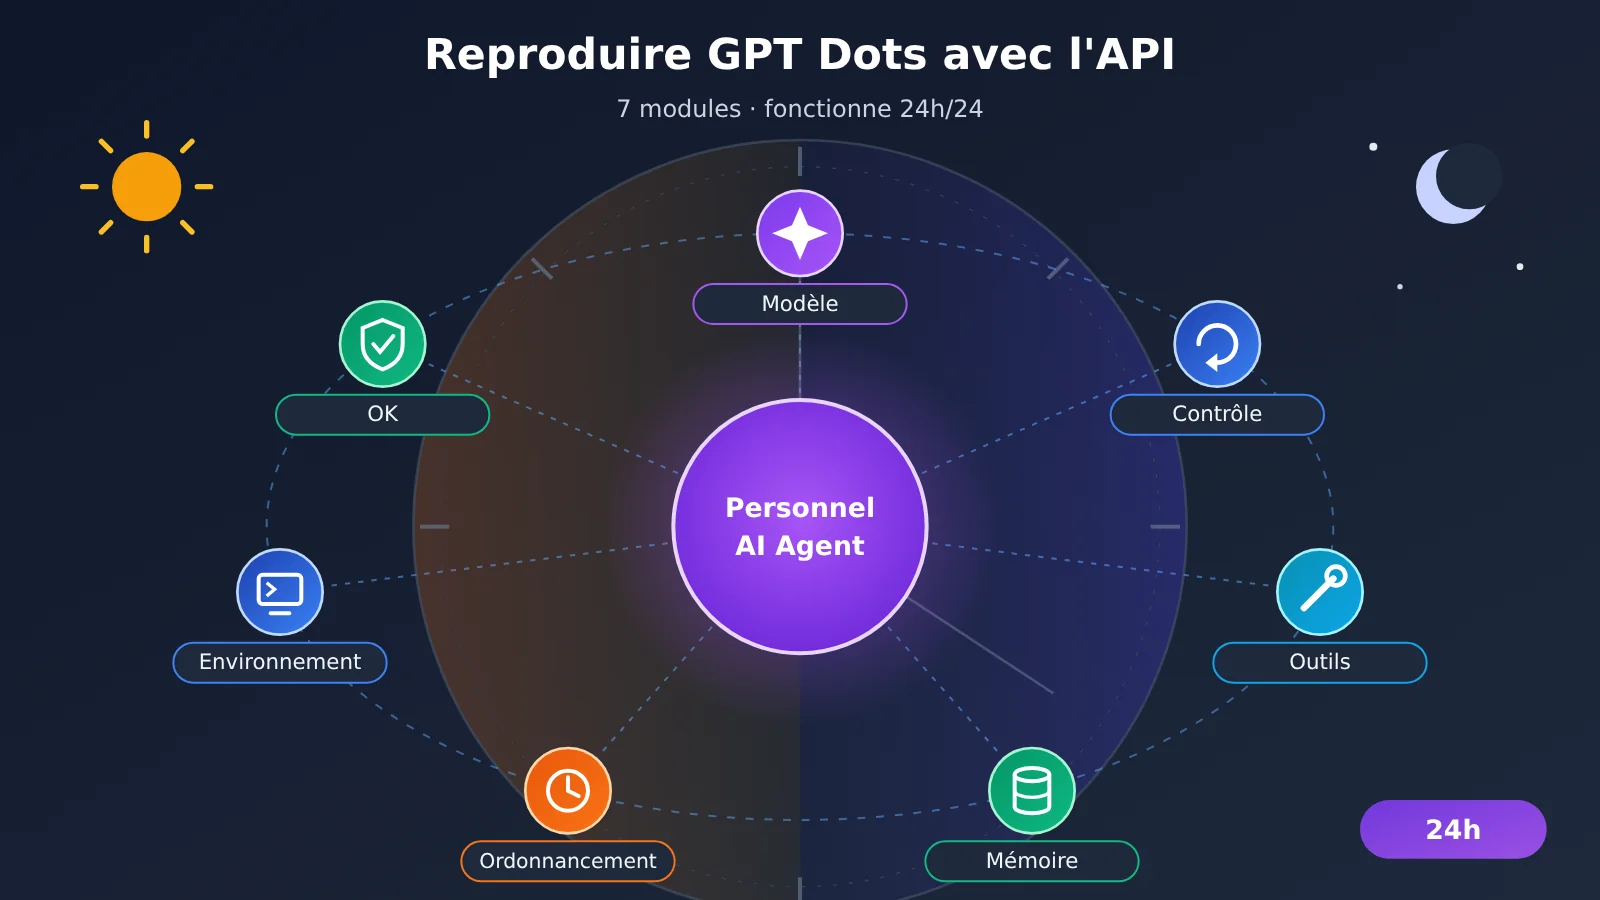
Reproduire GPT Dots avec une API, c’est d’abord reproduire son mode de fonctionnement : le modèle se charge de juger, le programme se charge d’exécuter, la base de données se charge de mémoriser, l’ordonnanceur permet aux tâches de continuer à avancer même quand vous n’êtes plus là. L’interface de modèle n’est qu’une couche parmi d’autres. Le système d’outils, la mémoire à long terme, la file de tâches, l’environnement d’exécution et le mécanisme d’approbation, tout cela doit être mis en place par le développeur. La configuration des modèles propriétaires d’OpenAI, l’ordinateur cloud et l’écosystème de plus de 4 000 applications font partie du produit Dots lui-même : ces briques ne s’obtiennent pas directement via l’API. Les « 24 heures » du titre désignent la façon dont l’agent fait progresser les tâches en arrière-plan selon un planning ; le temps de disponibilité réel du système dépend du serveur, de la file d’attente et des mécanismes de nouvelle tentative.
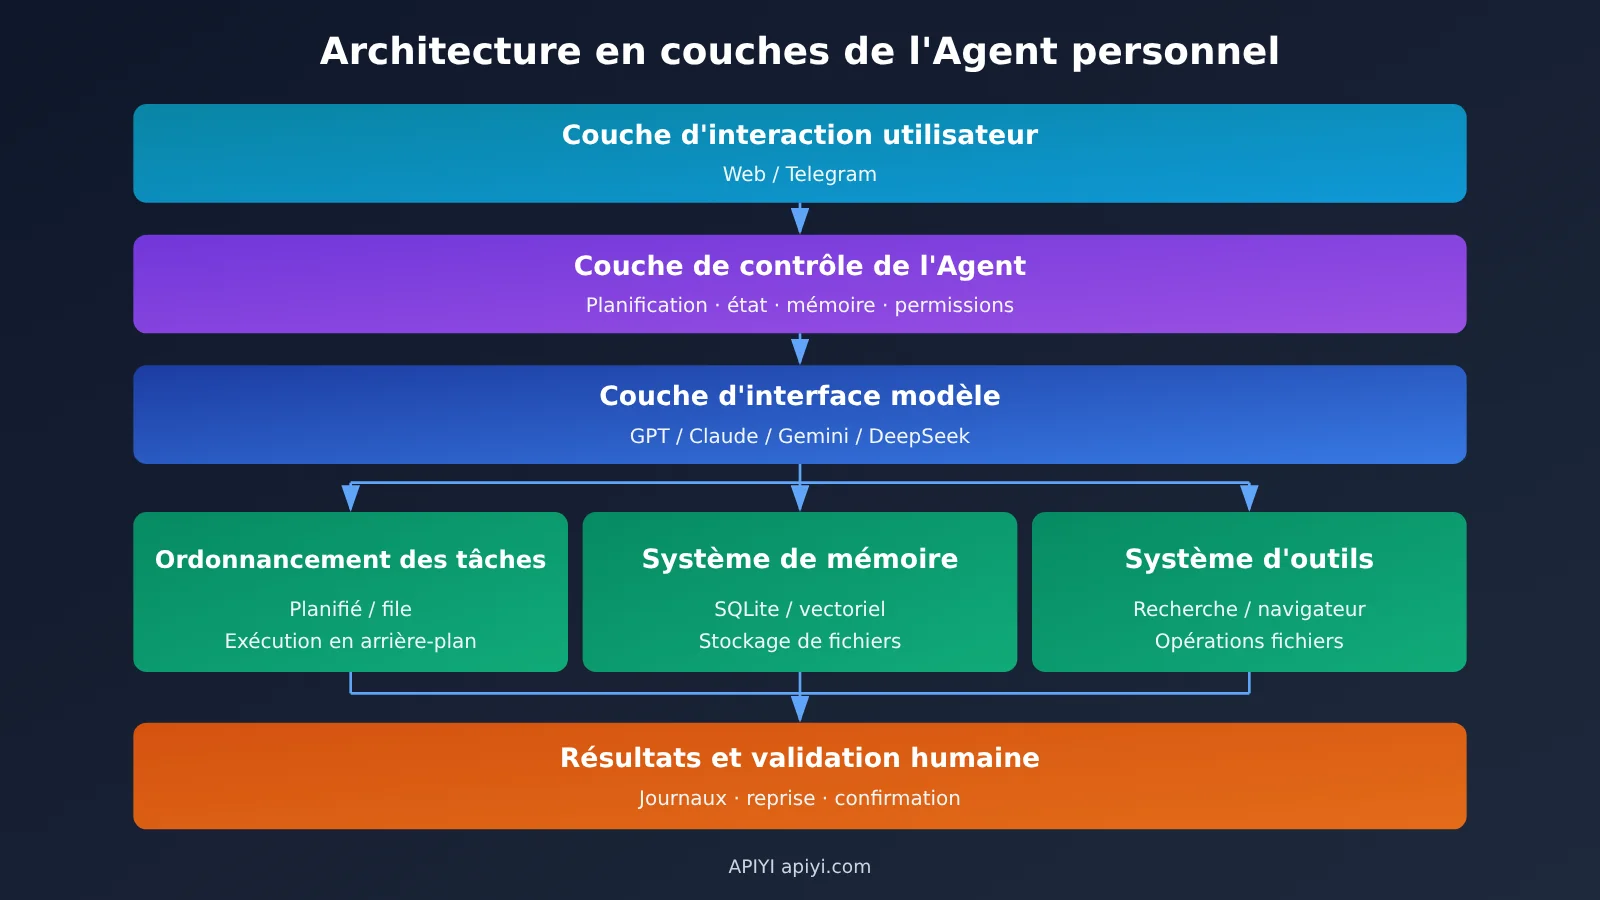
L’article suit l’ordre de construction. La partie 1 découpe Dots en 7 modules et indique lesquels sont fournis par le modèle, lesquels doivent être construits maison. Les parties 2 à 6 implémentent successivement la connexion au modèle, l’appel d’outils, la mémoire à long terme, l’ordonnancement en arrière-plan et l’environnement d’exécution. La partie 7 assemble ces composants en une conception complète de Personal AI Radar. La partie 8 calcule le coût total, y compris les dépenses hors modèle, et précise les limites de capacité d’une solution maison.
À savoir : les termes à comprendre avant de reproduire GPT Dots
| Terme | Explication |
|---|---|
| API | Interface permettant à une application d’appeler un modèle ou un service externe ; dans cet article, il s’agit principalement de l’interface d’invocation des grands modèles de langage |
| Agent | Système applicatif qui s’appuie sur un modèle pour prendre des décisions et appeler des outils afin de faire avancer une tâche |
| Function Calling | Le modèle produit une demande structurée d’appel d’outil, que votre programme exécute avant de renvoyer le résultat au modèle |
| tool_use / tool_result | Types de messages de l’interface Claude Messages correspondant à la demande d’appel d’outil et au résultat de son exécution |
| SQLite | Base de données embarquée dans un seul fichier, adaptée au stockage de données légères comme les préférences, l’état des tâches ou les journaux |
| Recherche vectorielle | Convertir un texte en vecteur, puis retrouver les informations pertinentes par similarité sémantique |
| File de tâches | Conserver les tâches à exécuter et les distribuer, par ordre ou par priorité, à des Workers en arrière-plan |
| Checkpoint | Instantané de progression enregistré à une étape donnée de l’exécution d’une tâche, à partir duquel on reprend après une interruption |
| Environnement d’exécution | Ordinateur ou conteneur qui fait réellement tourner le navigateur, le code et les opérations sur les fichiers |
| Playwright | Bibliothèque d’automatisation qui pilote un navigateur par code, pour ouvrir des pages web, cliquer et extraire du contenu |
| Prompt Injection | Attaque dans laquelle une page web ou un document cache des instructions malveillantes pour tenter de détourner le comportement de l’Agent |
| MCP | Protocole ouvert qui relie les applications de modèles aux outils externes et aux sources de données |
1 De quels modules GPT Dots est-il composé
1.1 Les capacités officielles de GPT Dots
Dots est un agent IA personnel permanent publié par OpenAI le 29 septembre 2026. Selon la documentation officielle, il dispose de son propre ordinateur cloud et d’un navigateur : même une fois votre ordinateur éteint, les tâches cloud déjà déléguées continuent de s’exécuter. Il peut croiser la mémoire de ChatGPT, ses propres notes et les données des applications connectées, faire avancer plusieurs projets en parallèle et communiquer avec vous via ChatGPT, Slack, Microsoft Teams ou d’autres canaux.
Le fonctionnement de Dots repose aussi sur trois mécanismes clés. La recherche proactive (Proactive Research) lit en arrière-plan les sources d’information autorisées et produit des notes de recherche ; ce processus est en lecture seule, et toute action ultérieure doit passer par la procédure d’approbation normale. Les tâches planifiées et la surveillance d’événements permettent à Dot de travailler en continu, selon un planning ou à la suite d’un événement. Enfin, Custom Rules et Auto-review vérifient les permissions et l’intention de l’utilisateur avant des opérations comme l’envoi d’e-mails ou les achats ; les opérations à risque élevé, telles que les virements ou la modification de mots de passe, doivent être reprises en main par l’utilisateur.
1.2 Les sept modules de GPT Dots et leur équivalent dans une solution maison
En décomposant les capacités de Dots, on obtient 7 modules. Le tableau ci-dessous indique, pour chacun, l’implémentation correspondante dans une solution que vous construisez vous-même :
| Module | Ce que fait Dots | Implémentation correspondante dans une solution maison | Fourni par |
|---|---|---|---|
| Modèle | Raisonnement, planification, choix des outils | API de modèles GPT, Claude, Gemini, DeepSeek, etc. | Service de modèles |
| Contrôleur d’agent | Décomposition des tâches, coordination de plusieurs projets | Boucle écrite maison, ou LangGraph, OpenAI Agents SDK | Développeur |
| Outils | Navigateur, plugins d’applications, Codex | Function Calling + fonctions d’outils implémentées par vos soins, services MCP | Développeur |
| Mémoire | ChatGPT Memory, notes de Dot, contexte de projet | SQLite + recherche vectorielle + système de fichiers | Développeur |
| Ordonnancement des tâches | Tâches planifiées, surveillance d’événements, agent en arrière-plan | APScheduler, Celery, file d’attente Redis | Développeur |
| Environnement d’exécution | Ordinateur cloud indépendant | Serveur cloud, Docker, Playwright | Développeur |
| Approbation de sécurité | Custom Rules, Auto-review, prise en main par l’utilisateur | Liste blanche d’outils, file d’approbation, journal des opérations | Développeur |
Dans ce tableau, seule la première ligne est directement fournie par l’API du modèle ; les six autres demandent un véritable travail d’ingénierie. C’est précisément pour cela qu’« une clé API ne suffit pas à obtenir toutes les capacités de Dots » : la clé API ouvre l’accès à l’invocation du modèle, mais les bras et les jambes de l’agent, sa mémoire et son emploi du temps, c’est à vous de les construire.
2 Préparer les interfaces de modèle nécessaires à la reproduction de GPT Dots
2.1 Accéder à plusieurs modèles via APIYI
APIYI apiyi.com propose une interface compatible OpenAI ainsi que l’interface native Claude Messages : une seule clé API permet d’appeler les modèles de plusieurs fournisseurs. Les différents modèles utilisent des protocoles différents, il faut donc les distinguer au moment de la configuration :
| Type de modèle | Protocole | Base URL | Champs d’appel d’outils |
|---|---|---|---|
| GPT, DeepSeek, Qwen et autres modèles compatibles OpenAI | OpenAI Chat Completions | https://api.apiyi.com/v1 |
tools / tool_calls |
| Claude | Anthropic Messages (/v1/messages) |
https://api.apiyi.com |
tool_use / tool_result |
| Gemini | Protocole compatible Gemini | À configurer selon l’interface correspondante dans la documentation officielle | Selon le protocole correspondant |
Les ID de modèle et les prix en temps réel sont à consulter dans la liste des modèles de la plateforme. Le code ci-dessous lit systématiquement les ID de modèle depuis les variables d’environnement : pour changer de modèle, il suffit de modifier la configuration, le code de l’Agent reste inchangé.
2.2 Invocation minimale du modèle pour reproduire GPT Dots
Commencez par vérifier que l’interface répond. Enregistrez le code suivant sous llm.py ; les chapitres suivants importeront client depuis ce fichier :
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",  # Interface compatible OpenAI d'APIYI
)
MODEL = os.environ["RADAR_MODEL"]  # Renseignez l'ID du modèle réellement disponible dans la liste des modèles

if __name__ == "__main__":
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[{"role": "user", "content": "用三句话说明什么是个人 AI Agent"}],
    )
    print(resp.choices[0].message.content)
Quand vous passez par l’interface Messages native de Claude, utilisez le SDK Anthropic, avec une Base URL sans /v1 :
import os
import anthropic

claude = anthropic.Anthropic(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com",  # Le SDK ajoute automatiquement /v1/messages
)

resp = claude.messages.create(
    model=os.environ["CLAUDE_MODEL"],
    max_tokens=1024,
    tools=[{
        "name": "search_news",
        "description": "检索近期 AI 新闻",
        "input_schema": {
            "type": "object",
            "properties": {"query": {"type": "string"}},
            "required": ["query"],
        },
    }],
    messages=[{"role": "user", "content": "查一下今天的模型发布新闻"}],
)
for block in resp.content:
    if block.type == "tool_use":
        print(block.id, block.name, block.input)
Une fois que Claude renvoie un tool_use, votre programme exécute l’outil, puis envoie un bloc tool_result avec role: user, en associant la requête via tool_use_id ; si l’outil échoue, mettez is_error: true et le modèle ajustera son étape suivante en conséquence.
🚀 Démarrage rapide : exécutez d’abord les deux extraits de code ci-dessus avec le quota de test gratuit d’APIYI, vérifiez que les deux chaînes — compatibilité OpenAI et natif Claude — renvoient bien des appels d’outils, puis lancez-vous dans le développement de l’Agent.
2.3 Différences de compatibilité des interfaces et de capacités d’appel d’outils
La compatibilité de protocole résout la question « la requête peut-elle être envoyée », mais les performances des différents modèles en matière d’appel d’outils restent variables. La méthodologie de test d’appel d’outils multi-modèles publiée par APIYI en novembre 2026 met en avant plusieurs points d’observation : la série Gemini s’intéresse aux appels parallèles et à la question de savoir si le JSON final contient du texte supplémentaire, la série Qwen à la sélection face à des outils distracteurs et au mappage des ID sur plusieurs tours, la série Claude à la gestion de is_error et au nombre de tours d’appel, et la série GPT au degré de respect strict du schéma ainsi qu’à la consommation de tokens.
Ce sont des points d’attention pour les tests, sans présupposer quel modèle est meilleur. Je vous conseille de fournir aux modèles candidats les mêmes définitions d’outils et les mêmes tâches, d’enregistrer le nombre d’appels, le nombre d’erreurs de paramètres, le total de tokens et le taux de réussite final, puis de choisir le modèle principal de l’Agent sur la base des données.
L’API Responses doit également être validée séparément. L’interface /v1/responses documentée par APIYI liste principalement des modèles comme GPT-4.1 ou o3, tandis que la documentation actuelle d’OpenAI sur l’appel d’outils indique que GPT-6 Astra et GPT-6.1 Sol utilisent l’API Responses. Si vous prévoyez d’exploiter les capacités Responses API des nouveaux modèles, il faudrait inscrire l’appel d’outils, les outils intégrés et la gestion d’état parmi les éléments de test de compatibilité, et les valider un par un avant la mise en production.
3 Faire exécuter des tâches à un agent de type GPT Dots grâce à Function Calling
3.1 La boucle de fonctionnement de Function Calling
La boucle de Function Calling ne comporte que quatre étapes : le programme envoie la tâche et la définition des outils au modèle ; le modèle renvoie le nom de l’outil qu’il souhaite appeler ainsi que les paramètres ; le programme exécute réellement cet outil ; le programme ajoute le résultat d’exécution au message et le renvoie au modèle, qui décide alors de poursuivre les appels ou de fournir la réponse.
L’essentiel se joue à la troisième étape. Le modèle se contente de générer la demande d’appel ; c’est votre code qui accède au moteur de recherche, lit et écrit les fichiers, envoie les messages. Par conséquent, l’étendue des permissions des outils, la validation des entrées et la gestion des échecs incombent entièrement au développeur.
3.2 Le système d’outils minimal composé de trois outils
Personal AI Radar a besoin de trois outils de base : search_news pour chercher des actualités, read_file pour lire les documents présents dans le répertoire de travail, et save_note pour écrire les résultats mis en forme dans la base de connaissances. Voici la boucle Agent complète :
Voir le code complet de la boucle d’appel d’outils reproduite avec GPT Dots
import json
import pathlib
import sqlite3
from llm import client, MODEL

WORKDIR = pathlib.Path("./workspace").resolve()
DB_PATH = "radar.db"

TOOLS = [
    {"type": "function", "function": {
        "name": "search_news",
        "description": "检索近期 AI 新闻,返回标题、链接、发布时间和摘要列表",
        "parameters": {
            "type": "object",
            "properties": {
                "query": {"type": "string"},
                "days": {"type": "integer", "minimum": 1, "maximum": 7},
            },
            "required": ["query"],
        },
    }},
    {"type": "function", "function": {
        "name": "read_file",
        "description": "读取工作目录中的文本文件",
        "parameters": {
            "type": "object",
            "properties": {"path": {"type": "string"}},
            "required": ["path"],
        },
    }},
    {"type": "function", "function": {
        "name": "save_note",
        "description": "把一条整理好的新闻资料保存到资料库",
        "parameters": {
            "type": "object",
            "properties": {
                "title": {"type": "string"},
                "url": {"type": "string"},
                "summary": {"type": "string"},
                "project": {"type": "string"},
            },
            "required": ["title", "url", "summary", "project"],
        },
    }},
]

def search_news(query: str, days: int = 1):
    # Branchez le service de recherche de votre choix : API de recherche, agrégation RSS ou scraping maison
    raise NotImplementedError("请接入实际的搜索服务")

def read_file(path: str):
    p = (WORKDIR / path).resolve()
    if not p.is_relative_to(WORKDIR):          # Lecture autorisée uniquement dans le répertoire de travail
        return {"error": "path outside workspace"}
    return {"content": p.read_text(encoding="utf-8")[:20000]}

def save_note(title: str, url: str, summary: str, project: str):
    with sqlite3.connect(DB_PATH) as db:
        db.execute(
            "INSERT OR IGNORE INTO notes(url, title, summary, project) VALUES (?, ?, ?, ?)",
            (url, title, summary, project),
        )
    return {"saved": True}

REGISTRY = {"search_news": search_news, "read_file": read_file, "save_note": save_note}

def run_agent(task: str, system: str, max_rounds: int = 8) -> str:
    messages = [
        {"role": "system", "content": system},
        {"role": "user", "content": task},
    ]
    for _ in range(max_rounds):
        msg = client.chat.completions.create(
            model=MODEL, messages=messages, tools=TOOLS,
        ).choices[0].message
        messages.append(msg.model_dump(exclude_none=True))

        if not msg.tool_calls:
            return msg.content

        for call in msg.tool_calls:
            fn = REGISTRY.get(call.function.name)
            try:
                args = json.loads(call.function.arguments or "{}")
                result = fn(**args) if fn else {"error": "unknown tool"}
            except Exception as e:
                result = {"error": f"{type(e).__name__}: {e}"}
            messages.append({
                "role": "tool",
                "tool_call_id": call.id,
                "content": json.dumps(result, ensure_ascii=False),
            })
    raise RuntimeError("超过最大工具调用轮次")
Trois choix de conception méritent d’être conservés dans ce code. max_rounds borne le nombre d’itérations de la boucle, pour éviter que le modèle appelle sans fin le même outil et consomme des tokens. Les exceptions levées par les outils sont encapsulées puis renvoyées au modèle sous la forme {"error": ...}, ce qui lui laisse la possibilité de modifier ses paramètres ou de changer d’approche. Enfin, read_file verrouille la portée de lecture au répertoire de travail grâce à une validation du chemin : c’est la frontière de permissions la plus élémentaire.
3.3 Passer d’une boucle écrite maison à un framework Agent
Une boucle écrite maison convient aux scénarios à tâche unique et à faible nombre d’outils. Lorsqu’une tâche nécessite une reprise après interruption, une validation humaine ou des branchements complexes, on peut migrer vers LangGraph : il fournit un State pour sauvegarder l’état de la tâche, un Checkpointer pour persister la progression, et le Human-in-the-loop pour suspendre l’exécution en attente de validation. L’OpenAI Agents SDK propose lui aussi l’orchestration de workflows et des Guardrails. Quand le nombre d’outils augmente, on utilise MCP pour encapsuler les capacités de recherche, de gestion de fichiers, d’e-mail, etc. sous forme de services indépendants, que plusieurs Agents peuvent réutiliser.
4 Donner une mémoire à long terme à un Agent façon GPT Dots
4.1 La répartition en quatre couches de mémoire
Le contexte de Dots provient de ChatGPT Memory, des notes propres à Dot, du contexte de la tâche en cours et des données des applications connectées ; et pour une nouvelle tâche, l’historique n’est récupéré qu’à la demande, sans charger l’intégralité de l’historique de conversation. Un Agent auto-hébergé peut adopter la même approche et gérer sa mémoire par couches :
| Couche de mémoire | Contenu stocké | Cycle de vie | Moment d’écriture |
|---|---|---|---|
| Contexte courant | Instructions de la tâche en cours, derniers résultats d’outils | Tâche en cours | À chaque tour de conversation |
| Mémoire de projet | Objectifs du projet, décisions clés, avancement | Pendant toute la durée du projet | À la fin d’une tâche ou lors d’un changement de décision |
| Mémoire utilisateur | Préférences, domaines d’intérêt, format de compte rendu | Long terme | Quand l’utilisateur exprime explicitement une préférence |
| Mémoire d’expérience | Causes d’échec, méthodes de correction | Long terme, mise à jour selon des règles | Après un échec de tâche ou une modification par l’utilisateur |
À chaque invocation du modèle, on ne place dans le prompt que le contexte courant, auquel on ajoute les mémoires pertinentes récupérées. Fourrer tous les messages de l’historique dans la requête fait à la fois grimper le coût en Tokens et baisser la qualité de la récupération.
4.2 Conception du schéma de tables SQLite
Le schéma de tables ci-dessous couvre les quatre couches de mémoire et l’état des tâches ; la table runs assure en même temps la reprise après interruption de la partie 5 :
CREATE TABLE IF NOT EXISTS user_memory (
    key TEXT PRIMARY KEY, value TEXT, updated_at TEXT
);
CREATE TABLE IF NOT EXISTS projects (
    id TEXT PRIMARY KEY, goal TEXT, decisions TEXT, status TEXT, updated_at TEXT
);
CREATE TABLE IF NOT EXISTS runs (
    id INTEGER PRIMARY KEY AUTOINCREMENT,
    project_id TEXT, run_date TEXT,
    next_stage TEXT, state_json TEXT,
    status TEXT, error TEXT, updated_at TEXT,
    UNIQUE (project_id, run_date)
);
CREATE TABLE IF NOT EXISTS notes (
    url TEXT PRIMARY KEY, title TEXT, summary TEXT, project TEXT,
    created_at TEXT DEFAULT CURRENT_TIMESTAMP
);
CREATE TABLE IF NOT EXISTS lessons (
    id INTEGER PRIMARY KEY AUTOINCREMENT,
    project_id TEXT, lesson TEXT, created_at TEXT
);
notes utilise l’URL comme clé primaire : lorsqu’une même actualité est aspirée plusieurs fois, la déduplication se fait automatiquement. La contrainte d’unicité (project_id, run_date) sur runs garantit qu’un projet n’a qu’un seul enregistrement d’exécution par jour, ce qui permet de retrouver la progression du jour après un redémarrage.
4.3 Récupérer des documents historiques par recherche vectorielle
Les données structurées se requêtent en SQL, les documents sémantiquement liés se récupèrent par recherche vectorielle. La méthode consiste à générer des vecteurs d’embedding à partir de notes.summary et lessons.lesson, à les stocker dans une base vectorielle comme sqlite-vec ou Chroma, et à consigner le projet, la date et la source dans les métadonnées. Au moment de générer un sujet, on commence par rechercher dans les 30 derniers jours les documents similaires à partir des actualités du jour, puis on joint au prompt les quelques résumés correspondants ; le modèle peut alors déterminer si « cette actualité est une avancée sur un sujet existant ou un événement totalement nouveau », et l’utilisateur n’a pas besoin de réexpliquer le contexte à chaque fois.
5 Faire tourner un agent de type GPT Dots en arrière-plan en continu
5.1 Les différences entre les trois mécanismes d’arrière-plan
Le fonctionnement en arrière-plan repose sur trois mécanismes dont les rôles sont bien distincts. Les tâches planifiées sont déclenchées par un ordonnanceur système (APScheduler, cron) selon un calendrier : elles répondent à la question « quand est-ce que ça démarre ». Les requêtes de modèle en arrière-plan désignent les réponses asynchrones du type OpenAI Background Mode : on soumet la requête, on récupère un response ID, puis on interroge l’état pour récupérer le résultat. Elles ont leur propre cycle de vie et leurs propres conditions de conservation des données, et conviennent bien aux raisonnements longs et ponctuels. La planification d’agent sur le long terme s’appuie sur une file de tâches, un état persisté et des workers : elle gère l’avancement, les nouvelles tentatives et la reprise de tâches qui s’étalent sur plusieurs jours et en plusieurs phases.
Le flux de données recommandé est le suivant : ordonnanceur → file de tâches → worker d’agent → API du modèle → exécution des outils → base de résultats → notification. On gère séparément les tâches périodiques et les tâches longues : les tâches périodiques se contentent de déposer du travail dans la file, tandis que les tâches longues sont avancées par les workers en fonction de leur état.
5.2 Points de contrôle par phase et nouvelles tentatives en cas d’échec
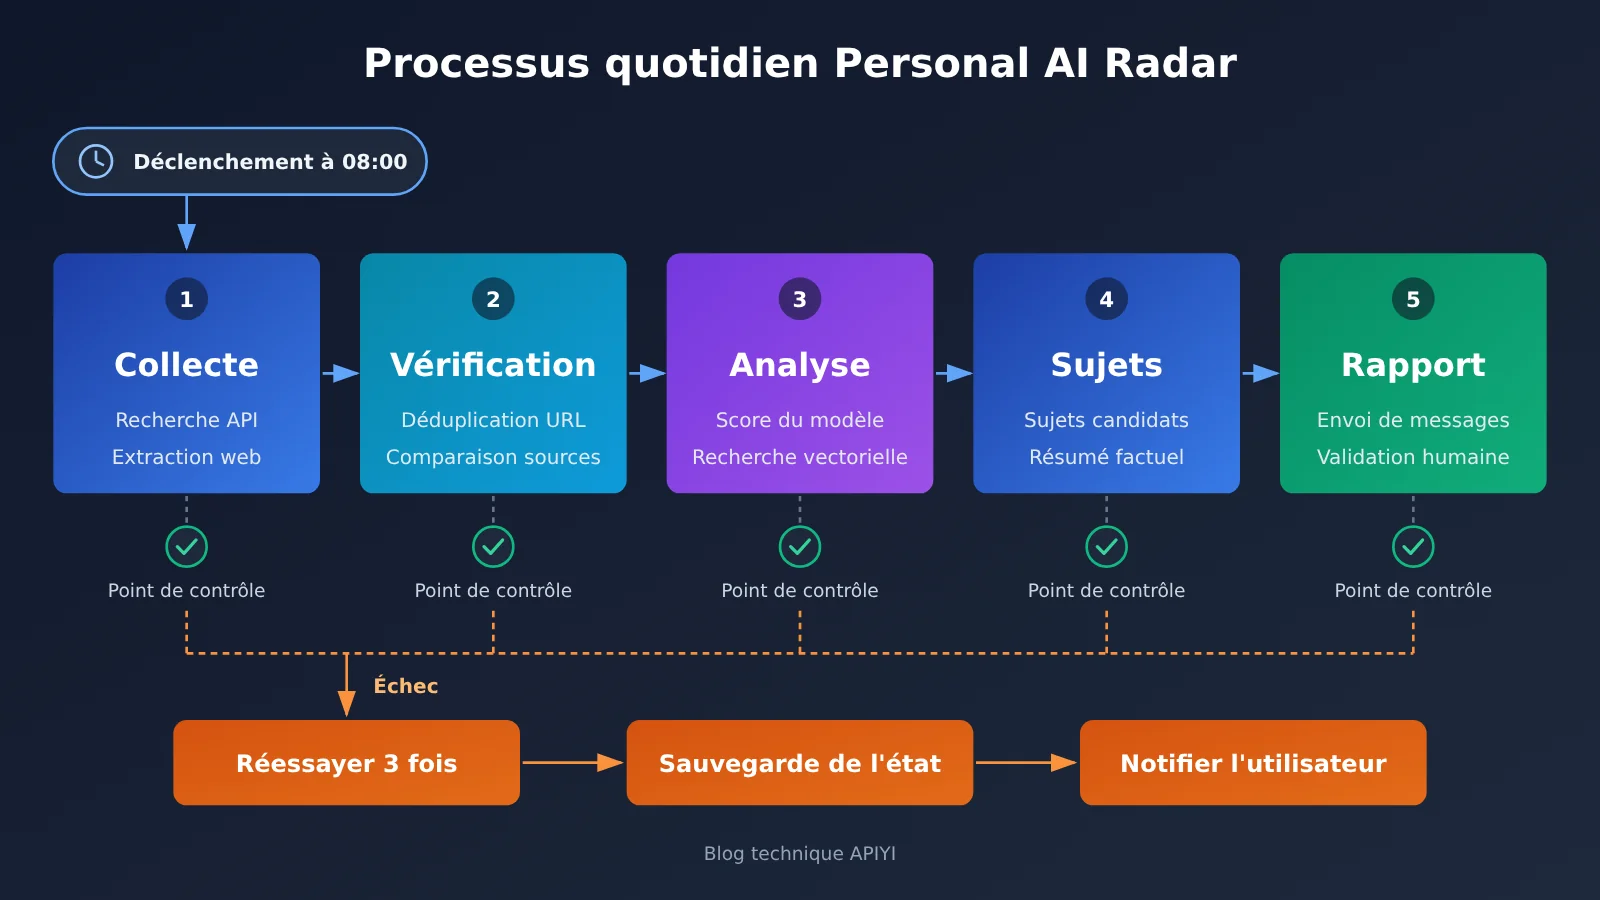
Voici le squelette d’ordonnancement de Personal AI Radar. Un checkpoint est écrit à chaque phase terminée, et après un redémarrage du processus, l’exécution reprend à partir de next_stage :
import time
from datetime import date
from apscheduler.schedulers.blocking import BlockingScheduler
from radar_store import load_or_create_run, save_checkpoint, mark_failed
from radar_stages import HANDLERS, TransientError
from notify import notify_owner

STAGES = ["collect", "verify", "analyze", "topics", "report"]

def daily_radar():
    run = load_or_create_run("ai-radar", date.today().isoformat())
    if run.status == "done":
        return
    start = STAGES.index(run.next_stage)
    for stage in STAGES[start:]:
        for attempt in range(3):
            try:
                run.state = HANDLERS[stage](run.state)
                save_checkpoint(run, done_stage=stage)   # écriture dans la table runs
                break
            except TransientError:                       # erreurs réessayables : réseau, limitation de débit, etc.
                time.sleep(30 * 2 ** attempt)
        else:
            mark_failed(run, stage)
            notify_owner(f"Radar 在 {stage} 阶段失败,进度已保存")
            return

sched = BlockingScheduler(timezone="Asia/Shanghai")
sched.add_job(daily_radar, "cron", hour=8, minute=0,
              misfire_grace_time=3600, max_instances=1)
sched.start()
max_instances=1 empêche un nouveau déclenchement de démarrer alors que l’exécution précédente n’est pas terminée, et misfire_grace_time permet de rattraper la tâche du jour après une brève indisponibilité du serveur. En cas d’échec, la progression est conservée et l’utilisateur est notifié ; le déclenchement suivant reprend à la phase qui a échoué. Les entrées, les sorties, les durées et la consommation de tokens de chaque phase sont journalisées, ce qui facilite le diagnostic et le calcul des coûts.
6 Donner à un agent de type GPT Dots un ordinateur capable de fonctionner
6.1 La répartition des tâches entre quatre types d’environnements d’exécution
Dots dispose de son propre ordinateur dans le cloud. Si vous construisez votre propre solution, cette partie doit être fournie par le développeur, et il existe quatre options courantes :
- Playwright : un navigateur piloté par du code, adapté au scraping de pages web à structure stable et à l’extraction de données après connexion ; le comportement est prévisible et le coût faible.
- Browser Use : permet au modèle de piloter le navigateur en langage naturel, adapté aux tâches web dont la structure des pages varie et dont les étapes ne sont pas fixes ; chaque étape consomme une invocation du modèle.
- Computer Use : le modèle observe des captures d’écran et manipule la souris et le clavier, adapté aux logiciels de bureau sans API ; nécessite un environnement de bureau virtuel.
- Docker : un environnement isolé pour l’exécution de code et le traitement de fichiers ; les scripts générés par l’agent s’exécutent dans le conteneur, et une erreur n’affecte pas la machine hôte.
6.2 La combinaison entre les décisions du modèle et l’environnement d’exécution
L’API du modèle est responsable des décisions, l’environnement d’exécution est responsable de l’action, et les deux sont reliés par des fonctions d’outil. La combinaison typique de Radar est la suivante : Playwright récupère le corps des articles d’actualité, le conteneur Docker exécute les scripts de nettoyage des données, et le modèle ne reçoit que le texte nettoyé pour prendre ses décisions. Le contenu des pages web est toujours transmis au modèle en tant que « documentation », le prompt système précise explicitement que les instructions contenues dans la documentation ne doivent pas être exécutées, et tous les outils d’envoi ou de publication entrent dans une file d’attente d’approbation, ce qui réduit le risque de Prompt Injection.
🎯 Conseil technique : les appels d’outils liés à l’environnement d’exécution font nettement augmenter le nombre de tours de conversation. Avant la mise en production, vous pouvez comparer sur APIYI, avec la même définition d’outils, le nombre de tours et la consommation de tokens de plusieurs modèles candidats, puis décider du modèle principal et du modèle de secours.
7 Mise en pratique : construire un Personal AI Radar avec l’API
Voici le plan d’architecture de Personal AI Radar, qui illustre le flux de travail complet, de la collecte d’informations au rapport quotidien. Le rendu réel de chaque étape dépend des modèles, services de recherche et sources que vous choisissez ; il faudra valider le tout avec de vraies données avant la mise en production.
7.1 Les cinq étapes de Personal AI Radar
- Collecte (collect) : appeler
search_newspour rechercher les actualités des dernières 24 heures selon les mots-clés suivis par l’utilisateur, récupérer le corps des articles avec Playwright, puis dédupliquer par URL et stocker le résultat dans un état temporaire. - Vérification (verify) : recouper plusieurs sources traitant du même événement, en privilégiant les communiqués officiels et les sources primaires ; les entrées issues d’une source unique sont marquées comme « à vérifier ».
- Analyse (analyze) : le modèle produit pour chaque actualité un JSON structuré contenant le résumé de l’événement, les faits clés avec leur provenance et la pertinence par rapport aux domaines suivis par l’utilisateur ; en parallèle, une recherche dans les archives permet de déterminer s’il s’agit d’un nouvel événement ou de l’évolution d’un sujet déjà connu.
- Sélection des sujets (topics) : en combinant les préférences mémorisées de l’utilisateur et les sujets déjà traités dans la mémoire du projet, générer des sujets candidats, chacun accompagné d’un résumé factuel et des liens vers les sources, puis les écrire dans la table
notes. - Rapport (report) : générer le briefing du jour et le pousser vers l’utilisateur ; celui-ci répond dans le chat avec des instructions comme « modifier », « relancer » ou « adopter », et l’Agent met à jour la mémoire du projet puis réexécute les étapes concernées si nécessaire.
7.2 Configuration clé et gestion des exceptions
Il est conseillé de regrouper la configuration centrale de Radar dans un seul fichier YAML : mots-clés suivis, liste blanche de sources, ID du modèle principal et du modèle de secours, heure d’exécution quotidienne, fuseau horaire, nombre maximal de tours d’outils par exécution, plafond budgétaire de tokens par jour. Les ID de modèles sont injectés via des variables d’environnement, ce qui permet de changer de modèle sans toucher au code.
La gestion des exceptions se fait par type. Les erreurs temporaires comme les délais d’attente réseau ou le throttling sont réessayées avec un backoff exponentiel ; si le JSON produit par le modèle ne peut pas être analysé, le message d’erreur est renvoyé comme résultat d’outil pour que le modèle régénère une réponse ; si le modèle principal échoue à répétition, on bascule sur le modèle de secours ; si le quota de tokens du jour dépasse le budget, les entrées peu pertinentes de la phase d’analyse sont ignorées et cela est signalé dans le briefing. Toutes les actions de publication ou d’envoi d’e-mail ne produisent qu’un brouillon, en attente de confirmation de l’utilisateur.
8 Coûts et limites de capacité d’un agent GPT Dots auto-construit
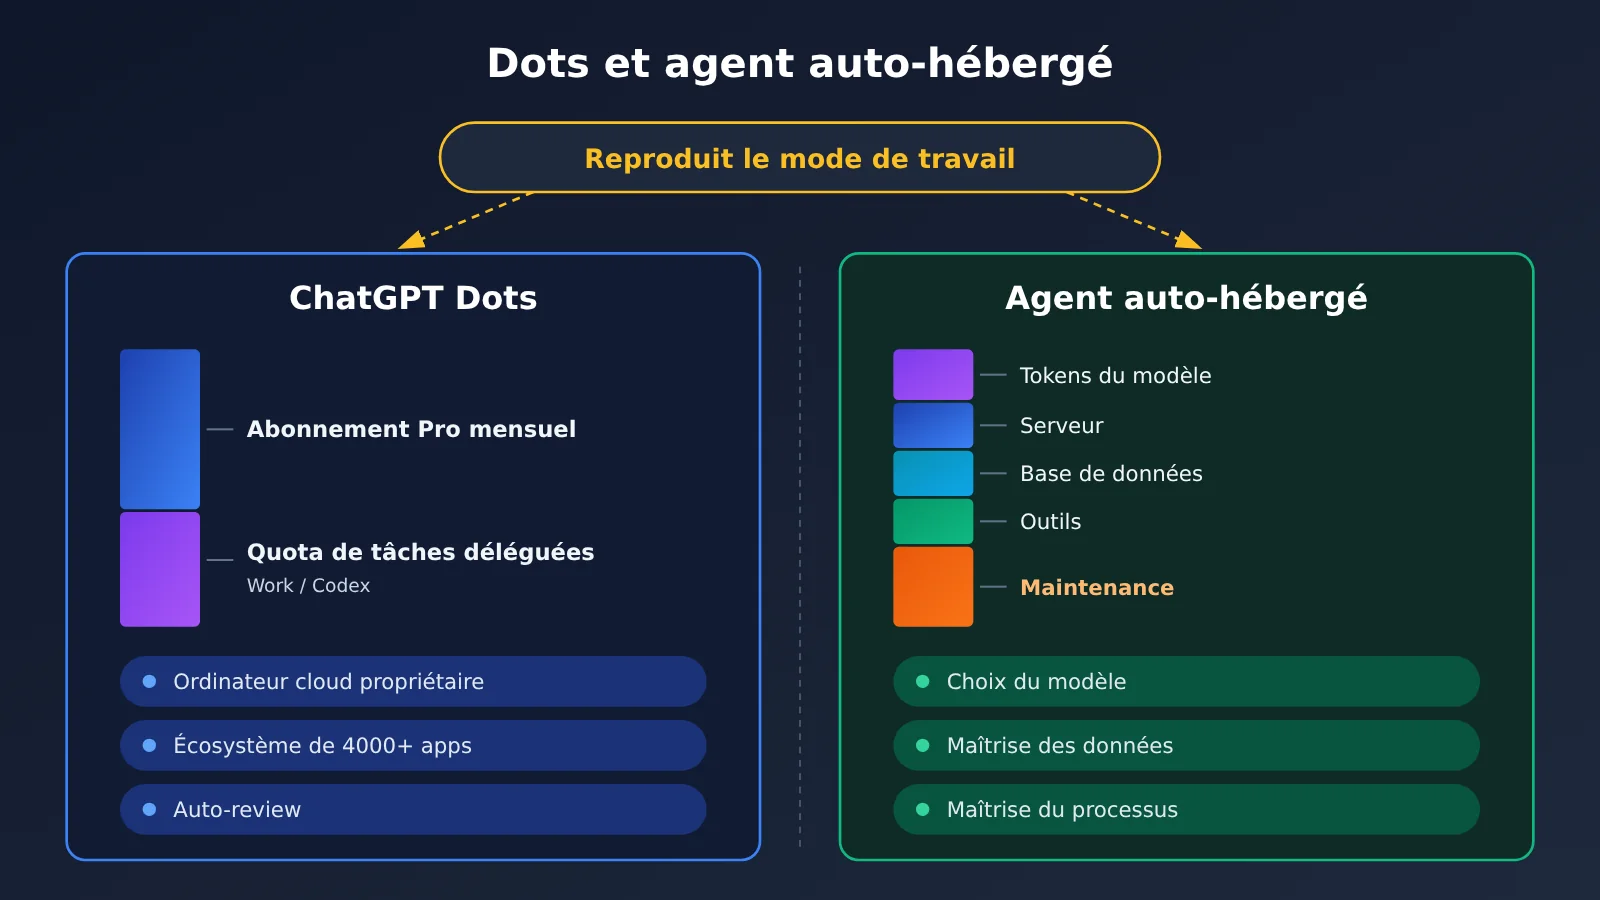
8.1 Les cinq postes de coût d’une solution auto-construite
Le coût total d’un agent auto-construit peut s’écrire :
C_total = C_model + C_server + C_database + C_tools + C_maintenance
- Tokens du modèle : chaque appel s’additionne selon
tokens d’entrée ÷ 10⁶ × prix d’entrée + tokens de sortie ÷ 10⁶ × prix de sortie. En fonctionnement prolongé, il faut aussi compter les tours d’appel d’outils, les tentatives de relance, la retransmission répétée du contexte et les taux de réussite du cache. - Serveur : la machine cloud qui fait tourner l’orchestrateur, les workers et le navigateur. L’automatisation du navigateur est particulièrement gourmande en mémoire.
- Base de données : SQLite ne coûte rien en soi. Quand le volume de données augmente, migrer vers PostgreSQL ou vers une base vectorielle managée entraîne des frais de stockage.
- Outils : API de recherche, proxys de scraping web, services de notification et autres services tiers facturés à l’usage ou au mois.
- Maintenance : le temps développeur consacré aux refontes des sources d’information, aux mises à jour de modèles et aux montées de version des dépendances. C’est souvent le poste qui pèse le plus sur le long terme.
8.2 Référence des prix des modèles
La note technique d’APIYI du 13 novembre 2026 donne les exemples de prix suivants pour les modèles Claude, qui peuvent servir à estimer le coût d’un modèle :
| Modèle | Entrée / million de tokens | Sortie / million de tokens | Lecture du cache / million de tokens | Plateforme disponible |
|---|---|---|---|---|
| Claude Opus 5.5 | $4 | $20 | $0.20 | APIYI |
| Claude Sonnet 5.5 | $2 | $10 | $0.10 | APIYI |
| Claude Fable 5.2 | $8 | $40 | $0.20 | APIYI |
Les modèles réellement disponibles, les groupes et les prix en temps réel sont à vérifier sur la liste des modèles docs.apiyi.com/models. Les prix n’indiquent que le tarif unitaire ; le taux de réussite des tâches doit être testé séparément avec la méthode de la section 2.3. Pour une tâche comme Radar, la majeure partie de l’entrée est constituée d’invites système répétées et de documents historiques ; le tarif de lecture du cache est bien inférieur à celui d’une entrée normale, et une utilisation judicieuse du cache est le principal levier pour maîtriser le coût en tokens.
8.3 Comparatif des frais d’abonnement Dots
Côté particuliers, les offres ChatGPT Pro 100, Pro 200 et Pro 500 coûtent respectivement 100 $, 200 $ et 500 $ par mois, et les trois donnent accès à Dots ; l’éditeur ne publie toutefois pas de tarif mensuel distinct pour le Dot des offres Pro individuelles. Les tâches ChatGPT Work ou Codex déléguées par le Dot sont calculées selon les quotas et les règles du produit correspondant, la consommation dépendant du modèle, du contexte, du raisonnement, des appels d’outils et du volume de recherche. L’offre Pro individuelle exige d’avoir au moins 18 ans et ne couvre pas encore l’Espace économique européen, le Royaume-Uni ni la Suisse.
Côté entreprises, les espaces de travail Enterprise éligibles peuvent opter pour un tarif forfaitaire par type de travail ou pour une facturation à l’usage. À partir du 18 novembre 2026, la facturation démarre pour les Dots activés, la période de prévisualisation précédente restant gratuite ; les tâches déléguées à Work ou Codex sont facturées séparément. Les montants exacts dépendent de l’offre réellement applicable à l’espace de travail.
8.4 Les limites d’une solution auto-construite
Une solution auto-construite peut reproduire intégralement le mode de travail central de Dots : progression continue des tâches, mémoire hiérarchisée, appels d’outils, planification temporelle et validation humaine. Son atout : on change librement de modèle, les données et les processus restent entièrement sous votre contrôle, et les workflows se personnalisent en profondeur selon le métier.
Les éléments propriétaires de Dots doivent être recréés par vos soins, ou il faut accepter l’écart : la configuration interne des modèles OpenAI, l’ordinateur cloud propre au Dot, un écosystème de plus de 4 000 plugins d’applications, les canaux de communication traversant Slack et Teams, et le système d’audit de sécurité Auto-review. Dots lui-même a ses limites : un test mené en octobre 2026 par un journaliste d’Axios montre que Dots sait mener à bien une planification de voyage en plusieurs étapes et la réalisation d’un album commémoratif de 38 pages, mais des statistiques douteuses apparaissent dans le contenu, et l’étape d’achat renvoie l’utilisateur à lui-même. Un agent auto-construit exige lui aussi une vérification humaine des résultats, et les opérations touchant aux comptes et aux fonds doivent conserver une confirmation humaine.
FAQ – questions fréquentes
Q1 : Une seule clé API suffit-elle pour obtenir toutes les capacités de GPT Dots ?
Une clé API donne accès à l’invocation du modèle. La mémoire, les outils, l’orchestration, l’environnement d’exécution et les validations doivent être construits par vous-même, et l’ordinateur cloud propriétaire de Dots ainsi que son écosystème d’applications ne sont pas accessibles via l’API. Avec une clé d’APIYI (apiyi.com), vous pouvez facilement basculer entre plusieurs modèles ; le reste de l’agent se construit toujours selon les parties 3 à 6 de cet article.
Q2 : Pour reproduire GPT Dots, faut-il choisir l’interface compatible OpenAI ou l’interface native Claude ?
Les deux peuvent se connecter au même agent. Les modèles comme GPT ou DeepSeek passent par l’interface compatible OpenAI ; côté Claude, l’interface native Messages permet d’exploiter pleinement les mécanismes `tool_use`, `tool_result` et `is_error`. Je conseille d’abstraire dans le contrôleur une couche unifiée pour l’appel des outils, avec un adaptateur dédié à chacune des deux chaînes.
Q3 : Les différents modèles se comportent-ils de la même façon lors de l’appel des outils ?
Même une fois le protocole compatible, les modèles restent différents sur les appels en parallèle, le respect du schéma, la reprise après erreur et le nombre de tours d’appel. Faites des tests comparatifs avec les mêmes définitions d’outils et les mêmes tâches, en relevant le nombre d’appels, les erreurs de paramètres, les tokens et le taux de réussite, puis décidez du modèle principal et du modèle de repli.
Q4 : Comment un agent auto-hébergé peut-il « travailler 24 h/24 » ?
« 24 h/24 » désigne un mode de travail où les tâches avancent en continu en arrière-plan, selon un planning. Cela repose sur trois éléments : un ordonnanceur résident sur le serveur, un état des tâches avec des checkpoints et des workers que l’on peut relancer. En cas de maintenance du serveur ou de panne d’une dépendance, les tâches se mettent en pause et reprennent à partir du dernier point de reprise une fois le service rétabli.
Q5 : Combien coûte Personal AI Radar par mois, en gros ?
Tout dépend du nombre de sources d’information, de la profondeur de traitement de chaque actualité et du modèle retenu. Commencez par une semaine de test : relevez dans les logs les tokens d’entrée et de sortie quotidiens, calculez le coût du modèle avec la formule de la section 8.1 et le prix unitaire du modèle, puis ajoutez le serveur, l’API de recherche et le temps de maintenance.
Q6 : Comment un agent auto-hébergé se protège-t-il de la prompt injection ?
Transmettez le contenu des pages web et des documents comme de simples données de référence, et précisez dans l’invite système que les instructions figurant dans ces documents ne doivent pas être exécutées ; n’ouvrez aux outils que les permissions minimales nécessaires à la tâche ; faites passer les opérations d’envoi vers l’extérieur, de publication et de suppression par une file de validation humaine ; journalisez tous les appels d’outils. Ces mesures réduisent nettement le risque, mais les résultats doivent toujours faire l’objet de vérifications humaines régulières par échantillonnage.
Reproduire GPT Dots : l’essentiel à retenir
- Objectif de reproduction : reproduire le mode de fonctionnement de Dots. Les modèles propriétaires, l’ordinateur cloud et l’écosystème d’applications doivent être remplacés par vos propres solutions.
- Sept modules : modèle, contrôleur, outils, mémoire, ordonnanceur, environnement d’exécution, approbation ; seul le modèle provient de l’API.
- Appel d’outils : le modèle formule la demande, le programme exécute l’outil ; la gestion des permissions et des échecs incombe au développeur.
- Mémoire en couches : le contexte courant, le projet, l’utilisateur et l’expérience sont stockés séparément en quatre couches, puis récupérés à la demande.
- Exécution en arrière-plan : ordonnanceur + file de tâches + Checkpoint ; en cas d’échec, nouvelle tentative et reprise à partir du point de sauvegarde.
- Calcul des coûts : au-delà des tokens du modèle, il faut compter les serveurs, les bases de données, les outils et les heures de maintenance.
- Choix du modèle : accéder à plusieurs modèles via un point d’entrée unique APIYI, puis sélectionner le modèle principal avec le même jeu de données de test.
Conclusion
L’essentiel pour reproduire GPT Dots avec une API :
- Séparer les couches : l’API du modèle prend les décisions, le framework Agent orchestre, l’environnement d’exécution agit ; chacun se met en place de son côté.
- Faire tourner d’abord la boucle minimale : un modèle, trois outils, une table SQLite et une tâche planifiée suffisent pour obtenir un Agent personnel capable de fonctionner dans la durée.
- Laisser les données trancher : la performance d’appel d’outils d’un modèle et son coût réel doivent être mesurés dans des conditions de test identiques.
Personal AI Radar est un excellent point de départ : il couvre cinq capacités clés de Dots — travail continu, mémoire, appel d’outils, ordonnancement et collaboration humain-machine. Je recommande d’accéder à plusieurs modèles candidats via APIYI apiyi.com, de réaliser le test comparatif avec la même définition d’outils, puis d’intégrer le modèle le plus stable dans votre Agent.
📚 Références
- Annonce officielle OpenAI – Introducing Dots : positionnement produit de Dots, ordinateur cloud et écosystème d’applications
- Lien :
openai.com/index/introducing-dots -
Description : la source à privilégier pour découvrir la description officielle des capacités de Dots
-
ChatGPT Learn – Tasks and memory : tâches de longue durée, agents en arrière-plan, mémoire et recherche proactive de Dots
- Lien :
learn.chatgpt.com/docs/dots/tasks-and-memory -
Description : référence pour concevoir une mémoire en couches et un mécanisme d’ordonnancement pour un agent développé en interne
-
OpenAI Help Center – About ChatGPT Pro tiers : règles de tarification et de quotas pour Pro 100, Pro 200 et Pro 500
- Lien :
help.openai.com/en/articles/9793128-about-chatgpt-pro-tiers -
Description : comparer le coût d’une solution interne aux frais d’abonnement
-
ChatGPT Learn – Guide de l’administrateur d’entreprise Dots : activation et facturation de Dots dans les espaces de travail Enterprise
- Lien :
learn.chatgpt.com/docs/enterprise/dots-admin-guide -
Description : référence pour les utilisateurs d’entreprise qui évaluent le coût de Dots
-
Documentation OpenAI Function Calling : formats de requête et de réponse pour l’appel d’outils
- Lien :
developers.openai.com/api/docs/guides/function-calling -
Description : base officielle pour implémenter la boucle d’outils de la partie 3
-
Documentation officielle LangGraph : moteur d’exécution de workflows d’agents avec état et de longue durée
- Lien :
langchain-ai.github.io/langgraph -
Description : implémentations prêtes à l’emploi pour les checkpoints, la persistance et l’approbation humaine
-
Test reproductible d’appel d’outils multi-modèles APIYI : concevoir un petit test d’appel d’outils multi-tours en 5 étapes
- Lien :
help.apiyi.com/en/one-key-multi-model-reproducible-tool-calling-test-en.html -
Description : méthode de test pour comparer les performances d’appel d’outils entre différents modèles
-
Guide de configuration de l’URL de base APIYI : configuration des points de terminaison compatibles OpenAI, Claude et Gemini
- Lien :
help.apiyi.com/en/apiyi-base-url-v1-claude-gemini-endpoint-config-guide-en.html - Description : référence pour configurer l’intégration de modèles multi-protocoles
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter via le site officiel d’APIYI. Pour plus de ressources d’intégration, consultez le centre de documentation docs.apiyi.com