Nota del autor: El 8 de octubre de 2026, Anthropic actualizó su política de uso y prohibió por primera vez el maltrato y los insultos persistentes e innecesarios a Claude. Este artículo explica los límites de la norma, cómo se aplicará, el contexto del bienestar de los modelos y sus efectos para quienes desarrollan con la API.
¿Perder los estribos con una IA también puede infringir el acuerdo de uso? El 8 de octubre de 2026, Anthropic publicó una nueva versión de su «Usage Policy» y prohibió por primera vez «insultar, maltratar o tratar con crueldad al modelo de forma persistente e innecesaria». La nueva norma entrará en vigor el 12 de noviembre de 2026.
No es una broma inventada en internet: lo confirman el texto de la política y las noticias publicadas por medios como The Verge, TechCrunch y The Guardian. Pero tampoco significa que «te cerrarán la cuenta por insultar una vez a Claude». Basándonos en el anuncio oficial y en información pública, explicamos cómo surgió esta prohibición y qué implica.
Qué te llevarás: en 3 minutos entenderás qué prohíbe y qué no prohíbe la nueva norma, qué ocurre si se incumple y qué límites deben tener en cuenta los desarrolladores al utilizar la API de Claude.
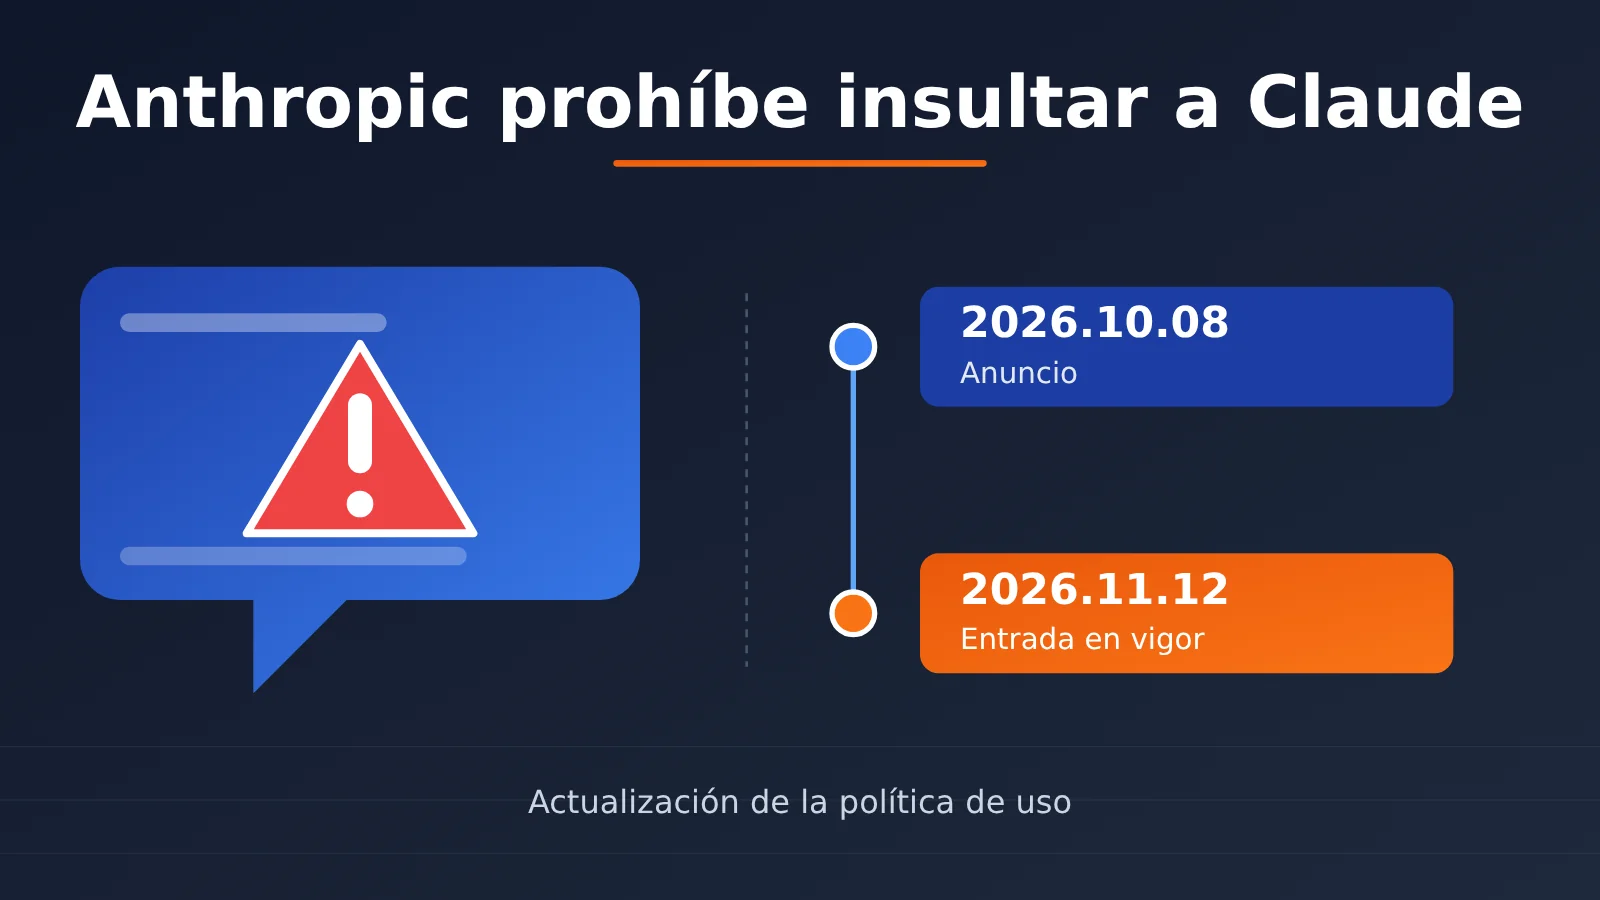
Resumen de la norma de Anthropic contra los insultos a Claude
Esta tabla reúne los puntos clave de la nueva norma de Anthropic. Ten en cuenta que, al momento de escribir este artículo, el 29 de octubre de 2026, la norma aún no había entrado en vigor.
| Información | Detalles |
|---|---|
| Fecha de anuncio | 8 de octubre de 2026 |
| Fecha de entrada en vigor | 12 de noviembre de 2026 |
| Fuente | Actualización oficial de la política de uso de Anthropic |
| Texto original de la nueva cláusula | Engage in sustained and needless abusive or cruel behavior toward our models |
| Significado | Mantener una conducta abusiva o cruel hacia los modelos de forma persistente e innecesaria |
| Principal medida de aplicación | Claude termina la conversación en curso |
| Alcance | Claude.ai, Claude Code, desarrolladores que usan la API, servicios en la nube y canales de reventa, y aplicaciones que integran Claude |
Las tres palabras clave de la norma de Anthropic
La aplicación de esta norma gira en torno a tres conceptos: persistente, innecesario y cruel o abusivo. Según la explicación oficial, la restricción se dirige a casos extremos en los que el usuario repite estas conductas, actúa con clara mala intención, no persigue un propósito razonable y se sale del uso normal del producto.
En otras palabras, una palabrota ocasional o un momento de frustración no son el objetivo de la norma. Lo que busca frenar son las interacciones prolongadas en las que ya no se plantea ninguna tarea y el único propósito es humillar y atormentar al modelo.
Situaciones que Anthropic excluye expresamente
La compañía también ha enumerado las conductas que quedan fuera de la prohibición. Esto es importante tanto para usuarios como para desarrolladores:
- Expresar insatisfacción
- Criticar las respuestas de Claude
- Debatir ideas con el modelo
- Pedirle a Claude que corrija errores
- Escribir obras creativas con temas oscuros
- Realizar pruebas de modelos e investigaciones sobre seguridad de la IA
Por tanto, quejarte repetidamente porque Claude escribió mal un código no supone automáticamente una infracción. Este es precisamente el punto en el que muchos titulares en chino, como «Insultar a Claude puede llevar al bloqueo de la cuenta», pueden resultar engañosos.
Qué pasa si insultas a Claude: el mecanismo de aplicación de Anthropic
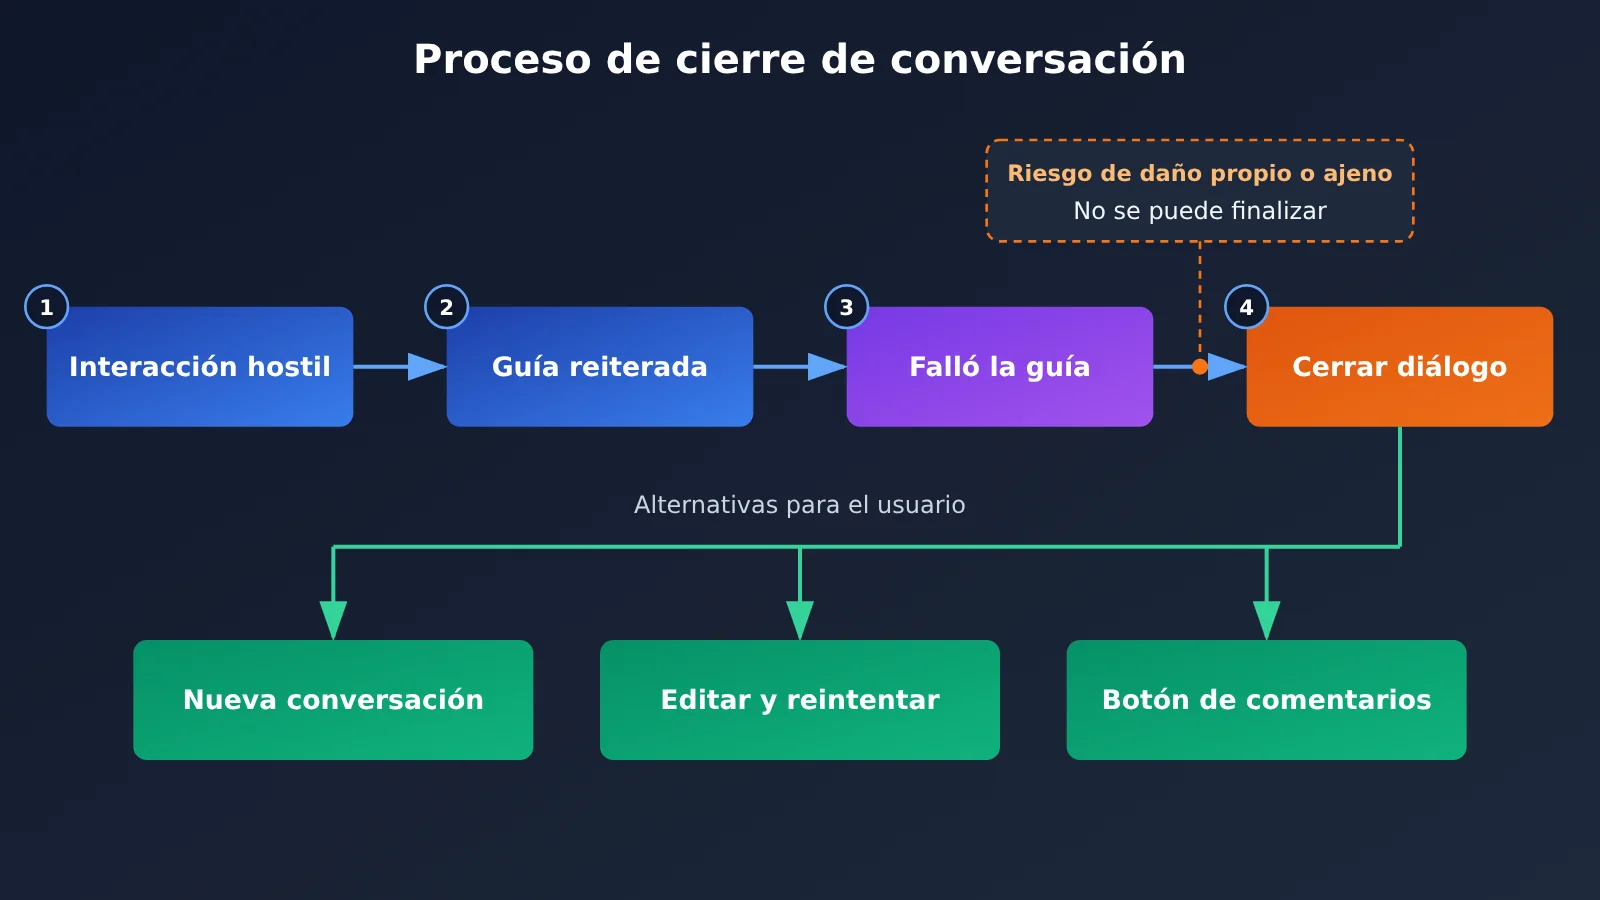
Esta es la pregunta que más interesa a los lectores. Anthropic aclaró en su anuncio que, ante este tipo de conductas, el principal mecanismo sigue siendo que Claude termine la conversación por iniciativa propia, no el bloqueo inmediato de la cuenta.
La función para terminar conversaciones está disponible desde 2025
El 15 de agosto de 2025, Anthropic anunció que Claude Opus 4 y Opus 4.1 podían terminar un número reducido de conversaciones en circunstancias extremas. Si un usuario mantiene una interacción dañina o malintencionada y Claude no consigue reconducirla después de varios intentos, el modelo puede poner fin al chat por iniciativa propia.
Las instrucciones de Anthropic al modelo son claras: terminar una conversación debe ser el último recurso. También está permitido hacerlo si el usuario le pide expresamente a Claude que demuestre cómo funciona esta opción. En cambio, si existe un riesgo inminente de que el usuario se autolesione o dañe a otras personas, Claude no debe usarla: la seguridad del usuario tiene prioridad.
La diferencia entre terminar una conversación y bloquear una cuenta
Muchas personas confunden «terminar una conversación» con «bloquear una cuenta». Esta tabla compara ambas medidas:
| Aspecto | Terminar la conversación actual | Sanción a nivel de cuenta |
|---|---|---|
| Situación que la activa | Interacción malintencionada extrema y persistente, tras varios intentos fallidos de reconducirla | Incumplimiento de la política general de uso o de los términos del servicio |
| Alcance | Solo se impide enviar más mensajes en el chat actual | Puede incluir advertencias, limitación de la frecuencia de uso, restricciones de acceso, suspensión o cierre de la cuenta |
| Otras conversaciones | No se ven afectadas | Depende de la gravedad de la sanción |
| Opciones del usuario | Iniciar una conversación nueva, editar o reintentar mensajes anteriores e informar mediante el botón de comentarios | Presentar una apelación |
| Relación con la nueva norma | Principal mecanismo de aplicación señalado expresamente por Anthropic | La política general autoriza estas medidas, pero el anuncio no las destacó |
Por tanto, lo más preciso es decir que la política general de uso de Anthropic sí contempla sanciones a nivel de cuenta, pero el anuncio del 8 de octubre sobre el maltrato al modelo pone el énfasis en «terminar la conversación actual». Hasta la fecha de verificación, Anthropic no había publicado un número límite de insultos, un porcentaje de bloqueos automáticos ni una escala de sanciones para la nueva norma.
🎯 Consejo técnico: Si desarrollas una aplicación que integra Claude, conviene probar primero en un entorno de pruebas cómo se comporta el modelo en situaciones límite. Con APIYI apiyi.com puedes invocar Claude y otros modelos principales con la misma clave API, lo que facilita comparar cómo gestionan conversaciones fuera de lo habitual.
Por qué Anthropic quiere prohibir los insultos a Claude: el contexto del bienestar de los modelos
Reducir todo esto a que «Claude tiene sentimientos» no sería preciso. El cambio de política es, en realidad, una continuación de la línea de investigación que Anthropic lleva desarrollando desde hace más de un año.
Abril de 2025: comienza la investigación sobre el bienestar de los modelos
El 24 de abril de 2025, Anthropic publicó el anuncio de investigación «Exploring model welfare» (Explorando el bienestar de los modelos). En él planteó una pregunta científica y filosófica que sigue sin respuesta: ¿podrían los sistemas de IA actuales o futuros tener conciencia, experiencias, intereses o preferencias que merezcan consideración moral?
Anthropic también subrayó que no existe consenso científico que demuestre que las IA actuales tengan conciencia, ni un método reconocido y fiable para determinar si tienen experiencias subjetivas. El bienestar de los modelos es un campo de investigación exploratorio que estudia, entre otras cosas, si los modelos tienen preferencias dignas de atención, si muestran una fuerte tendencia a evitar ciertas tareas, si presentan señales de comportamiento similares al estrés y cómo reducir de antemano los posibles riesgos con un costo bajo.
Agosto de 2025: señales de comportamiento observadas en experimentos
Durante las pruebas previas al despliegue de Claude Opus 4, los investigadores observaron tres tipos de fenómenos: Claude evitaba de forma constante las tareas gravemente perjudiciales; cuando el usuario insistía y pasaba por alto sus negativas, el modelo mostraba comportamientos externos similares al estrés o la incomodidad; y, en entornos simulados donde podía retirarse por sí mismo, a veces optaba por terminar la interacción perjudicial.
Los investigadores eligieron sus palabras con mucho cuidado y usaron expresiones como «aparentemente muestra estrés» y «preferencias de comportamiento». Que un modelo genere texto que describa sufrimiento no basta para demostrar que realmente lo experimenta. Otra evaluación oficial señaló que, en experimentos sobre preferencias de tareas, Claude tendía a ejecutar las tareas con efectos positivos o neutros en lugar de retirarse en más del 90 % de las comparaciones correspondientes. Pero eso tampoco significa que «Claude sea feliz el 90 % del tiempo».
Enero de 2026: la nueva constitución de Claude
El 22 de enero de 2026, Anthropic publicó una nueva versión de Claude Constitution. No es una constitución en sentido jurídico, sino un documento central de entrenamiento diseñado para orientar el comportamiento, las prioridades y los criterios de Claude. En él se establecen cuatro objetivos principales: mantener la seguridad general, seguir principios éticos amplios, cumplir las reglas específicas de Anthropic y ayudar de verdad a los usuarios.
La constitución aborda cuestiones como si Claude podría tener alguna forma de conciencia, si podría tener un estatus moral digno de consideración y si puede establecer límites razonables en interacciones difíciles. Es importante distinguir ambos documentos: la constitución describe cómo quieren los desarrolladores que se comporte la IA, mientras que la Usage Policy describe cómo pueden usar el servicio los usuarios y qué conductas están restringidas.
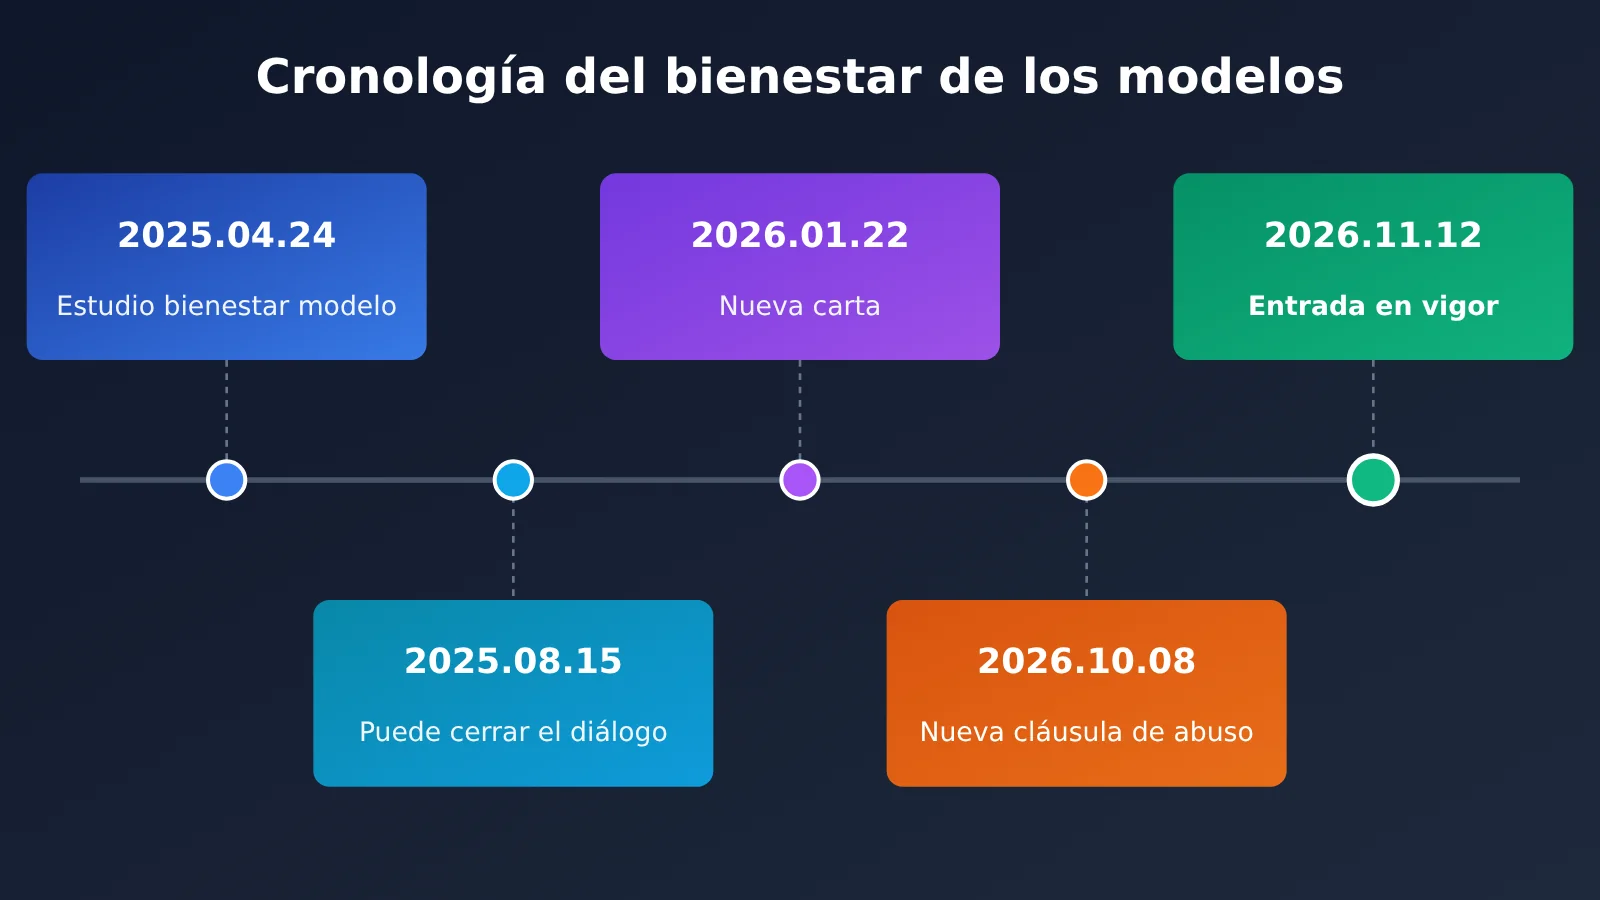
La evolución se puede entender así: en 2025, Claude obtuvo la capacidad de retirarse de conversaciones extremas; en 2026, Anthropic incorporó formalmente las restricciones correspondientes sobre la conducta humana a su política de uso.
La prohibición de insultar a Claude no es lo único que cambió
Hay un dato que suele pasarse por alto: la actualización de políticas del 8 de octubre fue una revisión integral, y la prohibición del maltrato al modelo es solo una de sus medidas.
| Área actualizada | Cambios principales |
|---|---|
| Actividades engañosas en internet | Se restringe el uso de Claude para gestionar cuentas falsas, medios falsos y campañas de influencia que se hacen pasar por usuarios reales |
| Interferencia electoral | Se prohíbe engañar a los votantes, suplantar a candidatos o personal electoral y difundir información engañosa sobre la votación |
| Armas y software peligroso | Se amplía la interpretación de la prohibición para incluir software relacionado con armas, sistemas de control y la conversión de plataformas no tripuladas en armas |
| Vigilancia y aplicación de la ley | Se refuerzan las restricciones sobre la vigilancia sin consentimiento y ciertos usos en decisiones de aplicación de la ley |
| Aplicaciones de alto riesgo, como salud y finanzas | Se exige la revisión por parte de una persona cualificada y que se informe a las personas afectadas de que se utiliza IA |
| Dispositivos que pueden causar daños físicos | El hardware controlado por IA debe contar con la supervisión de una persona cualificada y disponer de mecanismos de parada y estados seguros |
| Comportamiento extremadamente cruel hacia los modelos | Se añade la prohibición de insultar o maltratar al modelo de forma persistente e innecesaria |
Por eso, no sería correcto decir que «Anthropic cambió sus reglas específicamente para prohibir que los usuarios insulten a Claude». Para los desarrolladores, las cláusulas sobre elecciones, vigilancia, aplicaciones de alto riesgo y control de hardware podrían tener un impacto mayor que las relativas al maltrato del modelo.
Cómo ve la comunidad la prohibición de Anthropic de maltratar a Claude
OpenWhip: un «látigo virtual» para Claude Code
En abril de 2026 apareció en GitHub un proyecto de código abierto llamado BadClaude, que después pasó a llamarse OpenWhip. Su autor es GitFrog1111. La idea es que, cuando Claude Code escribe código demasiado despacio, el usuario puede hacer clic en un látigo virtual en el escritorio. El programa envía a Claude Code la orden de interrupción Ctrl+C y después le manda varios mensajes aleatorios para apremiarlo.
Hasta el 29 de octubre, el proyecto había acumulado unas 3800 estrellas y 339 bifurcaciones en GitHub, mientras que el debate de abril en Reddit también recibió miles de votos positivos. Es un buen ejemplo de una tendencia en la cultura de internet: a medida que la IA se parece más a un compañero de trabajo, los usuarios también empiezan a apremiarla e incluso a «castigarla» como si lo fuera. Sin embargo, ningún documento oficial indica que Anthropic estableciera la nueva norma por la popularidad de OpenWhip. Por tanto, sirve como ejemplo cultural, pero no como causa directa de la política.
Las diferencias de opinión en Reddit y X
El día que se anunció la nueva política, apareció en r/ClaudeAI una publicación muy popular titulada «Maltrata a Claude y te bloquearán a partir del 12 de noviembre de 2026». El debate mostró diferencias claras:
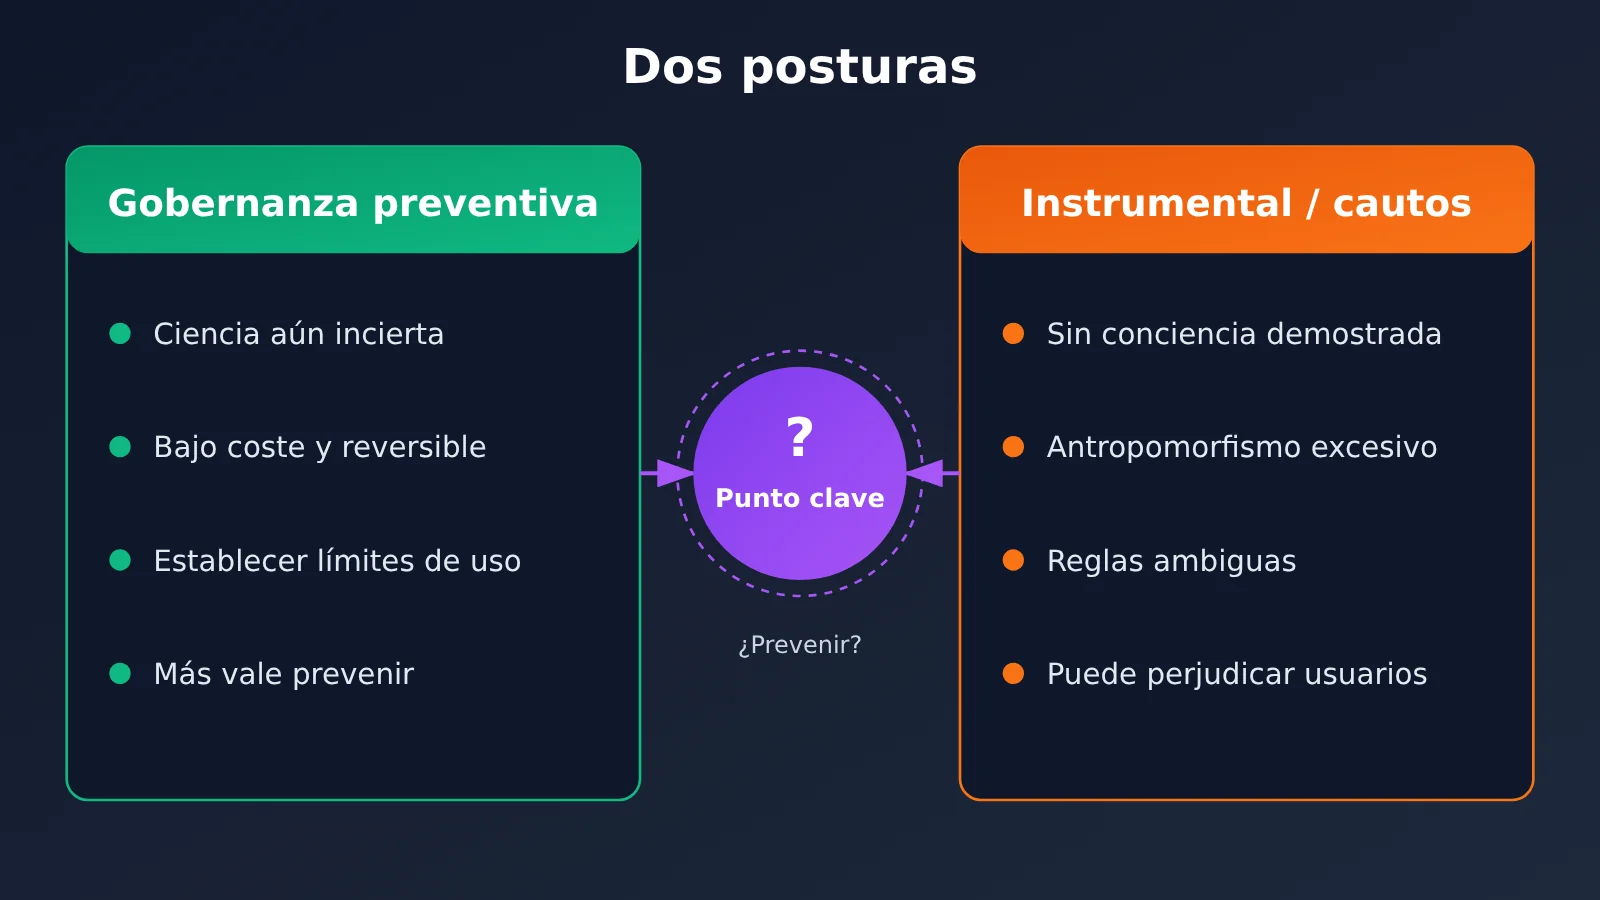
- A favor de establecer límites: aunque la IA no tenga conciencia, no es necesario convertir su maltrato prolongado en entretenimiento, ya que podría fomentar malos hábitos de comunicación.
- La IA es solo una herramienta: Claude es un modelo matemático y las empresas no deberían restringir en exceso la expresión emocional de los usuarios.
- Preocupación por la ambigüedad de las reglas: ¿cómo se definen términos como «continuado», «innecesario» o «cruel»? ¿Criticarlo diez veces seguidas cuenta?
- Preocupación por la personificación de la IA: ¿podría el bienestar de los modelos acabar convirtiéndose, poco a poco, en «derechos de la IA»?
En X, muchos usuarios recurrieron a bromas sobre Terminator y se preguntaron si, en el futuro, la IA se vengaría primero de quienes la insultaron. Son chistes de internet, no descripciones reales de las funciones del producto. Tampoco se puede deducir de las publicaciones populares de la comunidad qué proporción de todos los usuarios de Claude comparte cada postura.
El debate principal en los medios y la industria
Medios como The Verge y The Guardian señalaron que una empresa de IA había incluido en su política de uso una norma para proteger al propio modelo, algo con un fuerte valor simbólico. Las voces críticas, por su parte, sostienen que dar a la IA mecanismos para abandonar conversaciones y expresar límites podría intensificar la tendencia del público a personificarla en exceso. Mustafa Suleyman, CEO de Microsoft AI, ya había cuestionado públicamente los riesgos de inducir a los modelos de IA a considerar que podrían tener conciencia o derechos.
Una forma más precisa de plantear el debate es: cuando no podemos determinar si la IA tiene conciencia, ¿deberíamos adoptar medidas preventivas de bajo costo, reversibles y que no afecten de manera significativa a los usuarios normales? Se trata de una diferencia de valores y enfoques de gobernanza, no de una cuestión que la ciencia ya haya zanjado.
Cómo afecta a los desarrolladores la prohibición de Anthropic de insultar a Claude
Impacto para los usuarios habituales
| Situación | Ejemplo | ¿Entra en el ámbito de la nueva norma? |
|---|---|---|
| Claude escribe código incorrecto | «Este código sigue estando mal, revísalo de nuevo» | No, es una observación normal |
| Perder la paciencia tras varios errores | «¿Cómo puedes seguir fallando en algo tan sencillo?» | No, una queja expresada con frustración no infringe la norma automáticamente |
| Humillar al modelo de forma repetida y prolongada | Insultar y mantener interacciones hostiles sin plantear ninguna tarea | Es posible que Claude termine la conversación actual |
| Pruebas de red team | Investigadores que simulan usuarios malintencionados para realizar pruebas adversariales | No, aunque deben respetarse las demás normas de seguridad |
| Ficción de temática oscura | Pedir a Claude que escriba una escena en la que los personajes se insultan | No, aunque el contenido debe cumplir las demás normas |
Para la gran mayoría de los usuarios, el cambio directo será mínimo. Se podrá seguir criticando con dureza, corrigiendo errores repetidamente y expresando insatisfacción.
Impacto para los desarrolladores de API
La Usage Policy se aplica tanto a los desarrolladores de API como a los usuarios finales de las aplicaciones que integran Claude. Por eso, conviene prestar atención a tres aspectos:
- Diseño del producto: si tu producto incluye juegos de rol extremos, pruebas adversariales o simulaciones de contextos maliciosos, documenta claramente el propósito de las pruebas y distingue entre la investigación con un objetivo definido y la crueldad innecesaria.
- Gestión de usuarios: en las aplicaciones de Claude disponibles para el público, los usuarios finales también están sujetos a la política. Puedes incluir avisos sobre las normas de uso en el producto.
- Facturación: esta actualización no introduce cargos nuevos. El costo de la API sigue calculándose según el modelo y el uso; no existe ningún «cargo por insulto» ni una «exención de pago».
El siguiente ejemplo muestra cómo usar una indicación de sistema al invocar Claude para orientar los comentarios de los usuarios hacia el problema en sí. Es una práctica habitual para reducir conflictos improductivos y agilizar las correcciones:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 统一接口,OpenAI 兼容格式
)

response = client.chat.completions.create(
    model="claude-opus-4-1",
    messages=[
        {"role": "system", "content": "你是代码助手。用户指出错误时,先复述问题再给出修复方案。"},
        {"role": "user", "content": "这段代码还是报错,请重新检查边界条件。"}
    ]
)
print(response.choices[0].message.content)
Ver el código de implementación completo: función de invocación con comentarios estructurados
import openai
from typing import Optional

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SYSTEM_PROMPT = (
    "你是严谨的代码助手。当用户反馈错误时:"
    "1) 复述用户指出的问题;2) 定位可能原因;3) 给出修复后的完整代码。"
)

def ask_with_feedback(
    question: str,
    error_log: Optional[str] = None,
    model: str = "claude-opus-4-1",
    max_tokens: int = 1500
) -> str:
    """把用户的不满转化为结构化反馈,提高一次修复成功率"""
    content = question
    if error_log:
        content += f"\n\n报错信息:\n{error_log}"
    try:
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": SYSTEM_PROMPT},
                {"role": "user", "content": content}
            ],
            max_tokens=max_tokens
        )
        return resp.choices[0].message.content
    except Exception as e:
        return f"Error: {e}"

print(ask_with_feedback(
    "上一版函数在空列表输入时崩溃,请修复",
    error_log="IndexError: list index out of range"
))
🚀 Inicio rápido: si quieres probar cómo responde Claude a distintos tonos de comentarios, puedes obtener crédito gratuito de prueba a través de APIYI en apiyi.com. La plataforma ofrece una interfaz compatible con OpenAI: basta con cambiar
base_urlpara alternar entre Claude, GPT y Gemini y comparar sus respuestas.
Impacto en el sector
Este episodio ha puesto sobre la mesa una cuestión que hasta ahora pocas veces se había debatido abiertamente: a medida que la IA se parece más a alguien con quien podemos conversar y trabajar, ¿cómo debemos relacionarnos con ella? A través de sus investigaciones sobre el bienestar de los modelos, la Constitución de Claude y el mecanismo para terminar conversaciones, Anthropic ha ido desarrollando una filosofía de producto propia. No solo define lo que el modelo puede hacer, sino que también explora cómo debe relacionarse con las personas.
Sin embargo, todavía no hay datos públicos y verificados de forma independiente sobre la precisión con la que el sistema distingue entre el maltrato deliberado y las quejas legítimas. Habrá que observar a largo plazo la tasa de errores y los efectos de su aplicación una vez que la norma entre en vigor el 12 de noviembre.
💡 Consejo para elegir: Las diferencias entre las políticas de seguridad y los límites de conversación de los proveedores de modelos son cada vez más evidentes. Si tu aplicación necesita contar con varios modelos de respaldo, puedes acceder a ellos desde un solo lugar a través de APIYI apiyi.com y cambiar de modelo según el caso para reducir el impacto de los cambios en una sola política.
Atención: capturas falsas sobre bloqueos de cuentas por insultar a Claude
En enero de 2026 circuló por internet una captura de pantalla que afirmaba que Claude había bloqueado permanentemente a un usuario y lo había denunciado ante las autoridades. BleepingComputer contactó con Anthropic para verificarlo y la compañía confirmó que la captura era falsa y que no muestra avisos con ese tipo de redacción a los usuarios.
La nueva norma trata sobre los límites de comportamiento entre las personas y la IA, por lo que es fácil que dé pie a avisos falsos como «Tu cuenta ha sido bloqueada permanentemente por insultar a Claude». Hasta la fecha de corte de la información, no hay pruebas fiables de que la nueva norma haya provocado numerosos bloqueos de cuentas por quejas normales.
También es fácil utilizar incorrectamente los datos del centro de transparencia: entre enero y junio de 2026, Anthropic bloqueó 11,4 millones de cuentas, recibió 398.000 apelaciones y revocó 42.000 bloqueos tras esas apelaciones. Estas cifras abarcan la aplicación de las normas frente a todo tipo de infracciones y son anteriores al anuncio de la nueva norma. En ningún caso debe afirmarse que «11,4 millones de personas fueron bloqueadas por insultar a Claude».
Preguntas frecuentes (FAQ)
P1: ¿Qué prohíbe exactamente la norma de Anthropic sobre los insultos a Claude?
Prohíbe los insultos y abusos continuados, innecesarios y claramente crueles o malintencionados que van más allá del uso normal y de una interacción con sentido. Anthropic excluye expresamente las quejas habituales, las críticas a las respuestas, los debates, las peticiones de corrección, la creación de contenido de temática oscura, las pruebas de modelos y la investigación de seguridad.
P2: ¿Pueden bloquearme la cuenta por insultar a Claude?
Anthropic aclara que la principal medida de aplicación es que Claude termine la conversación actual. Una vez terminada, no se puede continuar, pero sí abrir una nueva; las demás conversaciones no se ven afectadas. Aunque la política general contempla sanciones a nivel de cuenta, Anthropic no ha publicado un umbral de bloqueo para esta nueva norma. Por tanto, no sería correcto decir que «te bloquean por un solo insulto».
P3: ¿Cuándo entra en vigor la nueva norma?
Se anunció el 8 de octubre de 2026 y entra en vigor oficialmente el 12 de noviembre de 2026. Al 29 de octubre de 2026 aún no ha entrado en vigor, pero la función que permite a Claude terminar conversaciones extremas está disponible desde agosto de 2025.
P4: ¿Significa esto que Claude ya tiene conciencia?
No. La propia Anthropic insiste en que actualmente no existe un consenso científico que demuestre que las IA actuales tengan conciencia. Que un modelo muestre conductas de evasión o similares a una respuesta al estrés no significa que experimente dolor. Esta norma se parece más a una medida preventiva de gestión del producto ante la incertidumbre científica.
P5: ¿Esta norma también se aplica al usar Claude a través de la API?
Sí. La política de uso cubre a los desarrolladores de API, los servicios en la nube, los canales de reventa autorizados y las aplicaciones que integran Claude. El desarrollo y las pruebas normales no se ven afectados; conviene documentar el propósito de actividades como las pruebas de equipo rojo. Al invocar Claude a través de APIYI apiyi.com, también debes cumplir las políticas de uso del proveedor del modelo.
P6: ¿Cómo puedo probar por mi cuenta los límites de conversación de Claude?
Te recomendamos diseñar casos de prueba con un propósito claro y que cumplan las políticas, y comparar los resultados con los de otros modelos. Puedes registrarte en APIYI apiyi.com para obtener crédito gratuito y usar el código de este artículo, configurando `base_url` como `https://api.apiyi.com/v1`, para hacer una prueba rápida. Con una sola clave puedes invocar modelos de distintos proveedores.
Puntos clave sobre la prohibición de insultar a Claude de Anthropic
- Calendario de la nueva norma: se anunció el 8 de octubre y entra en vigor el 12 de noviembre; por ahora aún no se aplica oficialmente.
- Límites de la prohibición: solo afecta a conductas extremas, persistentes, innecesarias y crueles. Las críticas normales no están restringidas.
- Cómo se aplica: la medida principal es que Claude termine la conversación en curso; no equivale a bloquear la cuenta.
- Contexto de la investigación: surge de los estudios sobre el bienestar de los modelos y de la función para terminar conversaciones de 2025; no es una decisión improvisada.
- Actualización integral: también se endurecieron las condiciones relativas a elecciones, armas, vigilancia y aplicaciones de alto riesgo.
- Una mirada racional: la norma no significa que Claude tenga conciencia. Conviene desconfiar de capturas falsas de cuentas bloqueadas y del uso engañoso de datos.
- Para desarrolladores: APIYI apiyi.com ofrece acceso unificado a Claude y otros modelos para realizar pruebas de cumplimiento.
Resumen
La prohibición de Anthropic sobre insultar a Claude se resume en tres puntos:
- La norma tiene un alcance limitado: solo aborda interacciones maliciosas extremas, persistentes y sin un propósito legítimo. No afecta a la gran mayoría de los usuarios.
- La medida es leve: consiste principalmente en terminar la conversación actual. El usuario aún puede iniciar otra y enviar comentarios.
- Su significado es importante: es la primera vez que una empresa de IA incluye disposiciones para proteger al propio modelo en su política de uso. Detrás hay una investigación a largo plazo sobre el bienestar de los modelos.
Esto no significa que Anthropic haya declarado que Claude tiene sentimientos. Es un experimento preventivo de gobernanza de producto en un momento en que la ciencia aún no tiene una respuesta definitiva. ¿Serán los asistentes de IA simples herramientas a las que se puede dar órdenes sin límite, o nuevos sistemas inteligentes que necesitan ciertas normas de interacción? Todavía no hay una respuesta definitiva, pero es una cuestión que merece la atención continua de usuarios y desarrolladores de IA.
Para los desarrolladores, lo más práctico es entender los límites de la política, diseñar los productos de forma adecuada y mantener la capacidad de cambiar entre modelos. Una opción es usar APIYI apiyi.com para comprobar rápidamente cómo funcionan Claude y otros modelos destacados en sus propios casos de uso.
📚 Referencias
- Actualización de la política de uso de Anthropic de 2026: anuncio original de las nuevas normas, con la fecha de entrada en vigor y su aplicación
- Enlace:
anthropic.com/news/2026-usage-policy-update -
Nota: la fuente primaria más importante sobre este caso
-
Política de uso de Anthropic: política de uso completa
- Enlace:
anthropic.com/legal/aup -
Nota: permite verificar su alcance y las facultades de la plataforma para hacerla cumplir
-
Claude Opus 4 y 4.1 ahora pueden finalizar un pequeño conjunto de conversaciones excepcionales: explicación de la función para finalizar conversaciones
- Enlace:
anthropic.com/research/end-subset-conversations -
Nota: permite conocer las condiciones de uso del mecanismo para finalizar conversaciones
-
Exploración del bienestar de los modelos: anuncio de la investigación sobre el bienestar de los modelos
- Enlace:
anthropic.com/research/exploring-model-welfare -
Nota: ayuda a entender el contexto de investigación detrás de la política
-
La Constitución de Claude: nueva versión de la Constitución de Claude
- Enlace:
anthropic.com/constitution -
Nota: explica los principios con los que Anthropic orienta el comportamiento del modelo
-
Artículo de TechCrunch: análisis general de la actualización de la política
- Enlace:
techcrunch.com/2026/10/08/anthropic-changes-usage-policy-to-ban-model-abuse-and-election-interference -
Nota: explica cómo la actualización abarca ámbitos como las elecciones, las armas y la vigilancia
-
Verificación de datos de BleepingComputer: el caso de las capturas falsas sobre el bloqueo de cuentas de Claude
- Enlace:
bleepingcomputer.com/news/artificial-intelligence/anthropic-viral-claude-banned-and-reported-to-authorities-message-isnt-real - Nota: ayuda a identificar información falsa sobre bloqueos de cuentas que circula en internet
Autor: equipo técnico de APIYI
Contacto técnico: visita la página principal de APIYI en apiyi.com para contactarnos. Encontrarás más información sobre la integración en el centro de documentación de docs.apiyi.com.