Nota del autor: cuando aparece un 429, no cambies de modelo de inmediato. En este artículo usamos un diagnóstico en 3 pasos para determinar si la limitación viene del proveedor upstream, de la puerta de enlace o del plan gratuito, y damos métodos de configuración para backoff exponencial, Retry-After y failover.
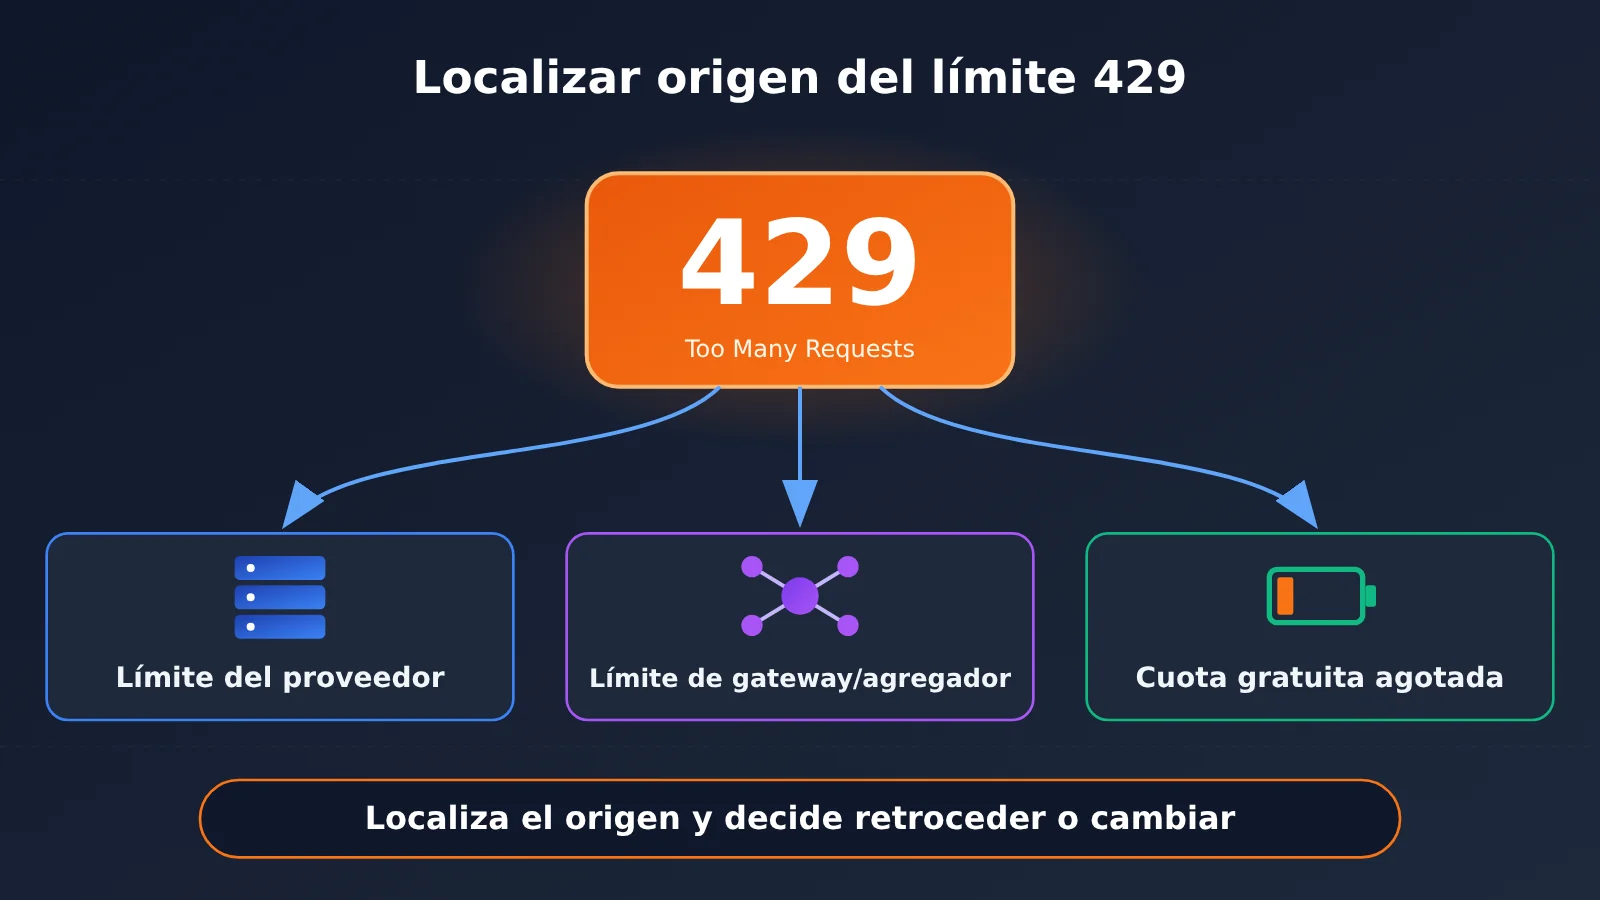
De madrugada, mientras se ejecutaba un job por lotes, los logs de repente se llenaron de 429 Too Many Requests. La primera reacción de mucha gente es “este modelo no sirve, hay que cambiar a otro”. Esa conclusión suele llegar demasiado pronto. Un 429 solo dice que “alguien te está limitando”; no dice quién ni en qué dimensión. La idea central de este artículo es primero localizar el origen de la limitación y después decidir si hacer backoff o cambiar de modelo.
Esto no es un artículo genérico sobre reintentos. Vamos a seguir el orden real de diagnóstico, desglosar el mensaje de error, las cabeceras de respuesta y las dimensiones de la limitación, y luego dar recomendaciones de configuración para los parámetros de backoff y la cadena de failover.
Valor principal: al terminar este artículo, podrás determinar en pocos minutos si un 429 proviene del proveedor upstream, de una puerta de enlace intermedia o de la cuota del plan gratuito, y configurar para tu aplicación una estrategia de tolerancia a fallos que “espere cuando toca esperar y cambie cuando toca cambiar”.
Puntos clave para interpretar un 429 por límite de tasa
429 es el código de estado “demasiadas peticiones” del estándar HTTP. En el contexto de las API de Modelos de Lenguaje Grande, puede devolverlo cualquiera de las capas de la cadena de llamadas. La siguiente tabla resume las tres fuentes más habituales y la forma correcta de tratarlas en cada caso.
| Origen del límite | Características típicas | ¿Conviene cambiar de modelo? | Tratamiento recomendado |
|---|---|---|---|
| Proveedor del modelo upstream | El cuerpo del error incluye el tipo y el texto propios del proveedor; las cabeceras de respuesta traen sus campos de límite de tasa | Normalmente no | Hacer backoff según Retry-After y, si hace falta, bajar la concurrencia o solicitar más cuota |
| Gateway intermedio/plataforma agregadora | El mensaje de error proviene del gateway; indica límites de velocidad a nivel de cuenta o de grupo | No | Revisar la cuota y la configuración de concurrencia en el gateway, o cambiar de grupo en el gateway |
| Plan gratuito/cuota de prueba | Menciona cupo gratuito, número de peticiones diarias o capacidad insuficiente | Depende | Pasar a un plan de pago o cambiar a un modelo similar con capacidad disponible |
Por qué un 429 no significa que el modelo se haya caído
Cuando el modelo en sí no está disponible, la señal más habitual son los errores 5xx. Por ejemplo, una sobrecarga de Anthropic devuelve 529 overloaded_error, y los fallos de gateway o de balanceador de carga suelen aparecer como 502 o 503. Estos códigos indican que el servidor no puede atender temporalmente la demanda, y no tienen nada que ver con que “tu cuenta se haya pasado de la cuota”.
El 429, en cambio, tiene una atribución clara: la regla de límite de tasa apunta a ti, ya sea a tu clave API, a tu organización, al plan gratuito en el que estás o a la velocidad que te asignó el gateway. Cambiar de modelo a veces sirve para esquivarlo, pero si el límite viene de una cuota a nivel de cuenta del gateway, cambiar de modelo no te salvará: te vas a estrellar igual. Si el límite viene del tope de tokens por minuto del proveedor upstream, con esperar unos segundos se recupera; cambiar de modelo solo añade incertidumbre sobre la calidad de la salida.
Las guías de solución de problemas de terceros para Claude Code también lo confirman: cuando Claude Code recibe un 429, muestra Request rejected (429) y añade el texto literal del servidor. Ese texto es justo el que te dice si el límite viene de Anthropic, del gateway o del plan gratuito. Por eso, el primer paso para diagnosticar siempre es leer el mensaje de error completo, no quedarse solo con el código de estado.
Diferencias entre 429 y los códigos de estado adyacentes
Para no mezclar errores distintos, la siguiente tabla muestra varios códigos de estado que en la invocación de Modelos de Lenguaje Grande se confunden fácilmente con 429.
| Código de estado | Significado | Responsable | ¿Apto para reintentar? | ¿Apto para conmutación por error? |
|---|---|---|---|---|
| 429 | Demasiadas solicitudes, se activó el límite de velocidad o de cuota | Cuota del solicitante | Sí, con retroceso | Conmutar tras retroceso sin efecto |
| 529 | Sobrecarga del upstream (específico de Anthropic) | Capacidad del servidor | Sí, retroceso breve | Sí |
| 503 | Servicio temporalmente no disponible | Servidor o puerta de enlace | Sí | Sí |
| 500/502 | Error interno o error de puerta de enlace | Servidor o puerta de enlace | Reintentos limitados | Sí |
| 400/401/403 | Problemas de parámetros, autenticación o permisos | Configuración del solicitante | No | No, hay que corregir la configuración |
Hay un detalle en esta tabla que se suele pasar por alto: según pruebas de terceros, el mecanismo fallbackModel de Claude Code solo se activa cuando hay sobrecarga 529, e intenta como máximo 3 modelos de respaldo, no cuando se produce un 429. Esto indica que los propios diseñadores de la herramienta consideran que la primera reacción ante un 429 debe ser el retroceso, no cambiar de modelo.
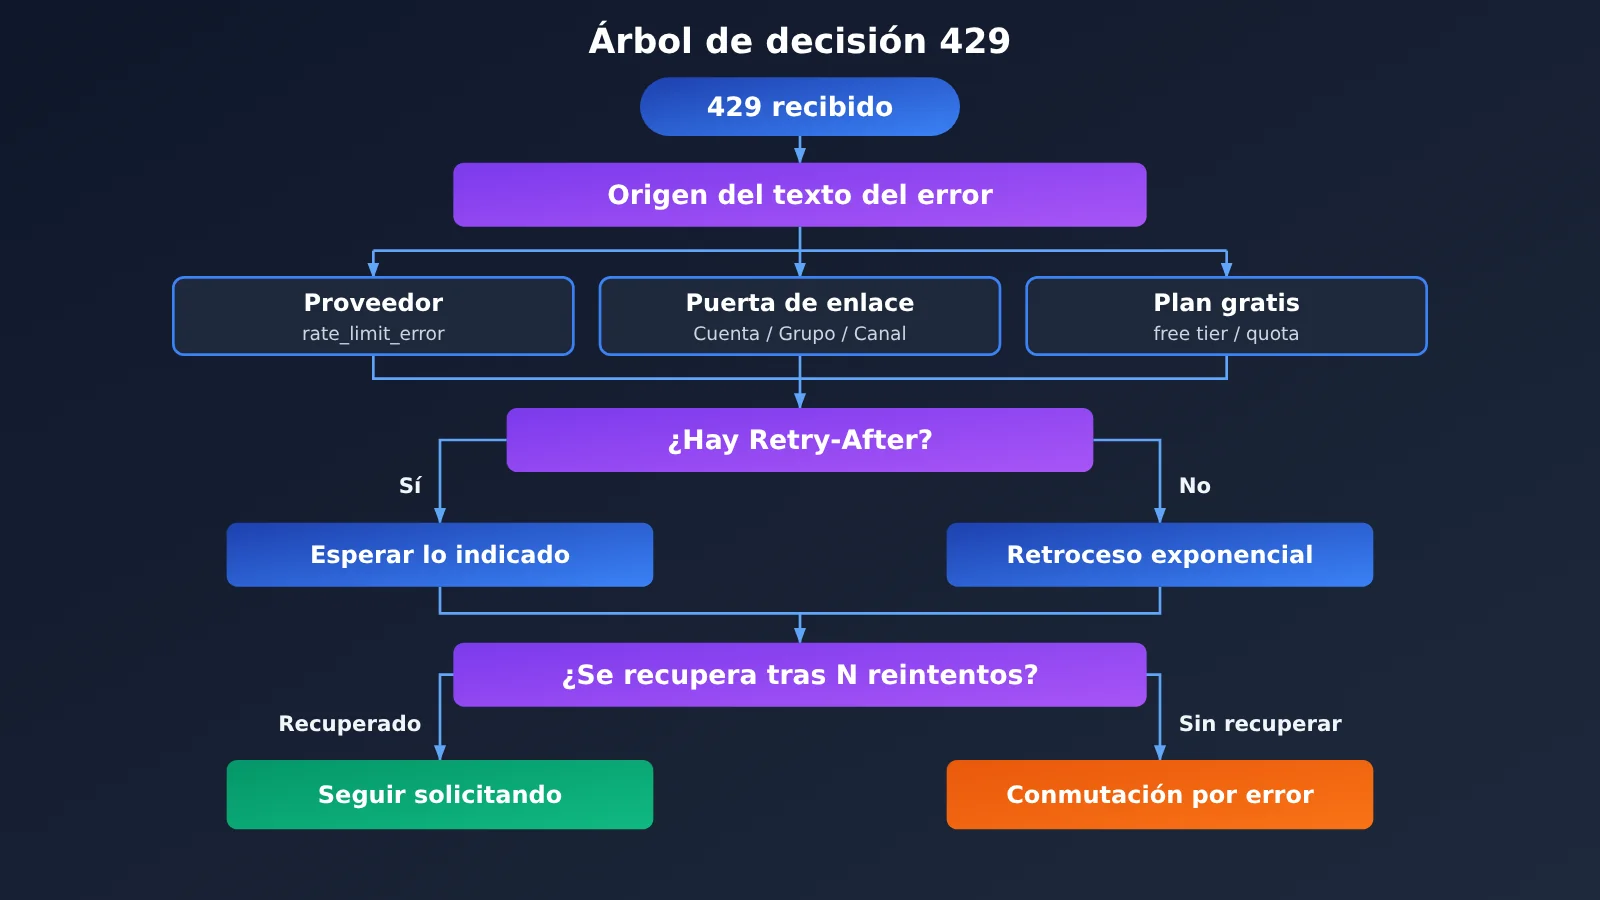
Cómo saber quién origina el 429: diagnóstico en 3 pasos
A continuación tienes un proceso de diagnóstico de errores 429 que puedes seguir tal cual. Son tres pasos ordenados de menor a mayor coste y, en la mayoría de los casos, con el primero ya se localiza el problema.
Paso 1: lee el cuerpo completo del error 429
No te limites a registrar el código de estado en los logs: guarda el cuerpo de la respuesta tal cual. Los 429 que devuelve cada capa se distinguen claramente por su redacción, y esa es la pista más directa.
- Devuelto por el proveedor upstream: el cuerpo del error suele incluir el campo de tipo de error del proveedor. Por ejemplo, Anthropic devuelve el tipo
rate_limit_error, y las interfaces al estilo OpenAI devuelven un código comorate_limit_exceeded, indicando además si se superó el límite de peticiones o el de tokens. - Devuelto por la pasarela: la redacción suele mencionar conceptos propios de la pasarela, como «cuenta», «grupo», «token» o «canal», o bien indica explícitamente el nombre de la pasarela.
- Devuelto por el plan gratuito: aparecen términos como «free tier», «quota», «daily limit» o «capacity». En pruebas de terceros con acceso gratuito a determinados modelos es muy habitual encontrarse con este tipo de 429 por capacidad.
Si llamas a través de un servicio proxy o de una plataforma agregadora, presta especial atención a si la pasarela reenvía el error original del upstream. Si lo reenvía, significa que es el upstream quien te está limitando; si en cambio muestra un mensaje personalizado que no es un reenvío, entonces es la pasarela la que te está limitando.
Paso 2: Revisar los encabezados de respuesta 429
Los encabezados de respuesta son la segunda cadena de evidencia. Los principales proveedores devuelven en los encabezados el cupo restante y el tiempo de reinicio, y la pasarela (gateway) también puede incluir sus propios campos.
| Encabezado de respuesta | Origen habitual | Significado | Utilidad para el diagnóstico |
|---|---|---|---|
Retry-After |
Estándar HTTP, común a varios | Segundos de espera recomendados | Priorizarlo al aplicar retroceso exponencial |
x-ratelimit-remaining-requests |
Interfaces estilo OpenAI | Solicitudes restantes en la ventana actual | Determinar si es un límite de RPM |
x-ratelimit-remaining-tokens |
Interfaces estilo OpenAI | Tokens restantes en la ventana actual | Determinar si es un límite de TPM |
anthropic-ratelimit-requests-remaining |
Anthropic | Solicitudes restantes | Confirmar que el límite proviene de Anthropic |
anthropic-ratelimit-input-tokens-remaining |
Anthropic | Tokens de entrada restantes | Determinar si es un límite de tokens de entrada |
La regla para decidirlo es sencilla: si aparecen encabezados de límite con prefijo del proveedor y el valor restante es 0, básicamente se puede confirmar que el proveedor upstream te está limitando; si no hay ningún encabezado de límite del proveedor y solo hay campos personalizados de la pasarela o, directamente, nada, entonces la probabilidad de que el problema esté en la capa de la pasarela es mayor. Cabe señalar que, en los últimos años, algunos proveedores han pasado a mostrar los límites concretos solo en la consola, por lo que la información de los encabezados puede estar incompleta; en ese caso, hay que volver a la redacción del error del paso 1 y a la comparación de dimensiones del paso 3.
Paso 3: Contrastar las dimensiones de la limitación de velocidad
Una vez que sabes quién te está limitando, aún queda por aclarar qué es exactamente lo que se limita. Las reglas de limitación no son uniformes entre proveedores: un análisis comparativo de terceros sobre cinco proveedores muestra que Anthropic limita principalmente por número de tokens por minuto, y los tokens que aciertan en la caché no cuentan para el límite; DeepSeek limita sobre todo el número de concurrencias; en OpenAI y Google, en cambio, las cuotas concretas se consultan más que nada en la consola.
Esto influye directamente en la estrategia de configuración. Las correspondencias habituales son las siguientes:
- RPM (peticiones por minuto) excedido: agrupa varias peticiones pequeñas en una petición por lotes, o añade un token bucket en el cliente para enviarlas a ritmo constante.
- TPM (tokens por minuto) excedido: acorta el contexto, activa la caché de indicaciones y reparte las tareas de documentos largos en distintas ventanas de tiempo.
- Número de concurrencias excedido: reduce la cantidad de workers y usa una cola para controlar las peticiones en vuelo; el simple backoff tiene un efecto limitado.
- Cuota diaria o crédito gratuito agotado: el backoff no sirve de nada; solo queda esperar el reinicio, subir de plan o cambiar a otro canal.
El cuarto caso es el único 429 en el que el backoff está condenado a no funcionar, y también el que más conviene identificar cuanto antes para pasar directamente al failover.
Cómo configurar la estrategia de backoff para un 429
Una vez confirmado que el 429 corresponde a un límite de tasa recuperable, pasamos a la fase de retroceso. El objetivo del backoff no es «reintentar lo antes posible», sino «recuperarse lo antes posible sin agravar la congestión».
Backoff exponencial con jitter aleatorio
La solución más habitual es el backoff exponencial (Exponential Backoff) combinado con jitter aleatorio. El tiempo de espera del n-ésimo reintento es aproximadamente «retardo base × 2 elevado a n», y sobre eso se añade una cantidad aleatoria, con un límite superior. La función del jitter aleatorio es dispersar los momentos de reintento de los distintos clientes, evitando que se concentren en el mismo segundo y formen una «tormenta de reintentos».
Si la respuesta incluye Retry-After, su prioridad debe ser mayor que el tiempo de retroceso que calcules por tu cuenta. El servidor sabe mejor que tú cuándo se restablece la ventana; esperar según su recomendación suele ser la forma más rápida de recuperarse.
Valores recomendados para los parámetros de backoff
La siguiente tabla ofrece un conjunto de parámetros iniciales válidos para la mayoría de escenarios de conversación y procesamiento por lotes; en la práctica se pueden ajustar según la tolerancia a la latencia de cada negocio.
| Parámetro | Valor inicial recomendado | Descripción |
|---|---|---|
| Retardo base | 1 segundo | Tiempo de espera antes del primer reintento |
| Multiplicador de retroceso | 2 | El tiempo de espera se duplica en cada reintento |
| Espera máxima por intento | 30-60 segundos | Evita que el tiempo de espera crezca sin límite |
| Número máximo de reintentos | 3-5 veces | Al superarlo se pasa a failover o se devuelve error |
| Jitter aleatorio | Aleatorio entre 0 y 100 % del tiempo de espera | Se recomienda el «full jitter», que dispersa los reintentos |
| Retry-After | Prioritario si existe | Sustituye al tiempo de retroceso calculado por ti |
Hay dos detalles de configuración que suelen pasarse por alto. Primero, en escenarios interactivos (por ejemplo, una interfaz de chat) el tiempo total de espera no debería ser demasiado largo; conviene fijar un presupuesto de timeout global y, al superarlo, cambiar directamente de recurso o avisar al usuario. Segundo, no apliques reintentos con backoff a errores de configuración como 400, 401 o 403: por mucho que esperes no se van a arreglar solos, solo consumirás tiempo y cuota para nada.
Si usas el SDK oficial, muchos ya incorporan reintentos automáticos para 429 y 5xx, normalmente controlados mediante parámetros del tipo max_retries. Antes de envolverlo con tu propia capa de reintentos, revisa primero el comportamiento por defecto del SDK, para evitar que dos capas de reintentos se acumulen y multipliquen el número real de intentos.
Cómo configurar el failover ante un 429
El backoff consiste en «esperar en el mismo sitio»; el failover (conmutación por error) es «tomar otro camino». No son alternativas excluyentes, sino una cuestión de orden: primero el backoff y, si no funciona, el cambio.
Cuándo disparar el failover
Se recomienda activar la conmutación cuando se cumpla cualquiera de estas condiciones, en lugar de cambiar en cuanto aparece el primer 429:
- Se alcanza el número máximo de reintentos y el 429 sigue llegando;
- El mensaje de error apunta claramente a una cuota diaria, al agotamiento del crédito gratuito o a «capacidad insuficiente»;
- El tiempo de espera indicado por
Retry-Aftersupera el límite que el negocio puede asumir; - El mismo canal falla varias veces seguidas en poco tiempo y se alcanza el umbral del cortocircuito.
La recomendación de terceros para tratar los 429 frecuentes de un modelo popular en OpenRouter sigue la misma lógica: primero backoff y luego failover a otro modelo dentro del mismo endpoint. Con este orden se conserva la calidad de salida del modelo original y se garantiza la continuidad del servicio.
Tres diseños para la cadena de conmutación
Las «rutas de respaldo» del failover tienen distintos niveles, y su coste de conmutación va de menor a mayor:
- Mismo modelo, otro canal: el mismo modelo con otra clave API, otro grupo u otro proveedor. Es la opción con mayor consistencia de salida y la primera a considerar.
- Mismo fabricante, otro nivel: por ejemplo, bajar de un modelo insignia a un modelo ligero de la misma familia; la capacidad baja un poco, pero el estilo es parecido.
- Otro fabricante, otro modelo: cambiar a un modelo equivalente de otra casa; es la opción con mayor disponibilidad, aunque hay que validar antes el efecto de las indicaciones y el formato de salida.
Por encima de esto conviene añadir una capa de circuit breaker: cuando un canal acumula fallos hasta el umbral, se salta directamente durante un periodo de enfriamiento; al terminar, se envían unas pocas peticiones de sondeo y, si se ha recuperado, se va aumentando el tráfico poco a poco. Así se evita que cada petición choque primero contra el mismo muro antes de cambiar, lo que reduce de forma notable la latencia global.
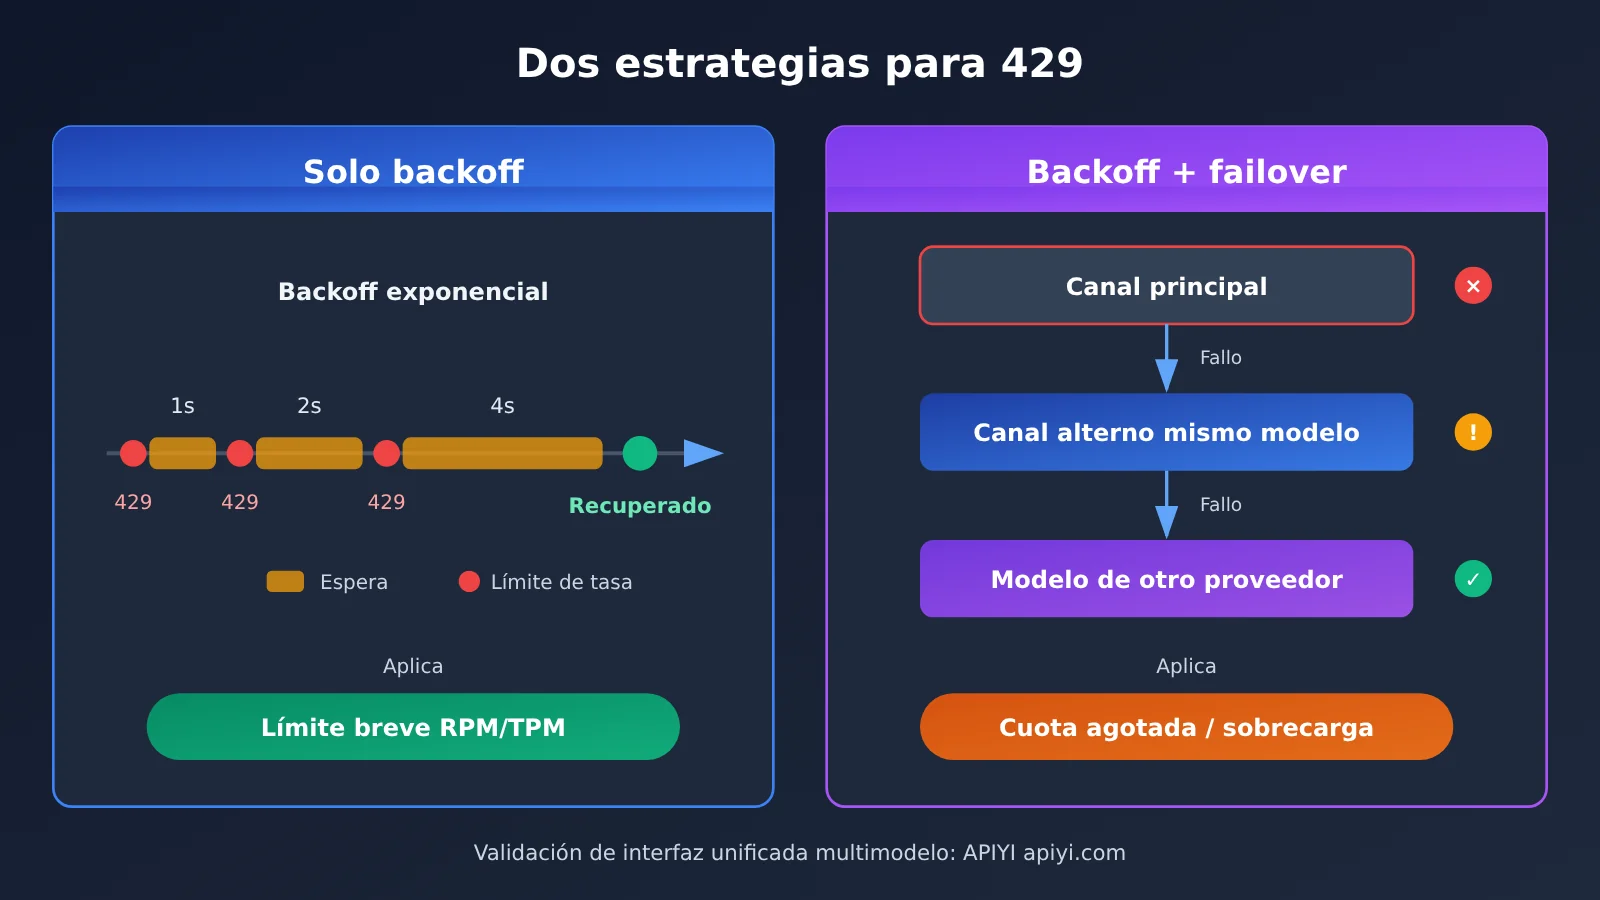
Las dos estrategias que compara la imagen se pueden validar en un proyecto real a través de una misma interfaz unificada. En plataformas como APIYI, compatibles con los formatos de interfaz de OpenAI y Anthropic, el mismo código solo necesita cambiar el parámetro model para pasar a un modelo de respaldo, lo que resulta mucho más cómodo que mantener un SDK distinto para cada fabricante.
Manejo rápido de la limitación de tasa 429
A continuación organizamos lo anterior en una lista de configuración que puedes aplicar directamente. No hay código en todo el texto; puedes usarla como checklist para revisiones de código o para la configuración de operaciones.
Checklist de 5 puntos de configuración
- Logs: registra el cuerpo completo de la respuesta y las cabeceras; como mínimo, el código de estado, el tipo de error, el mensaje de error,
Retry-Aftery todos los camposratelimit. - Clasificación: en el cliente, divide los errores en tres categorías: «se puede reintentar con retroceso» (429 de tasa, 529, 503), «requiere cambiar» (cuota agotada, fallos persistentes) y «no reintentable» (400, 401, 403).
- Retroceso: configura retroceso exponencial con jitter completo según la tabla de parámetros anterior, dando prioridad a
Retry-After, y define un número máximo de reintentos y un presupuesto total de tiempo de espera. - Cadena de conmutación: configura la lista de respaldo en el orden «mismo modelo, otro canal → mismo proveedor, otro nivel → otro proveedor, otro modelo» y valida de antemano el efecto de las indicaciones en cada modelo de respaldo.
- Cortacircuitos y alertas: define un umbral de fallos y un tiempo de enfriamiento para cada canal; además, alerta sobre la proporción de 429. Si se mantiene alta, significa que hay que solicitar un aumento de cuota o ajustar la concurrencia.
Ejemplo de cadena de modelos de respaldo
La siguiente tabla muestra un ejemplo habitual de cadena de conmutación de tres niveles. Los nombres concretos de los modelos deben tomarse de la lista de modelos de la plataforma; los precios implicados deben consultarse en la página de precios. En este artículo no se incluyen precios unitarios.
| Nivel | Criterio de elección | Formato de API | Plataformas disponibles | Criterio de precio |
|---|---|---|---|---|
| Principal | Modelo insignia con el mejor resultado para el negocio | Formato OpenAI o Anthropic | APIYI apiyi.com, API oficial | Según docs.apiyi.com/models |
| Respaldo de primer nivel | Otro canal o grupo del mismo modelo | Igual que el principal | APIYI apiyi.com, API oficial | Según docs.apiyi.com/models |
| Respaldo de segundo nivel | Modelo ligero del mismo proveedor o modelo equivalente de otro proveedor | Formato compatible con OpenAI | APIYI apiyi.com y otras plataformas agregadoras | Según docs.apiyi.com/models |
En cuanto a la integración, si usas los SDK oficiales de OpenAI o Anthropic, por lo general solo tienes que cambiar base_url por la dirección que proporciona la plataforma y api_key por la clave de la plataforma. Para las direcciones de API concretas y las instrucciones de invocación de cada modelo, te recomendamos guiarte por el centro de documentación de APIYI, docs.apiyi.com, y no copiar direcciones de internet sin verificar.
🚀 Inicio rápido: al construir la cadena de tolerancia a errores 429, te sugerimos empezar usando APIYI apiyi.com para integrar con el mismo código el modelo principal y los de respaldo. La plataforma ofrece llamadas API a los principales modelos de este artículo, es compatible con formatos de API de OpenAI y Anthropic, y para cambiar de modelo solo hay que modificar el parámetro
model. La documentación de integración está en docs.apiyi.com. Los precios de entrada y salida de cada modelo, los precios de caché y los criterios de facturación están sujetos a los datos reales de la página de precios docs.apiyi.com/models.
Preguntas frecuentes (FAQ)
P1: ¿Qué es el límite de tasa 429?
429 es el código de estado Too Many Requests del estándar HTTP, e indica que quien llama ha superado en una ventana de tiempo determinada el número de peticiones, tokens, concurrencia o cuota total permitidos. Lo que dice es «te han limitado», no que el modelo esté fallando.
P2: ¿En qué se diferencia 429 de 529 y 503?
El 429 apunta a un problema de cuota del lado de quien llama, la responsabilidad es «estás usando demasiado»; el 529 es el error de sobrecarga de Anthropic y el 503 significa servicio temporalmente no disponible, en ambos la responsabilidad está en la capacidad del servidor. En el primer caso conviene priorizar el backoff y ajustar el consumo; en los otros dos es mejor un backoff breve y pasar directamente al failover.
P3: ¿Cuál es la forma más rápida de saber si un 429 viene del proveedor upstream o de la pasarela?
Fíjate primero en la redacción del cuerpo del error: los que incluyen el tipo de error del proveedor suelen venir del upstream, y los que mencionan conceptos como cuenta, grupo o canal suelen venir de la pasarela. Luego revisa las cabeceras de respuesta: si aparece un campo `ratelimit` con prefijo del proveedor y el valor restante es 0, básicamente puedes confirmar que es el upstream quien está limitando.
P4: ¿Por qué después de hacer backoff muchas veces el 429 no se recupera?
La causa más común es haber diagnosticado mal la dimensión del límite. Si lo que se agotó es la cuota diaria o el crédito gratuito, el backoff está condenado a no servir de nada; si lo que se superó es el número de conexiones concurrentes y el cliente sigue enviando a alta concurrencia, el backoff solo alivia. En ese momento hay que reducir la concurrencia o pasar directamente al failover.
P5: ¿Cómo montar rápido una cadena de failover multimodelo?
Recomiendo validarlo con una plataforma que ofrezca una interfaz unificada para varios modelos:
1. Regístrate en APIYI apiyi.com y obtén tu API Key;
2. Configura `base_url` según la documentación de docs.apiyi.com y conéctate usando el formato de OpenAI o de Anthropic;
3. Configura en el cliente la lista de modelos principal y de respaldo, y cambia entre ellos modificando el parámetro `model`.
Así el modelo principal y el de respaldo comparten un mismo código y el coste de probar la cadena de conmutación baja muchísimo.
Q6: ¿Puede el failover descontrolar los costes?
Es posible. El precio unitario, la longitud de contexto y la estrategia de caché del modelo de respaldo pueden ser distintos de los del modelo principal, y cambiar con frecuencia altera la estructura de la factura. Conviene verificar de antemano el precio de cada modelo de respaldo, tomar siempre como referencia los datos reales de la página de precios de APIYI en docs.apiyi.com/models, y configurar alertas sobre la proporción de conmutaciones.
P7: ¿Qué limitaciones conocidas tienen las soluciones para el 429?
El backoff añade latencia a las peticiones, así que no encaja en escenarios con requisitos de tiempo real muy estrictos; cambiar entre proveedores puede introducir diferencias de estilo y formato en la salida, por lo que hay que hacer pruebas de regresión de antemano; algunos proveedores solo muestran los límites en la consola y la información de las cabeceras de respuesta es incompleta, de modo que al diagnosticar solo puedes apoyarte en la redacción del error y en los datos de monitorización.
Puntos clave del manejo de límites de tasa 429
- Un 429 solo indica que te han limitado: no dice quién te limitó ni qué limitó, así que no equivale directamente a un fallo del modelo.
- Primero lee el mensaje de error literal: la redacción del cuerpo del error es la pista más rápida para identificar si el límite viene del proveedor upstream, de la pasarela o del plan gratuito.
- Después revisa las cabeceras de respuesta: los campos
ratelimitcon prefijo del proveedor yRetry-Afterson la segunda cadena de evidencia. - Trata cada dimensión según corresponda: para RPM, reparte las peticiones de forma uniforme; para TPM, reduce la ventana de contexto; para concurrencia, controla los workers; si se agotó la cuota, cambia directamente.
- Primero el backoff, después la conmutación: backoff exponencial con jitter completo, prioridad al
Retry-Aftery un límite de reintentos. - Diseña la cadena de conmutación por capas: primero cambia de canal con el mismo modelo y, como respaldo, cambia de modelo entre proveedores, apoyándote en un circuit breaker.
- Usa una interfaz unificada para reducir costes: con la interfaz de APIYI compatible con los formatos de OpenAI y Anthropic, puedes gestionar los modelos principal y de respaldo con un solo conjunto de código.
Resumen
Cuando aparece un 429, el orden correcto es «localizar el origen → determinar la dimensión → backoff → conmutar», y no cambiar de modelo a la primera:
- Localizar el origen: la redacción del cuerpo del error junto con las cabeceras de respuesta permite distinguir el proveedor upstream, la pasarela y el plan gratuito.
- Determinar la dimensión: aclarar si es el número de peticiones, la cantidad de tokens, la concurrencia o la cuota total decide si el backoff será efectivo.
- Configurar la tolerancia a fallos: backoff exponencial con jitter como primera línea de defensa, y conmutación por capas con circuit breaker como segunda.
Si fijas este flujo en los logs, la clasificación de errores y la configuración del cliente, el 429 pasa de ser una «alarma a medianoche» a un evento rutinario, predecible y autorrecuperable.
Recomendamos verificar rápidamente el efecto de conmutación entre modelo principal y de respaldo a través de APIYI apiyi.com. Las instrucciones de integración están en docs.apiyi.com; los precios y criterios de facturación de los modelos involucrados se rigen por docs.apiyi.com/models.
📚 Referencias
- Rate Limit Reached in Claude Code: What Each 429 Message Means: Interpretación del significado de cada mensaje de error 429 en Claude Code
- Enlace:
ofox.ai/blog -
Descripción: Explica cómo distinguir, a partir del texto literal que devuelve el servidor, entre la limitación de Anthropic, la de la pasarela y la del plan gratuito
-
Claude Code fallbackModel: 3-Tier Failover Setup: Configuración de modelos de respaldo en Claude Code
- Enlace:
ofox.ai/blog -
Descripción: Señala que fallbackModel se activa ante sobrecargas 529, con un máximo de 3 modelos, y no ante errores 429
-
LLM API Rate Limits Compared: Comparación de las reglas de limitación de velocidad de 5 proveedores de Modelos de Lenguaje Grande
- Enlace:
ofox.ai/blog -
Descripción: Contrasta distintos criterios de limitación: por token, por concurrencia y los que solo se muestran en consola
-
Centro de documentación y página de precios de APIYI: Instrucciones de integración y facturación de modelos
- Enlace:
docs.apiyi.comydocs.apiyi.com/models - Descripción: El formato de la interfaz, la configuración de base_url y el precio real de cada modelo se rigen por lo indicado aquí
Autor: Equipo técnico de APIYI
Intercambio técnico: Te invitamos a contactarnos desde la página principal de APIYI apiyi.com para conversar sobre prácticas de limitación de velocidad y tolerancia a fallos; para más material de integración, visita el centro de documentación docs.apiyi.com