Nota del autor: Google AI Studio anunció la descontinuación de Gemini 2.5 Pro y 2.5 Flash; a partir del 1 de diciembre, las solicitudes a la API correspondientes se enrutarán automáticamente a otros modelos. Este artículo presenta un plan práctico de 6 pasos para que las aplicaciones en producción completen la migración antes de la fecha límite.
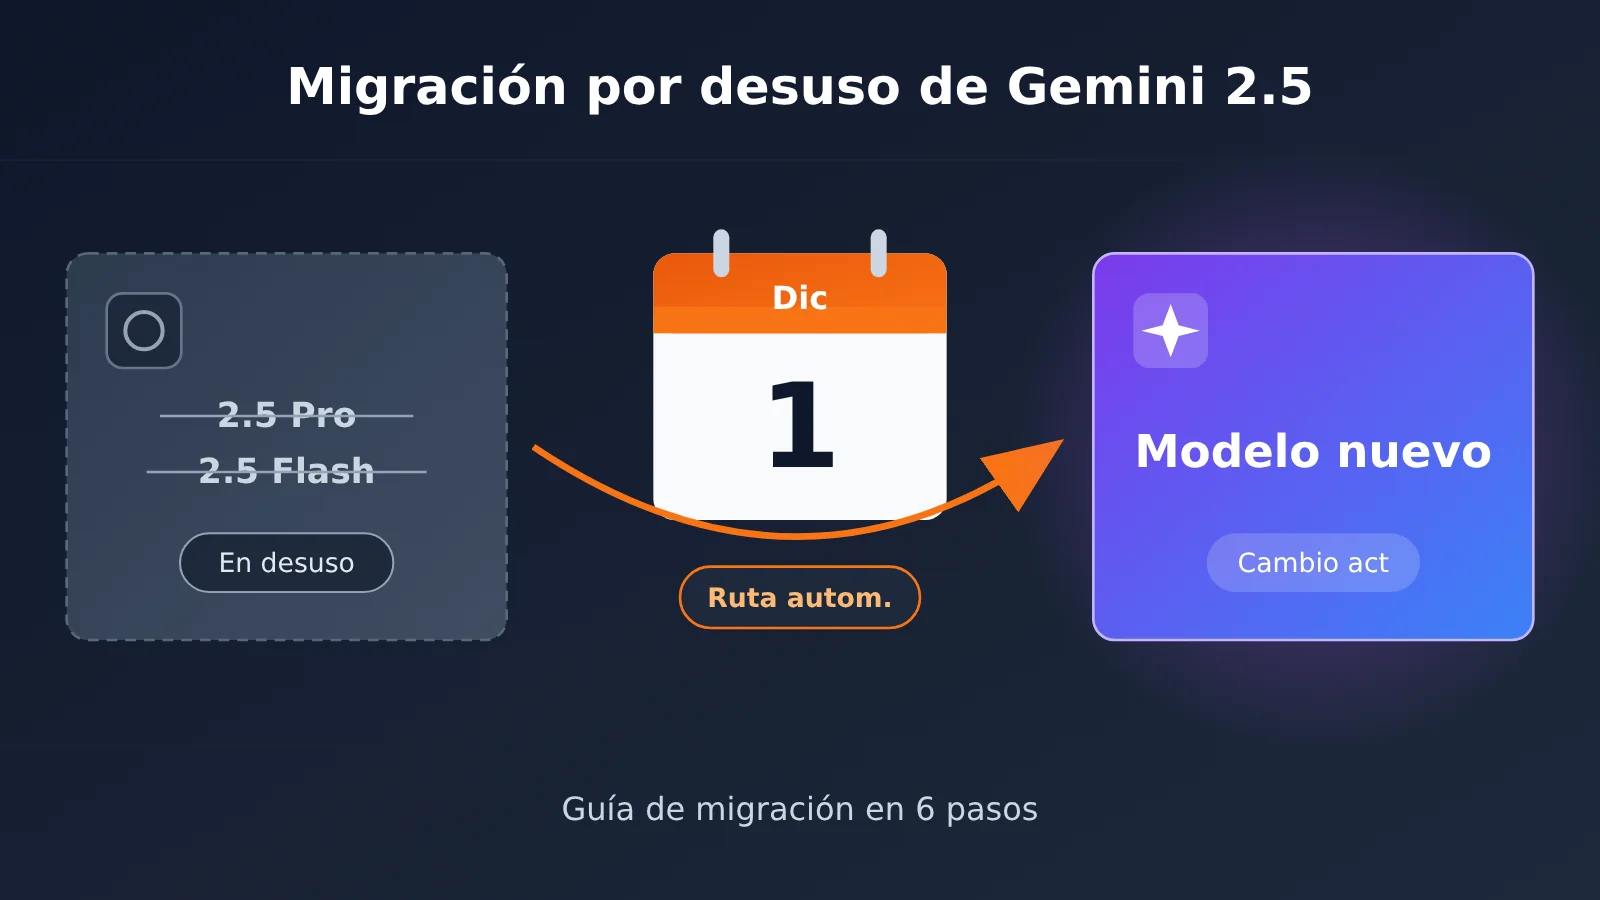
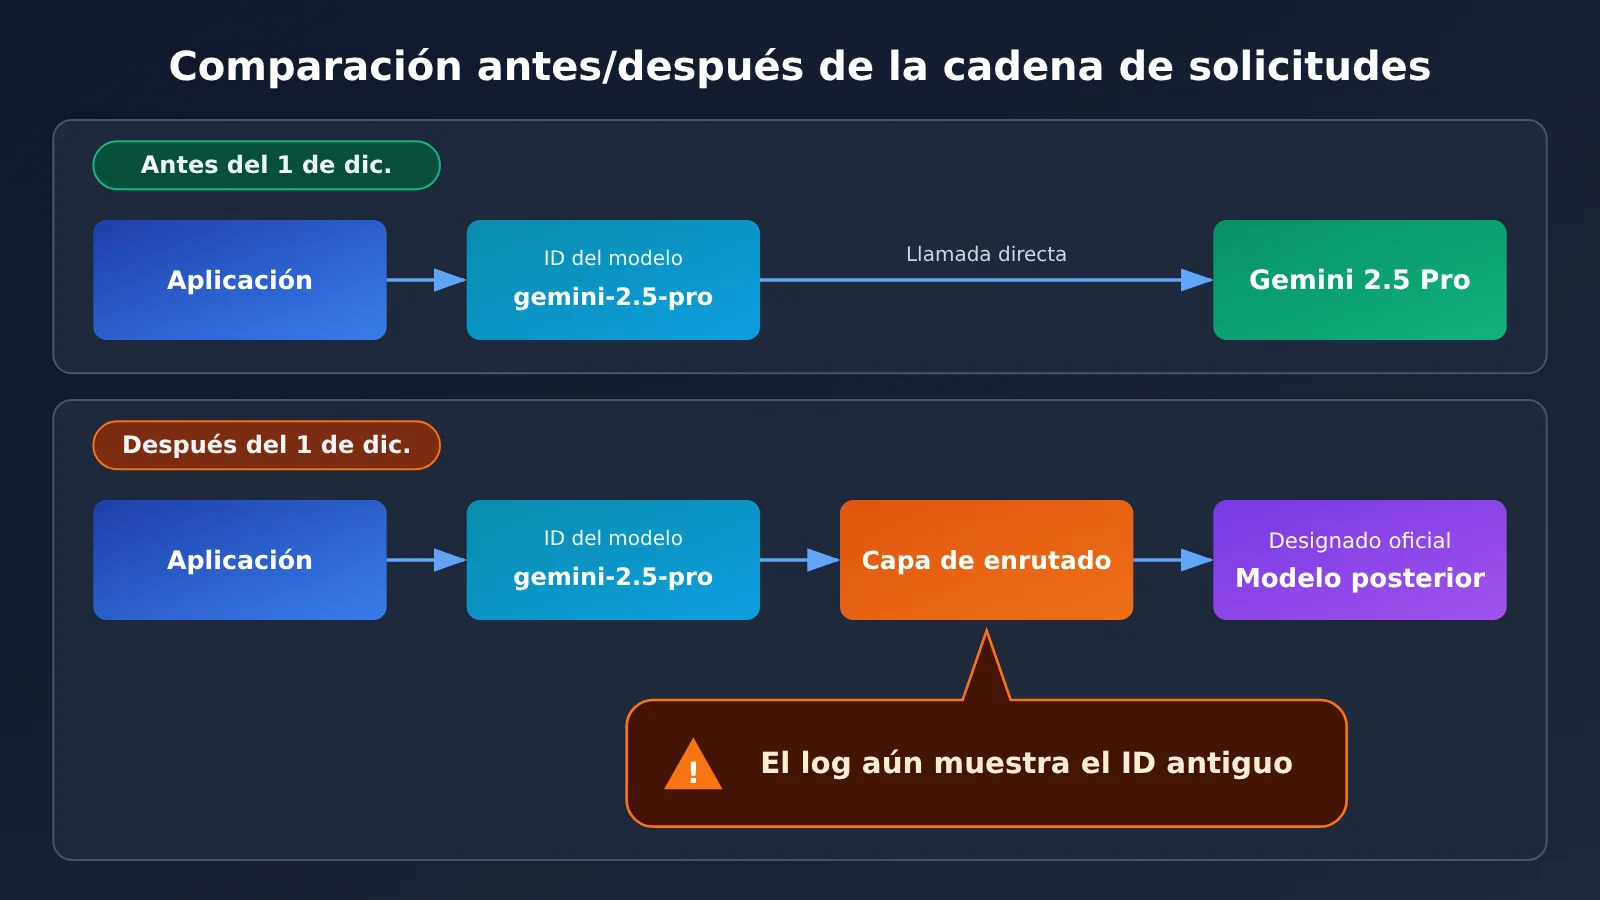
Si tu servicio en producción todavía llama a Gemini 2.5 Pro o Gemini 2.5 Flash, solo queda menos de un mes para el enrutamiento automático del 1 de diciembre. Según la nota de descontinuación publicada por Google AI Studio, estos dos modelos entran en el proceso de descontinuación y, en esa fecha, las solicitudes a la API enviadas a los ID de los modelos antiguos se reenviarán automáticamente a los modelos de reemplazo designados oficialmente.
Esto no es una buena noticia del tipo “no hay que hacer nada”. El enrutamiento automático garantiza que las solicitudes no fallen de inmediato, pero el comportamiento del modelo, el estilo de salida, la latencia y los criterios de facturación pueden cambiar. Para una aplicación en producción que depende de un formato de salida fijo, esto equivale a una “actualización silenciosa” que no pasó por pruebas.
Valor clave: al terminar este artículo, contarás con un proceso de migración en 6 pasos para reemplazar Gemini 2.5 Pro/Flash, ejecutar pruebas de regresión y hacer un despliegue gradual antes del 1 de diciembre, reduciendo al mínimo la incertidumbre que genera el enrutamiento automático.
Puntos clave de la deprecación de Gemini 2.5 Pro/Flash y del enrutamiento automático
Antes de ponerse a migrar, conviene tener claros los hechos clave de esta deprecación de Gemini 2.5 Pro/Flash. En la siguiente tabla solo se incluye la información que puede confirmarse con las referencias, junto con el impacto técnico que se deriva de ella.
| Punto clave | Descripción | Impacto en las aplicaciones en producción |
|---|---|---|
| Objeto de la deprecación | Gemini 2.5 Pro y Gemini 2.5 Flash en Google AI Studio | Todos los servicios que tienen codificados estos dos ID de modelo están dentro del alcance |
| Fecha clave | Entra en vigor el 1 de diciembre | La ventana para pruebas y despliegue gradual es limitada; hay que planificar el cronograma partiendo de la fecha límite |
| Forma de tratamiento | Las solicitudes de API se enrutan automáticamente al modelo sucesor designado oficialmente | La API no devolverá un error de inmediato, pero el modelo que realmente se ejecuta cambia |
| Riesgo principal | “Cambios silenciosos” en el estilo de salida, el formato, la latencia y los costos | El parseo posterior, las métricas de evaluación y el presupuesto de costos podrían desviarse |
| Estrategia recomendada | Cambiar de forma explícita y proactiva antes de la fecha límite y completar las pruebas de regresión | Convertir el “cambio pasivo de modelo” en una “actualización controlable” |
Por qué no conviene confiarse con el enrutamiento automático de Gemini 2.5
Muchos equipos, al ver “enrutamiento automático”, lo primero que sienten es alivio: como las solicitudes no fallarán, basta con esperar la transición natural del 1 de diciembre. El problema es que la estabilidad de una aplicación con Modelos de Lenguaje Grande nunca depende solo de que la API devuelva 200. Tus indicaciones se ajustaron al comportamiento de Gemini 2.5 Pro o Flash; al cambiar de modelo, las mismas indicaciones pueden producir contenido más largo o más corto, y el orden y el formato de los campos JSON también pueden variar ligeramente.
El riesgo más oculto está en la observabilidad. Cuando ocurre el enrutamiento automático, tus registros siguen mostrando el ID del modelo antiguo, pero el que ya está procesando la solicitud es otro modelo. Si aparecen quejas de calidad, al investigar es fácil que los registros te lleven por el camino equivocado y perder mucho tiempo localizando el problema. El sentido de una migración proactiva es precisamente que “el modelo escrito en los registros” y “el modelo que se ejecuta realmente” coincidan.
Cómo confirmar los modelos de destino concretos del enrutamiento automático
Las referencias confirman el mecanismo de “enrutamiento automático”, pero conviene consultar el anuncio oficial de deprecación de Google y el registro de cambios de Gemini API para saber a qué modelo se enruta exactamente, si también afecta al canal de Vertex AI y si los ID de modelo antiguos conservan algún periodo de retención de alias. Este artículo no especula sobre esos detalles; en su lugar, ofrece un método de migración que sirve sin importar cuál sea el modelo de destino.
Evaluación del impacto de la descontinuación de Gemini 2.5 Pro/Flash
No todos los tipos de aplicación se ven igual de afectados por el enrutamiento automático de Gemini 2.5. Conviene hacer primero una clasificación por impacto para decidir la prioridad de la migración y la profundidad de las pruebas.
| Tipo de aplicación | Uso típico | Grado de afectación por el enrutamiento automático | Prioridad de migración |
|---|---|---|---|
| Salida estructurada / extracción de información | Requiere que el modelo devuelva campos JSON fijos | Alta: la ausencia de campos o los cambios de formato hacen que el análisis falle directamente | Máxima |
| Agente / invocación de herramientas | Depende del formato de los argumentos y del momento de invocación de las llamadas a funciones | Alta: el orden de las llamadas y los hábitos de generación de parámetros pueden cambiar | Máxima |
| Análisis de documentos extensos | Aprovecha la ventana de contexto larga para resúmenes y preguntas y respuestas | Media: la calidad puede variar; hay que reevaluar la latencia y el costo | Alta |
| Diálogo de atención al cliente / generación de contenido | Salida de texto libre | Media-baja: el cambio de estilo se nota, pero normalmente no es crítico | Media |
| Herramientas internas / procesamiento por lotes offline | No es en tiempo real y se puede volver a ejecutar | Baja: se puede observar y ajustar después del enrutamiento | Baja |
Las tres dependencias que más se pasan por alto en la migración a Gemini 2.5
La primera es la dependencia implícita del modelo. Algunos equipos no escriben el ID del modelo directamente en el código de negocio, sino en el centro de configuración, en variables de entorno, en la configuración de nodos de plataformas low-code o incluso en los parámetros predeterminados de SDK de terceros. Estas ubicaciones se escapan con facilidad en una búsqueda global, así que hay que revisarlas con una lista específica.
La segunda es la dependencia de la semántica de los parámetros. La familia Gemini 2.5 admite configuraciones relacionadas con el pensamiento (thinking), como el presupuesto de razonamiento. Es posible que los modelos posteriores soporten este tipo de parámetros de otra forma, con valores predeterminados y rangos distintos; si se reutilizan los parámetros antiguos, pueden ignorarse, provocar errores o generar costos anómalos.
La tercera es la dependencia de la línea base de evaluación. Si tu conjunto de evaluación offline o las métricas de los experimentos A/B se basan en una línea base generada con Gemini 2.5 Pro o Flash, tras cambiar de modelo hay que reconstruir la línea base; de lo contrario, todas las comparaciones posteriores de métricas quedarán distorsionadas.
🎯 Recomendación técnica: Antes de la migración formal, puedes usar APIYI apiyi.com para llamar en paralelo al modelo antiguo y a los nuevos modelos candidatos con el mismo lote de muestras de prueba, y comparar rápidamente las diferencias en la salida. APIYI es compatible con los formatos de interfaz de OpenAI y Anthropic; para cambiar a un modelo candidato normalmente solo hay que modificar el nombre del modelo. Encontrarás las instrucciones de integración en el centro de documentación docs.apiyi.com.
Migración rápida de Gemini 2.5 Pro/Flash: flujo de 6 pasos
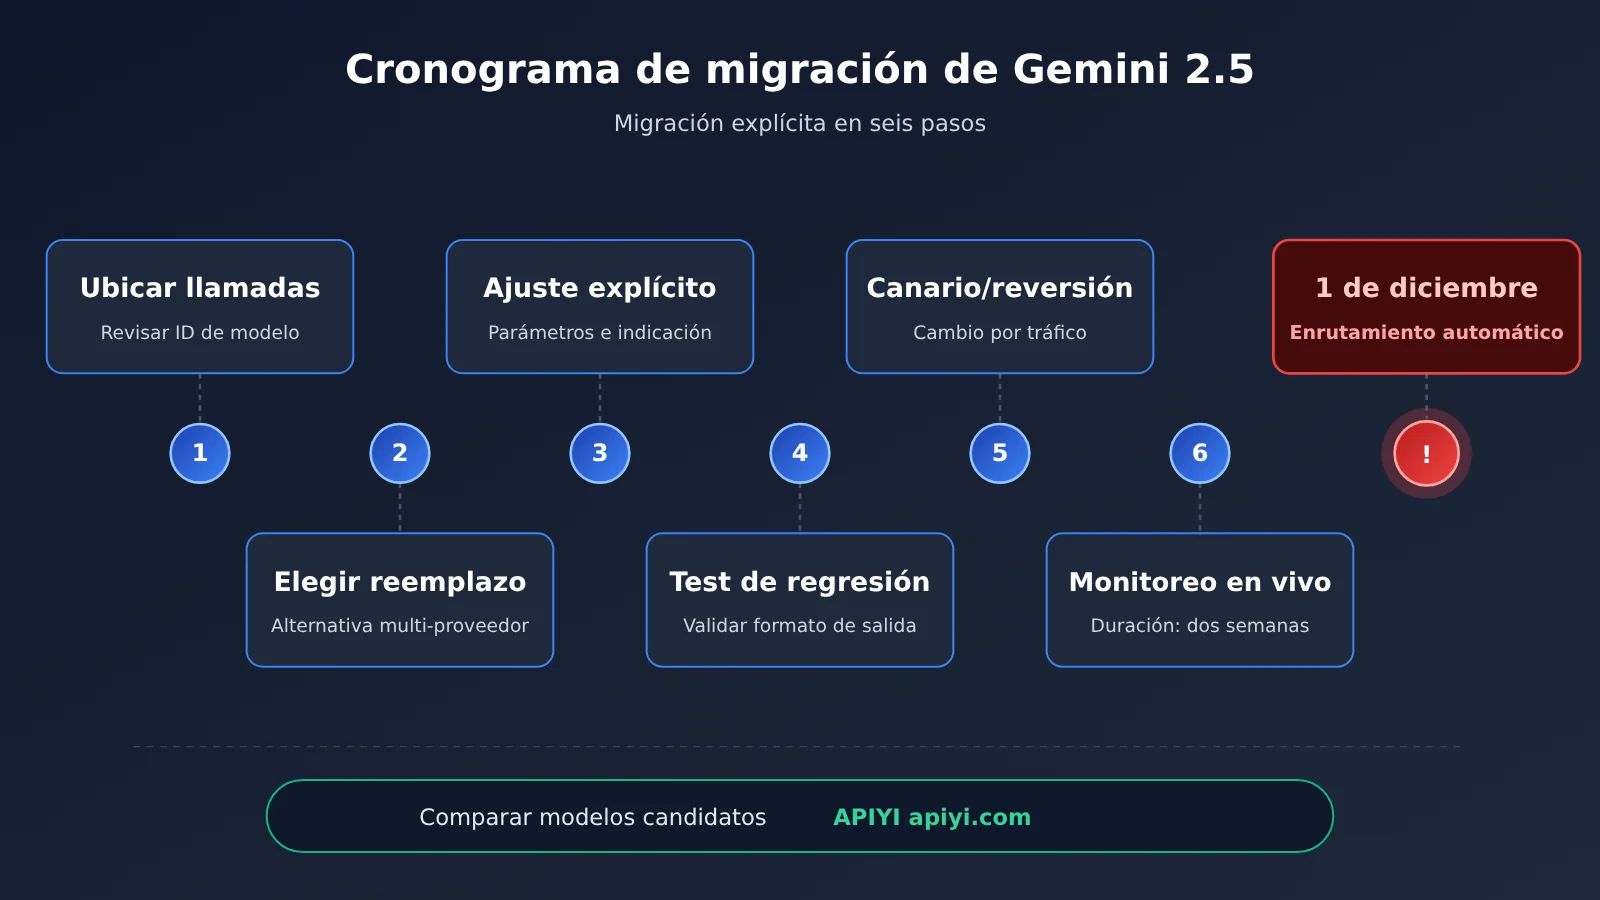
Las 6 etapas siguientes conforman el proceso de migración estándar que recomendamos, y cubren la cadena completa desde el inventario hasta la monitorización posterior al despliegue. Todo el flujo no depende de cuál sea el modelo posterior concreto, así que se puede aplicar directamente.
Paso 1: Inventariar todos los puntos de invocación de los modelos Gemini 2.5
Busca globalmente las dos palabras clave gemini-2.5-pro y gemini-2.5-flash en el repositorio de código, el centro de configuración, los scripts de despliegue y los flujos de trabajo low-code; al mismo tiempo, presta atención a las variantes de ID con sufijo de versión o marca de vista previa. Registra cada punto de invocación en una lista, anotando el servicio al que pertenece, el responsable, el volumen de llamadas y el nivel de impacto de la sección anterior.
Si tu servicio invoca Gemini a través de una puerta de enlace o plataforma agregadora, también debes comprobar si la capa de puerta de enlace hace mapeo de alias de modelos. A veces el código de negocio escribe un alias interno, y el verdadero ID del modelo Gemini 2.5 está escondido en la configuración de la puerta de enlace.
Paso 2: Determinar el modelo sustituto de Gemini 2.5
Toma como referencia los destinos de enrutamiento automático que aparecen en el anuncio oficial de Google y, al mismo tiempo, combínalos con las necesidades de tu propio negocio para elegir un modelo sustituto en cada punto de invocación. La regla general es: en los escenarios donde antes usabas Gemini 2.5 Pro para razonamiento complejo, documentos largos o tareas de código, conviene evaluar primero un modelo de la nueva generación del nivel Pro; en los escenarios donde usabas Gemini 2.5 Flash buscando velocidad y coste, conviene evaluar primero un modelo de la nueva generación del nivel Flash.
Ten en cuenta que los destinos de enrutamiento automático oficiales no tienen por qué ser la mejor solución para tu negocio. Algunos equipos aprovechan esta ocasión para reevaluar y degradar una parte del tráfico con requisitos de calidad bajos a modelos más ligeros, con el fin de optimizar costes.
💡 Sugerencia de elección: la elección del modelo sustituto depende principalmente del escenario concreto y de los requisitos de calidad. Se recomienda hacer pruebas reales a pequeña escala con los modelos candidatos a través de APIYI apiyi.com; la plataforma ofrece una interfaz unificada para invocar múltiples modelos populares, lo que facilita la comparación horizontal antes de tomar una decisión.
Paso 3: Modificar explícitamente el ID del modelo y calibrar los parámetros
No esperes al enrutamiento automático: sustituye de forma explícita el ID del modelo antiguo por el del nuevo en el código y en la configuración. La ventaja de hacerlo así es que los modelos que aparecen en los logs, el monitoreo y la facturación coinciden con el modelo que realmente se ejecuta, y no te llevas a engaños al diagnosticar problemas.
Al mismo tiempo que cambias el ID del modelo, revisa uno por uno los parámetros de invocación. La siguiente tabla recoge los elementos de configuración a los que hay que prestar más atención durante la migración:
| Elemento de configuración | Puntos a revisar durante la migración | Práctica recomendada |
|---|---|---|
| ID del modelo (model) | Si quedan IDs o alias antiguos sin actualizar | Centralizarlos todos en un centro de configuración para evitar valores codificados dispersos |
| Configuración relacionada con el razonamiento | Cómo admite el nuevo modelo parámetros como el presupuesto de razonamiento y cuáles son sus valores por defecto | Consultar la documentación del nuevo modelo y volver a configurarlo; no copiarlo tal cual |
| Longitud máxima de salida | El límite de salida y los valores por defecto del nuevo modelo pueden ser distintos | Definirla explícitamente para evitar truncamientos o salidas demasiado largas |
| Salida estructurada / JSON Schema | El grado de cumplimiento de las restricciones de campos puede cambiar | Probarlo junto con el manejo de errores y la validación de la capa de análisis |
| Definición de herramientas / llamadas a funciones | El estilo de generación de parámetros y la frecuencia de llamadas pueden cambiar | Validarlo reproduciendo muestras de conversaciones reales |
| Parámetros de muestreo como la temperatura | Un mismo valor produce efectos distintos en modelos diferentes | Reajustarlos según los resultados de la evaluación |
Paso 4: Pruebas de regresión con muestras reales
Extrae solicitudes reales representativas de los logs de producción y construye un conjunto de pruebas de regresión. Las muestras deben cubrir escenarios de alta frecuencia, escenarios de cola larga y casos límite que hayan causado problemas en el pasado; en las aplicaciones con salida estructurada, incluye también las muestras con el formato más complejo.
Ejecuta este lote de muestras con el modelo antiguo y con el nuevo, y compáralos en estas dimensiones: tasa de aprobación de formato (si el JSON se puede analizar correctamente), precisión de los campos clave, longitud media de la salida, latencia del primer token y latencia total, y cantidad de tokens consumidos por solicitud. Mientras la tasa de aprobación de formato y los indicadores clave no muestren una caída evidente, puedes pasar a la fase de despliegue gradual; si hay una caída notable, prioriza adaptar el nuevo modelo ajustando la indicación.
Paso 5: Despliegue gradual y plan de reversión
No hagas el cambio completo de una sola vez. Se recomienda aumentar el tráfico de forma gradual siguiendo el ritmo 5 %, 20 %, 50 % y 100 %, y observar al menos un ciclo de negocio completo en cada etapa. Lo ideal es poner el interruptor de despliegue gradual en el centro de configuración, para que el ID del modelo se pueda cambiar dinámicamente según la proporción de tráfico o el grupo de usuarios.
El plan de reversión merece una aclaración especial: a partir del 1 de diciembre, los ID de los modelos antiguos se enrutarán automáticamente, lo que significa que la opción de “volver a Gemini 2.5” ya no estará disponible en la práctica. Por eso, tu objetivo de reversión debería ser otro modelo alternativo ya validado, no el modelo antiguo. Esta es también la razón por la que se recomienda preparar con antelación al menos una alternativa de otro proveedor.
🚀 Inicio rápido: Si necesitas montar rápidamente una ruta alternativa entre modelos, puedes usar APIYI apiyi.com para integrar varios modelos de forma unificada. Como es compatible tanto con el formato de API de OpenAI como con el de Anthropic, el modelo alternativo y el principal pueden reutilizar la misma lógica de invocación; para revertir, solo hay que cambiar el nombre del modelo.
Paso 6: Monitoreo continuo después del lanzamiento
Una vez completada la migración, durante al menos dos semanas concéntrate en monitorear los siguientes indicadores: tasa de errores y de tiempos de espera, tasa de fallos al analizar salidas estructuradas, comentarios de calidad del lado del usuario (tasa de votos negativos, tasa de quejas), consumo de tokens y curva de costos. Se recomienda separar el ID del modelo como una dimensión independiente en el panel de monitoreo, para comparar mejor los cambios antes y después del cambio de modelo.
Además, el 1 de diciembre conviene hacer una revisión extra: si en ese momento todavía aparecen en el monitoreo solicitudes con el ID del modelo antiguo, significa que se pasó algo por alto en la fase de inventario. Esas solicitudes están usando el enrutamiento automático, así que hay que localizarlas cuanto antes y migrarlas de forma explícita.
Comparación de soluciones para Gemini 2.5: enrutamiento pasivo vs. migración proactiva
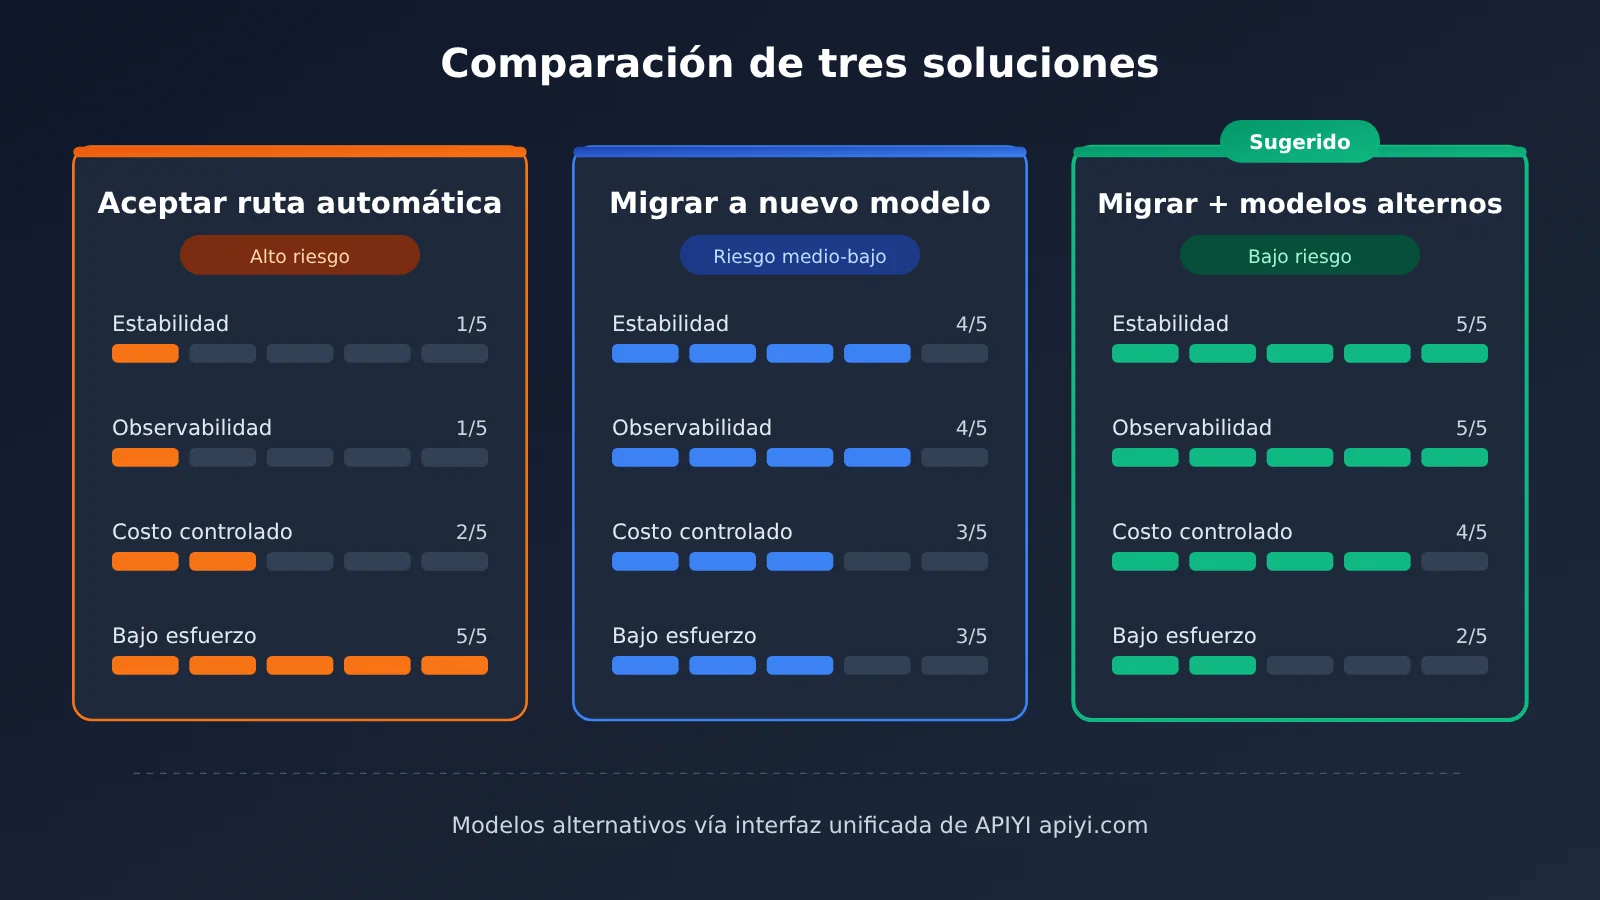
Ante el enrutamiento automático de Gemini 2.5 Pro/Flash del 1 de diciembre, los equipos suelen tener tres opciones principales. La siguiente tabla las compara en dimensiones como estabilidad, observabilidad y esfuerzo.
| Solución | Características clave | Cuándo conviene | Nivel de riesgo |
|---|---|---|---|
| Aceptar el enrutamiento automático | No se modifica el código; a partir del 1 de diciembre, el enrutamiento lo define la plataforma oficial | Herramientas internas de baja prioridad, tareas offline | Alto: el comportamiento cambia en silencio y los logs no reflejan la realidad |
| Migración explícita a los nuevos modelos Gemini | Cambiar de forma proactiva el ID del modelo y completar las pruebas de regresión | La mayoría de los servicios en producción | Medio-bajo: el cambio es controlable y observable |
| Migración explícita + alternativas multimodelo | Migrar el flujo principal al nuevo modelo y, a la vez, preparar alternativas de otros proveedores | Negocios centrales y servicios con altos requisitos de disponibilidad | Bajo: existe una ruta de reversión realmente utilizable |
| Aprovechar para reevaluar la selección | Reevaluar según el caso de uso y distribuir el tráfico entre modelos de distintos niveles | Negocios sensibles al costo y con gran volumen de invocaciones | Medio: el esfuerzo es mayor, pero el beneficio a largo plazo es claro |
Lectura comparativa de las soluciones para Gemini 2.5
Aceptar el enrutamiento automático es la opción que menos esfuerzo requiere, pero deja en manos externas tanto el momento como el destino del cambio de modelo. Para un servicio en producción que depende de un formato de salida fijo, equivale a publicar una actualización de una dependencia crítica sin pruebas; y si algo falla, tampoco será fácil identificar la causa de inmediato.
Migrar explícitamente a los nuevos modelos Gemini es la opción con mejor relación costo-beneficio. Sigues dentro del ecosistema Gemini, los cambios en las indicaciones y en la forma de integración son mínimos, y además obtienes observabilidad completa y garantías de prueba. Encaja con la gran mayoría de los equipos.
Migración explícita con alternativas multimodelo es lo adecuado para negocios centrales. Ten en cuenta que, después del 1 de diciembre, no se podrá revertir a Gemini 2.5; por eso, preparar un modelo alternativo de otro proveedor ya validado es la verdadera estrategia de reversión.
💰 Nota sobre costos: Para precios de modelos, precio unitario de entrada y salida, precios de caché y criterios de facturación, toma como referencia los datos reales de la página de precios de APIYI https://docs.apiyi.com/models. Este artículo no incluye cifras concretas; al evaluar la migración, conviene calcular la diferencia de costos combinando esos datos con tu propio consumo de tokens.
Preguntas frecuentes (FAQ)
Q1: ¿Qué es el enrutamiento automático de Gemini 2.5 Pro/Flash?
El enrutamiento automático significa que, tras la descontinuación de Gemini 2.5 Pro y 2.5 Flash por parte de Google AI Studio, a partir del 1 de diciembre las solicitudes de API dirigidas a esos dos IDs de modelo antiguos no devolverán un error directamente, sino que se reenviarán al modelo sucesor designado oficialmente para su procesamiento. A nivel de interfaz parece transparente, pero en realidad el modelo que se ejecuta ya ha cambiado.
Q2: ¿Cuál es la diferencia entre el enrutamiento automático y la migración proactiva?
El enrutamiento automático ahorra esfuerzo en cuanto a compatibilidad, pero el momento del cambio y el modelo de destino los decide un tercero; en los registros (logs) sigue apareciendo el ID del modelo antiguo, lo que dificulta el diagnóstico. La migración proactiva exige invertir esfuerzo en pruebas, pero el cambio de modelo es controlable y observable, y además permite calibrar de paso parámetros e indicaciones, lo que la hace más adecuada para servicios en producción.
Q3: ¿Cuándo entra en vigor el enrutamiento automático de Gemini 2.5? ¿Afecta a todos los canales?
Según el anuncio de Google AI Studio, el enrutamiento automático entra en vigor a partir del 1 de diciembre. En cuanto a si afecta también a otros canales como Vertex AI y si existe un periodo de conservación de alias, consulte el anuncio oficial de descontinuación de Google y el registro de cambios de la API de Gemini; antes de migrar, asegúrese de verificar el canal que está utilizando.
Q4: ¿Qué aplicaciones deben priorizar la gestión de la descontinuación de Gemini 2.5?
Las de mayor prioridad son las siguientes categorías:
– **Salida estructurada**: servicios de extracción de información y análisis de formularios que dependen de campos JSON fijos
– **Agentes y llamadas a herramientas**: flujos de automatización que dependen del formato de los parámetros de llamada a funciones
– **Análisis de documentos largos**: tareas de contexto largo que requieren reevaluar calidad, latencia y coste
Q5: ¿Cómo comparar rápidamente Gemini 2.5 con los modelos candidatos de reemplazo?
Se recomienda usar una plataforma que admita el acceso unificado a múltiples modelos para hacer pruebas en paralelo:
1. Visite APIYI apiyi.com, regístrese y obtenga su clave API
2. Consulte las instrucciones de acceso del centro de documentación docs.apiyi.com y configure la llamada según el formato compatible con OpenAI o Anthropic
3. Llame al modelo antiguo y a los modelos candidatos con el mismo conjunto de muestras de regresión, y compare la tasa de aprobación de formato, la latencia y el consumo de tokens
APIYI ofrece el acceso por API a modelos populares como la serie Gemini mencionada en este artículo; para cambiar de modelo normalmente basta con modificar el nombre del modelo.
Q6: ¿Qué limitaciones o riesgos conocidos tiene la migración de Gemini 2.5?
Hay que considerar objetivamente varios puntos. Primero, después del 1 de diciembre no es posible revertir a Gemini 2.5; cualquier reversión debe apuntar a otro modelo ya verificado. Segundo, el modo en que los nuevos modelos admiten parámetros como el presupuesto de razonamiento puede ser distinto y no se puede reutilizar tal cual. Por último, el coste puede variar; consulte los datos reales de la página de precios de APIYI docs.apiyi.com/models para el precio unitario y los criterios de facturación concretos, y así evitar desviaciones en el presupuesto.
Puntos clave para afrontar la deprecación de Gemini 2.5 Pro/Flash
- Hecho central: Gemini 2.5 Pro y 2.5 Flash quedan obsoletos; a partir del 1 de diciembre las solicitudes se enrutan automáticamente
- Mayor riesgo: El modelo cambia en silencio, los logs siguen mostrando el ID antiguo, y el formato y el coste pueden desviarse
- Primera acción: Inventariar globalmente los ID de modelo, incluyendo el centro de configuración, la pasarela y las plataformas low-code
- Forma de migrar: Sustituir explícitamente el ID del modelo y recalibrar parámetros como el razonamiento y la longitud de salida
- Garantía de calidad: Hacer pruebas de regresión con muestras reales de producción y después desplegar en canary por porcentajes
- Plan de rollback: Una vez pasada la fecha límite no se puede volver a Gemini 2.5; hay que preparar con antelación modelos alternativos de otros proveedores
- Cómo empezar: Puedes acceder a varios modelos de forma unificada a través de APIYI y comparar rápidamente los modelos candidatos
Resumen
Tras la deprecación de Gemini 2.5 Pro/Flash, los puntos clave para afrontar el enrutamiento automático del 1 de diciembre:
- No dependas del enrutamiento automático: solo garantiza que la interfaz no devuelva error, no que la calidad y el formato de salida se mantengan iguales
- Migra de forma proactiva en 6 pasos: inventario, selección, modificación explícita, pruebas de regresión, canary y rollback, monitorización continua
- Prepara de antemano una ruta alternativa: pasada la fecha límite no se puede volver a los modelos antiguos; la alternativa de otros proveedores es la verdadera red de seguridad
Queda menos de un mes para el 1 de diciembre. Te sugiero completar esta semana el inventario de puntos de invocación y la clasificación de impacto, la próxima entrar en pruebas de regresión y terminar el despliegue canary antes de fin de mes, dejando margen para la fecha límite.
Recomiendo verificar rápidamente el rendimiento de los modelos candidatos a través de APIYI apiyi.com. La plataforma es compatible con los formatos de API de OpenAI y Anthropic; las instrucciones de integración están en docs.apiyi.com, y los precios y criterios de facturación de los modelos se rigen por https://docs.apiyi.com/models.
📚 Referencias
- Noticia sobre la deprecación de Gemini 2.5 Pro y 2.5 Flash en Google AI Studio: cobertura de esta deprecación y del evento de enrutamiento automático
- Enlace:
aihot.news/items/ewvepczpb5fewcbzo2tkqdldm -
Descripción: confirma los modelos deprecados y el momento del enrutamiento automático el 1 de diciembre
-
Registro de cambios de la API de Gemini: registro oficial de Google sobre actualizaciones y deprecaciones de modelos
- Enlace:
ai.google.dev/gemini-api/docs/changelog -
Descripción: sirve para verificar los modelos de destino del enrutamiento automático y los canales afectados
-
Centro de documentación de APIYI: instrucciones de integración de múltiples modelos
- Enlace:
docs.apiyi.com -
Descripción: configuración de llamadas en formatos compatibles con OpenAI y Anthropic
-
Página de precios de modelos de APIYI: precios de modelos y criterios de facturación
- Enlace:
docs.apiyi.com/models - Descripción: base de precios para evaluar el costo de la migración
Autor: Equipo técnico de APIYI
Contacto técnico: puedes contactarnos desde la página principal del sitio de APIYI; para más materiales, visita el centro de documentación docs.apiyi.com