著者注:429 に遭遇しても、すぐにモデルを変える必要はありません。本記事では 3 ステップの切り分けで、レート制限が上流プロバイダー、ゲートウェイ、それとも無料枠に由来するのかを判断し、指数バックオフ、Retry-After、フェイルオーバーの設定方法を解説します。
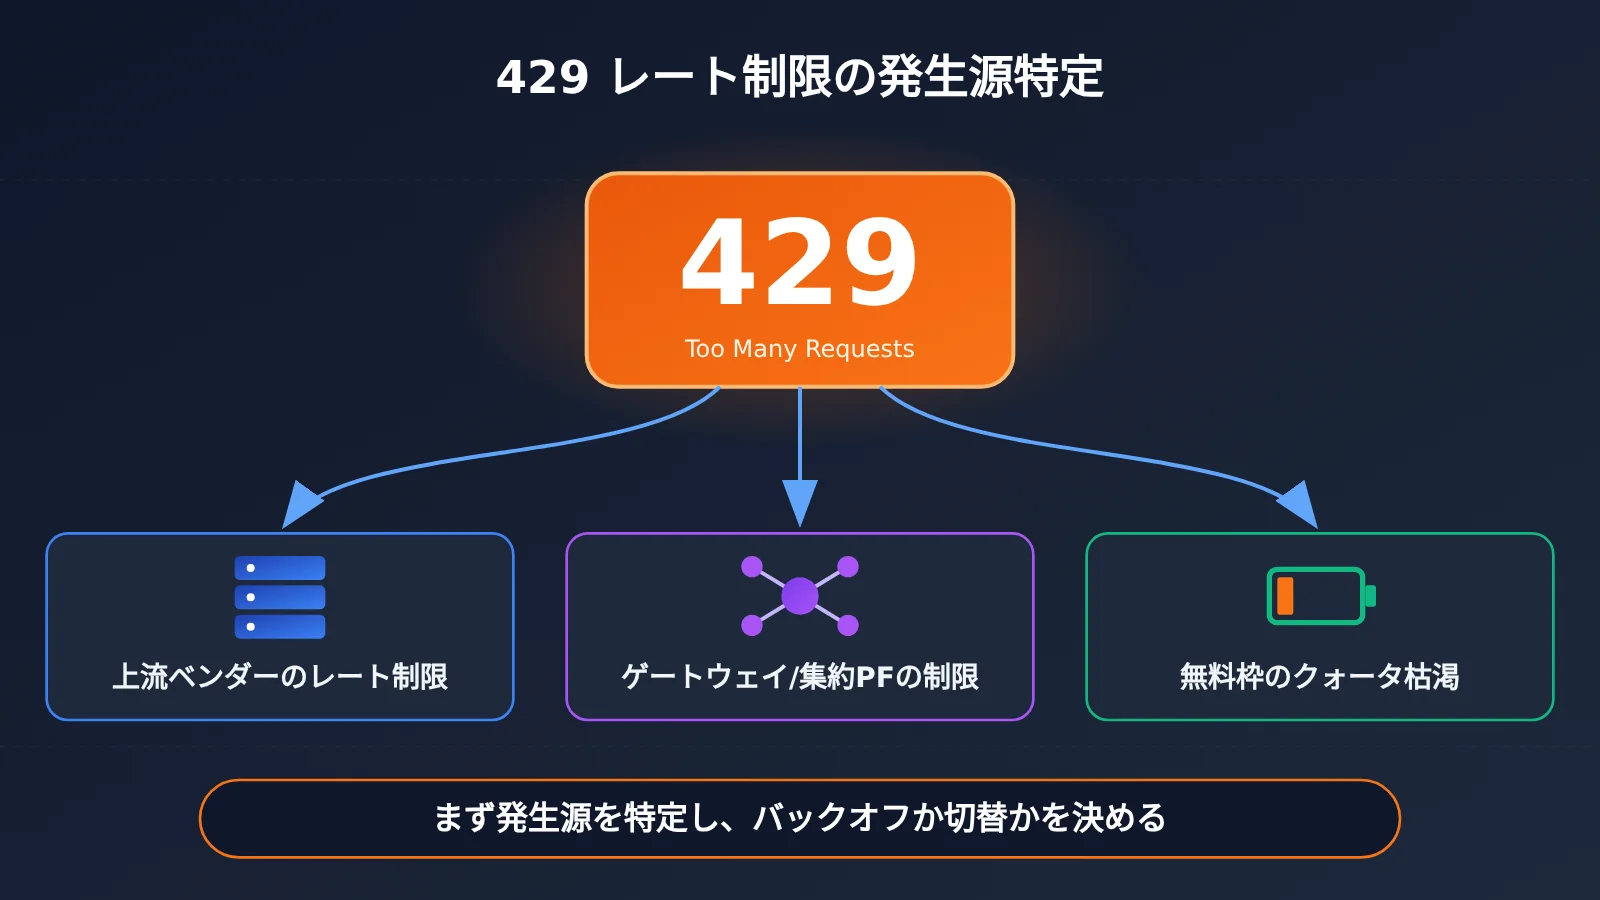
深夜のバッチ処理中にログへ突然 429 Too Many Requests が一画面分あふれ出したとき、多くの人の第一反応は「このモデルはダメだ、すぐ別のに変えよう」です。しかし、この判断は往々にして早すぎます。429 は「誰かがあなたを制限している」ことしか示しておらず、誰が制限しているのか、どのような次元で制限しているのかは示していません。本記事の中心的な主張は まずレート制限の発生源を特定し、それからバックオフするか切り替えるかを決める ことです。
これはありきたりなリトライ入門記事ではありません。実際のトラブルシューティングの順序に沿って、エラーメッセージ、レスポンスヘッダー、レート制限の次元を分解し、そのうえでバックオフパラメータとフェイルオーバー経路の設定推奨を示します。
コアバリュー:本記事を読み終えれば、数分で 429 が上流プロバイダー、中間ゲートウェイ、無料枠のクォータのどこから来たのかを判断でき、自分のアプリに「待つべきときは待ち、切り替えるべきときは切り替える」フォールトトレランス戦略を設定できるようになります。
429 レート制限判断の要点
429 は HTTP 標準における「リクエストが多すぎます」というステータスコードです。大規模言語モデル API の場面では、呼び出しチェーン上のどの層からでも返される可能性があります。次の表は、最もよくある 3 つの発生源と、それぞれに対する正しい対応方法をまとめたものです。
| レート制限の発生源 | 典型的な特徴 | モデルを変更すべきか | 推奨される対応 |
|---|---|---|---|
| 上流のモデルプロバイダー | エラーボディにベンダー独自のエラータイプと文言が含まれ、レスポンスヘッダーにベンダーのレート制限フィールドがある | 通常は不要 | Retry-After に従ってバックオフし、必要に応じて同時実行数を下げるか上限引き上げを申請する |
| 中間ゲートウェイ/アグリゲーションプラットフォーム | エラーの文言がゲートウェイ由来で、アカウント単位またはグループ単位のレートを示す | 不要 | ゲートウェイ側のクォータと同時実行設定を確認するか、ゲートウェイのグループを切り替える |
| 無料プラン/トライアル枠 | 無料枠、1日あたりの回数、または容量不足を示す | 状況次第 | 有料プランにアップグレードするか、容量のある同種モデルに切り替える |
429 はモデル障害を意味しない理由
モデル自体が利用できない場合、より一般的なシグナルは 5xx 系のエラーです。たとえば Anthropic の過負荷時には 529 overloaded_error が返り、ゲートウェイやロードバランサーの異常では 502、503 がよく見られます。これらのステータスコードは、サーバー側が一時的に処理しきれていないことを示しており、「あなたのアカウントがクォータを超えた」こととは別問題です。
一方、429 には明確な帰属の意味があります。レート制限ルールの対象はあなた自身であり、あなたの APIキー、所属組織、利用している無料プラン、あるいはゲートウェイが割り当てたレートである可能性があります。別のモデルに変えることで回避できることもありますが、制限がゲートウェイのアカウント単位クォータ由来であれば、モデルを変えても同じ壁にぶつかります。制限が上流プロバイダーの毎分のトークン上限由来なら、数秒待てば回復します。それなのにモデルを変えると、かえって出力品質に不確実性を持ち込むことになります。
サードパーティによる Claude Code のトラブルシューティング整理も、この点を裏付けています。Claude Code は 429 に遭遇すると Request rejected (429) を表示し、その後にサーバー側の原文が続きます。そして、この原文こそが、レート制限が Anthropic 由来なのか、ゲートウェイ由来なのか、無料プラン由来なのかを教えてくれます。したがって、調査の第一歩は常にエラーメッセージ全体を読むことであり、ステータスコードだけを見ることではありません。
429 と隣接するステータスコードとの違い
さまざまなエラーを混同しないよう、下表では大規模言語モデルの呼び出しにおいて 429 と紛らわしいステータスコードを整理しました。
| ステータスコード | 意味 | 責任の所在 | リトライに適するか | フェイルオーバーに適するか |
|---|---|---|---|---|
| 429 | リクエスト過多。レート制限またはクォータ制限に抵触 | 呼び出し側のクォータ | 適する(バックオフが必要) | バックオフが効かない場合に切り替え |
| 529 | 上流の過負荷(Anthropic 固有) | サーバー側のキャパシティ | 適する(短時間のバックオフ) | 適する |
| 503 | サービスが一時的に利用不可 | サーバー側またはゲートウェイ | 適する | 適する |
| 500/502 | 内部エラーまたはゲートウェイエラー | サーバー側またはゲートウェイ | 限定的な回数のリトライ | 適する |
| 400/401/403 | パラメータ・認証・権限の問題 | 呼び出し側の設定 | 適さない | 適さない(設定の修正が必要) |
この表には見落とされがちなポイントがひとつあります。Claude Code の fallbackModel の仕組みは、第三者によるテストによれば 529 の過負荷時にのみ発動し、最大 3 つの代替モデルを試行するものであって、429 では発動しません。これは、ツールの設計者自身も「429 に対する第一の対応はモデルの切り替えではなくバックオフである」と考えていることを示しています。
429 レート制限の発生元を判断する:3 ステップの切り分け
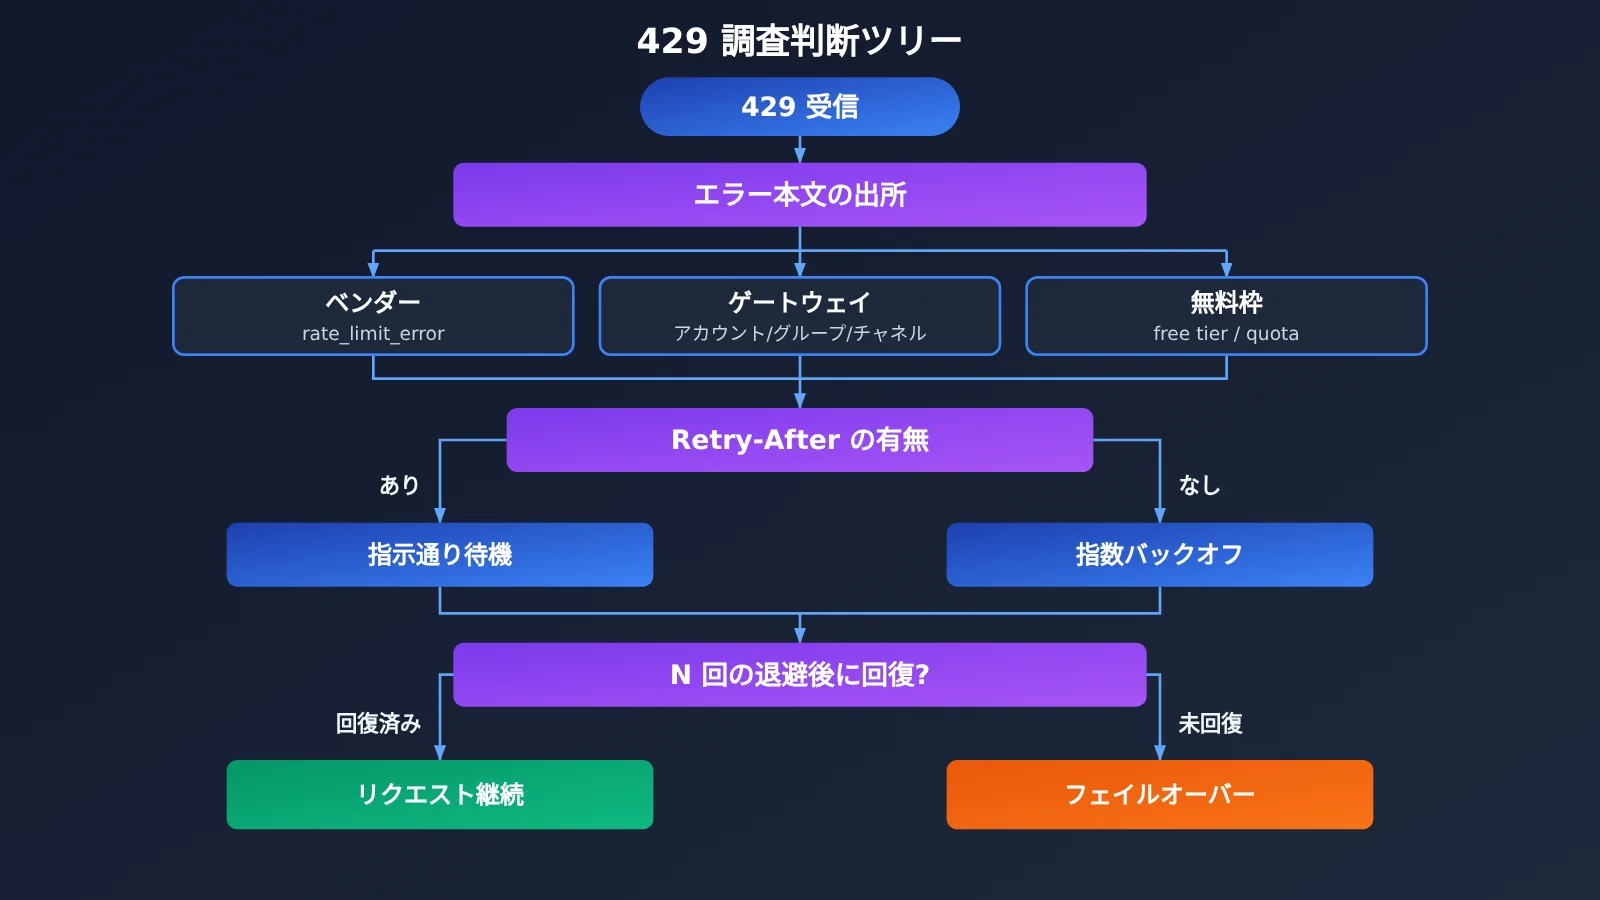
以下は、そのまま実行できる 429 調査フローです。3 つのステップはコストの低い順に並んでおり、多くの場合は最初のステップで発生元を特定できます。
ステップ 1:429 エラーレスポンス全体を読む
ステータスコードだけをログに残すのではなく、レスポンスボディをそのまま記録してください。どの層が返した 429 かによって文言には明確な違いがあり、これが最も直接的な手がかりになります。
- 上流プロバイダーが返す場合:エラーボディには通常、プロバイダー独自のエラータイプフィールドが含まれます。たとえば Anthropic は
rate_limit_errorタイプを返し、OpenAI 形式の API はrate_limit_exceededのようなエラーコードを返して、リクエスト数とトークン数のどちらが上限を超えたのかを示します。 - ゲートウェイが返す場合:文言に「アカウント」「グループ」「トークン」「チャネル」など、ゲートウェイ自身の概念が含まれることが多く、ゲートウェイ名が明記される場合もあります。
- 無料枠が返す場合:「free tier」「quota」「daily limit」「capacity」などの文字列が現れます。第三者による一部モデルの無料トライアル検証では、このキャパシティ制限による 429 が頻繁に確認されています。
API中継サービスやアグリゲーションプラットフォーム経由で呼び出す場合は、ゲートウェイが上流の元のエラーをそのまま透過しているかどうかに特に注意してください。透過されていれば上流が制限をかけていると判断でき、カスタム文言に置き換えられていればゲートウェイが制限していると判断できます。
ステップ2:429レスポンスヘッダーを確認する
レスポンスヘッダーは2つ目の証拠チェーンです。主要なプロバイダーは残りクォータとリセット時間をレスポンスヘッダーで返しており、ゲートウェイが独自のフィールドを付加している場合もあります。
| レスポンスヘッダー | よくある提供元 | 意味 | 調査での用途 |
|---|---|---|---|
Retry-After |
HTTP標準、多くの実装で共通 | 待機を推奨する秒数 | バックオフ時に優先的に採用 |
x-ratelimit-remaining-requests |
OpenAI形式のAPI | 現在のウィンドウでの残りリクエスト数 | RPM制限かどうかの判定 |
x-ratelimit-remaining-tokens |
OpenAI形式のAPI | 現在のウィンドウでの残りトークン数 | TPM制限かどうかの判定 |
anthropic-ratelimit-requests-remaining |
Anthropic | 残りリクエスト数 | 制限がAnthropic由来かの確認 |
anthropic-ratelimit-input-tokens-remaining |
Anthropic | 残り入力トークン数 | 入力トークン制限かどうかの判定 |
判定ルールはシンプルです。プロバイダー名を接頭辞に持つレート制限ヘッダーが存在し、残り値が0であれば、ほぼ間違いなく上流のプロバイダーが制限をかけています。逆にプロバイダーのレート制限ヘッダーが一切なく、ゲートウェイ独自のフィールドだけがある、あるいは何もない場合は、ゲートウェイ層の可能性が高くなります。注意したいのは、近年一部のプロバイダーが具体的な上限値をコンソール上でのみ表示するよう変更しており、レスポンスヘッダーの情報が不完全なことがある点です。その場合はステップ1のエラーの言い回しと、ステップ3の次元比較に立ち返ってください。
ステップ3:レート制限の軸を照合する
誰が制限しているのかが分かったら、次に「何が」制限されているのかを明確にする必要があります。ベンダーごとにレート制限のルールは統一されておらず、第三者による5社の横断的な整理によると、Anthropic は主に1分あたりの token 数で制限し、キャッシュヒットした token は制限にカウントされません。DeepSeek は主に同時実行数を制限し、OpenAI と Google の具体的な割り当てはコンソールで確認する形になっています。
これは設定戦略に直接影響します。よくある対応関係は次のとおりです。
- RPM(1分あたりのリクエスト数)超過:複数の小さなリクエストをバッチリクエストにまとめるか、クライアント側にトークンバケットを導入して一定速度で送信します。
- TPM(1分あたりの token 数)超過:コンテキストを短くし、プロンプトキャッシュを有効にし、長文ドキュメントのタスクは異なる時間帯に分割します。
- 同時実行数超過:worker の数を減らし、キューで同時に処理中のリクエスト数を制御します。単純なバックオフでは効果が限定的です。
- 日次クォータや無料枠の枯渇:バックオフしても意味がなく、リセットを待つか、プランをアップグレードするか、別のチャネルに切り替えるしかありません。
4番目のケースは、バックオフが確実に無効となる唯一の 429 であり、できるだけ早く検知して直接フェイルオーバーに移行すべき状況でもあります。
429 のバックオフ戦略はどう設定するか
429 が復旧可能なレート制限であることを確認したら、次はバックオフの段階に入ります。バックオフの目的は「できるだけ早くリトライすること」ではなく、「輻輳を悪化させずに、できるだけ早く復旧すること」です。
指数バックオフとランダムジッター
最もよく使われる方法は、指数バックオフ(Exponential Backoff)にランダムジッター(Jitter)を組み合わせるものです。n 回目のリトライの待ち時間は「基本遅延 × 2 の n 乗」を目安にし、そこにランダムな値を上乗せして上限を設けます。ランダムジッターの役割は、複数のクライアントのリトライ時刻をばらけさせることです。これにより、全員が同じ秒に集中してアクセスし「リトライストーム」が発生するのを防げます。
レスポンスに Retry-After が含まれている場合、その優先度は自分で計算したバックオフ時間より高くすべきです。ウィンドウがいつリセットされるかをサーバー側はあなたより正確に把握しています。その指示に従って待つのが、多くの場合もっとも早い復旧方法です。
バックオフパラメータの推奨値
次の表は、多くの対話・バッチ処理シーンに適用できる初期パラメータのセットです。実際に使う際は、業務の遅延許容度に合わせて調整してください。
| パラメータ | 推奨初期値 | 説明 |
|---|---|---|
| 基本遅延 | 1 秒 | 最初のリトライまでの待ち時間 |
| バックオフ倍率 | 2 | リトライごとに待ち時間を倍にする |
| 1 回あたりの最大待機 | 30〜60 秒 | 待ち時間が無限に伸びるのを防ぐ |
| 最大リトライ回数 | 3〜5 回 | 超えたらフェイルオーバーまたはエラー報告へ |
| ランダムジッター | 待ち時間の 0〜100% でランダム | 「フルジッター」方式を推奨、リトライをばらけさせる |
| Retry-After | あれば優先 | 自分で計算したバックオフ時間を上書きする |
見落とされがちな設定のポイントが 2 つあります。1 つ目は、対話型のシーン(チャット画面など)では総待ち時間をあまり長くしないことです。全体のタイムアウト予算を設定し、それを超えたら切り替えに進むか、ユーザーに通知することをおすすめします。2 つ目は、400・401・403 といった設定ミスに対してバックオフ付きリトライを行わないことです。これらはどれだけ待っても自然に直ることはなく、時間とクォータを無駄に消費するだけです。
公式 SDK を使用している場合、多くの SDK には 429 や 5xx 向けの自動リトライが組み込まれています。通常は max_retries のようなパラメータで回数を制御します。自分でもう 1 層リトライを重ねる前に、まず SDK のデフォルト動作を確認してください。2 層のリトライが重なることで、実際のリトライ回数が何倍にも膨れ上がるのを避けられます。
429 のフェイルオーバーはどう設定するか
バックオフは「その場で待つ」ことで、フェイルオーバー(Failover)は「別のルートに切り替える」ことです。この2つは二者択一ではなく、順序の関係にあります。まずバックオフし、それでも解決しない場合に切り替えます。
フェイルオーバーをいつ発動するか
429 を見ただけで即切り替えるのではなく、次のいずれかを満たしたときに発動するのがおすすめです。
- 最大リトライ回数に達しても、429 が返り続けている
- エラーメッセージが、日次クォータ、無料枠の枯渇、「容量不足」を明確に示している
Retry-Afterが示す待ち時間が、業務で許容できる上限を超えている- 同じチャネルで短時間に連続して失敗し、サーキットブレーカーのしきい値に達した
OpenRouter 上の人気モデルで 429 が頻発する場合に対するサードパーティの推奨も同じ考え方で、まずバックオフし、それから同じインターフェース配下の別モデルへフェイルオーバーします。この順序なら、元のモデルの出力品質を活かしつつ、サービスを止めずに済みます。
切り替え経路の3つの設計
フェイルオーバーの「代替ルート」には階層があり、切り替えコストは低い順に次のとおりです。
- 同じモデルでチャネルを変える:同じモデルを、別のAPIキー、別のグループ、あるいは別のプロバイダで呼び出します。出力の一貫性が最も良く、第一候補になります。
- 同じベンダー内でグレードを下げる:たとえばフラッグシップモデルから同シリーズの軽量モデルへ。能力はやや落ちますが、スタイルは近いままです。
- ベンダーをまたいでモデルを変える:他社の同級モデルへ切り替えます。可用性は最も高いものの、プロンプトの効き方や出力フォーマットは事前に検証しておく必要があります。
さらにその上にサーキットブレーカー(Circuit Breaker)を重ねるのがおすすめです。あるチャネルが連続失敗のしきい値に達したら、一定のクールダウン期間はそのチャネルをスキップし、クールダウンが明けたら少数のプローブリクエストを流し、回復したら徐々にトラフィックを戻します。これにより、毎回のリクエストがまず失敗してから切り替えるという無駄を防ぎ、全体のレイテンシを大きく下げられます。
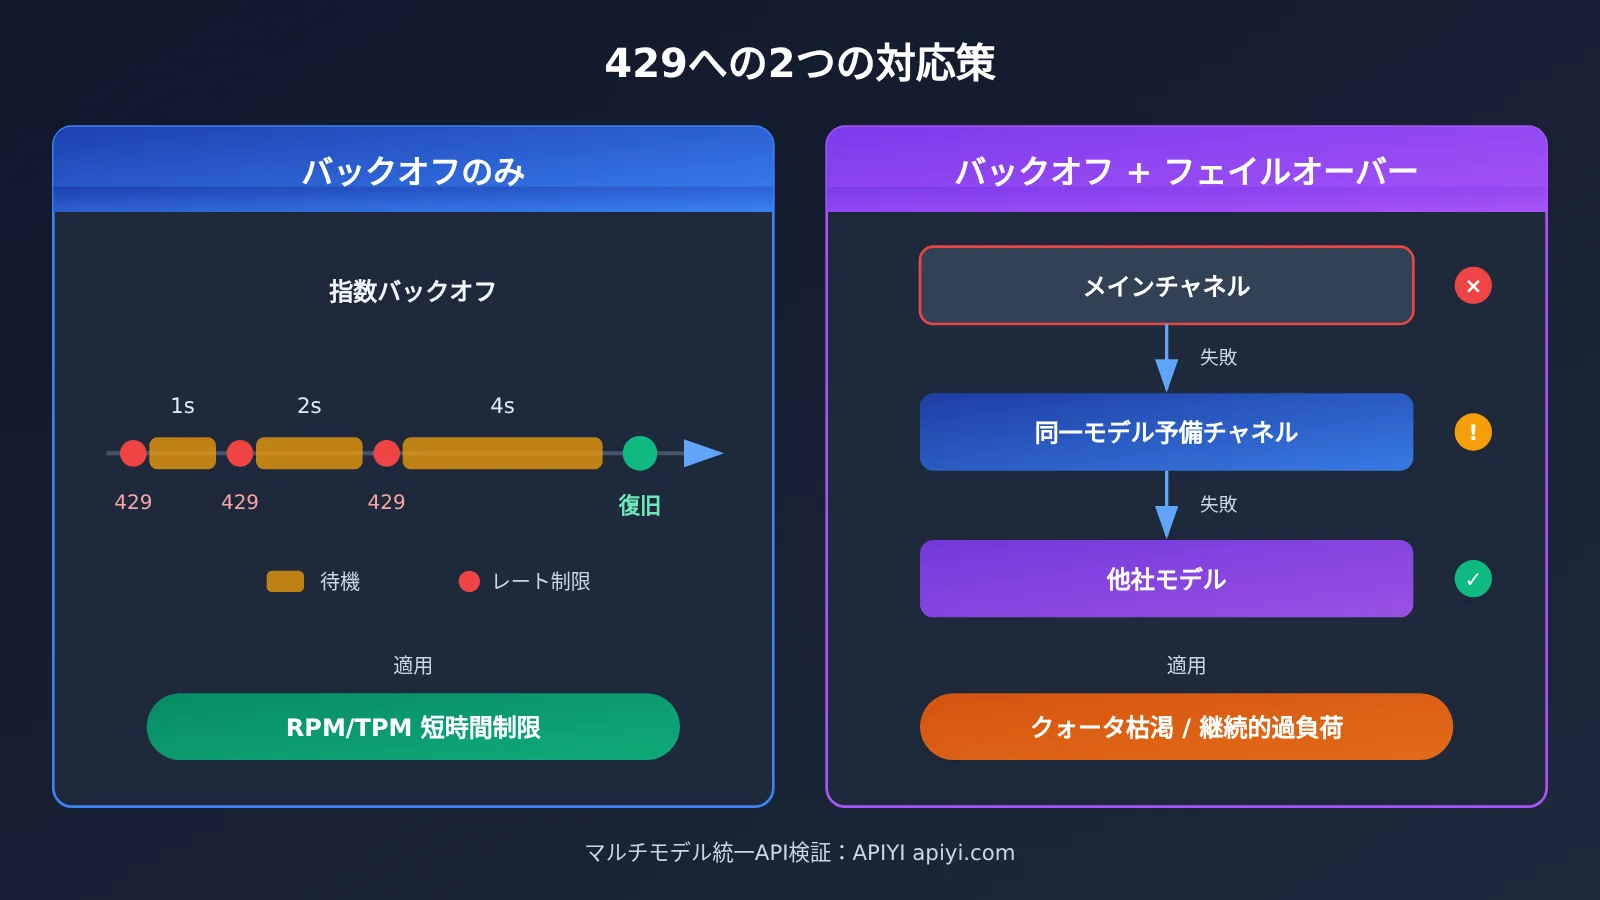
上の図で比較した2つの戦略は、実際のプロジェクトでは同じ統一インターフェース上で検証できます。APIYI のように OpenAI と Anthropic のインターフェース形式の両方に対応したプラットフォームなら、同じコードで model パラメータを変えるだけで予備モデルに切り替えられ、ベンダーごとに SDK を保守するよりもはるかに手間がかかりません。
429 レート制限処理クイックスタート
ここまでの内容を、そのまま実践できる設定チェックリストとして整理します。全文コードは登場しません。コードレビューや運用設定の際のチェック表として活用してください。
5項目の設定チェックリスト
- ログ:レスポンスボディとレスポンスヘッダーを完全に記録し、少なくともステータスコード、エラータイプ、エラーメッセージ、
Retry-After、各種ratelimitフィールドを含めます。 - 分類:クライアント側でエラーを「バックオフ可能」(429 レート系、529、503)、「切り替え必要」(クォータ枯渇、継続的な失敗)、「リトライ不可」(400、401、403)の3種類に分類します。
- バックオフ:上記のパラメータ表に従って指数バックオフ+フルジッターを設定し、
Retry-Afterを優先したうえで、最大リトライ回数と総タイムアウト予算を定めます。 - 切り替えチェーン:「同一モデルでチャネル変更 → 同一ベンダーでティア変更 → ベンダーをまたいでモデル変更」の順にバックアップリストを設定し、各バックアップモデルのプロンプト効果を事前に検証しておきます。
- サーキットブレーカーとアラート:各チャネルに失敗しきい値とクールダウン時間を設定すると同時に、429 の比率に対するアラートも設定します。比率が継続的に高い場合は、上限引き上げの申請や並列度の調整が必要だと考えられます。
バックアップモデル経路の例
下表は、よくある3段階の切り替えチェーンのイメージです。具体的なモデル名はプラットフォームのモデル一覧を参照してください。課金については価格ページを参照し、本記事では具体的な単価は記載しません。
| 階層 | 選択方針 | インターフェース形式 | 利用可能プラットフォーム | 価格基準 |
|---|---|---|---|---|
| メイン | 業務効果が最も良いフラッグシップモデル | OpenAI または Anthropic 形式 | APIYI apiyi.com、公式 API | docs.apiyi.com/models を参照 |
| 第1バックアップ | 同一モデルの別チャネルまたはグループ | メインと同じ | APIYI apiyi.com、公式 API | docs.apiyi.com/models を参照 |
| 第2バックアップ | 同一ベンダーの軽量モデル、またはベンダーをまたいだ同級モデル | OpenAI 互換形式 | APIYI apiyi.com などのアグリゲーションプラットフォーム | docs.apiyi.com/models を参照 |
接続方法について、OpenAI または Anthropic の公式 SDK を使う場合は、通常 base_url をプラットフォームが提供するアドレスに、api_key をプラットフォームのキーに変更するだけで済みます。具体的なインターフェースアドレスと各モデルの呼び出し方法については、APIYI ドキュメントセンター docs.apiyi.com を参照することをおすすめします。ネット上で未検証のアドレスをそのまま使わないでください。
🚀 クイックスタート:429 のフォールトトレラント経路を構築する際は、まず APIYI apiyi.com 経由で、同じコードを使ってメインとバックアップのモデルに接続することをおすすめします。プラットフォームは本記事で扱う主要モデルの API 呼び出しを提供しており、OpenAI と Anthropic のインターフェース形式に対応しています。モデルの切り替えは
modelパラメータを変更するだけです。接続ドキュメントは docs.apiyi.com をご覧ください。各モデルの入出力単価、キャッシュ価格、課金基準は、価格ページ docs.apiyi.com/models の実際のデータを参照してください。
よくある質問(FAQ)
Q1:429 レート制限とは何ですか?
429 は HTTP 標準の Too Many Requests ステータスコードで、呼び出し側が一定の時間枠内で許可されたリクエスト数、トークン数、同時実行数、または総クォータを超過したことを示します。これは「あなたが制限された」という意味であり、モデル自体の障害を示すものではありません。
Q2:429 と 529、503 の違いは何ですか?
429 は呼び出し側のクォータ問題を指し、責任は「使いすぎた側」にあります。一方 529 は Anthropic の過負荷エラー、503 はサービスが一時的に利用不可であることを示し、いずれも責任はサービス側の容量にあります。前者はバックオフと使用量の調整を優先し、後者は短時間のバックオフ後に直接フェイルオーバーするのが適しています。
Q3:429 が上流ベンダー由来かゲートウェイ由来かを最速で見分けるには?
まずエラー本文の文言を確認します。ベンダーのエラータイプが付いていれば通常は上流由来、アカウントやグループ、チャネルといった概念に言及していれば通常はゲートウェイ由来です。次にレスポンスヘッダーを見ます。ベンダープレフィックスの付いた `ratelimit` フィールドが存在し、残り値が 0 であれば、上流がレート制限しているとほぼ確認できます。
Q4:何度もバックオフしても 429 が解除されないのはなぜですか?
最もよくある原因は、レート制限の次元を判断し間違えていることです。日次クォータや無料枠の枯渇であれば、バックオフは無意味です。同時実行数の超過であれば、クライアントが依然として高並列で送信し続けているため、バックオフは緩和にしかなりません。この場合は並列度を下げるか、直接フェイルオーバーに移行すべきです。
Q5:マルチモデルのフェイルオーバー経路を素早く構築するには?
マルチモデル統一インターフェースをサポートするプラットフォームで検証することをおすすめします:
1. APIYI apiyi.com でアカウントを登録し、APIキーを取得します;
2. docs.apiyi.com のドキュメントに従って `base_url` を設定し、OpenAI または Anthropic 形式で接続します;
3. クライアントにメイン用とバックアップ用のモデルリストを設定し、`model` パラメータを変更して切り替えます。
これによりメイン用とバックアップ用のモデルが同じコードを共有でき、切り替え経路のテストコストを大幅に抑えられます。
Q6:フェイルオーバーでコストが制御不能になることはありますか?
可能性はあります。バックアップモデルの単価、コンテキスト長、キャッシュ戦略はメインモデルと異なる場合があり、頻繁な切り替えは請求構造を変えてしまいます。バックアップモデルごとに事前に価格を確認し、APIYI の価格ページ docs.apiyi.com/models の実際のデータを基準にし、切り替え比率にアラートを設定することをおすすめします。
Q7:429 の処理方法にはどのような既知の限界がありますか?
バックオフはリクエスト遅延を増やすため、リアルタイム性が極めて重要なシーンには向きません。ベンダーをまたぐ切り替えでは出力スタイルやフォーマットの差異が生じる可能性があり、事前に回帰テストが必要です。一部のベンダーはコンソールでしか上限を表示せず、レスポンスヘッダーの情報が不完全なため、調査時はエラーの文言と監視データに頼らざるを得ません。
429レート制限処理の核心ポイント Key Takeaways
- 429は「制限された」ということだけを示す:誰が何を制限したかまでは分からず、モデル障害と直接同一視することはできません。
- まずはエラー本文の文言を読む:エラー本文の言い回しは、上流ベンダー・ゲートウェイ・無料枠のどれなのかを判断する最速の手がかりです。
- 次にレスポンスヘッダーを見る:ベンダー接頭辞付きの
ratelimitフィールドとRetry-Afterが第二の証拠チェーンとなります。 - 次元ごとに適切に対処する:RPMは均等分散、TPMはコンテキスト縮小、並列数はworker制御、クォータ枯渇は即時切り替えで対応します。
- まずバックオフ、その後切り替え:指数バックオフ+フルジッター、
Retry-Afterを優先し、リトライには上限を設けます。 - 切り替えチェーンは階層設計:同一モデルではチャネル変更を優先し、クロスベンダーのモデル変更でフォールバックし、サーキットブレーカーを併用します。
- 統一インターフェースでコスト削減:APIYIのOpenAI・Anthropic互換インターフェースを通じれば、1つのコードで主系・予備モデルを管理できます。
まとめ
429に遭遇したときの正しい順序は「発生源の特定 → 次元の判断 → バックオフ → 切り替え」であり、いきなりモデルを変えることではありません。
- 発生源の特定:エラー本文の言い回しとレスポンスヘッダーから、上流ベンダー・ゲートウェイ・無料枠を見分けます。
- 次元の判断:リクエスト数、token数、並列数、総クォータのどれなのかを突き止め、バックオフが有効かどうかを判断します。
- フォールトトレランスの設定:指数バックオフ+ジッターを第一の防御線とし、階層化フェイルオーバー+サーキットブレーカーを第二の防御線とします。
このフローをログ、エラー分類、クライアント設定に組み込めば、429は「深夜のアラート」から、予測可能で自己修復できる通常イベントへと変わります。
主系・予備モデルの切り替え効果は、APIYI apiyi.com ですばやく検証することをおすすめします。接続の説明は docs.apiyi.com に、関連するモデル価格と課金基準は docs.apiyi.com/models を参照してください。
📚 参考資料
- Rate Limit Reached in Claude Code: What Each 429 Message Means:Claude Code における 429 エラーメッセージの意味を読み解く
- リンク:
ofox.ai/blog -
説明: サーバー側から返される原文メッセージをもとに、Anthropic・ゲートウェイ・無料プランのレート制限をどう見分けるかを解説
-
Claude Code fallbackModel: 3-Tier Failover Setup:Claude Code のフォールバックモデル設定
- リンク:
ofox.ai/blog -
説明: fallbackModel は 429 ではなく 529(過負荷)時に発動し、指定できるのは最大 3 モデルまでである点を指摘
-
LLM API Rate Limits Compared:5 社の大規模言語モデルベンダーにおけるレート制限ルールの比較
- リンク:
ofox.ai/blog -
説明: トークン単位・同時実行数単位・コンソール表示のみなど、ベンダーごとに異なるレート制限の基準を比較
-
APIYI ドキュメントセンターと料金ページ:接続手順とモデル課金
- リンク:
docs.apiyi.comとdocs.apiyi.com/models - 説明: インターフェース形式、base_url の設定、各モデルの実際の価格はこちらを基準とします
作者:APIYI 技術チーム
技術交流:レート制限やフォールトトレランスの実践について、APIYI(apiyi.com)のトップページからお気軽にお問い合わせください。接続に関する資料は docs.apiyi.com のドキュメントセンターでご覧いただけます。