Anmerkung des Autors: Bei einem 429 müssen Sie nicht sofort das Modell wechseln. Dieser Artikel zeigt in 3 Prüfschritten, ob das Rate-Limit vom Upstream-Anbieter, vom Gateway oder vom Free-Tier kommt, und gibt Konfigurationstipps für exponentielles Backoff, Retry-After und Failover.
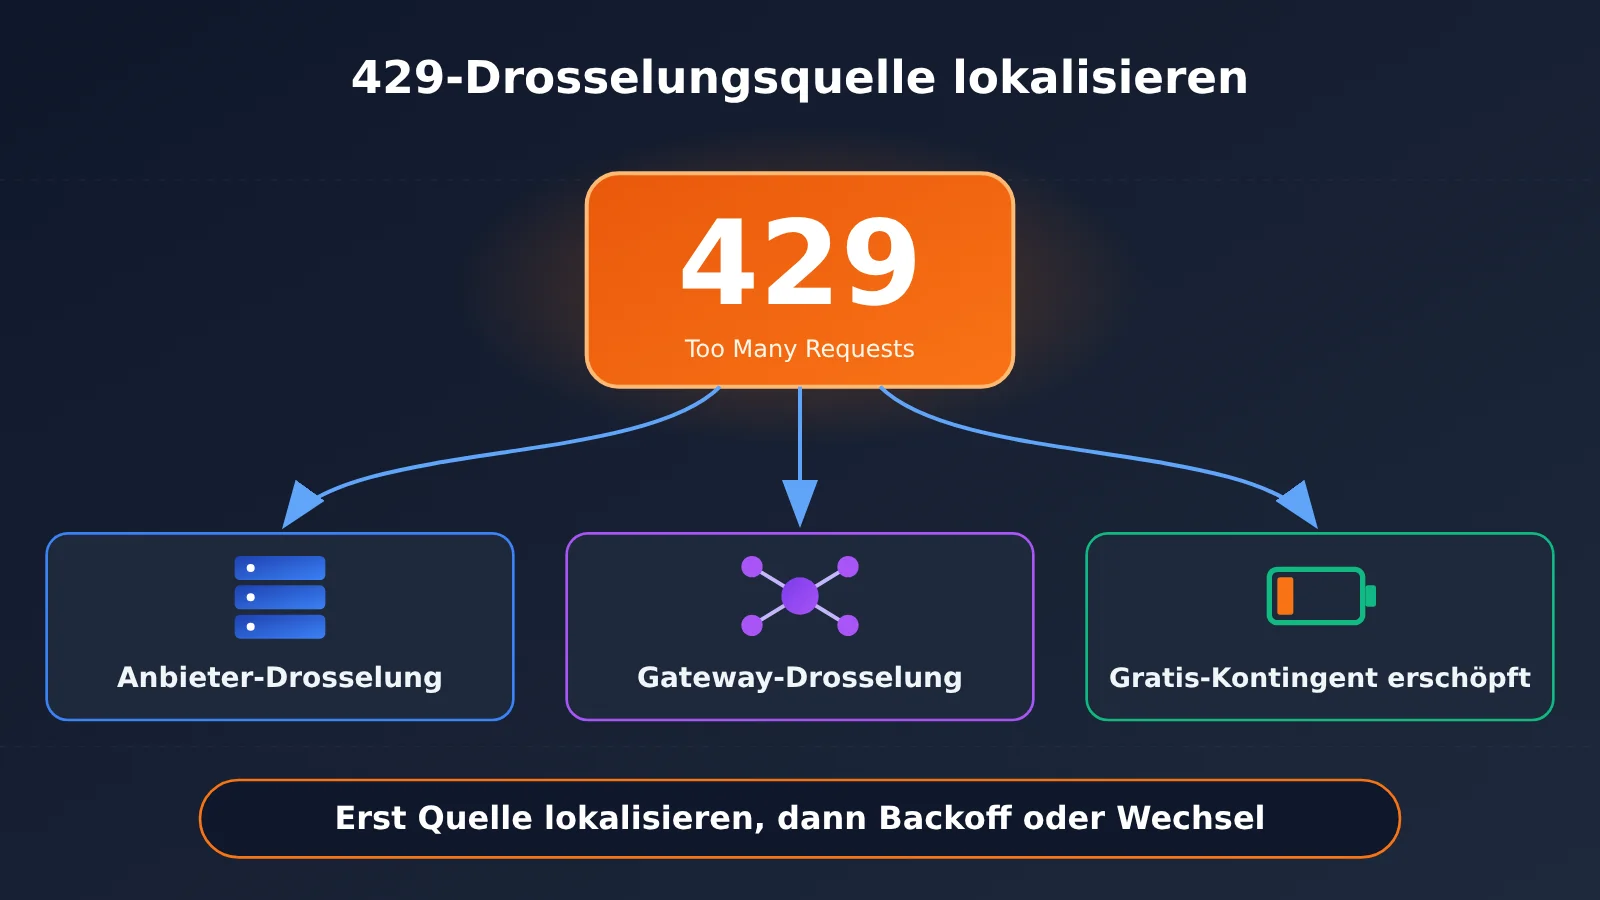
Bei nächtlichen Batch-Jobs erscheint im Log plötzlich eine Bildschirmseite voller 429 Too Many Requests. Viele denken sofort: „Dieses Modell taugt nichts, schnell ein anderes nehmen.“ Diese Schlussfolgerung wird oft zu früh gezogen. Ein 429 sagt nur: „Jemand hat dich limitiert“ – nicht, wer dich limitiert hat, und auch nicht, anhand welcher Dimension. Die Kernaussage dieses Artikels lautet: Zuerst die Quelle des Rate-Limits bestimmen, dann über Backoff oder Wechsel entscheiden.
Dies ist kein allgemeiner Artikel über Retries. Wir gehen in der Reihenfolge einer echten Fehlersuche vor, analysieren Fehlermeldungen, Response-Header und Rate-Limit-Dimensionen und geben anschließend Empfehlungen für Backoff-Parameter und die Konfiguration einer Failover-Kette.
Der zentrale Nutzen: Nach der Lektüre können Sie in wenigen Minuten einschätzen, ob ein 429 vom Upstream-Anbieter, von einem zwischengeschalteten Gateway oder vom Free-Tier-Kontingent stammt, und für Ihre Anwendung eine Fehlertoleranzstrategie konfigurieren, die nach dem Motto funktioniert: „Warten, wenn Warten angesagt ist; wechseln, wenn ein Wechsel nötig ist.“
Kernpunkte zur Bewertung von 429-Drosselungen
429 ist der HTTP-Standardstatuscode für „zu viele Anfragen“. In der Welt der Großes-Sprachmodell-APIs kann er von jeder beliebigen Ebene der Aufrufkette zurückkommen. Die folgende Tabelle fasst die drei häufigsten Quellen zusammen und zeigt, wie man jeweils richtig damit umgeht.
| Quelle der Drosselung | Typische Merkmale | Modellwechsel nötig? | Empfohlenes Vorgehen |
|---|---|---|---|
| Upstream-Modellanbieter | Der Fehlerkörper enthält die eigenen Fehlertypen und Formulierungen des Anbieters, die Response-Header enthalten dessen Rate-Limit-Felder | In der Regel nicht | Backoff gemäß Retry-After, bei Bedarf Parallelität senken oder Quota-Erhöhung beantragen |
| Zwischengeschaltetes Gateway / Aggregationsplattform | Die Fehlerformulierung stammt vom Gateway und weist auf ein Ratenlimit auf Konto- oder Gruppenebene hin | Nein | Quota- und Parallelitätseinstellungen im Gateway prüfen oder die Gateway-Gruppe wechseln |
| Kostenloser Tarif / Testkontingent | Hinweis auf kostenloses Kontingent, Tageslimit oder fehlende Kapazität | Situationsabhängig | Auf einen kostenpflichtigen Tarif upgraden oder auf ein vergleichbares Modell mit freier Kapazität wechseln |
Warum 429 nicht bedeutet, dass das Modell ausgefallen ist
Wenn das Modell selbst nicht verfügbar ist, sind Fehler aus der 5xx-Reihe das üblichere Signal. Bei Überlastung liefert Anthropic zum Beispiel 529 overloaded_error, bei Gateway- oder Load-Balancer-Problemen sind 502 und 503 üblich. Diese Statuscodes sagen, dass der Server vorübergehend nicht hinterherkommt – das ist etwas anderes als „dein Konto hat sein Kontingent überschritten“.
Ein 429 hat dagegen eine klare Zuordnung: Die Drosselungsregel richtet sich gegen dich – gegen deinen API-Schlüssel, deine Organisation, deinen kostenlosen Tarif oder die Rate, die das Gateway dir zuweist. Ein Modellwechsel hilft manchmal, um das Problem herumzukommen. Stammt die Drosselung aber aus dem Kontingent auf Gateway-Kontoebene, läufst du mit einem anderen Modell genauso gegen die Wand. Kommt sie vom Token-pro-Minute-Limit des Upstream-Anbieters, reichen ein paar Sekunden Wartezeit – ein Modellwechsel bringt dagegen nur Unsicherheit bei der Ausgabequalität.
Eine von Dritten zusammengestellte Fehlersuche zu Claude Code bestätigt genau das: Trifft Claude Code auf einen 429, zeigt es Request rejected (429) an, gefolgt vom Originalwortlaut des Servers – und dieser Wortlaut verrät dir, ob die Drosselung von Anthropic, vom Gateway oder vom kostenlosen Tarif kommt. Deshalb ist der erste Schritt bei der Fehlersuche immer, die vollständige Fehlermeldung zu lesen und nicht nur den Statuscode.
Unterschiede zwischen 429 und verwandten Statuscodes
Um verschiedene Fehler nicht miteinander zu verwechseln, listet die folgende Tabelle einige Statuscodes auf, die bei Aufrufen großer Sprachmodelle leicht mit 429 verwechselt werden.
| Statuscode | Bedeutung | Verantwortlich | Für Wiederholung geeignet | Für Failover geeignet |
|---|---|---|---|---|
| 429 | Zu viele Anfragen, Rate- oder Kontingentlimit ausgelöst | Kontingent des Aufrufers | Ja, mit Backoff | Erst nach wirkungslosem Backoff wechseln |
| 529 | Upstream überlastet (Anthropic-spezifisch) | Serverkapazität | Ja, kurzer Backoff | Ja |
| 503 | Dienst vorübergehend nicht verfügbar | Server oder Gateway | Ja | Ja |
| 500/502 | Interner Fehler oder Gateway-Fehler | Server oder Gateway | Begrenzte Wiederholungsversuche | Ja |
| 400/401/403 | Parameter-, Authentifizierungs- oder Berechtigungsproblem | Konfiguration des Aufrufers | Nein | Nein, Konfiguration muss korrigiert werden |
Ein oft übersehenes Detail in dieser Tabelle: Der fallbackModel-Mechanismus von Claude Code wird Tests von Drittanbietern zufolge nur bei einer 529-Überlastung ausgelöst und versucht dann höchstens 3 Ersatzmodelle – nicht bei 429. Das zeigt, dass die Entwickler des Tools selbst davon ausgehen, dass die erste Reaktion auf 429 Backoff sein sollte und nicht ein Modellwechsel.
Wie man erkennt, wer die 429-Drosselung verursacht: Fehlersuche in 3 Schritten
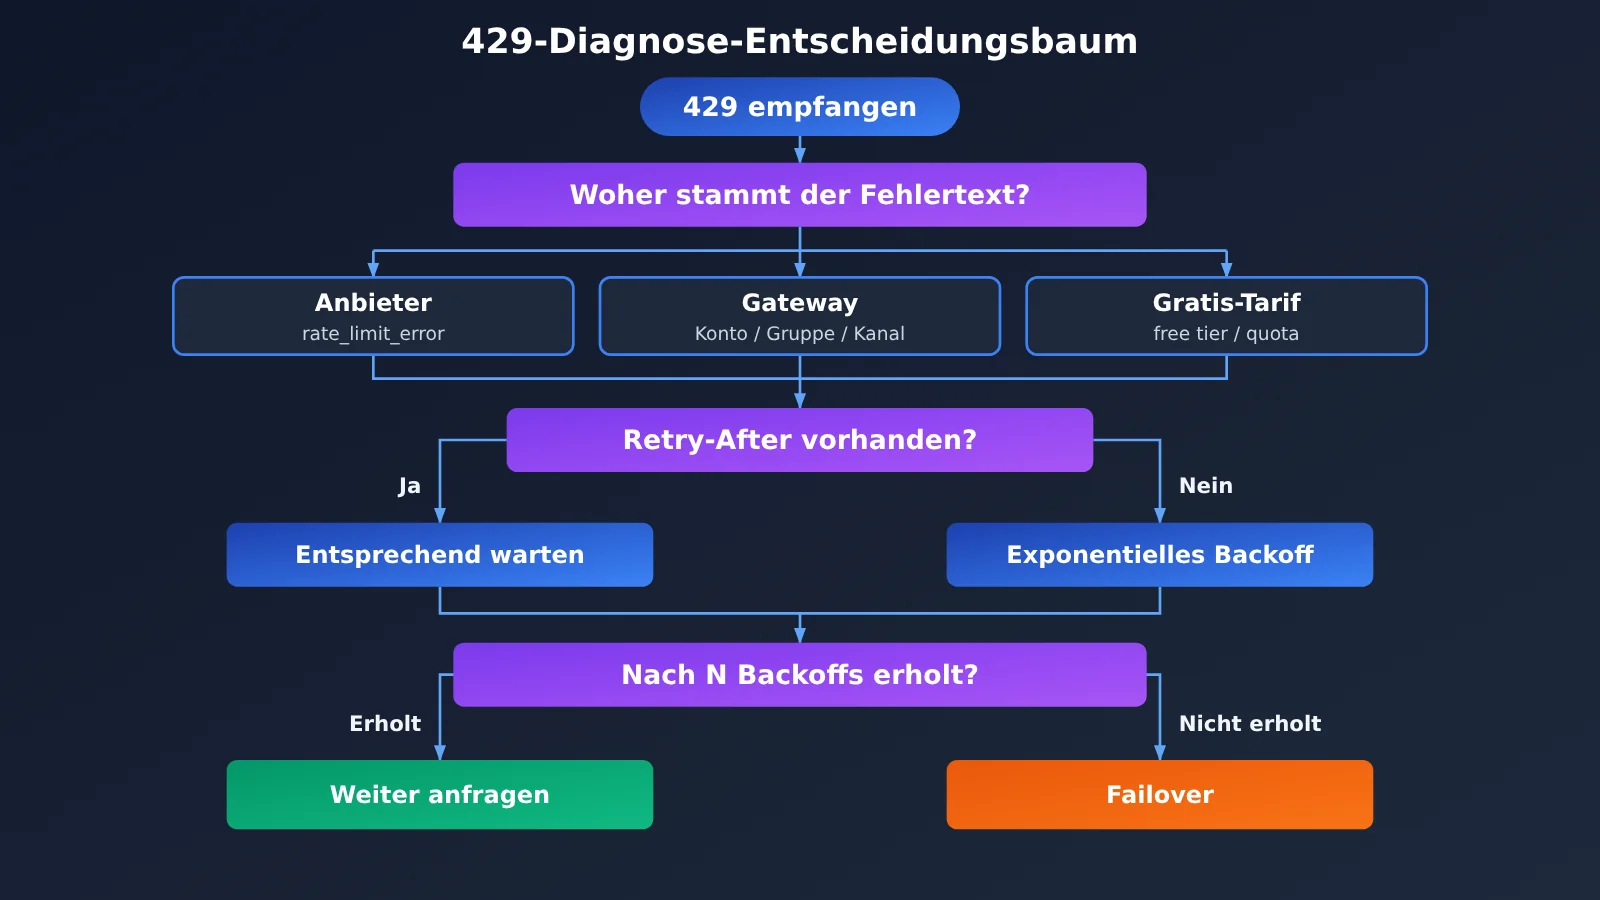
Hier ist ein 429-Diagnoseablauf, den du direkt nachvollziehen kannst. Die drei Schritte sind nach steigendem Aufwand geordnet – in den meisten Fällen lässt sich das Problem bereits im ersten Schritt lokalisieren.
Schritt 1: Den vollständigen 429-Fehlerkörper lesen
Protokolliere nicht nur den Statuscode im Log, sondern halte den Response-Body unverändert fest. 429-Antworten aus unterschiedlichen Ebenen unterscheiden sich deutlich in ihrer Formulierung – das ist der direkteste Hinweis.
- Vom Upstream-Anbieter zurückgegeben: Im Fehlerkörper steht in der Regel ein herstellerspezifisches Fehlertyp-Feld. Anthropic liefert zum Beispiel den Typ
rate_limit_error, OpenAI-kompatible Schnittstellen geben einen Fehlercode wierate_limit_exceededaus und erläutern, ob die Anzahl der Anfragen oder die Token-Menge überschritten wurde. - Vom Gateway zurückgegeben: Die Formulierung verweist oft auf gatewayeigene Konzepte wie „Konto“, „Gruppe“, „Token“ oder „Kanal“, oder der Gateway-Name wird explizit genannt.
- Vom Free-Tier zurückgegeben: Hier tauchen Begriffe wie „free tier“, „quota“, „daily limit“ oder „capacity“ auf. Bei Tests von Drittanbietern mit kostenlosen Testzugängen für bestimmte Modelle begegnet einem diese kapazitätsbedingte 429 besonders häufig.
Wenn du über einen Proxy- oder Aggregationsdienst aufrufst, achte besonders darauf, ob das Gateway den ursprünglichen Upstream-Fehler unverändert durchreicht. Wird er durchgereicht, limitiert der Upstream dich; eine eigene, nicht durchgereichte Formulierung bedeutet dagegen, dass das Gateway dich limitiert.
Schritt 2: Die 429-Response-Header prüfen
Die Response-Header sind die zweite Evidenzkette. Große Anbieter geben darin verbleibendes Kontingent und Reset-Zeit zurück; Gateways können zusätzlich eigene Felder anhängen.
| Response-Header | Häufige Quelle | Bedeutung | Nutzen bei der Fehlersuche |
|---|---|---|---|
Retry-After |
HTTP-Standard, weit verbreitet | Empfohlene Wartezeit in Sekunden | Beim Backoff bevorzugt verwenden |
x-ratelimit-remaining-requests |
API im OpenAI-Stil | Verbleibende Anfragen im aktuellen Fenster | Feststellen, ob ein RPM-Limit vorliegt |
x-ratelimit-remaining-tokens |
API im OpenAI-Stil | Verbleibende Tokens im aktuellen Fenster | Feststellen, ob ein TPM-Limit vorliegt |
anthropic-ratelimit-requests-remaining |
Anthropic | Verbleibende Anfragen | Bestätigen, dass die Limitierung von Anthropic kommt |
anthropic-ratelimit-input-tokens-remaining |
Anthropic | Verbleibende Input-Tokens | Feststellen, ob ein Input-Token-Limit vorliegt |
Die Faustregel ist einfach: Taucht ein Rate-Limit-Header mit Anbieterpräfix auf und ist der verbleibende Wert 0, kannst du ziemlich sicher davon ausgehen, dass der vorgelagerte Anbieter dich limitiert. Gibt es überhaupt keine anbieterspezifischen Rate-Limit-Header, sondern nur eigene Gateway-Felder oder gar nichts, ist die Gateway-Ebene wahrscheinlicher. Zu beachten ist, dass einige Anbieter konkrete Limits in den letzten Jahren nur noch in der Konsole anzeigen; die Informationen in den Response-Headern können dann unvollständig sein. In diesem Fall solltest du auf die Fehlerformulierung aus Schritt 1 und den Dimensionsvergleich aus Schritt 3 zurückgreifen.
Schritt 3: Die Drosselungsdimensionen vergleichen
Wenn du weißt, wer dich drosselt, musst du als Nächstes klären, was genau gedrosselt wird. Die Regeln unterscheiden sich von Anbieter zu Anbieter. Eine Gegenüberstellung von fünf Anbietern durch Dritte zeigt: Anthropic limitiert vor allem über die Token-Anzahl pro Minute, wobei Tokens aus Cache-Treffern nicht auf das Limit angerechnet werden. DeepSeek begrenzt hauptsächlich die Anzahl gleichzeitiger Anfragen. Bei OpenAI und Google finden sich die konkreten Kontingente eher in der Konsole.
Das hat direkte Auswirkungen auf die Konfigurationsstrategie. Die üblichen Zuordnungen sehen so aus:
- RPM (Requests pro Minute) überschritten: Mehrere kleine Anfragen zu einer Batch-Anfrage bündeln oder clientseitig mit einem Token-Bucket für gleichmäßigen Versand sorgen.
- TPM (Tokens pro Minute) überschritten: Kontext kürzen, Prompt-Caching aktivieren, lange Dokumentaufgaben auf verschiedene Zeitfenster verteilen.
- Gleichzeitige Anfragen überschritten: Anzahl der Worker reduzieren und die Zahl der gleichzeitig laufenden Anfragen per Queue begrenzen – reines Backoff bringt hier wenig.
- Tageskontingent oder kostenloses Volumen ausgeschöpft: Backoff ist sinnlos. Du kannst nur auf den Reset warten, ein höheres Tarifpaket buchen oder auf einen anderen Kanal wechseln.
Fall 4 ist der einzige 429, bei dem „Backoff garantiert nichts bringt“ – und genau deshalb der Fall, den du möglichst früh erkennen und direkt in einen Failover überführen solltest.
Wie man eine 429-Backoff-Strategie konfiguriert
Wenn bestätigt ist, dass es sich bei der 429 um eine behebbare Ratenbegrenzung handelt, beginnt die Backoff-Phase. Das Ziel des Backoffs ist nicht „so schnell wie möglich erneut versuchen“, sondern „so schnell wie möglich wiederherstellen, ohne die Überlastung zu verschärfen“.
Exponentielles Backoff mit zufälligem Jitter
Die gängigste Lösung ist exponentielles Backoff (Exponential Backoff) kombiniert mit zufälligem Jitter. Die Wartezeit beim n-ten Wiederholungsversuch beträgt etwa „Basisverzögerung × 2 hoch n“, dazu kommt ein Zufallswert, und es wird eine Obergrenze festgelegt. Der Zweck des zufälligen Jitters ist, die Wiederholungszeitpunkte mehrerer Clients zu streuen, damit sie nicht in derselben Sekunde gleichzeitig einprasseln und einen „Retry-Sturm“ auslösen.
Enthält die Antwort einen Retry-After-Header, sollte dieser Vorrang vor der selbst berechneten Backoff-Zeit haben. Der Server weiß besser als du, wann das Zeitfenster zurückgesetzt wird – auf seine Empfehlung zu warten ist meist der schnellste Weg zur Wiederherstellung.
Empfohlene Werte für die Backoff-Parameter
Die folgende Tabelle zeigt eine Reihe von Startparametern, die für die meisten Dialog- und Batch-Szenarien geeignet sind. In der Praxis lassen sie sich je nach Latenztoleranz des Geschäftsfalls anpassen.
| Parameter | Empfohlener Startwert | Beschreibung |
|---|---|---|
| Basisverzögerung | 1 Sekunde | Wartezeit vor dem ersten Wiederholungsversuch |
| Backoff-Multiplikator | 2 | Wartezeit verdoppelt sich bei jedem Wiederholungsversuch |
| Maximale Einzelwartezeit | 30-60 Sekunden | Verhindert unbegrenztes Anwachsen der Wartezeit |
| Maximale Anzahl Wiederholungen | 3-5 | Danach Failover oder Fehlermeldung |
| Zufälliger Jitter | 0-100 % der Wartezeit als Zufall | „Full Jitter“ empfohlen, um Wiederholungen zu streuen |
| Retry-After | Falls vorhanden, priorisiert | Überschreibt die selbst berechnete Backoff-Zeit |
Zwei Konfigurationsdetails werden oft übersehen. Erstens: In interaktiven Szenarien (etwa einer Chat-Oberfläche) sollte die gesamte Wartezeit nicht zu lang sein. Setze ein Gesamt-Timeout-Budget; wird es überschritten, wechsle direkt den Dienst oder informiere den Nutzer. Zweitens: Bei Konfigurationsfehlern wie 400, 401 oder 403 sollte man kein Backoff-Retry durchführen – sie werden sich auch nach noch so langem Warten nicht von selbst bessern, sondern verschwenden nur Zeit und Kontingent.
Wenn du das offizielle SDK verwendest, bringen viele SDKs bereits automatische Wiederholungen für 429 und 5xx mit, üblicherweise gesteuert über einen Parameter wie max_retries. Prüfe zuerst das Standardverhalten des SDK, bevor du selbst eine weitere Wiederholungsschicht darüberlegst – sonst können sich zwei Retry-Ebenen überlagern und die tatsächliche Anzahl der Wiederholungen vervielfachen.
Wie man Failover bei 429 konfiguriert
Backoff bedeutet „an Ort und Stelle warten“, Failover heißt „einen anderen Weg nehmen“. Das ist keine Entweder-oder-Entscheidung, sondern eine Reihenfolge: zuerst Backoff, und wenn der nichts bringt, umschalten.
Wann Failover ausgelöst werden sollte
Wir empfehlen, erst umzuschalten, wenn eine der folgenden Bedingungen erfüllt ist – und nicht sofort bei jedem 429:
- Die maximale Anzahl an Wiederholungen ist erreicht und es kommen weiterhin 429-Antworten zurück;
- Die Fehlermeldung deutet eindeutig auf ein Tageskontingent, ein aufgebrauchtes Gratis-Kontingent oder „unzureichende Kapazität“ hin;
- Die von
Retry-Aftervorgegebene Wartezeit überschreitet die Obergrenze, die das Geschäft akzeptieren kann; - Derselbe Kanal schlägt in kurzer Zeit mehrfach hintereinander fehl und erreicht damit die Circuit-Breaker-Schwelle.
Drittanbieter empfehlen für den häufigen 429-Fall bei einem beliebten Modell auf OpenRouter dieselbe Vorgehensweise: erst Backoff, dann Failover auf andere Modelle unter derselben Schnittstelle. Diese Reihenfolge sichert sowohl die Ausgabequalität des ursprünglichen Modells als auch die durchgehende Verfügbarkeit des Dienstes.
Drei Designs für die Umschaltkette
Für die „Ausweichroute“ beim Failover gibt es verschiedene Ebenen. Die Umschaltkosten steigen in dieser Reihenfolge:
- Gleiches Modell, anderer Kanal: Dasselbe Modell, aber ein anderer API-Schlüssel, eine andere Gruppe oder ein anderer Anbieter. Die Ausgabekonsistenz ist am besten – das ist die erste Wahl.
- Gleicher Hersteller, andere Stufe: Zum Beispiel vom Flaggschiffmodell auf ein leichteres Modell derselben Serie. Die Fähigkeiten sinken etwas, der Stil bleibt aber ähnlich.
- Herstellerübergreifend anderes Modell: Wechsel zu einem gleichwertigen Modell eines anderen Anbieters. Die Verfügbarkeit ist am höchsten, aber Prompt-Wirkung und Ausgabeformat müssen vorher geprüft werden.
Darüber hinaus empfiehlt sich eine zusätzliche Ebene: ein Circuit Breaker. Überschreitet ein Kanal die Fehlerschwelle, wird er für eine Abklingzeit direkt übersprungen. Nach Ablauf der Abklingzeit schickt man einige wenige Testanfragen und gibt danach schrittweise wieder mehr Last frei. So vermeidet man, dass jede einzelne Anfrage erst gegen die Wand läuft und dann umschaltet – das senkt die Gesamtlatenz deutlich.
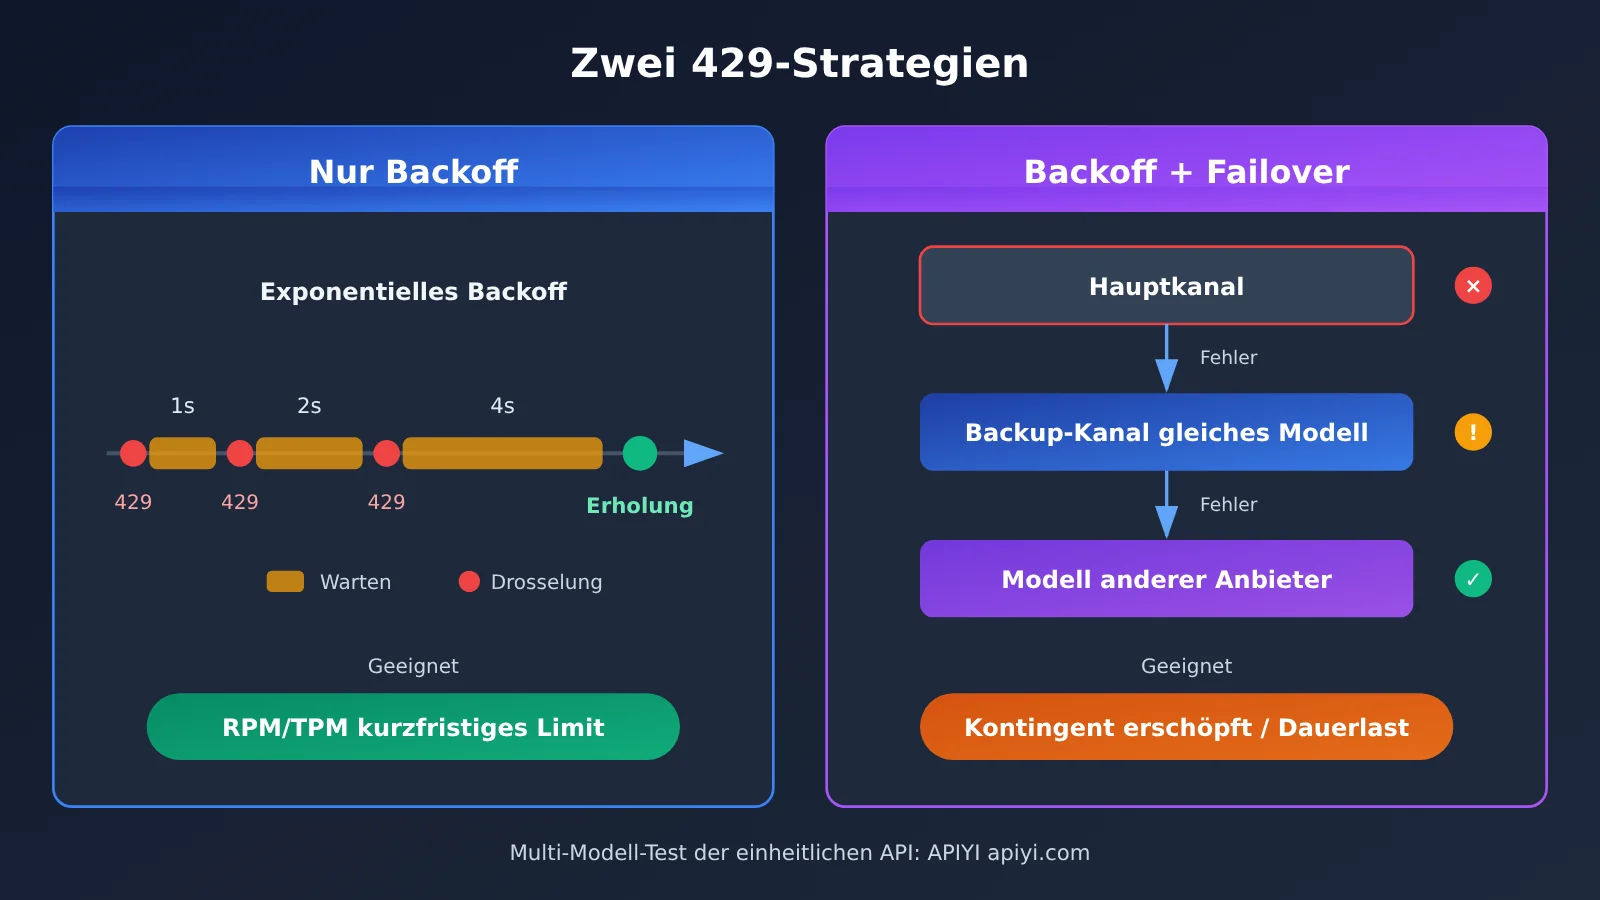
Die beiden oben verglichenen Strategien lassen sich im realen Projekt über dieselbe einheitliche Schnittstelle testen. Auf Plattformen wie APIYI, die sowohl das OpenAI- als auch das Anthropic-Schnittstellenformat unterstützen, genügt bei ein und demselben Code eine Änderung des Parameters model, um auf ein Ersatzmodell zu wechseln – deutlich weniger Aufwand, als für jeden Hersteller ein eigenes SDK zu pflegen.
Schnellstart: Umgang mit 429-Rate-Limiting
Im Folgenden wird der vorherige Inhalt zu einer Konfigurationscheckliste zusammengefasst, die Sie direkt als Referenz für die Umsetzung verwenden können. Der gesamte Text enthält keinen Code; Sie können ihn als Checkliste für Code-Reviews oder Betriebskonfigurationen nutzen.
Checkliste mit 5 Konfigurationspunkten
- Protokollierung: Vollständigen Response-Body und die Response-Header erfassen, mindestens Statuscode, Fehlertyp, Fehlermeldungstext,
Retry-Aftersowie alleratelimit-Felder. - Klassifizierung: Fehler clientseitig in drei Kategorien einteilen: „mit Backoff wiederholbar“ (429-Ratenfehler, 529, 503), „Wechsel erforderlich“ (Kontingent erschöpft, anhaltende Fehler) und „nicht wiederholbar“ (400, 401, 403).
- Backoff: Gemäß der Parametertabelle oben exponentielles Backoff mit Full Jitter konfigurieren,
Retry-Afterbevorzugen und eine maximale Anzahl an Wiederholungen sowie ein Gesamt-Timeout-Budget festlegen. - Wechselkette: In der Reihenfolge „gleiches Modell, anderer Kanal → gleicher Anbieter, andere Modellstufe → anbieterübergreifender Modellwechsel“ eine Fallback-Liste konfigurieren und die Wirkung der Eingabeaufforderung für jedes Ausweichmodell vorab prüfen.
- Circuit Breaker und Alarmierung: Für jeden Kanal eine Fehlerschwelle und eine Abklingzeit festlegen; zugleich einen Alarm für den 429-Anteil einrichten. Ist der Wert dauerhaft erhöht, deutet dies darauf hin, dass eine Kontingenterhöhung beantragt oder die Parallelität angepasst werden muss.
Beispiel für eine Fallback-Modellkette
Die folgende Tabelle zeigt eine übliche dreistufige Wechselkette. Die konkreten Modellnamen richten sich nach der Modellliste der Plattform; für die Abrechnung gelten die Angaben auf der Preisseite. In diesem Artikel werden keine konkreten Einzelpreise genannt.
| Ebene | Auswahlprinzip | Schnittstellenformat | Verfügbare Plattform | Preisbasis |
|---|---|---|---|---|
| Primär | Flaggschiffmodell mit der besten fachlichen Wirkung | OpenAI- oder Anthropic-Format | APIYI apiyi.com, offizielle API | gemäß docs.apiyi.com/models |
| Fallback Stufe 1 | Anderer Kanal oder eine andere Gruppe desselben Modells | wie beim Primärmodell | APIYI apiyi.com, offizielle API | gemäß docs.apiyi.com/models |
| Fallback Stufe 2 | Leichtgewichtiges Modell desselben Anbieters oder gleichwertiges Modell eines anderen Anbieters | OpenAI-kompatibles Format | APIYI apiyi.com und andere Aggregator-Plattformen | gemäß docs.apiyi.com/models |
Bei der Integration müssen Sie bei den offiziellen OpenAI- oder Anthropic-SDKs in der Regel nur base_url auf die von der Plattform bereitgestellte Adresse und api_key auf den Plattformschlüssel ändern. Für konkrete Schnittstellenadressen und Aufrufhinweise zu den einzelnen Modellen sollten Sie sich an das Dokumentationszentrum von APIYI unter docs.apiyi.com halten und keine ungeprüften Adressen aus dem Internet übernehmen.
🚀 Schnellstart: Beim Aufbau einer 429-fehlertoleranten Kette empfiehlt es sich, zuerst über APIYI apiyi.com mit demselben Code das Primärmodell und die Ausweichmodelle anzubinden. Die Plattform bietet API-Aufrufe für die in diesem Artikel behandelten gängigen Modelle und ist mit den Schnittstellenformaten von OpenAI und Anthropic kompatibel; beim Modellwechsel muss nur der Parameter
modelgeändert werden. Die Integrationsdokumentation finden Sie unter docs.apiyi.com. Die tatsächlichen Ein- und Ausgabepreise pro Modell, die Cache-Preise und die Abrechnungsgrundlagen richten sich nach den aktuellen Daten auf der Preisseite docs.apiyi.com/models.
Häufige Fragen (FAQ)
F1: Was ist die 429-Drosselung?
429 ist der Statuscode „Too Many Requests“ aus dem HTTP-Standard und bedeutet, dass der Aufrufer innerhalb eines bestimmten Zeitfensters die erlaubte Anzahl an Anfragen, Tokens, parallelen Verbindungen oder das Gesamtkontingent überschritten hat. Er sagt also aus: „Du wurdest begrenzt“ – und nicht, dass das Modell selbst gestört ist.
F2: Worin unterscheiden sich 429, 529 und 503?
429 weist auf ein Kontingentproblem beim Aufrufer hin – die Verantwortung liegt bei „du hast zu viel genutzt“. 529 ist der Überlastungsfehler von Anthropic, 503 bedeutet, dass der Dienst vorübergehend nicht verfügbar ist; beide liegen in der Verantwortung der Serverkapazität. Beim ersten Fall hilft vor allem Backoff und das Anpassen der Nutzung, bei den beiden anderen ist nach kurzem Backoff ein direkter Failover sinnvoller.
F3: Wie erkenne ich am schnellsten, ob ein 429 vom Upstream-Anbieter oder vom Gateway kommt?
Schau zuerst auf die Formulierung im Fehlerkörper: Fehler mit einem Anbieter-Fehlertyp stammen meist vom Upstream, Erwähnungen von Konto, Gruppe oder Kanal meist vom Gateway. Dann prüf die Response-Header: Taucht ein `ratelimit`-Feld mit Anbieter-Präfix auf und ist der Restwert 0, kannst du ziemlich sicher davon ausgehen, dass der Upstream drosselt.
F4: Warum erholt sich ein 429 trotz vieler Backoff-Versuche nicht?
Die häufigste Ursache ist eine falsch eingeschätzte Drosselungsdimension. Ist das Tageskontingent oder das kostenlose Guthaben aufgebraucht, bringt Backoff zwangsläufig nichts; ist die Zahl der parallelen Verbindungen überschritten und der Client sendet weiterhin mit hoher Parallelität, kann Backoff höchstens lindern. In dem Fall solltest du die Parallelität senken oder direkt auf Failover umschalten.
F5: Wie baue ich schnell eine Failover-Kette über mehrere Modelle auf?
Empfohlen ist eine Plattform mit einheitlicher Schnittstelle für mehrere Modelle, um das zu testen:
1. Registriere ein Konto bei APIYI apiyi.com und hole dir einen API-Schlüssel;
2. Konfiguriere `base_url` nach der Dokumentation unter docs.apiyi.com und binde das Ganze im OpenAI- oder Anthropic-Format ein;
3. Lege im Client eine Liste aus Primär- und Ausweichmodellen an und wechsle durch Ändern des `model`-Parameters.
So teilen sich Primär- und Ausweichmodell denselben Code, und die Testkosten für die Failover-Kette sind deutlich geringer.
F6: Kann Failover die Kosten außer Kontrolle bringen?
Möglich ist das. Stückpreis, Kontextlänge und Caching-Strategie des Ausweichmodells können sich vom Primärmodell unterscheiden, häufiges Umschalten verändert die Abrechnungsstruktur. Prüfe am besten vorab die Preise für jedes Ausweichmodell, orientiere dich einheitlich an den tatsächlichen Daten auf der APIYI-Preisseite docs.apiyi.com/models und setze eine Warnung für die Wechselquote.
F7: Welche bekannten Grenzen haben 429-Behandlungsstrategien?
Backoff erhöht die Anfrage-Latenz und eignet sich nicht für Szenarien mit extrem hohen Echtzeitanforderungen; ein Wechsel zwischen Anbietern kann Unterschiede in Ausgabestil und -format mit sich bringen, was vorab Regressionstests erfordert; manche Anbieter zeigen Limits nur in der Konsole und liefern unvollständige Header-Informationen, sodass bei der Fehlersuche nur die Fehlerformulierung und Monitoring-Daten bleiben.
429-Rate-Limiting: Die wichtigsten Punkte
- 429 bedeutet nur, dass eine Begrenzung greift: Es sagt nicht, wer begrenzt oder was genau begrenzt wurde – es ist also nicht automatisch ein Modellfehler.
- Zuerst den genauen Wortlaut der Fehlermeldung lesen: Die Formulierung im Fehlerkörper ist der schnellste Hinweis darauf, ob die Begrenzung vom Upstream-Anbieter, vom Gateway oder von der kostenlosen Stufe kommt.
- Dann die Response-Header prüfen: Herstellerpräfixte
ratelimit-Felder undRetry-Afterbilden die zweite Beweiskette. - Je nach Dimension gezielt behandeln: RPM gleichmäßig verteilen, bei TPM den Kontext verkleinern, Parallelität über Worker begrenzen, bei erschöpftem Kontingent direkt wechseln.
- Erst Backoff, dann Wechsel: Exponentielles Backoff mit vollständigem Jitter,
Retry-Afterhat Vorrang, Retries haben eine Obergrenze. - Wechselkette mehrschichtig aufbauen: Vorrangig beim selben Modell den Kanal wechseln, als Fallback anbieterübergreifend das Modell wechseln – kombiniert mit einem Circuit Breaker.
- Kosten mit einer einheitlichen Schnittstelle senken: Über APIYI, mit Schnittstellen, die sowohl mit OpenAI- als auch mit Anthropic-Formaten kompatibel sind, lassen sich Primär- und Backup-Modell mit einer Codebasis verwalten.
Zusammenfassung
Bei einem 429 ist die richtige Reihenfolge „Quelle lokalisieren → Dimension bestimmen → Backoff → Wechseln“ – und nicht sofort das Modell austauschen:
- Quelle lokalisieren: Anhand der Formulierung im Fehlerkörper und der Response-Header unterscheiden, ob der Upstream-Anbieter, das Gateway oder die kostenlose Stufe begrenzt.
- Dimension bestimmen: Klären, ob es um die Anzahl der Anfragen, die Token-Anzahl, die Parallelität oder das Gesamtkontingent geht – das entscheidet, ob Backoff überhaupt hilft.
- Fehlertoleranz konfigurieren: Exponentielles Backoff mit Jitter als erste Verteidigungslinie, mehrschichtiges Failover mit Circuit Breaker als zweite.
Wenn Sie diesen Ablauf in Logging, Fehlerklassifizierung und Client-Konfiguration verankern, wird aus einem 429 ein vorhersehbares, selbstheilendes Routineereignis statt eines Alarms mitten in der Nacht.
Zum schnellen Prüfen des Failovers zwischen Primär- und Backup-Modell empfehlen wir APIYI unter apiyi.com. Die Integrationshinweise finden Sie unter docs.apiyi.com; maßgeblich für Modellpreise und Abrechnungsdetails ist docs.apiyi.com/models.
📚 Referenzen
- Rate Limit Reached in Claude Code: What Each 429 Message Means: Interpretation der Bedeutung von 429-Fehlermeldungen in Claude Code
- Link:
ofox.ai/blog -
Beschreibung: Erläutert, wie man anhand der Originalaussage des Servers zwischen Ratenbegrenzung durch Anthropic, Gateway und kostenlosem Tarif unterscheidet
-
Claude Code fallbackModel: 3-Tier Failover Setup: Konfiguration eines Ausweichmodells in Claude Code
- Link:
ofox.ai/blog -
Beschreibung: Weist darauf hin, dass fallbackModel bei einer 529-Überlastung ausgelöst wird, maximal 3 Modelle umfasst und nicht bei 429 greift
-
LLM API Rate Limits Compared: Vergleich der Ratenbegrenzungsregeln von 5 Anbietern großer Sprachmodelle
- Link:
ofox.ai/blog -
Beschreibung: Vergleicht unterschiedliche Messgrößen der Ratenbegrenzung – nach Token, nach Parallelität sowie solche, die nur in der Konsole angezeigt werden
-
APIYI Dokumentationszentrum und Preisseite: Integrationshinweise und Modellabrechnung
- Link:
docs.apiyi.comunddocs.apiyi.com/models - Beschreibung: Schnittstellenformat, base_url-Konfiguration und tatsächliche Preise der einzelnen Modelle – maßgeblich sind diese Angaben
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI apiyi.com, um sich über Ratenbegrenzung und Fehlertoleranz auszutauschen. Weitere Integrationsunterlagen finden Sie im Dokumentationszentrum unter docs.apiyi.com