Vamos directo a la conclusión. En APIYI, para generar imágenes por lotes, en tareas habituales usa por defecto gpt-image-2.5-all, en el grupo Default; se puede invocar tanto con token por llamada como con token por consumo, con un precio de lista de 0.025 USD/imagen. Si necesitas fijar un tamaño concreto o 4K, cambia el nombre del modelo por uno de tipo -vip, como gpt-image-2.5-vip, con un precio de lista de 0.03 USD/imagen. Sin embargo, la propia página de -all indica que el 4K de -vip tiene fluctuaciones de estabilidad, así que no es la primera opción para 4K. Si necesitas los niveles oficiales de quality, repintado local con máscara o cualquier tamaño válido, usa el canal oficial con proxy. Para proyectos nuevos, prioriza gpt-image-2.6-flare (prioriza velocidad) y gpt-image-2.6-sunburst (prioriza edición y precisión).
El fallback tiene dos casos. Si el canal oficial con proxy devuelve 429 de forma persistente o se satura en el grupo Default, cambia el grupo del token a image2Enterprise; no hace falta cambiar el nombre del modelo. Si el canal inverso oficial se topa con una falla de la versión web de ChatGPT o del servicio original de Adobe, no reintentes con backoff una y otra vez sobre la misma ruta inversa: cambia el nombre del modelo por uno del canal oficial con proxy y confirma que el token esté en «prioridad por consumo». Además, hay dos tipos de errores que no se deben reintentar tal cual: los rechazos por seguridad de contenido y los errores de parámetros. También ojo con el parámetro n: en -all te cobran n veces, pero solo devuelve 1 imagen.
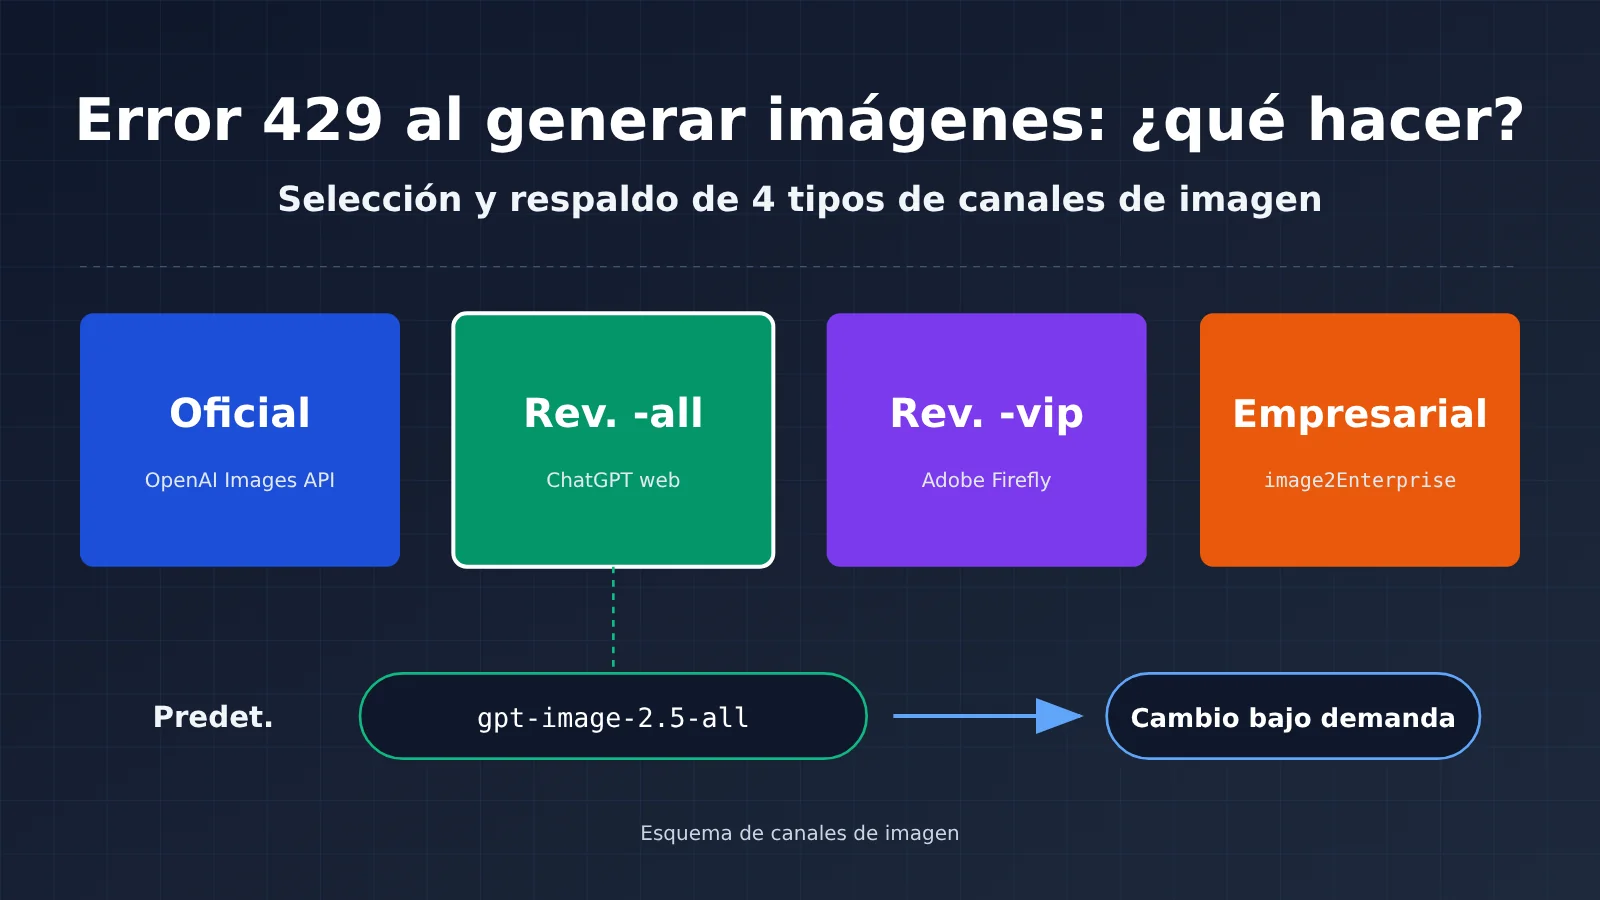
¿Cuáles son los cuatro nombres del canal de imágenes de GPT?
Un mismo modelo de imágenes GPT puede aparecer en la lista con varios sufijos, que corresponden al origen upstream y a la forma de facturación. Eso sí, el «grupo empresarial» no es un modelo, sino una opción de enrutamiento del token. A continuación los explico uno por uno con los términos que usa la documentación:
- Oficial directo (官转): conexión directa oficial a OpenAI Images API. La documentación indica que las solicitudes y respuestas son idénticas a las oficiales de OpenAI. En la tabla general de precios, los modelos de imagen del canal oficial directo son
gpt-image-2.6-flare,gpt-image-2.6-sunburst,gpt-image-2.5-flare,gpt-image-2.5-sunburst, las instantáneas con fecha de ambosgpt-image-2.5-flare-2026-09-08ygpt-image-2.5-sunburst-2026-09-08, y el modelo de la generación anteriorgpt-image-2. La documentación recomienda dar prioridad a flare para texto a imagen y a sunburst para edición y fusión de varias imágenes. En producción se puede fijar la instantánea con fecha para evitar que cambie el destino del alias. - Oficial inverso -all (官逆 -all): ingeniería inversa de la versión web de ChatGPT.
gpt-image-2-allygpt-image-2.5-allcuestan lo mismo, se comportan igual y son intercambiables. La razón es que la versión web de ChatGPT ya se actualizó por completo a Images 2.5, así quegpt-image-2-alltambién genera imágenes de 2.5. La documentación recomienda que los proyectos nuevos usen directamentegpt-image-2.5-all. - Oficial inverso -vip (官逆 -vip): línea de ingeniería inversa de Adobe (Firefly). Los modelos son
gpt-image-2-vip,gpt-image-2.5-flare-vipygpt-image-2.5-sunburst-vip. El aliasgpt-image-2.5-vipapunta agpt-image-2.5-sunburst-vip. - Grupo empresarial
image2Enterprise: grupo empresarial de contingencia del canal oficial directo en el upstream de OpenAI. Las preguntas frecuentes aclaran explícitamente que no es Google Vertex ni una línea de aceleración para reducir el tiempo de generación de imágenes. Su función es ofrecer otro pool de recursos cuando el grupo predeterminado está congestionado, pero no garantiza que el upstream esté siempre disponible.
Hay otro grupo que fácilmente se confunde con uno de contingencia: image2_OSS. Es un grupo de 1x, sin recargo, y tiene un solo propósito: garantizar que se devuelva una URL y que no se degrade a base64. No mejora la estabilidad y aplica a -all y -vip.
Por ahora, la versión 2.6 solo existe como oficial directo. En la tabla general de precios y en la API de precios del 2026-11-10 no aparecen gpt-image-2.6-all, gpt-image-2.6-vip ni nombres similares. Para modelos y precios, la referencia es la lista de modelos de la plataforma.
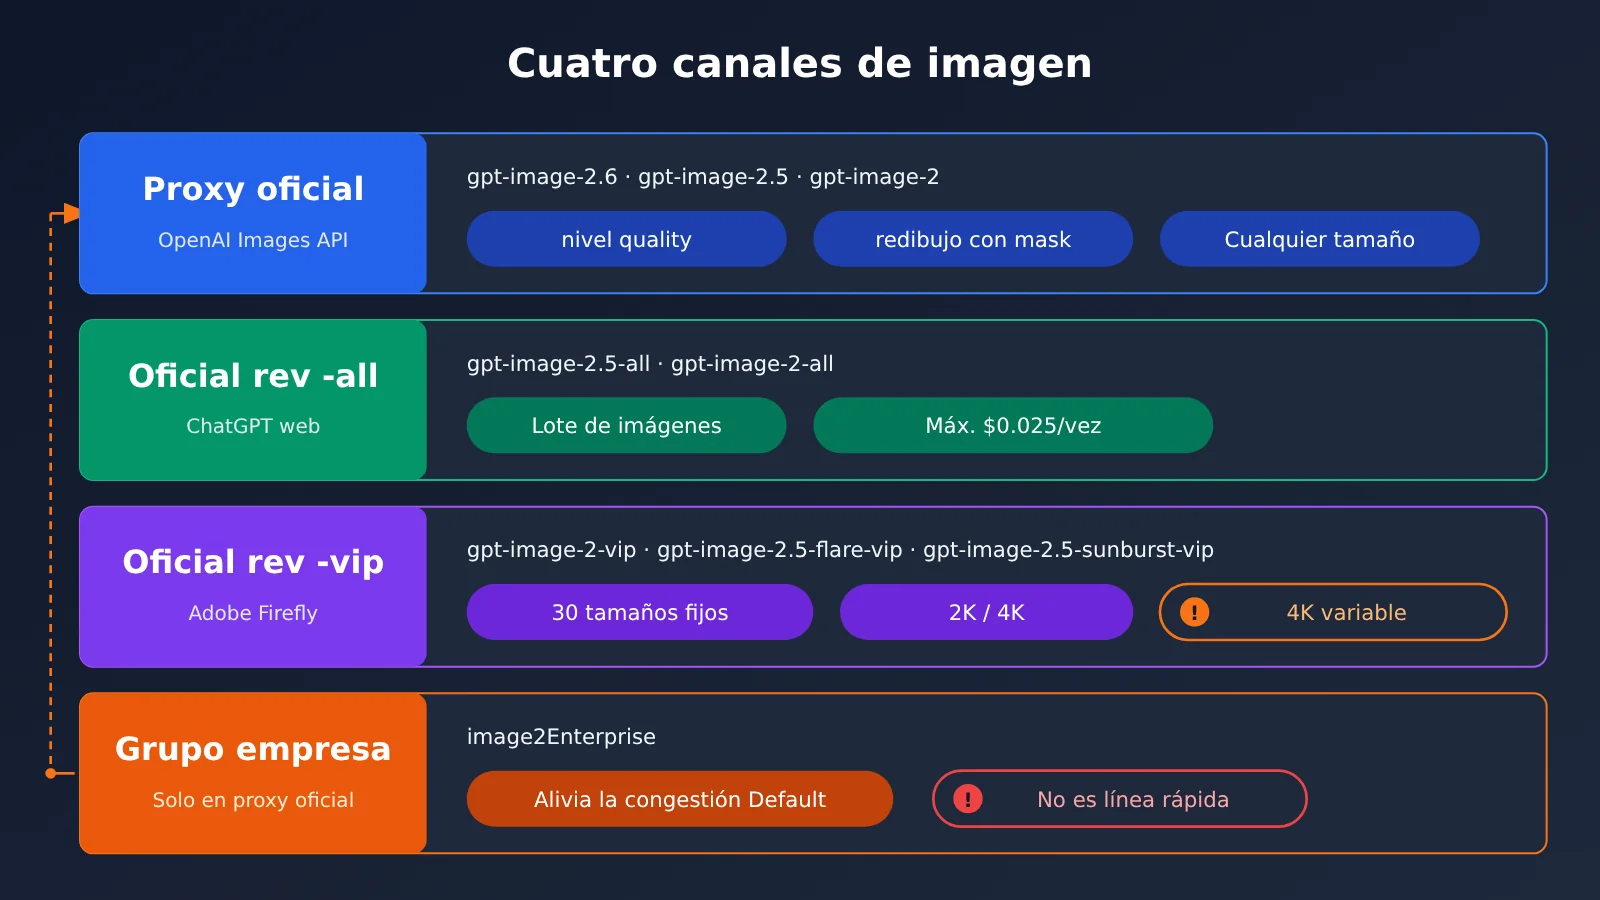
Elección del canal de imagen predeterminado según el escenario: tabla comparativa de precios y capacidades
Al elegir un canal, primero conviene responder tres preguntas: si necesitas los niveles de calidad oficiales, qué tan estrictos son los requisitos de tamaño y si el costo debe tener un tope por imagen. Puedes seguir este orden:
- Generación de imágenes por lotes, costo con tope por imagen y lado largo entre 512 y 1536: usa
gpt-image-2.5-all. Criterio de aceptación: el ancho y alto reales de la imagen devuelta coinciden con lo esperado, y el cargo en la consola por cada llamada es igual al precio unitario multiplicado por el número de llamadas. - Necesitas un tamaño fijo de los 30 niveles disponibles, o requieres 2K o 4K: cambia a un modelo -vip y pasa
sizede forma explícita. Criterio de aceptación: toma como referencia el ancho y alto reales de la imagen devuelta, no solo los parámetros de la solicitud. - Necesitas
qualityoficial, repintado local conmask, fondo transparente, cualquier tamaño válido o alinearte con los campos de OpenAI: usa el canal oficial. Para proyectos nuevos, usa 2.6; si necesitas bloquear el comportamiento, usa la instantánea 2.5 con fecha. Criterio de aceptación: los campos de la solicitud coinciden con la tabla de parámetros oficiales del modelo objetivo y no aparece un error 400.
Tabla comparativa de precios de canales de imagen
La facturación y los precios de lista de la siguiente tabla provienen de la tabla general de precios (actualizada el 2026-11-09) y son precios antes del descuento. Tras la recarga con bonificación de un 10% a un 20%, el cargo real será menor; el valor definitivo es el que indique la consola. Para consultar todos los modelos y precios, visita docs.apiyi.com/models.
| Modelo | Tipo de canal | Facturación | Precio de lista (antes del descuento) | Grupos disponibles |
|---|---|---|---|---|
gpt-image-2.6-flare / gpt-image-2.6-sunburst |
Oficial (disponible desde el 2026-11-05) | Por consumo | Por millón de tokens: entrada de texto 5, entrada de imagen 8, salida 30 USD | Default, image2Enterprise, image2_OSS, SVIP |
gpt-image-2.5-flare / gpt-image-2.5-sunburst y las instantáneas del 2026-09-08 |
Oficial | Por consumo | Igual que arriba; lectura de caché: texto 1.25, imagen 2 USD | Default, image2Enterprise, image2_OSS, SVIP |
gpt-image-2 |
Oficial (generación anterior) | Por consumo | Igual que arriba | Default, image2Enterprise, image2_OSS, SVIP |
gpt-image-2.5-all / gpt-image-2-all |
Canal inverso oficial de la versión web de ChatGPT | Por llamada | 0.025 USD/llamada | Default, image2_OSS, SVIP |
gpt-image-2.5-vip y otros 3 nombres -vip |
Canal inverso oficial de Adobe Firefly | Por llamada | 0.03 USD/llamada | Default, image2_OSS, SVIP |
La API de precios y la tabla general de precios no coinciden en un punto, así que hay que revisarlas por separado. En la API de precios, gpt-image-2, gpt-image-2.5-flare y gpt-image-2.5-sunburst tienen quota_type igual a 1 y model_price igual a 0.2. En cambio, gpt-image-2.6-flare, gpt-image-2.6-sunburst y las dos instantáneas del 2026-09-08 tienen quota_type igual a 0 y model_price igual a 0. La tabla general de precios, por su parte, marca todos estos modelos del canal oficial como de pago por consumo. Los precios de lista de este artículo siguen el criterio de pago por consumo de la tabla general de precios; no tomamos 0.2 como precio por llamada. Antes de comprar, verifica en la consola el precio real con descuento de ese grupo. El 0.025 de -all y el 0.03 de -vip coinciden en ambas fuentes, así que pueden usarse como precio de lista por llamada.
El coste por imagen en el canal oficial depende de los tokens de salida. La página de comparación (según la propia documentación) sitúa el rango típico en aproximadamente 0.03 a 0.2 USD por imagen: cuanto más larga sea la indicación y más altos sean size y quality, mayor será el coste. En la documentación hay un cálculo aproximado del 2026-09-09: una imagen cuadrada de 1024 con la versión 2.5 en xhigh cuesta unos 0.094 USD (3122 tokens de salida), y con max unos 0.211 USD (7024 tokens de salida), sin contar la entrada, que normalmente cuesta menos de 0.001 USD. La conclusión de la documentación es que un boceto 1K en low por el canal oficial no tiene por qué ser más caro; es en la calidad media-alta donde el canal inverso oficial, con 0.025 a 0.03 USD, resulta más rentable.
Hay que advertir también de un precio antiguo. Un artículo antiguo del centro de ayuda, del 2026-04-25, indicaba gpt-image-2-all a 0.03 USD/llamada; ese dato es anterior a la rebaja. El sufijo -all bajó a 0.025 USD el 2026-10-10, y los dos nombres -all se ajustaron al mismo tiempo. La razón de la rebaja que da la documentación es que -all es más estable que -vip; -vip se ve más afectado por los controles de riesgo del proveedor original y fluctúa más, pero sigue recibiendo mantenimiento y funciona con normalidad.
Tabla comparativa de capacidades del canal de imágenes
| Capacidad | Reverso oficial -all | Reverso oficial -vip | Redirección oficial |
|---|---|---|---|
size |
Página dedicada: relaciones de aspecto comunes con lado largo de 512 a 1536, incluidas las que no son múltiplos de 16; 2K no se indica como soporte exacto | 30 niveles (10 proporciones × 1K/2K/4K); solo se aplican en el endpoint images | Cualquier tamaño válido, con lados múltiplos de 16 y proporción no superior a 3:1; los preajustes incluyen 3840×2160 |
quality |
No se acepta | Comportamiento del canal, sin garantía; en las dos variantes 2.5, las pruebas repetidas del 2026-09-10 llegaron a max; gpt-image-2-vip solo llega a high |
Niveles garantizados oficialmente; xhigh/max solo en las dos variantes 2.5 (página comparativa) |
n |
No se acepta; aunque se envíe, se sigue cobrando el importe multiplicado por n | No compatible; 1 imagen por solicitud | Compatible |
| Máscara | Solo repintado de la imagen completa | Solo repintado de la imagen completa | Compatible con repintado local mediante mask |
| Fondo transparente | Sin background; solo se puede poner en la indicación |
Puede generar PNG con alfa, aunque la documentación no lo garantiza | Compatible en 2.5; gpt-image-2 está descontinuado |
| Velocidad (según la documentación) | Página dedicada: unos 30 a 60 segundos; página comparativa: unos 90 segundos | gpt-image-2-vip, de 90 a 150 segundos; flare-vip, de 22 a 138 segundos; sunburst-vip, de 37 a 120 segundos |
A fecha de 2026-09-09, 2.5-flare 1K low tardaba unos 10 segundos y sunburst unos 14 segundos; gpt-image-2, de 100 a 120 segundos |
Sobre la velocidad de -all, la documentación no coincide en dos lugares: la página dedicada indica unos 30 a 60 segundos y la página comparativa, unos 90 segundos. Aquí incluimos ambas cifras y no hacemos un promedio. El size de -all también tiene documentación desincronizada: la página dedicada dice «ahora sí admite size», mientras que la página comparativa todavía pone que no lo acepta. En este artículo tomamos como referencia la página dedicada. Esa misma página también menciona que la imagen cuadrada de 1536 puede pasar por interpolación y no representa detalles nativos. La frase de 2.6 «50 % más rápido en generación; Flare en baja calidad, tan rápido como 6 segundos» procede de un anuncio oficial citado en las novedades en vivo del 2026-11-05, no de datos de pruebas repetidas por la plataforma. Los nuevos parámetros de 2.6 (complexity, SVG, GIF, etc.) se rigen por la documentación oficial de OpenAI y no se puede aplicar directamente la tabla de parámetros de 2.5.
Si hay mucha demanda de 4K, la página dedicada de -all menciona otra vía: Nano Banana en APIYI. En la tabla general de precios, nano-banana-pro y la serie gemini-3-pro-image cuestan 0.09 USD por uso, mientras que nano-banana-2 y gemini-3.1-flash-image cuestan 0.055 USD por uso. Los grupos empresariales de esta vía son NanoBananaEnterprise y NanoBananaReverse, y no se pueden mezclar con image2Enterprise.
Cómo configurar los tipos de token y la prioridad de grupos en el canal de imágenes
Muchos errores no vienen del canal en sí, sino de haber configurado mal el tipo de token o el grupo. Todos los canales usan la misma Base URL: https://api.apiyi.com/v1. Para los endpoints, se recomienda usar /v1/images/generations y /v1/images/edits. Solo hay una regla de tipos de token que conviene recordar: el canal oficial debe usar «Pago por uso prioritario». Si llamas al canal oficial con un token de pago por llamada, la solicitud se rechaza porque el método de facturación no coincide. Para -all y -vip puedes usar «Pago por llamada» o «Pago por uso prioritario».
| Grupo | Multiplicador (API de precios, 2026-11-10) | Canales aplicables | Uso | Nota |
|---|---|---|---|---|
Default |
1 | canal oficial, -all, -vip | Primera opción por defecto | En horas pico del canal oficial puede haber congestión de concurrencia y aparecer un 429 |
image2Enterprise |
1.2 | Solo canal oficial | Respaldo empresarial del upstream de OpenAI | No es una línea acelerada ni Vertex; -all y -vip no están en este grupo |
image2_OSS |
1 | canal oficial, -all, -vip | Garantiza salida por URL | No mejora la estabilidad; la URL caduca en unas 24 horas |
SVIP |
La API devuelve 1; prevalece la página de tokens de la consola | canal oficial, -all, -vip | Según las indicaciones de la consola | Desde 2026-10-29, la promoción de multiplicador por tiempo limitado ha finalizado |
El multiplicador 1.2 del grupo empresarial, según la documentación, se fija así: «tras el bono del 20 % por una recarga única de 3000 USD para grandes clientes, equivale aproximadamente al precio de lista del sitio oficial»; la plataforma no contabiliza costos fiscales. Sobre qué modelos son visibles en este grupo, la tabla del cuerpo de las FAQ enumera gpt-image-2.5-flare, gpt-image-2.5-sunburst y gpt-image-2. La tabla general de precios y el campo enable_groups de la API de precios muestran que los dos modelos 2.6 también están incluidos, pero la tabla de las FAQ aún no se ha actualizado. La documentación no indica que este grupo requiera una solicitud aparte; si no aparece como opción, prevalece lo que muestre la consola.
La configuración recomendada es «un solo token cubre dos tipos de modelos». Un token puede tener 1 grupo predeterminado y hasta 2 grupos de respaldo. Según la configuración de la documentación, pon image2Enterprise como primera prioridad y Default como grupo predeterminado. Así, las solicitudes del canal oficial pasan primero por el grupo empresarial; -all y -vip, como no están en el grupo empresarial, se quedan en Default y generan imágenes con normalidad. Pasos concretos: abre api.apiyi.com/token, edita el token, selecciona los grupos y guarda; no hay que cambiar el código. Criterio de aceptación: con la misma solicitud, llama una vez a un modelo del canal oficial y otra a un modelo -all; ambas llamadas deben generar una imagen, y en la consola la llamada del canal oficial debe facturarse a 1.2x.
Los casos de uso que dependen fuertemente de la URL necesitan un tratamiento aparte. En el grupo predeterminado, la documentación registra que, en 2026-07, si no se pasa response_format se devuelve b64_json; si se pasa explícitamente response_format como url, se puede obtener el enlace, pero el grupo predeterminado no garantiza el formato de salida. Estos casos deberían cambiar el token a image2_OSS y, al mismo tiempo, pasar url explícitamente; en cuanto reciban el enlace, descargarlo y almacenarlo de inmediato. Criterio de aceptación: la respuesta trae el campo url y el archivo almacenado se puede abrir.
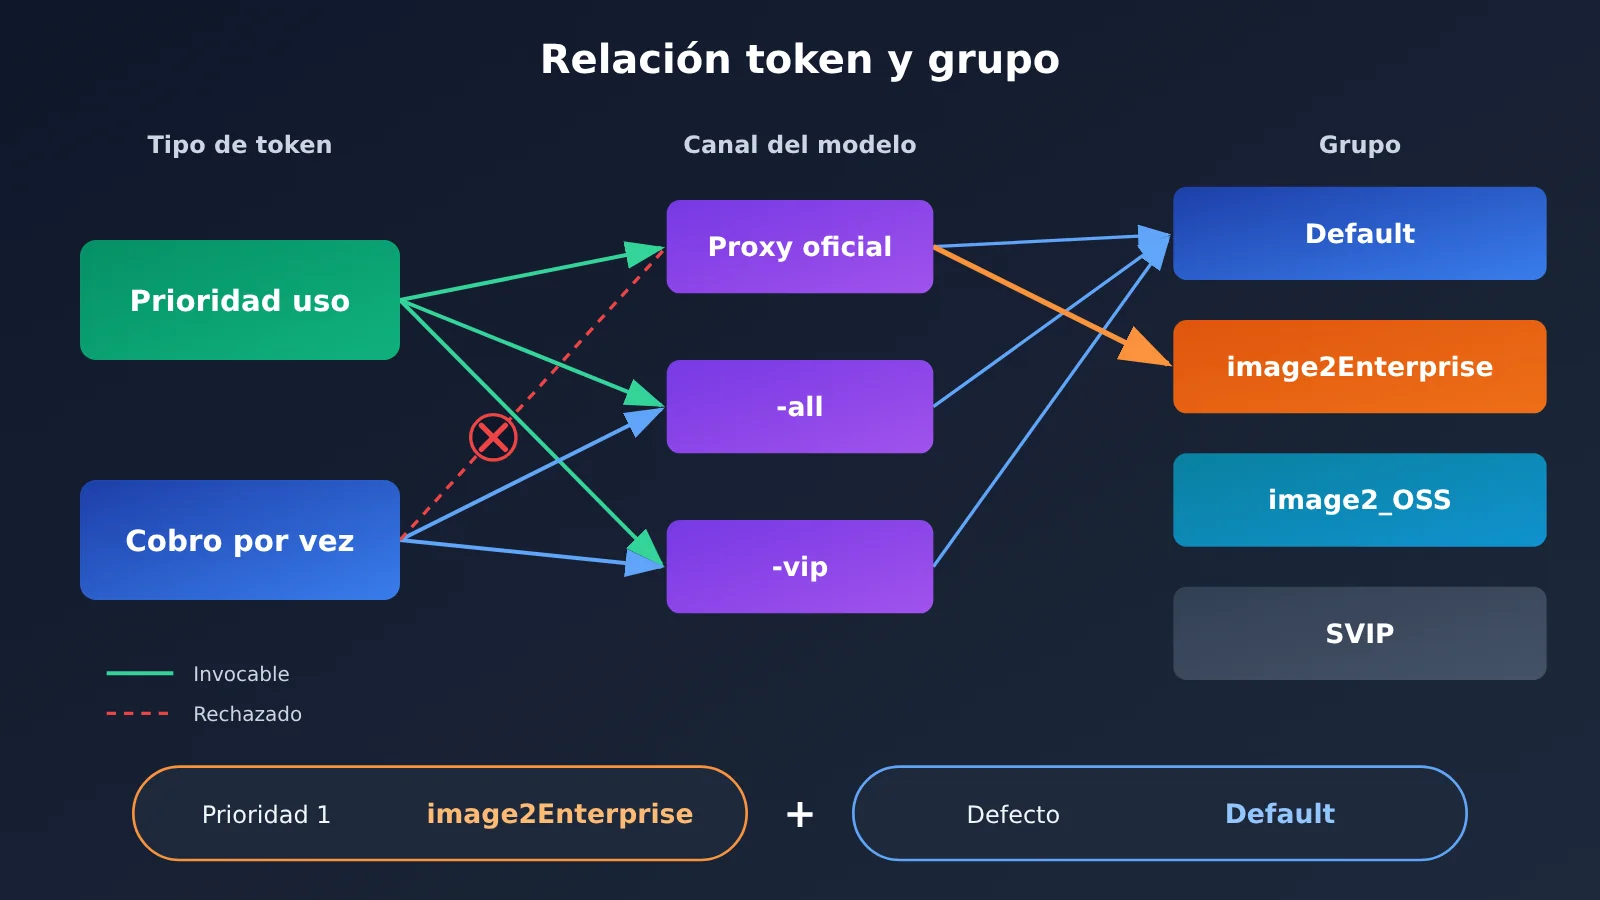
Cómo actuar ante 429, saturación y fallos del proveedor original al generar imágenes
Aunque todos sean errores, la causa puede ser completamente distinta, así que el primer paso es leer error.message en el cuerpo del error y luego decidir qué hacer. La página exclusiva de -vip divide los 429 en dos tipos: parámetros rechazados y saturación del grupo. La página de -all explica los 429 de forma general como «límite de velocidad o cuota insuficiente». En el estado en tiempo real también se han registrado dos tipos de fallos del proveedor original, procedentes de la versión web de ChatGPT y del upstream de OpenAI. La siguiente tabla resume estas situaciones en «qué error ves y qué hacer primero»:
| Lo que ves | Diagnóstico | Qué hacer primero | Criterio de aceptación |
|---|---|---|---|
| El canal oficial en Default devuelve 429 de forma continua o indica saturación | Congestión del grupo predeterminado | Ve a api.apiyi.com/token y cambia el grupo a image2Enterprise, o súbele la prioridad; el nombre del modelo no cambia |
La misma solicitud puede generar la imagen y la facturación pasa a 1,2 veces |
-vip devuelve 429 con un mensaje como quality must be one of… |
Parámetros rechazados | Cambia los parámetros; no lo reintentes tal cual | La primera solicitud después del cambio funciona |
| -vip devuelve 429 con el mensaje «当前分组上游负载已饱和» (la carga del upstream del grupo actual está saturada) | Saturación puntual | Reintenta con retroceso exponencial y consulta el estado en tiempo real al mismo tiempo | Se recupera dentro de un número limitado de intentos; si no, cambia al canal oficial |
| -all/-vip fallan de forma concentrada ese día y en el estado en tiempo real hay un aviso de fallo del proveedor original | Fallo del proveedor original de ChatGPT web o Adobe | Deja de reintentar con retroceso y cambia el nombre del modelo para pasar al canal oficial | La solicitud al canal oficial funciona y el token es de prioridad por consumo |
El grupo empresarial del canal oficial devuelve The server had an error while processing your request. |
Fallo del upstream de OpenAI | Reintenta 1 o 2 veces; si sigue fallando, cambia al canal oficial inverso | Tras cambiar a -all se puede generar la imagen |
| 401 | Problema de token | Revisa el token; no reintentes | Se recupera al usar el token correcto |
gpt-image-2 con background en transparent devuelve 400 |
La función ya fue desactivada por el proveedor oficial | Para fondo transparente, usa 2.5 del canal oficial con png o webp | La imagen devuelta incluye canal alfa |
Si sospechas que es un fallo del proveedor original, primero entra en docs.apiyi.com/live para ver si ese día hay un aviso correspondiente y luego decide si reintentar con retroceso o cambiar de canal. Pasar del canal oficial inverso al canal oficial es muy sencillo: en APIYI usas el mismo token y solo cambias el nombre del modelo; la página de comparación lo dice textualmente: «solo hay que cambiar el nombre de model para pasar al canal oficial». Pero hay dos requisitos que conviene revisar uno por uno:
- Tipo de token: confirma que el token es de «prioridad por consumo». Si es un token por llamada, la solicitud se rechazará.
- Elimina campos según el modelo de destino: al pasar a
gpt-image-2, elimina los niveles xhigh y max, y el fondo transparente; si vienes de -all con tamaños que no son múltiplos de 16, cámbialos a múltiplos de 16 y que la proporción no supere 3:1. En sentido contrario, al volver del canal oficial a -all, eliminaquality,n,aspect_ratioymask. - Tiempo de espera: en el canal oficial, para calidad baja y media configura 240 segundos; para high y xhigh, 300 segundos; para max y para high de
gpt-image-2, usa 600 segundos como respaldo. En -all y -vip, configura 300 segundos por precaución. Comprime las imágenes de entrada a menos de 1,5 MB.
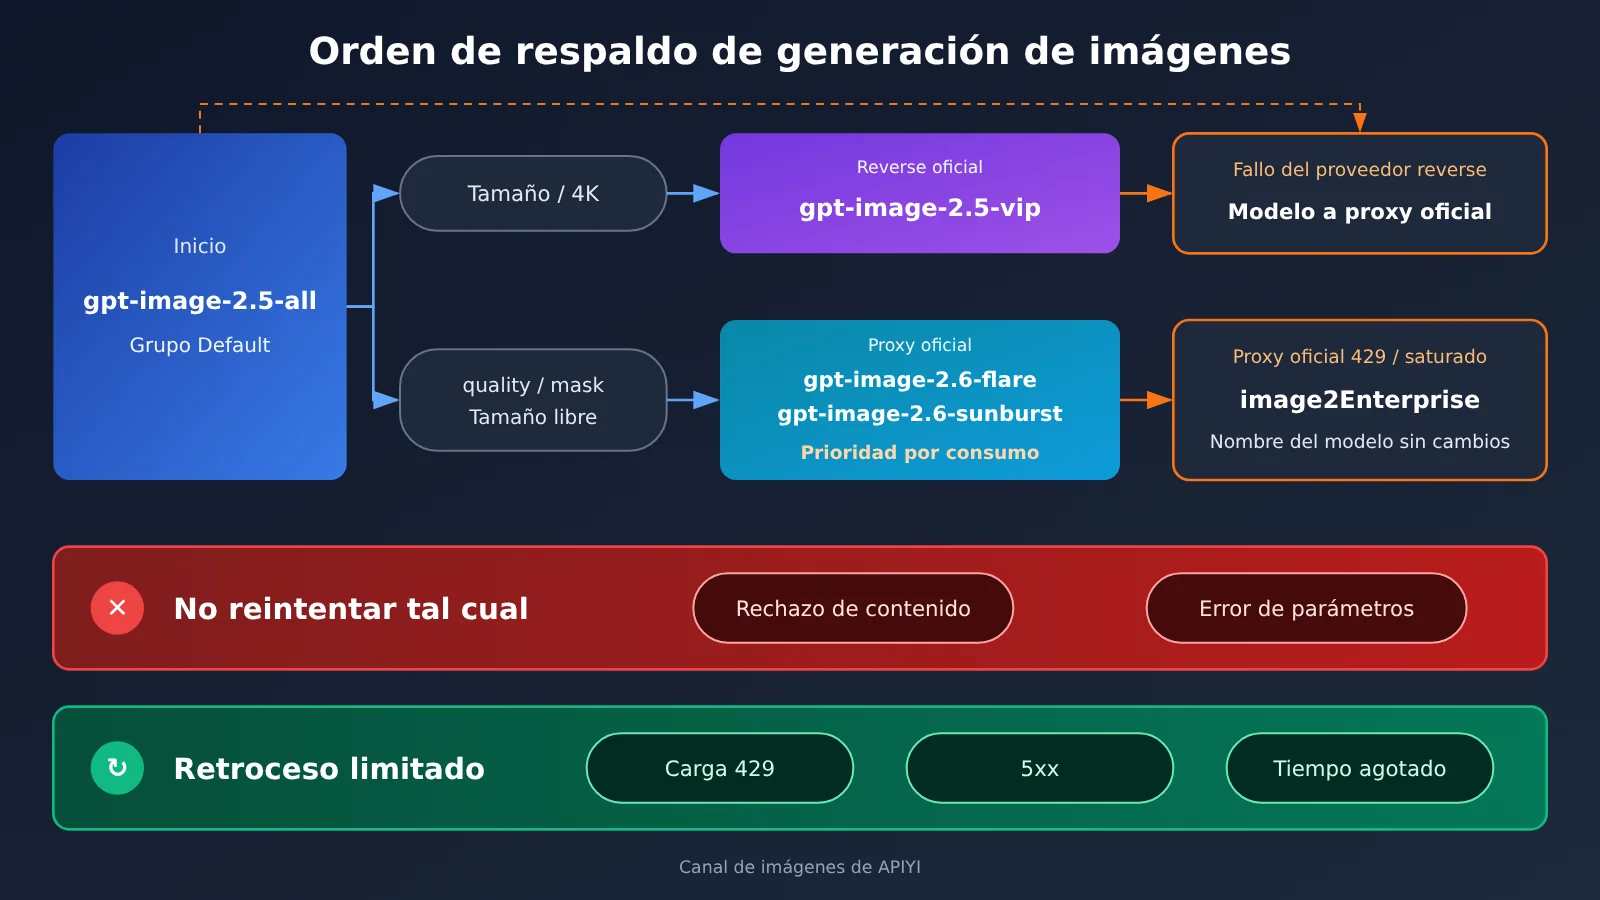
Tabla de referencia de los anuncios históricos de abril a noviembre de 2026
Estos eventos solo sirven para ilustrar «qué tipo de fallo se ha dado alguna vez y cómo se resolvió en su momento»; no reflejan la situación actual del 2026-11-10. Para saber si hay saturación ahora, lo que manda es el cuerpo del error de esta vez y el estado en tiempo real.
| Fecha | Evento (anuncio histórico) | Tratamiento en su momento | Cómo usarlo hoy |
|---|---|---|---|
| 2026-04-29 | El grupo predeterminado del canal oficial sigue devolviendo 429; solo image2Enterprise es estable, y -all y -vip también aguantan | El canal oficial pasa al grupo empresarial | Caso típico de «congestión del grupo predeterminado del canal oficial» |
| 2026-05-07 | El grupo empresarial del canal oficial también devuelve server error; la causa raíz está en el upstream de OpenAI | Esperar a que el upstream se recupere o cambiar de canal | El grupo empresarial tampoco garantiza que el upstream esté siempre disponible |
| 2026-05-13 | El grupo predeterminado se satura; image2Enterprise sigue generando imágenes | Cambiar al grupo empresarial | Sirve de apoyo a la configuración por prioridades |
| 2026-05-23 | Se añaden recursos al grupo predeterminado y la documentación indica que no hace falta pasar al grupo empresarial | Volver a Default | La congestión es algo puntual |
| 2026-09-21 | El grupo predeterminado de 2.5 en el canal oficial anda justo de concurrencia; el grupo empresarial es estable | Cambiar al grupo empresarial | Igual que arriba |
| 2026-10-15 | gpt-image-2-vip con carga demasiado alta; -all falla por un problema del proveedor original en la web de ChatGPT; en gpt-image-2 se desactiva el fondo transparente (la página de comparación lo registra como 2026-09-30) |
En el canal inverso se usa primero el canal oficial como respaldo; para fondo transparente se pasa a 2.5 en el canal oficial | Cuando falla el proveedor original hay que cambiar de canal, no insistir por cabezonería |
| 2026-11-05 | Entra en servicio 2.6 del canal oficial; el grupo Default queda disponible | Los proyectos nuevos ya pueden usarlo | Es un anuncio de lanzamiento, no un aviso de fallo |
Qué errores al generar imágenes conviene reintentar y cuáles no
Para decidir si reintentar hay un único criterio: si la causa del error desaparece por sí sola con el tiempo. Los 429 de carga, los 5xx y los timeouts pueden recuperarse solos, así que se puede aplicar un retroceso (backoff) con un número limitado de intentos; los errores de parámetros, los de token y los rechazos por contenido no desaparecen por sí mismos, y reenviar exactamente lo mismo solo hace perder tiempo y, en ocasiones, cobra de más. El criterio operativo del archivo de temas con fecha 2026-08-25 es «los 429 se pueden reintentar, los de seguridad de contenido no», en línea con esta regla.
- Se puede reintentar con espera progresiva: los 429 de carga con backoff exponencial; los 5xx, reintentar 1 o 2 veces; ante un timeout, primero ajusta el timeout del cliente al valor recomendado. Anota el
request-idde las cabeceras de respuesta para facilitar el diagnóstico. La documentación de -vip indica que con un RPM por debajo de 500 no hace falta preocuparse por la concurrencia. - Corregir y volver a enviar: si rechazan los parámetros, corrígelos primero; ante un 401, revisa la clave; ante un 400, contrasta con la tabla de campos del modelo objetivo. Los fallos de autenticación y de validación de parámetros no se cobran.
- No reintentar automáticamente: los rechazos por contenido son de dos tipos. Uno devuelve un error explícito, por ejemplo «no se ha generado la imagen según lo esperado, ajusta la indicación y vuelve a intentarlo»; este caso no se cobra y lo que hay que hacer es modificar la indicación. El otro devuelve un 200, pero el cuerpo dice algo como «no puedo cumplir con esta solicitud»; se trata de un rechazo blando. A nivel de protocolo cuenta como una respuesta normal, se cobra, y el servicio oficial tampoco puede identificarlo de antemano en la capa de protocolo. No vuelvas a enviar automáticamente la misma indicación.
Pregunta: pasé n=4 a -all, ¿por qué solo recibí 1 imagen pero me cobraron 4 veces?
-all no acepta n, pero si lo pasas igualmente se cobra multiplicado por n. El ejemplo de la página dedicada es que con n=3 se cobran 0.075 dólares y aun así solo devuelve 1 imagen. Cuando necesites N imágenes, debes hacer N llamadas en paralelo. Criterio de aceptación: el número de cargos en la consola debe ser igual al número de imágenes que realmente recibiste.
Pregunta: la página de comparación dice que -all no acepta size, ¿se puede pasar o no?
La página dedicada de -all es la referencia: sí se puede pasar. El size que se pasa explícitamente tiene prioridad sobre la descripción del tamaño en la indicación; si no se pasa o se pasa auto, se mantiene el comportamiento nativo. La página de comparación simplemente aún no se ha actualizado.
Pregunta: ¿El grupo empresarial puede acelerar la generación de imágenes?
No. Las FAQ lo indican claramente: no es una línea de aceleración, su función es solo ofrecer otro grupo de recursos cuando el grupo predeterminado está congestionado. Basta con colocar los modelos oficiales inversos en el grupo Default.
Pregunta: ¿El 0.2 de la conversión oficial en la interfaz de precios es un precio por llamada?
No debería interpretarse así. La tabla general de precios indica precios por consumo, y este artículo también se basa en el consumo. La interfaz devuelve model_price 0.2 para algunos alias sin fecha; los criterios de ambas partes no coinciden, así que antes de hacer el pedido verifica en la consola el precio real con descuento.
Pregunta: ¿2.6 tiene versiones -all o -vip?
A fecha de 2026-11-10, no aparecen ni en la tabla general de precios ni en la interfaz de precios, y este artículo tampoco hace ninguna suposición sobre la fecha de lanzamiento.
Configuración predeterminada para seguir al pie de la letra
- Nombre del modelo:
gpt-image-2.5-all; si necesitas tamaños específicos o 4K, cambia agpt-image-2.5-vip; si necesitas los parámetros oficiales, cambia agpt-image-2.6-flareogpt-image-2.6-sunburst - Grupo: primera prioridad
image2Enterprise, grupo predeterminadoDefault; para negocios que dependen en gran medida de URL, crea otro token y usaimage2_OSS - Tipo de token: prioridad al pago por uso (se puede invocar tanto en canal oficial directo como inverso)
- Segundos de tiempo de espera: para -all/-vip, 300; en canal oficial directo, calidad baja y media 240, high/xhigh 300, max 600
- Base URL:
https://api.apiyi.com/v1
Una vez que todo funcione con esta configuración, en el día a día solo hay que prestar atención a dos cosas: qué dice error.message dentro del cuerpo del error y si las actualizaciones en tiempo real de ese día incluyen algún anuncio relacionado. Tomando como referencia las dos tablas anteriores, podrás decidir si conviene reintentar con retroceso, modificar la solicitud o cambiar de canal.
Autor: Equipo técnico de APIYI
Contacto técnico: si encuentras un error que no se cubra en este artículo, no dudes en contactarnos a través de la página principal del sitio web oficial de APIYI, adjuntando elrequest-idy el cuerpo completo del error.