Сразу к делу. Для массовой генерации изображений в APIYI в обычных задачах по умолчанию используйте gpt-image-2.5-all, группа Default. Вызывать можно и с токеном с оплатой за вызов, и с токеном с оплатой по объёму; цена — 0.025 доллара за изображение. Если нужно зафиксировать размер или работать с 4K, замените имя модели на модель с суффиксом -vip, например gpt-image-2.5-vip; цена — 0.03 доллара за изображение. Но на странице -all прямо сказано: у -vip с 4K бывает нестабильность, поэтому первым выбором для 4K его считать не стоит. Если нужны официальный уровень quality, локальная перерисовка по маске или произвольный допустимый размер — идите через официальный релей. В новых проектах в первую очередь смотрите на gpt-image-2.6-flare (приоритет скорости) и gpt-image-2.6-sunburst (приоритет редактирования и точности).
Резервный сценарий бывает двух видов. Если официальный релей в группе Default постоянно отдаёт 429 или канал перегружен, переключите группу токена на image2Enterprise; имя модели менять не нужно. Если реверс-канал сталкивается со сбоем веб-версии ChatGPT или со сбоем на стороне самого Adobe, не запускайте повторные попытки с backoff на одном и том же реверс-маршруте — переключите имя модели на модель официального релея и убедитесь, что у токена включён режим «приоритет оплаты по объёму». Ещё есть две категории ошибок, которые нельзя повторять как есть: отказ по безопасности контента и ошибки параметров. И обратите внимание на параметр n: на -all он списывает оплату как за n изображений, но всё равно возвращает только 1 картинку.
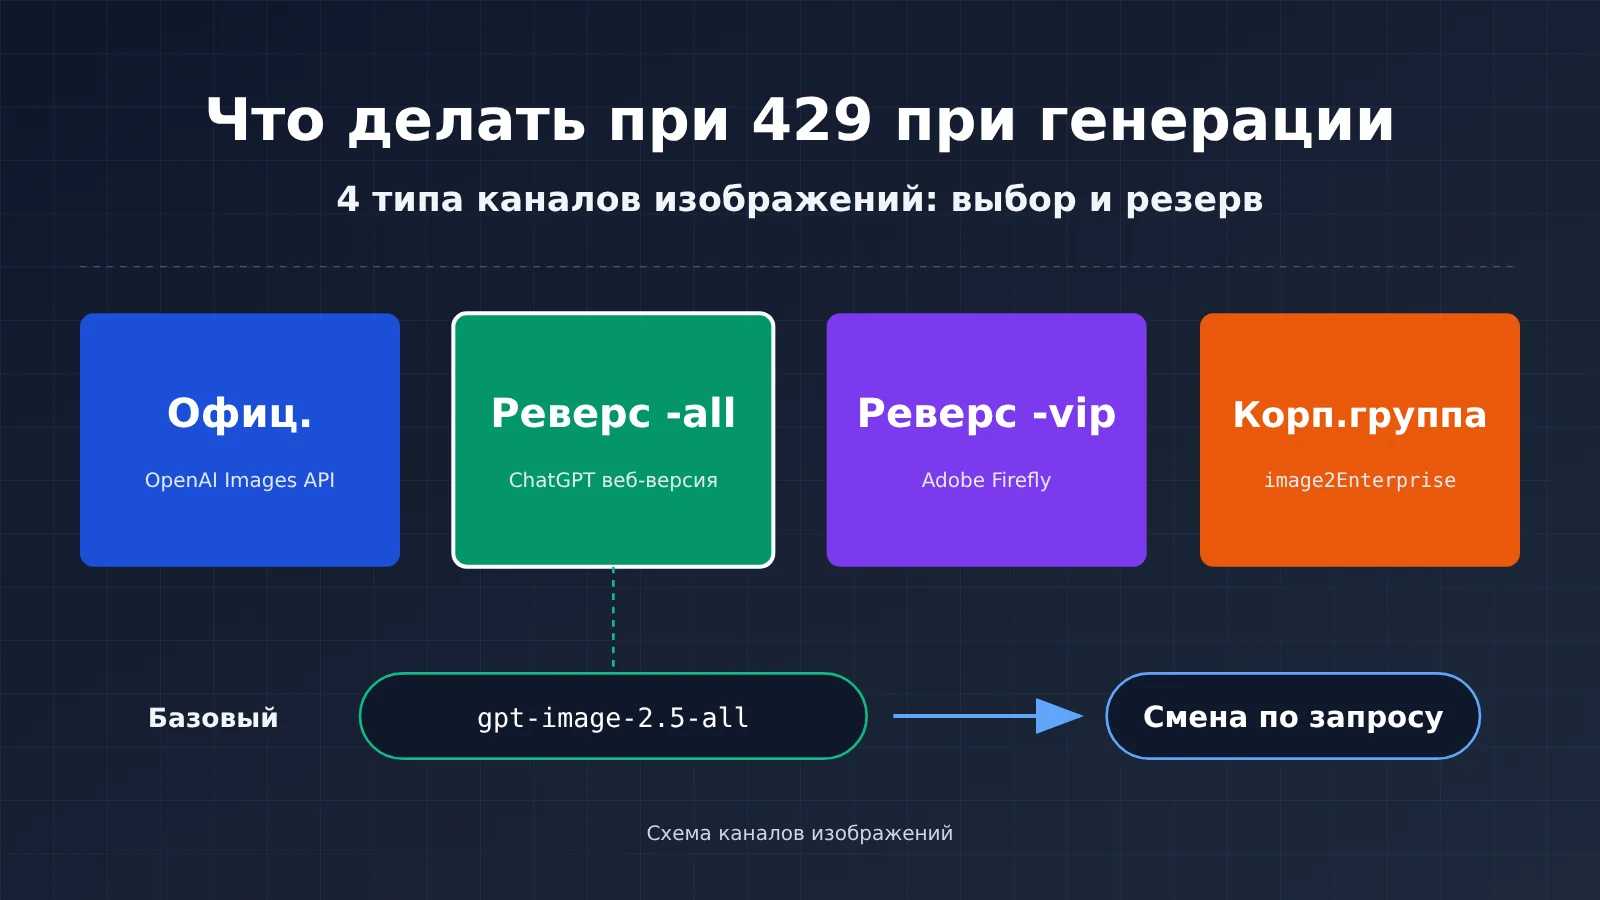
Какие четыре названия соответствуют каналам GPT для изображений
Одна и та же GPT-модель для изображений может появляться в списке с несколькими суффиксами: они обозначают источник на стороне upstream и способ тарификации. При этом «корпоративная группа» — не модель, а опция маршрутизации на токене. Ниже — по порядку, с формулировками из документации:
- Официальный маршрут (官转): прямое официальное подключение к OpenAI Images API. В документации указано, что запросы и ответы соответствуют официальному API OpenAI. В сводной таблице цен официальные модели для изображений такие:
gpt-image-2.6-flare,gpt-image-2.6-sunburst,gpt-image-2.5-flare,gpt-image-2.5-sunburst, их датированные снимкиgpt-image-2.5-flare-2026-09-08иgpt-image-2.5-sunburst-2026-09-08, а также предыдущее поколениеgpt-image-2. Документация рекомендует для текст-в-изображение в первую очередь использовать flare, а для редактирования и объединения нескольких изображений — sunburst. В продакшене можно зафиксировать датированный снимок, чтобы алиас не начал указывать на другую версию. - Официальный обратный канал -all (官逆 -all): обратный доступ через веб-версию ChatGPT.
gpt-image-2-allиgpt-image-2.5-allстоят одинаково, ведут себя одинаково и взаимозаменяемы. Причина в том, что веб-версия ChatGPT целиком обновилась до Images 2.5, поэтомуgpt-image-2-allтоже выдаёт изображения 2.5. Документация советует новым проектам сразу братьgpt-image-2.5-all. - Официальный обратный канал -vip (官逆 -vip): линия Adobe (Firefly) официального обратного канала. Модели:
gpt-image-2-vip,gpt-image-2.5-flare-vip,gpt-image-2.5-sunburst-vip. Алиасgpt-image-2.5-vipуказывает наgpt-image-2.5-sunburst-vip. - Корпоративная группа
image2Enterprise(企业分组): корпоративная резервная группа официального маршрута на upstream OpenAI. В FAQ прямо сказано, что это не Google Vertex и не ускоряющая линия для сокращения времени генерации. Её задача — дать дополнительный пул ресурсов при перегрузке группы по умолчанию, но она не гарантирует, что upstream будет доступен всегда.
Есть ещё одна группа, которую легко принять за резервную, — image2_OSS. Это группа с коэффициентом 1 и без наценки; у неё одна задача: гарантировать возврат URL, а не понижение до base64. Она не повышает стабильность и применима к -all и -vip.
У версии 2.6 сейчас есть только официальный маршрут. В сводной таблице цен и интерфейсе ценообразования на 2026-11-10 нет gpt-image-2.6-all, gpt-image-2.6-vip или похожих названий. Модели и цены определяются списком моделей платформы.
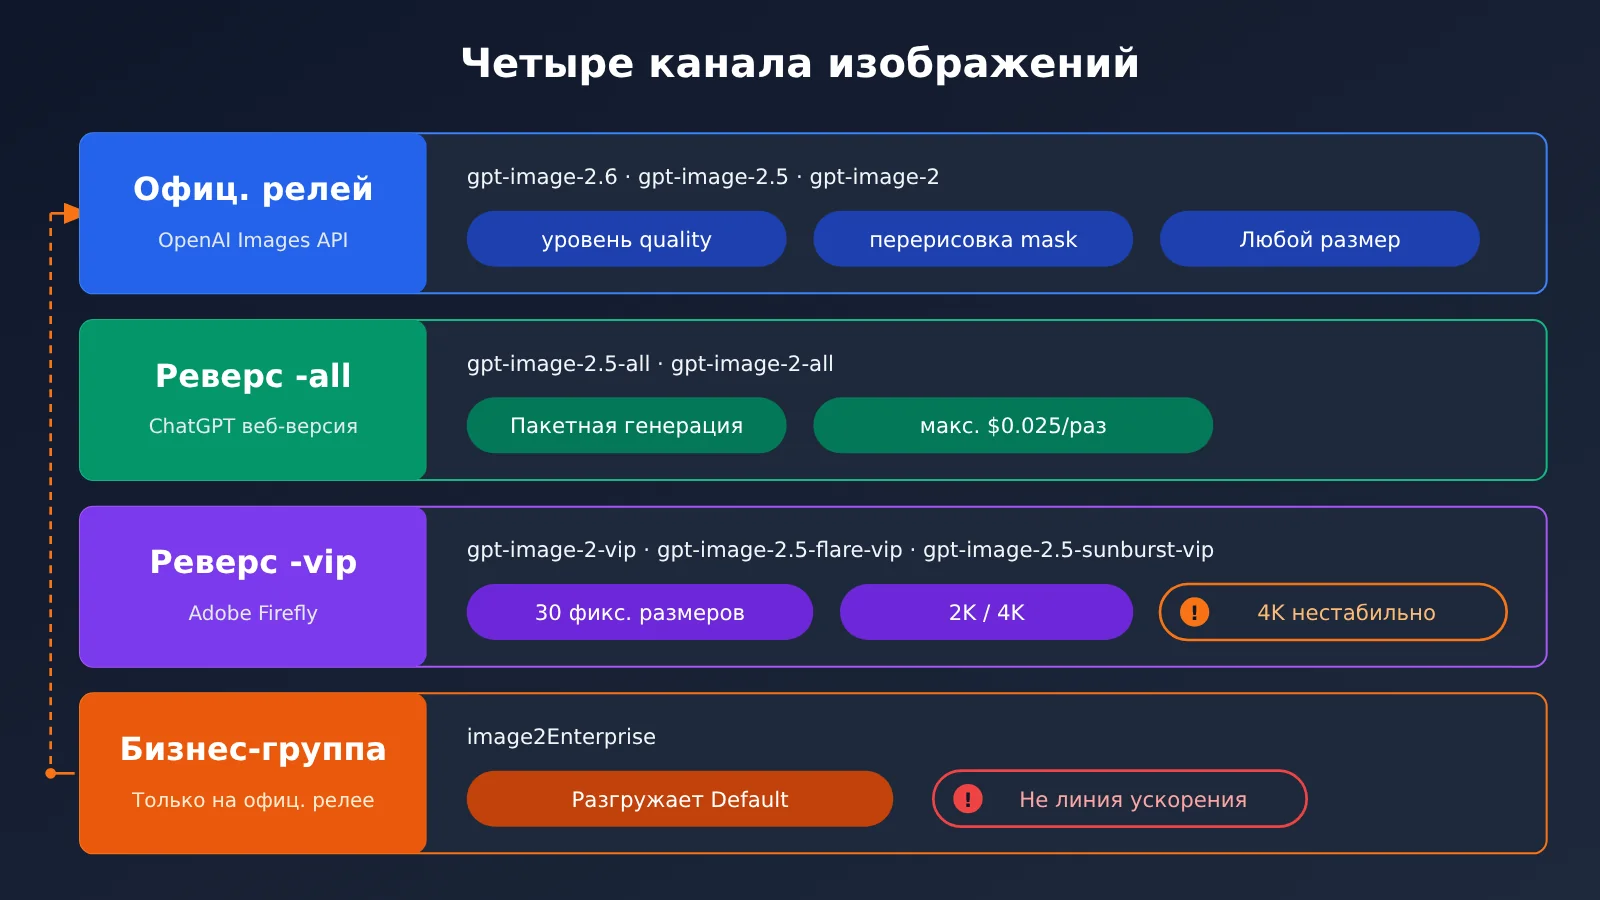
Выбор канала изображений по умолчанию под сценарий: таблица сравнения цен и возможностей
При выборе канала сначала ответьте на три вопроса: нужен ли официальный уровень качества, насколько строги требования к размеру и нужно ли ограничивать стоимость за изображение. Можно действовать в таком порядке:
- Пакетная генерация, стоимость с ограничением за изображение, длинная сторона от 512 до 1536: используйте
gpt-image-2.5-all. Критерий приёмки: фактическая ширина и высота возвращённого изображения соответствуют ожиданиям, а списание в консоли за каждый вызов равно цене за изображение, умноженной на количество вызовов. - Нужен фиксированный размер из 30 вариантов или требуется 2K, 4K: переходите на модель с суффиксом
-vipи явно передавайтеsize. Критерий приёмки: ориентируйтесь на фактические ширину и высоту возвращённого изображения, а не только на параметры запроса. - Нужны официальный
quality, локальная перерисовка черезmask, прозрачный фон, любой допустимый размер или совместимость с полями OpenAI: используйте официальный прокси-канал. Для новых проектов берите 2.6, а если нужно зафиксировать поведение — снимок 2.5 с датой. Критерий приёмки: поля запроса совпадают с официальной таблицей параметров целевой модели, ошибки 400 не возникает.
Сравнительная таблица цен на каналы изображений
Цены и тарификация в таблице ниже взяты из сводной таблицы цен (обновление 2026-11-09) и указаны до скидки. После бонуса 10–20% к пополнению фактическое списание будет ниже; окончательные значения смотрите в консоли. Полный список моделей и цены — на docs.apiyi.com/models.
| Модель | Тип канала | Тарификация | Базовая цена (до скидки) | Доступные группы |
|---|---|---|---|---|
gpt-image-2.6-flare / gpt-image-2.6-sunburst |
Официальный транзит (запущен 2026-11-05) | По объёму | За миллион токенов: текст на входе — 5, изображения на входе — 8, выход — 30 долларов США | Default, image2Enterprise, image2_OSS, SVIP |
gpt-image-2.5-flare / gpt-image-2.5-sunburst и снапшот от 2026-09-08 |
Официальный транзит | По объёму | То же; чтение текста из кэша — 1.25, изображений — 2 доллара США | Default, image2Enterprise, image2_OSS, SVIP |
gpt-image-2 |
Официальный транзит (предыдущее поколение) | По объёму | То же | Default, image2Enterprise, image2_OSS, SVIP |
gpt-image-2.5-all / gpt-image-2-all |
Реверс-инжиниринг официальной веб-версии ChatGPT | За вызов | 0.025 доллара США за вызов | Default, image2_OSS, SVIP |
gpt-image-2.5-vip и другие имена с суффиксом -vip (всего 4) |
Реверс-инжиниринг Adobe Firefly | За вызов | 0.03 доллара США за вызов | Default, image2_OSS, SVIP |
В интерфейсе ценообразования есть одно расхождение со сводной таблицей цен, и его нужно учитывать отдельно. В интерфейсе ценообразования у gpt-image-2, gpt-image-2.5-flare, gpt-image-2.5-sunburst quota_type равен 1, а model_price — 0.2. А у gpt-image-2.6-flare, gpt-image-2.6-sunburst и двух снапшотов от 2026-09-08 quota_type равен 0, model_price равен 0. При этом сводная таблица цен помечает все эти модели официального транзита как тарифицируемые по объёму. В статье за базовую цену принята объёмная тарификация из сводной таблицы; 0.2 не рассматривается как цена за вызов. Перед заказом проверьте в консоли фактическую цену со скидкой для нужной группы. Значения 0.025 для -all и 0.03 для -vip совпадают в обоих источниках, поэтому их можно использовать как цену за вызов.
Стоимость одного изображения при официальном транзите зависит от выходных токенов. На странице сравнения (по описанию в документации) указан типичный диапазон — примерно от 0.03 до 0.2 доллара США за изображение: чем длиннее промпт и чем выше size и quality, тем выше стоимость. В документации есть грубая оценка от 2026-09-09: квадратное изображение 1024 для 2.5 в режиме xhigh стоит около 0.094 доллара США (3122 выходных токена), в режиме max — около 0.211 доллара США (7024 выходных токена), без учёта входных данных, которые обычно стоят меньше 0.001 доллара США. Вывод в документации такой: эскиз 1K low через официальный транзит не обязательно обойдётся дороже, а вот при среднем и высоком качестве выгоднее реверс-инжиниринг за 0.025–0.03 доллара США.
Есть ещё одно напоминание о старой цене. В старой статье справочного центра от 2026-04-25 модель gpt-image-2-all указана по цене 0,03 доллара за запрос — это данные до снижения. С 2026-10-10 цена для -all снижена до 0,025 доллара, и оба названия с суффиксом -all обновили синхронно. В документации снижение объясняют так: -all работает стабильнее, чем -vip, а -vip сильнее зависит от риск-контроля производителя и потому больше подвержен колебаниям; при этом -vip по-прежнему поддерживается и доступен как обычно.
Таблица сравнения возможностей каналов изображений
| Возможность | Официальный reverse -all | Официальный reverse -vip | Официальный релей |
|---|---|---|---|
size |
Спецстраница: типовые пропорции с длинной стороной от 512 до 1536, включая значения, не кратные 16; 2K не указан как точно поддерживаемый | 30 вариантов (10 пропорций × 1K/2K/4K), действует только на endpoint images | Любой допустимый размер, стороны кратны 16, пропорции не более 3:1, в пресетах есть 3840×2160 |
quality |
Не принимается | Поведение зависит от канала, гарантий нет; две модели 2.5 при повторном тесте 2026-09-10 доходили до max, gpt-image-2-vip только до high |
Официально гарантированные уровни; xhigh/max только для двух моделей 2.5 (страница сравнения) |
n |
Не принимается, но если передать, всё равно спишется как за n изображений | Не поддерживается, 1 изображение за раз | Поддерживается |
| Маска | Только полная перерисовка изображения | Только полная перерисовка изображения | Поддерживает локальную перерисовку через mask |
| Прозрачный фон | Нет background, можно только описать в промпте |
Может выдавать alpha PNG, но документация не гарантирует | Поддерживается в 2.5; в gpt-image-2 уже отключено |
| Скорость (по документации) | Спецстраница: около 30–60 секунд; страница сравнения: около 90 секунд | gpt-image-2-vip 90–150 секунд; flare-vip 22–138 секунд, sunburst-vip 37–120 секунд |
На 2026-09-09 2.5-flare 1K low около 10 секунд, sunburst около 14 секунд; gpt-image-2 100–120 секунд |
Что касается скорости -all, в двух местах документации данные расходятся: на спецстранице указано около 30–60 секунд, на странице сравнения — около 90 секунд. В этой статье приведены оба числа, без усреднения. С size у -all тоже есть рассинхронизация документации: на спецстранице написано «теперь поддерживается size», а на странице сравнения по-прежнему указано, что не принимается. Здесь ориентируемся на спецстраницу. Там же упоминается, что квадратное изображение 1536 может проходить через интерполяцию и не отражает нативные детали. Фраза для 2.6 «генерация ускорена на 50%, Flare в низком качестве — до 6 секунд» взята из официального анонса, пересказанного в ленте обновлений от 2026-11-05, а не из данных повторного тестирования платформы. Новые параметры 2.6 (complexity, SVG, GIF и т. д.) нужно сверять с официальной документацией OpenAI; таблицу параметров 2.5 к ним напрямую применять нельзя.
Если потребность в 4K большая, на спецстранице -all упоминается ещё один маршрут: Nano Banana в APIYI. В сводной таблице цен nano-banana-pro и серия gemini-3-pro-image стоят 0.09 доллара за раз, nano-banana-2 и gemini-3.1-flash-image — 0.055 доллара за раз. Корпоративные группы этого маршрута — NanoBananaEnterprise и NanoBananaReverse, их нельзя смешивать с image2Enterprise.
Как настроить типы токенов и приоритеты групп для канала изображений
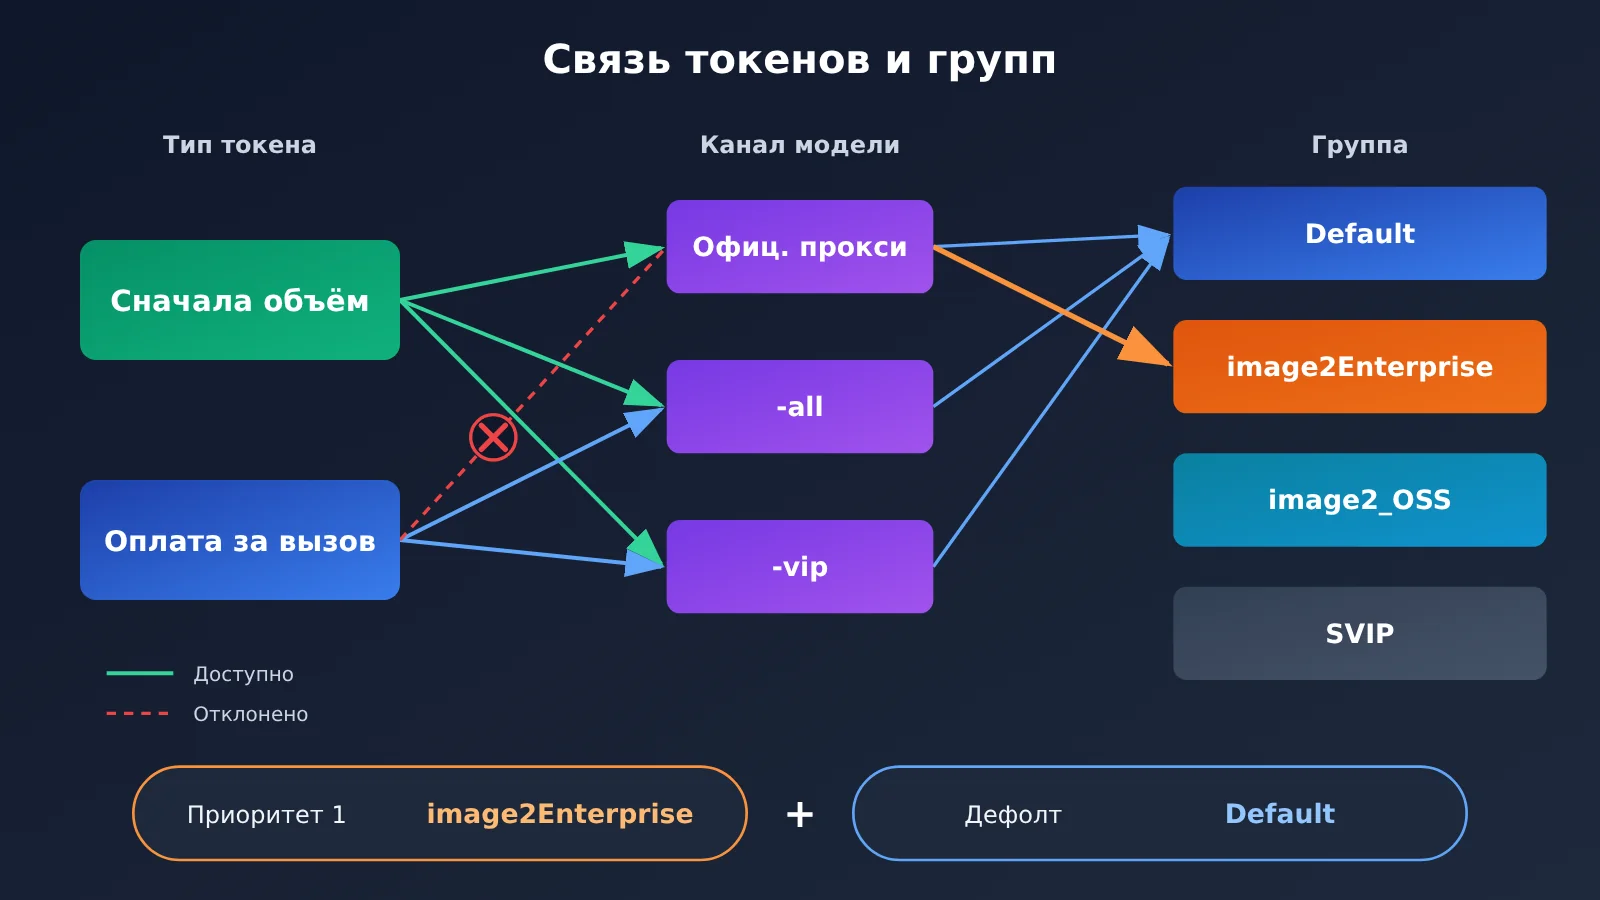
Многие ошибки возникают не из-за самого канала, а из-за неправильно выбранного типа токена или группы. Все каналы используют один и тот же Base URL: https://api.apiyi.com/v1. Рекомендуемые эндпоинты — /v1/images/generations и /v1/images/edits. Из правил по типам токенов особо запомнить нужно только одно: для официального релея обязательно нужен тариф «按量优先» (оплата по объёму). Если вызывать официальный релей токеном с оплатой за вызов («按次计费»), запрос отклонят из-за несовпадения способа тарификации. Для -all и -vip подойдёт и «按次计费», и «按量优先».
| Группа | Множитель (API тарифов, 2026-11-10) | Применимые каналы | Назначение | Примечание |
|---|---|---|---|---|
Default |
1 | Официальный релей, -all, -vip | Основной выбор по умолчанию | В пиковые часы официального релея может не хватать параллельных слотов, возможны 429 |
image2Enterprise |
1.2 | Только официальный релей | Корпоративный резерв на стороне upstream OpenAI | Это не ускоренная линия и не Vertex; -all и -vip в эту группу не входят |
image2_OSS |
1 | Официальный релей, -all, -vip | Гарантирует вывод URL | Не повышает стабильность; URL действует около 24 часов |
SVIP |
API показывает 1; ориентируйтесь на страницу токена в консоли | Официальный релей, -all, -vip | Согласно описанию в консоли | С 2026-10-29 ограниченная по времени акция с множителем завершена |
Множитель 1.2 для корпоративной группы документация объясняет так: он установлен исходя из того, что «после разового пополнения на 3000 долларов для крупных клиентов с бонусом 20% цена примерно равна исходной цене на официальном сайте». Платформа при этом не учитывает налоговые затраты. Что касается того, какие модели видны в этой группе: в таблице в тексте FAQ перечислены gpt-image-2.5-flare, gpt-image-2.5-sunburst и gpt-image-2. А общая таблица цен и enable_groups в API тарифов показывают, что в неё входят и две модели 2.6 — таблица FAQ ещё не обновлена. В документации не сказано, что для этой группы нужно отдельно подавать заявку; если выбрать её не удаётся, ориентируйтесь на то, что показывает консоль.
Рекомендуемый способ настройки — «один токен на два типа моделей». В одном токене можно задать 1 группу по умолчанию и до 2 резервных групп. Согласно инструкции, установите первый приоритет image2Enterprise, а группу по умолчанию — Default. Тогда запросы официального релея в первую очередь пойдут в корпоративную группу, а -all и -vip, поскольку их нет в корпоративной группе, останутся в Default и будут нормально генерировать изображения. Что делать конкретно: откройте api.apiyi.com/token, отредактируйте токен, выберите группу и сохраните — код менять не нужно. Критерий проверки: одним и тем же запросом вызовите один раз модель официального релея и один раз модель -all; оба раза должно получиться изображение, а в консоли вызов официального релея должен тарифицироваться с множителем 1.2.
Сценарии, где критична зависимость от URL, нужно обрабатывать отдельно. В группе по умолчанию, согласно документации на 2026-07, если не передать response_format, вернётся b64_json; если явно передать response_format со значением url, можно получить ссылку, но группа по умолчанию не гарантирует формат вывода. Таким сценариям стоит переключить токен на image2_OSS и явно передавать url; получив ссылку, сразу скачивайте и пересохраняйте файл. Критерий проверки: в ответе есть поле url, а сохранённый файл открывается.
Что делать при 429, перегрузке и сбоях у провайдера во время генерации изображений
Одна и та же ошибка может иметь совершенно разные причины, поэтому сначала смотрим error.message в теле ошибки и только потом решаем, как действовать. На отдельной странице -vip ошибка 429 разделена на два случая: отклонение параметров и перегрузка группы. На странице -all для 429 даётся общее объяснение — «ограничение частоты или нехватка квоты». В ленте оперативных статусов также фиксировались два типа сбоев у провайдера: со стороны веб-версии ChatGPT и со стороны upstream OpenAI. В таблице ниже собрано, что делать в первую очередь при каждой ошибке:
| Что видим | Диагноз | Что делать сначала | Критерий проверки |
|---|---|---|---|
| Канал 官转 в Default постоянно отдаёт 429 или сообщает о перегрузке | Перегружена группа по умолчанию | На api.apiyi.com/token переключить группу на image2Enterprise или повысить её приоритет; имя модели не меняется |
Тот же запрос выдаёт изображение, тарификация — 1.2× |
-vip возвращает 429, а в message что-то вроде quality must be one of… |
Отклонены параметры | Исправить параметры, не повторять запрос как есть | После исправления первый же запрос проходит |
-vip возвращает 429, message — «当前分组上游负载已饱和» (апстрим текущей группы перегружен) |
Эпизодическая перегрузка | Повторять с экспоненциальной задержкой и параллельно смотреть ленту статуса | Восстанавливается за ограниченное число попыток, иначе переключиться на 官转 |
| -all/-vip сегодня массово сыпят ошибками, в ленте статуса есть сообщение о сбое у провайдера | Сбой веб-версии ChatGPT или Adobe | Прекратить повторы, сменить имя модели и перейти на 官转 | Запрос через 官转 проходит, токен — «按量优先» (приоритет по объёму) |
Канал 官转 в корпоративной группе возвращает The server had an error while processing your request. |
Сбой upstream OpenAI | Повторить 1–2 раза; если не помогло — переключиться на 官逆 | После перехода на -all изображение получается |
| 401 | Проблема с токеном | Проверить токен, не повторять | После замены на правильный токен всё восстанавливается |
gpt-image-2 с background = transparent возвращает 400 |
Официально эта возможность отключена | Для прозрачного фона использовать 官转 2.5 с png или webp | Возвращается изображение с alpha-каналом |
Если есть подозрение на сбой у провайдера, сначала загляните на docs.apiyi.com/live — есть ли за сегодня соответствующее сообщение, — и только потом решайте, делать повторные попытки или менять канал. Перейти с канала 官逆 на канал 官转 просто: в APIYI с тем же токеном достаточно поменять имя модели. На странице сравнения формулировка такая: «достаточно поменять имя model, чтобы перейти на 官转». Но есть два условия, которые нужно проверить по пунктам:
- Тип токена: убедитесь, что токен — «по объёму» (pay-as-you-go). Если токен «за запрос», запрос отклонят.
- Убирайте поля под целевую модель: при переключении на
gpt-image-2уберите уровни xhigh и max, а также прозрачный фон. Размеры, пришедшие из -all и не кратные 16, нужно привести к кратности 16, а соотношение сторон ограничить 3:1. При обратном переключении с официального прокси на -all удалитеquality,n,aspect_ratioиmask. - Тайм-ауты: для официального прокси при низком и среднем качестве ставьте 240 секунд, для high и xhigh — 300 секунд, для max и high у
gpt-image-2— 600 секунд как запасной лимит. Для -all и -vip консервативно ставьте 300 секунд. Входные изображения сначала сжимайте до 1.5 МБ.
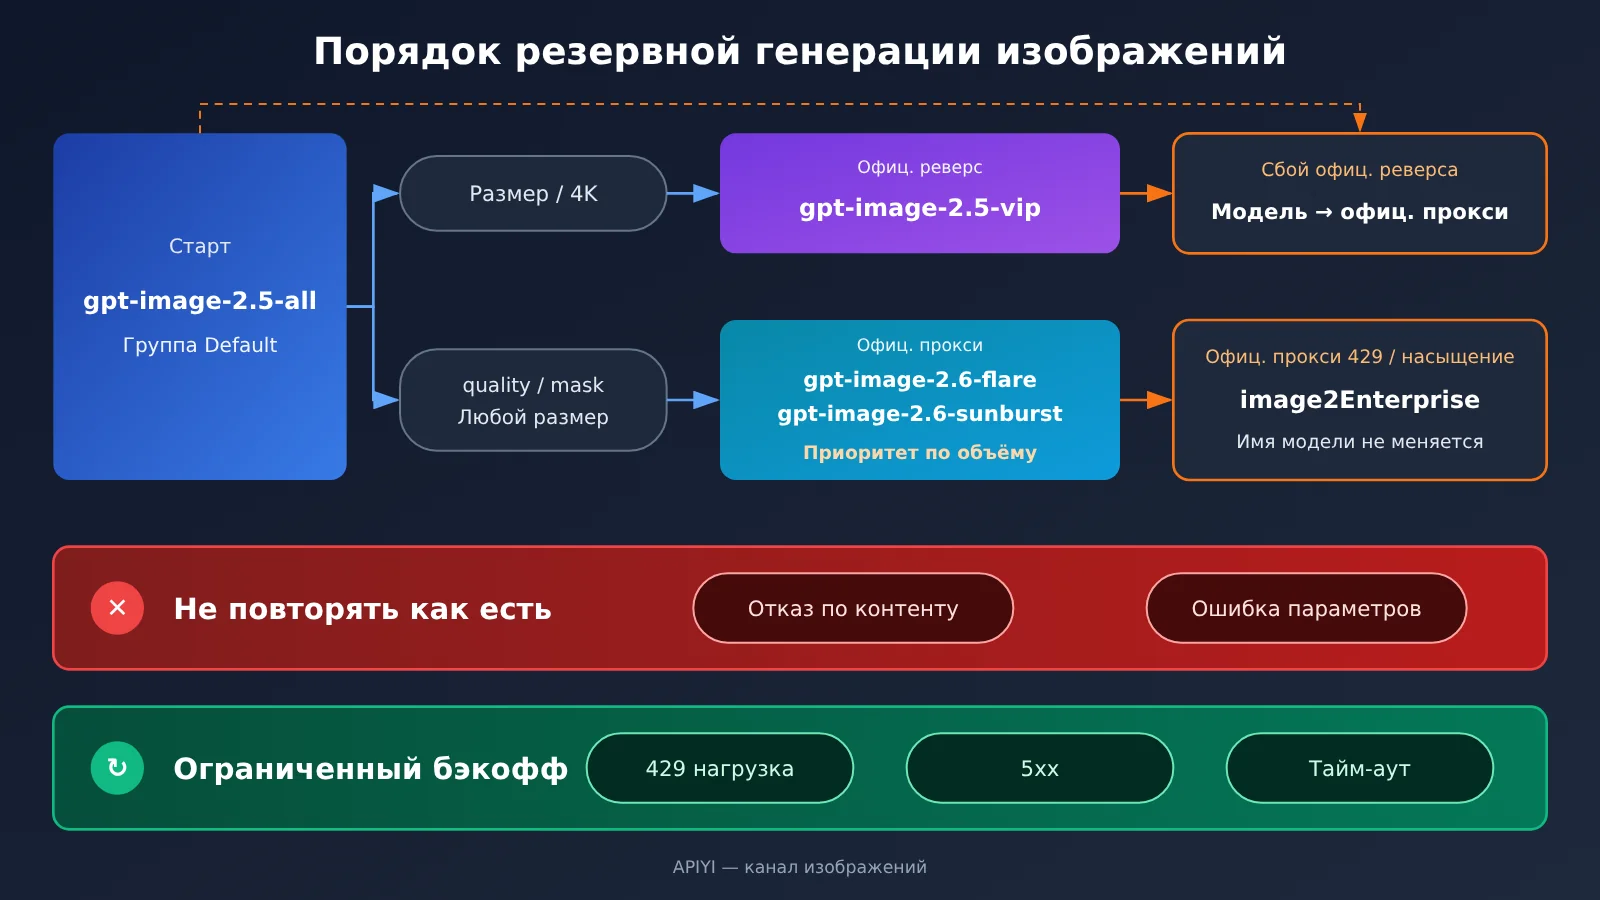
Таблица исторических оповещений за апрель — ноябрь 2026 года
События ниже приведены только для того, чтобы показать, «какие сбои уже случались и как их тогда обрабатывали». Они не описывают текущее состояние на 2026-11-10. Актуальная насыщенность определяется по текущему телу ошибки и оперативной динамике.
| Дата | Событие (историческое оповещение) | Что делали тогда | Как применять сегодня |
|---|---|---|---|
| 2026-04-29 | Группа по умолчанию официального релея по-прежнему отдаёт 429; стабильна только image2Enterprise; -all и -vip тоже стабильны | Официальный релей переключили на корпоративную группу | Использовать как типичный пример «перегрузки группы по умолчанию официального релея» |
| 2026-05-07 | Корпоративная группа официального релея тоже вернула server error; первопричина — на стороне upstream OpenAI | Дождались восстановления upstream или сменили канал | Корпоративная группа тоже не гарантирует, что upstream всегда доступен |
| 2026-05-13 | Группа по умолчанию насыщена, но image2Enterprise всё ещё генерирует изображения | Переключились на корпоративную группу | Подтверждает подход с расстановкой приоритетов |
| 2026-05-23 | В группу по умолчанию добавили ресурсы; в документации указано, что специально переключаться на корпоративную группу не нужно | Вернулись на Default | Перегрузка носит временный характер |
| 2026-09-21 | У официального релея 2.5 группа по умолчанию испытывает нехватку параллельных слотов, корпоративная группа стабильна | Переключились на корпоративную группу | То же самое |
| 2026-10-15 | gpt-image-2-vip перегружен; -all выдаёт ошибку из-за сбоя оригинального сервиса ChatGPT в вебе; gpt-image-2 с прозрачным фоном отключён (на странице сравнения указано 2026-09-30) |
Для официального реверса сначала подстраховались официальным релеем; для прозрачного фона перешли на официальный релей 2.5 | При сбое оригинального сервиса нужно менять канал, а не упираться |
| 2026-11-05 | Официальный релей 2.6 запущен, группа Default доступна | Новые проекты могут его использовать | Это оповещение о запуске, а не о сбое |
Какие ошибки при генерации изображений стоит повторять, а какие — нет
Критерий для решения о повторе только один: исчезнет ли причина ошибки сама по себе со временем. Ошибки нагрузки 429, 5xx и таймауты могут восстановиться самостоятельно — тут допустимо ограниченное число повторов с задержкой; ошибки параметров, токена и отказ по контенту сами не исчезнут, а повтор «как есть» только потратит время, а иногда и спишет лишние деньги. В операционных заметках от 2026-08-25 (архив темы) зафиксировано: «429 можно повторять, контентная безопасность повтора не требует» — это совпадает с нашим критерием.
- Можно повторять с задержкой: для 429 из-за нагрузки — экспоненциальная задержка; для 5xx — 1–2 повтора; при таймауте сначала поднимите клиентский таймаут до рекомендуемого значения. Записывайте
request-idиз заголовков ответа — пригодится для разбора. В документации -vip сказано: при RPM до 500 можно не задумываться о конкурентности. - Измените и отправьте заново: если параметры отклонены — сначала исправьте параметры; при 401 проверьте токен; при 400 сверьтесь с таблицей полей целевой модели. Неудачная аутентификация и провал валидации параметров не тарифицируются.
- Не повторяйте автоматически: отказ по контенту бывает двух видов. Первый — явная ошибка, например «не удалось сгенерировать изображение как ожидалось, измените промпт и попробуйте снова»; за это не списывают, и нужно править промпт. Второй — ответ 200, но в теле что-то вроде «я не могу выполнить этот запрос» — мягкий отказ. Формально по протоколу это нормальный ответ, он тарифицируется, и официальный сервис тоже не может заранее распознать его на уровне протокола. Не отправляйте один и тот же промпт повторно автоматически.
Вопрос: передал в -all параметр n=4 — почему получил всего 1 изображение, а списали 4 раза?
-all не принимает n, но если всё-таки передать — списание всё равно пойдёт кратно n. В примере на специальной странице n=3 списывает 0.075 доллара, а возвращается по-прежнему 1 изображение. Если нужно N картинок, вызывайте сервис N раз параллельно. Критерий приёмки: количество списаний в консоли равно количеству фактически полученных изображений.
Вопрос: на странице сравнения написано, что -all не принимает size, — так можно его передавать или нет?
Ориентируйтесь на специальную страницу -all: передавать можно. Явно переданный size имеет приоритет над описанием размера в промпте; если не передавать его или передать auto, сохраняется原生 поведение. Просто страницу сравнения ещё не успели обновить.
Вопрос: может ли корпоративная группа ускорить генерацию изображений?
Нет. В FAQ прямо указано, что это не линия ускорения — она лишь даёт дополнительный пул ресурсов на случай перегрузки группы по умолчанию. Модель 官逆 достаточно разместить в группе Default.
Вопрос: цена 0.2 для 官转 в интерфейсе тарифов — это плата за каждый вызов?
Так понимать не стоит. В сводной таблице цен указана оплата по объёму, и в этой статье мы тоже ориентируемся на оплату по объёму. Интерфейс для некоторых алиасов без даты возвращает model_price 0.2 — эти два источника расходятся, поэтому перед оформлением заказа проверьте фактическую цену со скидкой в консоли.
Вопрос: у версии 2.6 есть -all или -vip?
В сводной таблице цен и в интерфейсе ценообразования по состоянию на 2026-11-10 их нет, и в этой статье мы также не делаем никаких предположений о сроках запуска.
Конфигурация по умолчанию, которой можно просто следовать
- Имя модели:
gpt-image-2.5-all; если нужны размеры или 4K — меняйте наgpt-image-2.5-vip; если нужны официальные параметры — наgpt-image-2.6-flareилиgpt-image-2.6-sunburst - Группа: первый приоритет —
image2Enterprise, группа по умолчанию —Default; для бизнеса с жёсткой зависимостью от URL создайте отдельный токен и используйтеimage2_OSS - Тип токена: приоритет — оплата по факту использования (вызывать можно и через официальный форвард, и через официальный реверс)
- Таймаут в секундах: для -all/-vip — 300; для официального форварда при низком и среднем качестве — 240, при high/xhigh — 300, при max — 600
- Base URL:
https://api.apiyi.com/v1
Когда всё запущено с такой конфигурацией, обычно нужно следить всего за двумя вещами: что написано в error.message в теле ошибки и есть ли соответствующие сообщения в оперативной ленте за текущий день. Сверяясь с двумя таблицами выше, вы поймёте, нужно ли сделать паузу и повторить попытку, изменить запрос или переключить канал.
Автор: техническая команда APIYI
Техническая связь: если вы столкнулись с ошибкой, которая не описана в статье, напишите нам через главную страницу официального сайта APIYI, приложивrequest-idи полное тело ошибки.