Commençons par la conclusion. Pour générer des images en lot sur APIYI, on utilise par défaut gpt-image-2.5-all pour les tâches courantes, dans le groupe Default : l’appel passe aussi bien avec des jetons facturés à la requête qu’avec des jetons facturés à l’usage, au tarif affiché de 0,025 $/image. Si vous avez besoin d’une taille fixe ou de la 4K, remplacez le nom du modèle par une variante -vip du type gpt-image-2.5-vip, au tarif affiché de 0,03 $/image. Cela dit, la page dédiée à -all le précise elle-même : la 4K de -vip connaît des fluctuations de stabilité et n’est pas le premier choix pour la 4K. Pour disposer du niveau quality officiel, d’un repaint local avec masque ou de n’importe quelle taille légale, passez par l’officiel relayé (官转) ; pour un nouveau projet, privilégiez gpt-image-2.6-flare (priorité à la vitesse) et gpt-image-2.6-sunburst (priorité à l’édition et à la précision).
Le plan de secours se décline en deux cas. Quand l’officiel relayé renvoie en continu des 429 ou sature dans le groupe Default, basculez le groupe du jeton sur image2Enterprise, sans changer le nom du modèle. Quand l’officiel inversé (官逆) subit une panne de la version web de ChatGPT ou d’Adobe côté éditeur, n’enchaînez pas les backoffs sur la même ligne inversée : changez le nom du modèle pour un modèle officiel relayé et vérifiez que le jeton est bien en « priorité à l’usage » (按量优先). Autre point : deux types d’erreurs ne doivent jamais être réessayés tels quels — le refus pour raison de sécurité du contenu et les erreurs de paramètres. Attention aussi au paramètre n : sur -all, il facture n fois le prix, mais ne renvoie toujours qu’une seule image.
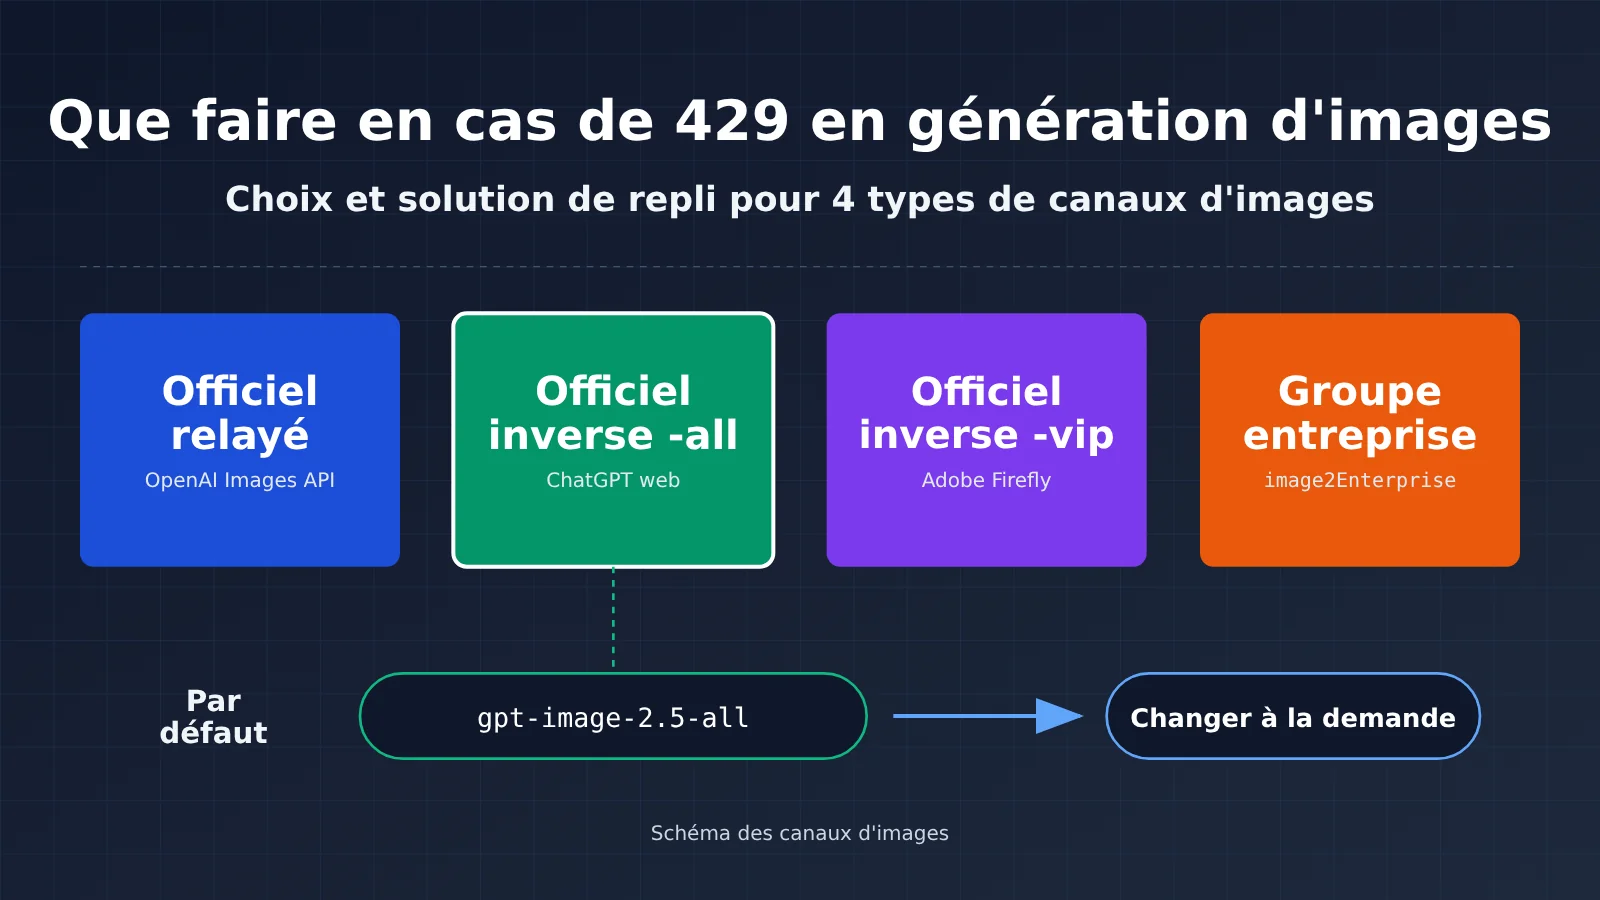
Quels sont les quatre noms du canal d’images GPT ?
Un même modèle d’images GPT peut apparaître dans la liste avec plusieurs suffixes, qui correspondent chacun à une source amont et à un mode de facturation. Parmi eux, le « groupe entreprise » n’est pas un modèle, mais une option de routage au niveau du jeton. Voici, en reprenant les termes de la documentation, ce que désigne chacun :
- 官转 (voie officielle directe) : connexion officielle directe à l’API OpenAI Images ; la documentation précise que les requêtes et les réponses sont identiques à celles d’OpenAI. Dans le tableau récapitulatif des prix, les modèles d’images de la voie 官转 sont
gpt-image-2.6-flare,gpt-image-2.6-sunburst,gpt-image-2.5-flare,gpt-image-2.5-sunburst, les snapshots datés de ces deux derniersgpt-image-2.5-flare-2026-09-08etgpt-image-2.5-sunburst-2026-09-08, ainsi que la génération précédentegpt-image-2. La documentation recommande d’utiliser flare en priorité pour le texte vers image, et sunburst pour l’édition et la fusion de plusieurs images. En production, vous pouvez verrouiller un snapshot daté pour éviter que la cible de l’alias ne change. - 官逆 -all (voie inversée « all ») : ingénierie inverse de la version web de ChatGPT.
gpt-image-2-alletgpt-image-2.5-allsont au même prix, se comportent de manière identique et sont interchangeables. La raison : la version web de ChatGPT est passée entièrement à Images 2.5, doncgpt-image-2-allproduit aussi des images 2.5. La documentation recommande aux nouveaux projets d’utiliser directementgpt-image-2.5-all. - 官逆 -vip (voie inversée « vip ») : la voie 官逆 d’Adobe (Firefly) ; les modèles sont
gpt-image-2-vip,gpt-image-2.5-flare-vipetgpt-image-2.5-sunburst-vip. L’aliasgpt-image-2.5-vippointe versgpt-image-2.5-sunburst-vip. - Groupe entreprise
image2Enterprise: un groupe de repli entreprise pour la voie 官转 côté amont OpenAI. La FAQ précise clairement qu’il ne s’agit pas de Google Vertex, ni d’une ligne accélérée destinée à réduire le temps de génération d’images. Son rôle est de fournir un autre pool de ressources lorsque le groupe par défaut est saturé, mais il ne garantit pas que l’amont sera toujours disponible.
Il existe aussi un groupe souvent pris à tort pour un fallback : image2_OSS. C’est un groupe à facteur 1, sans supplément, avec un seul objectif : garantir le retour d’une URL, sans dégradation en base64. Il n’améliore pas la stabilité et s’applique à -all et -vip.
Pour l’instant, la version 2.6 n’existe qu’en voie 官转. Dans le tableau récapitulatif des prix et l’API de tarification du 2026-11-10, on ne trouve ni gpt-image-2.6-all, ni gpt-image-2.6-vip, ni de nom similaire. Les modèles et les prix de référence sont ceux de la liste des modèles de la plateforme.
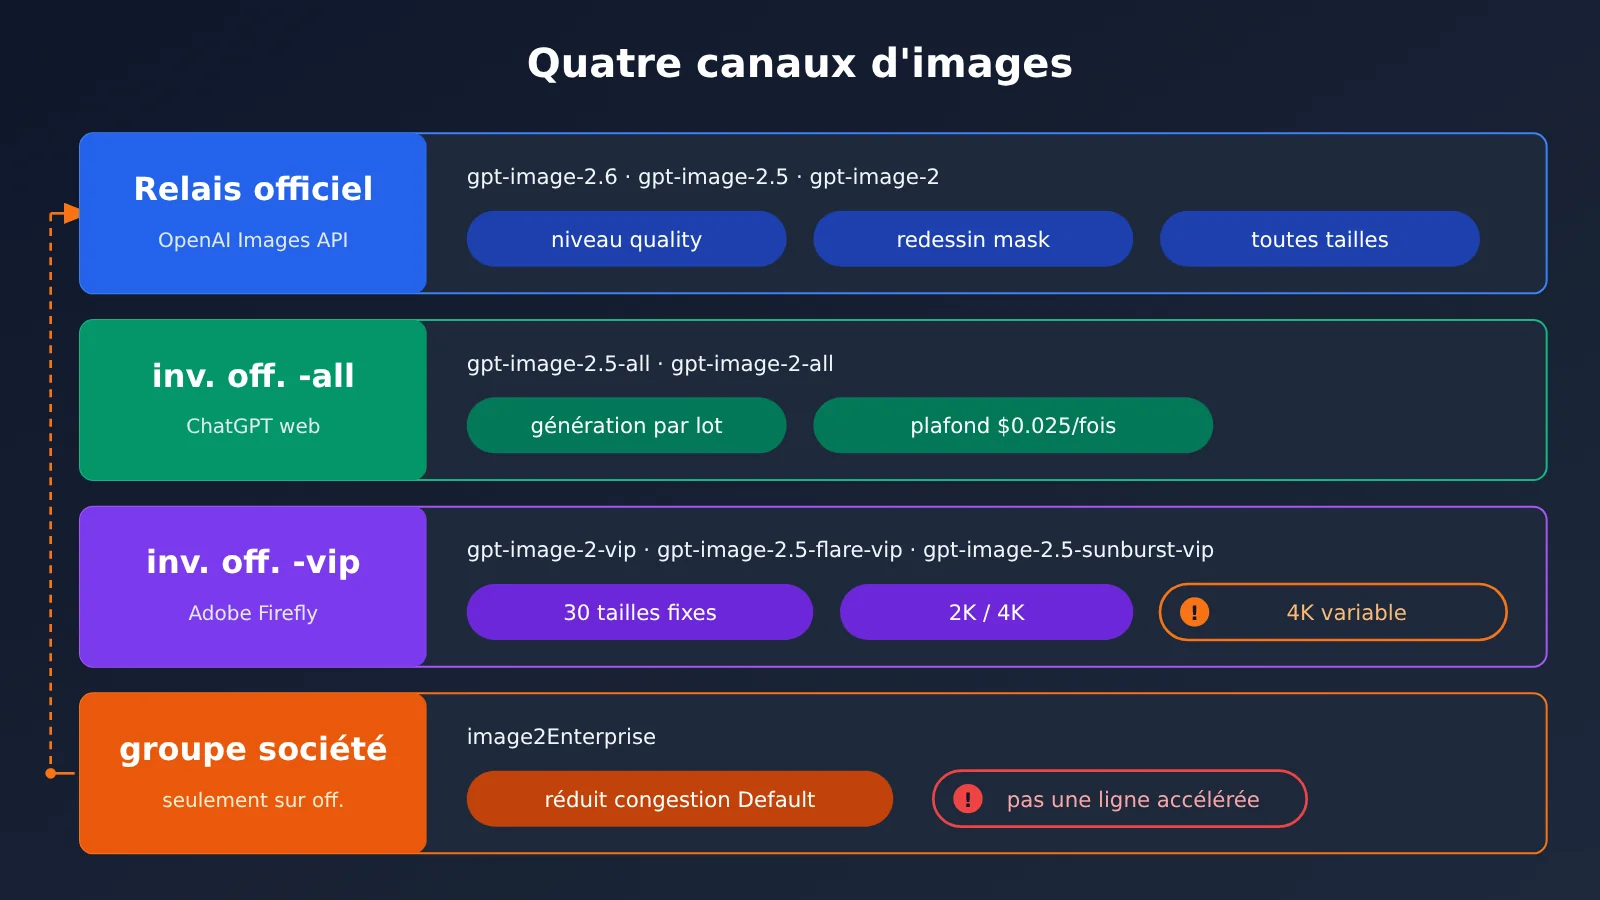
Choisir le canal d’image par défaut selon le scénario : tableau comparatif prix et capacités
Lors du choix d’un canal, commencez par examiner trois questions : avez-vous besoin des niveaux de qualité officiels, à quel point les dimensions sont-elles contraignantes, et faut-il plafonner le coût par image. Vous pouvez suivre l’ordre ci-dessous :
- Génération d’images en lot, coût plafonné par image, grand côté entre 512 et 1536 : utilisez
gpt-image-2.5-all. Critère de validation : la largeur et la hauteur réelles de l’image renvoyée correspondent aux attentes, et le montant débité dans la console à chaque appel est égal au prix unitaire multiplié par le nombre d’appels. - Besoin d’une taille fixe parmi les 30 paliers, ou de 2K/4K : passez à un modèle -vip et transmettez explicitement
size. Critère de validation : fiez-vous aux dimensions réelles de l’image renvoyée, ne vous contentez pas des paramètres de la requête. - Besoin du
qualityofficiel, d’une retouche locale viamask, d’un fond transparent, d’une taille valide quelconque, ou d’aligner les champs avec OpenAI : passez par un relais officiel. Pour les nouveaux projets, utilisez 2.6 ; si vous devez figer le comportement, utilisez un snapshot 2.5 daté. Critère de validation : les champs de la requête correspondent au tableau officiel des paramètres du modèle cible, sans erreur 400.
Tableau comparatif des prix des canaux d’image
La facturation et les prix indiqués dans le tableau ci-dessous proviennent du tableau tarifaire global (mis à jour le 2026-11-09) ; ce sont tous des prix affichés avant remise. Après le bonus de rechargement de 10 % à 20 %, le montant réellement débité sera plus bas ; en dernier ressort, c’est la console qui fait foi. Pour la liste complète des modèles et des prix, consultez docs.apiyi.com/models.
| Modèle | Nature du canal | Facturation | Prix affiché (avant remise) | Groupes disponibles |
|---|---|---|---|---|
gpt-image-2.6-flare / gpt-image-2.6-sunburst |
Relais officiel (lancé le 2026-11-05) | À l’usage | Par million de tokens : entrée texte 5, entrée image 8, sortie 30 USD | Default, image2Enterprise, image2_OSS, SVIP |
gpt-image-2.5-flare / gpt-image-2.5-sunburst et snapshot du 2026-09-08 |
Relais officiel | À l’usage | Idem, lecture de cache texte 1,25, image 2 USD | Default, image2Enterprise, image2_OSS, SVIP |
gpt-image-2 |
Relais officiel (génération précédente) | À l’usage | Idem | Default, image2Enterprise, image2_OSS, SVIP |
gpt-image-2.5-all / gpt-image-2-all |
Rétro-ingénierie — web ChatGPT officiel | Par appel | 0,025 USD/appel | Default, image2_OSS, SVIP |
gpt-image-2.5-vip et 3 autres noms -vip |
Rétro-ingénierie — Adobe Firefly officiel | Par appel | 0,03 USD/appel | Default, image2_OSS, SVIP |
Il y a une incohérence entre l’API de tarification et le tableau tarifaire global ; il faut les considérer séparément. Dans l’API de tarification, gpt-image-2, gpt-image-2.5-flare et gpt-image-2.5-sunburst ont un quota_type de 1 et un model_price de 0.2. En revanche, gpt-image-2.6-flare, gpt-image-2.6-sunburst et les deux snapshots du 2026-09-08 ont un quota_type de 0 et un model_price de 0. Le tableau tarifaire global, lui, indique tous ces modèles en relais officiel comme étant facturés à l’usage. Les prix affichés dans cet article suivent la logique « à l’usage » du tableau tarifaire global ; on ne considère pas 0,2 comme un prix par appel. Avant de passer commande, vérifiez dans la console le prix réel après remise de votre groupe. Les 0,025 des -all et les 0,03 des -vip concordent entre les deux sources ; on peut donc les utiliser comme prix par appel.
Le coût par image en relais officiel dépend des tokens de sortie. La page de comparaison (telle que décrite dans la documentation) donne une fourchette typique d’environ 0,03 à 0,2 USD par image : plus l’invite est longue et plus size et quality sont élevés, plus le coût grimpe. La documentation contient une estimation approximative datée du 2026-09-09 : une image carrée 1024 avec 2.5 en xhigh coûte environ 0,094 USD (3122 tokens de sortie), et en max environ 0,211 USD (7024 tokens de sortie), hors entrée qui coûte généralement moins de 0,001 USD. Conclusion de la documentation : pour un croquis 1K en low, passer par le relais officiel n’est pas forcément plus cher ; c’est sur les qualités moyennes à élevées que la rétro-ingénierie à 0,025–0,03 USD devient plus avantageuse.
Un autre ancien prix mérite d’être signalé. Un ancien article du centre d’aide daté du 2026-04-25 indiquait gpt-image-2-all à 0,03 USD/appel, mais c’était le tarif d’avant la baisse. Les -all sont passés à 0,025 USD le 2026-10-10, et les deux noms -all ont été ajustés en même temps. La raison de cette baisse selon la documentation : les -all sont plus stables que les -vip, ces derniers étant davantage affectés par le contrôle des risques de l’éditeur d’origine et donc plus fluctuants, mais ils restent maintenus et utilisables normalement.
Tableau comparatif des capacités des canaux d’image
| Capacité | Reverse officiel -all | Reverse officiel -vip | Relais officiel |
|---|---|---|---|
size |
Page dédiée : largeurs/hauteurs courantes avec un côté long de 512 à 1536, y compris les valeurs non multiples de 16 ; la 2K n’est pas listée comme prise en charge exacte | 30 paliers (10 ratios × 1K/2K/4K), effectifs uniquement sur l’endpoint images | Toute taille valide, avec des côtés multiples de 16 et un ratio ne dépassant pas 3:1 ; les préréglages incluent 3840×2160 |
quality |
Non accepté | Comportement du canal, aucune garantie ; les deux variantes 2.5 ont été retestées jusqu’à max le 2026-09-10, gpt-image-2-vip ne va que jusqu’à high |
Paliers garantis officiellement ; xhigh/max réservés aux deux variantes 2.5 (page comparative) |
n |
Non accepté ; même transmis, la facturation reste multipliée par n | Non pris en charge, 1 image par requête | Pris en charge |
| Masque | Uniquement une régénération de l’image entière | Uniquement une régénération de l’image entière | Prend en charge la retouche locale avec mask |
| Fond transparent | Pas de background ; il faut le décrire dans l’invite |
Peut produire un PNG alpha, sans garantie documentaire | Pris en charge en 2.5 ; gpt-image-2 a été désactivé |
| Vitesse (selon la documentation) | Page dédiée : environ 30 à 60 secondes ; page comparative : environ 90 secondes | gpt-image-2-vip : 90 à 150 secondes ; flare-vip : 22 à 138 secondes ; sunburst-vip : 37 à 120 secondes |
Au 2026-09-09, 2.5-flare 1K low : environ 10 secondes ; sunburst : environ 14 secondes ; gpt-image-2 : 100 à 120 secondes |
Concernant la vitesse de -all, les deux documents ne disent pas la même chose : la page dédiée indique environ 30 à 60 secondes, tandis que la page comparative parle d’environ 90 secondes. Cet article donne les deux chiffres, sans faire de moyenne. Le size de -all présente aussi un décalage documentaire : la page dédiée écrit « size est désormais pris en charge », alors que la page comparative indique encore que ce n’est pas accepté. Nous nous basons ici sur la page dédiée. Celle-ci précise également qu’une image carrée de 1536 peut avoir subi une interpolation et ne représente pas forcément les détails natifs. Pour la 2.6, « génération 50 % plus rapide, Flare en qualité faible en 6 secondes dans le meilleur des cas » vient d’une annonce officielle relayée dans le fil d’actualité du 2026-11-05, et non de données retestées par la plateforme. Les nouveaux paramètres de la 2.6 (complexity, SVG, GIF, etc.) doivent être vérifiés dans la documentation officielle OpenAI ; on ne peut pas appliquer directement le tableau des paramètres de la 2.5.
Si les besoins en 4K sont nombreux, la page dédiée de -all mentionne aussi une autre piste : Nano Banana sur APIYI. Dans le tableau récapitulatif des prix, les séries nano-banana-pro et gemini-3-pro-image sont à 0.09 USD par requête, tandis que nano-banana-2 et gemini-3.1-flash-image sont à 0.055 USD par requête. Les groupes entreprise de cette piste sont NanoBananaEnterprise et NanoBananaReverse, et ils ne doivent pas être confondus avec image2Enterprise.
Comment configurer les types de jetons et les priorités de groupe pour le canal d’images
Beaucoup d’erreurs ne viennent pas du canal lui-même, mais d’un type de jeton ou d’un groupe mal configuré. Tous les canaux passent par la même URL de base : https://api.apiyi.com/v1. Les points de terminaison recommandés sont /v1/images/generations et /v1/images/edits. Une seule règle concernant les types de jetons est vraiment à retenir : le relais officiel exige impérativement le « paiement à l’usage prioritaire ». Appeler le relais officiel avec un jeton à la requête sera refusé, car le mode de facturation ne correspond pas. Pour -all et -vip, « facturation à la requête » comme « paiement à l’usage prioritaire » fonctionnent.
| Groupe | Multiplicateur (interface de tarification 2026-11-10) | Canaux concernés | Usage | Attention |
|---|---|---|---|---|
Default |
1 | relais officiel, -all, -vip | premier choix par défaut | aux heures de pointe, le relais officiel peut saturer et renvoyer des 429 |
image2Enterprise |
1.2 | relais officiel uniquement | repli entreprise côté amont OpenAI | ce n’est pas une ligne accélérée, ni Vertex ; -all et -vip ne sont pas dans ce groupe |
image2_OSS |
1 | relais officiel, -all, -vip | garantit une sortie au format URL | n’améliore pas la stabilité ; l’URL expire au bout d’environ 24 heures |
SVIP |
l’interface renvoie 1, se fier à la page des jetons de la console | relais officiel, -all, -vip | selon les indications de la console | l’opération promotionnelle à multiplicateur limité dans le temps est terminée depuis le 2026-10-29 |
Pour le multiplicateur de 1,2 du groupe entreprise, la documentation l’explique ainsi : il est calibré sur « environ le prix du site officiel après le bonus de 20 % accordé aux gros clients qui rechargent 3 000 USD en une seule fois », la plateforme ne comptant pas les coûts fiscaux. Quant aux modèles visibles dans ce groupe, le tableau du corps de la FAQ liste gpt-image-2.5-flare, gpt-image-2.5-sunburst et gpt-image-2. Le tableau récapitulatif des prix et le champ enable_groups de l’interface de tarification indiquent que les deux versions 2.6 y figurent aussi ; le tableau de la FAQ n’a pas encore été mis à jour. La documentation ne précise pas si ce groupe doit faire l’objet d’une demande séparée : si vous ne le voyez pas dans la liste, fiez-vous à ce qu’affiche la console.
La configuration recommandée, c’est « un seul jeton pour couvrir les deux types de modèles ». Un jeton peut avoir 1 groupe par défaut et jusqu’à 2 groupes de secours. Selon la méthode décrite dans la documentation, mettez la première priorité sur image2Enterprise et le groupe par défaut sur Default. Ainsi, les requêtes vers le relais officiel passent d’abord par le groupe entreprise, tandis que -all et -vip, qui n’y figurent pas, restent sur Default et génèrent les images normalement. Concrètement : ouvrez api.apiyi.com/token, modifiez le jeton, sélectionnez les groupes et enregistrez ; le code n’a pas besoin d’être modifié. Critère de validation : avec la même requête, appelez une fois un modèle du relais officiel et une fois un modèle -all ; les deux doivent produire une image, et la console doit facturer la requête du relais officiel au multiplicateur 1,2.
Les activités qui dépendent fortement des URL doivent être traitées à part. Dans le groupe par défaut, la documentation note qu’en 2026-07, si l’on ne passe pas response_format, la réponse est en b64_json ; en passant explicitement response_format à url, on obtient un lien, mais le groupe par défaut ne garantit pas le format de sortie. Pour ces cas, basculez le jeton sur image2_OSS, passez explicitement url, puis téléchargez et archivez le fichier dès réception du lien. Critère de validation : la réponse contient bien un champ url et le fichier recopié s’ouvre correctement.
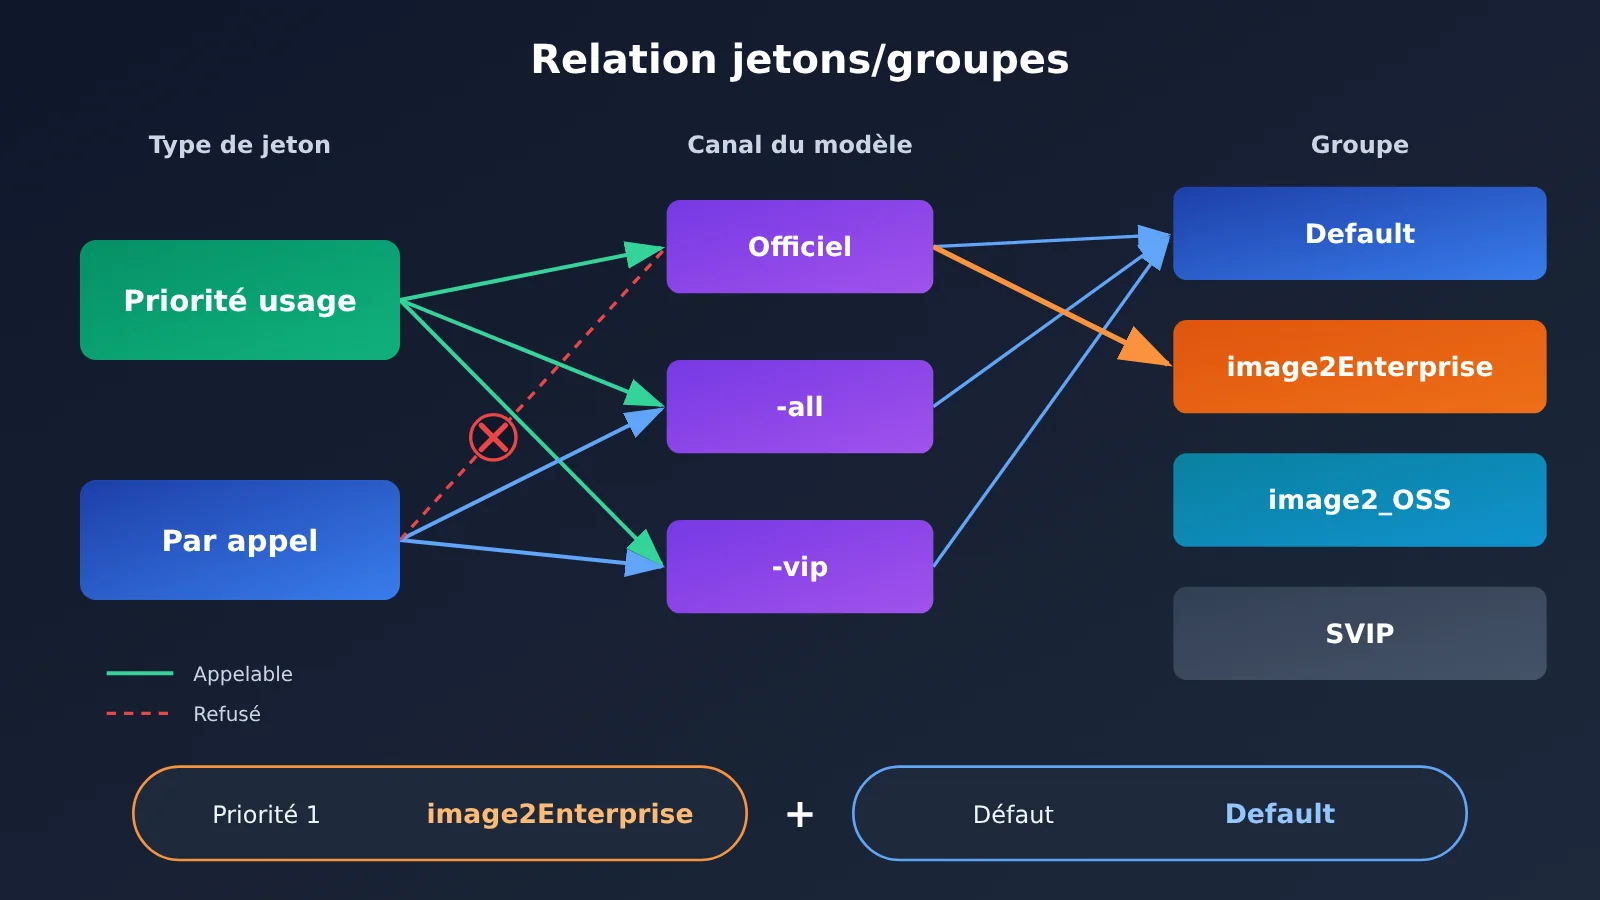
Comment rattraper les erreurs 429, la saturation et les pannes upstream lors de la génération d’images
Un même code d’erreur peut cacher des causes très différentes. La première étape consiste donc à lire error.message dans le corps de la réponse, puis à décider de la marche à suivre. La page dédiée à -vip distingue deux cas de 429 : le paramètre refusé et la saturation du groupe. La page -all, elle, reste plus vague et parle de « limite de débit ou quota insuffisant ». Le fil d’actualité temps réel a par ailleurs documenté deux types de pannes côté fournisseur, l’une venue de ChatGPT web, l’autre d’OpenAI en amont. Le tableau ci-dessous résume tout ça sous la forme « quel message je vois → quoi faire d’abord » :
| Ce que vous voyez | Diagnostic | Première action | Critère de validation |
|---|---|---|---|
| 官转 enchaîne les 429 sur Default ou signale une saturation | Congestion du groupe par défaut | Sur api.apiyi.com/token, basculer le groupe sur image2Enterprise, ou augmenter sa priorité — le nom du modèle ne change pas |
La même requête produit bien une image, la facturation passe à 1,2× |
-vip renvoie 429 avec un message du type quality must be one of… |
Paramètre refusé | Corriger le paramètre, ne surtout pas réessayer à l’identique | La première requête après correction réussit |
| -vip renvoie 429 avec un message du genre « la charge upstream du groupe actuel est saturée » | Saturation ponctuelle | Backoff exponentiel, en surveillant le fil d’actualité temps réel | Rétablissement en un nombre limité de tentatives, sinon basculer en 官转 |
| -all/-vip concentrent les erreurs sur la journée et le fil temps réel annonce une panne fournisseur | Panne ChatGPT web ou Adobe côté fournisseur | Arrêter le backoff, changer le nom du modèle pour passer en 官转 | La requête en 官转 réussit, avec un jeton en facturation à l’usage |
Le groupe entreprise de 官转 renvoie The server had an error while processing your request. |
Panne upstream OpenAI | Réessayer 1 à 2 fois, puis basculer en 官逆 si ça ne passe pas | Après passage sur -all, l’image se génère |
| 401 | Problème de jeton | Vérifier le jeton, ne pas réessayer | Rétabli après avoir utilisé le bon jeton |
gpt-image-2 avec background à transparent renvoie 400 |
La fonctionnalité a été désactivée côté officiel | Pour un fond transparent, passer à 2.5 官转 avec png ou webp | L’image renvoyée possède bien un canal alpha |
Si vous soupçonnez une panne côté fournisseur, commencez par vérifier sur docs.apiyi.com/live s’il y a une annonce correspondante ce jour-là, puis décidez entre backoff et changement de canal. Passer de 官逆 à 官转 est enfantin : sur APIYI, avec le même jeton, il suffit de changer le nom du modèle. La page de comparaison le dit textuellement : « il suffit de changer le nom de model pour basculer en 官转 ». Mais deux prérequis sont à vérifier un par un :
- Type de jeton : assurez-vous que le jeton est bien en « facturation à l’usage prioritaire ». Avec un jeton facturé à la requête, la demande sera rejetée.
- Retirer les champs selon le modèle cible : en passant à
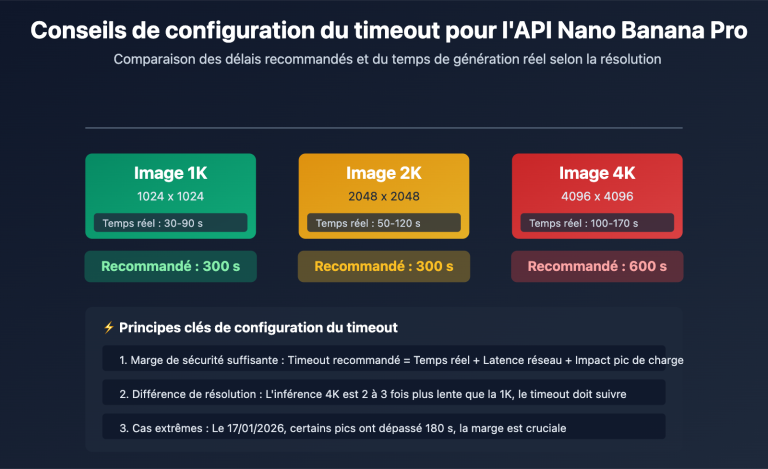
gpt-image-2, supprimez les paliers xhigh et max ainsi que le fond transparent ; les dimensions non multiples de 16 héritées de -all doivent être ramenées à un multiple de 16, avec un ratio ne dépassant pas 3:1. Dans l’autre sens, de 官转 vers -all, il faut retirerquality,n,aspect_ratioetmask. - Timeouts : en 官转, comptez 240 secondes pour la qualité basse et moyenne, 300 secondes pour high et xhigh, et 600 secondes en filet de sécurité pour max ainsi que pour le high de
gpt-image-2. Pour -all et -vip, restez prudent avec 300 secondes. Compressez d’abord les images d’entrée sous 1,5 Mo.
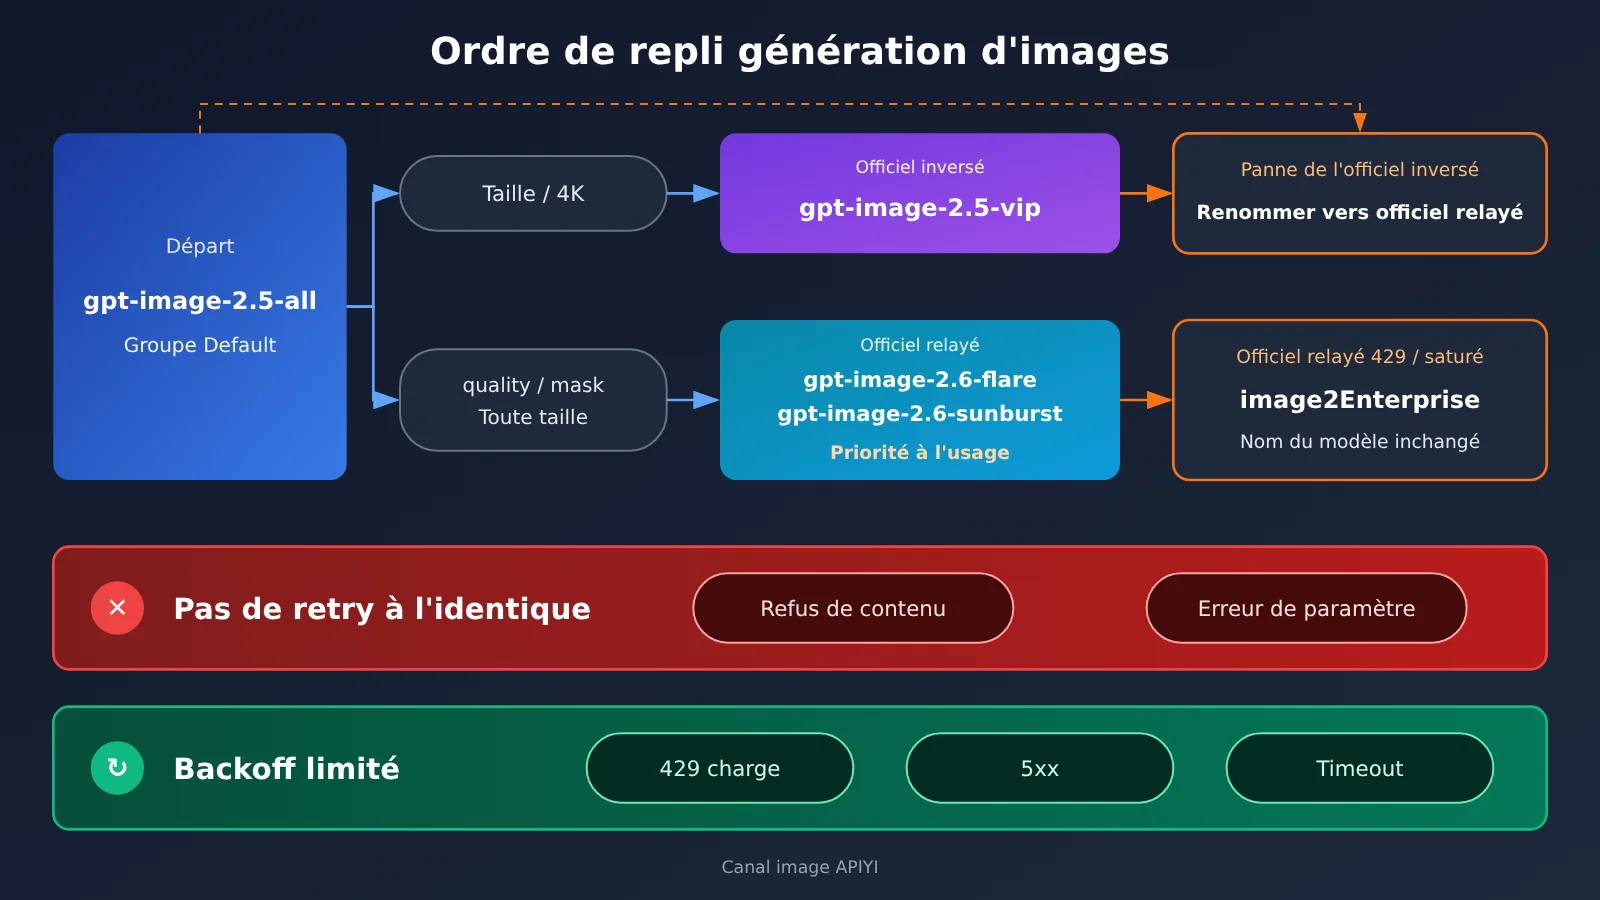
Tableau de lecture des annonces historiques d’avril à novembre 2026
Les événements ci-dessous servent uniquement à illustrer « quels types de pannes se sont déjà produits et comment ils ont été traités à l’époque » ; ils ne représentent pas la situation au 2026-11-10. Pour savoir si le service est actuellement saturé, fiez-vous à l’erreur renvoyée pour la requête concernée et aux informations en temps réel.
| Date | Événement (annonce historique) | Traitement à l’époque | Utilisation aujourd’hui |
|---|---|---|---|
| 2026-04-29 | Le groupe par défaut du relais officiel renvoie toujours des 429 ; seul image2Enterprise est stable, -all et -vip étant tous deux stables | Le relais officiel passe par le groupe entreprise | Cas typique de « congestion du groupe par défaut du relais officiel » |
| 2026-05-07 | Le groupe entreprise du relais officiel renvoie lui aussi une erreur serveur ; la cause racine est l’amont OpenAI | Attendre le rétablissement de l’amont ou changer de canal | Le groupe entreprise ne garantit pas non plus que l’amont reste toujours disponible |
| 2026-05-13 | Le groupe par défaut est saturé, image2Enterprise peut encore générer des images | Basculer vers le groupe entreprise | Prend en charge la configuration par priorité |
| 2026-05-23 | Des ressources ont été ajoutées au groupe par défaut ; la documentation indique qu’il n’est pas nécessaire de basculer spécialement vers le groupe entreprise | Retour à Default | La congestion est passagère |
| 2026-09-21 | La concurrence est tendue sur le groupe par défaut du relais officiel 2.5 ; le groupe entreprise est stable | Basculer vers le groupe entreprise | Idem |
| 2026-10-15 | gpt-image-2-vip est en surcharge ; -all renvoie une erreur à cause d’une panne du fournisseur d’origine de ChatGPT Web ; l’arrière-plan transparent de gpt-image-2 est désactivé (noté au 2026-09-30 sur la page de comparaison) |
Pour le canal inverse officiel, utiliser d’abord le relais officiel comme solution de repli ; pour le fond transparent, passer au relais officiel 2.5 | En cas de panne du fournisseur d’origine, changez de canal au lieu de vous acharner |
| 2026-11-05 | Le relais officiel 2.6 est en ligne ; le groupe Default est disponible | Les nouveaux projets peuvent l’utiliser | Il s’agit d’une annonce de mise en ligne, pas d’un incident |
Quelles erreurs de génération d’images réessayer, et lesquelles ne pas réessayer
Un seul critère permet de décider s’il faut réessayer : la cause de l’erreur va-t-elle disparaître d’elle-même avec le temps ? Les erreurs de charge de type 429, 5xx et les délais d’attente peuvent se résorber spontanément, on peut donc tenter un nombre limité de tentatives avec backoff ; les erreurs de paramètres, les erreurs de jeton et les refus de contenu, elles, ne disparaîtront pas toutes seules : renvoyer la même requête à l’identique ne fait que perdre du temps, et parfois coûte même un peu plus cher. La règle d’exploitation archivée dans la sélection du 2026-08-25 est « 429 réessayable, contenu sensible non réessayable », ce qui rejoint ce critère.
- Réessayer avec backoff : pour les erreurs de charge 429, utiliser un backoff exponentiel ; pour les 5xx, réessayer 1 à 2 fois ; pour les délais d’attente, commencer par régler le timeout côté client sur la valeur recommandée. Notez le
request-idprésent dans les en-têtes de réponse, cela facilite le diagnostic. La documentation -vip indique qu’en dessous de 500 RPM, il n’est pas nécessaire de se préoccuper d’emblée des problèmes de concurrence. - Modifier puis renvoyer : en cas de rejet de paramètre, corriger d’abord le paramètre ; en cas de 401, vérifier d’abord le jeton ; en cas de 400, comparer d’abord avec le tableau des champs du modèle ciblé. Un échec d’authentification ou de validation des paramètres n’est pas facturé.
- Ne pas réessayer automatiquement : le refus de contenu se présente sous deux formes. La première renvoie une erreur explicite, par exemple « l’image n’a pas été générée comme prévu, veuillez ajuster votre invite puis réessayer » : ce cas n’est pas facturé, il faut modifier l’invite. La seconde renvoie un 200, mais le corps de la réponse contient un refus mou du type « je ne peux pas répondre à cette demande ». Au niveau du protocole, cela compte comme un retour normal, c’est facturé, et le canal inverse officiel ne peut pas non plus l’identifier à l’avance au niveau protocolaire. Ne soumettez pas automatiquement la même invite une seconde fois.
Question : j’ai passé n=4 à -all, pourquoi je n’ai reçu qu’une seule image alors que j’ai été facturé 4 fois ?
-all n’accepte pas n, mais si vous le passez quand même, la facturation reste multipliée par n. L’exemple donné sur la page dédiée est n=3 pour 0.075 USD débités, alors qu’une seule image est renvoyée. Si vous avez besoin de N images, il faut lancer N appels en parallèle. Critère de validation : le nombre de débits dans la console doit correspondre au nombre d’images réellement obtenues.
Question : la page de comparaison indique que -all n’accepte pas size, alors on peut le passer ou non ?
C’est la page dédiée à -all qui fait référence : oui, vous pouvez le passer. Le size fourni explicitement a la priorité sur la description de dimensions contenue dans l’invite ; si vous ne le passez pas ou que vous passez auto, le comportement natif est conservé. La page de comparaison n’a simplement pas encore été mise à jour.
Q : Le groupe Entreprise peut-il accélérer la génération d’images ?
Non. La FAQ l’indique clairement : ce n’est pas une voie d’accélération. Son rôle est simplement d’offrir un autre pool de ressources lorsque le groupe par défaut est saturé. Il suffit de placer les modèles officiels rétro-ingénierés dans le groupe Default.
Q : Dans l’API de tarification, le 0.2 du relais officiel correspond-il à un prix par appel ?
Non, ce n’est pas comme ça qu’il faut le comprendre. Le tableau tarifaire global indique une facturation à l’usage, et cet article se base lui aussi sur ce principe. Pour certains alias sans date, l’API renvoie model_price à 0.2 ; les deux sources ne sont pas alignées. Avant de passer commande, vérifiez le prix réel après remise dans la console.
Question : existe-t-il des versions -all ou -vip pour 2.6 ?
Dans le tableau récapitulatif des prix et l’interface de tarification au 2026-11-10, elles n’apparaissent pas, et cet article ne fait aucune supposition sur une éventuelle date de lancement.
Configuration par défaut à appliquer
- Nom du modèle :
gpt-image-2.5-all; si vous avez besoin de dimensions spécifiques ou de 4K, passez àgpt-image-2.5-vip; si vous avez besoin des paramètres officiels, passez àgpt-image-2.6-flareougpt-image-2.6-sunburst - Groupe : en première priorité
image2Enterprise, groupe par défautDefault; pour les activités fortement dépendantes des URL, créez un jeton séparé et utilisezimage2_OSS - Type de jeton : paiement à l’usage en priorité (les canaux officiels directs et inverses peuvent tous deux être appelés)
- Délai d’expiration en secondes : réglez 300 pour -all/-vip ; pour le canal officiel direct, 240 en qualité basse et moyenne, 300 pour high/xhigh, 600 pour max
- URL de base :
https://api.apiyi.com/v1
Une fois cette configuration en place, il ne vous reste que deux choses à surveiller au quotidien : ce qu’indique error.message dans le corps de la réponse d’erreur, et si le statut en temps réel du jour contient une annonce à ce sujet. En vous référant aux deux tableaux ci-dessus, vous pourrez déterminer s’il faut réessayer avec un backoff, modifier la requête ou changer de canal.
Auteur : l’équipe technique APIYI
Échanges techniques : si vous rencontrez une erreur non couverte dans cet article, n’hésitez pas à nous contacter via la page d’accueil du site officiel APIYI, en joignant lerequest-idet le corps d’erreur complet.