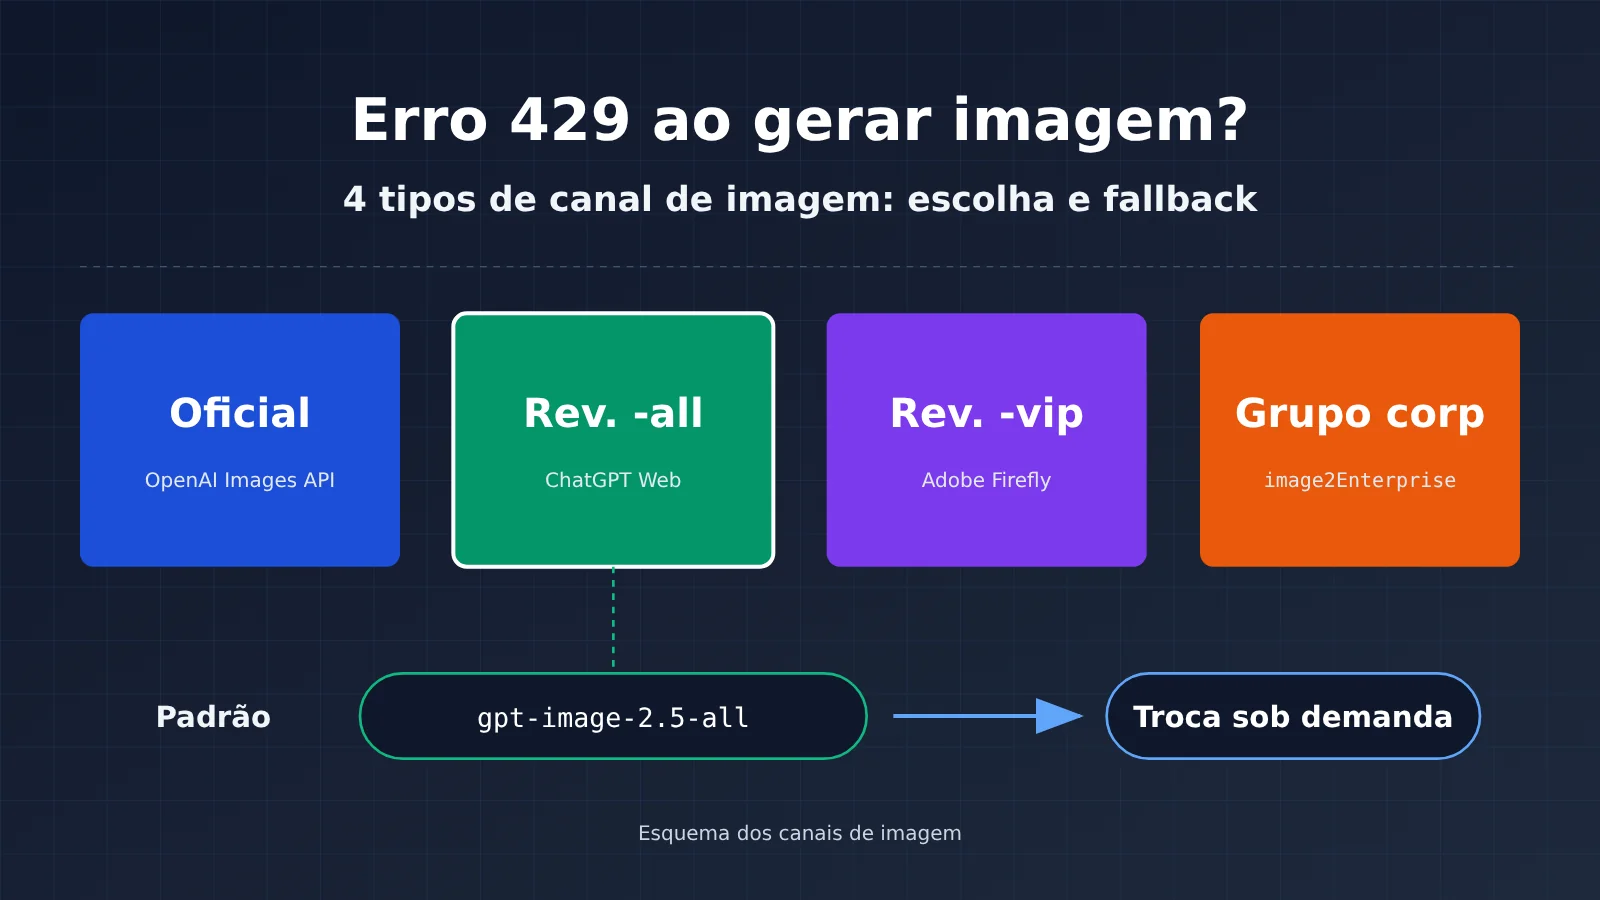
Vamos direto à conclusão. Para geração de imagens em lote na APIYI, use por padrão gpt-image-2.5-all em tarefas comuns, no grupo Default. Funciona tanto com token por chamada quanto com token por consumo, e o preço tabelado é de 0.025 USD/imagem. Quando precisar travar um tamanho fixo ou usar 4K, troque o nome do modelo por um modelo -vip, como gpt-image-2.5-vip, com preço tabelado de 0.03 USD/imagem. Mas a própria página dedicada ao -all avisa que o 4K do -vip tem instabilidade e não é a primeira escolha para 4K. Se você precisa do nível oficial de quality, de inpainting local com máscara ou de qualquer tamanho válido, use o canal oficial via proxy. Para projetos novos, priorize gpt-image-2.6-flare (prioridade em velocidade) e gpt-image-2.6-sunburst (prioridade em edição e precisão).
O fallback tem dois cenários. Se o canal oficial via proxy no grupo Default continuar retornando 429 ou ficar saturado, mude o grupo do token para image2Enterprise, sem alterar o nome do modelo. Se o canal oficial reverso enfrentar falha na versão web do ChatGPT ou no serviço original da Adobe, não faça backoff repetidamente na mesma rota reversa: troque o nome do modelo para um modelo do canal oficial via proxy e confirme que o token está com prioridade por consumo. Além disso, há dois tipos de erro que não devem ser repetidos como estão: recusa por segurança de conteúdo e erro de parâmetro. Fique atento também ao parâmetro n: no -all ele cobra n vezes, mas ainda retorna apenas 1 imagem.
Quais são os quatro nomes dos canais de imagem do GPT
O mesmo modelo de imagem do GPT aparece na lista com vários sufixos, e cada um representa a origem upstream e a forma de cobrança. Entre eles, o grupo empresarial não é um modelo, mas uma opção de roteamento no token. A seguir, explico um por um conforme os termos da documentação:
- Oficial direto: conexão direta oficial com a OpenAI Images API; a documentação afirma que a requisição e a resposta são iguais às oficiais da OpenAI. Na tabela geral de preços, os modelos de imagem oficiais diretos são
gpt-image-2.6-flare,gpt-image-2.6-sunburst,gpt-image-2.5-flare,gpt-image-2.5-sunburst, os snapshots datados dos dois últimosgpt-image-2.5-flare-2026-09-08egpt-image-2.5-sunburst-2026-09-08, além da geração anteriorgpt-image-2. A documentação recomenda usar flare para texto para imagem e sunburst para edição e fusão de várias imagens. Em produção, dá para fixar o snapshot datado para evitar que o alias mude de destino. - Reverso oficial -all: versão web do ChatGPT por engenharia reversa.
gpt-image-2-allegpt-image-2.5-alltêm o mesmo preço, comportamento idêntico e são intercambiáveis. O motivo é que a versão web do ChatGPT foi totalmente atualizada para o Images 2.5, entãogpt-image-2-alltambém gera imagens 2.5. A documentação recomenda que projetos novos usemgpt-image-2.5-alldiretamente. - Reverso oficial -vip: linha reversa oficial da Adobe (Firefly), com os modelos
gpt-image-2-vip,gpt-image-2.5-flare-vipegpt-image-2.5-sunburst-vip. O aliasgpt-image-2.5-vipaponta paragpt-image-2.5-sunburst-vip. - Grupo empresarial
image2Enterprise: grupo de fallback empresarial do canal oficial direto no upstream da OpenAI. O FAQ deixa claro que não é o Google Vertex, nem uma linha de aceleração para reduzir o tempo de geração. A função é oferecer outro pool de recursos quando o grupo padrão está congestionado, mas sem garantia de que o upstream estará sempre disponível.
Há também um grupo que costuma ser confundido com fallback: image2_OSS. Ele é um grupo de 1x, sem acréscimo de preço, e tem um único propósito: garantir que a URL seja retornada, sem ser rebaixada para base64. Ele não melhora a estabilidade e se aplica a -all e -vip.
O 2.6 atualmente só tem versão oficial direta. Na tabela geral de preços e na API de preços de 2026-11-10, não existem gpt-image-2.6-all, gpt-image-2.6-vip ou nomes parecidos. Modelos e preços devem ser consultados na lista de modelos da plataforma.
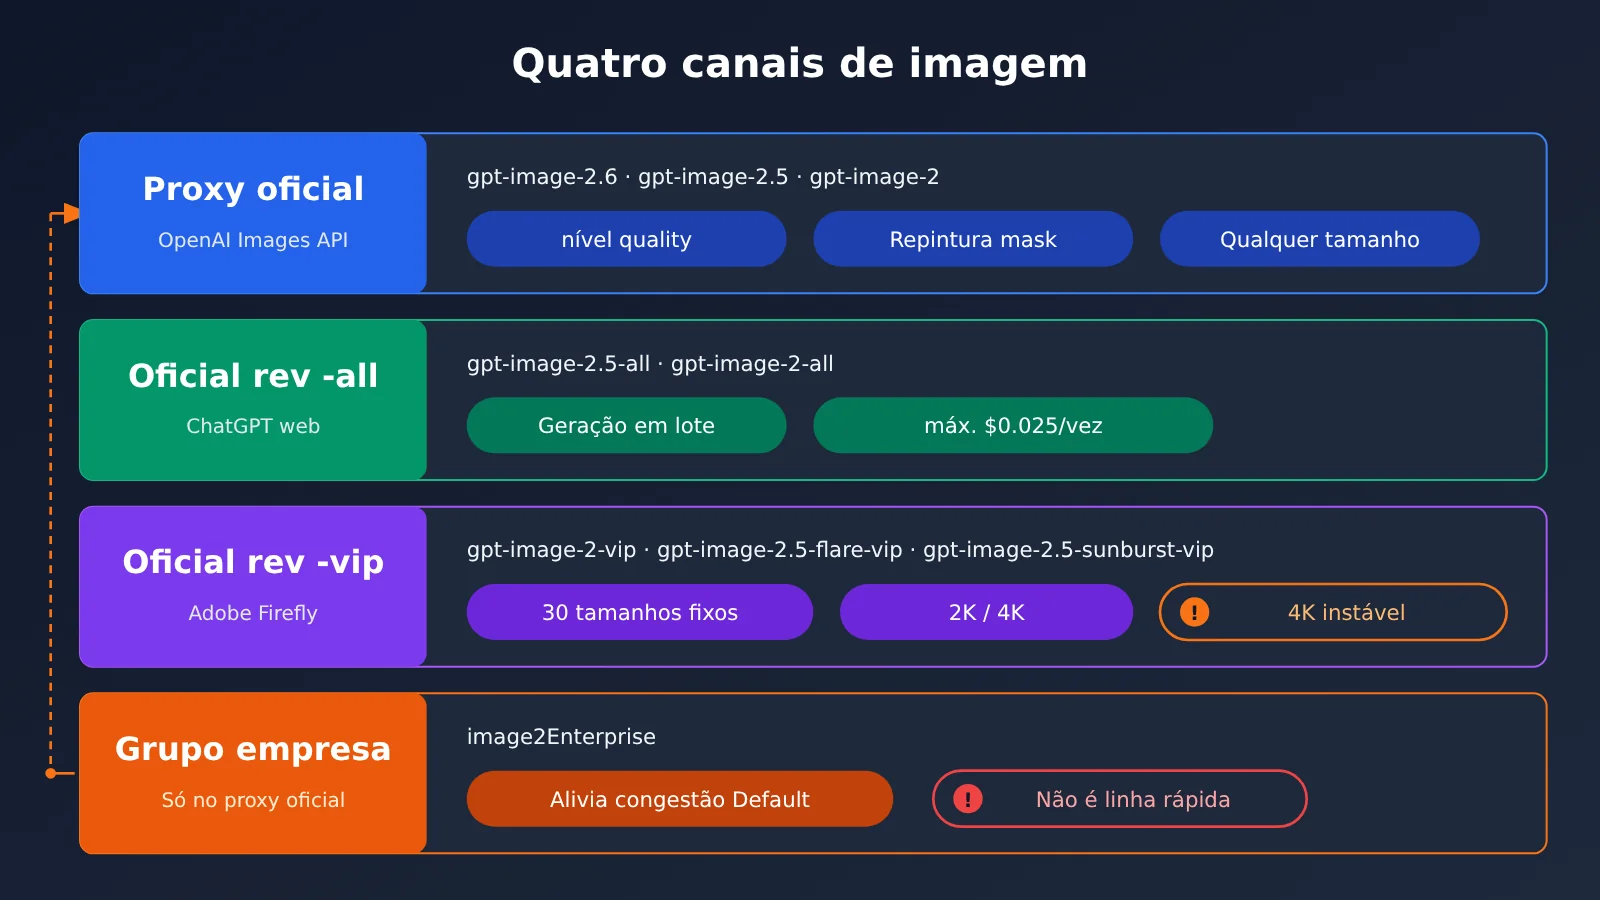
Escolha do canal de imagem padrão por cenário: tabela comparativa de preços e capacidades
Ao escolher um canal, comece respondendo a três perguntas: você precisa dos níveis de qualidade oficiais? Quão rígida é a exigência de tamanho? O custo precisa ter um teto por imagem? Use a ordem abaixo para decidir:
- Geração em lote, custo com teto por imagem e lado maior entre 512 e 1536: use
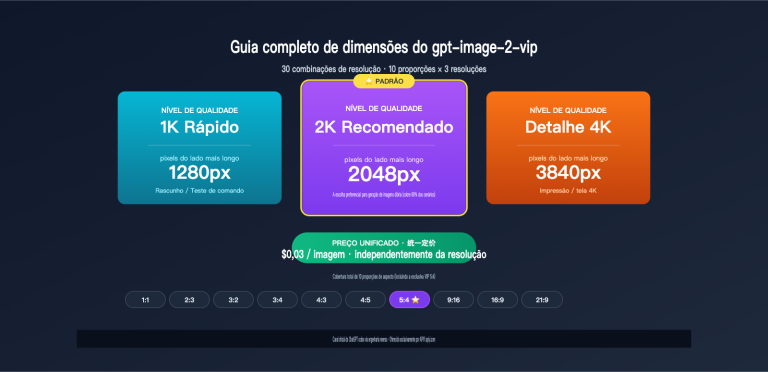
gpt-image-2.5-all. Critério de aceitação: a largura e a altura reais da imagem retornada correspondem ao esperado, e cada cobrança no console é igual ao preço unitário multiplicado pelo número de invocações. - Você precisa de um tamanho fixo entre os 30 níveis disponíveis, ou precisa de 2K/4K: use o modelo -vip e passe
sizeexplicitamente. Critério de aceitação: considere a largura e a altura reais da imagem retornada; não confie apenas nos parâmetros da requisição. - Você precisa do
qualityoficial, de repintura local commask, de fundo transparente, de qualquer tamanho válido, ou de alinhamento com os campos da OpenAI: use o canal oficial. Em projetos novos, use 2.6; quando precisar de comportamento travado, use o snapshot 2.5 com data. Critério de aceitação: os campos da requisição batem com a tabela de parâmetros oficiais do modelo alvo, sem erro 400.
Tabela comparativa de preços dos canais de imagem
A cobrança e os preços abaixo vêm da tabela geral de preços (atualizada em 2026-11-09) e são todos preços de tabela antes do desconto. Com o bônus de recarga de 10% a 20%, o valor efetivamente debitado fica menor; a referência final é o console. Para ver todos os modelos e preços, consulte docs.apiyi.com/models.
| Modelo | Natureza do canal | Cobrança | Preço de tabela (antes do desconto) | Grupos disponíveis |
|---|---|---|---|---|
gpt-image-2.6-flare / gpt-image-2.6-sunburst |
Oficial via relay (lançado em 2026-11-05) | Por consumo | Por milhão de tokens: texto de entrada US$ 5, imagem de entrada US$ 8, saída US$ 30 | Default, image2Enterprise, image2_OSS, SVIP |
gpt-image-2.5-flare / gpt-image-2.5-sunburst e snapshot de 2026-09-08 |
Oficial via relay | Por consumo | Idem; leitura de cache: texto US$ 1,25, imagem US$ 2 | Default, image2Enterprise, image2_OSS, SVIP |
gpt-image-2 |
Oficial via relay (geração anterior) | Por consumo | Idem | Default, image2Enterprise, image2_OSS, SVIP |
gpt-image-2.5-all / gpt-image-2-all |
Reverso do ChatGPT web | Por chamada | US$ 0,025/chamada | Default, image2_OSS, SVIP |
gpt-image-2.5-vip e outros 3 nomes -vip |
Reverso do Adobe Firefly | Por chamada | US$ 0,03/chamada | Default, image2_OSS, SVIP |
Há uma divergência entre a API de preços e a tabela geral de preços, então é preciso analisar separadamente. Na API de preços, gpt-image-2, gpt-image-2.5-flare e gpt-image-2.5-sunburst têm quota_type 1 e model_price 0,2. Já gpt-image-2.6-flare, gpt-image-2.6-sunburst e os dois snapshots de 2026-09-08 têm quota_type 0 e model_price 0. A tabela geral de preços, por sua vez, marca todos esses modelos oficiais via relay como cobrança por consumo. Os preços deste artigo seguem a cobrança por consumo da tabela geral; não tratamos 0,2 como preço por chamada. Antes de comprar, confira no console o preço com desconto real desse grupo. Os US$ 0,025 do -all e os US$ 0,03 do -vip são iguais nas duas fontes e podem ser usados como preço de tabela por chamada.
No canal oficial via relay, o custo por imagem depende dos tokens de saída. A página de comparação (segundo a própria documentação) indica uma faixa típica de cerca de US$ 0,03 a US$ 0,2 por imagem; quanto mais longo o comando e mais altos size e quality, maior o custo. A documentação traz um cálculo aproximado de 2026-09-09: uma imagem quadrada de 1024 com o 2.5 em xhigh custa cerca de US$ 0,094 (3122 tokens de saída); em max, cerca de US$ 0,211 (7024 tokens de saída), sem contar a entrada, que normalmente fica abaixo de US$ 0,001. A conclusão da documentação é: para rascunhos 1K em low, o oficial via relay não necessariamente sai mais caro; é na qualidade média/alta que o canal reverso, a US$ 0,025 a US$ 0,03, se torna mais vantajoso.
Há ainda um preço antigo que vale o alerta. Um artigo antigo da Central de Ajuda, de 2026-04-25, listava o gpt-image-2-all a US$ 0,03/chamada; esse era o dado antes da redução de preço. O -all caiu para US$ 0,025 em 2026-10-10, e os dois nomes -all foram ajustados em conjunto. O motivo da redução, segundo a documentação, é que o -all é mais estável que o -vip; o -vip sofre mais oscilação por causa do controle de risco do fabricante original, mas continua sendo mantido e está disponível normalmente.
Tabela comparativa de capacidades do canal de imagem
| Capacidade | Oficial reverso -all | Oficial reverso -vip | Oficial relay |
|---|---|---|---|
size |
Página dedicada: larguras/alturas comuns com lado maior de 512 a 1536, incluindo valores que não são múltiplos de 16; 2K não é listado como suporte exato | 30 opções (10 proporções × 1K/2K/4K), válidas apenas no endpoint images |
Qualquer tamanho válido, com lados múltiplos de 16 e proporção não superior a 3:1; predefinições incluem 3840×2160 |
quality |
Não aceita | Comportamento do canal, sem garantia; os dois modelos 2.5 foram retestados em 2026-09-10 até max; gpt-image-2-vip só chega a high |
Níveis oficialmente garantidos; xhigh/max apenas nos dois modelos 2.5 (página de comparação) |
n |
Não aceita; se enviado, ainda cobra n vezes | Não suportado, 1 imagem por vez | Suportado |
| Máscara | Apenas redesenho da imagem inteira | Apenas redesenho da imagem inteira | Suporta redesenho parcial com mask |
| Fundo transparente | Sem background; só dá para escrever no comando |
Consegue gerar PNG com alpha, mas a documentação não garante | 2.5 suporta; gpt-image-2 foi desativado |
| Velocidade (conforme a própria documentação) | Página dedicada: cerca de 30 a 60 segundos; página de comparação: cerca de 90 segundos | gpt-image-2-vip 90 a 150 segundos; flare-vip 22 a 138 segundos; sunburst-vip 37 a 120 segundos |
Em 2026-09-09, 2.5-flare 1K low cerca de 10 segundos, sunburst cerca de 14 segundos; gpt-image-2 100 a 120 segundos |
Sobre a velocidade do -all, as duas documentações divergem: a página dedicada diz cerca de 30 a 60 segundos, enquanto a página de comparação diz cerca de 90 segundos. Este artigo lista os dois números, sem tirar média. O size do -all também tem documentação dessincronizada: a página dedicada diz “agora suporta size”, mas a página de comparação ainda informa que não aceita. Aqui consideramos a página dedicada como referência. A página dedicada também menciona que a imagem quadrada de 1536 pode passar por interpolação e não representa detalhes nativos. O “aumento de 50% na velocidade de geração, com Flare em baixa qualidade chegando a 6 segundos no melhor caso” do 2.6 vem de um anúncio oficial reproduzido no feed em tempo real de 2026-11-05, não de dados de reteste da plataforma. Os novos parâmetros do 2.6 (complexity, SVG, GIF etc.) seguem a documentação oficial da OpenAI e não podem ser aplicados diretamente à tabela de parâmetros do 2.5.
Se a demanda por 4K for grande, a página dedicada do -all também menciona outra rota: o Nano Banana na APIYI. Na tabela geral de preços, nano-banana-pro e a série gemini-3-pro-image custam US$ 0,09 por chamada, enquanto nano-banana-2 e gemini-3.1-flash-image custam US$ 0,055 por chamada. Os grupos empresariais dessa rota são NanoBananaEnterprise e NanoBananaReverse, e não podem ser misturados com image2Enterprise.
Como configurar tipos de token e prioridade de grupos nos canais de imagem
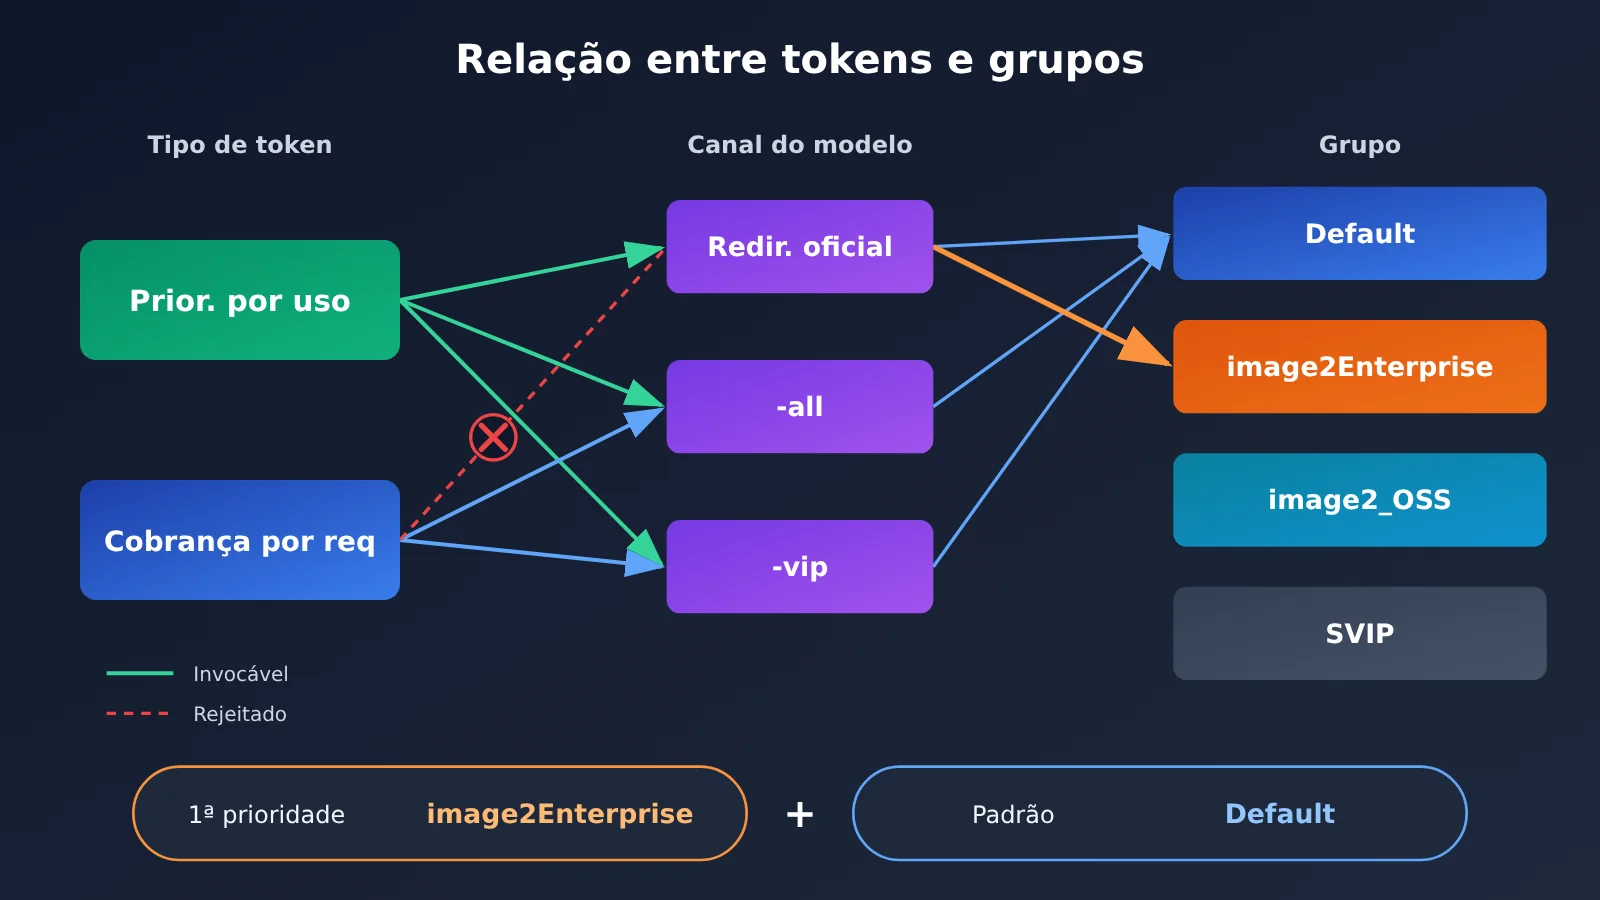
Muitos erros não acontecem por causa do canal em si, mas porque o tipo de token ou o grupo foi configurado errado. Todos os canais usam a mesma URL base: https://api.apiyi.com/v1. Os endpoints recomendados são /v1/images/generations e /v1/images/edits. Só existe uma regra de tipo de token que você precisa memorizar: o canal oficial (官转) deve usar “按量优先”. Usar um token “按次计费” para chamar o canal oficial será rejeitado porque o modo de cobrança não bate. -all e -vip podem usar “按次计费” ou “按量优先”.
| Grupo | Multiplicador (API de preços, 2026-11-10) | Canais aplicáveis | Uso | Observações |
|---|---|---|---|---|
Default |
1 | Oficial, -all, -vip |
Primeira opção padrão | Em horários de pico, o canal oficial pode ter concorrência apertada e retornar 429 |
image2Enterprise |
1.2 | Apenas oficial | Fallback empresarial do upstream OpenAI | Não é uma linha de aceleração, não é Vertex; -all e -vip não estão neste grupo |
image2_OSS |
1 | Oficial, -all, -vip |
Garante saída via URL | Não melhora a estabilidade; a URL expira em cerca de 24 horas |
SVIP |
A API retorna 1; vale a página de tokens do console | Oficial, -all, -vip |
Conforme as instruções do console | A promoção de multiplicador por tempo limitado terminou em 2026-10-29 |
O multiplicador de 1.2 do grupo empresarial, segundo a documentação, foi definido com base em “após o bônus de 20% para grandes clientes com recarga única de US$ 3000, o valor fica aproximadamente igual ao preço original do site oficial”; a plataforma não considera custos tributários. Sobre quais modelos ficam visíveis neste grupo, a tabela do corpo do FAQ lista gpt-image-2.5-flare, gpt-image-2.5-sunburst e gpt-image-2. A tabela geral de preços e o enable_groups da API de preços mostram que os dois modelos 2.6 também estão nela, mas a tabela do FAQ ainda não foi atualizada. A documentação não informa que esse grupo exige solicitação separada; se não conseguir selecioná-lo, considere o que o console mostra.
A configuração recomendada é “um único token cobre os dois tipos de modelo”. Um token pode ter 1 grupo padrão e até 2 grupos de fallback. Conforme a configuração da documentação, defina a primeira prioridade como image2Enterprise e o grupo padrão como Default. Assim, as requisições do canal oficial vão preferencialmente para o grupo empresarial; -all e -vip, por não estarem no grupo empresarial, permanecem no Default e geram imagens normalmente. Na prática: abra api.apiyi.com/token, edite o token, selecione o grupo e salve; não é preciso alterar o código. Critério de aceite: com a mesma requisição, chame uma vez um modelo do canal oficial e uma vez um modelo -all; as duas chamadas devem gerar imagem, e o console deve mostrar a chamada do canal oficial cobrada com multiplicador 1.2.
Negócios que dependem fortemente de URL precisam de tratamento separado. No grupo padrão, a documentação registra que, em 2026-07, não passar response_format retorna b64_json; passar response_format explicitamente como url fornece o link, mas o grupo padrão não garante o formato de saída. Para esse tipo de negócio, troque o token para image2_OSS, passe url explicitamente e, assim que receber o link, baixe e salve imediatamente. Critério de aceite: a resposta traz o campo url e o arquivo salvo pode ser aberto.
Como fazer fallback para 429, saturação e falhas do provedor original ao gerar imagens
O mesmo erro pode ter causas completamente diferentes. Por isso, o primeiro passo é ler o error.message no corpo do erro e só então decidir como tratar. A página dedicada ao -vip divide o 429 em dois casos: parâmetro rejeitado e saturação do grupo. Já a página do -all explica o 429 de forma genérica como “limite de taxa ou cota insuficiente”. O status em tempo real também registrou dois tipos de falha do provedor original, vindos da versão web do ChatGPT e do upstream da OpenAI. A tabela abaixo organiza essas situações em “o que você vê no erro e o que fazer primeiro”:
| O que você vê | Diagnóstico | O que fazer primeiro | Critério de aceite |
|---|---|---|---|
| O canal 官转 no Default continua retornando 429 ou indica saturação | Congestionamento do grupo padrão | Acesse api.apiyi.com/token, mude o grupo para image2Enterprise ou aumente a prioridade dele; o nome do modelo não muda |
A mesma requisição consegue gerar a imagem e a cobrança passa a ser 1,2x |
-vip retorna 429 e a message é algo como quality must be one of… |
Parâmetro rejeitado | Altere o parâmetro; não repita a requisição como está | Depois da alteração, a primeira requisição já funciona |
-vip retorna 429 e a message é 当前分组上游负载已饱和 |
Saturação ocasional | Tente novamente com backoff exponencial e confira o status em tempo real | Recupera dentro de um número limitado de tentativas; caso contrário, mude para o canal 官转 |
-all/-vip concentram erros no mesmo dia e o status em tempo real anuncia uma falha do provedor original |
Falha do provedor original no ChatGPT web ou na Adobe | Pare o backoff e troque o nome do modelo para o canal 官转 | A requisição no canal 官转 funciona; o token é do tipo prioridade por uso |
O grupo empresarial do canal 官转 retorna The server had an error while processing your request. |
Falha no upstream da OpenAI | Tente mais 1 ou 2 vezes; se não funcionar, mude para o canal 官逆 | Depois de mudar para -all, consegue gerar a imagem |
| 401 | Problema no token | Verifique o token; não repita | Volta a funcionar depois de trocar para o token correto |
gpt-image-2 com background definido como transparent retorna 400 |
O recurso foi descontinuado oficialmente | Para fundo transparente, use o 官转 2.5 com png ou webp | A imagem retornada tem canal alfa |
Se você suspeitar de falha do provedor original, primeiro confira em docs.apiyi.com/live se há um aviso correspondente naquele dia e só então decida entre fazer backoff ou trocar de canal. A troca do canal 官逆 para o canal 官转 é simples: no APIYI, basta usar o mesmo token e mudar apenas o nome do modelo. A página de comparação diz, textualmente: “basta trocar o nome do model para mudar para o canal 官转”. Mas há pré-requisitos que precisam ser conferidos item por item:
- Tipo de token: confirme se o token é do tipo “prioridade por uso”. Se for um token por chamada, a requisição será rejeitada.
- Reduza os campos de acordo com o modelo de destino: ao mudar para
gpt-image-2, remova os níveis xhigh e max e o fundo transparente; tamanhos não múltiplos de 16 vindos do-allprecisam ser alterados para múltiplos de 16, com proporção não superior a 3:1. No sentido inverso, ao voltar do canal 官转 para o-all, removaquality,n,aspect_ratioemask. - Timeout: no canal 官转, defina 240 segundos para qualidade baixa e média, 300 segundos para high e xhigh, e 600 segundos como fallback para max e para o high do
gpt-image-2. Para-alle-vip, defina 300 segundos por precaução. Comprima as imagens de entrada para até 1,5 MB antes de enviar.
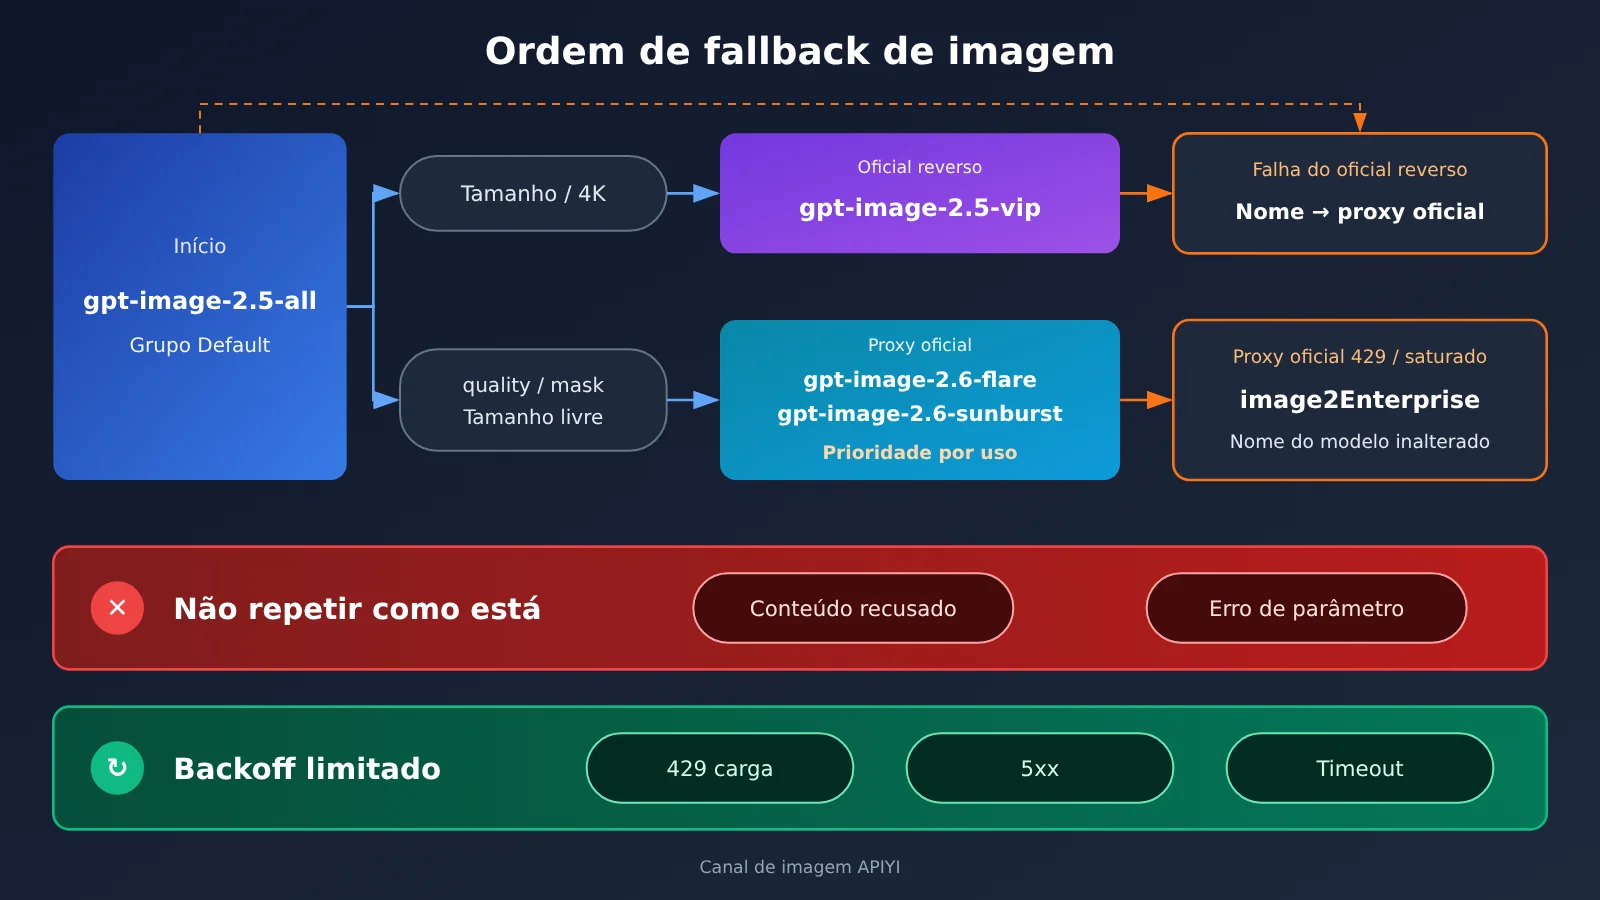
Tabela de referência dos avisos históricos de abril a novembro de 2026
Os eventos abaixo servem apenas para mostrar “que tipo de falha já apareceu e como foi tratada na época” — eles não representam a situação atual em 2026-11-10. Se há saturação agora, isso deve ser avaliado pelo corpo do erro e pelas atualizações em tempo real do momento.
| Data | Evento (aviso histórico) | Tratamento na época | Como usar hoje |
|---|---|---|---|
| 2026-04-29 | O grupo padrão do oficial proxy ainda retornava 429, só o image2Enterprise era estável; -all e -vip também estavam estáveis | Usar o grupo empresarial do oficial proxy | Serve como caso típico de “congestionamento no grupo padrão do oficial proxy” |
| 2026-05-07 | O grupo empresarial do oficial proxy também retornava server error, e a causa raiz era o upstream da OpenAI | Esperar o upstream se recuperar ou trocar de canal | O grupo empresarial também não garante que o upstream fique disponível para sempre |
| 2026-05-13 | Grupo padrão saturado, e o image2Enterprise continuava gerando imagens | Trocar para o grupo empresarial | Sustenta a configuração por prioridade |
| 2026-05-23 | O grupo padrão recebeu recursos extras, e a documentação dizia que não era preciso trocar especificamente para o grupo empresarial | Voltar para o Default | O congestionamento é pontual |
| 2026-09-21 | Concorrência apertada no grupo padrão do 2.5 oficial proxy; grupo empresarial estável | Trocar para o grupo empresarial | O mesmo caso acima |
| 2026-10-15 | gpt-image-2-vip com carga excessiva; -all dava erro por falha no original da versão web do ChatGPT; gpt-image-2 com fundo transparente desativado (a página de comparação registra 2026-09-30) |
No oficial reverso, usar primeiro o oficial proxy como fallback; para fundo transparente, mudar para o 2.5 oficial proxy | Em falha do original, troque de canal em vez de insistir |
| 2026-11-05 | O 2.6 oficial proxy entrou no ar e o grupo Default ficou disponível | Novos projetos podem usar | Este é um aviso de lançamento, não um aviso de falha |
Quais erros de geração de imagens vale a pena repetir e quais não valem
Só existe um critério para decidir se vale repetir: a causa do erro vai desaparecer sozinha com o tempo? Erros de carga como 429, 5xx e timeouts podem se resolver sozinhos, então dá para fazer um número limitado de retentativas com backoff; já erro de parâmetro, erro de token e recusa de conteúdo não somem com o tempo — repetir do mesmo jeito só perde tempo e, às vezes, cobra a mais. A diretriz operacional registrada no arquivo de pauta de 2026-08-25 é “429 pode repetir, segurança de conteúdo não precisa repetir”, o que bate com esse critério.
- Pode repetir com backoff: para 429 de carga, use backoff exponencial; para 5xx, repita de 1 a 2 vezes; para timeout, primeiro ajuste o timeout do cliente para o valor recomendado. Anote o
request-iddo cabeçalho de resposta, isso facilita a investigação. A documentação do -vip diz que abaixo de 500 RPM não é preciso se preocupar com concorrência. - Altere antes de reenviar: se o parâmetro foi rejeitado, ajuste o parâmetro primeiro; se der 401, verifique o token primeiro; se der 400, confira a tabela de campos do modelo de destino. Falha de autenticação e falha de validação de parâmetro não são cobradas.
- Não repita automaticamente: a recusa de conteúdo tem dois tipos. Um retorna um erro explícito, por exemplo “não foi possível gerar a imagem como esperado, ajuste o comando e tente novamente” — nesse caso não há cobrança e você deve alterar o comando. O outro retorna 200, mas o corpo da resposta é uma recusa branda do tipo “não consigo atender a esse pedido”. Pelo protocolo, isso conta como retorno normal e é cobrado, e nem a API oficial reversa consegue identificar isso antecipadamente na camada de protocolo. Para o mesmo comando, não reenvie automaticamente.
Pergunta: passei n=4 com -all, por que recebi apenas 1 imagem e fui cobrado 4 vezes?
O -all não aceita n, mas se você passar mesmo assim, a cobrança será multiplicada por n. O exemplo na página dedicada é n=3, que cobra US$ 0,075 e ainda retorna apenas 1 imagem. Quando precisar de N imagens, você deve fazer N chamadas em paralelo. Critério de aceitação: o número de cobranças no console deve ser igual ao número de imagens realmente recebidas.
Pergunta: a página de comparação diz que -all não aceita size, afinal, dá para passar ou não?
Vale o que está na página dedicada do -all: pode passar. O size informado explicitamente tem prioridade sobre a descrição de dimensões no comando; se não for passado ou se for passado auto, o comportamento nativo é mantido. A página de comparação é que ainda não foi atualizada de forma sincronizada.
Pergunta: O agrupamento empresarial consegue acelerar a geração de imagens?
Não. O FAQ deixa claro que não é uma linha de aceleração; serve apenas para oferecer outro pool de recursos quando o agrupamento padrão está congestionado. Basta colocar o modelo 官逆 no grupo Default.
Pergunta: No endpoint de preços, o 0.2 do 官转 é preço por chamada?
Não convém entender assim. A tabela geral de preços indica cobrança por volume (pay-per-use), e este artigo também segue essa base. Para alguns aliases sem data, o endpoint retorna model_price 0.2, ou seja, há inconsistência entre os dois critérios. Antes de fazer o pedido, confira no console o preço real com desconto.
Pergunta: as versões 2.6 têm -all ou -vip?
Na tabela consolidada de preços e na API de preços de 2026-11-10 não há, e este artigo também não faz nenhuma especulação sobre data de lançamento.
Configuração padrão recomendada
- Nome do modelo:
gpt-image-2.5-all; quando precisar de tamanho específico ou 4K, mude paragpt-image-2.5-vip; quando precisar dos parâmetros oficiais, mude paragpt-image-2.6-flareougpt-image-2.6-sunburst - Grupo: primeira prioridade
image2Enterprise, grupo padrãoDefault; para serviços que dependem fortemente de URL, crie outro token e useimage2_OSS - Tipo de token: priorizar cobrança por uso (tanto o canal oficial de encaminhamento quanto o canal oficial reverso conseguem chamar)
- Timeout em segundos: para -all/-vip, defina 300; para o canal oficial de encaminhamento com qualidade baixa/média, 240; high/xhigh, 300; max, 600
- Base URL:
https://api.apiyi.com/v1
Depois de rodar com essa configuração, no dia a dia basta ficar de olho em duas coisas: no que está escrito em error.message no corpo do erro e se há algum anúncio relacionado nas atualizações em tempo real do dia. Consultando as duas tabelas acima, dá para decidir se é hora de fazer retry com backoff, alterar a requisição ou trocar de canal.
Autor: Equipe técnica da APIYI
Contato técnico: se encontrar um erro não coberto no artigo, fale conosco pela página inicial do site oficial da APIYI e inclua orequest-ide o corpo completo do erro.