Nota del autor: ¿La invocación de gpt-6.1-sol se completa sin errores pero devuelve un cuerpo vacío? La documentación indica que los 300 completion_tokens son todos reasoning_tokens, y que no se escribió ni una sola palabra del cuerpo. Este artículo explica el motivo y dos soluciones.
Si acabas de invocar gpt-6.1-sol y la API no devolvió errores, pero el message.content que recibiste es una cadena vacía, no te apresures a culpar a la red ni a sospechar que el modelo está roto. Revisa el usage de la respuesta: completion_tokens es 300, reasoning_tokens también es 300 y text_tokens es 0. Es decir, esos 300 tokens se consumieron por completo en el razonamiento y no se escribió ni una palabra del cuerpo.
Esto no es un problema esotérico ocasional ni el modelo está holgazaneando. La documentación indica que el proceso de razonamiento de gpt-6.1-sol y el cuerpo final comparten el mismo presupuesto de max_tokens; cuando el razonamiento aún no ha terminado y el presupuesto se agota primero, el cuerpo se trunca por completo. Muchos desarrolladores que invocan gpt-6.1-sol en APIYI (apiyi.com), al encontrarse por primera vez con este fenómeno, pensaron que la plataforma había fallado.
No es otro artículo genérico de divulgación sobre modelos de razonamiento, sino una guía de diagnóstico centrada en el síntoma concreto de «el cuerpo está vacío». Después de leer este artículo, podrás entender qué dicen esos números del usage y, con dos ajustes en los parámetros, hacer que el cuerpo se genere con normalidad.
Puntos clave del cuerpo vacío en gpt-6.1-sol
Primero la conclusión; los detalles los desglosamos después. Varias piezas clave de información registradas en la documentación determinan cómo debes investigar a continuación:
| Punto clave | Explicación según la documentación | Valor para ti |
|---|---|---|
| El pensamiento y el cuerpo comparten el presupuesto | Tanto el proceso de razonamiento como la respuesta final de gpt-6.1-sol se descuentan de max_tokens |
Entender la raíz del cuerpo vacío |
| Los 300 tokens se gastan todos en el pensamiento | completion_tokens 300 equivale a reasoning_tokens 300, y text_tokens es 0 |
Identificar el tipo de problema de un vistazo |
| Dos manifestaciones externas | Devuelve el código de error empty_response, o HTTP 200 pero con el cuerpo como cadena vacía |
No dejarse engañar por el «falso éxito» |
| El reintento es básicamente inútil | Con la misma indicación y el mismo max_tokens, al enviar de nuevo el resultado es similar |
Ahorrar esfuerzo inútil |
¿En qué se gastaron estos 300 tokens?
Para entender el cuerpo vacío, primero hay que entender cómo responde gpt-6.1-sol. Pertenece a los modelos de razonamiento: antes de empezar a escribir formalmente, hace un «borrador» interno — descompone el problema, prueba rutas, se autocorrige. Ese borrador es la parte que se contabiliza en reasoning_tokens.
La clave es que, según la documentación, el borrador y el cuerpo no son dos presupuestos independientes, sino que comparten el mismo max_tokens. Cuando max_tokens se configura en un rango de aproximadamente 200 a 500 y la tarea realmente requiere razonamiento, el presupuesto se agota fácilmente en la fase de pensamiento: el pensamiento aún no ha terminado, el cuerpo ni siquiera ha empezado, y el presupuesto ya tocó fondo. Lo que se te devuelve, naturalmente, es un cuerpo en blanco.
Ese conjunto de cifras en la documentación lo dice de forma muy clara:
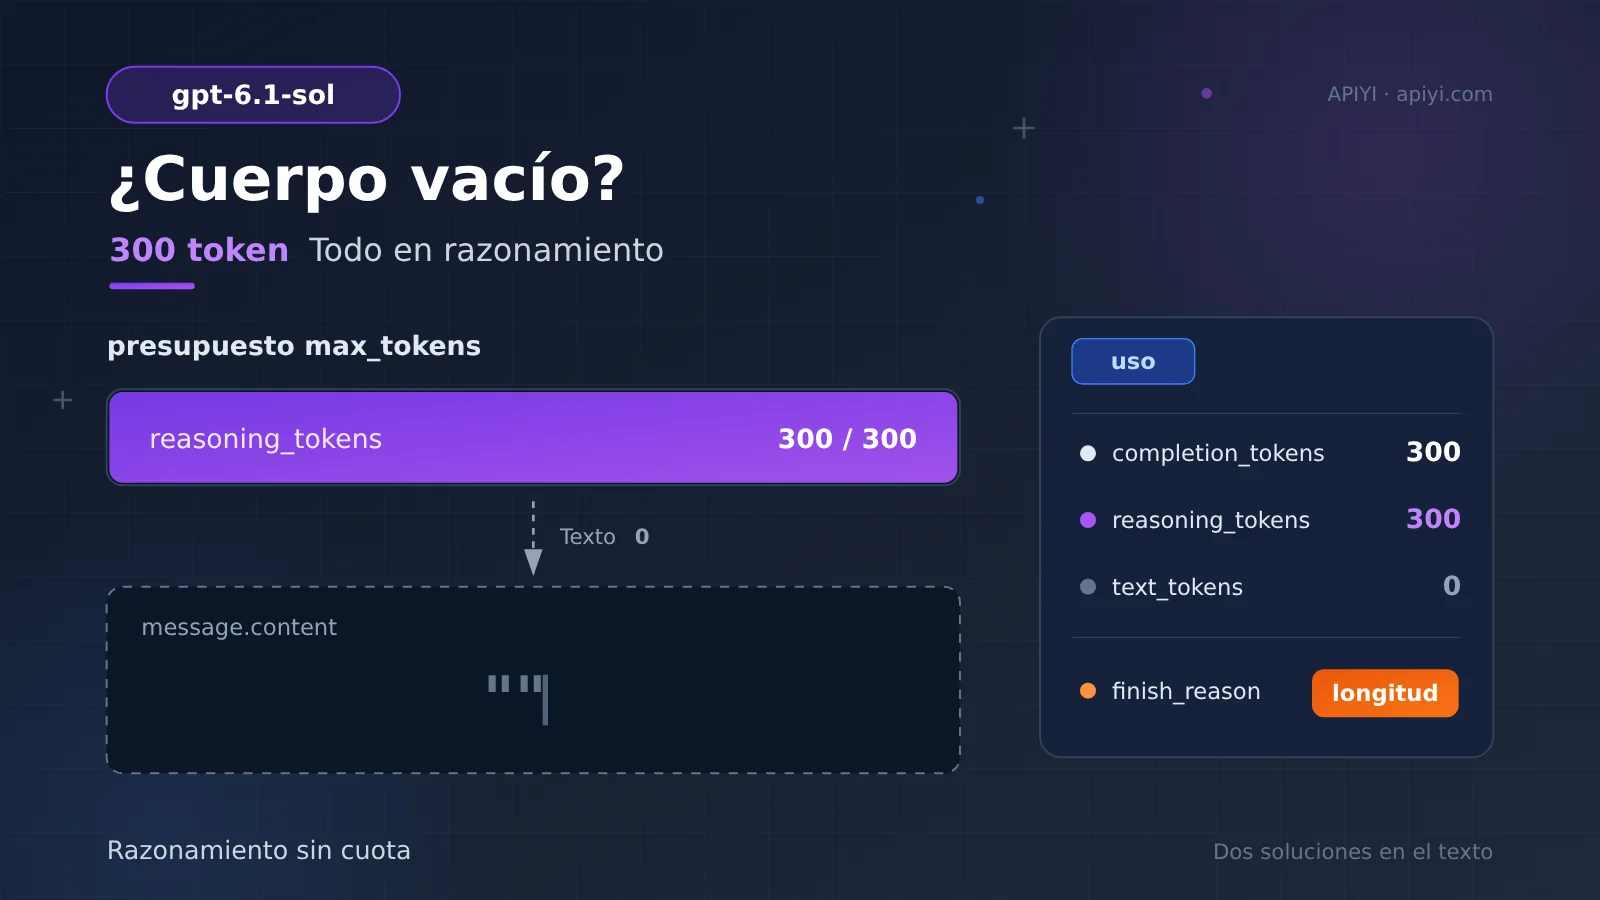
completion_tokens: 300 — la cantidad total generada esta vezreasoning_tokens: 300 — la parte gastada en el pensamientotext_tokens: 0 — la parte realmente escrita como cuerpofinish_reason:length— la razón de parada es haber alcanzado el límite de longitud, no un cierre normal
completion_tokens es exactamente igual a reasoning_tokens y text_tokens se reduce a cero; esta es casi la firma estándar de «el presupuesto se lo comió todo el pensamiento». Junto con finish_reason igual a length, se puede confirmar que el modelo no es que «no quiera responder», sino que «no tiene presupuesto para responder». El límite alcanzado esta vez también cae justo dentro del rango de 200 a 500 que la documentación describe como fácil de agotar.
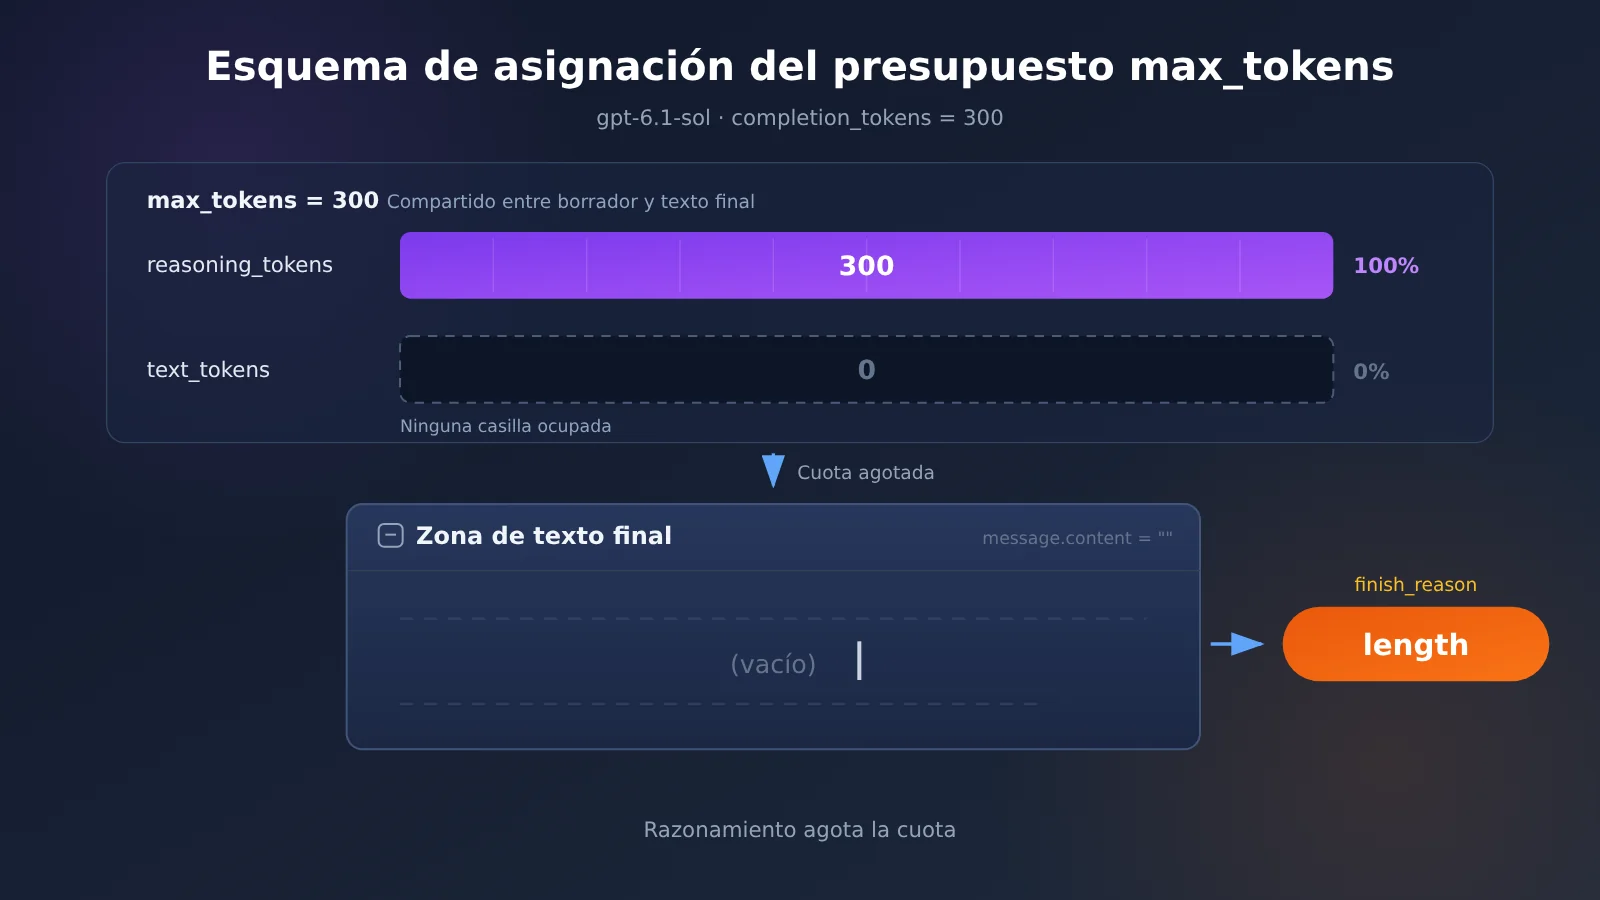
El diagrama anterior describe precisamente cómo se asignó el presupuesto en esta invocación. El texto original completo del significado de los campos está incluido en el centro de documentación de APIYI; se recomienda compararlo con el original para confirmar los detalles una vez más y evitar cambiar parámetros de memoria.
Las dos manifestaciones externas del cuerpo vacío
La misma causa tiene dos manifestaciones a nivel de la interfaz, y la documentación registra ambas. Una es un error directo: devuelve el código de error empty_response y la solicitud se marca claramente como anómala. La otra es un «falso éxito»: HTTP 200, todo parece normal, pero message.content es una cadena vacía.
La segunda es más engañosa. El código de estado es exitoso y el tiempo de respuesta también es normal; si no revisas el usage, no descubrirás en absoluto que el cuerpo está vacío. Por eso, cuando te encuentres con «la interfaz tuvo éxito pero el contenido está vacío», tu primera reacción debería ser revisar el usage, no revisar la red.
| Manifestación externa | Contenido devuelto | Criterio de juicio |
|---|---|---|
| Error directo | Código de error empty_response |
Visible de un vistazo |
| Falso éxito | HTTP 200, message.content es una cadena vacía |
Hay que revisar el usage y finish_reason |
Cómo confirmar la causa de un cuerpo vacío en gpt-6.1-sol
El diagnóstico no es complicado: con cuatro pasos basta, y se recomienda empezar por el campo usage:
- Comprueba si
completion_tokensyreasoning_tokensson iguales. Si coinciden, significa que toda la capacidad de generación se destinó al razonamiento y el cuerpo de la respuesta no recibió ningún presupuesto. - Comprueba si
text_tokenses 0. Que esté a cero indica que no se escribió ni una sola palabra del cuerpo; es la evidencia más directa. - Comprueba si
finish_reasoneslength. Que sealengthy no un cierre normal indica que el modelo se detuvo por el límite máximo. - Revisa tu configuración de
max_tokens. Si está entre 200 y 500 y la tarea además requiere razonamiento, casi seguro que este es tu caso.
Una vez confirmado, hay algo que puedes descartar de inmediato: reintentar tal cual. La documentación indica que, con la misma indicación y el mismo max_tokens, reintentar casi no sirve de nada. Porque no se trata de un fallo de red, sino del resultado inevitable del reparto del presupuesto: si lo envías otra vez, el presupuesto seguirá siendo el mismo y el razonamiento volverá a consumirlo primero.
Si invocas gpt-6.1-sol a través de una plataforma agregadora, el punto de entrada para el diagnóstico normalmente es así:
- Dirección de la plataforma: APIYI apiyi.com
- Dirección de la API:
https://api.apiyi.com/v1 - Nombre del modelo:
gpt-6.1-sol - Especificación de la API: compatible con OpenAI, la semántica de los parámetros es idéntica a la API oficial
Sugerencia: obtén cuota de prueba gratuita a través de APIYI apiyi.com y compara, con la misma indicación, las respuestas con distintos
max_tokens; en pocos minutos podrás confirmar que el problema está en el reparto del presupuesto y no en el modelo en sí.
Solución rápida para la respuesta vacía de gpt-6.1-sol: aumentar max_tokens o reducir reasoning_effort
La causa ya está clara, así que la solución cae por su propio peso. Solo hay dos caminos: dejar espacio para el cuerpo de la respuesta o hacer que el razonamiento consuma menos. Cada solución encaja en tareas distintas, no las mezcles.
Solución uno: aumentar max_tokens. Los valores de referencia que da la documentación son: conversaciones normales desde 2000; tareas de razonamiento complejo o textos largos, 16000 o más. Esa magnitud no está elegida al azar: el borrador de razonamiento en sí puede ser largo y el cuerpo de la respuesta necesita espacio adicional; 2000 es solo el punto de partida para una conversación normal.
Solución dos: reducir reasoning_effort. Si la tarea no requiere razonamiento profundo, por ejemplo una reescritura sencilla, una conversión de formato o una pregunta con respuesta de una frase, puedes hacer que el modelo «piense menos». Al bajar el consumo de la fase de razonamiento, la misma cuota de tokens también alcanza.
| Solución | Cómo hacerlo | Cuándo usarla | Efecto esperado |
|---|---|---|---|
Aumentar max_tokens |
Conversaciones normales: desde 2000; razonamiento complejo o textos largos: 16000 o más | Tareas que necesitan calidad de razonamiento completa | Resuelve la causa |
Reducir reasoning_effort |
Bajar la intensidad de razonamiento | Tareas ligeras, que no exigen mucha profundidad de razonamiento | Reduce el consumo de razonamiento |
| Reintentar con los mismos parámetros | Enviar otra vez sin cambiar nada | Básicamente inútil | No recomendado |
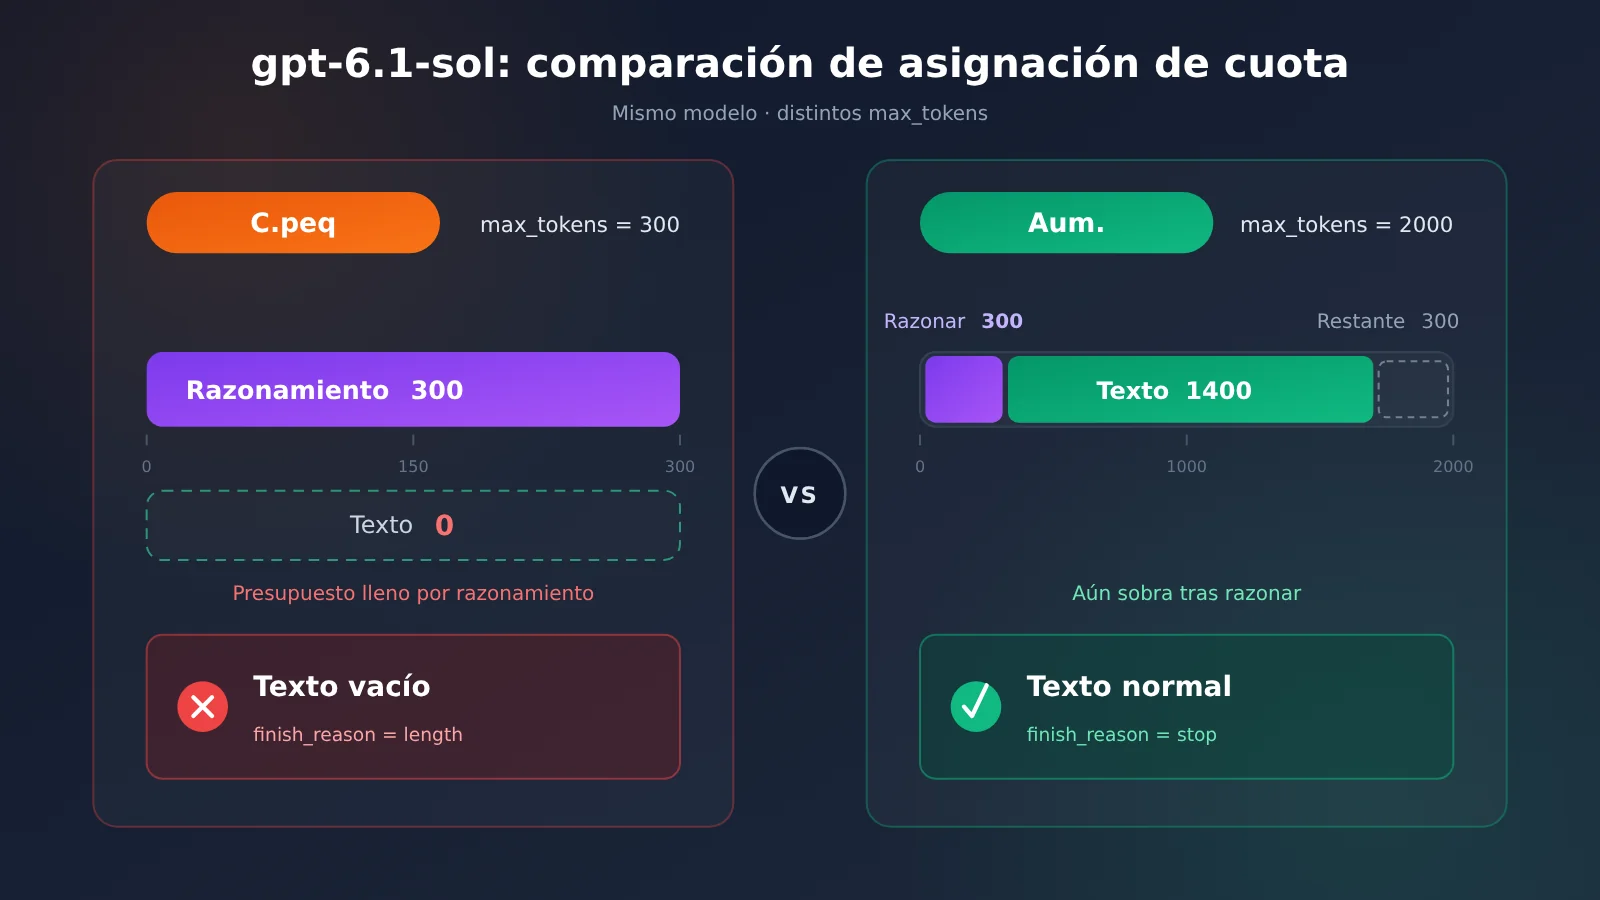
Comparación de las soluciones
Aumentar max_tokens es la opción prioritaria. No cambia la forma en que el modelo razona; solo amplía el «papel de borrador», así que la calidad del razonamiento no se ve afectada. Después de subir el límite, el razonamiento sigue su curso y el cuerpo de la respuesta también recibe su propia cuota; text_tokens deja de ser 0 de forma natural.
Reducir reasoning_effort encaja en otro tipo de escenario: la tarea en sí no necesita pensamiento profundo, pero el modelo por defecto ejecuta un razonamiento completo. Al bajarlo, el consumo de pensamiento disminuye y la respuesta llega más rápido; sin embargo, no se recomienda para tareas complejas, porque comprimir la profundidad de razonamiento puede afectar la calidad de la respuesta.
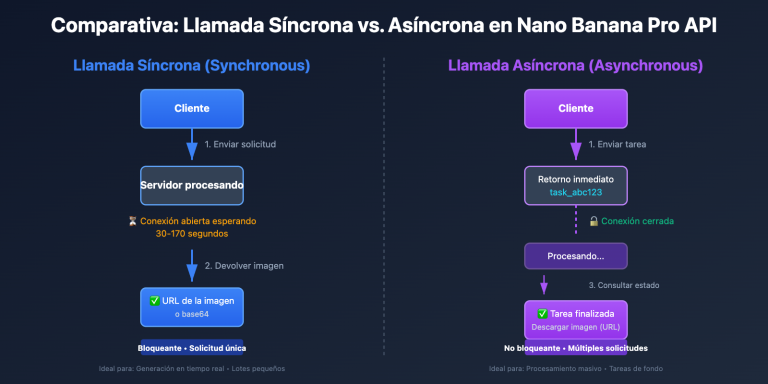
Reintentar con los mismos parámetros lo menciono por separado porque es la reacción equivocada más común. La documentación indica que, con la misma indicación y el mismo max_tokens, reintentar básicamente no sirve: no es un problema de suerte, es un problema de aritmética. La diferencia entre los dos escenarios de la figura anterior también se puede reproducir en la plataforma APIYI apiyi.com con la misma indicación; en dos minutos verás el resultado de la comparación.
¿Aumentar max_tokens cuesta más?
Mucha gente no se atreve a aumentar max_tokens por miedo de que la factura se dispare. Aquí la documentación deja una aclaración clave: max_tokens es un límite superior, no el consumo real; la facturación se calcula según los tokens realmente generados.
En otras palabras, subir max_tokens de 300 a 2000 no significa que cada llamada se cobre como 2000. Se cobra por lo que consumió el razonamiento y por lo que se escribió en el cuerpo de la respuesta; la parte del límite que no se usa no genera cargo. Aumentar el límite consiste, en esencia, en dar espacio vital al cuerpo de la respuesta, no en pagar por adelantado un gasto mayor. APIYI apiyi.com usa un modelo de facturación por uso; el precio unitario concreto está en la página de precios de la plataforma, y este artículo no cita cifras específicas.
FAQ de problemas frecuentes con el cuerpo vacío de gpt-6.1-sol
Q1: ¿Qué es el cuerpo vacío de gpt-6.1-sol?
Al invocar `gpt-6.1-sol`, el proceso de razonamiento y el cuerpo comparten `max_tokens`. El razonamiento se gasta primero el presupuesto y el cuerpo queda truncado por completo, así que el resultado sale vacío. En el conjunto de cifras que registra la documentación, los 300 de `completion_tokens` son todos `reasoning_tokens` y `text_tokens` es 0.
Q2: ¿HTTP 200 también cuenta como anomalía?
Sí. Según la documentación, el cuerpo vacío se presenta de dos formas: devuelve el código de error `empty_response`, o devuelve HTTP 200 pero `message.content` es una cadena vacía. Que el código de estado sea exitoso no significa que el contenido esté bien; hay que evaluarlo junto con `text_tokens` y `finish_reason` del usage.
Q3: ¿Por qué reintentar no sirve de nada?
Según la documentación, con la misma indicación y el mismo `max_tokens`, reintentar básicamente no cambia nada. Porque el reparto del presupuesto es determinista: si el presupuesto no cambia, el razonamiento se lo vuelve a gastar primero. Para cambiar el resultado hay que tocar los parámetros, no confiar en la suerte.
Q4: ¿Entonces el modelo no respondió?
No es que se niegue a responder, es que no tiene presupuesto para responder. Que `finish_reason` sea `length` indica que el modelo fue detenido por el límite máximo, no que se detuvo por voluntad propia. Si aumentas `max_tokens`, la misma pregunta ya devuelve cuerpo.
Q5: ¿Qué configuración es la más propensa a fallar?
Según la documentación, cuando `max_tokens` se fija en torno a 200–500 y la tarea además requiere razonamiento, el presupuesto se agota en la fase de razonamiento. Ese rango puede bastar para un modelo de conversación normal, pero para modelos de razonamiento como `gpt-6.1-sol`, muchas veces no alcanza ni para terminar el borrador.
Q6: ¿Cómo verificar rápido que la corrección funciona?
Recomendamos hacer una verificación comparativa en APIYI apiyi.com: registra una cuenta para obtener crédito de prueba gratuito, pon como dirección del endpoint `https://api.apiyi.com/v1`, selecciona el modelo `gpt-6.1-sol` y luego:
1. Con la misma indicación, sube `max_tokens` a 2000 y envíala otra vez
2. Comprueba si `text_tokens` es mayor que 0
3. Comprueba si `message.content` tiene cuerpo
Comparando en la misma plataforma y con la misma indicación, la única variable es un parámetro: la conclusión es la más limpia.
Q7: ¿Aumentar max_tokens encarece el costo?
No se cobra según el límite máximo. Según la documentación, `max_tokens` es un techo, no el consumo real; el cobro se calcula sobre los tokens realmente generados. Se cobra lo que de verdad se genere entre razonamiento y cuerpo; el precio unitario concreto lo marca la página de precios de APIYI.
Q8: ¿Los modelos que no razonan también hacen esto?
Según la documentación, los modelos que no razonan no presentan este cuerpo vacío. Como no tienen fase de razonamiento, todo el `max_tokens` queda para el cuerpo; con un presupuesto pequeño el resultado es solo una respuesta más corta, no un cuerpo totalmente vacío. Esto es también uno de los criterios para decidir si conviene cambiar de modelo.
Puntos clave sobre el contenido vacío en gpt-6.1-sol
- Origen del contenido vacío: el razonamiento y el contenido comparten
max_tokens, y el razonamiento agota primero el presupuesto. - Firma de diagnóstico:
completion_tokenses igual areasoning_tokensytext_tokensvale 0. - Dos formas de manifestarse: código de error
empty_response, o HTTP 200 con cadena vacía. - Solución recomendada: desde 2000 para conversaciones normales; más de 16000 para razonamiento complejo o textos largos.
- Alternativa ligera: reducir
reasoning_effortpara comprimir el consumo de razonamiento. - No pierdas el tiempo: reintentar con los mismos parámetros casi nunca funciona.
- Lógica de facturación:
max_tokenses un límite superior; se factura según lo realmente generado.
Resumen
Los puntos clave sobre el contenido vacío en gpt-6.1-sol, vistos en retrospectiva, son bastante claros:
- Causa: el razonamiento y el contenido comparten
max_tokens; ese bloque de cifras de 300 era todoreasoning_tokens,text_tokensera 0 yfinish_reasoneralength. - Corrección: aumentar
max_tokens(desde 2000 para conversaciones normales, más de 16000 para razonamiento complejo), o reducirreasoning_effort; reintentar con los parámetros originales casi no funciona. - Facturación:
max_tokenses un límite, no un consumo; se factura según los tokens realmente generados, así que no tengas reparo en aumentarlo.
La próxima vez que te encuentres con «la API responde correctamente pero el contenido está vacío», revisa primero usage y luego finish_reason; en unos diez segundos podrás identificarlo. Te recomiendo verificar rápidamente el efecto de la corrección con APIYI apiyi.com: la plataforma ofrece cuota de prueba gratuita e interfaz unificada para múltiples modelos, así que basta cambiar un parámetro para comparar al instante.
Referencias
- Centro de documentación de APIYI: explicación sobre respuestas con cuerpo vacío en modelos de razonamiento
- Enlace:
docs.apiyi.com/faq/reasoning-model-empty-response.md -
Descripción: registro original de las causas del cuerpo vacío, sus dos manifestaciones y las soluciones
-
Boletín de documentación de APIYI: caso de cuerpo vacío de gpt-6.1-sol (2026-11)
- Enlace:
docs.apiyi.com/live/2026-11/reasoning-model-empty-response.md - Descripción: incluye la fuente de los datos del grupo con
completion_tokens300 y del valor recomendado demax_tokens
Autor: Equipo técnico de APIYI
Contacto técnico: Puedes contactarnos desde la página de inicio de APIYI; para más recursos, consulta el centro de documentación en docs.apiyi.com