Nota del autor: cuando invocas un Modelo de Lenguaje Grande a través de una API de terceros, la calidad de la respuesta no basta para confirmar qué modelo está funcionando realmente. Este artículo disecciona FlashProve, el proyecto de código abierto de Anthropic: cómo usa zkSNARK para atar el resultado de la inferencia a unos pesos concretos, cuánto cuesta, qué puede demostrar y qué no, y cuánto falta para que esto llegue a las llamadas de API de todos los días.
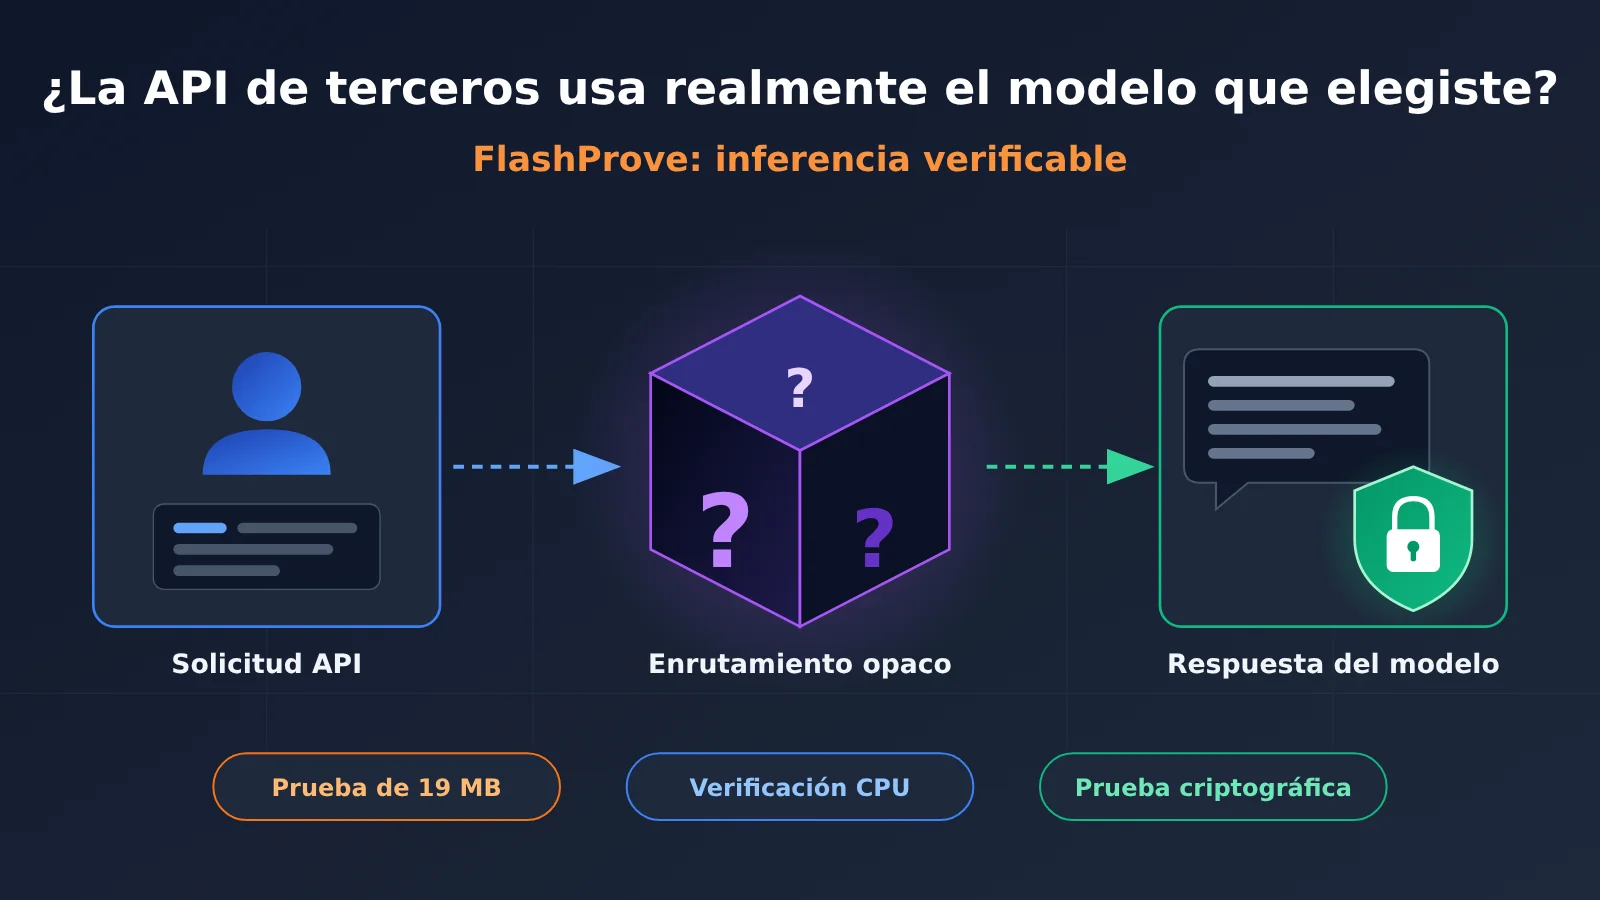
El 2 de noviembre de 2026, el Frontier Red Team de Anthropic, junto con investigadores de EPFL, MIT y otras instituciones, publicó FlashProve: un prototipo de código abierto de inferencia verificable para Modelos de Lenguaje Grandes. Sobre Llama 4 Maverick de 400B de parámetros, genera la prueba con una sola H100: cada prueba ocupa unos 19 MB y un CPU corriente la verifica en poco más de diez segundos.
No es una demo conceptual ni un producto de PowerPoint. Anthropic publicó a la vez el informe técnico, la especificación del protocolo, el código ejecutable del lado del probador y dos implementaciones del lado del verificador, además de una prueba formal en Lean, todo bajo licencia Apache 2.0. Dicho eso, también deja claro que se trata de un avance de investigación por etapas y que aún queda bastante camino hasta el objetivo completo.
Lo esencial: al terminar el artículo sabrás por qué la «identidad del modelo» es tan difícil de confirmar en las llamadas a API de terceros, con qué mecanismo la resuelve FlashProve, dónde están sus costes y sus límites reales, y qué puedes hacer hoy mismo como usuario de API.
Por qué existe un problema de confianza sobre la identidad del modelo en las APIs de terceros
Cuando envías una solicitud a cualquier API, lo único que recibes de vuelta es un fragmento de texto y un campo con el nombre del modelo. Anthropic lo dice sin rodeos en su blog de investigación: hoy los usuarios no pueden confirmar que una respuesta venga realmente del modelo que el proveedor afirma. Puede que un servicio de enrutamiento lo haya sustituido en silencio por motivos de costos, o que un atacante haya manipulado el flujo de tokens.
Lo más importante es que una salida de buena calidad no prueba que la identidad del modelo sea auténtica. Un modelo barato también puede responder muy bien a ciertas preguntas, y una versión degradada no siempre se detecta a simple vista. Incluso si se publicara el historial completo de un chat, en teoría se podría falsificar con un modelo más económico, así que ese tipo de evidencia no tiene un valor probatorio absoluto.
Verificarlo de raíz tampoco es fácil. Los pesos de los modelos de frontera casi nunca son públicos, y aunque se tuvieran, la potencia de cálculo necesaria para repetir la inferencia supera con creces lo que pueden asumir los usuarios comunes e incluso las instituciones de evaluación. Anthropic describe varios escenarios típicos de este problema de confianza:
- Servicios de enrutamiento de terceros: el cliente quiere confirmar que los tokens que recibe provienen del modelo que eligió y pagó.
- Evaluación independiente: los evaluadores necesitan comprobar que el modelo que probaron antes del lanzamiento es el mismo que realmente atiende en producción.
- Detección de manipulación: si se vulnera el servidor de inferencia, un atacante podría intercalar respuestas maliciosas e incluso instalar malware en el equipo del usuario.
- Regulación y cumplimiento: los reguladores pueden exigir que solo se desplieguen modelos que hayan pasado una revisión de seguridad, o confirmar que el hardware realmente está haciendo inferencia y no entrenando a escondidas.
El objetivo de la inferencia demostrable (Provable Inference) es que un usuario con poca capacidad de cómputo y sin acceso a los pesos pueda verificar que una respuesta concreta proviene del modelo solicitado.
FlashProve: resumen de la información clave
| Elemento | Detalles |
|---|---|
| Fecha de publicación | 2 de noviembre de 2026 |
| Publicado por | Anthropic Frontier Red Team, junto con investigadores de EPFL, MIT, StarkWare, Succinct y otras instituciones |
| Tecnología central | zkSNARK (argumento de conocimiento sucinto de conocimiento cero), construido a partir de funciones hash y con seguridad poscuántica |
| Modelo de prueba | Llama 4 Maverick, 400B de parámetros MoE, con unos 17B de parámetros activos por token y pesos públicos cuantizados a 4 bits |
| Contenido publicado | Blog de investigación, informe técnico, especificación del protocolo redactada por Claude, código del lado del probador y dos verificadores (C++ y Lean), pruebas en Lean y herramientas de visualización |
| Licencia de código abierto | Apache 2.0 |
| Estado actual | Prototipo de investigación: comparte avances parciales y da la bienvenida a mejoras externas |
Un dato interesante: Anthropic cuenta que Claude se encargó de buena parte de las optimizaciones del sistema. Como en sistemas grandes y complejos una IA puede tomar «decisiones difíciles de evaluar», el equipo escribió en Lean una declaración de seguridad de nivel superior que se puede auditar, como medida de cobertura.
Cómo demuestra FlashProve que una inferencia proviene del modelo indicado
FlashProve solo tiene dos roles: el proveedor del modelo actúa como probador (Prover) y el usuario como verificador (Verifier). El proceso se divide en una fase offline y una fase online, más una comprobación por parte del verificador.
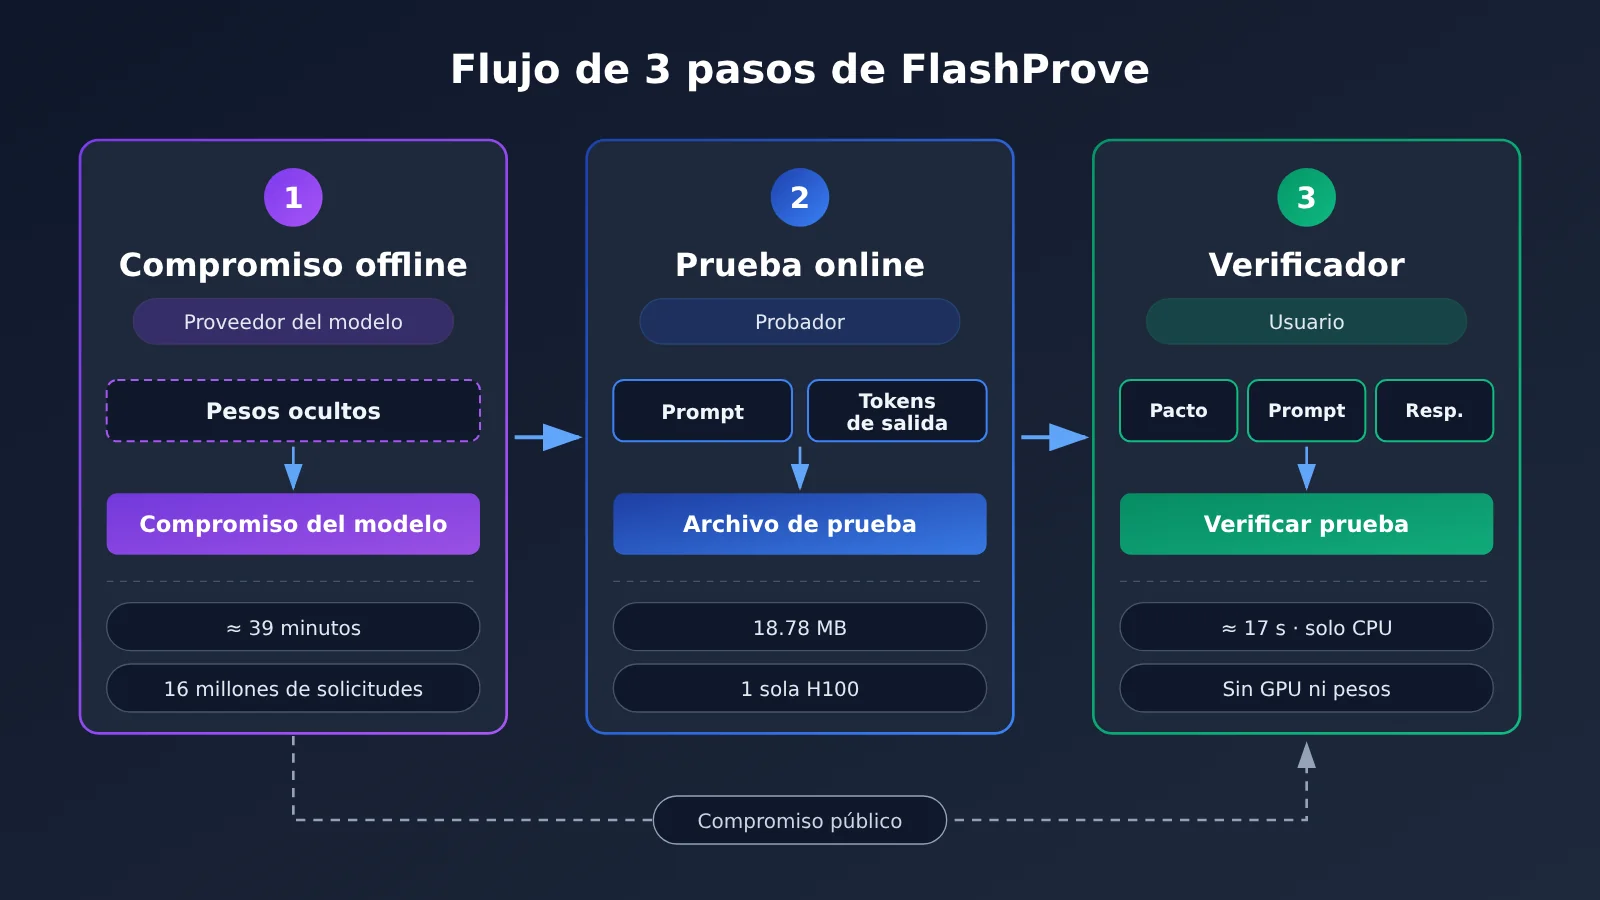
Los tres pasos del mecanismo de FlashProve
- Compromiso offline del modelo (Model Commitment): el probador publica un compromiso sobre los pesos del modelo, que puede entenderse como una «huella» muy corta. Esta huella fija un conjunto exacto de pesos, pero los pesos en sí siguen ocultos. En las pruebas, este paso se ejecuta una sola vez por modelo, tarda unos 39 minutos y el compromiso resultante da soporte a unos 16 millones de solicitudes, tras las cuales hay que generar uno nuevo.
- Generación de la prueba online: al recibir la solicitud del verificador (la indicación y los tokens de salida correspondientes), el probador genera un archivo de prueba. Lo que demuestra es que «el modelo comprometido, al ejecutarse, produce estos tokens de salida».
- Comprobación del verificador: cualquiera que tenga el compromiso, la indicación y la respuesta puede comprobar la prueba. No necesita los pesos y le basta con una capacidad de cómputo limitada para confiar en que los pesos comprometidos producen exactamente esos tokens con esa indicación.
Las cuatro propiedades de seguridad de FlashProve
Las dos primeras (completitud y solidez) también las lograría un verificador que conozca los pesos y tenga suficiente cómputo, simplemente recalculando por su cuenta. Lo que hace que el sistema tenga verdadero sentido son las otras dos:
- Completitud (Completeness): la prueba generada por un probador honesto siempre es aceptada.
- Solidez (Soundness): falsificar una prueba válida de una afirmación falsa es tan difícil como romper supuestos criptográficos ampliamente aceptados, así que el verificador no necesita confiar en el probador.
- Conocimiento cero (Zero Knowledge): el verificador no puede averiguar los pesos ni los valores intermedios del cálculo, ni tampoco qué expertos se activan en cada capa, aunque la arquitectura del modelo en sí no se oculta.
- Concisión (Succinctness): lo que se demuestra es una ejecución de un modelo cuantizado de unos 232 GB, pero el verificador solo recibe un archivo de unos 19 MB que puede comprobar en pocos segundos con una CPU de 24 núcleos.
Cómo reduce la arquitectura MoE el coste de la prueba en FlashProve
Gran parte de la aceleración de FlashProve aprovecha la estructura MoE (mezcla de expertos). En Llama 4 Maverick, cada token solo usa unos 17B de los 400B parámetros, y la carga de trabajo del probador es proporcional a esos 17B aproximadamente, mientras que la prueba sigue ocultando qué expertos se eligieron en concreto.
Hay otros dos diseños de ingeniería igualmente clave. El primero es la prueba por lotes a posteriori: el probador lee en paralelo el texto ya generado, igual que en el prefill, y abre el compromiso de los pesos una sola vez por lote. El segundo es la adaptación a una sola GPU: los pesos se dividen en segmentos por capas y se prueban uno a uno, cargándolos en streaming desde la memoria normal, de modo que basta una GPU de 80 GB con unos 290 GB de memoria del host.
Datos medidos del costo de prueba de FlashProve
El costo es el indicador clave para saber si la inferencia verificable puede llegar a producción. El entorno de pruebas de Anthropic fue este: el lado del probador usa una sola H100 más 24 núcleos de CPU, el lado del verificador usa solo CPU, y cada solicitud es una ventana de 1024 tokens.
| Etapa | Indicador | Valor medido |
|---|---|---|
| Compromiso offline | Duración / vigencia | Unos 39 minutos / unos 16 millones de solicitudes |
| Prueba online | Duración de un lote de 24 solicitudes | Unos 223 segundos |
| Prueba online | Rendimiento de procesamiento | Unos 110 tokens/s |
| Archivo de prueba | Tamaño de cada uno | 18,78 MB |
| Descarga del verificador | Tamaño del compromiso de los pesos | Unos 6,5 MB |
| Tiempo de verificación | 24 hilos / un solo hilo | 17 segundos / 21 segundos (incluye la comprobación de la fase offline) |
| Comparación con vLLM | Múltiplo de tiempo de una sola GPU | Unas 72 veces (66-77 veces), y unas 94 veces con la carga máxima |
La referencia de comparación es el mismo modelo en su versión FP8 ejecutado con vLLM sobre 8 H100. Dicho de otro modo, el tiempo de GPU necesario para probar un lote de solicitudes equivale a entre 70 y 95 veces el de procesar ese mismo lote con inferencia normal, es decir, una sobrecarga de unos dos órdenes de magnitud.
110 tokens/s no significa probar una respuesta completa en tiempo real
Este es el punto que más fácilmente se malinterpreta al leer sobre FlashProve. El informe técnico lo deja claro: cada prueba comprueba en realidad un solo token después del prompt, y los 110 tokens/s son el rendimiento con el que el probador procesa las ventanas de las solicitudes, no la velocidad de verificar token por token una respuesta completa.
| Criterio de medición | Rendimiento | Explicación |
|---|---|---|
| Lote de 24 solicitudes, contando por volumen de ventana procesado | Unos 110 tokens/s | La cifra de titular del blog; cada prueba comprueba un token |
| Comprobar cada token de la respuesta, contando por tokens verificados | 39,1 tokens/s | Más cercano al escenario de «verificar la respuesta entera» |
| Prueba de una sola solicitud por separado | 17,6 tokens/s | Cada prueba tarda unos 58 segundos, sin la ventaja del procesamiento por lotes |
Por eso, decir que «FlashProve ya puede probar respuestas completas en tiempo real» no es exacto. Una formulación más rigurosa sería esta: con procesamiento por lotes, contextos cortos y prueba posterior a la inferencia, reduce el costo de la inferencia verificable a un nivel que antes era difícil de imaginar.
FlashProve frente a las soluciones de inferencia demostrable existentes
En el ámbito académico, la inferencia demostrable suele conocerse como zkML. Anthropic repasó los avances en su blog, y la comparación de cifras es bastante reveladora.
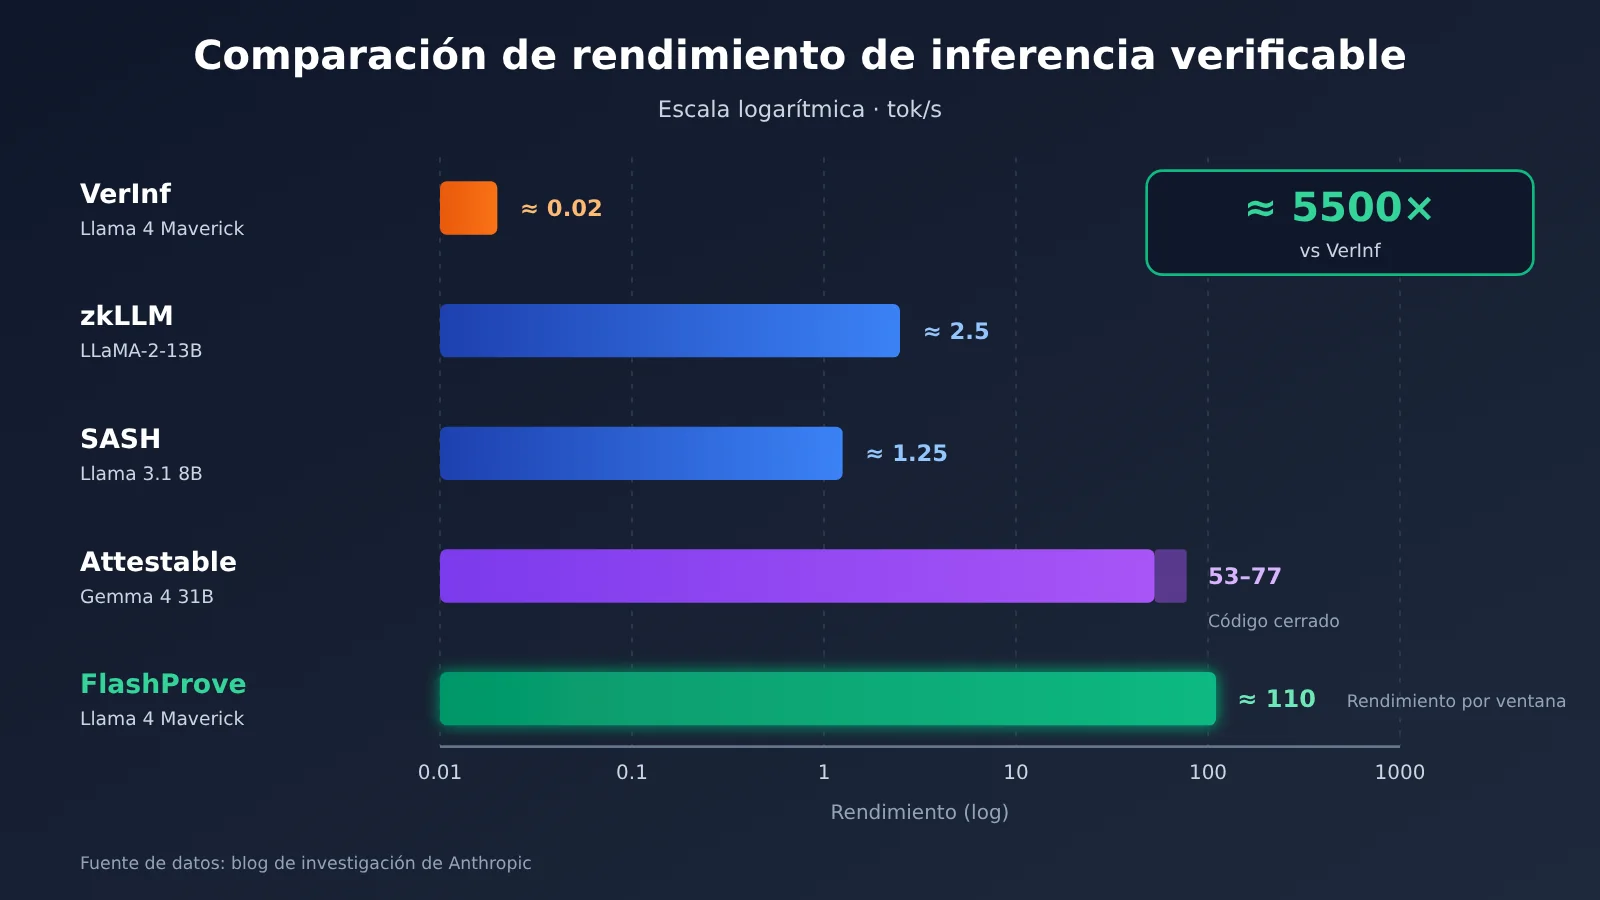
| Solución | Objeto de la demostración | Rendimiento / tiempo | Notas |
|---|---|---|---|
| VerInf | Llama 4 Maverick (400B MoE) | ~0.02 tok/s; 1000 tokens requieren 14.3 horas | Prueba de 93.6 GB; la verificación tarda casi un día |
| zkLLM (2024) | LLaMA-2-13B | ~2.5 tok/s por lotes | Una sola A100 |
| SASH (2026) | Llama 3.1 8B | ~1.25 tok/s | Una sola H100 |
| Attestable | Gemma 4 31B (modelo denso) | 53-77 tok/s | Solución comercial, aún sin código abierto |
| FlashProve | Llama 4 Maverick (400B MoE) | ~110 tok/s | Prueba de ~19 MB, verificación en segundos, código abierto |
Comparación con VerInf: VerInf era hasta ahora la única solución conocida que había logrado demostrar el mismo modelo, pero sus pruebas pesan hasta 93.6 GB y la verificación tarda casi un día, así que en la práctica es inutilizable. FlashProve, en cambio, reduce el tamaño de la prueba a unos 19 MB y acorta la verificación a una docena de segundos, con lo que por primera vez resulta viable que un tercero audite el resultado en una CPU corriente.
Comparación con Attestable: Attestable ha conseguido cifras comerciales espectaculares con modelos densos, pero en el momento de escribir el blog todavía no había publicado una biblioteca de código abierto. La ventaja de FlashProve es que el código, las pruebas en Lean y la documentación son totalmente abiertos, de modo que cualquiera puede reproducirlos y mejorarlos. El precio a pagar es que, por ahora, depende en gran medida de la arquitectura MoE.
Qué puede y qué no puede demostrar FlashProve
Para quien usa APIs de terceros, entender los límites es tan importante como entender las capacidades. La siguiente tabla resume las salvedades clave que aparecen en el blog de investigación y en el informe técnico:
| Dimensión | Lo que FlashProve sí logra | Lo que FlashProve todavía no logra |
|---|---|---|
| Identidad del modelo | Demuestra que la respuesta está vinculada a un compromiso de pesos concreto, es decir, que se trata del «modelo comprometido» | No puede demostrar que ese compromiso corresponda a un modelo con un nombre comercial determinado; hace falta publicar un compromiso por separado |
| Corrección de la salida | Demuestra que los tokens comprobados son el resultado de la decodificación voraz (greedy) del modelo cuantizado a enteros | No cubre directamente las salidas de implementaciones en punto flotante ni del muestreo aleatorio (temperature mayor que 0) |
| Protección de la privacidad | La prueba en sí no filtra los pesos | No oculta la arquitectura del modelo; los ataques de canal lateral, como el tiempo de generación, quedan fuera de su alcance |
| Longitud de contexto | Admite contextos de hasta 1024 tokens | Muy por debajo de las decenas o incluso cientos de miles de tokens (hasta más de un millón) habituales en escenarios de chat |
| Momento de la protección | Detecta a posteriori problemas de integridad | No impide que una respuesta manipulada llegue primero al usuario |
| Arquitectura del modelo | Se aplica a modelos MoE | Otras arquitecturas, como los modelos densos, requieren más investigación |
Limitaciones de detección de la prueba a posteriori en FlashProve
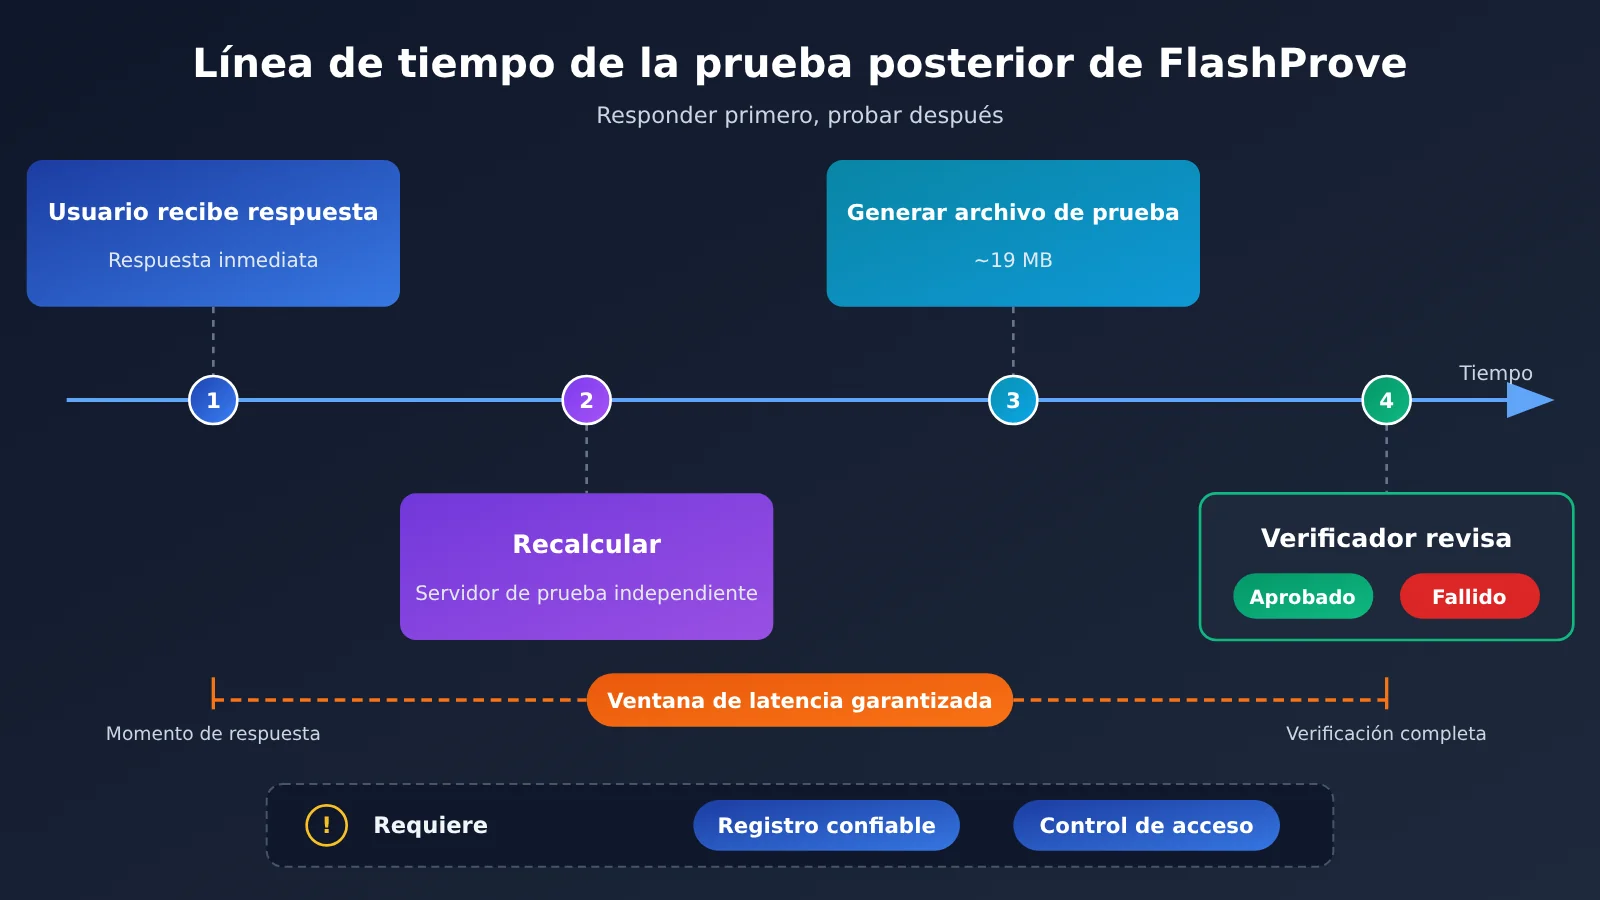
FlashProve usa pruebas a posteriori (Post-hoc Proving): el usuario recibe primero la respuesta, después un servidor de prueba independiente vuelve a calcularla y genera la prueba, y por último un verificador la comprueba. Este enfoque permite que la generación de la prueba sea más lenta, a cambio de no tener que sacrificar seguridad por eficiencia. El precio es que la garantía llega con retraso: si la prueba falla, solo sirve para revelar el problema, pero no protege al usuario antes de que reciba la respuesta.
El informe técnico también advierte de que, si el propio sistema de registros (logs) está controlado por el atacante, este podría enviar al usuario contenido manipulado mientras el log solo registra el resultado correcto. Por eso FlashProve debe usarse junto con otras medidas de seguridad, como registros confiables y control de acceso.
Lo que le falta a la verificación formal de FlashProve
Decir que «se hizo una prueba formal con Lean» puede interpretarse fácilmente como «todo el sistema está demostrado como correcto», pero no es así. Los límites que enumera el informe técnico son los siguientes:
- La prueba en Lean de la propiedad de conocimiento cero solo cubre la prueba de una única solicitud; todavía no cubre las pruebas por lotes.
- El código del lado del probador en GPU lo generó una IA a partir de la representación en Lean, y aún no se ha demostrado que sea equivalente a ella.
- El verificador rápido en C++ que se usa en el día a día también lo generó una IA y no tiene garantías formales; solo se sabe que, en las pruebas, sus conclusiones coinciden en todos los casos con las del verificador en Lean.
- El documento largo con la especificación del protocolo lo generó una IA y los autores no lo revisaron en detalle, así que conviene tratarlo por separado del informe técnico redactado por ellos.
Estas limitaciones no invalidan la investigación. Lo que muestran es que la verificación formal se centra, por ahora, en las propiedades matemáticas de la capa del protocolo, y que entre el código ejecutable y el protocolo sigue haciendo falta una auditoría humana o de agentes para cerrar la brecha.
Análisis de impacto: ¿qué tan lejos está FlashProve de las llamadas diarias a APIs de terceros?
Impacto para desarrolladores y usuarios de APIs
- No aparecerá pronto en el flujo cotidiano de invocaciones: un sobrecoste de GPU de unos dos órdenes de magnitud, pruebas de aproximadamente 19 MB por solicitud y un límite de ventana de contexto de 1024 tokens hacen que sea difícil usarlo directamente en APIs de conversación de alta frecuencia.
- Ámbito de aplicación limitado: el sistema asume una arquitectura MoE, modelos cuantizados a enteros y decodificación voraz (greedy). La mayoría de las invocaciones en producción usan muestreo aleatorio e inferencia en punto flotante, así que no se puede aplicar tal cual.
- Su mayor valor es conceptual: por primera vez, «verificar la identidad de un modelo» pasa de ser imposible a ser un problema de ingeniería. Conviene tener claro que el campo con el nombre del modelo que devuelve la respuesta, el ID del modelo o los registros normales de solicitudes no equivalen a una prueba criptográfica.
💡 Recomendación: mientras la inferencia verificable no madure, al elegir un servicio de terceros conviene fijarse más en la transparencia de la facturación, la trazabilidad de los registros de invocación y la coherencia en tus propias pruebas. Si usas una plataforma de agregación como APIYI (apiyi.com), puedes invocar varios modelos a la vez y conservar el historial completo de llamadas, lo que facilita hacer comparaciones cruzadas y auditorías por tu cuenta.
Impacto para la industria y la regulación
- Una opción más en la caja de herramientas de evaluación y cumplimiento: los reguladores podrían exigir a los proveedores que adjunten pruebas a las solicitudes de inferencia de un periodo determinado, para confirmar que el hardware realmente sirve el modelo indicado sin llegar a conocer los pesos propietarios. Eso sí, Anthropic reconoce que esto no demuestra que el hardware no esté entrenando por otra vía en paralelo.
- El software y el hardware de confianza se complementan: los entornos de ejecución confiables dependen de hardware a prueba de manipulaciones del fabricante, mientras que zkSNARK se apoya en la dificultad de ciertos problemas computacionales, de modo que no se pueden falsificar pruebas aunque se comprometan el hardware y el sistema operativo. Cada uno funcionará mejor en escenarios distintos.
- La verificación en producción de Anthropic sigue otro camino: en la actualización del Frontier Safety Roadmap del 19 de octubre de 2026, Anthropic menciona que su proyecto de verificación de inferencia ya cuenta con un prototipo sobre tráfico de inferencia real en producción: firma el tráfico interno de tokens y recalcula la inferencia en servidores de confianza. Con él detectó una anomalía de integridad extremadamente rara y no maliciosa. El proyecto pasó a llamarse inference verification y, aunque está relacionado con FlashProve, son dos proyectos independientes que no deben confundirse.
Qué puede hacer hoy quien usa APIs de terceros: crear sus propios registros de auditoría
Como las pruebas criptográficas todavía no están a nuestro alcance, lo que sí pueden hacer los desarrolladores es dejar bien resuelta la «trazabilidad». El siguiente ejemplo fija temperature=0 en cada llamada y guarda en un log local la hora de la solicitud, el ID de la solicitud, el campo de modelo devuelto y el hash de la respuesta, para facilitar pruebas de consistencia posteriores. Conviene subrayarlo: esto es solo un registro de auditoría a nivel de ingeniería, no una prueba criptográfica de la identidad del modelo.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz de APIYI compatible con OpenAI
)

resp = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "用一句话解释零知识证明"}],
    temperature=0
)
print(resp.model, resp.id)
print(resp.choices[0].message.content)
Ver el código completo de la implementación del log de auditoría
import hashlib
import json
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Una sola clave para invocar modelos de varios proveedores
)

def audited_call(prompt: str, model: str, log_path: str = "audit.jsonl") -> str:
    """Invoca el modelo y registra información de trazabilidad (no es una prueba criptográfica)"""
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        temperature=0,
        max_tokens=512,
    )
    content = resp.choices[0].message.content or ""
    record = {
        "ts": int(start),
        "latency_s": round(time.time() - start, 3),
        "requested_model": model,
        "returned_model": resp.model,   # Solo es un campo declarativo devuelto por el servidor
        "request_id": resp.id,
        "prompt_sha256": hashlib.sha256(prompt.encode()).hexdigest(),
        "output_sha256": hashlib.sha256(content.encode()).hexdigest(),
        "usage": resp.usage.model_dump() if resp.usage else None,
    }
    with open(log_path, "a", encoding="utf-8") as f:
        f.write(json.dumps(record, ensure_ascii=False) + "\n")
    return content

# Fija un conjunto de indicaciones de prueba, repite la prueba periódicamente y compara los hashes de salida y la distribución de latencia
probes = ["计算 37*43 并只输出结果", "列出三种排序算法的时间复杂度"]
for p in probes:
    for m in ["gpt-4o-mini", "claude-sonnet-4-5"]:
        print(m, audited_call(p, m)[:60])
🚀 Primeros pasos: puedes conseguir crédito de prueba gratuito en APIYI (apiyi.com) y usar el script de pruebas de arriba para repetir tests periódicos en varios modelos. Eso sí, este tipo de método solo mejora la trazabilidad; no sustituye a las pruebas a nivel de pesos como FlashProve.
Además, hay algunas prácticas útiles que puedes combinar con lo anterior: fijar el ID exacto del modelo en lugar de usar alias ambiguos; mantener un conjunto de indicaciones de prueba para seguir a largo plazo los cambios en la salida y la latencia; en procesos críticos, consultar varios modelos a la vez y contrastar los resultados; y estar atento a si los proveedores publican compromisos sobre los pesos o avanzan en mecanismos verificables.
Preguntas frecuentes (FAQ)
P1: ¿Qué es FlashProve?
FlashProve es un prototipo de investigación de inferencia demostrable que Anthropic publicó como código abierto en noviembre de 2026. Está basado en zkSNARK: el proveedor del modelo primero se compromete con los pesos y luego genera una prueba para el resultado de la inferencia. Así, el usuario puede verificar, sin necesidad de los pesos y usando solo CPU, si una respuesta proviene realmente del modelo comprometido.
P2: ¿En qué se diferencia FlashProve del proyecto de verificación de inferencia (inference verification) de Anthropic?
Los dos tienen objetivos parecidos, pero se implementan de forma distinta. El proyecto de verificación de inferencia ya cuenta con un prototipo sobre tráfico de producción: usa tráfico de tokens internos firmado y lo recalcula en un servidor de confianza. FlashProve, en cambio, es una solución criptográfica de software puro que por ahora sigue siendo un prototipo de investigación. No conviene confundirlos.
P3: ¿Los 110 tokens/s de FlashProve significan que se puede demostrar una respuesta completa en tiempo real?
No. Los 110 tokens/s son el rendimiento al procesar ventanas por lotes, y cada prueba solo comprueba un token. Si se verifica cada token de la respuesta, el rendimiento baja a 39,1 tokens/s, y con una prueba por solicitud individual cae a 17,6 tokens/s. Además, todo el proceso es una prueba a posteriori.
P4: ¿APIYI ya ofrece pruebas de FlashProve en cada respuesta?
No. Por ahora no hay ningún material que indique que APIYI (apiyi.com) haya desplegado FlashProve u ofrezca pruebas criptográficas a nivel de pesos. El nombre del modelo que devuelve la plataforma y los registros de invocación tampoco equivalen a una prueba criptográfica. Hoy por hoy, lo más práctico es aprovechar la interfaz unificada y el historial de llamadas de la plataforma para hacer tus propias repeticiones de prueba y comparaciones cruzadas.
P5: ¿Cómo hacer rápidamente pruebas de consistencia entre varios modelos mediante la API?
Lo recomendable es usar una plataforma agregadora compatible con varios modelos:
1. Entra en APIYI (apiyi.com), crea una cuenta y obtén tu clave API junto con una cuota de prueba gratuita.
2. Configura el `base_url` del código de este artículo como `https://api.apiyi.com/v1`.
3. Fija `temperature=0`, repite periódicamente las pruebas con indicaciones de sondeo y guarda el hash de cada salida.
Este método ayuda a detectar fluctuaciones anómalas, pero es una auditoría de ingeniería, no una prueba de identidad del modelo.
P6: ¿Qué limitaciones conocidas tiene FlashProve?
Las principales son:
– El coste en GPU es aproximadamente de 70 a 95 veces el de una inferencia normal.
– El contexto máximo es de 1024 tokens.
– Depende de una arquitectura MoE, de modelos cuantizados a enteros y de decodificación voraz (greedy).
– No oculta la arquitectura del modelo, y los ataques de canal lateral quedan fuera de su alcance.
– Al ser una prueba a posteriori, no impide que el contenido manipulado llegue primero al usuario.
– Todavía no existe una prueba formal de equivalencia entre el código ejecutable y el protocolo en Lean.
FlashProve: puntos clave (Key Takeaways)
- La brecha de confianza es real: cuando usas una API de terceros, que la respuesta sea de buena calidad no demuestra que el modelo sea realmente el que dicen.
- Mecanismo central: un compromiso de pesos offline más una prueba zkSNARK online; el usuario puede verificarla solo con una CPU.
- Reducción drástica de costes: una sola H100 alcanza unos 110 tokens/s por ventana, con pruebas de unos 19 MB y una verificación de unos 17 segundos.
- Ojo con las métricas: el rendimiento al comprobar token a token es de 39.1 tokens/s, y con una sola petición baja a 17.6 tokens/s.
- Límites claros: solo funciona con MoE, decodificación voraz (greedy) con enteros, contexto de 1024 tokens y detección a posteriori.
- Cómo empezar: por ahora puedes usar la interfaz unificada multimodelo de APIYI (apiyi.com) para hacer tus propias pruebas y auditorías.
Conclusión
La importancia de FlashProve se resume en tres puntos:
- Convierte la verificación de identidad del modelo en un problema de ingeniería: antes, demostrar que se estaba usando el mismo modelo requería más de diez horas y casi 100 GB de pruebas; ahora se reduce a cientos de tokens/s en procesamiento por lotes y a pruebas de 19 MB.
- Aún está lejos de producción: el sobrecoste de dos órdenes de magnitud, el contexto corto, las limitaciones de arquitectura y de método de decodificación, y una verificación formal incompleta hacen que por ahora siga siendo un prototipo de investigación.
- Necesita combinarse con otros mecanismos de seguridad: una prueba a posteriori solo detecta, no bloquea, así que debe ir acompañada de registros de confianza y control de acceso.
Para quien usa hoy APIs de terceros, lo más sensato es no tomar el campo del nombre del modelo como prueba de nada, pero tampoco angustiarse de más. Primero conviene consolidar los registros de llamadas, las pruebas con sondas y la validación cruzada entre varios modelos, y seguir de cerca los avances de la inferencia verificable. Te recomendamos usar APIYI (apiyi.com): con una sola clave puedes comparar varios modelos y construir una línea base de calidad trazable con tus propios datos de negocio.
📚 Referencias
- Blog de investigación de Anthropic – Progress on provable inference for large language models: artículo original de lanzamiento de FlashProve
- Enlace:
anthropic.com/research/provable-inference -
Descripción: incluye el diseño del sistema, datos de pruebas reales, comparación con soluciones existentes y una explicación de sus limitaciones
-
Informe técnico de FlashProve: detalles técnicos completos adjuntos al blog de investigación
- Enlace:
anthropic.com/research/provable-inference(acceso «Read the technical report» dentro de la página) -
Descripción: incluye las condiciones clave, como el criterio de medición del rendimiento (throughput), las limitaciones de las pruebas a posteriori y los límites de la verificación formal
-
Anthropic Frontier Safety Roadmap: avances del proyecto de verificación de inferencia
- Enlace:
anthropic.com - Descripción: para entender la diferencia entre inference verification y FlashProve
Autor: Equipo técnico de APIYI
Contacto técnico: escríbenos desde la página principal de APIYI; encontrarás más información de integración en el centro de documentación docs.apiyi.com