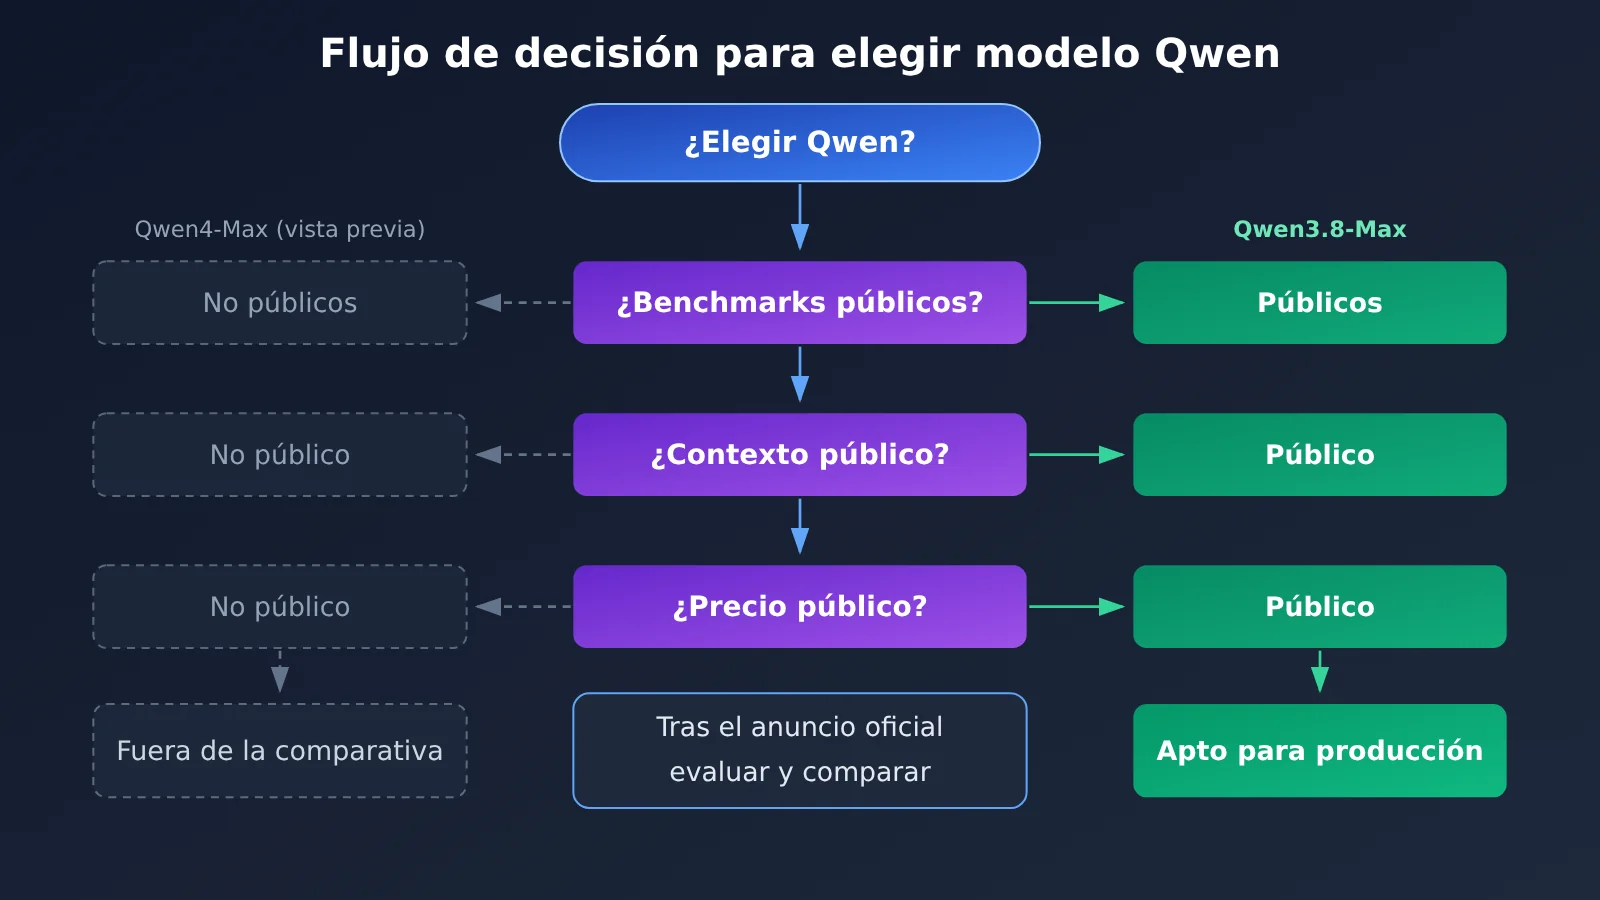
Nota del autor: Qwen4-Max sigue en fase de vista previa y todavía no tiene resultados de benchmarks públicos, longitud de contexto ni precio por token. Esos tres puntos no se pueden comparar de forma directa con Qwen3.8-Max. Hoy, el modelo que sí se puede invocar con facturación por uso sigue siendo qwen3.8-max.
Cuando salió la vista previa de Qwen4-Max, lo primero que preguntaron los desarrolladores que ya usan Qwen fue: ¿hay que cambiarse? ¿Cuánto mejor es que Qwen3.8-Max? ¿Cuánto más caro? Ahora mismo no hay una respuesta comparable, porque en esta fase de vista previa faltan tres datos públicos imprescindibles para comparar.
Esto no es hablar mal de Qwen4-Max. No juzgamos si el modelo es más o menos capaz; solo constatamos un hecho: a fecha de 2026-11-12, la vista previa de Qwen4-Max aún no tiene benchmarks públicos, longitud de contexto ni precio por token, mientras que Qwen3.8-Max ya está lanzado y se puede invocar con facturación por uso. Según la lista de modelos de APIYI (apiyi.com) a 2026-11-12, el que se puede integrar directamente hoy es qwen3.8-max.
Lo que te llevas: en 3 minutos tendrás claro qué puntos entre la vista previa de Qwen4-Max y Qwen3.8-Max no se pueden comparar todavía, y cómo organizar tus proyectos mientras no se publique la información oficial.
Qwen4-Max y Qwen3.8: resumen de la información clave
Primero juntemos lo que se puede confirmar de ambos lados. La tabla solo incluye lo que respaldan las fuentes de referencia; lo que no es público se marca como «No publicado», sin especular.
| Elemento | Qwen4-Max (versión preliminar) | Qwen3.8-Max |
|---|---|---|
| Estado de lanzamiento | Fase preliminar | Modelo ya lanzado |
| Benchmarks públicos | No publicados | Modelo ya lanzado; se puede consultar la documentación oficial |
| Longitud de contexto | No publicada | Según la documentación oficial y la descripción del modelo |
| Precio por token | No publicado | Entrada $1.65 / salida $4.95 / lectura de caché $0.20625 (por 1M de tokens) |
| Invocación por consumo | No aparece en la lista de modelos del 2026-11-12 | Disponible, ID del modelo qwen3.8-max |
| Plataformas disponibles | Según los anuncios oficiales posteriores | APIYI y otras plataformas |
«No publicado» aparece tres veces en la tabla: benchmarks, contexto y precio. Son justo las tres dimensiones que más se usan para comparar al elegir un modelo, y si falta cualquiera de ellas, la comparación pierde su base. Ya hay artículos anteriores que presentan cómo se abrió la versión preliminar, así que aquí solo vamos a ver por qué estas tres cosas impiden hacer una comparación directa.
Qué afecta cada uno de los tres datos que faltan en Qwen4-Max preliminar
Los benchmarks determinan la valoración de la capacidad. Sin puntuaciones oficiales publicadas, no hay una vara de medir común para saber si Qwen4-Max avanza o retrocede frente a Qwen3.8-Max en razonamiento, código, textos largos y otras tareas. Las capturas sueltas de la comunidad o las impresiones de alguna conversación usan conjuntos de prueba, indicaciones y parámetros de muestreo distintos, así que no sustituyen a un benchmark oficial.
La longitud de contexto determina el diseño de la arquitectura. El tamaño de los fragmentos en RAG, la estrategia para truncar el historial de conversación y si un documento largo se introduce de una vez o por partes dependen de un límite de contexto concreto. Mientras ese número no esté definido, no se puede evaluar si al migrar sería posible prescindir de la lógica de segmentación actual, ni saber si aparecerán errores por exceso de longitud.
El precio por token determina el modelo de costos. El presupuesto, la tarifación y la estrategia de límites de uso se construyen sobre el precio unitario. Aunque en la fase preliminar se pueda probar el modelo, eso no significa que ya exista un precio que se pueda poner en la tabla de costos; comparar un precio indefinido con la tarifa vigente de qwen3.8-max no lleva a ninguna conclusión útil.
Precio y acceso a Qwen3.8-Max con pago por uso
Como todavía no se dan las condiciones para comparar, lo más sensato es basar los proyectos actuales en los modelos ya publicados. La siguiente tabla recoge los precios de qwen3.8-max según la lista de modelos del 2026-11-12, en dólares por cada 1M de tokens.
| Concepto | Precio unitario (por 1M tokens) | Descripción |
|---|---|---|
| Entrada | $1.65 | Parte de la indicación que no acierta en la caché |
| Salida | $4.95 | Contenido generado por el modelo; cuesta 3 veces el precio de entrada |
| Lectura de caché | $0.20625 | Parte de la entrada que acierta en la caché; cuesta 1/8 del precio de entrada |
Si miramos la estructura, la salida cuesta el triple que la entrada y la lectura de caché solo el 12.5 % de la entrada. Por eso, controlar la longitud de la salida y subir la tasa de aciertos de caché son las dos formas más directas de reducir el costo de qwen3.8-max. En escenarios con indicaciones de sistema largas o conversaciones de varios turnos con un prefijo estable, el ahorro de la caché se nota todavía más.
Ejemplos de estimación de costos con Qwen3.8-Max
Con los precios anteriores se puede calcular el costo de algunas solicitudes típicas. Todas las cifras salen directamente de los precios públicos, así que es fácil aplicarlas al volumen de tu propio negocio.
| Escenario | Tokens de entrada | De ellos, aciertos de caché | Tokens de salida | Costo por solicitud |
|---|---|---|---|---|
| Solicitud normal | 10,000 | 0 | 2,000 | $0.0264 |
| Misma solicitud con acierto de caché del prefijo | 10,000 | 8,000 | 2,000 | $0.01485 |
| Procesamiento por lotes con 1M de entrada | 1,000,000 | 0 | 200,000 | $2.64 |
La segunda fila tiene el mismo total de entrada y salida que la primera; la única diferencia es que 8,000 tokens de entrada aciertan en la caché, y con eso el costo por solicitud baja de $0.0264 a unos $0.0149, una reducción de más del 40 %. Este es un cálculo que Qwen4-Max en versión preliminar no permite hacer hoy, porque todavía no se ha publicado su precio.
Cómo conectarse a qwen3.8-max
APIYI ofrece una interfaz compatible con OpenAI, así que puedes conectarte directamente con el SDK de OpenAI o con cualquier cliente compatible. Solo hay que cambiar tres parámetros:
base_url:https://api.apiyi.com/v1(la interfaz unificada de APIYI)api_key: la clave API que creas en la consola de APIYImodel:qwen3.8-max
La forma de invocación es la misma que la de Chat Completions: basta con organizar el arreglo messages en el orden de roles system, user y assistant. Si tu proyecto ya trabaja con un endpoint compatible con OpenAI, normalmente solo tienes que cambiar el base_url y el ID del modelo, sin tocar el código de negocio.
🚀 Para empezar: regístrate en APIYI (apiyi.com) y obtén crédito gratuito de prueba. Ejecuta primero tus propias indicaciones de negocio con
qwen3.8-maxy anota las proporciones reales de entrada, salida y aciertos de caché; así, cuando Qwen4-Max se abra oficialmente, ya tendrás datos con los que compararlo.
Impacto de la vista previa de Qwen4-Max en los proyectos Qwen existentes
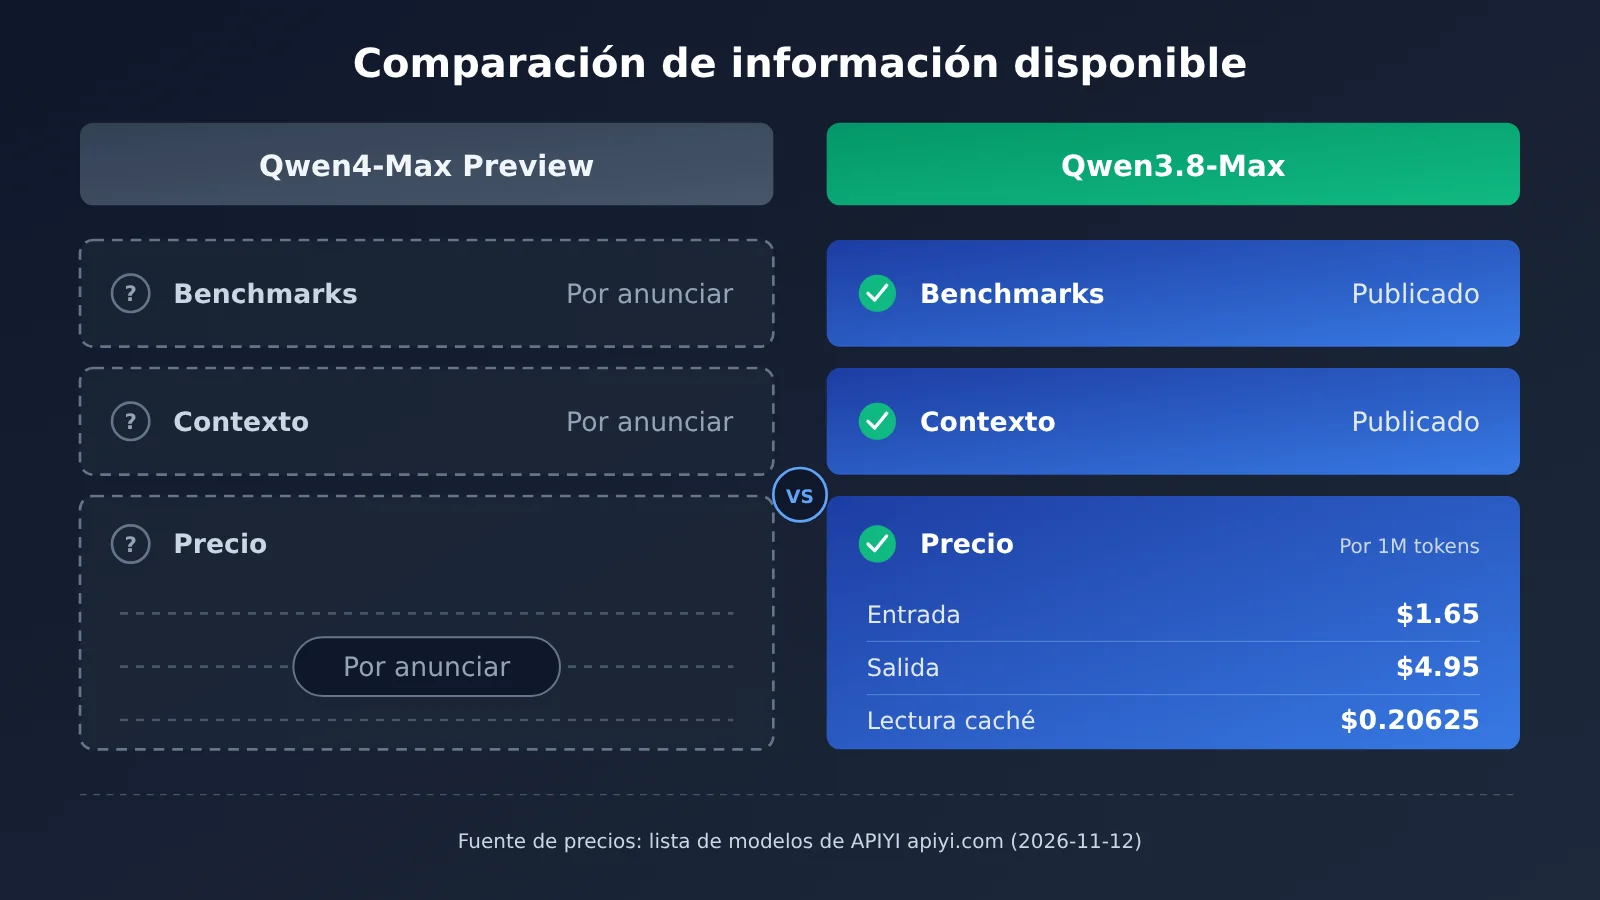
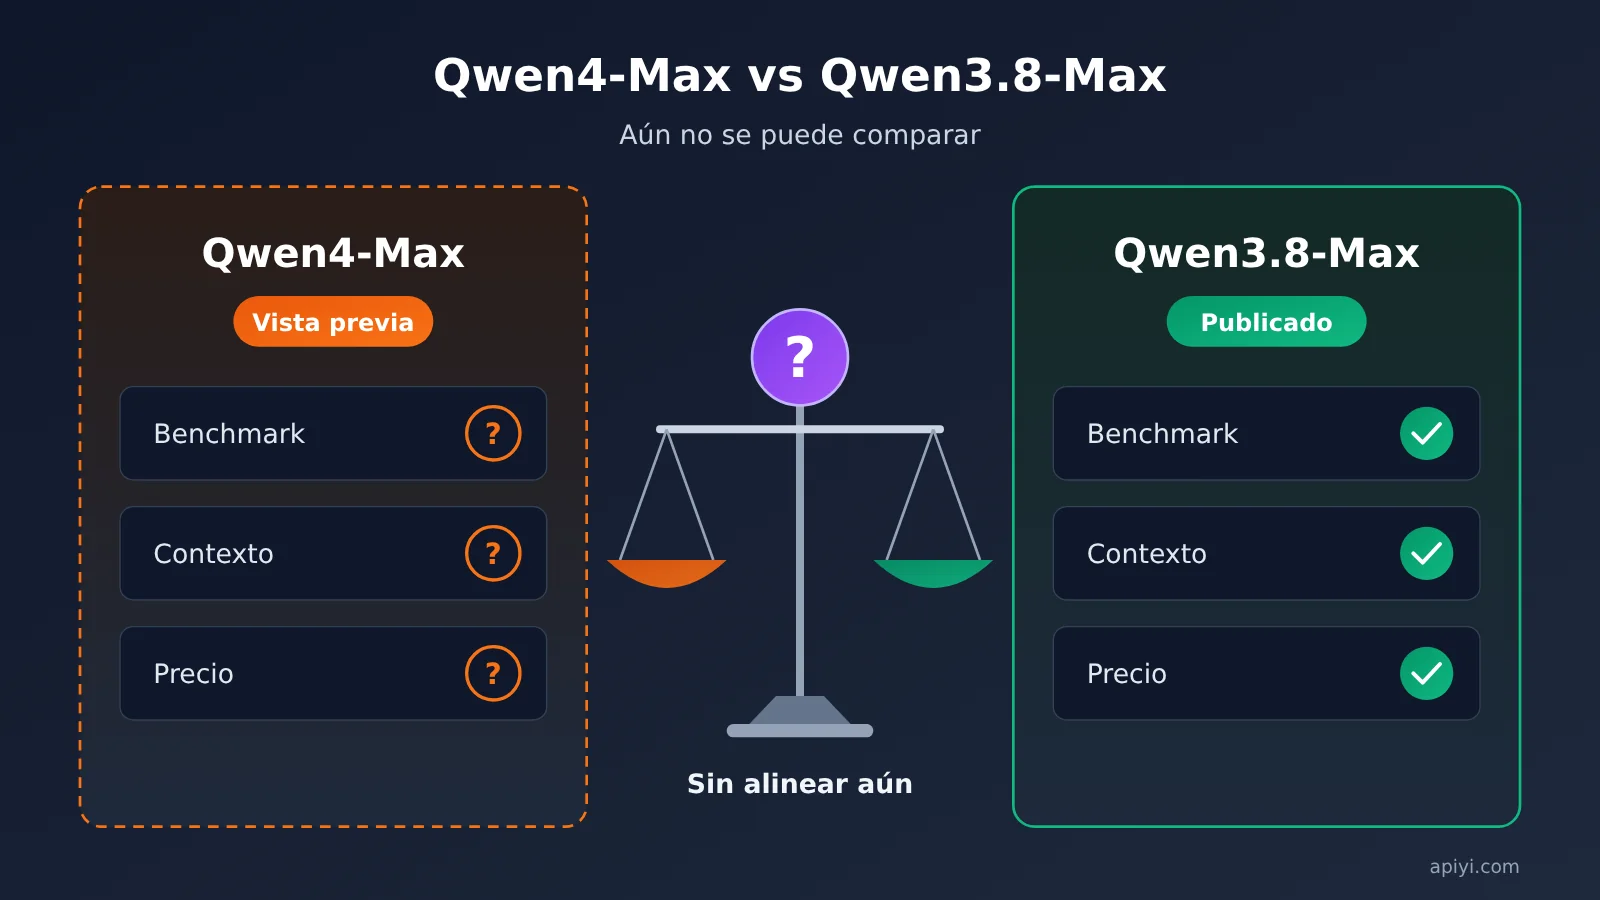
El gráfico pone lado a lado la información disponible de cada modelo: a un lado, tres huecos por anunciar; al otro, datos que se pueden consultar directamente. Con este panorama, cualquier conclusión del tipo «es mucho mejor» o «es mucho más caro» carece de fundamento. Los precios se pueden verificar en la lista de modelos de APIYI (apiyi.com).
Qué significa para quienes ya usan Qwen
- No hace falta tocar producción: la vista previa de Qwen4-Max no cambia la disponibilidad ni el precio de qwen3.8-max, así que tus invocaciones actuales siguen funcionando igual.
- Puedes ir preparando la evaluación: reúne un conjunto de indicaciones de prueba que represente tu negocio, junto con tus criterios de puntuación, para comparar ambos modelos en cuanto se publique la información oficial.
- El presupuesto de costes sigue basándose en qwen3.8-max: en la fase de vista previa no hay precio unitario, así que no conviene incluir Qwen4-Max en el presupuesto ni en las cotizaciones de la siguiente etapa.
- Deja en pausa los cambios relacionados con el contexto: hasta que se publique la longitud de contexto de Qwen4-Max, no es recomendable ajustar tu lógica de fragmentación o truncado por su causa.
Recomendaciones según el rol
| Rol | Qué puedes hacer ahora | Qué hacer cuando se publique la información oficial |
|---|---|---|
| Desarrollador de aplicaciones | Seguir con qwen3.8-max y construir un conjunto de evaluación de tu negocio |
Comparar ambos modelos con ese mismo conjunto |
| Responsable de arquitectura | Diseñar la estrategia de contexto según los límites reales de qwen3.8-max | Evaluar si se puede simplificar la fragmentación según el contexto de Qwen4-Max |
| Responsable de costes | Elaborar el presupuesto con entrada $1.65 y salida $4.95 por 1M tokens | Recalcular el coste de migración cuando se conozca el precio de Qwen4-Max |
| Product manager | Basar la comunicación externa en las capacidades de los modelos ya publicados | Decidir si se anuncia la mejora según los benchmarks públicos |
Lecciones para el proceso de selección de modelos
El error más fácil de cometer con una versión preliminar es confundir «parece más nuevo» con «ya es mejor». Un proceso de selección riguroso necesita al menos tres tipos de datos públicos: capacidad (benchmarks), capacidad de carga (contexto) y coste (precio unitario). Hasta que estén los tres, el modelo nuevo encaja en una lista de seguimiento, pero no en un plan de producción.
Gestionar la invocación de modelos mediante una interfaz unificada tiene además otra ventaja: cuando Qwen4-Max se abra oficialmente al pago por uso, bastará con cambiar el parámetro model para hacer pruebas A/B, sin tener que integrar otro SDK.
💡 Recomendación: hasta que se publiquen los tres datos clave de Qwen4-Max, lo más sensato es mantener qwen3.8-max como modelo principal en producción. Si te conectas a través de la interfaz unificada de APIYI (apiyi.com), podrás cambiar y comparar rápidamente con el nuevo modelo usando el mismo código cuando salga.
Preguntas frecuentes (FAQ)
P1: ¿Ya se puede comparar Qwen4-Max (vista previa) con Qwen3.8-Max?
Todavía no en tres aspectos: benchmarks, longitud de contexto y precio por token. Qwen4-Max sigue en fase de vista previa y ninguno de esos tres datos es público, así que no hay una base común para comparar. Lo único que se puede afirmar es el estado de lanzamiento: Qwen3.8-Max ya está publicado y se puede usar con pago por uso, mientras que Qwen4-Max sigue en vista previa.
P2: ¿Qwen4-Max ya supera por completo a Qwen3.8-Max?
Por ahora no hay datos públicos que respalden esa conclusión. Que la nueva generación tenga un número de versión mayor no significa que sea mejor en todas las tareas, ni que su precio sea más conveniente. Para saber si lo supera y en qué tareas, hay que esperar a que se publiquen los benchmarks oficiales y, a ser posible, validarlo con tu propio conjunto de evaluación.
P3: ¿Cuál es el precio actual de Qwen3.8-Max?
Según la lista de modelos del 2026-11-12, qwen3.8-max cuesta por cada 1M de tokens: $1.65 de entrada, $4.95 de salida y $0.20625 de lectura de caché. El precio de lectura de caché es solo 1/8 del de entrada, así que en escenarios donde el prefijo de la indicación es estable, el ahorro de costes puede ser notable.
P4: ¿Cómo invoco Qwen3.8-Max rápidamente por API?
Lo recomendable es usar una plataforma agregadora de API que soporte varios modelos:
1. Entra en APIYI (apiyi.com), crea una cuenta y obtén tu clave API junto con crédito gratuito para pruebas.
2. Configura `base_url` como `https://api.apiyi.com/v1`.
3. Usa `qwen3.8-max` como ID del modelo y haz la invocación con el formato Chat Completions compatible con OpenAI.
P5: Cuando Qwen4-Max se abra oficialmente, ¿será costoso migrar?
A nivel de interfaz, el coste de migración depende de cómo hayas integrado el modelo. Si gestionas todo con una interfaz compatible con OpenAI, normalmente basta con cambiar el ID del modelo; lo que realmente hay que evaluar son las diferencias de calidad y de coste. Te sugiero ir acumulando desde ahora datos de evaluación con qwen3.8-max en APIYI (apiyi.com) para poder compararlos directamente cuando llegue el momento.
P6: ¿Qué limitaciones hay que tener en cuenta durante la vista previa?
Todos los parámetros clave pueden cambiar durante la vista previa. Sin benchmarks públicos no se pueden conocer los límites de capacidad; sin la longitud de contexto, no se puede cerrar una solución para textos largos; y sin precio unitario, no se puede incluir en el presupuesto. Por eso no recomendamos usar modelos en vista previa en producción cuando se exige estabilidad y control de costes.
Qwen4-Max y Qwen3.8: puntos clave (Key Takeaways)
- Estado de lanzamiento distinto: Qwen4-Max sigue en vista previa, mientras que Qwen3.8-Max ya está publicado y se puede invocar con facturación por uso.
- Tres aspectos que no se pueden comparar a la fuerza: de Qwen4-Max no se han publicado ni los resultados de benchmarks, ni la longitud de contexto, ni el precio por token.
- No saques conclusiones antes de tiempo: sin datos públicos, no se puede afirmar que Qwen4-Max supere por completo a Qwen3.8-Max.
- Precio vigente consultable: qwen3.8-max cuesta $1.65 de entrada, $4.95 de salida y $0.20625 de lectura de caché por cada 1M de tokens.
- La caché es la clave para reducir costes: el precio de lectura de caché es solo 1/8 del de entrada, así que el ahorro es notable en escenarios con prefijos estables.
- En producción, quédate con qwen3.8-max: intégralo a través de la interfaz unificada de APIYI y, cuando cambies de modelo más adelante, solo tendrás que modificar el ID del modelo.
Resumen
La relación entre la vista previa de Qwen4-Max y Qwen3.8-Max se resume en estos puntos:
- Todavía no hay condiciones para comparar: a la vista previa de Qwen4-Max le faltan benchmarks públicos, longitud de contexto y precio por token, así que ninguno de los tres aspectos se puede contrastar con Qwen3.8-Max.
- Lo que se puede usar hoy es qwen3.8-max: tiene precios claros: $1.65 de entrada, $4.95 de salida y $0.20625 de lectura de caché (por cada 1M de tokens).
- Prepárate ahora y compara cuando haya anuncio oficial: ve acumulando un conjunto de evaluación propio de tu negocio y datos de costes, y decide la migración cuando tengas toda la información.
Hasta que se publique la información oficial de Qwen4-Max, lo más sensato es seguir apoyando tu negocio en qwen3.8-max y, mientras tanto, dejar listas tus bases de evaluación y de costes. Te recomendamos acceder a qwen3.8-max a través de APIYI (apiyi.com): la plataforma ofrece una interfaz unificada compatible con OpenAI y créditos gratuitos para pruebas, de modo que, cuando salga el nuevo modelo, podrás compararlo directamente con el mismo código.
📚 Referencias
- Lista de modelos y precios de APIYI: verificación de modelos disponibles al 2026-11-12
- Enlace:
api.apiyi.com/api/pricing -
Descripción: se usó para confirmar los modelos Qwen que se pueden invocar actualmente con facturación por uso
-
Documentación de modelos de APIYI: información de facturación de qwen3.8-max
- Enlace:
docs.apiyi.com/models - Descripción: incluye los precios unitarios de entrada, salida y lectura de caché de qwen3.8-max
Autor: equipo técnico de APIYI
Contacto técnico: escríbenos desde la página principal de APIYI; encontrarás más material sobre cómo integrar modelos en el centro de documentación de APIYI