Claude Fable 5.2 se lanzó el 9 de noviembre de 2026. Su precio estándar por API es un 20 % más bajo que el de la versión 5.1.
Muchas empresas se preguntarán enseguida: si ahora cuesta menos, ¿podemos pasar directamente a max?
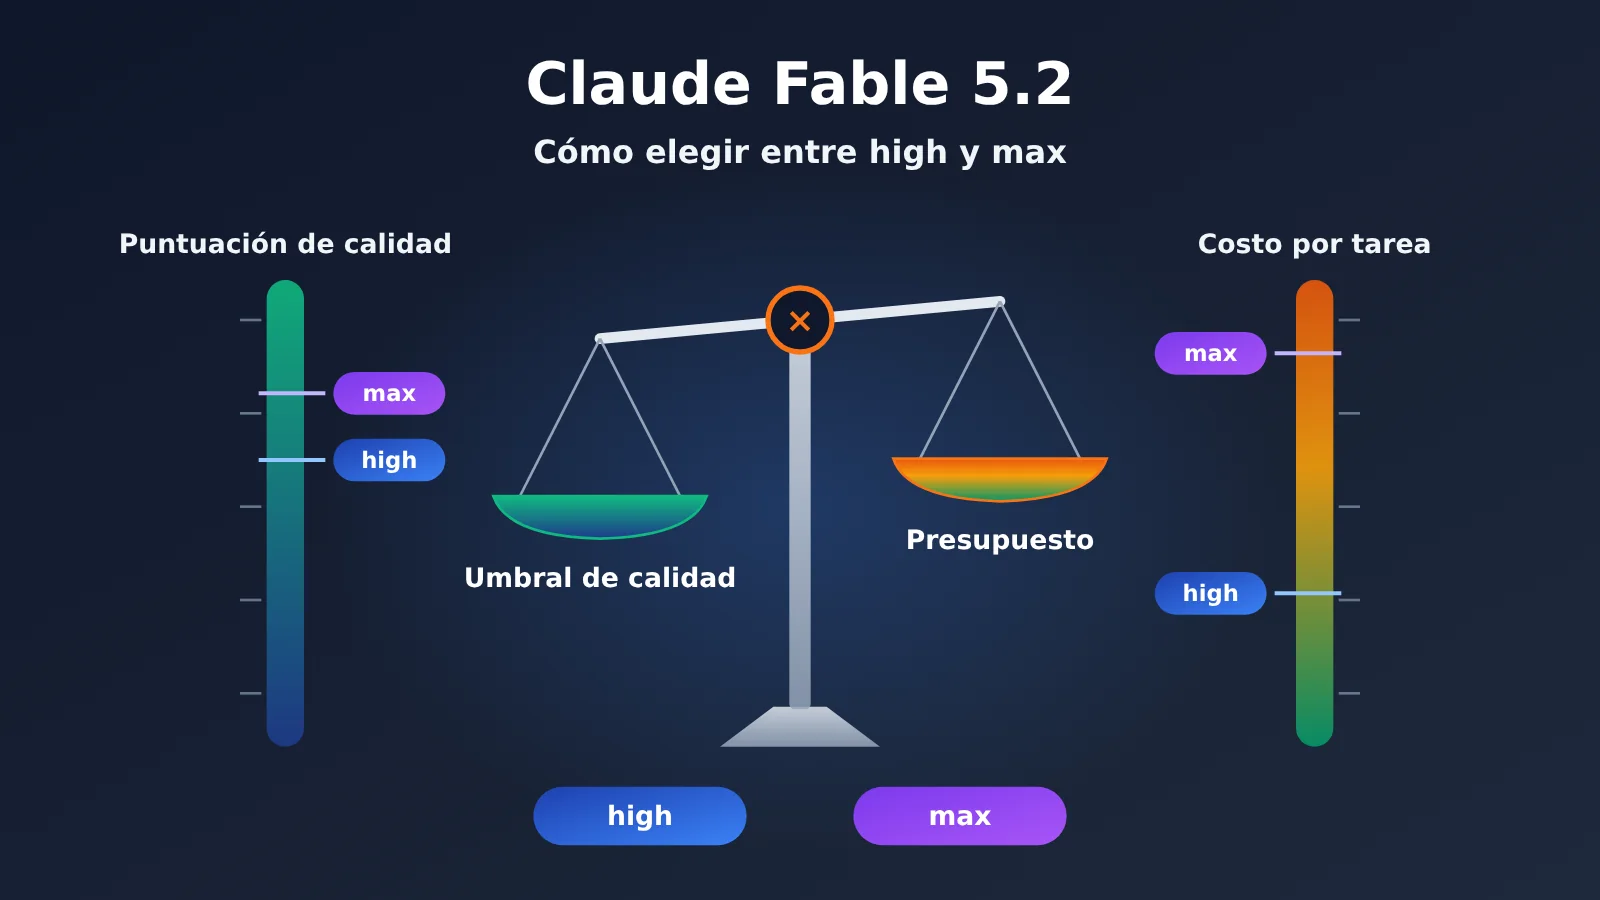
En este artículo comparamos Fable 5.2 high y Fable 5.2 max con el mismo marco de análisis, teniendo en cuenta tanto la calidad como el costo por tarea.
Valor principal: al terminar de leer, sabrás en qué condiciones conviene usar high o max en Fable 5.2 y tendrás una lista de verificación que puedes aplicar directamente para evaluar una actualización.
Índice
- Lo que debes saber: términos relacionados con la elección de nivel en Fable 5.2
- 1 El nivel high y el nivel max de Fable 5.2 no cambian el mismo precio unitario
- 2 Calidad y costo de Fable 5.2 en una misma tabla
- 3 Revisión de las tendencias por nivel de Fable 5.2 con datos de entidades independientes
- 4 Elección del nivel de Fable 5.2 según el uso
- 5 Cómo decidir, con tus propias pruebas de aceptación, si actualizar Fable 5.2 a max
- Preguntas frecuentes / conclusiones clave / resumen
Para tener en cuenta
| Término | Significado | Qué debes tener en cuenta al leer este artículo |
|---|---|---|
| Effort | Configuración que controla cuánto esfuerzo dedica el modelo a pensar | El valor predeterminado de la API de Fable 5.2 es high |
| Adaptive thinking | Mecanismo por el que el modelo asigna automáticamente la cantidad de pensamiento | Siempre está activado en Fable 5.2 |
| Harness | Entorno de ejecución que proporciona herramientas, sesiones y reglas de ejecución al modelo | El Harness de Cursor es diferente al de AA |
| Intelligence Index | Índice compuesto que AA calcula ponderando varias evaluaciones | Es un índice, no un porcentaje de aciertos |
| Puntos porcentuales | Diferencia absoluta que se obtiene al restar dos porcentajes | De 56,9 % a 60,0 % hay 3,1 puntos porcentuales |
| Coste por tarea | Coste del modelo repartido entre cada tarea en unas condiciones de prueba determinadas | No equivale a tu factura de la API |
| Umbral de aceptación | Nivel de calidad que debe alcanzar una tarea | Primero hay que superar el umbral y después comparar presupuestos |
| Segmentación de tareas | Agrupación de tareas según su dificultad y el coste de fallar | Cada nivel requiere una configuración distinta |
1. high y max de Fable 5.2 no cambian el mismo precio unitario
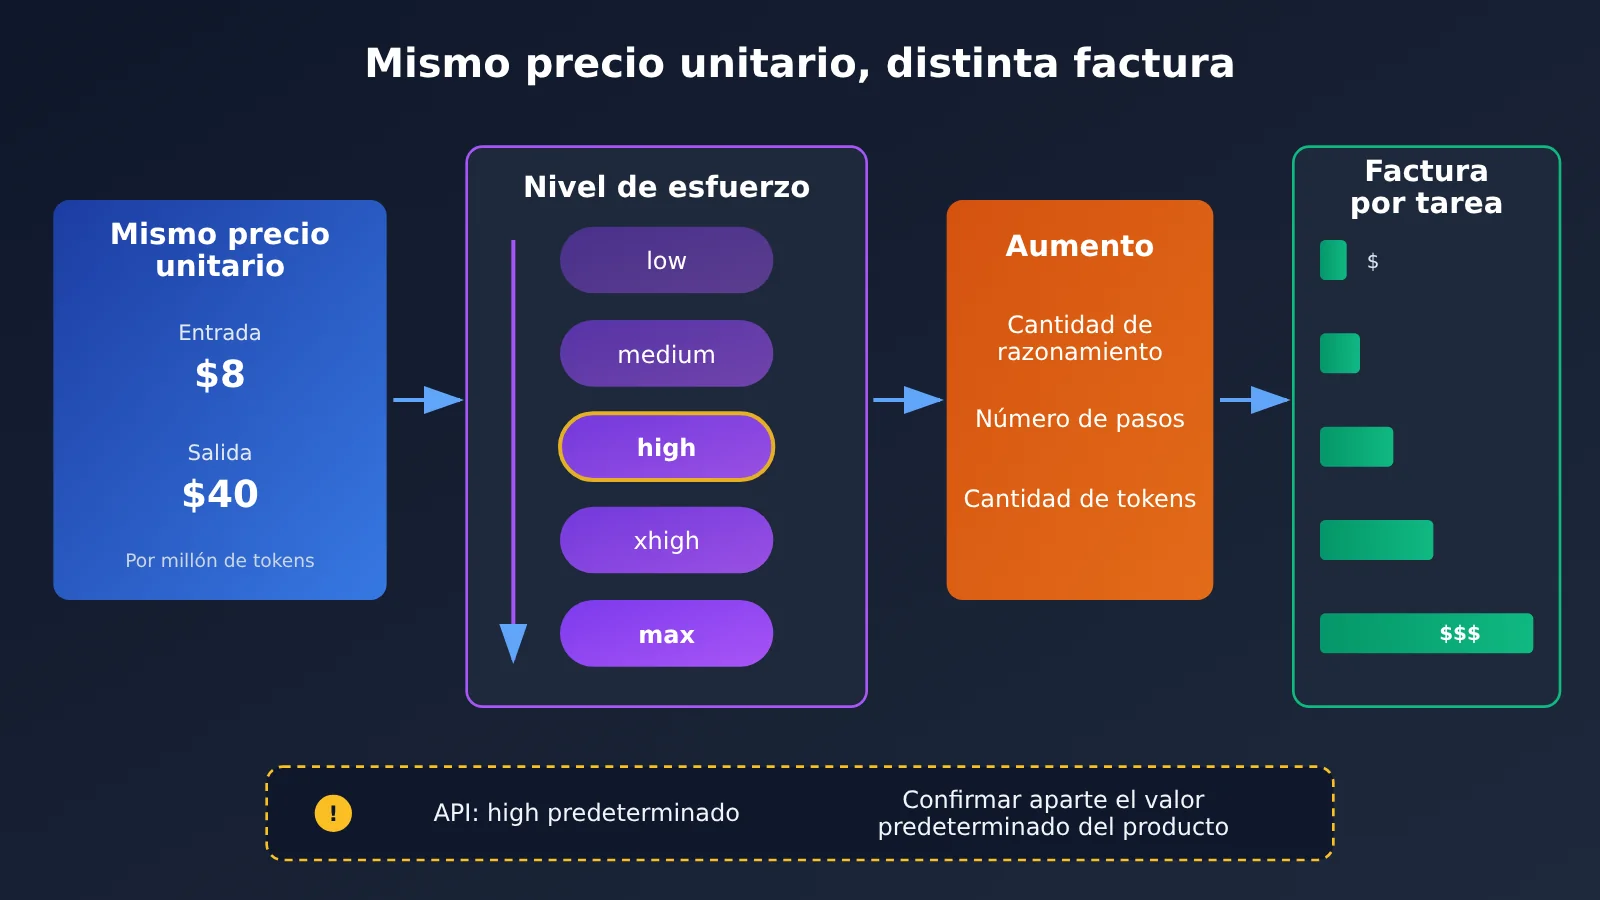
Mucha gente piensa que cuanto más alto es el nivel, más caro es el precio unitario. Sin embargo, con las tarifas estándar oficiales de Anthropic, Fable 5.2 cuesta 8 dólares por cada millón de tokens de entrada y 40 dólares por cada millón de tokens de salida. Estos precios no varían según el nivel.
effort cambia cuánto piensa el modelo en una tarea, cuántos pasos da, cuánto tarda y cuántos tokens consume. Por eso, aunque el precio unitario sea el mismo, el coste de una tarea puede multiplicarse varias veces.
Cómo afectan los niveles de Fable 5.2 a la factura
En Fable 5.2, el pensamiento adaptativo está siempre activado; effort determina el límite y la tendencia de la inversión de pensamiento. Al subir de nivel, el modelo suele hacer más razonamientos y llamadas a herramientas, lo que aumenta los tokens facturables.
Con los mismos 100.000 tokens de entrada, si la salida aumenta de 20.000 a 40.000 tokens, el coste en el modo estándar de 5.2 sube de 1,60 a 2,40 dólares; es decir, supera incluso los 2 dólares que costaba 5.1 con el consumo anterior.
También conviene distinguir dos tipos de «valor predeterminado». La documentación oficial del modelo especifica que el effort predeterminado de la API es high. Productos como Cursor tienen su propia capa de configuración. Por ejemplo, su contexto predeterminado es de 300K, algo que no está en el mismo nivel que la especificación de 1M de la documentación de la API.
Un último detalle: la guía oficial de indicaciones advierte que un mismo nivel puede implicar una cantidad de pensamiento distinta en cada versión. Por eso, no conviene aplicar sin más a 5.2 lo aprendido con los niveles de la época de 5.1.
2 Calidad y costo de Fable 5.2 en una misma tabla
CursorBench 4.0 es una evaluación que Cursor realiza con sus propias tareas y herramientas. No es una prueba independiente de propósito general, pero compara los cinco niveles bajo el mismo harness, por lo que resulta útil para observar las diferencias relativas entre ellos. Los datos se consultaron el 10 de noviembre de 2026.
| Nivel de Fable 5.2 | Puntuación | Costo por tarea (USD) | tokens (campo agregado) | Pasos |
|---|---|---|---|---|
| Low | 53.2% | 3.94 | 36,616 | 30 |
| Medium | 54.8% | 4.66 | 44,103 | 35 |
| High | 56.9% | 9.70 | 99,259 | 69 |
| Extra High | 56.3% | 15.48 | 161,251 | 108 |
| Max | 60.0% | 32.79 | 352,794 | 218 |
Nota: la columna de tokens es un campo agregado de la página de referencia; no debe interpretarse como si incluyera solo la cantidad de tokens de salida. Fuente: CursorBench 4.0.
De Fable 5.2 High a Max: 3.1 puntos porcentuales y un costo unas 3.38 veces mayor
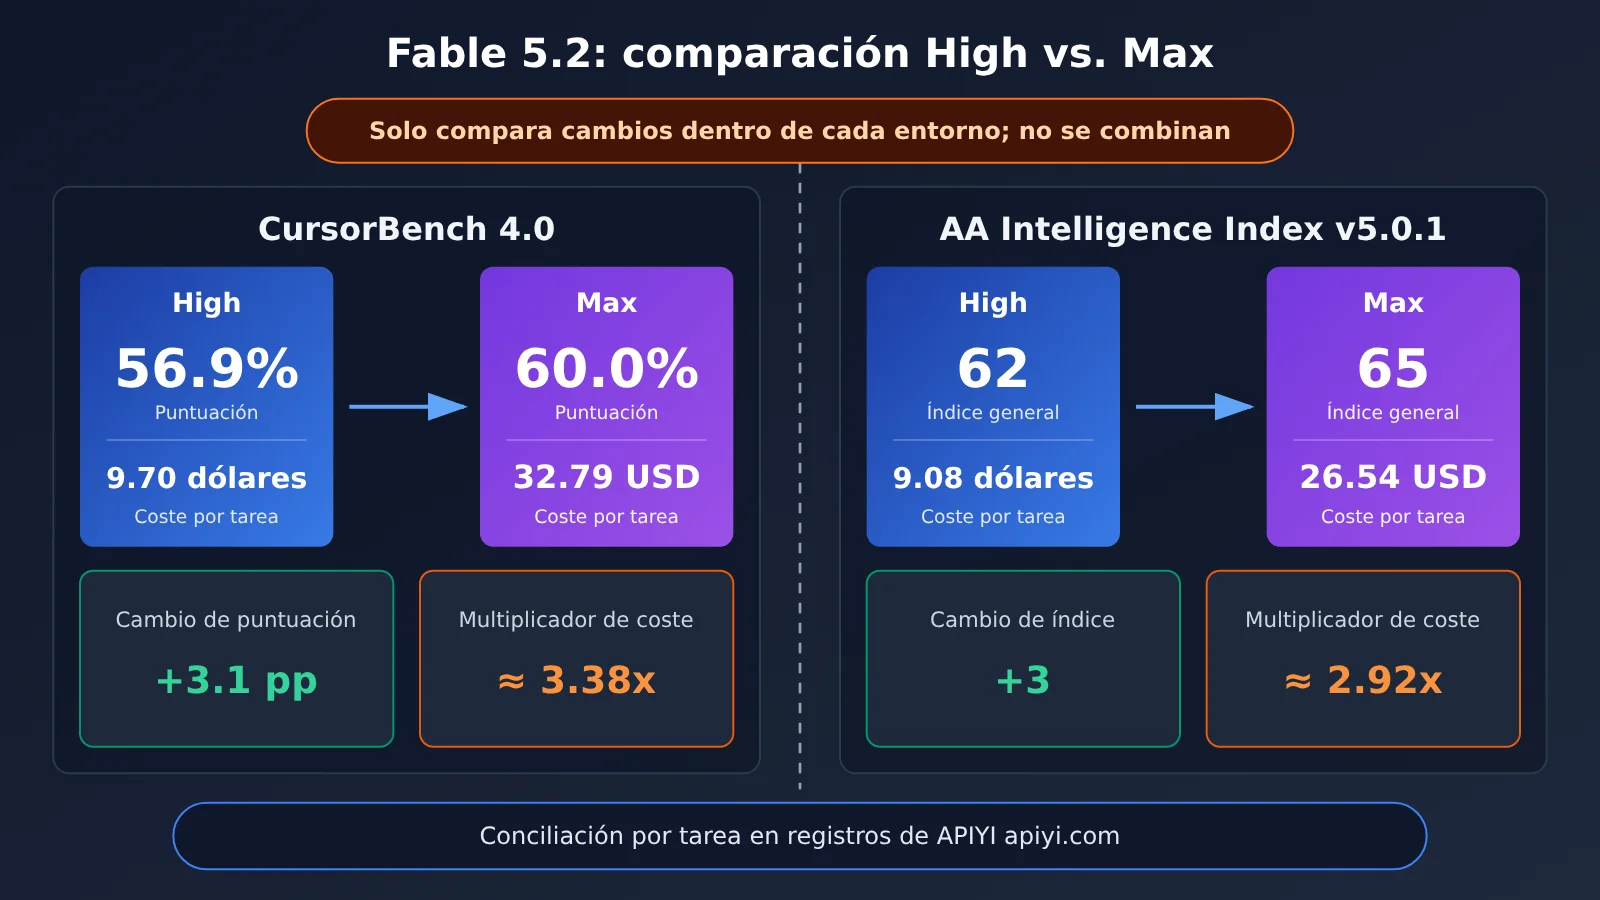
En esta tabla, la puntuación sube de 56.9% en High a 60.0% en Max: una mejora de 3.1 puntos porcentuales. El costo por tarea pasa de 9.70 a 32.79 dólares, es decir, unas 3.38 veces más —un aumento de aproximadamente el 238%—.
Según nuestros cálculos, el campo de tokens aumenta unas 3.55 veces, y los pasos pasan de 69 a 218, alrededor de 3.16 veces más. El aumento del costo se debe principalmente a que se requieren más pasos de razonamiento y ejecución, no a un cambio en el precio unitario.
Estos datos solo permiten afirmar que, en este entorno, una puntuación más alta va acompañada de un gasto notablemente mayor.
Cómo interpretar el resultado atípico de Extra High
Hay otro dato que llama la atención: Extra High cuesta alrededor de un 60% más que High, pero obtiene una puntuación 0.6 puntos porcentuales menor.
💡 Recomendación: solo se pueden comparar los niveles dentro de una misma tabla; no conviene combinar cifras de distintas evaluaciones. Si quieres reproducir una comparación similar con tus propias tareas, puedes conciliar los datos con la interfaz unificada y los registros de invocaciones de APIYI (apiyi.com). Antes, confirma qué ID de modelo y qué niveles admite la plataforma ese día.
3 Comprobar la tendencia de los niveles de Fable 5.2 con datos de una entidad independiente
Si solo se consulta un entorno de evaluación, las conclusiones pueden verse afectadas por las particularidades de ese entorno. AA es una entidad de evaluación independiente y su clasificación permite comprobar si la tendencia observada en Cursor también aparece en otro entorno. A continuación se muestra una instantánea actualizada al 10 de noviembre de 2026, con la versión metodológica Intelligence Index v5.0.1.
| Configuración | Intelligence Index | Coste por tarea (USD) |
|---|---|---|
| Fable 5.2 medium | 56 | 3.80 |
| Fable 5.2 high | 62 | 9.08 |
| Fable 5.2 xhigh | 62 | 14.83 |
| Fable 5.2 max | 65 | 26.54 |
| Opus 5.5 max | 59 | 10.04 |
65 no significa un 65 % de respuestas correctas
La página metodológica de AA explica que el índice de la versión v5.0.1 se compone de 9 evaluaciones y que cada una de las cuatro categorías de capacidades tiene un peso del 25 %. Por tanto, 65 es una puntuación compuesta, no un 65 % de respuestas correctas. En el entorno de AA, el índice sube 3 puntos de high a max, mientras que el coste por tarea se multiplica aproximadamente por 2.92. Que high y xhigh obtengan ambos 62 solo significa que tienen la misma puntuación compuesta, no que su comportamiento sea idéntico en cada tarea.
Los dos entornos solo se pueden comparar por separado
Ambos entornos muestran la misma tendencia: max obtiene una puntuación más alta y cuesta aproximadamente 3 veces más que high. Esto sirve como corroboración de la tendencia. Sin embargo, AA y Cursor utilizan tareas, métodos de puntuación y cálculos de costes distintos, así que no se deben combinar el 65 de AA y el 60.0 % de Cursor para calcular una única tasa de respuestas correctas.
4. Elige el nivel de Fable 5.2 según la tarea
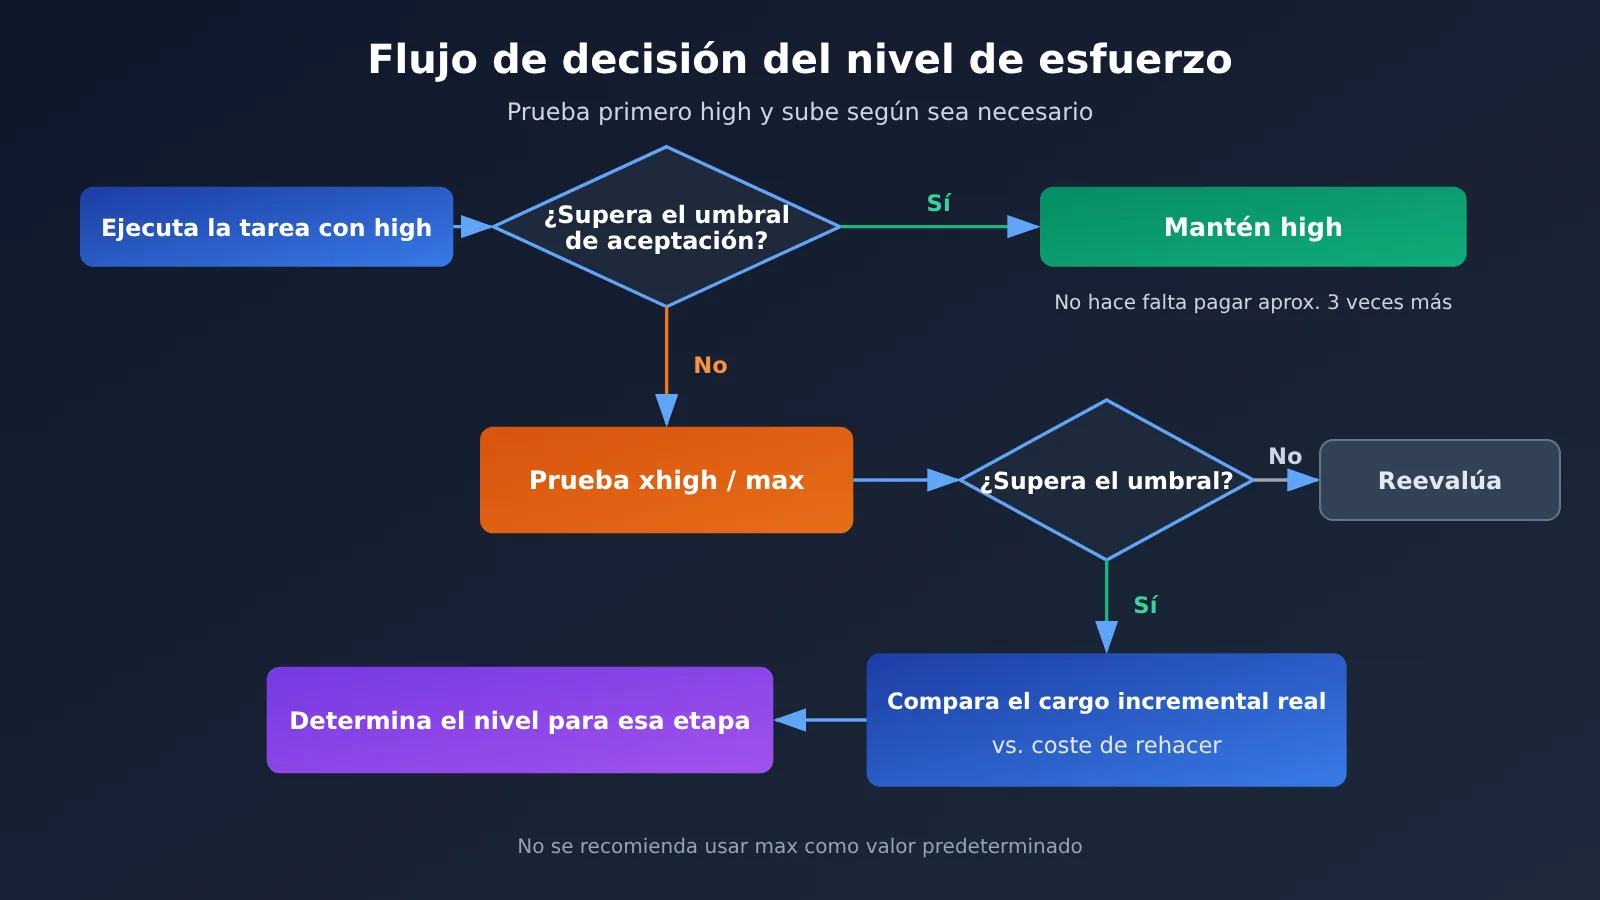
La guía oficial de indicaciones propone una lógica inicial: empieza con high en la API y sube o baja según los resultados de tus evaluaciones. medium está más orientado a escenarios interactivos; reserva xhigh para tareas difíciles y largas en las que se haya demostrado que aporta un beneficio adicional. Usa max para evaluar el límite de capacidad o en las pocas tareas en las que el tiempo y los tokens no sean importantes. Ten en cuenta que los niveles bajos también conllevan el riesgo de que la tarea termine antes de tiempo.
Tabla de recomendaciones para distintos escenarios de Fable 5.2
Los tres escenarios siguientes son hipotéticos y sirven para ilustrar cómo elegir.
| Escenario hipotético | Punto de partida recomendado | Cuándo considerar subir de nivel | Qué no se recomienda |
|---|---|---|---|
| Cambio de requisitos (modificar campos, ajustar interfaces, añadir pruebas) | Evaluar con medium y, si hace falta, usar high |
medium termina antes de tiempo o pasa por alto cambios |
Usar max por defecto para cambios pequeños |
| Corrección compleja (errores que afectan a varios módulos, problemas de concurrencia) | high |
La tasa de éxito de high no alcanza el umbral de aceptación |
Pasar directamente a xhigh sin validarlo |
| Investigación prolongada (preguntas abiertas, exploración de soluciones) | Empezar con high |
La pregunta tiene mucho valor, el costo de fallar es alto y las evaluaciones ya han demostrado que max aporta beneficios |
Configurar max como predeterminado para todas las solicitudes |
Cuándo elegir Fable 5.2 high
- Para la mayoría de las tareas de API que requieren un razonamiento sólido y tienen criterios de aceptación claros.
- Si el equipo aún no cuenta con un sistema para evaluar los niveles y necesita un punto de partida recomendado oficialmente.
- Para flujos de producción con muchas solicitudes y en los que el costo por tarea es importante.
Cuándo elegir Fable 5.2 max
- Para evaluar el límite de capacidad del modelo en un tipo de problema.
- Para unas pocas preguntas abiertas en las que el costo de fallar sea muy superior al costo del modelo.
- Cuando tus propias muestras hayan demostrado que
maxpuede elevar la tasa de éxito por encima del umbral y quehighno lo consigue.
🎯 Recomendación técnica: elige el nivel según las categorías de tareas; no hace falta decidirlo para cada solicitud. La mejor práctica recomendada oficialmente es empezar con
highen un conjunto representativo de tareas. Si planeas integrar todo mediante la API de APIYI (apiyi.com), confirma en la plataforma, antes de iniciar la ejecución formal, el ID del modelo, el grupo, el endpoint y los niveles de esfuerzo disponibles ese día.
5 Decide con tus propios criterios de aceptación si actualizar Fable 5.2 a max
Las evaluaciones públicas solo sirven para ver tendencias. Para decidir si te conviene actualizar, debes basarte en los resultados de tus propias pruebas de aceptación. Puedes usar directamente la siguiente lista de registro. El principio clave es cambiar solo una variable cada vez: el nivel de esfuerzo.
| Elemento que registrar | Requisito |
|---|---|
| Tareas y entradas | El mismo conjunto de tareas, las mismas entradas y la misma indicación del sistema |
| Permisos de herramientas | El conjunto de herramientas y los permisos deben ser idénticos |
| Modelo y nivel de esfuerzo | Registra el ID del modelo y el nivel de esfuerzo; cambia solo el nivel en cada ronda |
| Criterios de aprobación | Define de antemano los umbrales de aceptación; no los ajustes después de ver los resultados |
| Uso | Registra por separado las entradas, las escrituras y lecturas de caché y las salidas |
| Duración y reintentos | Registra la duración total, el número de reintentos y cuántas veces se finalizó antes de tiempo |
| Importe cobrado | Toma como referencia el importe cobrado que aparece en los registros de la plataforma; no lo sustituyas por una estimación basada en las tarifas oficiales |
| Casos fallidos | Conserva las salidas originales y analiza qué problemas resolvió max |
Primeros pasos con Fable 5.2: registra primero el usage
Este ejemplo mínimo solo muestra cómo realizar una llamada y registrar el usage. Este artículo no incluye cómo pasar el parámetro effort: para saber si Fable 5.2 ya está disponible en la plataforma y si se puede pasar effort, consulta la documentación vigente de la plataforma.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz compatible con OpenAI de APIYI
)

resp = client.chat.completions.create(
    model="YOUR_MODEL_ID",  # Introduce el ID del modelo que la plataforma confirme como disponible ese día
    messages=[{"role": "user", "content": "按验收标准修复以下函数……"}]
)
print(resp.usage)  # Registra el usage para conciliarlo más adelante
Ver el código completo para registrar datos y conciliarlos
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Tarifas estándar oficiales de Anthropic (USD por millón de tokens); solo sirven como estimación y no representan el cargo real
RATE_IN, RATE_OUT = 8.0, 40.0

def run_task(task_id: str, prompt: str, model: str, effort_label: str, passed_fn):
    """Ejecuta una tarea y devuelve un registro de aceptación. effort_label es solo una etiqueta para el registro."""
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}]
    )
    text = resp.choices[0].message.content
    u = resp.usage
    est_usd = u.prompt_tokens / 1e6 * RATE_IN + u.completion_tokens / 1e6 * RATE_OUT
    return {
        "task_id": task_id,
        "model": model,
        "effort": effort_label,
        "passed": passed_fn(text),          # Función de aceptación definida de antemano
        "prompt_tokens": u.prompt_tokens,
        "completion_tokens": u.completion_tokens,
        "est_usd": round(est_usd, 4),       # Valor estimado
        "seconds": round(time.time() - start, 1),
        "output": text,                     # Conserva el texto original de los casos fallidos
    }

def quota_to_usd(quota: int) -> float:
    """En los registros de la plataforma, quota ÷ 500000 equivale al cargo real en USD."""
    return quota / 500000
La documentación de registros de APIYI enumera campos como model_name, prompt_tokens, completion_tokens, quota, duration_for_view y request_id. quota ÷ 500000 equivale al cargo real en USD, y el campo other contiene información adicional, como los multiplicadores por grupo. Al vincular los registros de aceptación con los registros de la plataforma mediante request_id, puedes calcular el gasto real de las «tareas aprobadas» en lugar de fijarte solo en el coste de cada llamada.
🚀 Inicio rápido: Si primero quieres validar el flujo con una muestra pequeña, regístrate en APIYI, en apiyi.com, y usa el crédito gratuito de prueba para nuevos usuarios. Así podrás probar el método de registro «misma tarea, una sola variable, cargo real» antes de ampliar la muestra.
El criterio final es: primero comprueba si high alcanza el umbral de calidad. Si lo alcanza, no hace falta pagar alrededor de 3 veces más por esos pocos puntos porcentuales adicionales. Solo si high no llega al umbral y max sí lo consigue, compara el coste adicional de max con el coste de los fallos o del trabajo repetido. No se recomienda establecer max como valor predeterminado para todas las solicitudes.
Preguntas frecuentes
P1: ¿Qué niveles de effort tiene Claude Fable 5.2?
Effort es un ajuste que controla cuánto esfuerzo dedica el modelo a pensar. Los niveles disponibles van de low a max. No cambia el precio por token, sino la cantidad de razonamiento, el número de pasos, el tiempo y el uso de tokens. Por eso, el costo de una misma tarea puede variar varias veces según el nivel. El nivel predeterminado de la API es high.
P2: ¿Qué diferencia hay entre Fable 5.2 high y max?
En CursorBench 4.0, high obtuvo un 56,9 % con un costo de 9,70 dólares, mientras que max obtuvo un 60,0 % con un costo de 32,79 dólares. La diferencia es de 3,1 puntos porcentuales y el costo es aproximadamente 3,38 veces mayor. En AA, high obtuvo 62 con un costo de 9,08 dólares, y max obtuvo 65 con un costo de 26,54 dólares; el costo es aproximadamente 2,92 veces mayor. Los datos de cada conjunto solo se pueden comparar dentro de su propio entorno.
P3: ¿De cuándo son estos datos? ¿Pueden cambiar?
Fable 5.2 se lanzó el 9 de noviembre de 2026. Los datos de este artículo son una captura consultada el 10 de noviembre. Las páginas de AA y Cursor se actualizan dinámicamente, así que las cifras pueden cambiar con versiones posteriores, cambios en los conjuntos de tareas o modificaciones en el algoritmo de costos. Al citarlas, indica la fecha de consulta.
P4: Extra High obtuvo una puntuación inferior a High. ¿Significa que no debería usarlo?
Este resultado corresponde únicamente a esta evaluación de CursorBench 4.0; no permite concluir que xhigh sea peor para todas las tareas. La recomendación oficial es reservar xhigh para tareas largas y difíciles en las que tus propias evaluaciones hayan confirmado que aporta una mejora. Si todavía no has comprobado que sea útil, no hace falta activarlo por defecto.
P5: ¿Cómo puedo comparar por API el costo de los distintos niveles de Fable 5.2?
Lo recomendable es usar el mismo conjunto de tareas, cambiar solo el nivel y registrar el usage y el importe real cobrado por la plataforma. Al usar la interfaz unificada de APIYI apiyi.com, puedes convertir el cargo real a dólares con `quota÷500000`, según los registros. Antes de empezar, confirma el ID del modelo, el grupo y la compatibilidad con effort que ofrece la plataforma ese día. Este artículo no incluye formas de transmisión que no se hayan verificado.
P6: ¿Qué limitaciones tienen los datos de las evaluaciones públicas?
CursorBench es una evaluación que realiza un proveedor de herramientas en su propio entorno, mientras que el índice AA es una puntuación compuesta ponderada. Ninguno de los dos equivale a la tasa de éxito de tu negocio, y una diferencia de unos 3 puntos porcentuales no basta para determinar si el resultado es significativo. Las opiniones del primer día en redes sociales pueden servir como pistas, pero las conclusiones definitivas deberían basarse en tus propias muestras de aceptación.
P7: Tras la rebaja del 20 % en la API, ¿sale rentable usar max?
No necesariamente. La rebaja solo supone un ahorro proporcional si el uso no cambia. El consumo de tokens y el número de pasos de max pueden superar en más de 3 veces los de high, así que el aumento de uso puede anular fácilmente la bajada del precio. Conviene comparar «el importe real cobrado por completar una tarea», no fijarse únicamente en el precio por unidad.
Fable 5.2 high y max: puntos clave
- El precio unitario no cambia, pero la factura sí:
effortmodifica la cantidad de razonamiento y los pasos necesarios. Con el mismo precio unitario, el costo de una tarea puede variar varias veces. - La API usa
highde forma predeterminada: la recomendación oficial es empezar conhighy ajustar el nivel según los resultados de tus propias evaluaciones. - Comparación en Cursor: pasar de
highamaxmejora 3,1 puntos porcentuales y multiplica el costo por aproximadamente 3,38. - Comparación en AA: el índice sube de 62 a 65 y el costo se multiplica por aproximadamente 2,92; 65 no es una tasa de acierto.
- No se deben combinar los entornos: los resultados de ambas evaluaciones solo se pueden comparar dentro de cada entorno; no se pueden combinar para obtener una puntuación común de relación costo-beneficio.
- Reserva
maxpara unas pocas tareas: úsalo para evaluar el límite de capacidad del modelo y para problemas abiertos de alto valor. - Valida con el importe realmente facturado: usa la misma tarea y cambia una sola variable; registra el uso y, si hace falta, consulta los registros de APIYI en apiyi.com para cuadrar los cargos.
Resumen
La elección entre high y max en Fable 5.2 se puede resumir en tres puntos:
- Distingue entre precio unitario y costo de la tarea: el nivel no cambia el precio unitario, sino la cantidad de recursos que se utilizan.
- Interpreta los datos dentro de cada entorno: tanto Cursor como AA muestran que
maxobtiene una puntuación ligeramente superior, con un costo de aproximadamente tres veces el dehigh, pero los resultados de ambos entornos no se pueden combinar. - Guíate por los criterios de aceptación: si
highcumple los requisitos, mantenlo. Compara el costo adicional con el costo de repetir el trabajo solo sihighno cumple ymaxsí.
Para la mayoría de los equipos, lo más prudente es empezar con high, definir categorías de tareas y registrar los criterios de aceptación. Después, se pueden seleccionar unas pocas tareas de alto valor y evaluar max por separado. APIYI en apiyi.com permite validar rápidamente tus propias muestras con una interfaz unificada y registros de invocaciones. Antes de ampliar el uso, confirma que el modelo y el nivel estén disponibles.
📚 Referencias
- Anuncio de Anthropic: alcance del lanzamiento de Fable y Mythos 5.2, y evaluación del proveedor
- Enlace:
anthropic.com/claude-fable-and-mythos-5-2 -
Nota: la fecha de lanzamiento es el 2026-11-09; incluye los criterios de medición de velocidad y una tabla de evaluaciones
-
Precios de Claude API: tarifas estándar oficiales
- Enlace:
platform.claude.com/docs/en/about-claude/pricing -
Nota: Fable 5.2 cuesta 8 / 40 dólares por millón de tokens de entrada / salida
-
Especificaciones del modelo Fable 5.2: contexto, límite de salida y nivel de esfuerzo predeterminado
- Enlace:
platform.claude.com/docs/en/models/fable-5-2/overview -
Nota: el pensamiento adaptativo está siempre activado; el valor predeterminado de la API es high
-
Guía de indicaciones para Fable 5.2: recomendaciones oficiales para elegir el nivel
- Enlace:
platform.claude.com/docs/en/build-with-claude/prompt-engineering/prompting-claude-fable-5-2 -
Nota: casos de uso de medium, high, xhigh y max
-
CursorBench 4.0: evaluaciones en cinco niveles dentro del entorno propio de Cursor
- Enlace:
prod.cursor.com/evals -
Nota: es una evaluación del propio proveedor de herramientas, no una repetición independiente de carácter general
-
Clasificación de modelos de Artificial Analysis: clasificación dinámica de una organización independiente
- Enlace:
artificialanalysis.ai/leaderboards/models -
Nota: Intelligence Index y costo por tarea
-
Metodología de evaluación de Artificial Analysis: composición de Intelligence Index v5.0.1
- Enlace:
artificialanalysis.ai/methodology/intelligence-benchmarking -
Nota: 9 evaluaciones; cada una de las cuatro categorías de capacidades representa el 25 %
-
Cómo compara Cursor la calidad de los modelos: artículo sobre la metodología de una versión anterior del benchmark
- Enlace:
prod.cursor.com/blog/cursorbench -
Nota: sirve únicamente para entender el planteamiento del diseño; no es aplicable a las conclusiones estadísticas de la versión 4.0
-
API de consulta de registros de APIYI: campos de registro y cálculo del importe cobrado
- Enlace:
docs.apiyi.com/api-capabilities/log-query - Nota:
quota÷500000equivale al importe cobrado en dólares
Autor: Equipo técnico de APIYI
Intercambio técnico: Puedes contactarnos desde la página de inicio de APIYI, apiyi.com. Encontrarás más recursos en el centro de documentación, docs.apiyi.com.