Nota del autor: una investigación de Stanford descubrió que el 44% de las conclusiones más difundidas sobre los LLM ya han quedado obsoletas y que su vida útil media es de solo 15.7 meses. Este artículo convierte el estudio en una lista de comprobación que los equipos de desarrollo pueden usar directamente para volver a evaluar sus opciones de modelos.
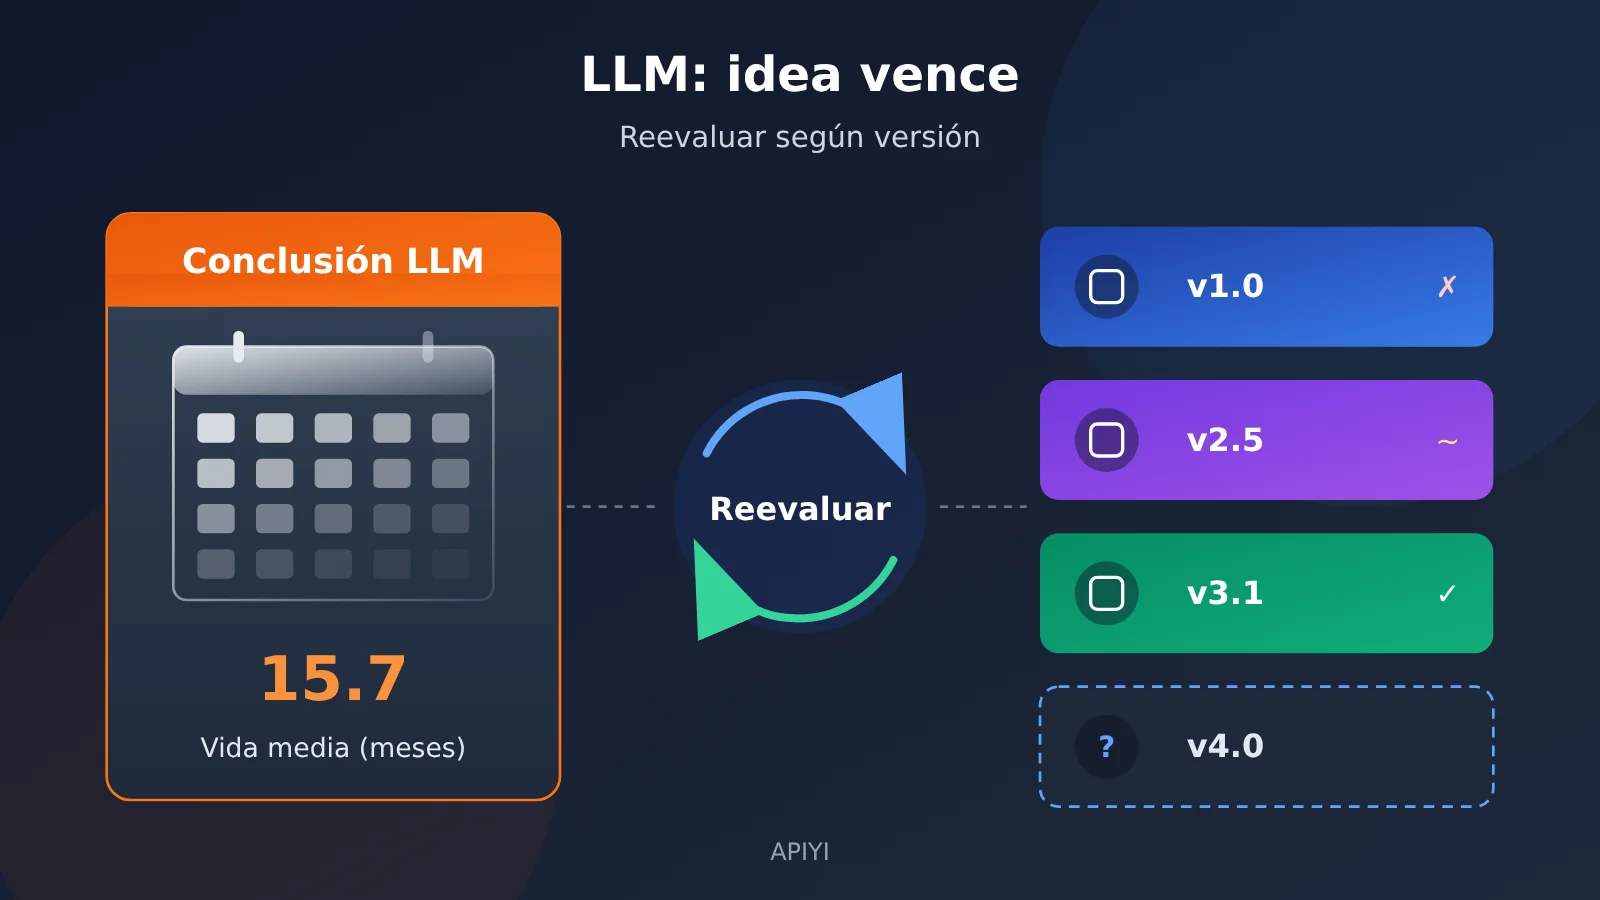
«Cierto modelo no sabe contar cuántas r hay en strawberry», «la información del centro de un contexto largo se pierde», «los modelos tienden a inventar referencias bibliográficas»: seguramente has escuchado estas afirmaciones una y otra vez en artículos, grupos técnicos y reuniones de selección de modelos. Los investigadores de Stanford Owen Queen y James Zou volvieron a examinar 50 conclusiones sobre LLM ampliamente citadas, utilizando 20 modelos, y descubrieron que el 44% ya habían quedado obsoletas y que aquellas cuya fecha de caducidad pudo estimarse solo se mantenían vigentes durante una media de 15.7 meses.
Esto no es otra reflexión genérica sobre cómo «los modelos son cada vez más capaces». El estudio aporta datos concretos: qué tipos de conclusiones caducan más rápido, cuáles duran más y qué diferencias hay entre modelos de una misma generación. En este artículo adaptaremos las recomendaciones que los investigadores dirigieron a la comunidad académica para convertirlas en un proceso que los equipos de desarrollo puedan seguir al elegir un modelo.
Valor principal: al terminar de leer, sabrás qué afirmaciones del tipo «los modelos no son buenos en X» son menos fiables y podrás adoptar un hábito de selección: registrar el nombre del modelo, la versión y la fecha; conservar la indicación; y repetir la prueba en el modelo que quieres evaluar.
Puntos clave del estudio sobre la caducidad de las conclusiones acerca de los LLM
Esta tabla resume las cifras más importantes del estudio. Los modelos analizados fueron publicados entre julio de 2024 y septiembre de 2026 por 8 desarrolladores distintos. La noticia sobre el estudio se publicó el 3 de noviembre de 2026.
| Punto clave | Datos del estudio | Qué implica para elegir un modelo |
|---|---|---|
| Proporción de conclusiones caducadas | De 50 conclusiones, el 44% había caducado y el 34% se había debilitado considerablemente | La mayoría de los defectos de los modelos que circulan por internet ya no pueden citarse sin más |
| Proporción que sigue vigente | Solo el 16% se mantenía y el 6% incluso se había reforzado | Conviene seguir de cerca algunas tendencias «persistentes» a largo plazo |
| Vida media | Entre las 22 conclusiones cuya fecha de caducidad podía estimarse, la media fue de 15,7 meses | Conviene tomar con cautela las conclusiones de evaluaciones realizadas hace más de un año |
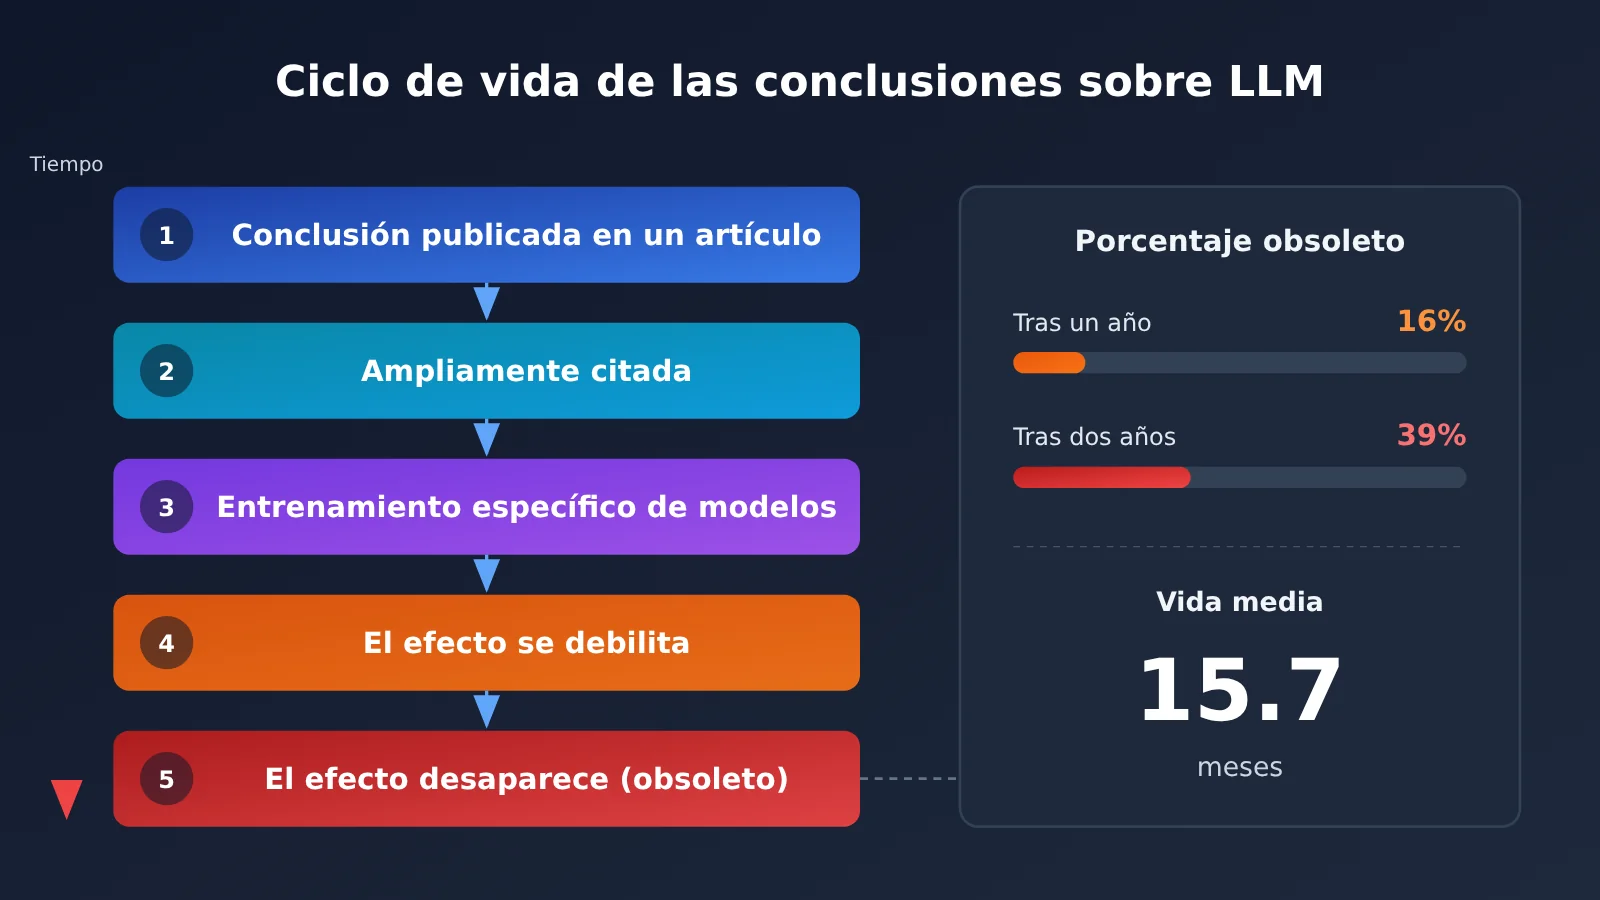
| Acumulación con el tiempo | El 16% había caducado al cabo de un año; a los dos años, la cifra subía al 39% | Cuanto más antigua sea una conclusión, más necesario es volver a ponerla a prueba |
| Diferencias entre modelos de la misma generación | En los modelos publicados entre julio y septiembre de 2026, el número de conclusiones caducadas variaba entre 11 y 30 | No se pueden deducir las capacidades de un modelo a partir de su fecha de lanzamiento |
Dos hallazgos clave sobre la caducidad de las conclusiones acerca de los LLM
El primer hallazgo tiene que ver con el significado de «caducar». En el estudio, una conclusión ha caducado cuando el efecto en el que se basaba prácticamente ha desaparecido en los modelos nuevos, no solo cuando ha mejorado en cierta medida. Otro 34% de las conclusiones se había «debilitado considerablemente»: el problema seguía ahí, pero era mucho menos grave de lo descrito en el artículo original. Sumadas ambas categorías, casi ocho de cada diez conclusiones ampliamente difundidas ya no pueden aplicarse tal cual a los modelos actuales.
El segundo hallazgo es que la «vida útil» de una conclusión está muy relacionada con su tipo. Las conclusiones sobre limitaciones de capacidad, que describen «qué no puede hacer» un modelo, son las que caducan más rápido. En cambio, las conclusiones sobre preferencias, que describen «cómo tiende a actuar» un modelo, duran más. Según los investigadores, esto se debe a que los errores de capacidad suelen tener una «respuesta correcta», lo que da a los desarrolladores un objetivo claro para optimizar el entrenamiento. Las preferencias y tendencias, por su parte, no tienen una respuesta estándar y, por eso, son más difíciles de «corregir».
Qué conclusiones sobre los LLM caducan más rápido
Entender el tipo de conclusión es el primer paso para decidir qué conviene volver a evaluar primero. A partir de lo publicado sobre la investigación, la siguiente tabla clasifica las conclusiones típicas en dos grupos: las que caducan fácilmente y las relativamente duraderas.
| Tipo de conclusión | Ejemplos típicos | Estado en el estudio | Prioridad de reevaluación |
|---|---|---|---|
| Deficiencias de razonamiento y capacidad | Contar las letras de strawberry, hacer operaciones en bases numéricas poco habituales, perder información situada en medio de un contexto largo, abandonar una respuesta correcta cuando el usuario la cuestiona | De 9 conclusiones sobre razonamiento, 5 quedaron obsoletas y ninguna se mantuvo ni se intensificó | Máxima: hay que volver a evaluarlas antes de citarlas |
| Veracidad y alucinaciones | Inventar referencias científicas | En algunos modelos se ha reducido casi a 0; en otros sigue siendo muy frecuente | Alta: las diferencias son enormes y hay que evaluar cada modelo por separado |
| Razonamiento combinatorio | Preguntas de dos pasos, «maldición de la inversión», respuestas contradictorias a pares de preguntas temporales | Se ha debilitado, pero sigue siendo detectable | Media-alta: el problema persiste, aunque su magnitud varía mucho |
| Preferencias al actuar como evaluador | Favorecer sus propias respuestas, dar puntuaciones similares a artículos aceptados y rechazados, dejarse influir por la forma en que están redactados los resúmenes médicos | Se mantienen o se intensifican | Media: es un riesgo a largo plazo, pero conviene comprobarlo periódicamente |
| Adulación y tendencia a complacer al usuario | Dar la razón al usuario y seguir su punto de vista | Representan una proporción considerable de las conclusiones que se mantienen o se intensifican | Media: prioritaria en aplicaciones de atención al cliente y asesoramiento |
| Tendencias en la distribución de las respuestas | Sesgo político hacia la izquierda, respuestas muy similares a preguntas abiertas, distribución desigual de los números aleatorios generados | Se mantienen o se intensifican | Media: hay que tenerlas en cuenta al generar contenido o realizar muestreos |
Cabe aclarar que, sobre las conclusiones relacionadas con el razonamiento, el cuerpo del artículo señala que «5 de 9 quedaron obsoletas y ninguna se mantuvo ni se intensificó», mientras que el pie de figura afirma que «las 9 se han atenuado». Al considerar ambas afirmaciones, la interpretación sería que 5 quedaron obsoletas y las demás también se debilitaron, sin que ninguna permaneciera igual. Como no pudimos consultar la lista completa de las 50 conclusiones ni los métodos de reevaluación del artículo original, la clasificación concreta debe verificarse en ese trabajo.
Por qué duran más las conclusiones sobre las preferencias de los LLM
De las 11 conclusiones que se mantuvieron o se intensificaron, 3 están relacionadas con los LLM como evaluadores y otras 3 con la adulación y la tendencia a complacer. Las restantes se refieren a la inclinación política, la similitud entre respuestas a preguntas abiertas y la distribución desigual de números aleatorios. Estos problemas comparten algo: es difícil definir cuál sería una respuesta «correcta» y, por tanto, también resulta difícil eliminarlos mediante un entrenamiento específico.
Para los equipos de desarrollo, esto implica una jerarquía de riesgos poco intuitiva. El conocido problema de que «el modelo no sabe contar letras» a menudo ya ha dejado de serlo, mientras que las tendencias sistemáticas menos evidentes son las que merecen más atención. Si usas un LLM para evaluar, puntuar o recomendar de forma automática, conviene incluir los problemas de preferencias en las pruebas de regresión habituales.
Las conclusiones sobre sesgos sociales en los LLM muestran resultados mixtos
Los investigadores señalan que las conclusiones sobre sesgos sociales no siguen todas la misma trayectoria. El sesgo político hacia la izquierda persiste, los estereotipos de género y los sesgos de asociación implícita se han debilitado y, en los datos de tendencias, el sesgo contra quienes hablan inglés afroamericano incluso ha invertido su dirección. Esto demuestra una vez más que cualquier afirmación general como «los modelos presentan determinado sesgo» solo cobra sentido cuando se refiere a un modelo y un momento concretos.
Por qué no se puede deducir el rendimiento de un LLM por su fabricante o fecha de lanzamiento
Al elegir un modelo, muchos equipos parten de una intuición sencilla: un modelo nuevo siempre será mejor que uno antiguo, los modelos de un mismo fabricante rendirán de forma parecida y un modelo grande será más fiable que uno pequeño. Los datos de la investigación contradicen directamente estas suposiciones.
El ejemplo más claro es la prueba de invención de referencias bibliográficas. En el estudio original de Walters y Wilder de 2023, GPT-3.5 inventó el 55% de las referencias. Los investigadores de Stanford probaron modelos actuales con las mismas indicaciones: GPT-6.1 Sol obtuvo un 0% y Claude Sonnet 5.5 un 1%, mientras que Qwen3.7-Flash, también lanzado en 2026, inventó el 69% de las referencias, incluso más que GPT-3.5 tres años antes.
Las diferencias entre modelos lanzados en un mismo periodo son igual de sorprendentes. Entre los publicados de julio a septiembre de 2026, el número de conclusiones «refutadas» osciló entre 11 para DeepSeek V4 Pro y 30 para GPT-6.1 Sol. El estudio señala expresamente que ni la fecha de lanzamiento, ni el fabricante, ni el tamaño del modelo permiten predecir este patrón de forma fiable.
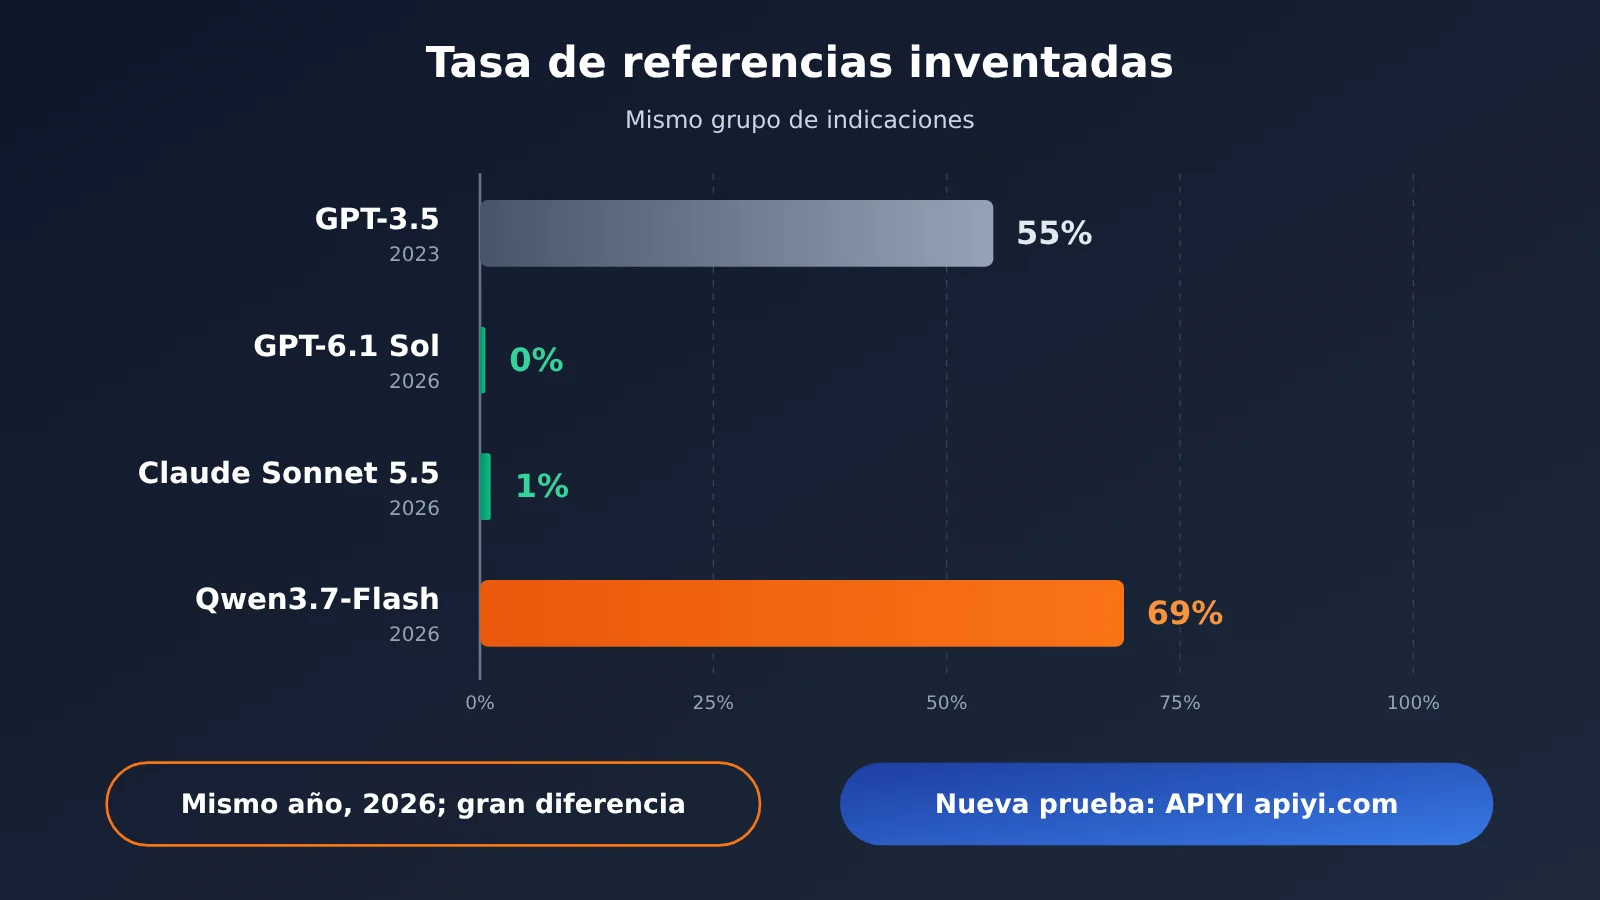
La idea central de esta comparación es que modelos de una misma época pueden situarse en extremos opuestos en una misma prueba. Si quieres reproducir este tipo de comparación dentro de tu equipo, puedes usar una plataforma de interfaz unificada como APIYI apiyi.com para probar el mismo conjunto de indicaciones en varios modelos candidatos. Consulta la lista oficial de la plataforma para conocer los modelos disponibles.
Los investigadores también advierten que una mejora no significa que «el problema esté completamente resuelto». En preguntas de dos pasos, que requieren combinar dos hechos conocidos, Claude Sonnet 5.5 seguía respondiendo mal alrededor del 10% de las preguntas combinadas, incluso cuando podía contestar correctamente cada una de las dos preguntas por separado. El artículo original reportaba un 43% para ChatGPT. La cifra ha bajado considerablemente, pero si tu negocio depende de combinar hechos en varios pasos, ese 10% todavía puede causar incidentes en producción.
Cómo empezar a reevaluar LLM para elegir uno: lista de 5 pasos
La recomendación de los investigadores para la comunidad académica es tratar las conclusiones empíricas sobre los LLM como «observaciones de un modelo concreto en un momento determinado», no como verdades universales. Los artículos deberían registrar el modelo, la versión y la fecha, además de publicar las indicaciones y el código de análisis para facilitar futuras reevaluaciones con otros modelos. Estas recomendaciones pueden aplicarse casi tal cual al proceso de selección de un equipo de desarrollo.
Paso 1: Añade metadatos a cada conclusión sobre un LLM
Ya sea que una conclusión provenga de un artículo académico, un blog, la experiencia de un colega o tus propias pruebas, primero completa los campos de la siguiente tabla. Una conclusión que carezca de datos clave solo puede considerarse una «pista pendiente de validar», no una base para tomar decisiones.
| Campo de metadatos | Qué registrar | Por qué es necesario |
|---|---|---|
| Nombre del modelo | Nombre completo del modelo, no «un modelo de tal empresa» | Los modelos de un mismo proveedor pueden ser muy diferentes |
| Versión específica | Número de versión o identificador de la instantánea | El rendimiento de un modelo puede cambiar tras una actualización, aunque conserve el mismo nombre |
| Fecha de la prueba | Fecha exacta, incluido el día | Permite valorar la antigüedad de la conclusión, tomando como referencia la vida útil media de 15,7 meses |
| Indicación completa | Indicación del sistema, entrada del usuario y ejemplos | Si se cambia la indicación, no se puede reproducir la prueba |
| Parámetros de invocación | Temperatura, longitud máxima de salida, etc. | Los parámetros de muestreo pueden afectar a las conclusiones sobre la estabilidad |
| Criterios de evaluación | Qué se considera un resultado satisfactorio y qué se considera un fallo | Sin ellos, no se pueden comparar las conclusiones de distintas personas |
| Tamaño de la muestra | Número de casos de prueba | Una captura de una sola conversación no permite estimar proporciones |
Paso 2: Prioriza las pruebas de los LLM según el tipo de conclusión
Cuando encuentres una conclusión, identifica primero a qué categoría pertenece. Considera que las conclusiones sobre deficiencias de capacidad —dificultad para contar, calcular o recordar, o cambiar de respuesta ante una objeción— probablemente ya estén desactualizadas y debes volver a ponerlas a prueba antes de citarlas. En cambio, considera que las conclusiones sobre preferencias y tendencias —preferencia por sí mismo, complacencia o respuestas demasiado parecidas— probablemente sigan vigentes e inclúyelas en las pruebas de regresión a largo plazo.
Ten en cuenta también la antigüedad de la conclusión: según los datos del estudio, si tiene más de un año, hay alrededor de un 16 % de probabilidad de que haya quedado desactualizada; si tiene más de dos años, la proporción sube al 39 %. Si el modelo al que se refiere ya ha sido sustituido por tu modelo candidato, vuelve a poner la conclusión a prueba, por conocida que sea.
Paso 3: Convierte las conclusiones en casos de prueba ejecutables para LLM
Una afirmación como «el modelo entiende mal los documentos largos» no se puede probar directamente: hay que convertirla en casos concretos. Por ejemplo, coloca un dato clave al principio, en medio y al final de un documento largo; luego haz una pregunta sobre cada ubicación y calcula el porcentaje de respuestas correctas. También puedes pedirle primero al modelo una respuesta correcta, simular después una objeción del usuario y medir con qué frecuencia cambia de respuesta.
Al diseñar los casos, intenta que se parezcan lo más posible a tus datos reales de negocio, en lugar de limitarte a reutilizar los ejemplos simplificados del estudio. Es muy posible que distintos proveedores ya hayan entrenado específicamente sus modelos con los problemas clásicos que el estudio considera «desactualizados». Superarlos no garantiza que el modelo también funcione bien con tus datos de negocio.
Paso 4: Repite las pruebas con el mismo conjunto de indicaciones en todos los LLM candidatos
La clave de la repetición de pruebas es controlar las variables: usa el mismo conjunto de indicaciones, los mismos parámetros y los mismos criterios de evaluación, y cambia solo el modelo. Si hay que integrar un SDK y gestionar la autenticación por separado para cada modelo, el costo de repetir las pruebas puede ser tan alto que el equipo prefiera no hacerlo.
🚀 Consejo práctico: APIYI apiyi.com utiliza el estándar unificado de la API de OpenAI y permite invocar más de 200 modelos con un solo token. Para cambiar de modelo candidato, solo hay que modificar el parámetro model y mantener las mismas indicaciones y parámetros. Esto resulta práctico para hacer comparativas de este tipo. Consulta la lista oficial de modelos de la plataforma para conocer los modelos y las versiones disponibles.
Paso 5: Crea un registro de conclusiones sobre los LLM y revísalo periódicamente
Guarda los resultados de cada nueva prueba en un «registro de conclusiones» que incluya, como mínimo, la conclusión original, los metadatos, los resultados de la prueba y la fecha de la próxima revisión. Tomando como referencia la vida útil media de 15,7 meses, conviene revisar cada trimestre o cada semestre las conclusiones de las que dependen procesos clave del negocio. Si planeas actualizar la versión de un modelo, realiza siempre una nueva prueba completa.
| Escenario | Alcance recomendado de las pruebas | Momento |
|---|---|---|
| Selección inicial | Todas las conclusiones que influyen en la decisión + casos de uso clave del negocio | Antes de la revisión para la selección |
| Actualización de la versión del modelo | Todos los casos de prueba de regresión | Antes de implementar el cambio en producción |
| Cita de conclusiones externas | Solo las conclusiones pertinentes | Antes de incluirlas en el documento de la propuesta |
| Operación habitual | Tendencias de preferencia + casos de uso de alto riesgo | Cada trimestre o semestre |
| Anomalías en producción | Capacidades relacionadas con la anomalía | De inmediato |
💡 Consejo para elegir: al seleccionar un modelo, no empieces preguntándote «¿cuál es el más potente?». Primero identifica qué tipo de error sería más perjudicial para tu negocio y después repite las pruebas específicas en los modelos candidatos. Con la interfaz unificada de APIYI apiyi.com, puedes comparar varios modelos candidatos dentro de un mismo flujo de pruebas y reducir las variables adicionales derivadas de la integración.
Preguntas frecuentes FAQ
P1: ¿Qué significa que una conclusión sobre los LLM haya «quedado obsoleta»?
En este estudio de Stanford, significa que el efecto detrás de una conclusión empírica sobre los LLM prácticamente ha desaparecido en los modelos más recientes. Esto es distinto de un efecto «atenuado», que sigue presente, pero con mucha menor intensidad. De las 50 conclusiones, el 44% quedó obsoleto y el 34% se atenuó.
P2: ¿En qué se diferencian las conclusiones sobre limitaciones de capacidad de las que tratan sobre preferencias?
Las primeras describen «qué no puede hacer» un modelo, como contar letras, realizar operaciones aritméticas o recuperar información en contextos largos. Tienen respuestas correctas claras y son más fáciles de corregir mediante entrenamiento específico, por lo que quedan obsoletas más rápido. Las segundas describen «cómo tiende a actuar» el modelo, por ejemplo, si favorece sus propias respuestas o halaga al usuario. Como no hay una respuesta estándar, estas tendencias persisten más tiempo.
P3: ¿Cuándo se publicó el estudio sobre la vigencia de las conclusiones sobre los LLM?
La noticia se publicó el 3 de noviembre de 2026. El estudio evaluó 20 modelos de 8 desarrolladores, publicados entre julio de 2024 y septiembre de 2026. Como los modelos evolucionan rápidamente, los datos concretos citados en este artículo también pueden perder vigencia. Conviene consultar el artículo original antes de utilizarlos.
P4: ¿Qué equipos necesitan volver a probar los LLM con cada versión?
Principalmente, los que se encuentran en estas situaciones:
– **Equipos que están seleccionando o cambiando de modelo**: para no descartar candidatos por impresiones sobre defectos de hace dos años
– **Equipos que usan LLM para evaluar y puntuar**: las tendencias a favorecer sus propias respuestas o dejarse influir por la redacción siguen presentes
– **Aplicaciones sensibles a la precisión factual**: la tasa de referencias inventadas oscila entre el 0% y el 69% en modelos de una misma generación
– **Productos conversacionales de atención al cliente o asesoría**: las tendencias a halagar y complacer al usuario requieren seguimiento continuo
P5: ¿Cómo se pueden repetir las pruebas en varios LLM a bajo costo?
La clave es unificar la capa de acceso para que resulte sencillo «cambiar solo el modelo y mantener las demás variables»:
1. Visita APIYI apiyi.com, crea una cuenta y obtén una clave API
2. Confirma en la lista oficial de modelos que los candidatos y las versiones estén disponibles
3. Usa el mismo conjunto de indicaciones y parámetros, modifica únicamente el parámetro model en cada invocación y registra los resultados y metadatos
Así podrás concentrarte en diseñar los casos de prueba, en lugar de integrar una y otra vez las interfaces de distintos proveedores.
P6: ¿Se pueden usar las puntuaciones de las clasificaciones de modelos nuevos en lugar de repetir las pruebas?
No conviene depender por completo de ellas. El estudio muestra que ni la fecha de publicación, ni el proveedor, ni el tamaño permiten predecir de forma fiable cómo se comportará un modelo respecto a una conclusión concreta. Incluso entre modelos publicados en fechas cercanas hay grandes diferencias. Las clasificaciones sirven para hacer una selección inicial, pero la decisión final debe basarse en pruebas repetidas con datos de tu propio negocio.
P7: ¿Qué limitaciones tiene este estudio sobre los LLM?
En primer lugar, para consultar la lista completa de las 50 conclusiones y los métodos de reevaluación hay que acudir al artículo original: las fuentes secundarias no cubren todos los detalles. Además, en la cobertura del estudio hay diferencias entre el texto principal y los pies de figura sobre las conclusiones relacionadas con el razonamiento, por lo que conviene remitirse al original. Por último, los resultados también son observaciones sobre «modelos específicos en un momento específico» y, según la lógica de los propios investigadores, también quedarán obsoletos con el tiempo.
Conclusiones de LLM obsoletas: puntos clave
- Alta proporción de conclusiones obsoletas: de 50 conclusiones populares sobre LLM, el 44% ha quedado obsoleto y el 34% se ha debilitado de forma notable.
- Vida útil corta: las conclusiones cuya duración puede estimarse se mantienen vigentes una media de 15,7 meses; casi cuatro de cada diez quedan obsoletas al cabo de dos años.
- Las deficiencias de capacidad caducan antes: conviene reevaluar primero afirmaciones sobre el conteo de letras, la aritmética o la pérdida de información en contextos largos.
- Las tendencias de preferencia perduran más: la preferencia por sí mismo, la adulación y la similitud entre respuestas deberían incluirse en pruebas de regresión a largo plazo.
- No basta con fijarse en el proveedor o la fecha: entre modelos de 2026, la tasa de invención de referencias oscila entre el 0% y el 69%.
- Los metadatos son imprescindibles: sin el nombre del modelo, la versión, la fecha o la indicación, es difícil reproducir una conclusión.
- Una interfaz unificada reduce el costo de reevaluación: con APIYI apiyi.com se pueden hacer comparaciones entre modelos cambiando solo el parámetro
model.
Resumen
Las conclusiones sobre los LLM quedan obsoletas, en promedio, a los 15,7 meses. Estos datos nos recuerdan que:
- Las conclusiones tienen fecha de caducidad: cualquier afirmación sobre un LLM debe considerarse «una observación sobre un modelo concreto en un momento determinado».
- El tipo de conclusión determina la prioridad: conviene volver a evaluar primero las limitaciones de capacidad y monitorear las tendencias y preferencias a largo plazo.
- La versión lo determina todo: ni el proveedor, ni la fecha de lanzamiento, ni el tamaño del modelo sustituyen las pruebas de una versión concreta.
La próxima vez que escuches en una reunión de selección «ese modelo no es bueno para X», prueba a hacer tres preguntas: ¿qué versión? ¿Cuándo se probó? ¿Todavía tienen la indicación? Si nadie puede responder, añádelo a la lista de nuevas pruebas.
Recomendamos integrar los modelos candidatos en un mismo proceso de pruebas mediante APIYI apiyi.com y utilizar el mismo conjunto de indicaciones para volver a evaluarlos rápidamente. Consulta la lista oficial para conocer los modelos disponibles.
📚 Referencias
- THE DECODER – Rapid LLM development is outrunning the research meant to explain it, study finds: artículo sobre el estudio de Stanford acerca de la caducidad de las conclusiones sobre los LLM
- Enlace:
the-decoder.com/rapid-llm-development-is-outrunning-the-research-meant-to-explain-it-study-finds -
Descripción: incluye datos clave, como el 44 % de conclusiones obsoletas, la vida media de 15,7 meses, los casos de referencias inventadas y las diferencias entre modelos de una misma generación.
-
Artículo original de Owen Queen y James Zou: estudio en el que investigadores de Stanford volvieron a evaluar 50 conclusiones sobre los LLM
- Enlace: busca los nombres de los autores y el título del artículo en una plataforma de búsqueda académica.
- Descripción: no se pudo acceder al texto completo del artículo original. Consulta la fuente para conocer la lista de las 50 conclusiones y la metodología de reevaluación.
Autor: Equipo técnico de APIYI
Intercambio técnico: contáctanos a través de la página principal de APIYI apiyi.com. Encontrarás más información sobre la integración de modelos en el centro de documentación docs.apiyi.com.