Nota del autor: este artículo explica cómo enviar la primera solicitud a Gemini 4 Neon usando dos protocolos en APIYI, y qué campos y registros conviene revisar cuando la solicitud se complete correctamente.
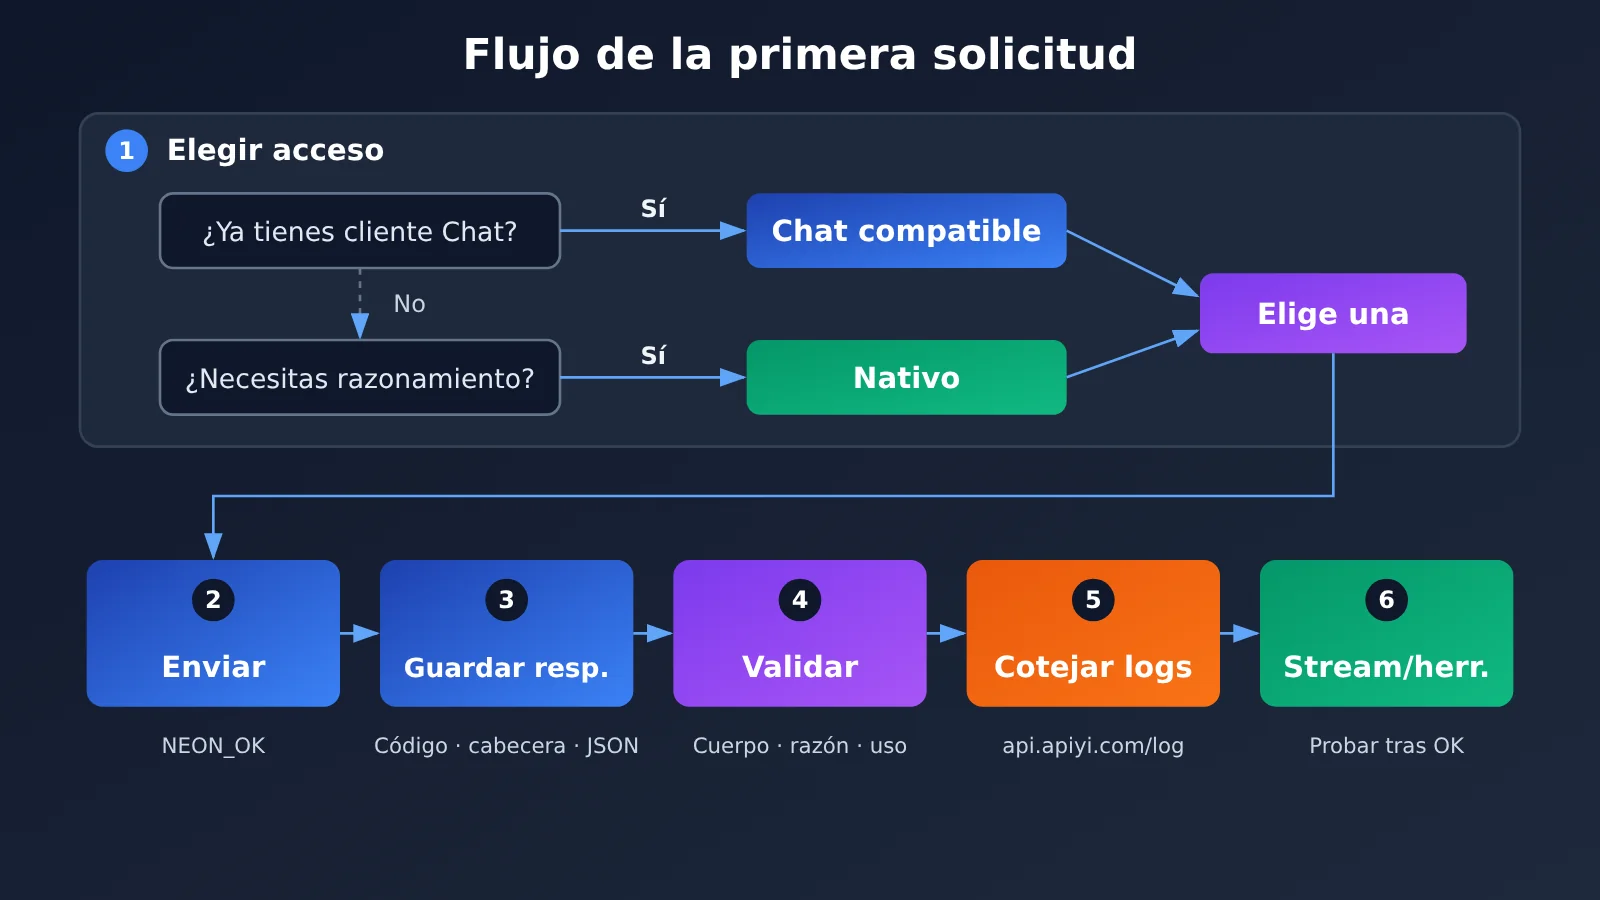
Conclusión primero: si tu proyecto ya cuenta con un cliente OpenAI Chat, usa la entrada Chat Completions compatible con OpenAI; solo tienes que cambiar base_url y el nombre del modelo. Si necesitas definir explícitamente el nivel de pensamiento de Gemini, usa la entrada nativa generateContent de Gemini y especifícalo en generationConfig.thinkingConfig.thinkingLevel. Elijas el camino que elijas, primero prueba texto plano con una misma indicación breve y luego valida según el estado HTTP, el cuerpo de la respuesta, el motivo de finalización, el consumo y los registros de la plataforma. Cuando la validación pase, podrás probar la salida en streaming, las llamadas a herramientas y otras capacidades.
Los antecedentes son los siguientes. Google publicó Gemini 4 Neon en el registro de cambios de AI Studio del 18 de noviembre de 2026 y anunció su disponibilidad general (GA). APIYI confirmó su disponibilidad el 20 de noviembre de 2026 a las 11:45, hora de Beijing; en el catálogo público de precios aparece gemini-4-neon, y los grupos disponibles son default y svip. Los ejemplos de este artículo se elaboraron según la documentación de APIYI y la documentación del SDK; no se invocó ningún endpoint de pago y el texto tampoco incluye estadísticas de pruebas reales.
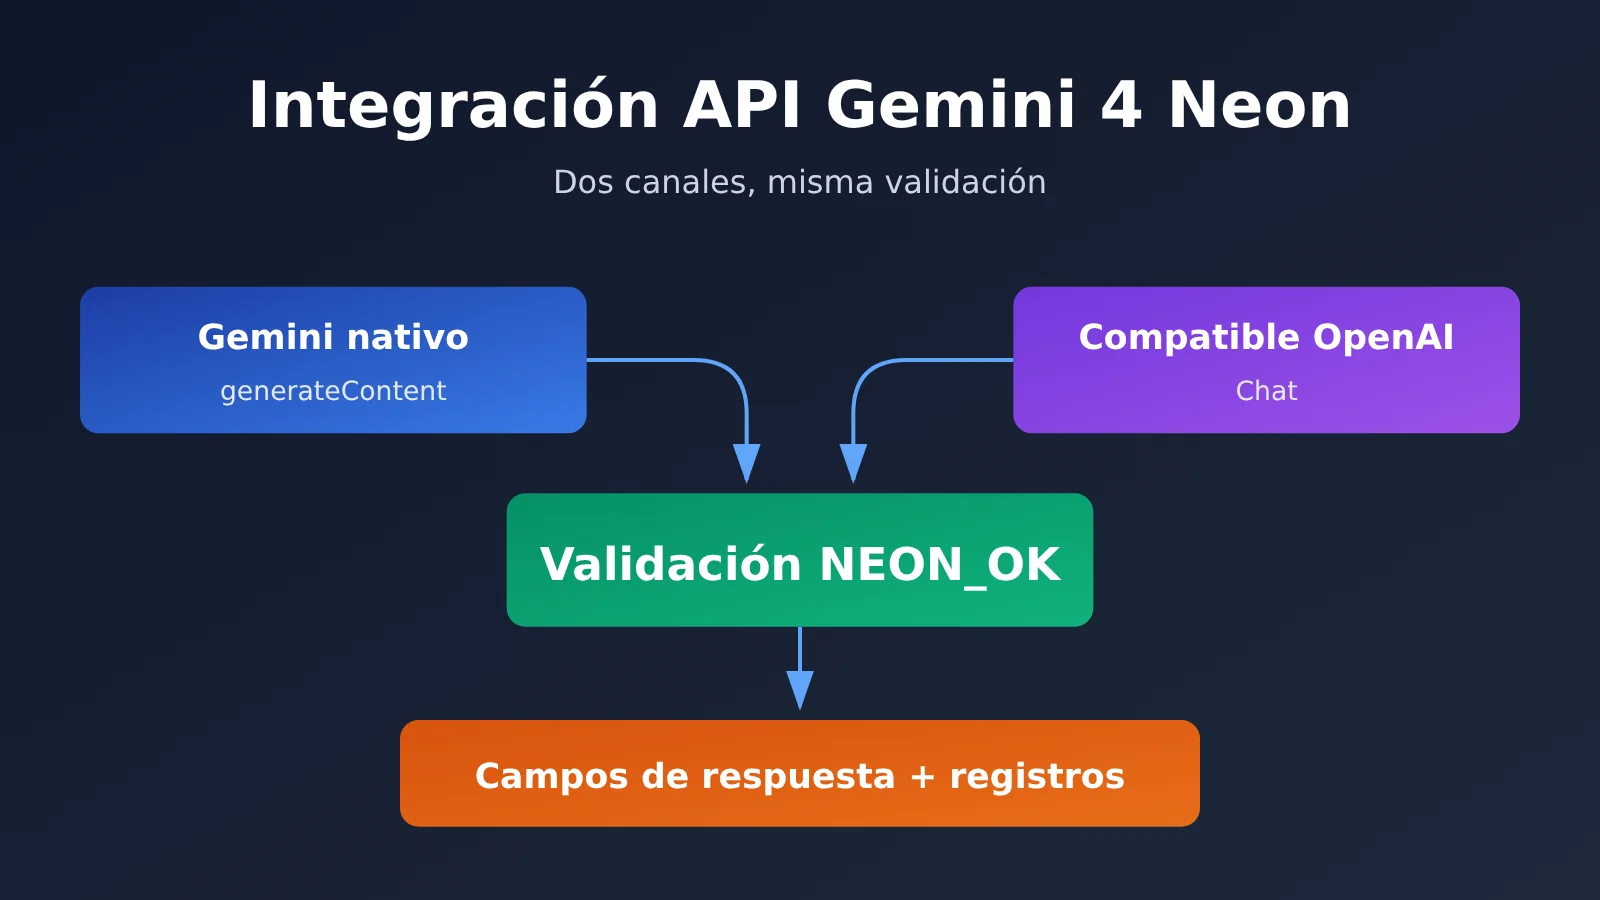
Mapa de conocimiento e índice para la integración de la API de Gemini 4 Neon
Todo el proceso de integración se divide en tres pasos: elegir la interfaz, enviar la petición y verificar la salida y los registros. Lo que produce cada paso es la entrada del siguiente. La tabla a continuación reúne la relación de orden entre estos tres pasos, la razón de esa disposición y el objetivo que debe alcanzar cada uno; puedes usarla como mapa de conocimiento o como índice de lectura.
| Nº | Paso | Qué aporta el paso anterior | Por qué se ordena así | Objetivo de este paso |
|---|---|---|---|---|
| 1 | Elegir la entrada (1.1 Compatible con Chat / 1.2 Nativa y nivel de razonamiento) | Tu stack de código actual y la necesidad de niveles de razonamiento | La entrada determina la URL, la forma de autenticación y la estructura de campos; todos los pasos posteriores dependen de ella | Fijar un único protocolo para no depurar dos caminos al mismo tiempo |
| 2 | Enviar la misma petición corta (2.1 cURL nativo / 2.2 SDK de Python) | La entrada ya definida y el formato de la petición | Con una indicación corta y fija se descartan las diferencias de capacidad del modelo y se comprueba solo si el enlace funciona | Obtener el código de estado, las cabeceras y el cuerpo de la respuesta completos |
| 3 | Verificación (3.1 Campos / 3.2 Identidad y registros / 3.3 Evidencia en caso de fallo) | La respuesta original guardada en el paso 2 | Primero se mira la propia respuesta y luego se contrasta con los registros de la plataforma: la evidencia va de lo más cercano a lo más lejano | Determinar si se cumple el «éxito de texto»; si no, dejar evidencia rastreable |
Consejo de lectura: si solo usas uno de los dos protocolos, después de leer la subsección correspondiente de la sección 1, ve directamente a 2.1 o a 2.2; la sección 3 conviene leerla completa.
To Know: Términos imprescindibles de la API de Gemini 4 Neon
| Término | Explicación breve |
|---|---|
generateContent |
Interfaz de generación no en streaming nativa de Gemini; en el cuerpo de la petición el contenido se organiza con contents y parts |
thinkingLevel |
Campo de nivel de razonamiento dentro de generationConfig.thinkingConfig de la interfaz nativa; en los ejemplos de este artículo se usa high |
| thought part | La part de la respuesta nativa marcada como contenido de razonamiento; hay que excluirla al concatenar el texto principal |
finishReason / finish_reason |
Campo de motivo de detención de la interfaz nativa y de la compatible, respectivamente |
X-Shellapi-Request-Id |
Identificador de petición que APIYI devuelve en las cabeceras originales de la respuesta o en el mensaje de error, útil para diagnóstico |
1 Cómo elegir el punto de entrada para la API de Gemini 4 Neon
Los dos puntos de entrada apuntan al mismo modelo; la diferencia está en la forma del protocolo y en los parámetros que puedes controlar. Primero verás una comparación y, después, dos subsecciones con los motivos para elegir cada opción.
| Elemento de comparación | Chat compatible con OpenAI | Gemini nativo |
|---|---|---|
| Dirección | https://api.apiyi.com/v1 + Chat Completions |
https://api.apiyi.com/v1beta/models/gemini-4-neon:generateContent |
| Para quién | Proyectos que ya tienen un SDK de OpenAI o un cliente Chat | Proyectos que necesitan controlar parámetros de Gemini de forma explícita |
| Nivel de pensamiento | En este artículo no se envían parámetros relacionados | thinkingConfig.thinkingLevel |
| Ubicación del cuerpo | choices[0].message.content |
El text que no sea thought dentro de candidates[0].content.parts |
| Identificador del modelo | El model de la respuesta |
El modelVersion de la respuesta (si se devuelve) |
1.1 Entrada compatible de Gemini 4 Neon: reutilizar el cliente Chat existente
Cuando tu código ya se basa en el SDK de Python de OpenAI o en otro cliente de Chat Completions, el cambio mínimo consiste en reemplazar base_url por https://api.apiyi.com/v1 y escribir el nombre del modelo como gemini-4-neon, sin tocar la estructura de los mensajes. La ventaja es que el código de la capa de negocio casi no necesita modificarse y, si surge un problema, también resulta más fácil determinar si está en la red, en la autenticación o en el modelo.
Hay varios límites que conviene aclarar al usar esta vía. Primero, no envíes reasoning_effort. La propia capa de compatibilidad de Google lo mapea, pero eso no significa que el punto de entrada compatible de APIYI haya asumido el mismo compromiso. Segundo, este artículo no utiliza la interfaz /v1/responses. Tercero, la antigua forma de thinkingBudget y el nivel minimal tampoco están dentro del alcance de este artículo. Si realmente necesitas controlar el nivel de pensamiento, usa el punto de entrada nativo de 1.2.
1.2 Entrada nativa de Gemini 4 Neon: establecer explícitamente el nivel de pensamiento
El punto de entrada nativo utiliza la estructura de solicitud propia de Gemini. El nivel de pensamiento se pasa de forma explícita mediante generationConfig.thinkingConfig.thinkingLevel; el valor usado en el caso específico de APIYI es "high". La respuesta nativa también separa el contenido de pensamiento y el cuerpo en partes distintas, así que al leer el cuerpo hay que filtrar de forma activa; la sección 2.1 muestra cómo hacerlo.
En cuanto a la autenticación, este caso nativo utiliza la cabecera Authorization: Bearer y no la forma habitual de Gemini oficial de pasar la clave mediante el parámetro key. Al migrar código nativo existente, primero revisa este punto.
2 Enviar la misma solicitud breve a la API Gemini 4 Neon
Ambos protocolos usan la misma indicación: Reply with exactly NEON_OK and nothing else. Esta indicación tiene una salida esperada muy corta y el resultado es fácil de evaluar. Si la respuesta no es NEON_OK, significa que hay un problema en la ruta de la solicitud o en el procesamiento de la respuesta, y puedes descartar interferencias como «diferencias en el estilo de respuesta del modelo». La clave API siempre se lee de la variable de entorno APIYI_API_KEY; no la escribas en el código ni en el historial de comandos.
2.1 cURL nativo de Gemini 4 Neon y extracción de valores JSON
El siguiente comando guarda por separado el código de estado HTTP, los encabezados de respuesta y el cuerpo JSON de la respuesta; los tres se usarán en la validación de la sección 3.
curl -sS -X POST "https://api.apiyi.com/v1beta/models/gemini-4-neon:generateContent" \
  -H "Authorization: Bearer ${APIYI_API_KEY}" \
  -H "Content-Type: application/json" \
  -D neon_native_headers.txt \
  -o neon_native_body.json \
  -w "%{http_code}\n" \
  -d '{
    "contents": [
      {"role": "user", "parts": [{"text": "Reply with exactly NEON_OK and nothing else."}]}
    ],
    "generationConfig": {
      "thinkingConfig": {"thinkingLevel": "high"}
    }
  }' > neon_native_status.txt
Al leer el cuerpo, hay que concatenar todos los text de candidates[0].content.parts que no sean thought; no basta con tomar solo el primer elemento part. El siguiente ejemplo usa jq; si no tienes jq instalado, puedes usar cualquier otra herramienta de análisis JSON:
# Cuerpo: concatenar los valores text que no sean thought
jq -r '[.candidates[0].content.parts[]? | select(.thought != true) | .text // empty] | join("")' neon_native_body.json

# Motivo de finalización, uso y versión del modelo (si un campo no existe, se muestra null; no rellenes valores por tu cuenta)
jq '{finishReason: .candidates[0].finishReason, usageMetadata, modelVersion}' neon_native_body.json

# Identificador de solicitud de la plataforma
grep -i "x-shellapi-request-id" neon_native_headers.txt
2.2 Llamada a Gemini 4 Neon con el SDK de OpenAI para Python y lectura de la respuesta
El endpoint compatible usa with_raw_response, de modo que obtienes tanto el objeto ya parseado como los encabezados de respuesta sin procesar. max_retries=0 sirve para desactivar los reintentos automáticos del SDK, evitando que un fallo quede enmascarado por un reintento y que en la plataforma aparezcan varios registros que impidan saber a qué solicitud corresponde cada uno.
import os
from openai import OpenAI, APIStatusError, APIConnectionError

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",  # Endpoint compatible con OpenAI de APIYI
    max_retries=0,
    timeout=120.0,
)

try:
    raw = client.chat.completions.with_raw_response.create(
        model="gemini-4-neon",
        messages=[{"role": "user", "content": "Reply with exactly NEON_OK and nothing else."}],
        max_tokens=4096,
    )
    print("HTTP:", raw.status_code)
    print("X-Shellapi-Request-Id:", raw.headers.get("x-shellapi-request-id"))

    completion = raw.parse()
    if not completion.choices:
        print("choices 为空,不读取正文")
    else:
        choice = completion.choices[0]
        print("content:", choice.message.content)
        print("finish_reason:", choice.finish_reason)
    print("usage:", completion.usage)
    print("model:", completion.model)

except APIStatusError as e:
    print("HTTP:", e.status_code)
    print("X-Shellapi-Request-Id:", e.response.headers.get("x-shellapi-request-id"))
    print("error:", e.message)  # Antes de registrarlo, confirma que no contiene la clave API u otra información sensible
except APIConnectionError as e:
    print("未拿到 HTTP 响应:", type(e).__name__)
Este código tiene un punto al que hay que prestar especial atención: cuando choices está vacío, no escribas directamente choices[0], porque de lo contrario se lanzará un error de índice que ocultará el problema real. Los errores de conexión no tienen código de estado HTTP ni encabezados de respuesta, así que deben manejarse por separado de APIStatusError.
3 Validación de la primera solicitud a Gemini 4 Neon API
El objetivo de la validación es determinar si se cumple que “la solicitud de solo texto fue exitosa”. Que el HTTP sea 2xx y que el cuerpo sea el NEON_OK esperado solo indica que esta solicitud de texto funcionó. No prueba la identidad del modelo ni sirve como resultado de una prueba de rendimiento.
3.1 Estado HTTP, cuerpo, motivo de finalización y uso
| Elemento de comprobación | Campo nativo | Campo compatible | Condición de aprobación |
|---|---|---|---|
| Estado HTTP | status guardado | raw.status_code |
2xx |
| Cuerpo | concatenación de text que no sea de pensamiento |
choices[0].message.content |
igual a NEON_OK |
| Motivo de finalización | candidates[0].finishReason |
choices[0].finish_reason |
registrado y coherente con lo que muestra el cuerpo |
| Uso | usageMetadata |
usage |
registrado para contrastarlo con los logs |
Si algún campo no existe en la respuesta, regístralo como “no devuelto” y no inferir su valor a partir de la experiencia. El motivo de finalización debe analizarse junto con el cuerpo. Cuando el cuerpo está vacío y el motivo de finalización no corresponde a una finalización normal, el problema suele estar en el proceso de generación, no en el código de análisis.
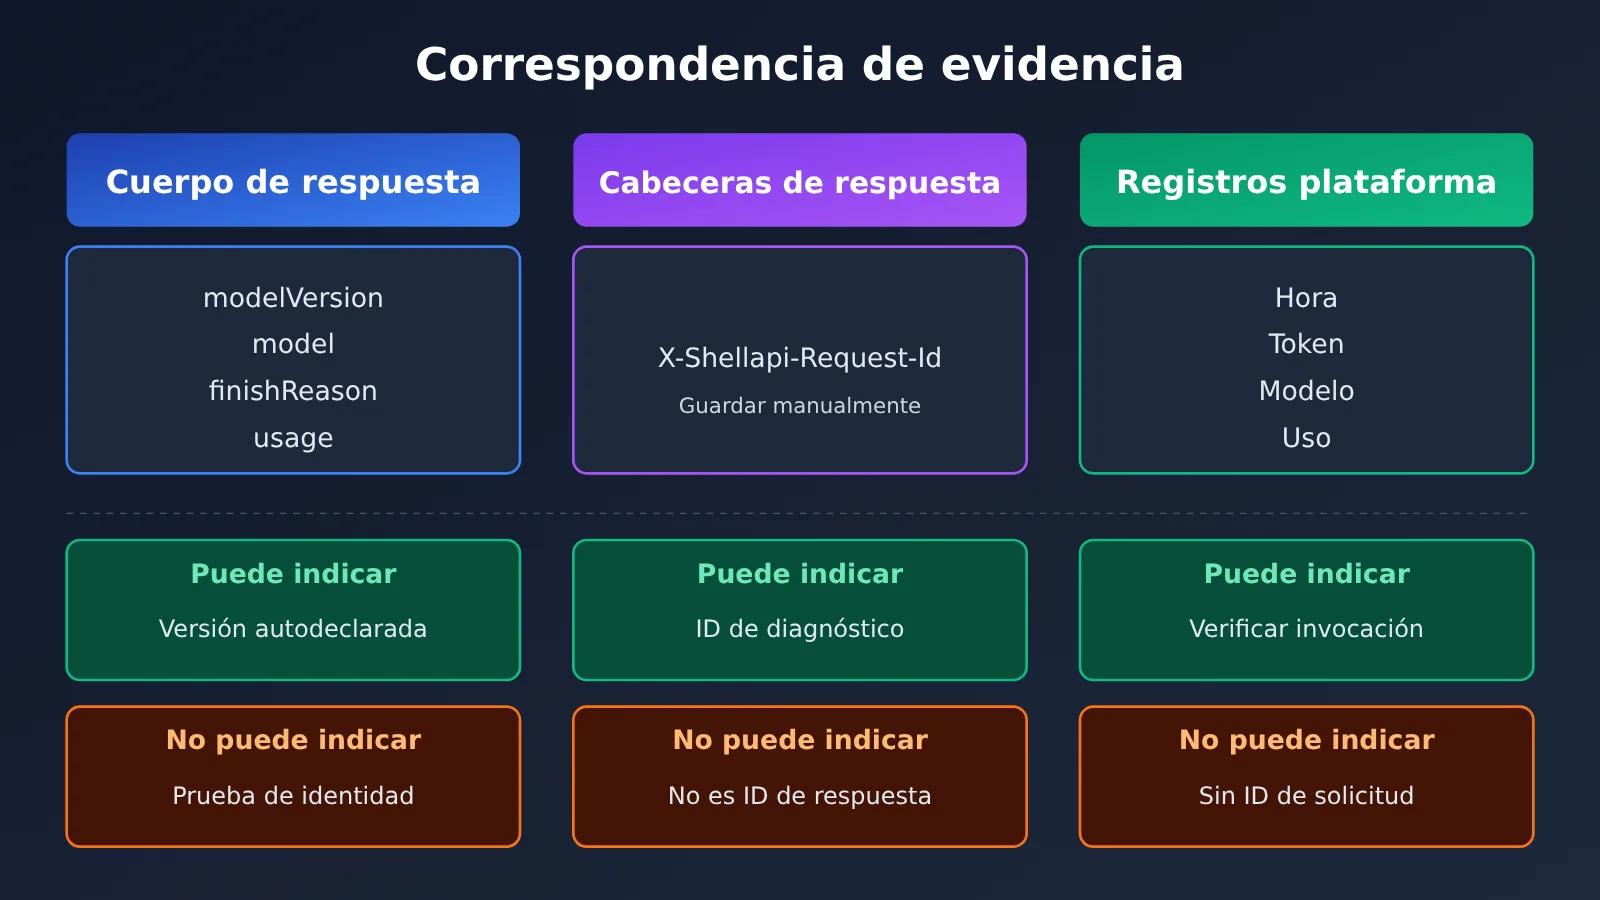
3.2 ¿Qué puede demostrar cada uno: modelVersion nativo, model compatible y los registros?
Cada uno de estos datos tiene un alcance probatorio distinto; al registrarlos, no los uses como sustituto unos de otros:
| Información | Origen | Puede demostrar | No puede demostrar |
|---|---|---|---|
modelVersion |
Cuerpo de respuesta nativo (si se devuelve) | La versión del modelo declarada por la propia respuesta | No sirve por sí sola como prueba de identidad |
model |
Cuerpo de respuesta compatible | El nombre del modelo declarado por la propia respuesta | Lo mismo que arriba |
| Registros de la plataforma | api.apiyi.com/log |
Verificar esta invocación por hora, token, modelo y consumo | La consola no muestra el ID de solicitud |
X-Shellapi-Request-Id |
Cabecera de respuesta original o mensaje de error | Identificador de solicitud que usa la plataforma para diagnóstico | No es responseId, ni el id de Chat, ni el _request_id del SDK |
Al verificar los registros, usa la hora de envío de la solicitud, el token utilizado, el nombre del modelo gemini-4-neon y las cifras de consumo para hacer la correspondencia. Como la consola no muestra el ID de solicitud, debes guardar X-Shellapi-Request-Id desde la cabecera de respuesta por tu cuenta; después no podrás encontrarlo en la consola.
3.3 Gemini 4 Neon: cómo conservar evidencia cuando no hay cuerpo de respuesta o la solicitud falla
Si la solicitud falla o no hay cuerpo, no reintentes de inmediato; guarda la evidencia en el siguiente orden:
- Guarda el código de estado HTTP. Si se trata de un error de conexión, anota el tipo de excepción.
- Guarda los encabezados de respuesta originales y extrae de ellos
X-Shellapi-Request-Id. - Guarda el cuerpo de respuesta original o el mensaje de error, y elimina datos sensibles como la clave API.
- Registra el motivo de parada y el uso (si existe), junto con la hora de envío de la solicitud, el nombre del token utilizado y el nombre del modelo.
- En
api.apiyi.com/log, busca por hora y token el registro correspondiente; después, con los materiales anteriores, contrasta el ID de solicitud de la plataforma y sigue la documentación de diagnóstico por ID de solicitud.
Hay otro punto que conviene tener en cuenta con la respuesta nativa. Si en parts solo hay contenido de pensamiento (thought), el cuerpo filtrado quedará vacío. En ese caso, debes registrar fielmente «el cuerpo filtrado está vacío»; no conviertas el contenido de pensamiento en cuerpo solo para obtener una salida.
Una vez que la solicitud de texto simple de un solo turno haya pasado la validación como se describió, valida según las necesidades del proyecto la salida en streaming, las llamadas a herramientas y otras capacidades. Por cada capacidad que añadas, valídala por separado con el método de «misma solicitud, guardar la respuesta original, contrastar con los registros». Este artículo no aborda benchmarks ni precios; para esa información, consulta las publicaciones oficiales y el catálogo público de APIYI.
Referencias
- Registro de cambios de Google AI Studio (2026-11-18):
aistudio.google.com/docs/changelog - Estructura de Gemini GenerateContentResponse:
aistudio.google.com/api-reference/generate-content - Anuncio de lanzamiento de Gemini 4 Neon en APIYI y ejemplos de ambos protocolos:
docs.apiyi.com/news/gemini-4-neon-launch.md - Procesamiento de respuestas de Gemini en APIYI:
docs.apiyi.com/api-capabilities/gemini/response-handling - Procesamiento de respuestas compatibles con OpenAI en APIYI:
docs.apiyi.com/api-capabilities/openai/response-handling - Diagnóstico por ID de solicitud en APIYI:
docs.apiyi.com/faq/request-id-troubleshooting - Acceso a la respuesta original en openai-python:
github.com/openai/openai-python
Un viaje de mil millas comienza con un solo paso. — Dao De Jing