Nota del autor: en noviembre de 2026 se lanzaron en masa nuevos modelos. Este artículo explica cómo cambiar de modelo con un solo punto de acceso, conectarse por endpoint y llevar la facturación de cada canal por separado.
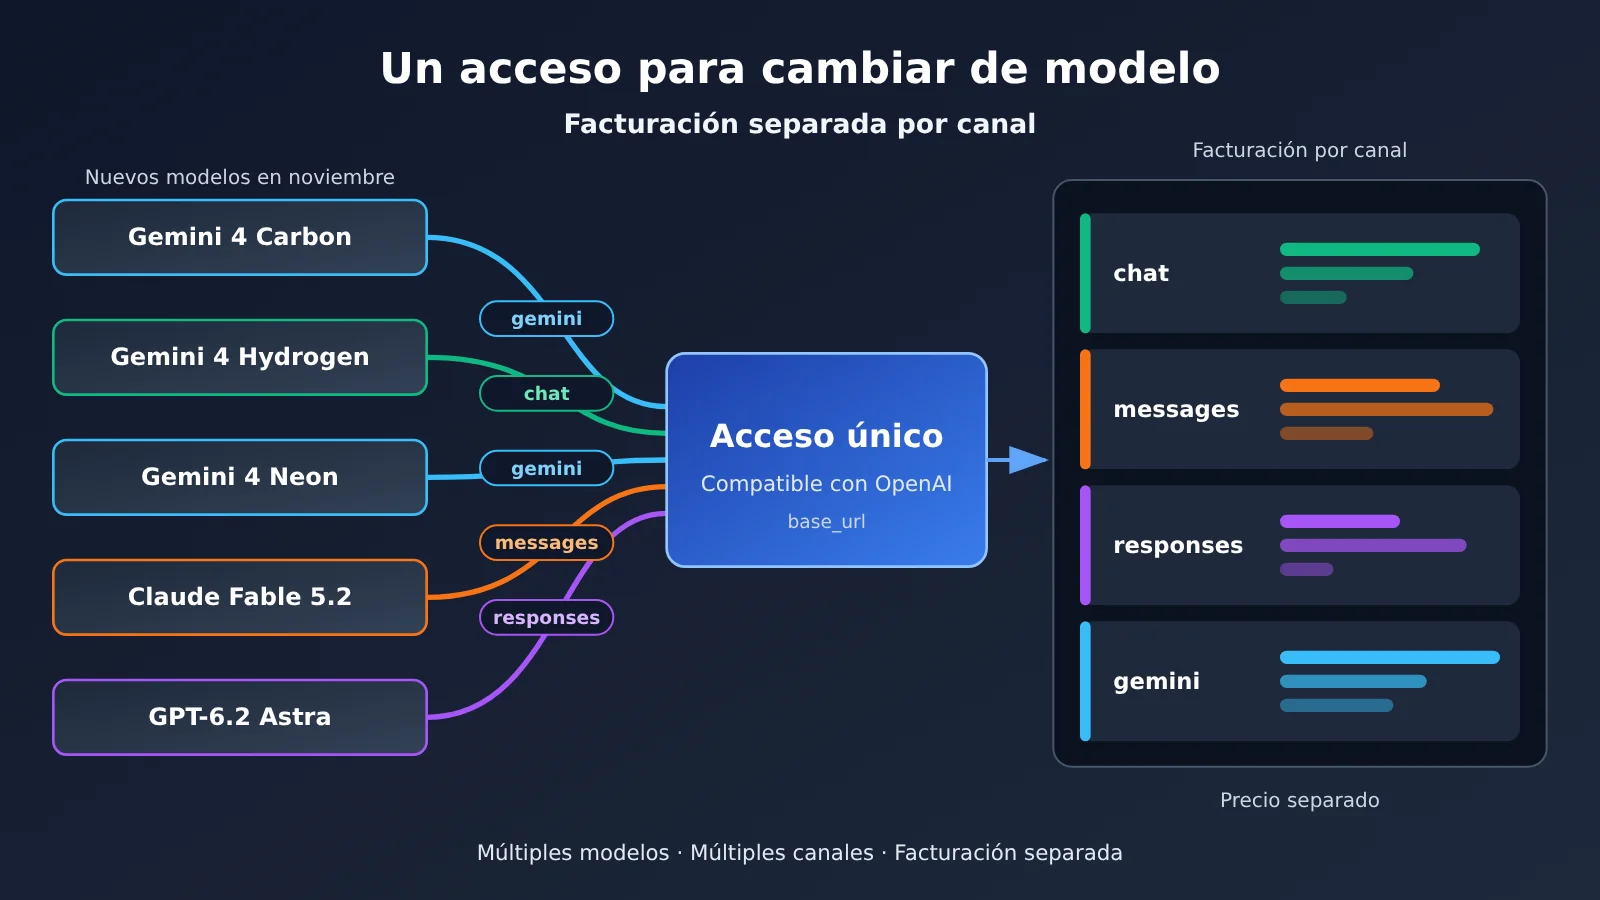
Apenas llevamos tres semanas de noviembre y Google ya ha lanzado tres modelos Gemini 4 seguidos: Carbon el 10 de noviembre, Hydrogen el 12 de noviembre y Neon el 18 de noviembre. También han ido apareciendo en las noticias nuevos modelos en áreas como imagen y codificación. Para los desarrolladores que quieren probar modelos nuevos, el problema no está en no saber escribir el código de invocación, sino en que cada proveedor tiene su propio SDK, su propio sistema de autenticación y su propio criterio de facturación. Este artículo ofrece una forma más práctica: un solo punto de acceso para cambiar de modelo, y facturación separada por canal.
Esta no es una lista promocional del «paquete completo de nuevos modelos». En este artículo trataremos por separado los modelos que aparecen en las noticias y los que ya se pueden invocar en la plataforma. Por ejemplo, MAI Image 2.7 de las noticias aún no ha entrado en el catálogo de APIYI, y no lo trataremos como un modelo invocable.
Valor principal: después de leer este artículo, sabrás dónde consultar primero la lista de modelos, cómo decidir qué ID de modelo cambiar, qué endpoint debe usar cada tipo de modelo y cómo evitar estimar la factura completa con el precio unitario de un solo modelo. Los modelos y precios mencionados a continuación se basan en la lista de modelos y la API de precios de APIYI (apiyi.com) correspondientes al 2026-11-20.
Puntos clave para la integración de nuevos modelos de noviembre
Cuando los nuevos modelos salen en masa, los errores más frecuentes se concentran en tres lugares: confundir el nombre del modelo anunciado con el que ya está disponible, usar el endpoint equivocado, y estimar todo el costo con un solo precio unitario. La siguiente tabla reúne esos tres puntos junto con la forma correcta de proceder.
| Punto clave | Descripción | Valor |
|---|---|---|
| Revisar primero la lista de modelos | Toma como referencia la tabla general de la plataforma y el endpoint de precios; registra por separado los modelos anunciados y los invocables | Evita llamar directamente con el nombre que salió en la presentación y terminar con un error |
| Cambiar de modelo = cambiar el ID + verificar el endpoint | Bajo el mismo base_url, cambias el parámetro model y luego confirmas si va por chat, messages, responses o gemini |
No necesitas escribir un SDK distinto para cada proveedor |
| Mirar la factura por canal | Registra por separado input, output y tokens de lectura de caché para cada modelo y cada endpoint | Los modelos con precios que difieren varias veces no se promedian entre sí, y el costo es rastreable |
| El precio de lanzamiento tiene fecha límite | Algunos modelos nuevos tienen precio promocional por tiempo limitado; al vencer, el precio estándar oficial cambia | Puedes prever el presupuesto del mes siguiente sin que la subida te desordene los planes |
Detalles clave de la integración: modelo anunciado ≠ modelo en el catálogo
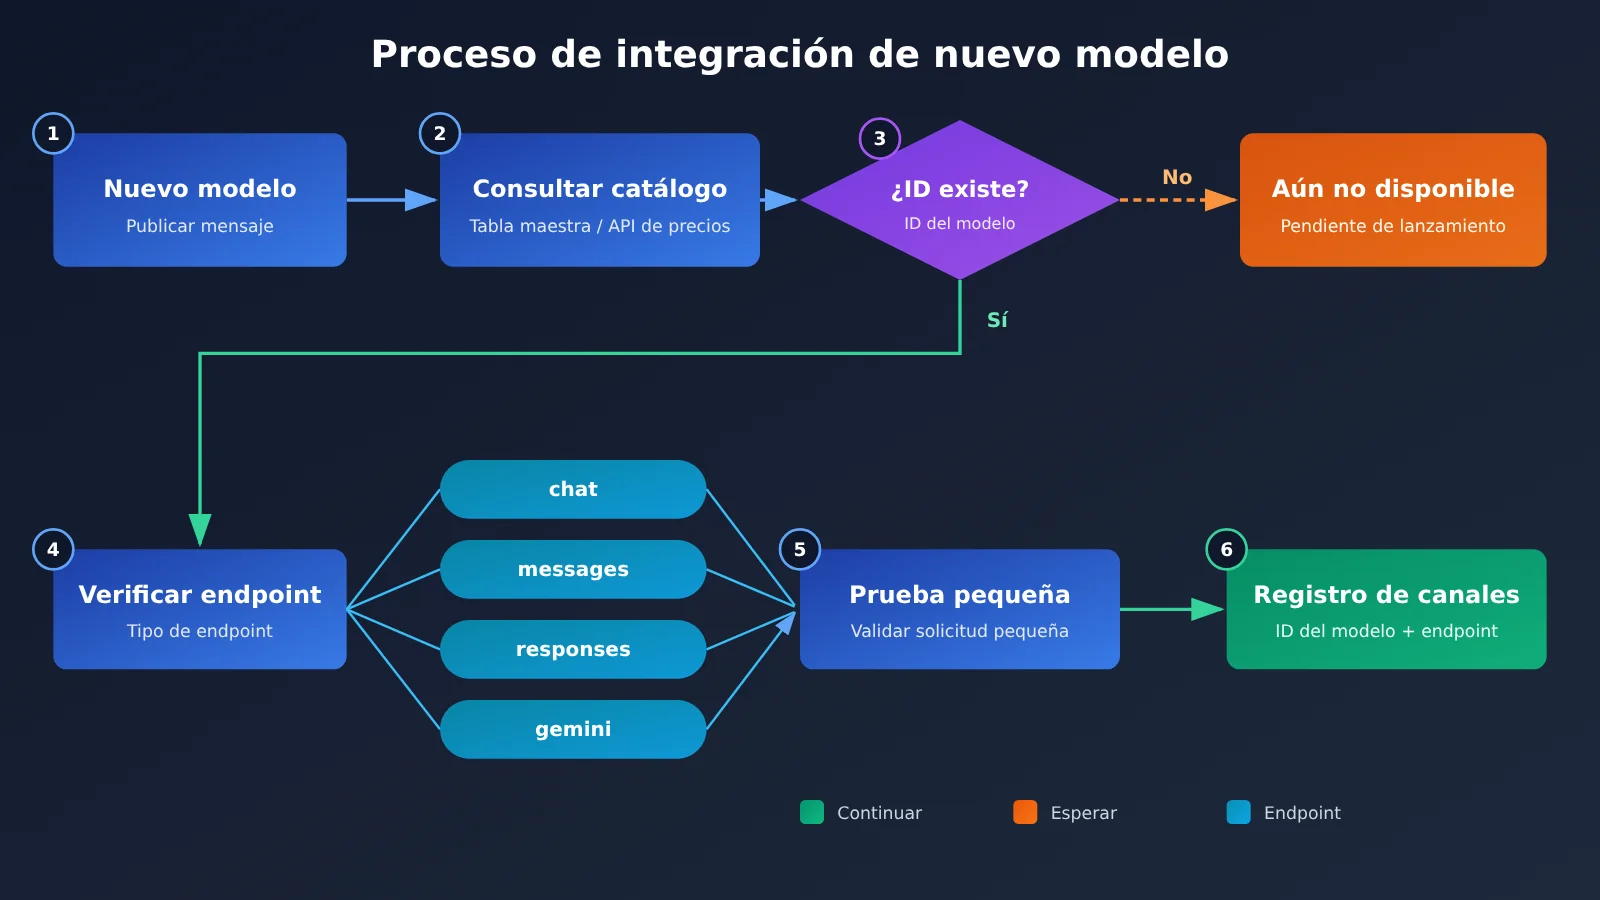
El primer paso para integrar es consultar el catálogo, no escribir código. La dirección de la tabla general de modelos de APIYI es docs.apiyi.com/models.md, la versión de referencia de este artículo se actualizó el 2026-11-19 10:59 (UTC+8). También existe un endpoint de precios legible por máquina https://api.apiyi.com/api/pricing, con identificador de versión shell-api-modelmak-v1. Los ritmos de actualización de ambos pueden no estar sincronizados; por ejemplo, gemini-4-neon todavía no aparece en esta versión de la tabla general, pero en el endpoint de precios ya tiene todos los campos de precio. Por eso, al decidir «si se puede invocar», conviene consultar tanto la tabla general como el endpoint de precios: si cualquiera de los dos tiene registro, confirma con una petición pequeña.
El caso contrario también merece atención. MAI Image 2.7 es un modelo de imagen que apareció en las noticias recientes, pero en la tabla general y el endpoint de precios actuales de APIYI solo están MAI-Image-2.6 y MAI-Image-2.6-Flash, no 2.7. Es decir, MAI Image 2.7 aún no está disponible; lo pondremos disponible lo antes posible, y en ese momento el nombre del modelo y el precio se regirán por la lista de modelos de la plataforma. Además, Kling, Muse y gemini-4-flash-lite no aparecen por ahora ni en la tabla general ni en el endpoint de precios, así que no los incluyas al planificar.
Modelos nuevos de noviembre y su estado en el catálogo
La siguiente tabla relaciona, uno por uno, los modelos mencionados en las noticias de noviembre con su estado en el catálogo a fecha 2026-11-20. Solo se incluye la información verificable en los materiales; no se hacen suposiciones sobre lo que no se ha podido confirmar.
| Modelo | Información de prensa | Estado en el catálogo de APIYI (2026-11-20) | ID del modelo |
|---|---|---|---|
| Gemini 4 Carbon | Lanzado el 2026-11-10, orientado a tareas complejas de largo recorrido | Disponible en la tabla general y en la interfaz de precios | gemini-4-carbon |
| Gemini 4 Hydrogen | Lanzado el 2026-11-12, gama diaria de alta velocidad | Disponible en la tabla general y en la interfaz de precios | gemini-4-hydrogen |
| Gemini 4 Neon | Lanzado el 2026-11-18, capacidades intermedias | Ya aparece en la interfaz de precios, pero no en la tabla general de esta versión | gemini-4-neon |
| Gemini 4 Argon | — | Disponible en la tabla general | gemini-4-argon |
| MAI Image 2.7 | Modelo de imagen mencionado en la prensa | Aún no disponible en el catálogo; se añadirá lo antes posible | Según la lista de la plataforma |
| MAI Image 2.6 / 2.6 Flash | — | Disponible, facturación por uso | MAI-Image-2.6 / MAI-Image-2.6-Flash |
El posicionamiento de los tres niveles de Gemini 4 se puede resumir así: Carbon está orientado a tareas de cadena larga y alta dificultad, Hydrogen prioriza la velocidad y encaja en llamadas diarias de alta frecuencia, y Neon queda entre ambos. A la hora de elegir, conviene primero escoger el nivel según la dificultad de la tarea y luego mirar el precio; así resulta más seguro que ir directamente al más barato.
Nuevos modelos de noviembre: guía rápida para empezar, con un solo punto de acceso para cambiar de modelo
Ejemplo mínimo: cambia dos parámetros y cambias de modelo
APIYI ofrece una interfaz compatible con OpenAI. Al integrar un modelo nuevo, la mayoría de los cambios se concentran en dos lugares: base_url y model. Tomando como ejemplo el SDK oficial de Python de OpenAI, los pasos mínimos son:
- Instala el SDK:
pip install openai - Crea el cliente:
client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1") - Inicia la conversación:
client.chat.completions.create(model="gemini-4-hydrogen", messages=[{"role": "user", "content": "Hello!"}]) - Lee el resultado:
response.choices[0].message.content
Si quieres pasar de Hydrogen a Carbon, solo cambia model="gemini-4-hydrogen" por model="gemini-4-carbon"; no hace falta tocar el cliente, la autenticación ni la estructura de los mensajes. Eso es lo que significa «un solo punto de acceso para cambiar de modelo»: normalmente cambiar de modelo consiste en cambiar el ID del modelo y verificar el endpoint, sin escribir un SDK distinto para cada proveedor.
Ver la estrategia completa de integración (incluye cambio de endpoint y registro de consumo por canal)
En un proyecto completo, conviene poner el mapeo «ID del modelo → endpoint» en la configuración, en lugar de repartirlo por el código:
1. Define la opción de configuración `MODEL_ROUTES`; cada registro contiene tres campos: `model`, `endpoint` y `price_key`. Por ejemplo, `gemini-4-neon` corresponde a `chat`, `claude-fable-5-2` a `messages` y `gpt-6.2-astra` a `responses`.
2. Encapsula una función `call_model(model, prompt)`: según el `endpoint`, llama a `client.chat.completions.create`, a `client.responses.create`, o utiliza el SDK de Anthropic para solicitar con el formato Messages (con el mismo `base_url`).
3. Después de cada respuesta, lee los tokens de entrada, salida y caché desde el campo `usage` de la respuesta, y escribe en el registro local usando `model+endpoint` como clave de canal.
4. Una vez al día, consulta de forma programada la interfaz de precios; calcula el precio unitario según `model_ratio`, `completion_ratio` y `cache_ratio`, y luego multiplícalo por el número de tokens del registro para obtener el costo estimado de cada canal.
5. Si la invocación falla, registra `model` y el mensaje de error. Si indica que el modelo no existe, primero revisa la lista de modelos; no reintentes a ciegas.
Así, cuando se publique un modelo nuevo, basta añadir una línea de configuración en `MODEL_ROUTES`; no hay que modificar el código de negocio.
🚀 Consejo para empezar rápido: primero regístrate en APIYI (apiyi.com) y reclama el crédito de prueba gratuito para nuevos usuarios; valida el flujo completo con un modelo de uso diario como Hydrogen y luego cambia a Neon y Carbon para comparar resultados. Todo el proceso solo requiere una clave API.
Comparación de endpoints de los nuevos modelos: no hay que meter todos los modelos en chat
Tener un único punto de entrada no significa tener un único endpoint. Los modelos de texto que ya se pueden invocar no admiten todos los mismos endpoints; al cambiar de modelo, hay que revisar este paso:
| Serie de modelos | Ejemplo de ID de modelo | Endpoints disponibles | Descripción |
|---|---|---|---|
| Serie Gemini 4 | gemini-4-carbon / gemini-4-neon / gemini-4-hydrogen |
chat o gemini | chat es el endpoint /v1/chat/completions compatible con OpenAI; gemini es el formato nativo de Gemini, y la ruta concreta debe consultarse en la documentación de la plataforma |
| Claude Fable 5.2 | claude-fable-5-2 / claude-fable-5-2-thinking |
chat o messages | messages es el endpoint /v1/messages al estilo de Anthropic |
| GPT-6.2 Astra | gpt-6.2-astra |
Se recomienda responses | Se recomienda usar /v1/responses |
| MAI Image 2.6 | MAI-Image-2.6 / MAI-Image-2.6-Flash |
Generación de imágenes | Se factura por llamada; la forma de invocación debe consultarse en la documentación de la plataforma |
En la práctica, si el equipo ya tiene mucho código basado en el formato chat, Gemini y Claude pueden seguir usando el endpoint chat al principio, con un coste de migración mínimo. Cuando haga falta usar las capacidades nativas del proveedor, se puede cambiar al endpoint gemini o messages. Para GPT-6.2 Astra, en cambio, se recomienda integrarlo directamente mediante el endpoint responses, no forzarlo dentro de chat solo por costumbre.
La factura de los nuevos modelos de noviembre: desglose por canal
Primero, aprendamos a leer el endpoint de precios
El endpoint de precios de APIYI expresa los precios con multiplicadores. Las reglas de conversión son las siguientes:
- Precio unitario de entrada =
model_ratio × 2(unidad: USD por millón de tokens; cuandomodel_ratiovale 1, equivale a$2 / 1M) - Precio unitario de salida = precio unitario de entrada ×
completion_ratio - Precio unitario de lectura de caché = precio unitario de entrada ×
cache_ratio
Pongamos gemini-4-neon como ejemplo. El endpoint de precios indica model_ratio 1.5, completion_ratio 5 y cache_ratio 0.05; tras la conversión, la entrada es $3 / 1M, la salida $15 / 1M y la lectura de caché $0.15 / 1M, igual al precio de lista de Google. Una vez que tengas claro este método de conversión, en cuanto se publique un modelo nuevo podrás calcular el precio unitario por tu cuenta desde https://api.apiyi.com/api/pricing, sin esperar a que se actualice el artículo.
Comparación de precios por canal (verificado el 2026-11-20)
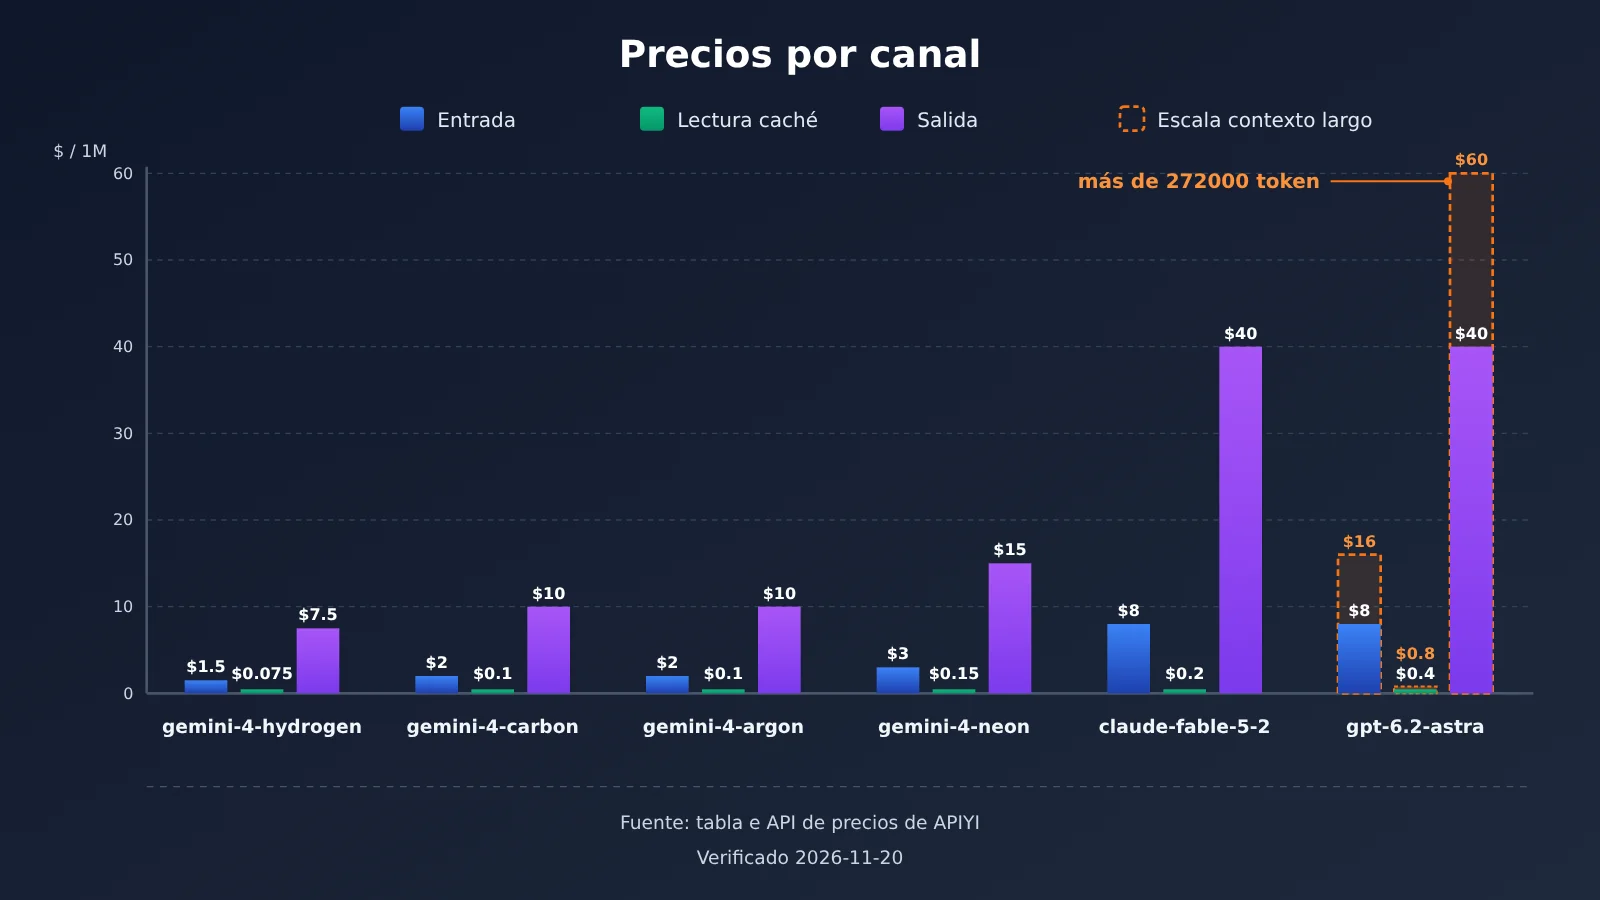
📊 Nota sobre la fuente de datos: Los precios del gráfico y de la tabla anteriores provienen de la tabla general de modelos y la interfaz de precios de APIYI apiyi.com; la fecha de verificación es 2026-11-20. Los ajustes posteriores prevalecen según la lista en tiempo real de la plataforma.
| Canal (ID de modelo) | Entrada | Lectura de caché | Salida | Notas |
|---|---|---|---|---|
gemini-4-hydrogen |
$1.5 / 1M |
$0.075 / 1M |
$7.5 / 1M |
Versión rápida de uso diario |
gemini-4-carbon |
$2 / 1M |
$0.1 / 1M |
$10 / 1M |
Corresponde al precio introductorio de Google vigente hasta el 2026-11-30 |
gemini-4-argon |
$2 / 1M |
$0.1 / 1M |
$10 / 1M |
Tomado de la tabla general |
gemini-4-neon |
$3 / 1M |
$0.15 / 1M |
$15 / 1M |
Tomado de la interfaz de precios |
claude-fable-5-2 / -thinking |
$8 / 1M |
$0.2 / 1M |
$40 / 1M |
Ambos ID tienen el mismo precio |
gpt-6.2-astra (primer tramo) |
$8 / 1M |
$0.4 / 1M |
$40 / 1M |
Más de 272000 tokens: ver más abajo |
MAI-Image-2.6 |
Por uso: $0.12 |
— | — | Imagen |
MAI-Image-2.6-Flash |
Por uso: $0.06 |
— | — | Imagen |
Hay dos puntos de la tabla que conviene explicar por separado.
El primero es el escalón de contexto largo de GPT-6.2 Astra. La tabla general indica que, al superar los 272000 tokens, la entrada pasa a $16 / 1M; la interfaz de precios añade además que, por encima de 272000 tokens, la salida se calcula a $60 / 1M y la lectura de caché a $0.8 / 1M. Si tu negocio va a incluir contextos extremadamente largos, calcula los costos por separado según el escalón; no apliques el precio del primer tramo a todas las solicitudes.
El segundo es el precio introductorio de Gemini 4 Carbon. El precio actual corresponde al precio introductorio de Google vigente hasta el 2026-11-30. A partir del 1 de diciembre, el precio estándar de Google será $4 / 1M de entrada y $20 / 1M de salida. Los precios futuros de la plataforma se regirán por la lista de modelos de APIYI; para el presupuesto de diciembre, conviene reservar esa diferencia.
Por qué no se puede resumir todo con el precio unitario de un solo proveedor
Como se ve en la tabla anterior, para el mismo millón de tokens de salida, Hydrogen cuesta $7.5, mientras que Claude Fable 5.2 y GPT-6.2 Astra arrancan en $40: más de cinco veces de diferencia. Si el equipo ejecuta tres o cuatro modelos a la vez, fijarse solo en un «precio unitario promedio» o en el de un único proveedor lleva fácilmente a subestimar o sobreestimar el costo de forma considerable. Lo más sensato es usar «ID del modelo + endpoint» como clave de canal, registrar por separado los tokens de entrada, de salida y de lectura de caché de cada canal, multiplicarlos por su precio unitario y sumar al final.
Conviene tener en cuenta también que un punto de acceso unificado resuelve el costo de integración, pero no implica que todos los modelos salgan necesariamente más baratos. En la tabla anterior, varios modelos Gemini 4 tienen el mismo precio que el oficial de Google. Que sea rentable o no debe comprobarse canal por canal contra tu consumo real, en lugar de generalizar.
💰 Consejo de costos: al comparar opciones, puedes llamar a Hydrogen, Neon y Carbon desde APIYI apiyi.com con el mismo lote de muestras de prueba, anotar el consumo de tokens por canal, calcular el costo real por llamada de cada canal y luego decidir el modelo principal.
Preguntas frecuentes (FAQ)
Q1: ¿Qué significa «un solo punto de acceso para cambiar de modelo»?
Significa que todos los modelos comparten el mismo `base_url` y la misma clave API. Al cambiar de modelo, solo modificas el ID del modelo en el parámetro `model` y verificas el endpoint compatible con ese modelo. No necesitas registrar cuentas por separado ni integrar un SDK distinto para cada proveedor.
Q2: ¿Se pueden invocar directamente los modelos recién anunciados en las noticias?
No necesariamente. Que un modelo se anuncie no significa que ya esté disponible. Tomando como ejemplo el 2026-11-20, MAI Image 2.7 aparecía solo en las noticias; en el catálogo de APIYI solo estaban `MAI-Image-2.6` y `MAI-Image-2.6-Flash`, y la 2.7 aún no está listada, pero se listará lo antes posible. Antes de invocar, consulta primero la tabla general y la interfaz de precios para confirmar que el ID del modelo existe; solo entonces intégralo.
Q3: ¿Cómo elegir entre Carbon, Hydrogen y Neon de Gemini 4?
Elige el nivel según la dificultad de la tarea: para tareas de cadena larga y alta complejidad, usa Carbon; para llamadas diarias de alta frecuencia en las que prima la velocidad, usa Hydrogen; y para lo que queda entre ambos, usa Neon. Los tres se lanzaron el 10, 12 y 18 de noviembre respectivamente, y sus precios también son distintos. Se recomienda compararlos con el mismo lote de muestras antes de decidir cuál será tu modelo principal.
Q4: Si no encuentro gemini-4-neon en la tabla general, ¿significa que aún no se puede usar?
No basta con mirar solo la tabla general. En la versión de la tabla general del 2026-11-19 no aparecía `gemini-4-neon`, pero la interfaz de precios ya indicaba el multiplicador completo: tras la conversión, entrada `$3 / 1M`, salida `$15 / 1M` y lectura de caché `$0.15 / 1M`. Hay un desfase temporal entre ambas fuentes de información; toma como referencia la interfaz de precios y el resultado de una prueba real con un importe pequeño.
Q5: ¿Cómo invocar rápidamente estos nuevos modelos de noviembre a través de la API?
Se recomienda seguir estos pasos:
1. Regístrate en APIYI apiyi.com, obtén la clave API y el crédito de prueba gratuito para nuevos usuarios
2. Consulta la tabla general de modelos y la interfaz de precios para confirmar el ID del modelo objetivo
3. Configura `base_url` con la dirección compatible con OpenAI de la plataforma y, según la tabla de comparación de endpoints anterior, elige chat, messages, responses o gemini
4. Envía primero una solicitud corta y, tras confirmar que funciona, intégrala en tu negocio
Q6: Para un mismo Claude Fable 5.2, ¿el precio cambia según se use chat o messages?
En los materiales de referencia, `claude-fable-5-2` y `claude-fable-5-2-thinking` tienen el mismo precio: entrada `$8 / 1M`, lectura de caché `$0.2 / 1M` y salida `$40 / 1M`. Los materiales no distinguen precios por endpoint. Aun así, al llevar la contabilidad se recomienda incluir el endpoint como parte de la clave del canal, para facilitar la resolución de problemas y las verificaciones posteriores.
Q7: ¿Un punto de acceso unificado siempre es más barato que conectarse directamente al oficial?
No se puede concluir así. El valor principal del punto de acceso unificado es tener que integrar menos conjuntos de interfaces y contar con un único punto de autenticación y facturación. Los precios deben revisarse canal por canal; por ejemplo, el precio de `gemini-4-neon` coincide con el precio oficial de Google. Si resulta más económico o no depende de la combinación de modelos y del volumen de uso; debes hacer tus propios cálculos por canal.
Q8: ¿Qué limitaciones conocidas conviene planificar de antemano?
Hay tres puntos principales. Primero, algunos modelos nuevos aún no están disponibles; por ejemplo, MAI Image 2.7, Kling, Muse y `gemini-4-flash-lite` no aparecen por ahora. Segundo, el precio de introducción tiene fecha límite: el precio de introducción de Google para Gemini 4 Carbon estará vigente hasta el 30 de noviembre. Tercero, GPT-6.2 Astra aplica precios por tramos a partir de 272000 tokens. En estos casos, primero ajusta el plan según la lista de la plataforma y después vuelve a modificar el código.
Puntos clave para integrar los nuevos modelos de noviembre
- Primero revisa el catálogo, luego escribe código: guíate por la tabla general de modelos y la API de precios, y registra por separado los modelos anunciados y los que se pueden invocar.
- Para cambiar de modelo solo tocas dos cosas: cambia el ID del modelo bajo el mismo
base_urly luego verifica el tipo de endpoint. - Cada endpoint debe encajar con su tipo: Gemini usa chat o gemini; Claude usa chat o messages; para GPT-6.2 Astra se recomienda responses.
- Con saber leer los multiplicadores, ya sabes calcular el precio:
model_ratio × 2es el precio unitario de entrada; luego multiplica por los multiplicadores de salida y de caché. - Desglosa la facturación por canal: registra cada caso por separado usando «ID del modelo + endpoint» como clave; no apliques el precio de un solo proveedor a todo.
- Presta atención a fechas límite y tramos: el precio de introducción de Carbon y el tramo de 272000 tokens de Astra afectarán tu presupuesto.
- Ruta para empezar: en APIYI, reclama la cuota gratuita con una clave API; primero usa el nivel de uso diario y luego compara en paralelo.
Resumen: lluvia de modelos nuevos en noviembre — un solo punto de entrada para cambiar de modelo y la factura revisada por canal
Cuando en noviembre se acumulan los lanzamientos de modelos nuevos, la clave para integrarlos no está en perseguir cada noticia, sino en establecer un proceso fijo:
- Contrasta la lista de modelos: revisa tanto la tabla general como la interfaz de precios. El MAI Image 2.7 que aparece en las noticias todavía no está en el catálogo, así que no lo metas en el plan de lanzamiento.
- Cambia el ID del modelo y verifica el endpoint: con un solo
base_urlcubres varios modelos; eligechat,messages,responsesogeminisegún la tabla de equivalencias de endpoints. - Revisa la factura por canal: contabiliza tokens y costos por separado para cada modelo y cada endpoint, y no pierdas de vista la fecha límite del precio de introducción ni los tramos de contexto largo.
Una vez que el proceso queda fijo, la próxima vez que se publique un modelo nuevo solo tienes que añadir una línea con el ID del modelo en la configuración y consultar una vez la interfaz de precios: con eso completas la integración y la evaluación de costos. Te recomendamos usar el crédito gratuito para usuarios nuevos en APIYI apiyi.com para validar primero un canal de punta a punta y, después, ir sumando Gemini 4, Claude Fable 5.2 y GPT-6.2 Astra a la comparación.
📚 Referencias
-
Blog oficial de Google: anuncio de lanzamiento de Gemini 4 Neon: presentación de los modelos de la serie Gemini 4
- Enlace:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - Descripción: conoce el posicionamiento y las fechas de lanzamiento de Carbon, Hydrogen y Neon
- Enlace:
-
Tabla general de modelos e interfaz de precios de APIYI: fuente para contrastar modelos y precios
- Enlace: consulta la sección «modelo de la noticia ≠ modelo en el catálogo» del texto principal
- Descripción: la tabla general y la interfaz de precios pueden no estar sincronizadas, así que conviene compararlas en ambos lugares
Autor: equipo técnico de APIYI
Contacto técnico: escríbenos desde la página principal del sitio de APIYI; encontrarás más documentación de integración en el centro de documentación docs.apiyi.com