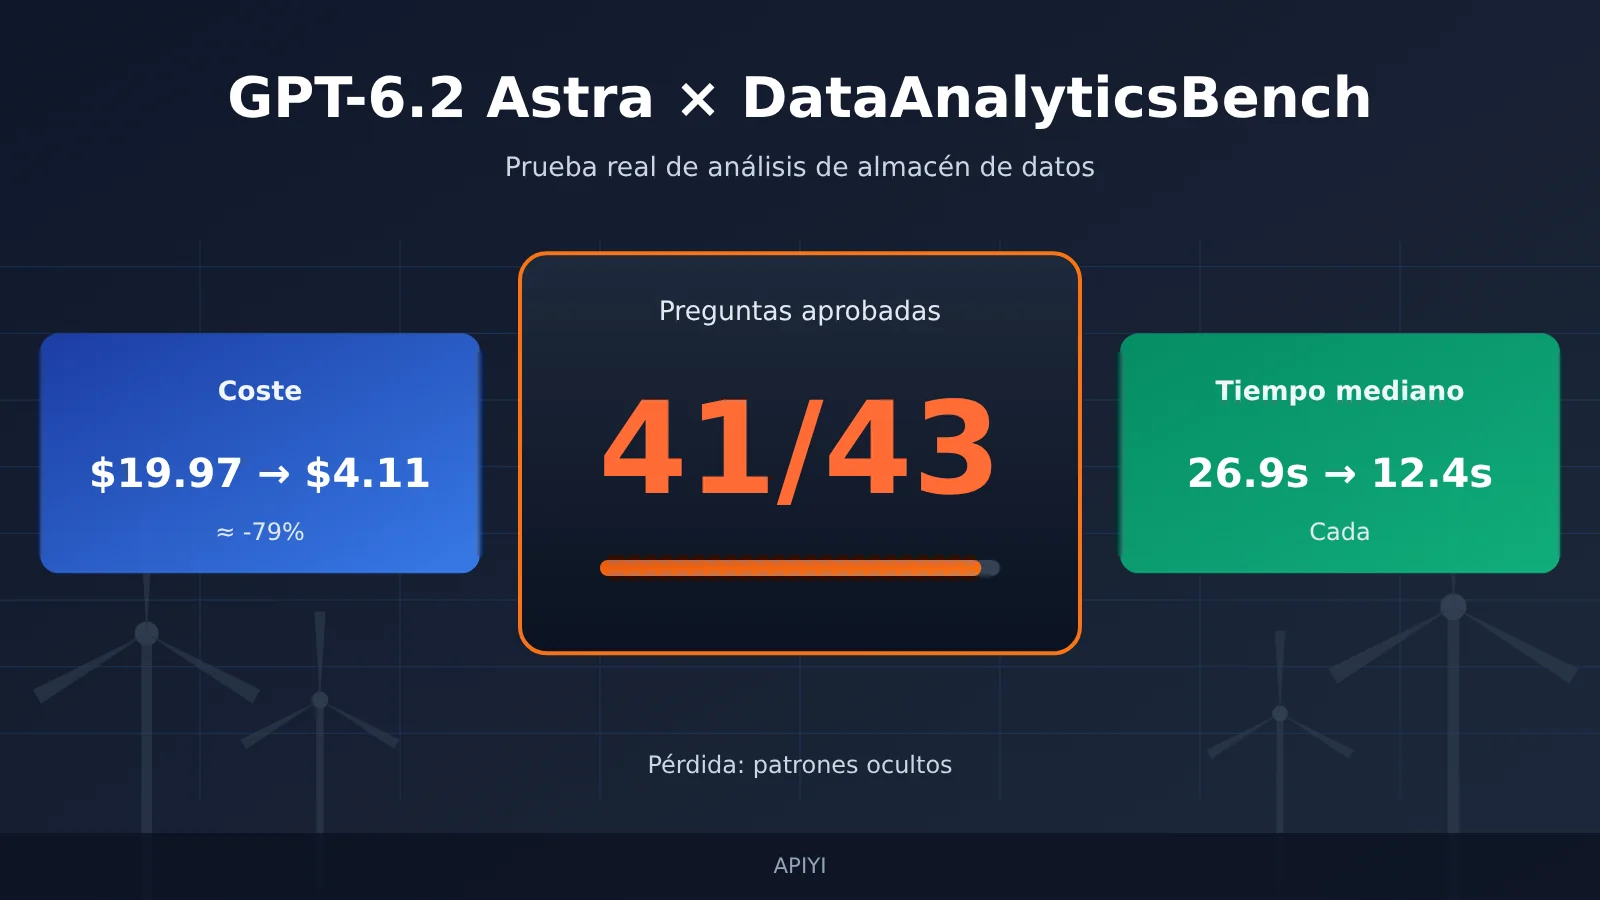
Conclusión clave: en la prueba DataAnalyticsBench de Plotly, GPT-6.2 Astra supera 41 de las 43 preguntas de análisis de datos. La generación anterior, GPT-6 Astra, obtuvo 43/43. Las dos fallas estuvieron ambas en la categoría de preguntas de «patrones ocultos»; las otras cinco categorías se superaron por completo. Al mismo tiempo, el costo de la ronda completa bajó de $19.97 a $4.11, y la mediana de tiempo por pregunta se redujo de 26.9 segundos a 12.4 segundos. La nueva generación de Astra sacrificó dos preguntas a cambio de un costo inferior a un cuarto del de la generación anterior y un tiempo de espera inferior a la mitad. Pero si de verdad retrocedió en la búsqueda proactiva de anomalías es algo que, con solo una ronda de datos, todavía está por confirmar; hace falta repetir la prueba con tus propios datos.
¿Qué puedes aprender al leer este artículo?
- Qué mide DataAnalyticsBench, cómo puntúa y dónde está el límite de la puntuación 41/43.
- El puntaje detallado de las seis categorías de preguntas y cómo falló cada una de las dos preguntas perdidas.
- Las dos fuentes de la caída de aproximadamente 79% en el costo: reducción de tarifas y menor carga de trabajo, y cuánto aporta cada una.
- El equilibrio entre puntuación, costo y latencia de GPT-6.2 Astra frente a GPT-6 Astra, GPT-6.1 Sol y GPT-6.2 Sol.
- Un método de repetición de pruebas listo para adaptar y código Python para validar las conclusiones en tu propio data warehouse.
Índice: la tabla To Know explica los conceptos propios de la evaluación; el resumen de impacto condensa el significado de esta noticia para distintos tipos de audiencia. La sección «Hechos objetivos» describe en orden el entorno de prueba y las reglas de puntuación, el puntaje de las seis categorías de preguntas, los datos de costo y tiempo, y la identidad oficial del modelo y los criterios de precios de OpenAI. La sección «Análisis y valoración» interpreta el significado de 41/43, plantea hipótesis para explicar las fallas en las preguntas de patrones ocultos, desglosa las fuentes de la caída de costos y ofrece recomendaciones de selección y código para repetir la prueba.
GPT-6.2 Astra DataAnalyticsBench: conceptos que conviene conocer primero
| Concepto | Explicación breve |
|---|---|
| DataAnalyticsBench | 43 preguntas de análisis de almacén de datos (data warehouse) diseñadas por investigadores de Plotly y Mila, que evalúan la capacidad analítica del modelo sobre datos simulados de operación de parques eólicos |
| Entorno de ejecución de la prueba | Sistema de evaluación que entrega a cada modelo el mismo almacén de datos, además de herramientas de solo lectura como consultas, generación de gráficos y visualización de tablas |
| Reglas de puntuación | Para cada pregunta se especifica qué tipo de respuesta se considera suficiente para cumplir con lo pedido; solo se juzga como aprobado o no aprobado, sin puntos parciales |
| Problemas de calidad de datos | Fallos en los datos de entrada que afectan las conclusiones del análisis, como valores faltantes, duplicados y registros anómalos; se introducen a propósito dentro de las preguntas |
| Trampas estadísticas | Preguntas en las que un algoritmo intuitivo o una forma de agregación intuitiva puede llevar a conclusiones erróneas |
| Patrones ocultos | Patrones o causas anómalas que el enunciado no indica y que el modelo debe investigar por su cuenta |
| Mediana del tiempo por pregunta | El valor central obtenido al ordenar los tiempos reales de las 43 preguntas; esta tabla incluye el tiempo de las consultas a herramientas |
| Costo de la ronda completa | Costo acumulado de las invocaciones del mismo modelo al completar las 43 preguntas |
| Aciertos de caché | La parte de tokens de entrada que, al repetirse el prefijo de entrada y quedar almacenada en caché en el servidor, se factura a un precio unitario más bajo |
Resumen rápido del impacto de las puntuaciones de GPT-6.2 Astra DataAnalyticsBench según el perfil
- Responsables de selección de API: GPT-6.2 Astra mejora de forma evidente el costo por unidad y la velocidad de respuesta, así que para tareas como informes rutinarios y aclaración de criterios puede ser una opción prioritaria. Por ahora, no conviene trasladar directamente las conclusiones del ranking a tareas de diagnóstico de anomalías.
- Desarrolladores de productos de datos: al crear productos como “consultas de datos en lenguaje natural” o asistentes de BI, que la mediana de latencia se reduzca a la mitad influye mucho en la experiencia interactiva. Aun así, hay que evaluar por separado la “paciencia” del modelo en exploraciones de múltiples turnos y, si hace falta, forzar pasos de verificación adicionales en la indicación o en el flujo de trabajo.
- Equipos de análisis: pueden usar el modelo como un analista más rápido para un primer borrador, pero las conclusiones de investigaciones de causa raíz todavía requieren revisión humana. Con interfaces de agregación compatibles con OpenAI como APIYI apiyi.com, se puede cambiar entre cuatro modelos dentro del mismo código para hacer pruebas comparativas.
Hechos objetivos sobre GPT-6.2 Astra DataAnalyticsBench
Escenarios de prueba y reglas de puntuación de GPT-6.2 Astra
DataAnalyticsBench fue diseñado por investigadores de Plotly y Mila, y utiliza un almacén de datos simulado de operaciones eólicas. El almacén contiene 44 tablas, alrededor de 19,9 millones de filas y 554 columnas, y abarca datos de telemetría de equipos, alarmas, órdenes de trabajo, inspecciones y clima. Cada pregunta se ejecuta en Plotly Studio Embedded y el modelo se invoca a través de OpenRouter. Las únicas herramientas que el modelo puede usar son cuatro herramientas de solo lectura: listar conjuntos de datos, ejecutar SQL, dibujar gráficos y mostrar tablas.
El modelo decide por sí mismo la ruta de consulta y cuándo responder; el evaluador no le planifica los pasos. Esto significa que la evaluación no solo mide la escritura de SQL, sino también el criterio para decidir «hasta qué punto basta seguir consultando».
En cuanto a la puntuación, la evaluación determina pregunta por pregunta si se aprueba, según la clave de respuestas y las reglas de calificación, sin puntuación parcial. El modelo juez es Claude Sonnet 5, con temperatura fijada en 0. Los organizadores generan las respuestas de forma independiente por tres vías —SQL, pandas y Polars— y las validan de forma cruzada; además, revisan manualmente las trayectorias fallidas y auditan también los resultados con puntuación completa. Hay dos tipos de preguntas especiales con condiciones de aprobación claras:
- Preguntas ambiguas: el modelo aprueba si aclara la ambigüedad, o si explicita los supuestos y ofrece una solución alternativa.
- Preguntas que los datos no permiten responder: basta con señalar con precisión las limitaciones de los datos existentes para aprobar.
El banco de preguntas también tiene límites claros: un único dominio de negocio (operaciones eólicas), inglés, el mismo entorno de prueba, y cada modelo se ejecuta solo una ronda. Las preguntas, los datos y las claves de respuestas los conserva la organización y no se hacen públicos.
Fuente: Plotly, Introducing DataAnalyticsBench, publicado el 2026-10-14, actualizado el 2026-11-19, plotly.com/blog/introducing-dataanalyticsbench/
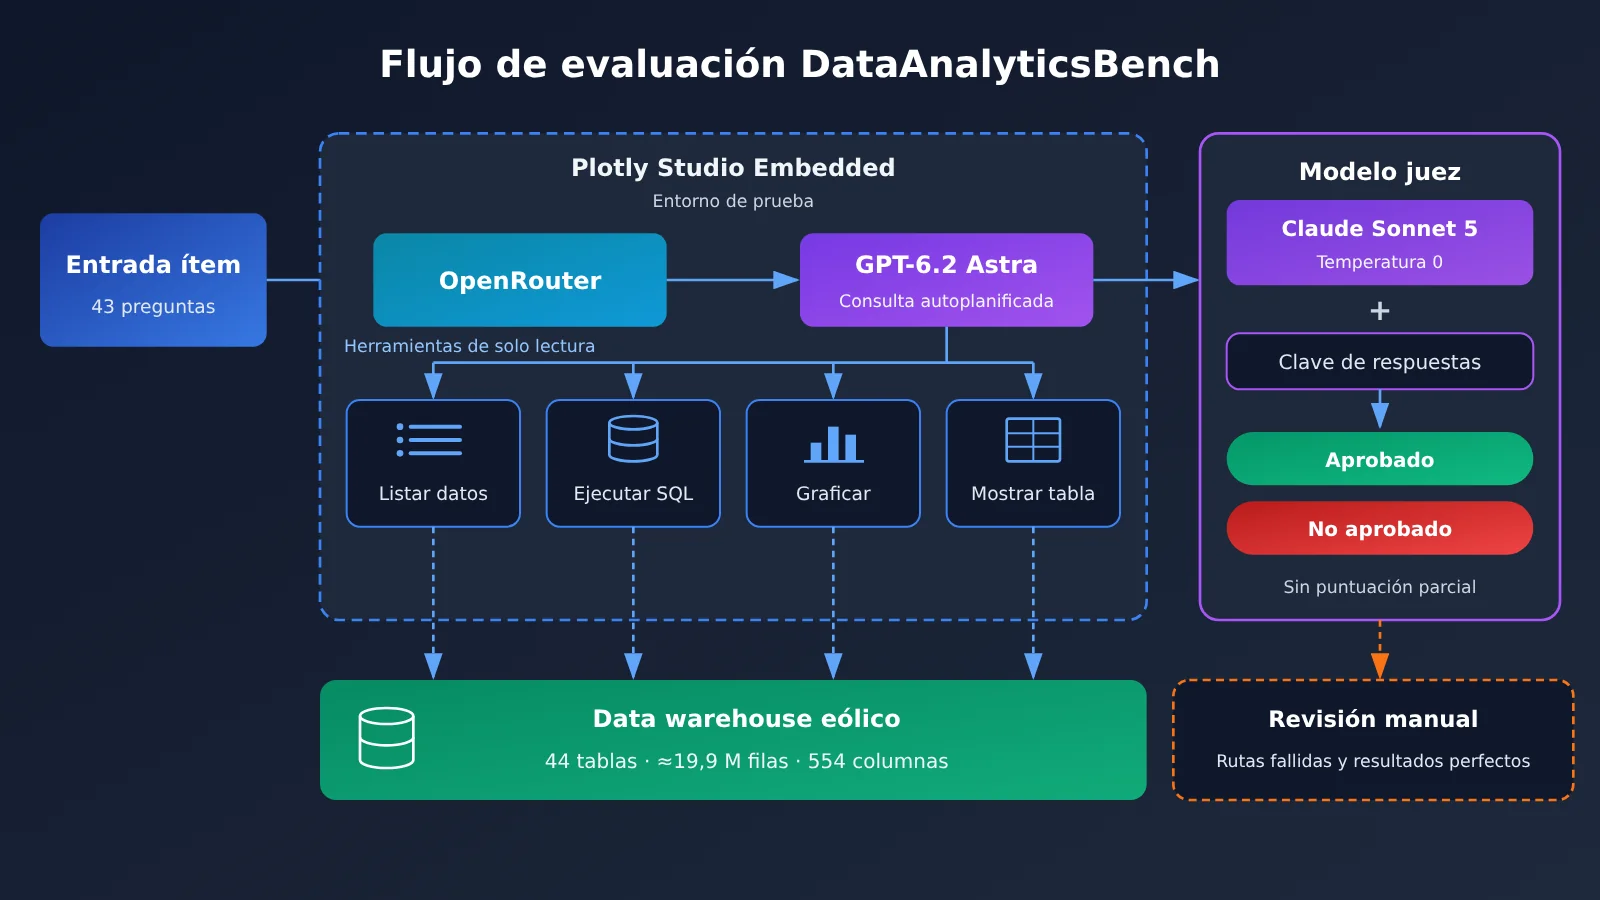
Nota de la ilustración: esta estructura de «el modelo planifica sus propias consultas + herramientas de solo lectura + aprobación pregunta por pregunta» se puede reproducir de forma aproximada en tu propio entorno usando la interfaz compatible con OpenAI de APIYI apiyi.com, para hacer pruebas de comparación internas.
Puntuación de GPT-6.2 Astra en seis tipos de preguntas: las pérdidas se concentran en patrones ocultos
El informe dedicado a Astra que Plotly publicó el 17 de noviembre de 2026 ofrece las puntuaciones por categoría:
| Tipo de pregunta | GPT-6.2 Astra | GPT-6 Astra | Aspecto evaluado |
|---|---|---|---|
| Análisis estándar | 20/20 | 20/20 | SQL de varios pasos, uniones de tablas e intervalos de tiempo |
| Juicio de ambigüedad | 5/5 | 5/5 | Aclarar criterios o explicar supuestos razonables |
| Preguntas no respondibles con los datos | 5/5 | 5/5 | Identificar preguntas que no se pueden responder con los datos disponibles |
| Calidad de datos | 3/3 | 3/3 | Identificar problemas de calidad insertados |
| Trampas estadísticas | 5/5 | 5/5 | Identificar posibles engaños de algoritmos intuitivos |
| Patrones ocultos | 3/5 | 5/5 | Investigar de forma proactiva patrones anómalos no explicitados |
| Total | 41/43 | 43/43 | Cada pregunta tiene el mismo peso; se evalúa aprobado/no aprobado por pregunta |
Las primeras cinco categorías suman 38/38, con un desempeño idéntico entre ambas generaciones. Toda la diferencia proviene de las preguntas de patrones ocultos: la nueva generación obtuvo 3/5 y la generación anterior, 5/5.
Las dos preguntas falladas fueron revisadas manualmente por Plotly y fallaron de maneras distintas:
- En una, el modelo nunca llegó a localizar el patrón insertado.
- En la otra, el modelo encontró la ubicación que debía investigar, pero descartó la causa real.
El informe también aporta un dato sobre el proceso: en las preguntas de patrones ocultos, GPT-6.2 Astra ejecutó en promedio unas 9 consultas a la base de datos por pregunta, mientras que GPT-6 Astra ejecutó unas 15.
Fuente: Plotly, GPT-6.2 Astra Benchmark Results for Data Analysis, 2026-11-17, plotly.com/blog/gpt-6-2-astra-plotly-data-analytics-bench/
GPT-6.2 Astra: costos y tiempo — comparación entre dos generaciones y modelos del mismo proveedor
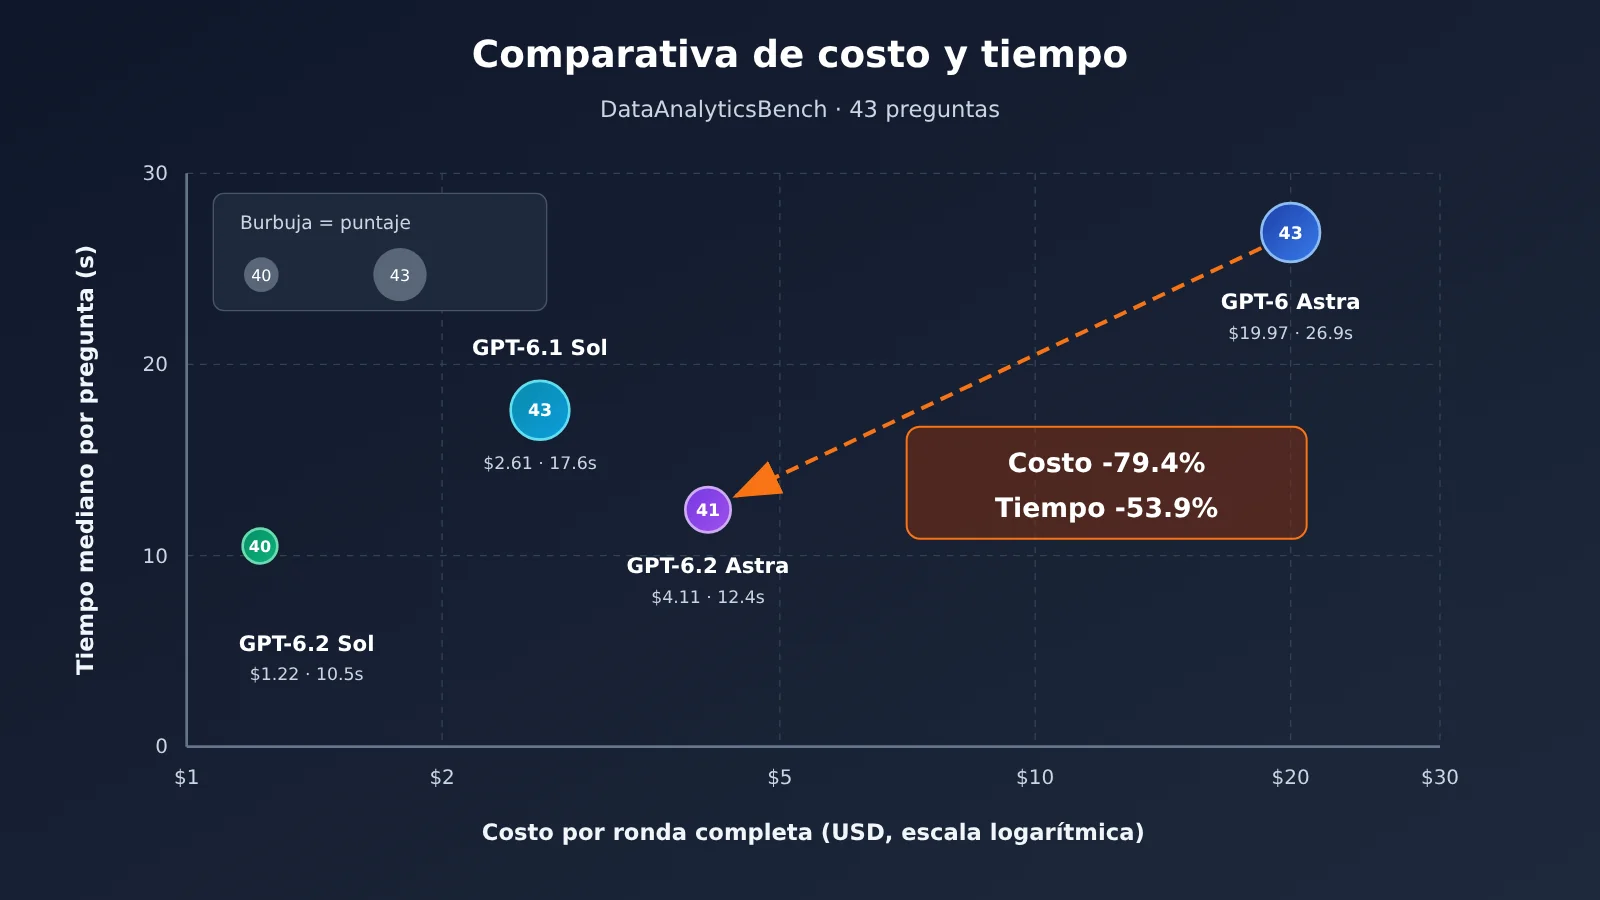
| Modelo | Puntuación | Costo de la ronda completa | Tiempo mediano por pregunta |
|---|---|---|---|
| GPT-6.2 Astra | 41/43 | $4.11 | 12.4 s |
| GPT-6 Astra | 43/43 | $19.97 | 26.9 s |
| GPT-6.1 Sol | 43/43 | $2.61 | 17.6 s |
| GPT-6.2 Sol | 40/43 | $1.22 | 10.5 s |
Según los cálculos de la tabla original, GPT-6.2 Astra reduce el costo de la ronda completa en aproximadamente 79.4% frente a la generación anterior, y recorta el tiempo mediano por pregunta en cerca de 53.9%. En las pruebas del autor, la ronda completa de 6.2 Astra dura unos 13 minutos, mientras que la de la generación anterior ronda los 32 minutos. El tiempo aquí corresponde al tiempo real transcurrido, incluidas las consultas a herramientas, no al tiempo de inferencia pura del modelo.
Hay dos métricas de costo por pregunta que conviene distinguir: al dividir $4.11 ÷ 43 se obtiene un promedio de aproximadamente $0.096 por pregunta; en cambio, la tabla general actualizada marca $0.066 como la mediana del costo por pregunta de esta ronda. El valor promedio es superior a la mediana, lo que indica que unas pocas preguntas costaron bastante más y elevaron el promedio.
Plotly también ofrece el desglose de carga de trabajo de las rondas originales de ambas generaciones:
| Métrica de carga de trabajo | GPT-6 Astra (generación anterior) | GPT-6.2 Astra |
|---|---|---|
| Llamadas a herramientas | 266 | 148 |
| Llamadas al modelo | 249 | 171 |
| Tokens de entrada | ≈ 9.1 millones | ≈ 4.4 millones |
| Tokens de salida | ≈ 78 mil | ≈ 34 mil |
| Proporción de aciertos de caché de entrada | 93% | 98% |
Plotly recalculó con las nuevas tarifas el mismo uso de la generación anterior, estimando alrededor de $11. Conviene tener en cuenta que estos costos provienen de los precios de OpenRouter vigentes en el momento de las pruebas de Plotly, no de una conversión directa de la lista de precios oficial de OpenAI.
Fuente: informe específico de Plotly sobre Astra plotly.com/blog/gpt-6-2-astra-plotly-data-analytics-bench/; tabla general de Plotly plotly.com/blog/introducing-dataanalyticsbench/#full-results
Identidad del modelo GPT-6.2 Astra y las cifras oficiales de precio
OpenAI lanzó GPT-6.2 Astra y GPT-6.2 Sol el 17 de noviembre de 2026. Astra está orientado a razonamiento complejo, programación y trabajo profesional, y su ID de modelo en la API es gpt-6.2-astra. Las evaluaciones que aparecen en el anuncio de OpenAI son cifras del propio fabricante; DataAnalyticsBench de Plotly es otro conjunto de evaluaciones de terceros, y no se deben mezclar ni comparar entre sí.
Según la ficha del modelo, Astra acepta entrada de texto e imágenes y produce salida de texto, con una ventana de contexto de 1.050.000 tokens, un máximo de 922.000 tokens de entrada y un máximo de 128.000 tokens de salida. Es compatible tanto con la Responses API como con la Chat Completions API, y las capacidades de herramientas integradas, Multi-agent y ventanas de finalización en segundo plano se rigen por la Responses API. La ficha también indica que las solicitudes con reasoning.effort establecido en none se rechazan.
Los precios estándar de OpenAI para solo texto con contexto corto (por millón de tokens) son: entrada normal $8, entrada con acierto de caché $0.40 y salida $40. La compañía afirma que, en comparación con la generación anterior, el precio unitario de la entrada normal y de la salida baja un 20%, y el de la entrada con acierto de caché baja un 60%.
Fuentes: anuncio de OpenAI openai.com/index/introducing-gpt-6-2-astra-sol/; ficha del modelo developers.openai.com/api/docs/models/gpt-6.2-astra; registro de cambios de la API developers.openai.com/api/docs/changelog; tabla de precios developers.openai.com/api/docs/pricing
Análisis y conclusiones sobre GPT-6.2 Astra DataAnalyticsBench
Cómo interpretar 41/43: no es un “debilitamiento general”
Si desglosamos 41/43, GPT-6.2 Astra no perdió puntos en las cinco categorías: análisis convencional, ambigüedad, preguntas no respondibles, calidad de datos y trampas estadísticas. Estas cinco categorías cubren la mayor parte de los escenarios habituales de informes y verificación de criterios. Si el negocio se concentra sobre todo en este tipo de preguntas, a la luz de los datos de esta ronda, la calidad de la nueva generación de Astra es comparable a la de la generación anterior, mientras que el costo y la velocidad son claramente mejores.
La diferencia de dos preguntas también debe interpretarse dentro del margen de fluctuación. Plotly informó que, al volver a ejecutar pruebas con otros modelos, se han observado fluctuaciones de hasta tres preguntas. Por lo tanto, 41 frente a 43 conviene tomarlo como “el valor observado de esta ronda”, no como una diferencia de capacidad estable. La afirmación más precisa es: en la categoría de patrones ocultos apareció una señal que vale la pena seguir, pero los datos de una sola ronda aún no bastan para confirmar que existe una degradación.
Por qué conviene volver a evaluar las preguntas de patrones ocultos: una hipótesis explicativa sobre la profundidad de exploración
Lo que sigue es una hipótesis explicativa basada en los datos del informe, no una conclusión de Plotly. En las preguntas de patrones ocultos, la nueva generación hace unas 9 consultas por pregunta de media, frente a unas 15 de la generación anterior. En las dos preguntas en las que falló, el comportamiento fue uno de «no lo encontró» y otro de «encontró la ubicación, pero descartó la causa real». Ambas parecen responder a la misma lógica: «dejar de buscar antes de profundizar lo suficiente». En el primer caso, el alcance de exploración fue insuficiente; en el segundo, se llegó a una conclusión negativa demasiado pronto durante la fase de verificación.
Es posible que esto y la reducción de costes y latencia provengan del mismo cambio de comportamiento: el modelo tiende más a responder tras menos consultas. En las preguntas habituales, esa tendencia se traduce directamente en eficiencia; en las preguntas de causa raíz, que exigen formular y verificar hipótesis de forma iterativa, puede convertirse en un riesgo. Para validar esta hipótesis, hay que contrastar en los propios datos la relación entre el número de consultas y la tasa de aciertos, en lugar de fijarse solo en la puntuación total.
Por qué bajaron a la vez el coste y el tiempo de respuesta de GPT-6.2 Astra
La caída de $19.97 a $4.11 puede dividirse en dos partes, según los datos recalculados por Plotly:
- Factor de tarifa: si se recalculara el consumo de la generación anterior con las nuevas tarifas, daría unos $11; es decir, solo con la bajada de precios, el coste pasaría de $19.97 a $11, una reducción de alrededor del 45%. El precio unitario oficial de entrada en caché se redujo un 60% y, en escenarios con una tasa de aciertos de caché del 93% al 98%, este efecto resulta especialmente notable.
- Factor de volumen de trabajo: el paso de unos $11 a $4.11 se explica por una reducción del volumen de trabajo. Las llamadas a herramientas bajaron de 266 a 148, los tokens de entrada pasaron de unos 9,1 millones a unos 4,4 millones, los tokens de salida se redujeron en más de la mitad y la proporción de aciertos de caché subió del 93% al 98%.
Si se calcula a grandes rasgos el consumo de la nueva generación con los precios oficiales, el resultado también queda en el mismo orden de magnitud que $4.11: de unos 4,4 millones de tokens de entrada, el 98% se factura a precio de caché, el resto a precio normal de entrada, y hay que sumar unos 34.000 tokens de salida. Esto indica que, en escenarios como el análisis de datos, con contextos largos y múltiples rondas de llamadas a herramientas, la tasa de aciertos de caché y el número de rondas de llamada pueden influir más en el coste que el propio precio unitario. La mejora de velocidad responde a la misma lógica: menos consultas y menos llamadas al modelo hacen que el tiempo transcurrido se acorte de forma natural.
💰 Consejo de costes: al evaluar el coste de este tipo de tareas de tipo Agent, hay que registrar los tokens con acierto de caché y el número de rondas de llamadas a herramientas; no basta con mirar solo la tabla de precios unitarios. Cuando se hacen llamadas por consumo a través de APIYI apiyi.com, se puede contrastar el campo usage de la factura y los logs para comprobar si la caché está surtiendo efecto.
GPT-6.2 Astra frente a GPT-6.1 Sol y GPT-6.2 Sol: cómo decidir
Los cuatro modelos ocupan posiciones distintas:
- GPT-6.1 Sol: con esta configuración, logra 43/43 por $2.61 y es la opción más económica entre las que obtuvieron puntuación perfecta en esta ronda; el precio a pagar es una mediana de tiempo de 17.6 segundos, más lento que GPT-6.2 Astra.
- GPT-6.2 Astra: 41/43, $4.11 y 12.4 segundos. Su ventaja aparece cuando se comparan puntuación y velocidad al mismo tiempo. Si solo se consideran coste y puntuación, no lleva ventaja.
- GPT-6.2 Sol: $1.22 y 10.5 segundos, el más barato y el más rápido, pero su puntuación de 40/43 es la más baja.
- GPT-6 Astra: puntuación perfecta, pero tanto el coste como la latencia son claramente más altos; en esta comparación ya resulta difícil encontrar una razón para elegirlo como primera opción.
Las diferencias entre ellos quedan dentro del margen de fluctuación de como máximo tres preguntas mencionado por Plotly. Esto significa que, si solo se mira la puntuación total, resulta difícil establecer un orden fiable; las dimensiones que realmente permiten una distinción fiable son el coste y la latencia. En la práctica, los productos interactivos de consulta de datos son sensibles a la latencia, por lo que conviene comparar primero GPT-6.2 Astra y GPT-6.2 Sol; el análisis por lotes offline no es sensible a la latencia, así que la relación calidad-precio de GPT-6.1 Sol merece más atención.
Cómo volver a evaluar GPT-6.2 Astra con tus propios datos
El siguiente método de reevaluación es una recomendación de la redacción. DataAnalyticsBench solo cubre operaciones de energía eólica, en inglés y en un único entorno, lo que difiere bastante del almacén de datos real de la mayoría de los equipos. Un enfoque más seguro consiste en crear un pequeño conjunto de preguntas con tus propios datos, fijar los datos, las herramientas y las indicaciones, ejecutar varias rondas y medir por separado el desempeño en cada tipo de tarea.
| Subconjunto | Número de preguntas sugerido | Qué registrar principalmente | Uso para decidir |
|---|---|---|---|
| Informes rutinarios | 15-20 preguntas | Tasa de éxito, latencia mediana | ¿Se pueden delegar al modelo las consultas diarias de datos con confianza? |
| Criterios ambiguos | Alrededor de 5 preguntas | ¿Aclara de forma proactiva o explica los supuestos? | Evitar que «elija un criterio en silencio» |
| Sesgos estadísticos | Alrededor de 5 preguntas | ¿Detecta trampas como la paradoja de Simpson? | Credibilidad de las conclusiones |
| Causa raíz de anomalías | 5-8 preguntas | Tasa de éxito, número de consultas, latencia P90 | Validar las señales de pérdida de puntos en preguntas con patrones ocultos |
| Todas las preguntas | — | Costo total por ronda, tasa de aciertos de caché | Presupuesto de costos |
Para cada modelo, se recomienda ejecutar al menos 3 rondas y registrar la media y la variación. La latencia de cola (P90) debe registrarse por separado: una mediana atractiva no significa que las preguntas más lentas sean aceptables.
A continuación, un ejemplo mínimo de invocación. El ID del modelo es gpt-6.2-astra, publicado por OpenAI; los modelos disponibles son los que aparezcan en la lista de la plataforma:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

resp = client.chat.completions.create(
    model="gpt-6.2-astra",
    reasoning_effort="medium",  # la ficha del modelo indica que las solicitudes con effort none se rechazarán
    messages=[{"role": "user", "content": "上月各风场故障工单数环比变化最大的是哪个?请说明计算口径。"}],
)
print(resp.choices[0].message.content)
Ver el script completo de reevaluación: tasa de éxito, costo y latencia P50/P90 por subconjunto
import time
import statistics
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

MODELS = ["gpt-6.2-astra", "gpt-6-astra", "gpt-6.1-sol", "gpt-6.2-sol"]

# Conjunto de preguntas propio: category corresponde al subconjunto de la tabla de retest; checker lo implementas tú según la clave de respuestas
TASKS = [
    {"id": "r01", "category": "常规报表", "prompt": "...", "checker": lambda a: "..." in a},
    {"id": "h01", "category": "异常根因", "prompt": "...", "checker": lambda a: "..." in a},
]

# Precio unitario de la conexión directa oficial (USD/millón de tokens), solo para una estimación aproximada; lo que factura realmente la plataforma es lo que cuenta
PRICE = {"input": 8.0, "cached": 0.40, "output": 40.0}

def estimate_cost(usage):
    cached = getattr(getattr(usage, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    fresh = usage.prompt_tokens - cached
    return (fresh * PRICE["input"] + cached * PRICE["cached"]
            + usage.completion_tokens * PRICE["output"]) / 1_000_000

def p90(values):
    values = sorted(values)
    return values[max(0, int(len(values) * 0.9) - 1)]

def run(model, rounds=3):
    stats = {}
    for _ in range(rounds):
        for t in TASKS:
            start = time.perf_counter()
            resp = client.chat.completions.create(
                model=model,
                reasoning_effort="medium",
                messages=[{"role": "user", "content": t["prompt"]}],
            )
            elapsed = time.perf_counter() - start
            answer = resp.choices[0].message.content or ""
            s = stats.setdefault(t["category"], {"pass": 0, "n": 0, "lat": [], "cost": 0.0})
            s["n"] += 1
            s["pass"] += int(t["checker"](answer))
            s["lat"].append(elapsed)
            s["cost"] += estimate_cost(resp.usage)
    for cat, s in stats.items():
        print(f"{model} | {cat} | 通过率 {s['pass']}/{s['n']} | "
              f"P50 {statistics.median(s['lat']):.1f}s | P90 {p90(s['lat']):.1f}s | "
              f"估算费用 ${s['cost']:.3f}")

for m in MODELS:
    run(m)
Este script solo hace preguntas y respuestas de una sola ronda. Si quieres acercarte a la configuración de DataAnalyticsBench, también hay que conectar una herramienta SQL de solo lectura, para que el modelo consulte por su cuenta durante varias rondas, y registrar además el número de llamadas a herramientas por pregunta, de modo que puedas poner a prueba la hipótesis que planteamos antes sobre «número de consultas y puntos perdidos».
🎯 Sugerencia para la nueva prueba: los cuatro modelos usan el protocolo compatible con OpenAI, así que puedes cambiar entre ellos con la misma clave API a través de APIYI apiyi.com. La cuota de prueba gratuita para usuarios nuevos alcanza para correr primero un conjunto pequeño de preguntas y luego decidir si vale la pena ampliar la escala.
Lo que publican los rankings solo marca una dirección; cuando se trata de tu propio almacén de datos y tus propios tipos de anomalías, las respuestas solo las puedes obtener corriendo tú mismo. Lu You escribió en «Instruyendo a Ziyu en una noche de invierno mientras leía»: «Lo que se aprende sobre el papel siempre resulta superficial; para dominar de verdad algo, hay que ponerlo en práctica uno mismo.»
Autor: Equipo técnico de APIYI
Contacto técnico: puedes escribirnos desde la página principal de APIYI apiyi.com; más materiales de integración están disponibles en el centro de documentación docs.apiyi.com