Resumen: la API de la suite completa de DeepSeek factura por separado los tokens del modelo y las llamadas a herramientas. El costo completo debe calcularse elemento por elemento según el número de búsquedas, las páginas de archivo, el volumen de procesamiento de voz y la tasa de aciertos de caché.
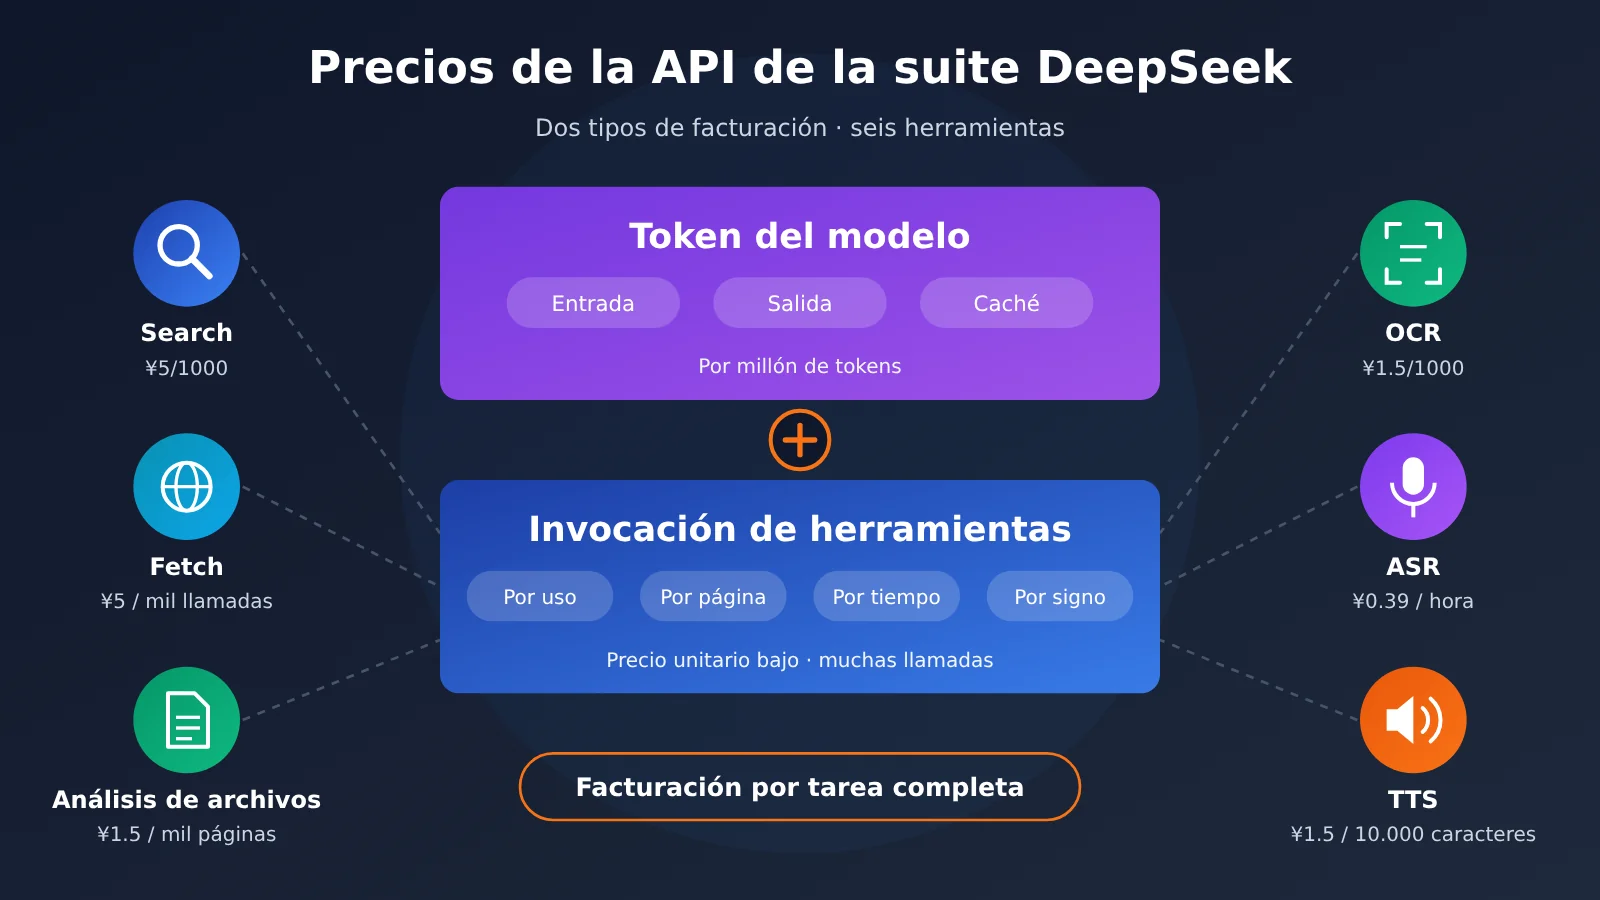
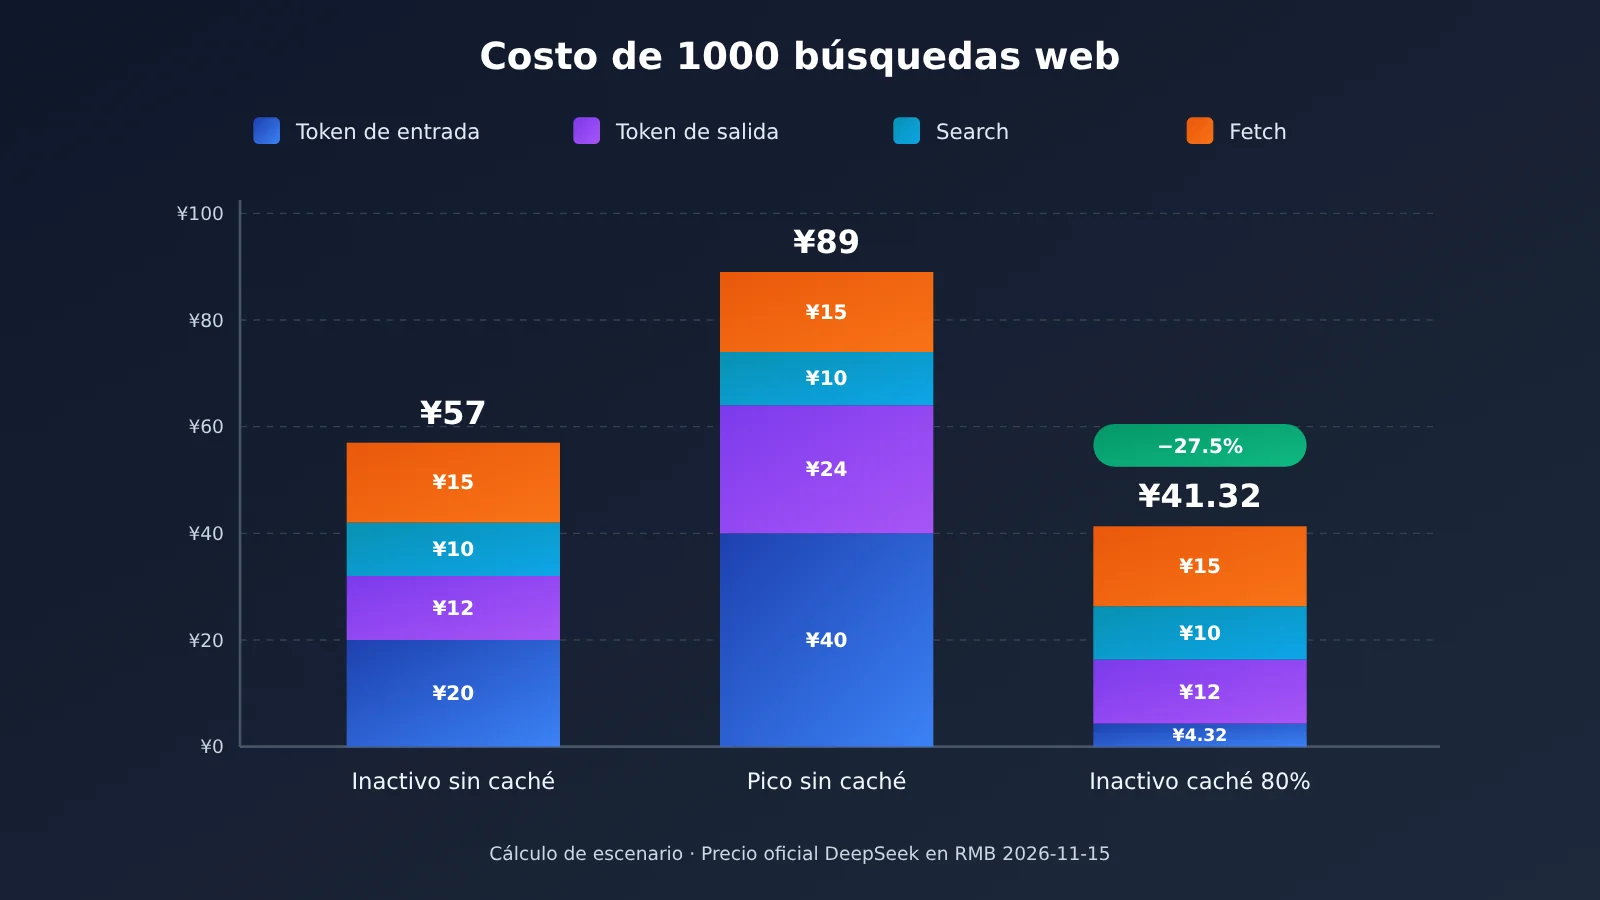
Primero, la conclusión: según el documento oficial de precios de DeepSeek en chino, del 15 de noviembre de 2026, Search y Fetch cuestan ¥5 por cada 1000 solicitudes exitosas; el análisis de archivos y el OCR cuestan ¥1.5 por cada 1000 páginas; el precio promocional por tiempo limitado de ASR es ¥0.39 por hora; y el precio promocional por tiempo limitado de TTS es ¥1.5 por cada 10,000 caracteres facturables. El precio unitario de las herramientas es muy bajo, pero la factura de una tarea de agente con conexión a internet normalmente está dominada por los tokens del modelo. Según el cálculo para una tarea de investigación con “2 búsquedas, 3 recuperaciones, 20,000 tokens de entrada y 3,000 tokens de salida”, 1000 tareas cuestan aproximadamente ¥57 en horario valle y ¥89 en horario pico; cuando la caché de entrada tiene una tasa de aciertos del 80%, en horario valle el costo puede bajar a unos ¥41.32. Por eso, al hacer presupuestos, conviene calcular por “tarea completa”; el precio de una sola solicitud a la API es solo uno de los componentes.
A continuación, desglosaremos primero la estructura de facturación de los costos del modelo y de las herramientas, y después enumeraremos uno por uno los precios unitarios y las unidades de facturación de Search, Fetch, análisis de archivos, OCR, ASR y TTS. Luego, con 4 escenarios de supuestos fijos, mostraremos el algoritmo completo y explicaremos cómo la búsqueda profunda, el contexto largo y los límites de velocidad afectan la factura. Por último, ofreceremos un código de registro de costos listo para reutilizar y compararemos los criterios para elegir entre la búsqueda integrada del modelo y las interfaces independientes Search / Fetch.
To Know: Terminología de facturación de la API del paquete completo de DeepSeek
| Término | Explicación |
|---|---|
| Token | Unidad de medida que el modelo utiliza al procesar texto; las tarifas del modelo se calculan por millón de tokens |
| Token de entrada | Todo el contenido que entra en el contexto del modelo y participa en la inferencia, incluidas las indicaciones, el contenido de archivos y los resultados de búsqueda |
| Token de salida | El contenido que genera el modelo; en el modo de razonamiento, el proceso de razonamiento también cuenta como salida |
| Context Cache | Reutilizar el contexto procesado previamente para reducir el costo de entradas repetidas |
| Cache Hit | El contenido de entrada reutiliza con éxito el caché y se factura a un precio unitario menor de «acierto de caché» |
| Horario pico / horario valle | DeepSeek distingue dos niveles de precios según la hora de Pekín; el precio en horario valle es la mitad del precio en horario pico |
| Search API | Consulta páginas web por palabra clave y devuelve resultados de búsqueda estructurados |
| Fetch API | Obtiene una página web específica y devuelve el contenido del texto principal |
| Búsqueda integrada del modelo | Declarar la herramienta de búsqueda en la solicitud de conversación; el modelo decide por sí mismo cuándo buscar y el servidor ejecuta la búsqueda en su lugar |
| QPS | Número de solicitudes que se pueden procesar por segundo |
| OCR | Reconocer texto a partir de imágenes o documentos |
| ASR | Convertir voz en texto |
| TTS | Sintetizar texto en voz |
| Carácter facturable | Unidad de medida de TTS; cada carácter chino cuenta como 2 caracteres facturables |
| Tool Usage | Uso facturable generado cuando el modelo o el programa llama realmente a herramientas externas |
1 ¿Cómo se cobra realmente la API de la suite completa de DeepSeek?
1.1 Los dos tipos de cargos de la API de la suite completa de DeepSeek: costos de modelo y costos de herramientas
El 13 de noviembre de 2026, DeepSeek abrió como API las capacidades que están detrás de su App: búsqueda web, búsqueda con razonamiento profundo, lectura de enlaces, entrada de archivos, OCR, ASR, TTS y verificación de seguridad, entre otras. En la facturación, estas capacidades y la inferencia del modelo se cobran por separado. Se puede resumir con una fórmula:
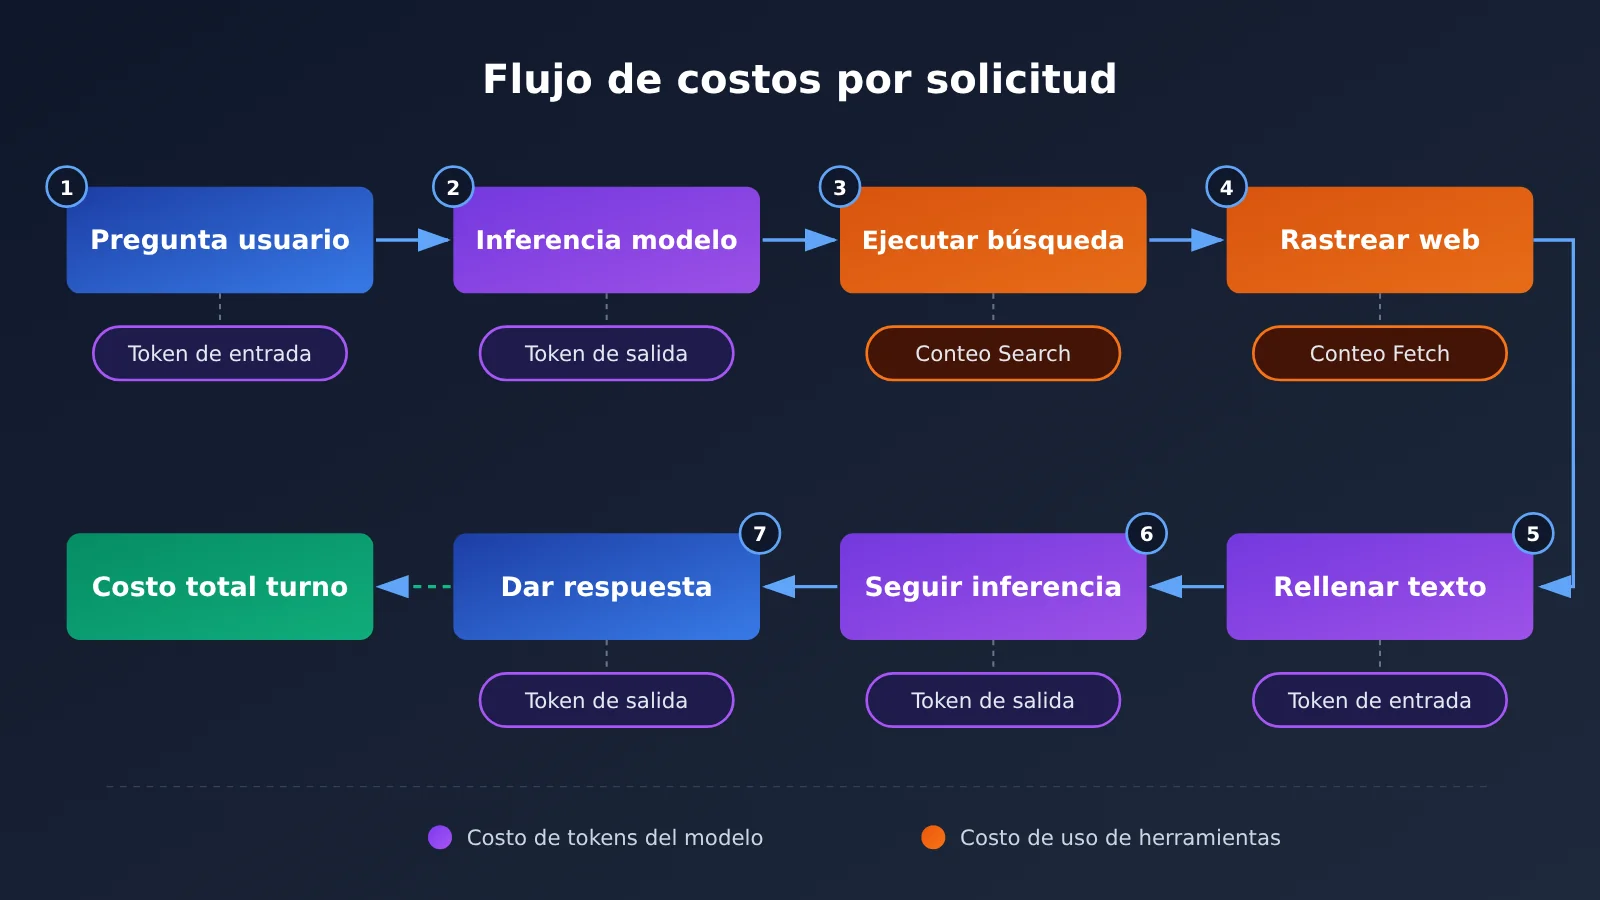
Costo total = costo de entrada del modelo (aciertos de caché + fallos de caché)
            + costo de salida del modelo (incluidos tokens de razonamiento)
            + costo de invocación de herramientas (Search / Fetch / búsqueda de imágenes)
            + costo de procesamiento de archivos y voz (páginas procesadas / páginas OCR / duración de audio / caracteres TTS)
Una misma ronda de preguntas y respuestas puede generar al mismo tiempo cada uno de esos cargos. Por ejemplo, al activar la búsqueda con razonamiento profundo en una conversación, el modelo genera varias consultas de búsqueda, abre varias páginas web y luego incorpora el contenido de las páginas al contexto para seguir razonando. Esa solicitud genera cargos por búsqueda y obtención de páginas, y también muchos tokens de entrada porque el texto de las páginas entra en el contexto; además, el proceso de razonamiento se cuenta como tokens de salida.
1.2 Precios de los modelos DeepSeek Flash y Pro
Estos son los precios publicados en la documentación oficial de precios de DeepSeek el 15 de noviembre de 2026. La moneda es el yuan (RMB) y la unidad es por cada millón de tokens.
| Modelo | Aciertos de caché (valle / pico) | Fallos de caché (valle / pico) | Salida (valle / pico) | Límite de concurrencia |
|---|---|---|---|---|
| DeepSeek-V4.1-Flash | ¥0.02 / ¥0.04 | ¥1 / ¥2 | ¥4 / ¥8 | 2500 |
| DeepSeek-V4-Pro | ¥0.15 / ¥0.30 | ¥4.5 / ¥9 | ¥13.5 / ¥27 | 500 |
El horario pico es de 09:00 a 12:00 y de 14:00 a 18:00, hora de Beijing, de lunes a viernes, excluidos los días festivos oficiales de China; el resto del tiempo (incluidos los fines de semana y los días festivos completos) es horario valle. Ambos modelos tienen una ventana de contexto de 1M y una salida máxima de 384K; Flash admite comprensión de imágenes, Pro no.
La elección del modelo también afecta la disponibilidad de herramientas. En este anuncio, la integración completa de herramientas a nivel de conversación (búsqueda web, búsqueda con razonamiento profundo, lectura de enlaces, análisis de archivos, comprensión de imágenes y verificación de seguridad) corre sobre deepseek-flash (DeepSeek-V4.1-Flash). Si planeas una aplicación que necesite herramientas integradas, toma Flash como referencia para construir el modelo de costos.
2 ¿Cuánto cuestan Search, Fetch, OCR, ASR y TTS en la suite completa de API de DeepSeek?
La siguiente tabla muestra los precios oficiales de las herramientas de DeepSeek (15 de noviembre de 2026, en yuanes). El «precio de lista» y la «oferta por tiempo limitado» aparecen por separado; cuando finalice la oferta por tiempo limitado, deberás volver a presupuestar con el precio de lista.
| Capacidad | Unidad de facturación | Precio de lista | Oferta por tiempo limitado | Equivalencia por solicitud/unidad |
|---|---|---|---|---|
| Search (búsqueda) | 1000 solicitudes exitosas | ¥5 | ¥5 | ¥0.005 / solicitud |
| Fetch (extracción web) | 1000 solicitudes exitosas | ¥5 | ¥5 | ¥0.005 / solicitud |
| Análisis de archivos | 1000 páginas | ¥1.5 | ¥1.5 | ¥0.0015 / página |
| OCR | 1000 páginas | ¥1.5 | ¥1.5 | ¥0.0015 / página |
| ASR | 1 hora de audio | ¥0.78 | ¥0.39 | menos de 1 segundo se cuenta como 1 segundo |
| TTS | 10000 caracteres facturables | ¥3 | ¥1.5 | un carácter chino cuenta como 2 caracteres |
2.1 Cómo se facturan Search y Fetch de DeepSeek
Search independiente se factura por solicitudes exitosas: solo cuenta como éxito si el HTTP es 200 y el array results no está vacío. Una sola solicitud puede devolver de 1 a 50 resultados (count por defecto es 10); devolver 1 o 50 resultados cuesta lo mismo, así que pedir más resultados de una vez ahorra más que hacer varias solicitudes con pocos resultados. Fetch independiente requiere HTTP 200 y que se devuelva correctamente el cuerpo de la página; los fallos, los tiempos de espera agotados y la ausencia de resultados no se cobran.
Los criterios de cómputo de la búsqueda integrada en el modelo son distintos. La búsqueda de texto integrada se factura según el número de términos de consulta realmente ejecutados: si una llamada a la herramienta incluye 3 términos de consulta, se cobra como 3. La búsqueda de imágenes integrada se factura según el número de imágenes devueltas y de áreas recuadradas; la extracción web integrada se factura según el número de páginas extraídas correctamente. Por eso, cuando activas la búsqueda en una conversación, es normal que una ronda de preguntas y respuestas genere varios cargos por búsqueda.
2.2 Facturación por página del análisis de archivos y OCR de DeepSeek
El análisis de archivos se realiza mediante Files API: se sube el archivo, el servidor lo procesa y devuelve file_id; basta referenciar file_id en la conversación. La facturación se basa en las páginas procesadas correctamente, a ¥1.5 por cada 1000 páginas. Si después vuelves a referenciar el mismo archivo ya procesado en una conversación, no se cobra de nuevo el análisis, pero cada vez que el contenido del archivo entra en el contexto se factura como tokens de entrada.
El modo de análisis también afecta al uso de tokens. text_recognition solo entrega texto plano al modelo; rich_layout_recognition recorta gráficos y tablas como imágenes y las envía al modelo junto con el texto, lo que resulta adecuado para informes financieros y PPT, pero aumenta los tokens de imagen. Archivos como XLSX, CSV, TXT, MD, JSON y EPUB se pueden subir como user_data y convertirse a Markdown; este tipo de carga no conlleva cargo por análisis.
OCR es una interfaz independiente (/v1/tools/ocr), también a ¥1.5 por cada 1000 páginas, facturada según las páginas reconocidas correctamente; los fallos y los tiempos de espera agotados no se cobran. Sus enfoques son distintos: OCR solo se encarga de extraer texto e información de posición, mientras que el análisis de archivos envía el resultado directamente al contexto del modelo para que lo comprenda.
2.3 Facturación de voz de DeepSeek ASR y TTS
ASR (/v1/tools/asr) tiene un precio de lista de ¥0.78 por hora de audio; actualmente, con un 50% de descuento por tiempo limitado, ¥0.39. Menos de 1 segundo se cobra como 1 segundo. Utiliza carga de archivo completo y reconocimiento no en streaming; un solo audio puede durar como máximo 120 segundos y pesar como máximo 8 MiB; admite WAV PCM de 16 bits y Ogg Opus; la concurrencia es de 50 por cuenta. Las grabaciones largas deben dividirse primero en segmentos; la parte final de menos de 1 segundo de cada segmento se redondea hacia arriba por separado, así que cuanto más fragmentados estén los segmentos, mayor será la acumulación de redondeos.
TTS (/v1/tools/tts, también admite síntesis en streaming por WebSocket) tiene un precio de lista de ¥3 por cada 10000 caracteres facturables, y un precio por tiempo limitado de ¥1.5. Cada carácter chino cuenta como 2 caracteres facturables; las letras inglesas, los números y los espacios cuentan como 1; la entrada máxima por solicitud es de 10000 caracteres facturables. En términos prácticos, 100 000 caracteres facturables equivalen aproximadamente a 50 000 caracteres chinos, así que el presupuesto para contenido en chino debe multiplicarse por 2 de antemano.
3 Estimación de costos del conjunto de APIs de DeepSeek en cuatro escenarios
Los siguientes 4 casos se calculan a partir de precios unitarios públicos y supuestos fijos. El número de invocaciones y el consumo de tokens son valores hipotéticos: son estimaciones por escenario que ilustran el método de cálculo, y la factura real se rige por los campos de facturación devueltos por el servidor.
3.1 Escenario 1: 1000 tareas de investigación con acceso a internet (fuera de horas pico ¥57 / horas pico ¥89)
Supuestos: se usa DeepSeek-V4.1-Flash; cada tarea incluye 2 consultas de búsqueda exitosas, 3 páginas web rastreadas con éxito, 20000 tokens de entrada sin caché y 3000 tokens de salida.
| Concepto | Fórmula de cálculo | Fuera de horas pico (¥/vez) | Horas pico (¥/vez) |
|---|---|---|---|
| Tokens de entrada | 20000 ÷ 1000000 × precio unitario | 0.020 | 0.040 |
| Tokens de salida | 3000 ÷ 1000000 × precio unitario | 0.012 | 0.024 |
| Search | 2 × ¥0.005 | 0.010 | 0.010 |
| Fetch | 3 × ¥0.005 | 0.015 | 0.015 |
| Total por vez | — | 0.057 | 0.089 |
| Total por 1000 veces | Total por vez × 1000 | ¥57 | ¥89 |
En horas pico, el costo de tokens del modelo se duplica, mientras que los precios de Search y Fetch no cambian, así que la factura total pasa de ¥57 a ¥89, un aumento de aproximadamente 56%. En esta tarea, el costo del modelo representa cerca del 56% de la factura fuera de horas pico (¥32 / ¥57), lo que indica que el mayor gasto de un agente con acceso a internet sigue estando en los tokens. Programar las tareas por lotes que se pueden posponer fuera de horas pico es la forma más directa de reducir costos.
3.2 Escenario 2: ¿cuánto se ahorra con un 80 % de aciertos en la caché de entrada?
Supuesto: mismas condiciones que el escenario 1 (franja de poca actividad), pero de los 20 000 tokens de entrada, 16 000 aciertan en la caché y 4000 no.
- Entrada con acierto de caché: 16000 ÷ 1000000 × ¥0.02 = ¥0.00032
- Entrada sin acierto de caché: 4000 ÷ 1000000 × ¥1 = ¥0.004
- Salida: 3000 ÷ 1000000 × ¥4 = ¥0.012
- Búsqueda + recuperación: ¥0.010 + ¥0.015 = ¥0.025
- Total por llamada ¥0.04132, total de 1000 llamadas ¥41.32
Frente a los ¥57 del escenario 1, supone un ahorro de ¥15.68, alrededor del 27.5%. La caché solo actúa sobre el coste de entrada: la entrada baja de ¥0.020 a unos ¥0.0043, mientras que el coste de salida y el de herramientas no cambia en absoluto. Cuanto mayor sea la tasa de aciertos de caché, más se acercará la factura al límite inferior de «salida + herramientas»; a partir de ese punto, seguir recortando costes depende de reducir el número de búsquedas y de controlar la longitud de la salida.
3.3 Escenario 3: procesamiento por lotes de 5000 páginas de documentos empresariales
Supuesto: franja de baja actividad de Flash; las 5000 páginas se analizan una sola vez; el análisis posterior acumula 10 millones de tokens de entrada con fallo de caché y 1 millón de tokens de salida.
- Análisis de archivos: 5000 ÷ 1000 × ¥1.5 = ¥7.50
- Entrada del modelo: 10000000 ÷ 1000000 × ¥1 = ¥10.00
- Salida del modelo: 1000000 ÷ 1000000 × ¥4 = ¥4.00
- Total ¥21.50
La tarifa de análisis representa solo alrededor del 35 %. Si el mismo lote de archivos se metiera entero en el contexto una y otra vez durante varias rondas de conversación, los tokens de entrada se multiplicarían, mientras que la tarifa de análisis ya no aumentaría. La clave en escenarios con documentos grandes es controlar «cuántas veces el contenido de los archivos entra en el contexto».
3.4 Escenario 4: 10 horas de reconocimiento de voz + TTS de 100 000 caracteres facturables
Supuesto: se usa el precio actual con 50 % de descuento por tiempo limitado; ASR con 10 horas de audio y TTS con 100000 caracteres facturables.
- ASR: 10 × ¥0.39 = ¥3.90
- TTS: 100000 ÷ 10000 × ¥1.5 = ¥15.00
- Total ¥18.90
Este costo solo cubre el servicio de voz. Cuando el texto transcrito se pasa al modelo conversacional para resúmenes o preguntas y respuestas, los tokens del modelo se facturan aparte. Según el precio de lista, el mismo consumo sería 10 × ¥0.78 + 10 × ¥3 = ¥37.80; cuando termine la promoción, el presupuesto de voz se duplicará. Además, con un límite de 120 segundos, las 10 horas de audio se dividen en al menos 300 segmentos, lo que exige coordinar una concurrencia de 50.
4 ¿Qué factores hacen subir la factura de la API del conjunto completo de DeepSeek?
4.1 La búsqueda de pensamiento profundo ejecuta varios términos de consulta en una sola vez
La búsqueda de pensamiento profundo puede invocar hasta unas 20 herramientas antes de responder, y el cobro se acumula según las acciones reales. Algunas reglas clave de las condiciones oficiales de facturación:
- Una llamada Search con 3 términos de consulta y todos con resultados cuenta como 3 búsquedas.
- Una búsqueda de imágenes que devuelve 3 imágenes cuenta como 3 veces; si el modelo además selecciona 2 regiones de la imagen, se cobran 2 veces adicionales.
- Abrir con éxito 1 página web que requiere captura desde Internet cuenta como 1 Fetch; volver a abrir la misma página no se cobra de nuevo.
- Ejecutar
find_in_pagesobre una página ya abierta no se cobra por separado; una búsqueda sin resultados no se cobra. - Cuando está activada la seguridad de contenido del modelo, algunas páginas, aunque aparezcan como
url_not_allowedounavailable, pueden seguir cobrándose si la captura subyacente se realizó con éxito.
Para hacer el cálculo, usa los campos de facturación server_tool_use.tool_search, tool_fetch y tool_image_search. web_search_requests y web_fetch_requests solo muestran la cantidad de bloques devueltos y pueden incluir solicitudes fallidas; calcular con ellos sobreestima el costo.
4.2 Contextos largos y archivos de entrada repetidos
Los resultados de búsqueda, el cuerpo de las páginas web y los archivos ya procesados entran todos en el contexto. La herramienta de lectura de enlaces considera como máximo 10 URL diferentes en el último mensaje del usuario; cuando se leen varias páginas a la vez, el contexto disponible por página se reduce, pero el volumen total de entrada sigue siendo considerable. En conversaciones largas, cada turno arrastra el historial, y los Token de entrada crecen acumulativamente con cada turno.
Hay tres formas de reducir costos: guardar resúmenes y hechos clave en la capa de aplicación y citar el resumen en turnos posteriores; colocar la indicación del sistema, los materiales públicos y las reglas del flujo de trabajo al inicio del contexto y mantenerlos estables para aumentar las posibilidades de acierto en la caché; usar rich_layout_recognition solo cuando sea necesario revisar gráficos.
4.3 Límites de velocidad de solicitudes en tareas por lotes
El límite a nivel de cuenta para Search independiente es de 100 QPS y para Fetch de 25 QPS; esta es la cuota de toda la cuenta y la comparten varias claves API. Fetch también está sujeto a un límite de QPS por dominio de destino, por lo que rastrear de forma concentrada el mismo sitio web dispara más fácilmente un 429. Recomendaciones para el manejo de errores:
- 408, 429, 5xx: reintentar después de un retroceso exponencial y espaciar las solicitudes al mismo dominio.
- 402: saldo insuficiente; primero resuelve el saldo de la cuenta.
- Otros 4xx (como errores de parámetros): corregir la solicitud antes de reenviarla; reintentar no sirve.
Las solicitudes fallidas no se cobran, así que reintentar no aumenta el costo de las herramientas, pero alarga la duración de la tarea. Para tareas de gran volumen, estima el tiempo de finalización tomando como referencia el límite de Fetch de 25 QPS.
5 Cómo diseñar un presupuesto de costos razonable para un Agente DeepSeek
5.1 Registro de costos de la API del paquete completo DeepSeek: inicio rápido
En un entorno de producción hay que registrar como mínimo, por separado: tokens de entrada con acierto de caché, tokens de entrada sin acierto de caché, tokens de salida, número de Search, número de Fetch, número de búsquedas de imágenes, páginas de análisis de documentos, duración de audio y caracteres facturables de TTS. La siguiente función lee directamente el campo usage y calcula el costo de una sola vez; puedes engancharla después de cada solicitud para escribir el log.
# Estimación de costos del paquete completo DeepSeek (RMB, precios oficiales del 2026-11-15)
FLASH = {"cache_hit": 0.02, "cache_miss": 1.0, "output": 4.0}  # ¥/millón de tokens en horario valle
TOOL = {"search": 0.005, "fetch": 0.005, "image_search": 0.005}  # ¥/vez

def estimate_cost(usage: dict, peak: bool = False) -> dict:
    k = 2 if peak else 1  # el precio pico es el doble del valle; el precio de las herramientas no cambia
    stu = usage.get("server_tool_use", {})
    model = (usage.get("cache_read_input_tokens", 0) * FLASH["cache_hit"]
             + usage.get("input_tokens", 0) * FLASH["cache_miss"]
             + usage.get("output_tokens", 0) * FLASH["output"]) / 1e6 * k
    tools = (stu.get("tool_search", 0) * TOOL["search"]
             + stu.get("tool_fetch", 0) * TOOL["fetch"]
             + stu.get("tool_image_search", 0) * TOOL["image_search"])
    return {"model": round(model, 5), "tools": round(tools, 5),
            "total": round(model + tools, 5)}

# Reproducir el escenario 2: 16000 aciertos + 4000 fallos + 3000 de salida + 2 search + 3 fetch
print(estimate_cost({"cache_read_input_tokens": 16000, "input_tokens": 4000,
                     "output_tokens": 3000,
                     "server_tool_use": {"tool_search": 2, "tool_fetch": 3}}))
# {'model': 0.01632, 'tools': 0.025, 'total': 0.04132}
El precio unitario de la búsqueda de imágenes aquí se trata igual que el precio unitario de Search; antes de salir a producción, confírmalo contra la documentación oficial. En cuanto a las dimensiones del presupuesto, los productos de preguntas y respuestas encajan mejor con una contabilidad «por solicitud de usuario», mientras que los agentes de varios pasos, Deep Research y la automatización por lotes encajan mejor con una contabilidad «por ciclo de vida de la tarea», agregando todas las invocaciones de modelos y de herramientas dentro de una misma tarea bajo un mismo task_id.
5.2 Cuándo elegir la búsqueda integrada de DeepSeek y cuándo la interfaz independiente Search / Fetch
| Dimensión | Búsqueda integrada en el modelo (deepseek_web_search / read_url) | API independiente Search / Fetch |
|---|---|---|
| Complejidad de desarrollo | Baja; el servidor realiza la búsqueda, el rastreo y el ensamblaje del contexto | Mayor; requiere orquestar uno mismo el bucle de herramientas |
| Control del flujo | El modelo decide cuántas búsquedas hacer y qué páginas leer | El desarrollador controla con precisión cada llamada |
| Criterio de facturación | Por número de términos de consulta, imágenes y páginas rastreadas con éxito | Por número de solicitudes HTTP exitosas |
| Previsibilidad del costo | Bastante variable; la búsqueda profunda puede llegar a unas 20 llamadas de herramientas | Alta; el número de llamadas lo determina el código |
| Escenarios adecuados | Asistentes conversacionales y replicación rápida de la experiencia de una app | RAG, recolección por lotes y agentes con flujo fijo |
Cuando necesitas lanzar rápido un producto conversacional, la búsqueda integrada ahorra mucho trabajo de ingeniería; si necesitas mantener el costo por tarea dentro de un rango fijo, o primero filtrar y luego rastrear, la interfaz independiente encaja mejor. También se pueden combinar: usar las herramientas integradas en el flujo principal de la conversación y la interfaz independiente para completar datos por lotes en segundo plano.
5.3 Integración y precios de DeepSeek Search / Fetch en APIYI
APIYI lanzó el 21 de octubre de 2026 las interfaces de herramientas independientes de DeepSeek deepseek-search y deepseek-fetch, con los endpoints POST /v1/tools/search y POST /v1/tools/fetch. No consumen tokens del modelo y se facturan por número de llamadas exitosas; están disponibles en los grupos default y svip, y los tokens del grupo ClaudeCode no pueden invocarlas directamente. En cuanto a la búsqueda integrada en el modelo que usan clientes como DeepSeek Harness y Claude Code, el trabajo de compatibilidad de APIYI sigue planificado para más adelante; por ahora lo disponible son las interfaces independientes Search / Fetch.
A continuación se muestran los precios publicados en la documentación de APIYI, en dólares estadounidenses:
| Concepto | Precio oficial según la documentación | Precio en la plataforma APIYI | Equivalente con bonificación del 20% | Equivalente con bonificación del 10% |
|---|---|---|---|---|
| Search / 1000 llamadas | $0.75 | $0.90 | $0.75 | aprox. $0.82 |
| Fetch / 1000 llamadas | $0.75 | $0.90 | $0.75 | aprox. $0.82 |
Tomando como ejemplo el volumen de herramientas del escenario 1 (1000 llamadas a Search + 3000 a Fetch), la facturación en la plataforma sería (1000 + 3000) ÷ 1000 × $0.90 = $3.60; si la bonificación del 20% aplica a todo el consumo, el equivalente es $3.60 ÷ 1.20 = $3.00; con una bonificación del 10%, aproximadamente $3.27. DeepSeek factura oficialmente en yuanes; al comparar el costo real hay que unificar la moneda, el tipo de cambio y las condiciones de las bonificaciones por recarga. El precio final será el que muestre la consola de la cuenta.
Ejemplo mínimo de llamada (los campos de la solicitud se rigen por la documentación de APIYI):
import requests

BASE_URL = "https://api.apiyi.com/v1"  # Interfaz unificada de APIYI
headers = {"Authorization": "Bearer YOUR_API_KEY"}

resp = requests.post(f"{BASE_URL}/tools/search", headers=headers,
                     json={"model": "deepseek-search",
                           "query": "DeepSeek API 价格", "count": 10})
print(resp.json())
Ver la implementación completa: primero Search y luego Fetch, con reintentos con retroceso para 429 y conteo
import time
import requests

BASE_URL = "https://api.apiyi.com/v1"  # Punto de acceso compatible con OpenAI de APIYI
HEADERS = {"Authorization": "Bearer YOUR_API_KEY"}
RETRY_CODES = {408, 429, 500, 502, 503, 504}

def call_tool(path: str, payload: dict, max_retry: int = 4) -> dict | None:
    """Llama a la interfaz de la herramienta; aplica retroceso exponencial para errores reintentables; las solicitudes fallidas no se facturan"""
    for i in range(max_retry):
        r = requests.post(f"{BASE_URL}{path}", headers=HEADERS,
                          json=payload, timeout=60)
        if r.status_code == 200:
            return r.json()
        if r.status_code == 402:
            raise RuntimeError("余额不足,请先充值")
        if r.status_code in RETRY_CODES:
            time.sleep(2 ** i)  # 1s, 2s, 4s, 8s
            continue
        raise ValueError(f"请求参数错误: {r.status_code} {r.text}")
    return None

def research(query: str, fetch_top: int = 3) -> dict:
    stats = {"search": 0, "fetch": 0}
    result = call_tool("/tools/search",
                       {"model": "deepseek-search", "query": query, "count": 10})
    items = (result or {}).get("results", [])
    if items:
        stats["search"] += 1  # Solo se factura si el resultado no está vacío
    pages = []
    for item in items[:fetch_top]:  # Solo obtiene las páginas cuyo texto original realmente necesita leer
        page = call_tool("/tools/fetch",
                         {"model": "deepseek-fetch", "url": item.get("url")})
        if page:
            stats["fetch"] += 1
            pages.append(page)
        time.sleep(0.05)  # Controla el ritmo para evitar el límite de 25 QPS de Fetch y la limitación por dominio
    return {"pages": pages, "billing": stats}

if __name__ == "__main__":
    out = research("DeepSeek 全家桶 API 计费规则")
    print(out["billing"])  # Por ejemplo {'search': 1, 'fetch': 3}
🚀 Inicio rápido: regístrate en APIYI (apiyi.com) para obtener crédito de prueba; primero valida Search / Fetch con solicitudes de pequeño volumen y luego calcula el presupuesto definitivo a partir del número real de llamadas que aparezcan en los registros.
Preguntas frecuentes (FAQ)
P1: ¿Qué conceptos de cobro incluye la API de la suite completa de DeepSeek?
Incluye tokens del modelo (entrada con acierto de caché, entrada con fallo de caché y salida) y costos de herramientas (Search, Fetch, búsqueda de imágenes, análisis de archivos, OCR, ASR, TTS). La verificación de seguridad y la búsqueda dentro de la página `find_in_page` no tienen un precio desglosado en la tabla de precios pública.
P2: ¿Qué diferencia hay entre la facturación de la API Search independiente y la búsqueda integrada en el modelo?
La API Search independiente cuenta 1 vez por cada solicitud HTTP exitosa; aunque devuelva 50 resultados, solo cuenta como 1 vez. La búsqueda integrada en el modelo se factura según el número real de términos de consulta; una llamada con 3 términos de consulta cuenta como 3 veces. La modalidad integrada es más sencilla de desarrollar; la modalidad independiente permite controlar mejor los costos.
P3: ¿De cuándo son estos precios? ¿Cambiarán las promociones por tiempo limitado?
Los precios de este artículo provienen del documento oficial de precios en chino de DeepSeek, con fecha de referencia del 15 de noviembre de 2026. ASR y TTS tienen actualmente un descuento del 50 % por tiempo limitado; cuando termine, volverán a ¥0.78 por hora y ¥3 por cada 10000 caracteres facturados, respectivamente. Para presupuestos a largo plazo, se recomienda dejar margen según el precio de lista.
P4: ¿La factura se duplicará directamente en horas punta?
Solo se duplica la parte de tokens del modelo; los precios de las herramientas no varían según la franja horaria. En el escenario 1, la factura total pasa de ¥57 a ¥89, un aumento de aproximadamente el 56 %. Cuanto mayor sea la proporción de costos de herramientas en una tarea, menor será el aumento en horas punta.
P5: ¿Cómo invocar rápidamente DeepSeek Search y Fetch mediante la API?
1. Regístrate en APIYI (apiyi.com) y crea un token del grupo default o svip
2. Configura `base_url` como `https://api.apiyi.com/v1`
3. Usa el código de este artículo para solicitar `/tools/search` y `/tools/fetch`, con los nombres de modelo `deepseek-search` y `deepseek-fetch`, respectivamente
La misma clave API también puede invocar otros modelos principales de la plataforma, lo que facilita pasar los resultados de búsqueda a diferentes modelos para comparar su rendimiento.
P6: ¿Se cobra varias veces si hago preguntas repetidas después de analizar un archivo?
La tarifa de análisis se cobra una sola vez; si vuelves a referenciar el mismo `file_id`, no se cobra de nuevo el análisis. Pero cada vez que el contenido del archivo entra en el contexto, se factura como tokens de entrada; en archivos grandes con varias rondas de preguntas, el principal costo proviene de los tokens de entrada.
P7: ¿Qué limitaciones conocidas tiene la API de la suite completa de DeepSeek?
– La integración completa de herramientas a nivel de conversación está pensada por ahora para `deepseek-flash`
– Search independiente: 100 QPS a nivel de cuenta; Fetch: 25 QPS; además, está sujeto a los límites de velocidad del dominio de destino
– ASR: cada segmento dura como máximo 120 segundos y no es en streaming; TTS: como máximo 10000 caracteres facturables por solicitud; por ahora no permite ajustar la velocidad de la voz
– Análisis de archivos: máximo 100 MiB y 1000 páginas por archivo; hasta 20 archivos referenciados por solicitud
P8: ¿APIYI puede invocar todas las herramientas integradas recién lanzadas por DeepSeek?
Actualmente, APIYI ya ofrece `deepseek-search` y `deepseek-fetch` independientes, que puedes orquestar por tu cuenta en agentes y RAG. El trabajo de compatibilidad de la búsqueda integrada en el modelo con clientes como Harness, Claude Code y otros aún está en planificación; los avances se consultarán en la documentación oficial de APIYI (apiyi.com).
Puntos clave sobre los precios de la familia completa de APIs de DeepSeek
- Estructura de facturación: los tokens del modelo y las llamadas a herramientas se facturan por separado; una tarea genera varios cargos a la vez.
- Precio unitario de las herramientas: Search y Fetch cuestan ¥5 / 1000 llamadas cada uno; el análisis de archivos y el OCR cuestan ¥1.5 / 1000 páginas cada uno.
- Precios de voz: ASR a ¥0.39 / hora por tiempo limitado; TTS a ¥1.5 / 10,000 caracteres facturables por tiempo limitado; cada carácter chino cuenta como 2 caracteres.
- El grueso de la factura: en tareas de investigación en línea, los tokens del modelo suelen representar más de la mitad; las horas de baja actividad y la caché son lo más eficaz.
- Efecto de la caché: cuando el 80 % de la entrada se sirve desde la caché, la factura del escenario 1 baja de ¥57 a ¥41.32, con un ahorro de aproximadamente 27.5 %.
- Criterio de conteo: se registra con el campo de facturación
server_tool_use; los campos mostrados pueden incluir solicitudes fallidas. - Cómo empezar: las interfaces independientes Search / Fetch se pueden invocar y probar en APIYI apiyi.com con una clave API unificada.
Resumen
Los puntos centrales sobre los precios de la familia completa de APIs de DeepSeek:
- Calcular por tarea: el coste de una tarea de agente = entrada + salida + herramientas + archivos y voz; el precio de una sola solicitud solo refleja uno de esos componentes.
- Los tokens dominan la factura: el precio unitario de las herramientas es bajo; lo que realmente dispara el coste son los contextos largos, los archivos repetidos y la salida de razonamiento.
- El criterio de facturación define el control: la búsqueda integrada se factura por término de consulta, lo que facilita el desarrollo; la interfaz independiente se factura por solicitud, lo que estabiliza el presupuesto.
Para llevarlo a la práctica, primero ejecute la función de costes de este artículo sobre una muestra pequeña para obtener los campos de facturación reales, luego multiplique por el volumen de negocio para calcular el presupuesto y reserve margen para cuando venzan las ofertas por tiempo limitado. Los equipos que necesiten orquestar por su cuenta los procesos de búsqueda y rastreo pueden invocar las interfaces independientes DeepSeek Search / Fetch a través de APIYI apiyi.com y comparar en la misma moneda usando los precios reales de la consola.
📚 Referencias
- Modelos y precios de DeepSeek: documentación oficial de precios en tiempo real
- Enlace:
api-docs.deepseek.com/zh-cn/quick_start/pricing -
Descripción: precio unitario por token del modelo, horarios pico y valle, precios de las herramientas
-
Herramientas de búsqueda web de DeepSeek: documentación técnica de búsqueda y lectura de enlaces integradas
- Enlace:
api-docs.deepseek.com/zh-cn/guides/web_tools -
Descripción: detalles de facturación de la búsqueda profunda y el campo de facturación
server_tool_use -
Búsqueda web y extracción de contenido de DeepSeek: documentación independiente de Search / Fetch
- Enlace:
api-docs.deepseek.com/zh-cn/guides/search -
Descripción: definición de solicitud exitosa, límites de QPS y manejo de códigos de error
-
Análisis de archivos / OCR / ASR / TTS de DeepSeek: documentación técnica de cada herramienta
- Enlace:
api-docs.deepseek.com/zh-cn/guides/document_parsing -
Descripción: en el mismo directorio se pueden consultar las limitaciones y unidades de facturación de ocr, asr y tts
-
Anuncio de la API de la suite completa de aplicaciones DeepSeek: publicado el 13 de noviembre de 2026
- Enlace:
api-docs.deepseek.com/zh-cn/news/news261113 - Descripción: lista de capacidades abiertas en esta ocasión y el alcance de compatibilidad de modelos
Autor: equipo técnico de APIYI
Contacto técnico: puedes contactarnos desde la página de inicio del sitio web de APIYI. Los parámetros de la interfaz y los precios más recientes de DeepSeek Search / Fetch están disponibles en el centro de documentación de APIYI.