作者注:Codex 输入框看不到上下文用量?入口在 /status。本文用 API易 调用日志 5 步算出 Codex 每轮 token 消耗和金额,并给出“该压缩还是该新开”的判断表。
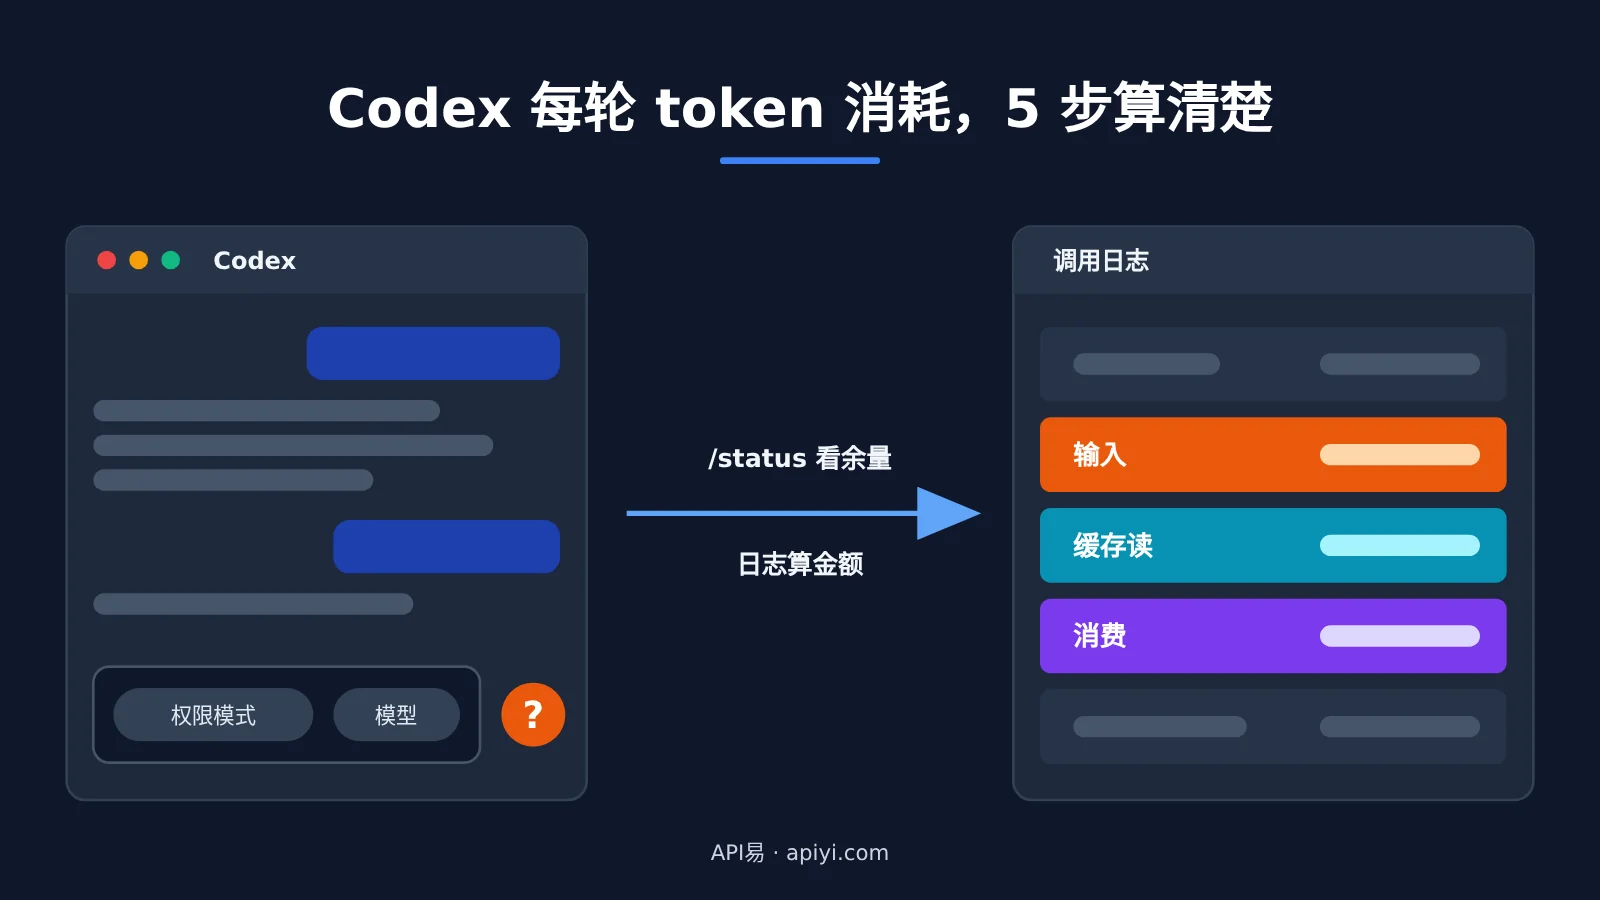
你用 Codex 接上 API易,在一个对话里连续干了几个小时的活。输入框下方只显示权限模式和模型,上下文用了多少却看不到,你也拿不准该不该新开窗口。
先说结论:不是 Codex 不给看,上下文用量的入口挪到了 /status;能算钱的数据在 API易 / apiyi.com 的调用日志里。本文围绕 用 API易 调用日志查看 Codex 每轮 token 消耗 这件事,分五步讲清楚:看什么,怎么合计,什么时候压缩或新开。
这不是又一篇概念科普。每一步都写了界面上会看到什么、该点哪里,并附一句验收标准。
为什么在 Codex 里看不到每轮 token 消耗
很多人以为 Codex 去掉了上下文显示。实际情况是,相关信息分散在三个入口里,而且每个入口能看到的东西不一样。
- 桌面客户端 / IDE 插件:输入框只显示权限模式和模型。输入
/status,能看到 chat ID、context usage(上下文已用比例)和 rate limits(速率余量)。 - CLI:
/status显示当前模型、审批策略、可写目录和当前 token 用量。CLI 页脚原本就有上下文提示。用/statusline可以把 context stats(上下文统计)和 token counters(token 计数)加到页脚,选择结果会写回config.toml的tui.status_line。 codex exec --json:非交互执行时,Codex 每次状态变化都会输出一行 JSON 事件。其中turn.completed事件带usage,包含input_tokens、cached_input_tokens、cache_write_input_tokens、output_tokens、reasoning_output_tokens五个字段。
另外 /usage 只能看账号维度的 token 活动,前提是官方登录态。如果你用的是第三方 Key,这个命令不适用。
Codex token 消耗的三套口径对比
| 口径 | 覆盖场景 | 能看到什么 | 看不到什么 |
|---|---|---|---|
| API易 调用日志 | 桌面、IDE、CLI 全覆盖 | 每次请求的输入、输出、缓存读写、金额 | 对话内容;一行只是一次请求,一轮需要自己合计 |
Codex /status |
桌面与 CLI 交互界面 | 上下文用量、速率余量、当前 token 用量 | 金额 |
codex exec --json |
仅非交互执行 | 每轮的输入、缓存读、缓存写、输出、思考 token | 交互式 TUI 与桌面端的数据 |
三套口径里只有日志能看到金额。前提是你走的通道本身提供日志和用量明细,官方订阅没有逐次请求的明细可查。
第一步:确定 Codex token 消耗的统计口径
开始统计前,先记住一点:一次请求不等于一轮对话。
请求指 Codex 向模型发出一次调用。轮指你发一句话、Codex 干完活回复你的整个过程。在一轮里,Codex 会读文件、跑命令、改代码,每次工具调用结束后都要把结果连同完整历史再发给模型一次。所以一轮对话在日志里通常对应好几行,复杂任务可能有几十行。
还要知道,模型本身不记得之前说过什么。第 N 轮的输入 ≈ 前 N-1 轮的全部内容 + 本轮新增内容,这就是长对话越聊越贵的根本原因。
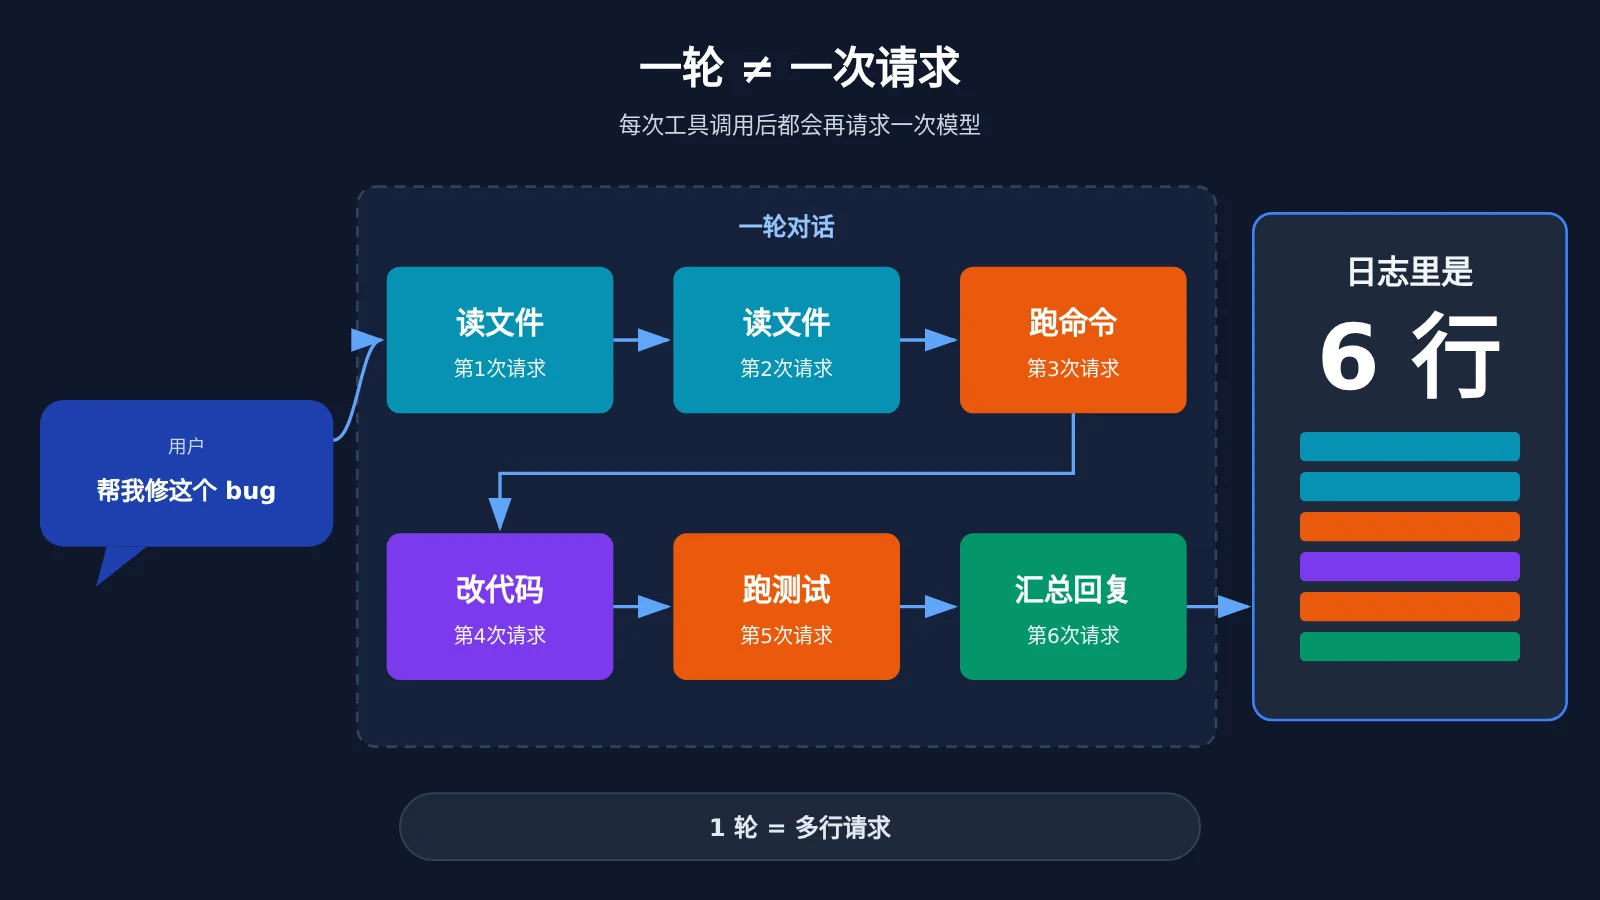
验收:看到日志里多行请求时,你能判断它们属于同一轮,不会把单行当成一轮来算。
第二步:给 Codex 单独建一把令牌
统计的前提是日志里只有 Codex 的请求。如果 Codex 和脚本、其他工具共用一把 Key,后面就没法按令牌筛选了。
- 进入 API易 控制台的令牌页面,点「添加令牌」,名字起一个自己能认出来的,例如带上“codex”字样。
- 打开 Codex 的
config.toml,在model_providers下添加一个 provider,base_url = "https://api.apiyi.com/v1",通过env_key指定读取这把令牌的环境变量。 - 把
model_provider指向这个 provider。桌面、IDE 和 CLI 读的是同一份配置,改一次就够了。 - 其他工具一律使用别的 Key,不要复用这把。
🎯 技术建议:专用令牌、日志按令牌筛选、导出,这三项是 API易 / apiyi.com 控制台提供的统计抓手。官方订阅看不到单次请求明细,用专用令牌后,Codex 的账可以单独算。
验收:在日志页「展开」后的进阶筛选里,「令牌」选中这把 Key,列表里只剩 Codex 发出的请求。
第三步:在调用日志里读懂单次请求
打开 api.apiyi.com/log,也就是左侧菜单的「日志」。列表里每一行是一次 API 请求。
顶部默认可以筛时间区间、类型、模型和缓存状态。缓存状态的提示语写着“命中=读取缓存,未命中=创建缓存”。点「展开」后,还可以按令牌、流式、提示/补全范围、首字节耗时等条件进一步筛选。
日志各列的含义
| 列名 | 你会看到什么 | 怎么理解 |
|---|---|---|
| 时间 | 请求完成时间 | 默认 UTC+0,比北京时间晚 8 小时 |
| 模型 | 例如 gpt-5.6-terra | 换了模型,缓存不共享 |
| 信息 | 流式/非流式、首字节耗时、提示/补全 token、金额 | 一格内看全本次请求概况 |
| 提示 / 补全 | 两个数字 | 提示=输入 tokens,补全=输出 tokens,思考 token 通常算在补全里 |
| 消费 | 美元金额 | 折扣前金额,已含分组倍率 |
| 说明 | 各项倍率、缓存写入 tokens、缓存读取 tokens | 缓存命中与写入在这里单独列出,不需要猜 |
带缓存的请求,「信息」列会同时显示命中和写入的数字。不带缓存明细的行只显示“非流式 首字节:N秒 提示/补全 金额”这样的组合。按次计费的图像、视频模型也会显示提示和补全,但它们的金额不是按 token 算的,不要拿来套本文的算法。
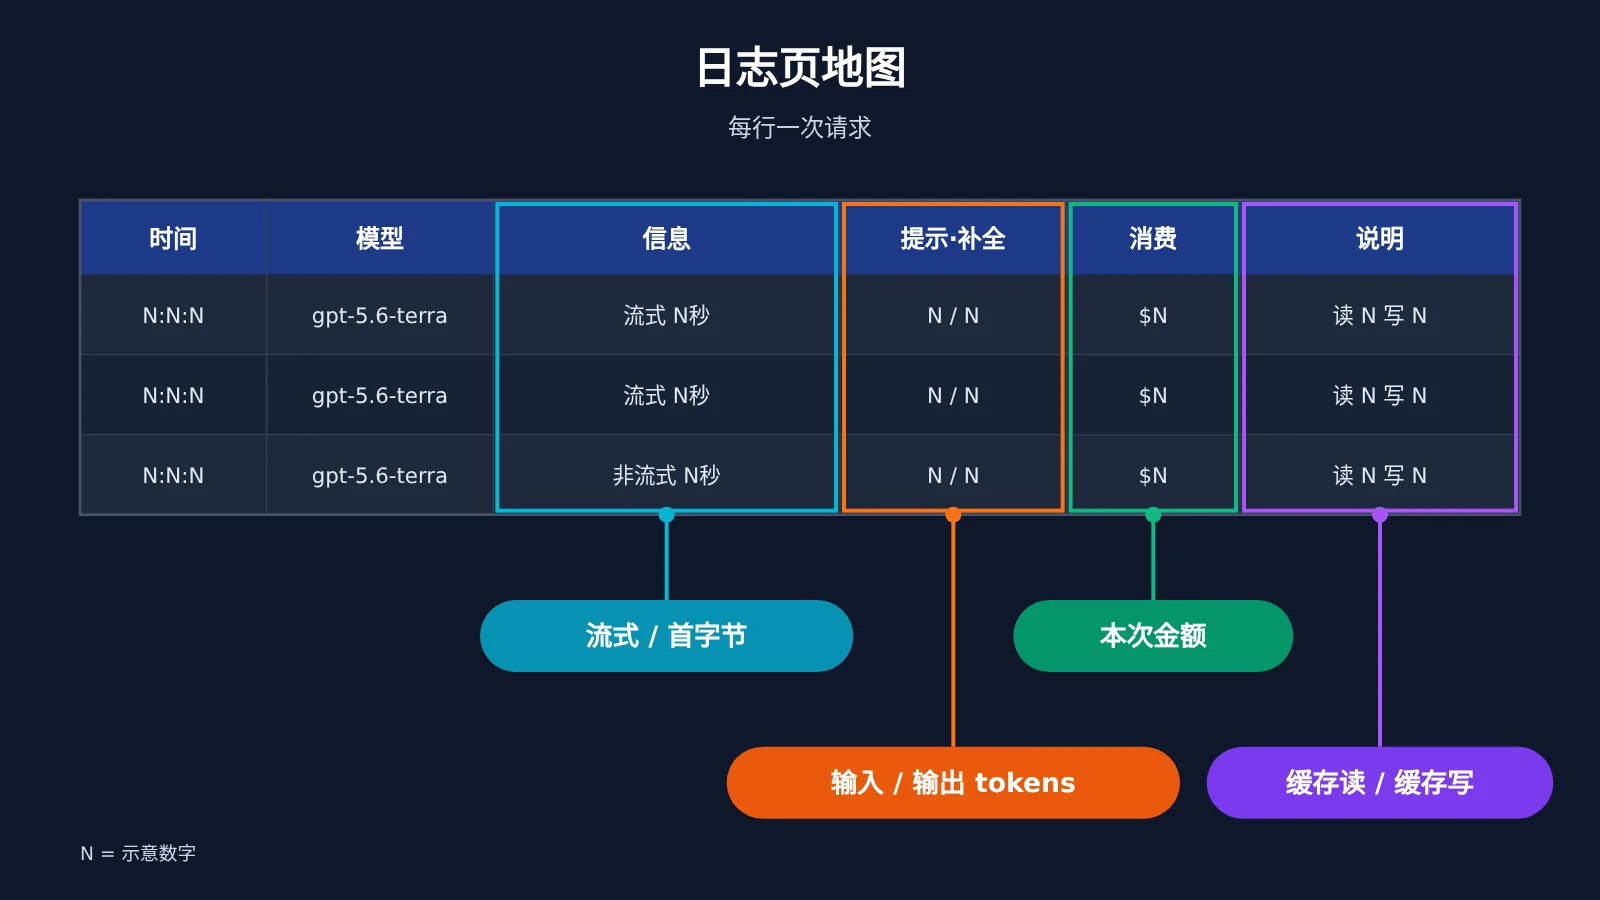
验收:随便指着一行,你能说出这次请求的输入是多少、输出是多少、缓存命中多少、花了多少钱。
第四步:把多行日志合成一轮 Codex token 消耗
单行数据只说明一次请求。要看一轮对话的消耗,需要合计。
合计规则:同一令牌、同一模型,你发出指令后约 5 分钟窗口内的请求全部加起来。时间窗口按自己的实际情况调整。
- 页面上直接看:筛选令牌 + 模型 + 时间区间,逐行看提示和补全。适合偶尔查一次。
- 导出复算:点列表右上角「导出」,拉出 Excel 或 CSV,在表格里按时间分组求和。
- 日志查询 API:调用
GET /api/log/self,认证用个人访问令牌(以nap_开头,用sk_开头的 API Key 会返回 401)。参数传type=2(只看消费)、token_name、start_timestamp和end_timestamp(Unix 秒)。注意分页参数是驼峰写法pageSize,写成page_size会被静默忽略。 - 换算金额:接口返回的
quota ÷ 500,000 = 美元。other字段是 JSON 字符串,需要再解析一次,才能拿到usage等明细。
使用查询接口时,时间窗口一定要传,跨度建议不超过 1 天。不传时间窗口,接口会回溯全部历史,数据量大的账号容易超时报错。查询日志本身不消耗额度。
用价格算一轮 Codex 花了多少
| 模型 | 输入 | 缓存读 | 输出 | 上下文 | 算例:一轮合计 |
|---|---|---|---|---|---|
| gpt-5.6-sol | $4 | $0.4 | $20 | 1,000,000 | 约 $0.214 |
| gpt-5.6-terra | $2 | $0.2 | $12 | 1,000,000 | 约 $0.107 |
| gpt-5.6-luna | $0.2 | $0.02 | $1.2 | 1,000,000 | 约 $0.011 |
单价均为每百万 tokens,查于 2026-10-28。单次请求输入超过 272,000 tokens 后,输入价翻倍。
💰 价格说明:型号与价格以 API易 / apiyi.com 平台型号列表为准。表中算例按一轮累计输入 120,000、其中命中缓存 96,000、输出 4,000 计算。以 sol 为例:未命中 24,000 × $4 + 命中 96,000 × $0.4 + 输出 4,000 × $20,除以一百万后合计约 $0.214。
这组数字说明了两件事。第一,缓存命中的 96,000 只花了约 $0.038,缓存是长对话成本的关键。第二,同一轮任务换到 luna,费用接近 sol 的二十分之一。不过 luna 官方页面注明,256K 以上的超长上下文表现较弱。
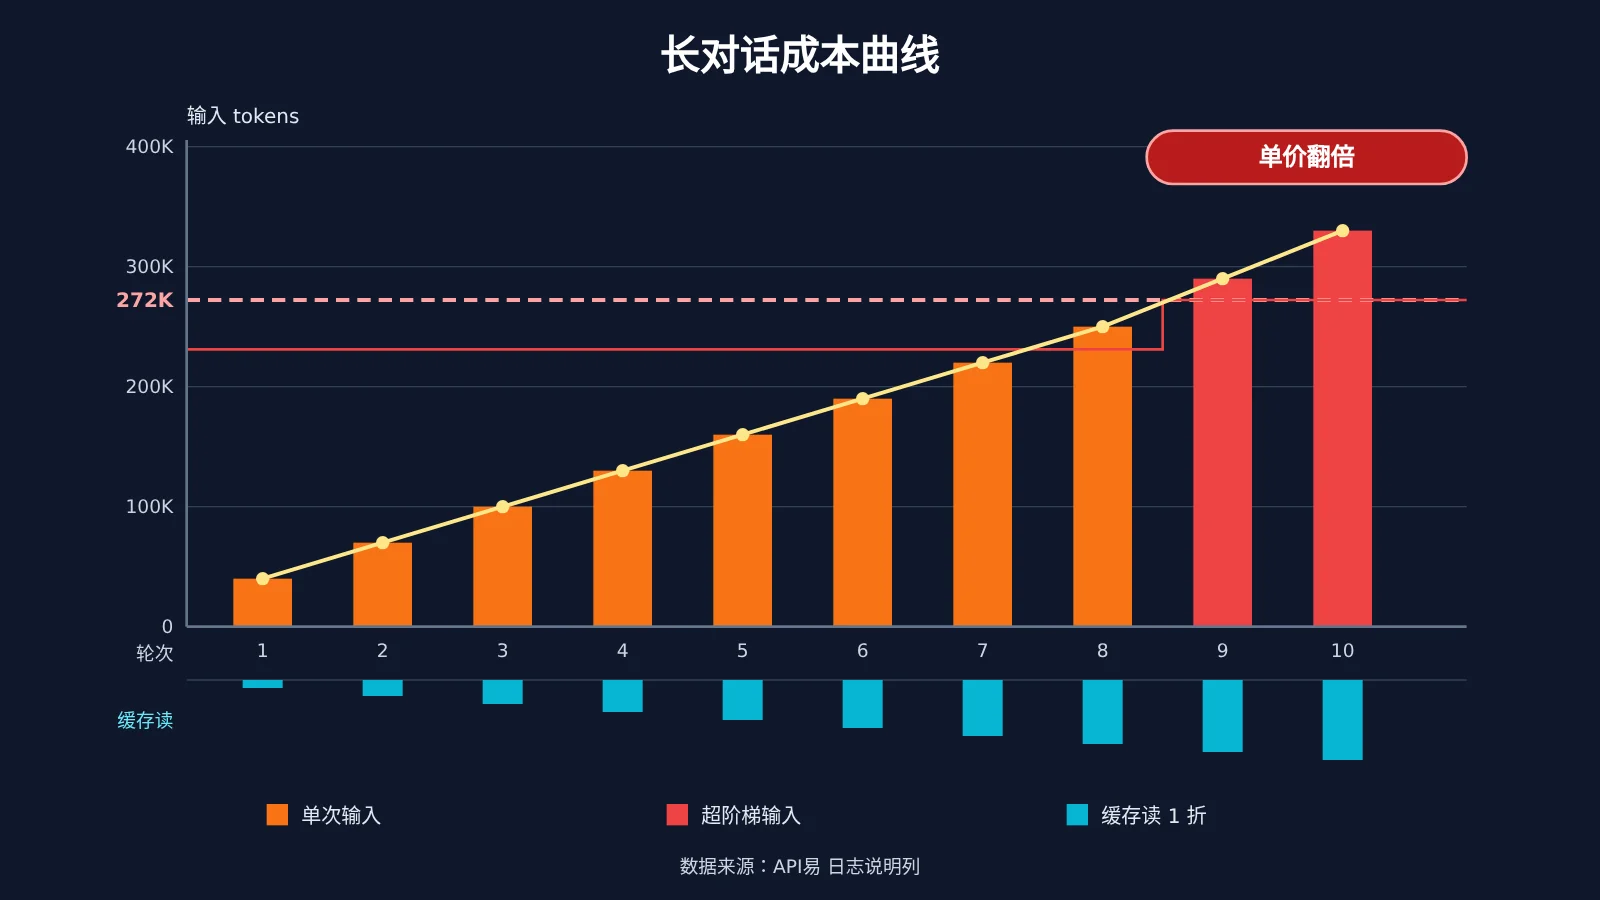
验收:你能算出“这一轮比上一轮多了多少输入 token”,并说出多出来的部分里有多少是缓存命中。
第五步:用 Codex token 数据决定压缩还是新开
有了每轮数据,判断就可以基于数字。重点看三个信号:
- 输入增速:每轮新增的输入越来越多,说明工具输出和历史在快速堆积。
- 缓存读占比:说明列里缓存读取占输入的比例明显下降,说明前缀变了,新输入大多按全价计费。
- 单次输入:接近 272,000 时,下一次请求就会跨过价格阶梯。
压缩与新开窗口判断表
| 你在日志里看到的 | 建议动作 | 原因 |
|---|---|---|
| 单次输入接近 272,000,任务还没做完 | 先手动 /compact |
避免跨过阶梯后输入价翻倍 |
| 单次输入接近 272,000,任务已告一段落 | 新开窗口 | 压缩不如重开干净 |
| 缓存读占比连续几轮下滑 | 新开窗口,换新话题 | 缓存已经失效,继续聊大多按全价 |
| 每轮输入增量突然变大 | 检查工具输出,必要时调低 tool_output_token_limit |
大段命令输出被写进了历史 |
| 输入平稳、缓存读占比高 | 继续当前对话 | 这时长对话性价比最高 |
| 刚压缩过一次,又快满了 | 新开窗口 | 多次压缩会让摘要越来越粗 |
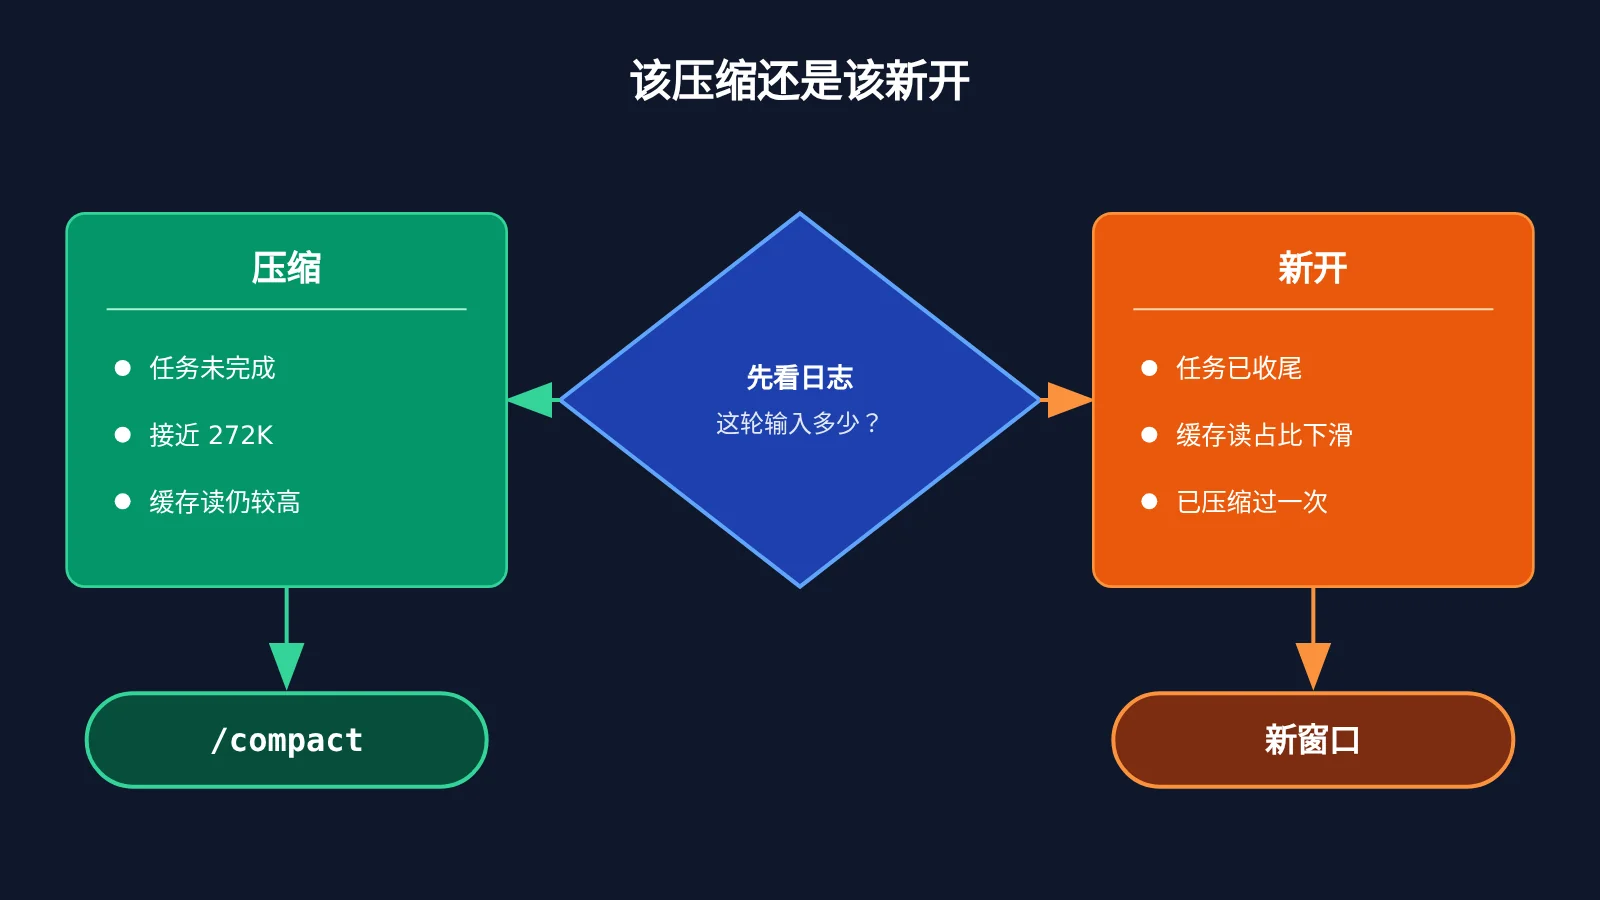
Codex 上下文压缩怎么配置
压缩,指把较早的对话轮次替换成一段精简摘要,从而腾出上下文空间。Codex 支持手动和自动两种方式。
- 手动压缩:桌面端和 CLI 都可以输入
/compact。 - 自动压缩:由
model_auto_compact_token_limit设置触发阈值,不填则使用模型默认值。 - 阈值的计算范围:
model_auto_compact_token_limit_scope可选total(按整段活动上下文计算)或body_after_prefix(只计算携带前缀之后新增的部分)。 - 使用第三方 base_url 时:模型名不在 Codex 内置表里,
model_context_window和自动压缩阈值建议手动填写。如果想在跨过价格阶梯前触发压缩,可以把阈值设在 272,000 以下。 remote_compaction不要随意开启:设为v2时,需要上游支持 Responses 侧的压缩协议。保持unsupported,使用本地压缩更稳妥。
压缩的代价
压缩并不免费。它会改写历史前缀,缓存随即失效,压缩后的那次请求输入几乎按全价计费。所以压缩完成后,最好直接开始新话题,不要回头重复旧任务。压缩也会丢失细节,摘要不能保证保留所有信息。
常见问题 FAQ
Q1:日志里查不到某次请求,是漏记了吗?
日志只记录成功计费的调用。网络、鉴权、参数校验等环节失败的请求没有到达上游,不扣费,也不会出现在日志里。反过来,日志里有记录,就说明请求确实产生了消耗。另外要检查令牌筛选和时间区间是否选对。
Q2:为什么金额比我按 token 估算的低?
最常见的原因是缓存。OpenAI 通道使用自动前缀缓存,前缀不少于 1024 tokens 且保持稳定时就会命中,命中部分按输入价的 1 折计费。在 API易 / apiyi.com 日志的说明列里,可以看到缓存读取的 token 数。另外,日志显示的是折扣前金额,实际成本 ≈ 日志金额 ÷(1 + 加赠比例)。
Q3:日志时间和我的操作时间对不上?
日志默认按 UTC+0 显示,北京时间是 UTC+8,两者相差 8 小时。按北京时间筛选“下午三点那轮”,看起来会像缺了一段数据。筛选前先把时间换算好即可。
Q4:日志能保留多久?
建议按“最近约 30 天可查”来安排。实际保留时间可能更长,但平台不做承诺,清理策略也可能调整。需要长期对账的话,请定期用「导出」或日志查询 API 自行留存。
Q5:日志能看到 Codex 读了哪些文件、发了什么内容吗?
看不到。日志只保留计费所需的基础信息,比如 token 数、金额和倍率,不记录输入输出内容。想知道某一轮做了什么,需要回到 Codex 对话本身查看。
Q6:想把每轮用量自动记下来,有更省事的办法吗?
如果是脚本化执行,可以用 `codex exec –json`,读取 `turn.completed` 事件里的 usage。交互式使用时,可以通过日志查询 API,按专用令牌和时间窗口定时拉取并聚合。新用户可以先在 API易 / apiyi.com 领取免费测试额度,跑通整个流程。
Codex 每轮 token 消耗核心要点 Key Takeaways
- 入口没有消失:上下文用量在
/status里查看,CLI 还可以用/statusline放到页脚。 - 请求 ≠ 轮:一轮对话包含多次工具调用,在日志里对应多行,需要按时间窗口合计。
- 专用令牌:给 Codex 单独建一把 Key,日志才能干净地筛出来。
- 看说明列:缓存读写单独列出,命中部分按 1 折计费。
- 272K 阶梯:单次输入超过 272,000,输入价翻倍。
- 压缩有代价:压缩后缓存失效,那次请求输入几乎全价,压缩后适合直接换新话题。
总结
在 Codex 里看不到上下文用量,原因不是功能被删,而是入口换了地方。/status 告诉你还剩多少上下文,调用日志告诉你每轮花了多少钱。把两者结合起来,“要不要新开窗口”就能按数字判断。
今天就可以动手:给 Codex 建一把专用令牌,然后打开 API易 / apiyi.com 的日志页,挑最近一轮对话,把它的几行请求加起来算一遍。
📚 参考资料
- OpenAI Codex 官方仓库:CLI 源码与事件定义
- 链接:
github.com/openai/codex -
说明:
codex-rs/exec/src/exec_events.rs中定义了turn.completed的 usage 字段 -
Codex 官方文档:斜杠命令与配置参考
- 链接:
developers.openai.com/codex -
说明:
/status、/compact、/statusline以及压缩相关配置项的说明 -
API易 帮助文档:调用日志、缓存计费、日志查询 API
- 链接:
docs.apiyi.com - 说明:日志字段口径、缓存 1 折规则、
quota换算方法
作者:API易 技术团队
技术交流:欢迎在 API易 官网首页联系我们,更多配置说明见文档中心。