Anmerkung des Autors: Ein Blick auf LongCat 2.5. Dieser Artikel behandelt Parameter und Architektur, acht offizielle Demonstrationen, die Ergebnisse von 25 offiziellen Benchmark-Tests, eine Kostenrechnung zum zeitlich begrenzten Rabattpreis und die Einbindung in Claude Code und Cline.
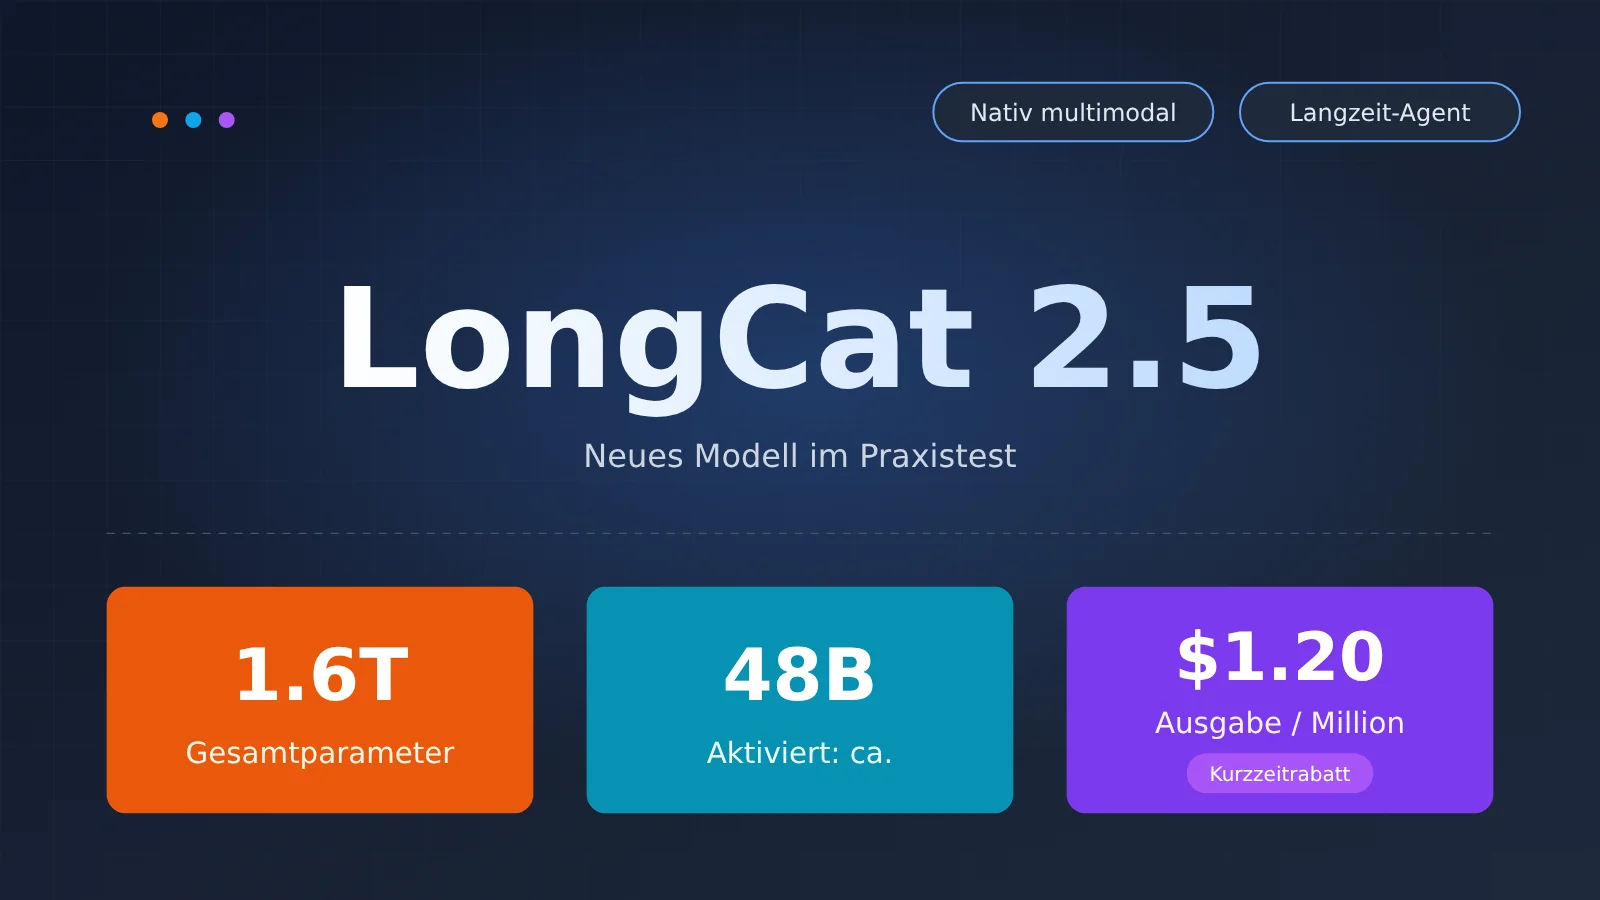
Das LongCat-Team von Meituan – so wird es in der Community üblicherweise genannt – hat am 1. November LongCat-2.5 veröffentlicht. Das Modell hat insgesamt 1,6 Billionen Parameter, von denen es pro Token rund 48 Milliarden aktiviert. Es ist nativ multimodal und auf langfristige Agentenaufgaben ausgelegt. Gegenüber Version 2.0 wurden vor allem das native visuelle Verständnis und die agentenbasierte Programmierung verbessert. Die Preise gelten für einen begrenzten Zeitraum: 1,20 $ pro Million Ausgabe-Token, 0,30 $ pro Million Eingabe-Token ohne Cache-Treffer und 0,006 $ pro Million Eingabe-Token mit Cache-Treffer.
Dies ist kein Vergleich zur Modellauswahl. Im Folgenden geht es nur um drei Fragen: Was ist LongCat 2.5, welche Aufgaben beherrscht es gut und was kostet die Nutzung? Benchmark-Ergebnisse dienen lediglich als Orientierung, nicht als Grundlage für die Entscheidung, welches Modell ein anderes ersetzen sollte.
Der Kernnutzen: Nach der Lektüre haben Sie drei Dinge zur Hand: eine Übersicht der Fähigkeiten, eine nachvollziehbare Kostenrechnung und einen möglichst kurzen Weg zum Einstieg.
LongCat 2.5: Die wichtigsten Fakten im Überblick
| Information | Details |
|---|---|
| Veröffentlichung | 01.11.2026 (offizieller Blog) |
| Ausrichtung | Natives multimodales Modell für langlaufende Agentenaufgaben |
| Modellgröße | Insgesamt 1,6 Billionen Parameter, davon rund 48 Milliarden pro Token aktiviert |
| Neuerungen gegenüber 2.0 | Natives visuelles Verständnis, agentisches Programmieren |
| Kontextfenster / maximale Ausgabe | 1 Mio. Tokens / 128.000 Tokens |
| Schnittstellen | Zwei Protokolle: OpenAI- und Anthropic-Format |
| Preise (zeitlich begrenzter Rabatt) | Eingabe: 0,30 $ (ohne Cache-Treffer) / 0,006 $ (mit Cache-Treffer), Ausgabe: 1,20 $; jeweils pro Million Tokens |
| Modellgewichte | Auf GitHub und Hugging Face als „demnächst verfügbar“ gekennzeichnet, noch nicht veröffentlicht |
Bei den aktivierten Parametern gibt es eine mögliche Verwechslungsquelle: Am Tag der Veröffentlichung nannten einige Community-Beiträge 440 Milliarden. Laut offiziellem Blog werden jedoch pro Token rund 48 Milliarden Parameter aktiviert. Dieser Artikel verwendet durchgehend den offiziellen Wert.
Was ist LongCat 2.5? Parameter, Architektur und native Multimodalität
Modellgröße und Trainingsansatz von LongCat 2.5
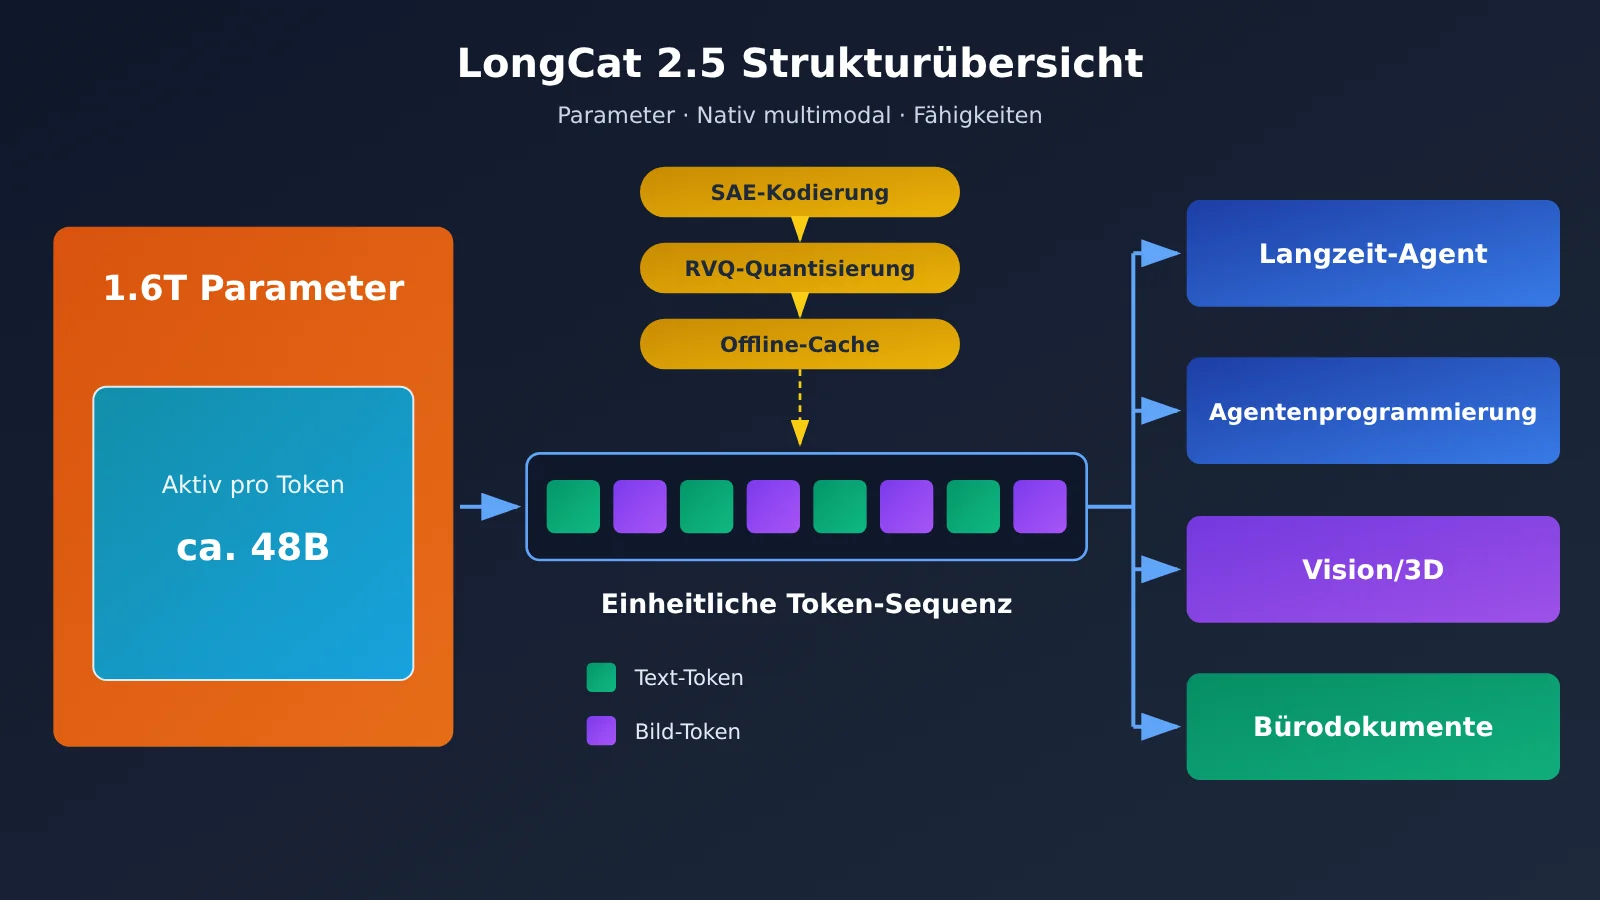
Mit insgesamt 1,6 Billionen Parametern, von denen etwa 48 Milliarden aktiviert werden, ist LongCat 2.5 ein großes Sprachmodell mit spärlicher Aktivierung: Es verfügt über eine hohe Gesamtkapazität, nutzt aber bei jeder Inferenz nur einen kleinen Teil davon. Diese Architektur schafft Spielraum zwischen Wissenskapazität und Inferenzkosten – und ist eine der Voraussetzungen für die später beschriebenen niedrigen Preise.
Beim Training nennt der Anbieter mehrere Ansätze, die direkt auf langfristige Aufgaben abzielen:
- Mehr langfristige Abläufe als Trainingsdaten: Das Training mit langen Sequenzen umfasst zusätzliche langfristige Abläufe. Anschließend trainiert das Modell mit umfangreichem langfristigem Reinforcement Learning End-to-End-Entwicklungsaufgaben, etwa die Arbeit an komplexen Codebasen oder die Umsetzung vollständiger Projekte.
- Reale Fehlverläufe in Trainingsaufgaben umwandeln: Datensynthese, Umgebungsaufbau und gemischtes Training über verschiedene Harnesses hinweg werden parallel ausgebaut. So entstehen aus den Fehlverläufen realer Agenten reproduzierbare, überprüfbare Aufgaben.
- „Zu langes Nachdenken“ und „wiederholte Aufrufe“ eindämmen: Wiederholte Gedankengänge und Tool-Aufrufe werden zusätzlich bestraft. Bei übermäßigem Nachdenken und zu schnell wachsenden Ausgaben werden die Belohnungen für positive Beispiele neu verteilt.
Der dritte Punkt ist für Agenten besonders praxisrelevant. Bei langfristigen Aufgaben wird es oft teuer, wenn das Modell immer wieder dasselbe Tool aufruft, ohne voranzukommen. Wer das schon beim Training eindämmt, spart direkt Token.
So funktioniert die native Multimodalität von LongCat 2.5
„Nativ multimodal“ hat hier eine konkrete Bedeutung: Visuelle Signale werden als diskrete Token auf mehreren Ebenen dargestellt. Das Basismodell verarbeitet visuelle Inhalte und Text gemeinsam in einem einheitlichen Token-Format. Es verwendet also keinen externen visuellen Encoder, dessen Merkmale anschließend hinzugefügt werden.
Das Verfahren besteht laut den Entwicklern aus drei Schritten:
- Visuelle Diskretisierung in nativer Auflösung: Ein semantisch ausgerichteter Encoder (SAE) und eine Residualvektorquantisierung (RVQ) zerlegen das Bild in diskrete Token.
- Offline-Vorverarbeitung visueller Token: Sobald der Tokenizer feststeht, lassen sich die visuellen Token-IDs offline vorausberechnen und zwischenspeichern.
- Gemeinsames Lernen: Die visuellen Embeddings werden zusammen mit dem Basismodell trainiert.
Laut den Entwicklern erzielt das Modell mit diesem Ansatz starke Ergebnisse beim Visual Coding und unterstützt Aufgaben wie kreatives Design und 3D. Die Benchmarks 3DCodeBench und Vision2Web in der späteren Ergebnistabelle messen genau diese Fähigkeiten.
Warum LongCat 2.5 zu diesem Preis angeboten werden kann
Der offizielle Blog widmet der technischen Effizienz viel Platz – und liefert damit eine Erklärung für den Preis. Das Training läuft auf in China entwickelter Hardware mit weniger als 80 GB Speicher pro GPU. Um den Speicherbedarf zu senken, setzt das Team unter anderem auf doppelt geshardetes FSDP, parallele Verarbeitung gemischter Vokabulare und dynamische Expertenreplikation. Bei SFT-Aufgaben mit langen Sequenzen erreicht diese FSDP-Konfiguration pro GPU einen um 86 % höheren Durchsatz als die DDP-Baseline.
Bei der Inferenz kommt W4A4 zum Einsatz: Sowohl die Expertengewichte als auch die Aktivierungen werden auf 4 Bit quantisiert. Im offiziellen Online-Lasttest gegenüber einer W8A8-INT8-Baseline stieg der Prefill-Durchsatz um 43,3 % und der Decode-Durchsatz um 42,77 %. Die Latenz bis zum ersten Token (TTFT) sank um 15,91 %, die Latenz pro Token (TPOT) um 19,72 %. Bei einem um mehr als 40 % höheren Durchsatz sinken entsprechend die Kosten pro Token.
Wo LongCat 2.5 punktet: langlaufende Agentenaufgaben und 8 offizielle Beispiele
Der Sprung von LongCat 2.0 auf 2.5
Zunächst der Vergleich mit dem Vorgänger. Die folgenden Zahlen stammen aus offiziellen Tests von LongCat; mit einem Stern markierte Vergleichswerte stammen aus öffentlichen Bestenlisten. Dieser Abschnitt nennt nur die Ergebnisse der beiden LongCat-Generationen.
- Terminal Bench v4.0: 2.0 erreicht 3,0, 2.5 erreicht 38,5.
- DeepSWE v1.1: 2.0 erreicht 9,7, 2.5 erreicht 64,6.
- Program Bench Almost Resolved: 2.0 erreicht 2,5, 2.5 erreicht 25,5.
- AutomationBench v1.0.6: 2.0 erreicht 15,8, 2.5 erreicht 51,8.
Diese Benchmarks prüfen mehrstufige Aufgaben wie Terminaloperationen, Fehlerbehebungen auf Repository-Ebene und automatisierte Abläufe. Während 2.0 hier kaum Punkte erreichte, liegt 2.5 nun in einem Bereich, der Vergleiche mit anderen Modellen erlaubt. Das zeigt einen deutlichen Fortschritt beim agentischen Programmieren. Laut offizieller Angabe wurden alle Ergebnisse von LongCat-2.5 mit aktiviertem Thinking sowie temperature=1.0 und top_p=0.95 erzielt.
Die 8 offiziellen Demobeispiele von LongCat 2.5
LongCat hat acht Beispiele veröffentlicht, die jeweils Ende zu Ende generiert wurden und in zwei Gruppen aufgeteilt sind. Wichtig: Es handelt sich um offizielle Demos; für diesen Artikel wurden sie nicht einzeln nachgestellt.
| Kategorie | Beispiel | Was dabei getestet wird |
|---|---|---|
| Softwareentwicklung | Flüssigkeitssimulation in Echtzeit | Physikalische Berechnungen + Echtzeit-Rendering im Frontend |
| Softwareentwicklung | Interaktive 3D-Präsentation historischer Artefakte | Aufbau einer 3D-Szene und Interaktionslogik |
| Softwareentwicklung | Stadtmodell | Anordnung und Organisation vieler Objekte |
| Softwareentwicklung | Assets für Miniaturszenen | Detailkontrolle bei der Erstellung von 3D-Assets |
| Professionelle Büroarbeit | Analyse der Geschäftsentwicklung | Daten einlesen, Kennzahlen aufschlüsseln und Schlussfolgerungen formulieren |
| Professionelle Büroarbeit | Analysebericht zu Kundenfeedback | Unstrukturierte Texte kategorisieren und zusammenfassen |
| Professionelle Büroarbeit | Webseite zur chinesischen Farbästhetik | Visuelles Gespür und Weblayout |
| Professionelle Büroarbeit | Generator für Veranstaltungseinladungen | Formularinteraktion + Layoutdesign |
Drei der vier Beispiele aus der Softwareentwicklung haben direkt mit 3D zu tun. Sie passen damit zum Schwerpunkt auf nativen visuellen Fähigkeiten und Visual Coding. In der Bürogruppe geht es dagegen eher darum, Material auszuwerten und fertige Ergebnisse zu erstellen – ähnlich wie bei Aufgaben in Benchmarks wie JobBench und GDPVal.
Wo steht LongCat 2.5 im Benchmark-Vergleich?
Die offizielle Evaluation umfasst mehr als 25 Tests in drei Kategorien: Code Agent, General Agent und Visual. Die folgende Tabelle vergleicht fünf Modelle anhand von neun ausgewählten Benchmarks.
| Benchmark | LongCat-2.5 | Claude Opus 5 | GPT-5.6-Sol | GLM-5.3 | Kimi K3 |
|---|---|---|---|---|---|
| Terminal Bench v2.1 | 88,4 | 89,1* | 88,8* | 88,2* | 88,3* |
| Terminal Bench v4.0 | 38,5 | 53,9* | 37,3* | 41,8* | 12,6* |
| DeepSWE v1.1 | 64,6 | 68,8* | 72,7* | 66,9* | 67,5* |
| BrowseComp | 91,9 | 90,8* | 90,4* | 81,0 | 91,2* |
| HLE w/tools | 63,1 | 64,7* | 58,0* | 62,5* | 56,0* |
| JobBench | 65,4 | 66,7* | 45,4* | 61,4* | 52,9* |
| MCP Atlas | 83,1 | 85,8* | 81,8* | 84,2* | 84,2* |
| 3DCodeBench Text to 3D | 55,4 | 54,3 | 52,3 | 53,4 | 49,3 |
| Vision2Web | 78,6 | 80,2* | 73,5* | 77,8* | 79,0* |
Mit * gekennzeichnete Werte stammen aus öffentlich zugänglichen Ranglisten oder technischen Berichten, die LongCat offiziell zitiert. Die übrigen Werte hat LongCat selbst ermittelt; sie dienen nur als Vergleichswerte.
Aus den Ergebnissen lassen sich einige Punkte ablesen:
- Rechercheaufgaben: Mit 91,9 bei BrowseComp erzielt LongCat den höchsten Wert der fünf Modelle. Zum Einsatz kam ein selbst entwickeltes, schlankes Harness mit nur zwei aktivierten Tools: search und browse_with_goal. Erlaubt waren maximal 1024 Runden.
- 3D-Generierung: Bei 3DCodeBench Text to 3D liegt LongCat mit 55,4 ebenfalls vorn. Allerdings trägt in dieser Zeile keiner der fünf Werte ein Sternchen – sie stammen also alle aus LongCats eigenen Tests.
- Terminal-Aufgaben: Bei Terminal Bench v2.1 liegen alle fünf Modelle eng zwischen 88,2 und 89,1. Bei der schwierigeren Version v4.0 erreicht LongCat-2.5 38,5 und Claude Opus 5 53,9 – ein Abstand von 15,4 Punkten.
- Fehlerbehebung auf Repository-Ebene: Bei DeepSWE v1.1 erzielt LongCat mit 64,6 den niedrigsten Wert der fünf Modelle. GPT-5.6-Sol erreicht 72,7.
- Tool-Aufrufe und Büroaufgaben: Bei MCP Atlas erreicht LongCat 83,1 und bei JobBench 65,4. Das sind 2,7 beziehungsweise 1,3 Punkte weniger als bei Opus 5.
Auch das Harness ist wichtig: Beide Versionen von Terminal Bench nutzen das Claude Code Harness mit einem max_seq_length von 512K. DeepSWE verwendet mini-swe-agent mit einer Sequenzlänge von 1M. Werte aus Tests mit unterschiedlichen Harnesses sollten nicht direkt miteinander verglichen werden.
Was kostet LongCat 2.5? Preisvergleich und Rechnung für 1 Million Token
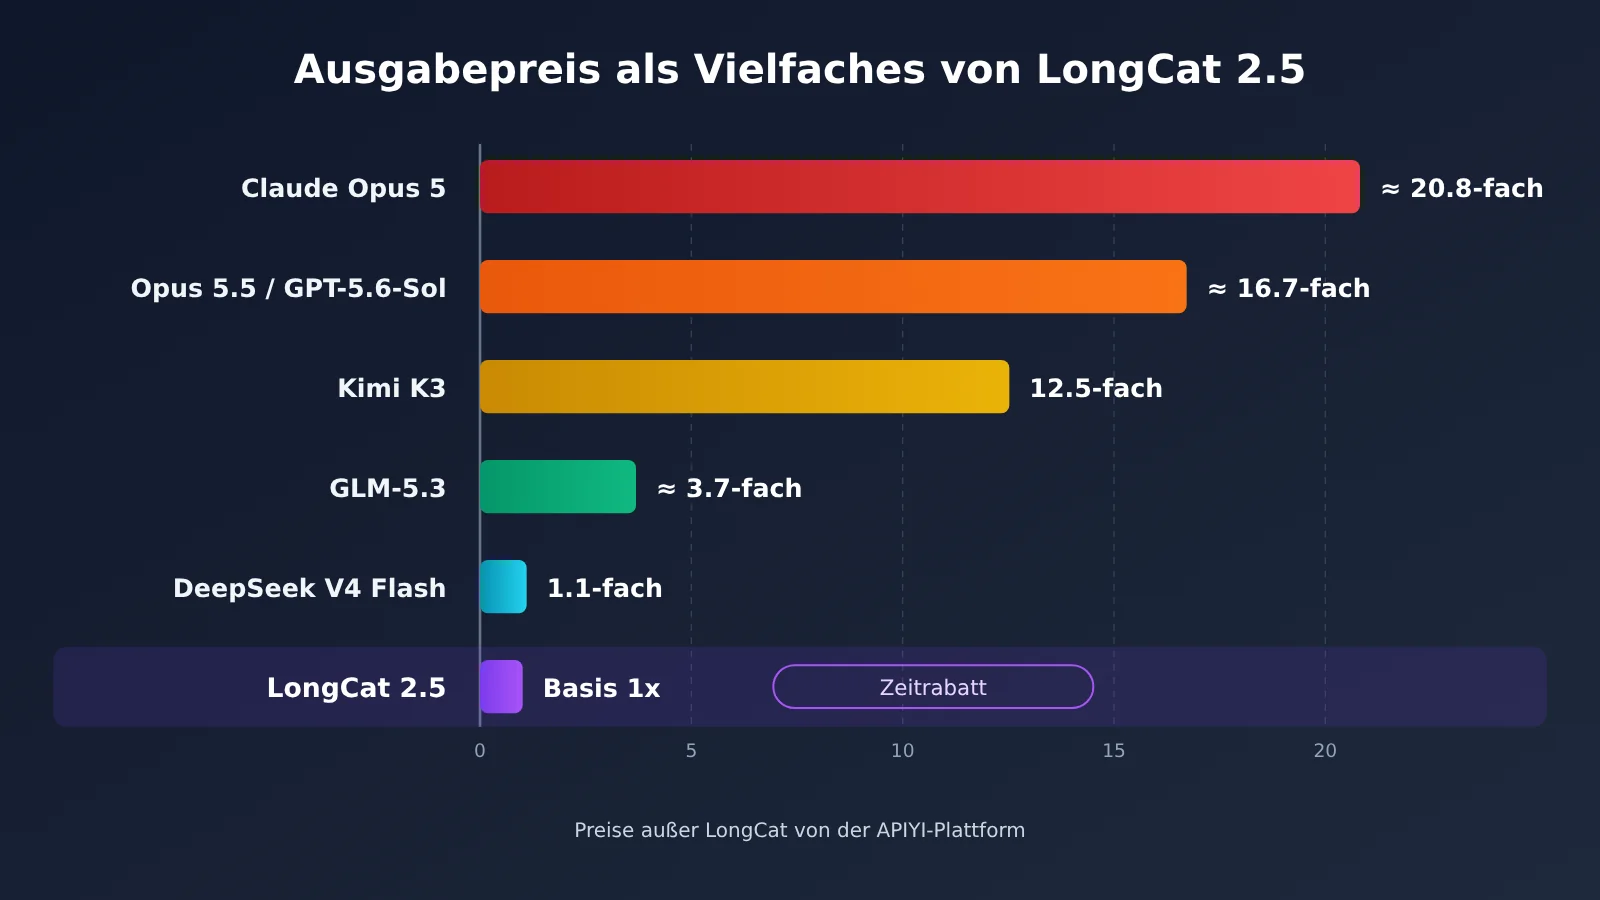
Bildunterschrift: Für LongCat-2.5 gilt der zeitlich begrenzte Rabattpreis der offiziellen API-Plattform. Die Preise der übrigen Modelle stammen aus der Modellliste der Plattform APIYI auf apiyi.com.
| Modell | Eingabe (pro 1 Million Token) | Ausgabe (pro 1 Million Token) | Ausgabepreis im Vergleich zu LongCat |
|---|---|---|---|
| LongCat-2.5 (zeitlich begrenzter Rabatt, offizielle Plattform) | $0.30 (Cache-Treffer $0.006) | $1.20 | 1-fach |
| Claude Opus 5 | $5 | $25 | ca. 20,8-fach |
| Claude Opus 5.5 | $4 | $20 | ca. 16,7-fach |
| GPT-5.6-Sol | $4 | $20 | ca. 16,7-fach |
| Kimi K3 | $3 | $15 | 12,5-fach |
| GLM-5.3 | $1.4 | $4.396 | ca. 3,7-fach |
| DeepSeek V4 Flash | $0.44 | $1.32 | ca. 1,1-fach |
Die Preise auf APIYI apiyi.com wurden am 02.11.2026 abgerufen und entsprechen der Modellliste an diesem Tag. Die Preise für LongCat-2.5 stammen von der LongCat-API-Plattform; laut Anbieter können sie sich ändern.
Die Rechnung für 1 Million Token
Nehmen wir an, ein Batch-Auftrag umfasst insgesamt 1 Million Token: 800.000 Eingabe- und 200.000 Ausgabe-Token, ohne Berücksichtigung des Caches.
- LongCat-2.5 (zeitlich begrenzter Rabatt): 0,8 × $0.30 + 0,2 × $1.20 = $0.48
- DeepSeek V4 Flash: $0.352 + $0.264 = $0.616
- GLM-5.3: $1.12 + $0.879 ≈ $2.00
- Kimi K3: $2.40 + $3.00 = $5.40
- GPT-5.6-Sol oder Claude Opus 5.5: $3.20 + $4.00 = $7.20
- Claude Opus 5: $4.00 + $5.00 = $9.00
Für denselben Auftrag kostet Opus 5 also etwa 18,75-mal so viel wie LongCat-2.5. Wenn der Cache greift, wird der Unterschied noch größer. Das offizielle Beispiel geht von 1 Million Eingabe-Token aus (400.000 Cache-Treffer, 600.000 ohne Treffer) und 500.000 Ausgabe-Token. Die Rechnung beträgt $0.18 + $0.0024 + $0.6 = $0.7824. Eingabe-Token mit Cache-Treffer kosten nur $0.006 – ein Fünfzigstel des Preises ohne Treffer.
Zwei weitere Abrechnungsdetails sind wichtig: Nur Anfragen mit der Antwort HTTP 200 werden berechnet. Fehlgeschlagene Anfragen mit Statuscodes wie 401, 403, 429 oder 500 kosten nichts. Das Guthaben wird im Voraus aufgeladen und verfällt nicht; vorhandenes Bonusguthaben wird zuerst aufgebraucht.
Wie Sie sich den Vergleich mehrerer Modelle erleichtern
In der Praxis kommt ein Agent-Projekt selten mit nur einem Modell aus. Vielleicht möchten Sie dieselben Eingabeaufforderungen mit LongCat-2.5, Claude, GPT und GLM testen und die Ergebnisse vergleichen. Bei APIYI auf apiyi.com können Sie mit einem Konto und einem API-Schlüssel zwischen Modellen wechseln, statt bei jedem Anbieter ein eigenes Konto anzulegen und Guthaben aufzuladen.
📌 Hinweis: Die verfügbaren Modelle und Preise finden Sie in der Modellliste von APIYI auf apiyi.com. LongCat-2.5 ist bei APIYI derzeit noch nicht verfügbar, soll aber so bald wie möglich angeboten werden.
Einstieg in LongCat 2.5: Weboberfläche und API-Anbindung
Schritt 1: Zuerst im Browser ausprobieren
Der offizielle Zugang zum Online-Chat ist longcat.ai/chat. Laut einem Community-Beitrag erhalten neue Nutzer während der Einführungsphase 10 Millionen Tokens und bestehende Nutzer 5 Millionen Tokens geschenkt. Das Guthaben wird automatisch gutgeschrieben; Cache-Treffer verbrauchen davon nichts. Der Beitrag erwähnt außerdem ein zeitlich begrenztes Angebotspaket für 9,9 Yuan, das „demnächst verfügbar“ sein soll. Probieren Sie zunächst Such- und Bildverständnisaufgaben aus: In diesen beiden Bereichen liegt das Modell bei den Benchmarks weit vorne.
Schritt 2: API nutzen – vier Angaben merken
- Endpunkt im OpenAI-Format:
https://api.longcat.ai/openai - Endpunkt im Anthropic-Format:
https://api.longcat.ai/anthropic - Feld model:
LongCat-2.5 - Kontext und Ausgabe: 1 Million Tokens Kontext, maximal 128.000 Tokens Ausgabe
Zu den Rate-Limits gibt der Anbieter nur an, dass bei Überschreitung HTTP 429 mit dem Fehlercode rate_limit_exceeded und einem retry_after-Wert von 60 zurückgegeben wird. Für erneute Versuche empfiehlt er exponentielles Backoff auf Client-Seite. Konkrete RPM- und TPM-Werte wurden nicht veröffentlicht.
Wenn Ihr Code bereits das OpenAI SDK für andere Modelle verwendet, müssen Sie für den Wechsel nur base_url, api_key und model anpassen. Nutzen Sie beispielsweise APIYI mit der base_url https://api.apiyi.com/v1, wechseln Sie für die offizielle LongCat-API zu https://api.longcat.ai/openai und setzen model auf LongCat-2.5.
Schritt 3: In Claude Code einbinden
- Claude Code, Abschnitt
envin~/.claude/settings.jsonändern: FürANTHROPIC_AUTH_TOKENden LongCat-API-Schlüssel eintragen - Abschnitt
envderselben Datei: FürANTHROPIC_BASE_URLhttps://api.longcat.ai/anthropiceintragen - Abschnitt
envderselben Datei: FürANTHROPIC_MODELLongCat-2.5eintragen - Abschnitt
envderselben Datei: FürCLAUDE_CODE_MAX_OUTPUT_TOKENS131072eintragen - Abschnitt
envderselben Datei (ebenfalls empfohlen):ANTHROPIC_SMALL_FAST_MODEL,ANTHROPIC_DEFAULT_SONNET_MODELundANTHROPIC_DEFAULT_OPUS_MODELjeweils aufLongCat-2.5setzen
Bleiben die letzten drei Variablen unverändert, könnten interne Teilaufgaben von Claude Code weiterhin die Standardmodelle anfragen. Das kann zu Fehlern oder einer unerwarteten Abrechnung führen.
Schritt 4: In Cline einbinden
- Cline, Einstellungsbereich in der VS-Code-Seitenleiste: Als API Provider eine OpenAI-kompatible Option auswählen
- Im selben Bereich: Als Base URL
https://api.longcat.ai/openaieintragen - Im selben Bereich: Als API Key den LongCat-API-Schlüssel und als Model ID
LongCat-2.5eintragen
Die offizielle LongCat-Dokumentation bietet eine eigene Anleitungsseite für Cline. Maßgeblich sind die dort angegebenen Feldnamen. Außerdem gibt es Anleitungsseiten für mehr als zehn weitere Tools, darunter Codex, OpenCode, Kilo Code, Cherry Studio, Chatbox und CC Switch.
🚀 Tipp für den schnellen Einstieg: Testen Sie Ihre Aufgaben zunächst mit dem offiziellen Startguthaben und entscheiden Sie danach, ob Sie LongCat dauerhaft einbinden möchten. Wenn Sie zum Vergleich auch Claude, GPT und Gemini aufrufen möchten, können Sie diese bei APIYI auf apiyi.com über eine gemeinsame OpenAI-kompatible Schnittstelle verwalten. Sobald LongCat-2.5 dort verfügbar ist, können Sie im selben Konto direkt zwischen den Modellen wechseln.
Wofür eignet sich LongCat 2.5?
| Geeignet für LongCat 2.5 | Erst einmal abwarten |
|---|---|
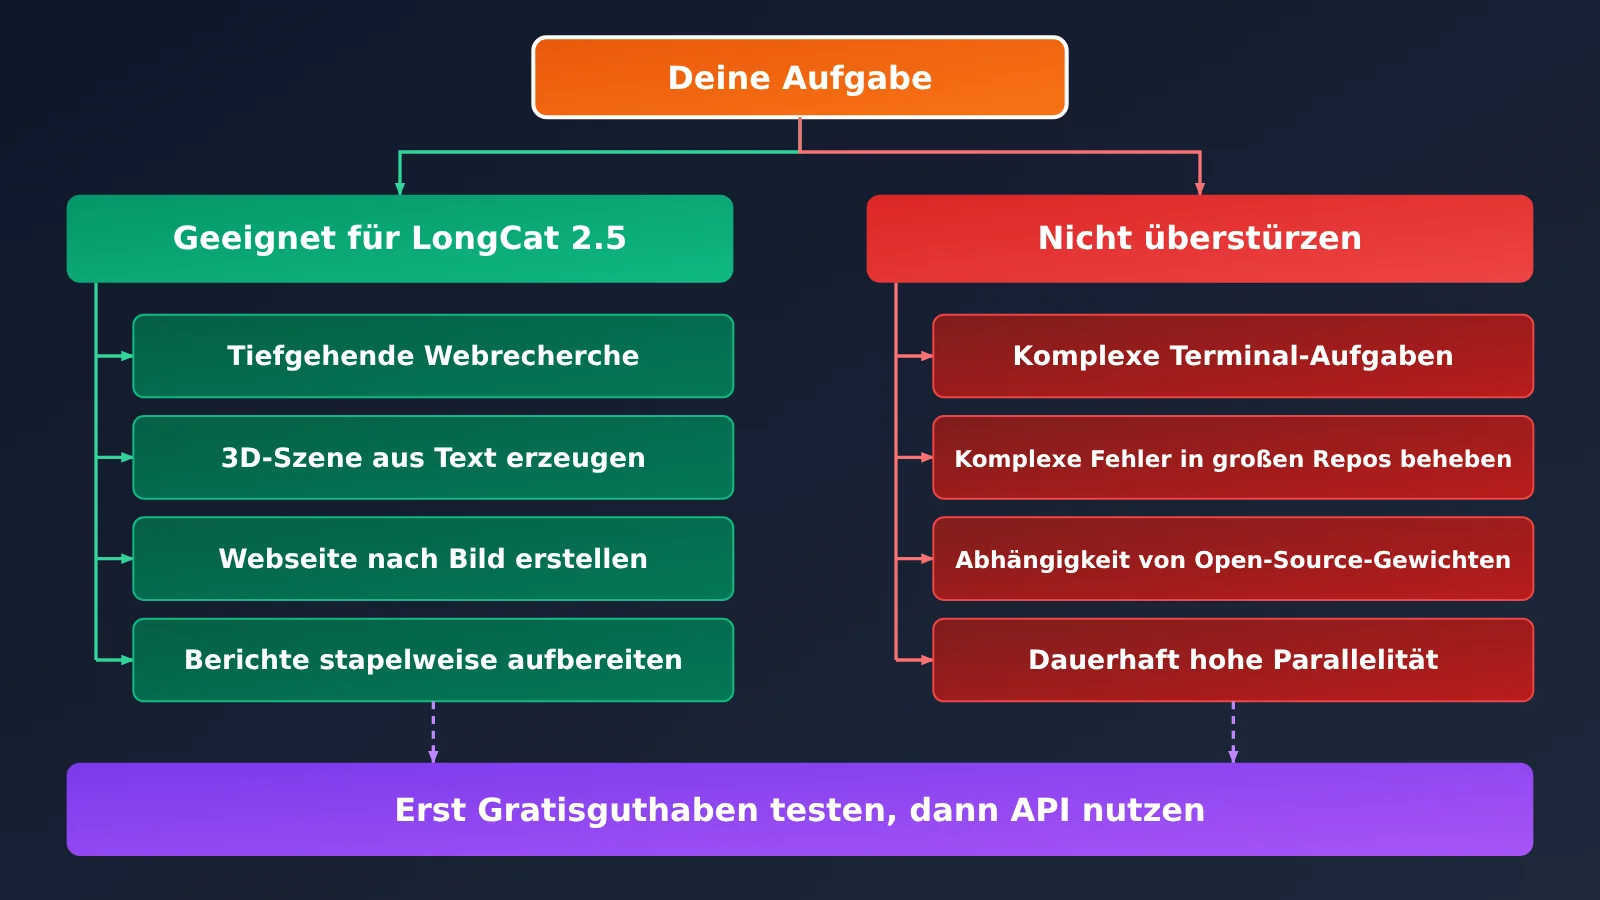
| Webrecherche über mehrere Schritte und Zusammenfassung von Quellen (BrowseComp 91.9) | Anspruchsvolle, mehrstufige Administrationsaufgaben im Terminal (Terminal Bench v4.0: 38.5, Opus 5: 53.9) |
| 3D-Szenen etwa mit Three.js anhand von Textbeschreibungen erzeugen (3DCodeBench 55.4) | Schwierige Bugfixes in großen Repositories (DeepSWE v1.1: 64.6, der niedrigste Wert der fünf Spalten) |
| Webseiten anhand von Designvorlagen oder Screenshots erstellen (Vision2Web 78.6) | Projekte, die eine eigene Bereitstellung und lokale Modellgewichte erfordern (Gewichte noch nicht veröffentlicht) |
| Kundenfeedback und Geschäftsdaten in großen Mengen aufbereiten und daraus Texte erstellen (JobBench 65.4, zeitlich begrenzter Angebotspreis für die Ausgabe: $1.20/Million Token) | Produktivdienste, die ein festes Kontingent für hohe Parallelität benötigen (RPM/TPM offiziell nicht veröffentlicht) |
Die Aufgaben in der linken Spalte haben eines gemeinsam: Sie sind umfangreich, verbrauchen viele Token und reagieren empfindlich auf den Preis. Hier überzeugen sowohl die Benchmark-Ergebnisse als auch der Preis von LongCat-2.5. Die rechte Spalte bedeutet nicht, dass das Modell diese Aufgaben nicht bewältigen kann. Allerdings sind die Leistungsunterschiede noch sichtbar oder die Bedingungen für Bereitstellung und Kontingente unklar. Hier lohnt sich zunächst ein kleiner Test.
Häufige Fragen zu LongCat 2.5
F1: Wurden die Benchmark-Ergebnisse von LongCat 2.5 unabhängig getestet?
Nein. Alle Werte für LongCat-2.5 in der Tabelle stammen aus eigenen Tests von LongCat. Bei den Vergleichsmodellen stammen die mit einem Sternchen markierten Werte aus öffentlichen Berichten oder offiziellen Bestenlisten; die übrigen ebenfalls aus LongCats eigenen Tests. Die Ergebnisse dienen daher am besten als Orientierung für einen Vergleich.
F2: Ist 1,20 $ pro Million Tokens der dauerhafte Preis?
Nein. LongCat kennzeichnet ihn als zeitlich begrenzten Rabattpreis und weist darauf hin, dass sich die Preise ändern können. Massgeblich sind die Angaben auf der LongCat-API-Plattform und die Abrechnung. Für die langfristige Budgetplanung empfiehlt sich ein alternatives Modell. Über eine Plattform wie APIYI apiyi.com bleibt ein Wechsel bei Bedarf möglich.
F3: Ist LongCat 2.5 Open Source?
Noch nicht. Die GitHub- und HuggingFace-Schaltflächen im offiziellen Blog sind beide mit „Demnächst verfügbar“ gekennzeichnet. Derzeit lässt sich das Modell nur online ausprobieren oder per API nutzen. Einen Zeitplan für die Veröffentlichung als Open Source hat LongCat nicht genannt.
F4: Kann ich LongCat 2.5 über APIYI aufrufen?
Derzeit noch nicht. APIYI wird das Modell so bald wie möglich anbieten. Bis dahin können Sie die offizielle LongCat-API direkt nutzen. Für Vergleichstests mit Claude, GPT und GLM können Sie auf APIYI apiyi.com andere Modelle mit einem einzigen API-Schlüssel aufrufen. Die verfügbaren Modelle und Preise finden Sie in der Modellliste der Plattform.
F5: Was tun bei einem 429-Fehler?
Die Anfrage hat eine Ratenbegrenzung ausgelöst. Die Antwort enthält für `retry_after` den Wert 60. LongCat empfiehlt, Wiederholungsversuche im Client mit exponentiell steigenden Wartezeiten durchzuführen. Anfragen mit einem 429-Fehler werden nicht berechnet und verursachen keine zusätzlichen Kosten.
Fazit: Lohnt sich die Anbindung von LongCat 2.5?
Die wichtigsten Punkte zu LongCat 2.5:
- Ausrichtung: Ein nativ multimodales Modell mit insgesamt 1,6 Billionen Parametern, von denen pro Token rund 48 Milliarden aktiviert werden. Es ist auf länger laufende Agentenaufgaben ausgelegt.
- Verbesserungen: Gegenüber Version 2.0 steigt das Ergebnis im Terminal Bench v4.0 von 3,0 auf 38,5 und im DeepSWE v1.1 von 9,7 auf 64,6.
- Stärken: Mit 91,9 bei BrowseComp und 55,4 bei 3DCodeBench erzielt es die höchsten Werte der fünf hier verglichenen Modelle – laut offiziellen Angaben.
- Rückstand: Bei Terminal Bench v4.0 und DeepSWE v1.1 gibt es weiterhin einen sichtbaren Abstand.
- Preis: Im zeitlich begrenzten Angebot kosten eine Million Ausgabe-Token 1,20 $. Für 800.000 Eingabe- und 200.000 Ausgabe-Token fallen etwa 0,48 $ an.
- Anbindung: OpenAI- und Anthropic-Protokoll werden unterstützt. Für Claude Code müssen nur vier Variablen geändert werden.
Kurz gesagt: Testen Sie Such- und Bildverständnisaufgaben zunächst auf longcat.ai/chat mit dem kostenlosen Guthaben von 10 Millionen Token. Wenn alles funktioniert, können Sie zur API wechseln. Wer langfristig zwischen mehreren Modellen wechseln möchte, kann sie gemeinsam über APIYI apiyi.com verwalten.
📚 Quellen
- Offizieller LongCat-Blog: Artikel zur Veröffentlichung von LongCat-2.5 mit Architektur, Training und Evaluationstabellen
- Link:
longcat.ai/blog/longcat-2.5 -
Hinweis: Primärquelle für die Parameterzahl, acht Demo-Beispiele und die Angaben zu den Benchmark-Ergebnissen
-
LongCat-API-Plattformdokumentation: Schnittstellen, Abrechnung und Anbindung von Tools
- Link:
longcat.ai/platform/docs -
Hinweis: Endpunkte für beide Protokolle, zeitlich begrenzte Rabattpreise und Anleitungen zur Anbindung von Claude Code und Cline
-
APIYI-Modellliste: Plattformpreise der einzelnen Modelle
- Link:
docs.apiyi.com/models - Hinweis: Quelle für die Preisvergleiche in diesem Artikel. Maßgeblich sind die jeweils aktuell angezeigten Preise.
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gern über die Startseite von APIYI. Weitere Informationen finden Sie im Dokumentationszentrum unter docs.apiyi.com.