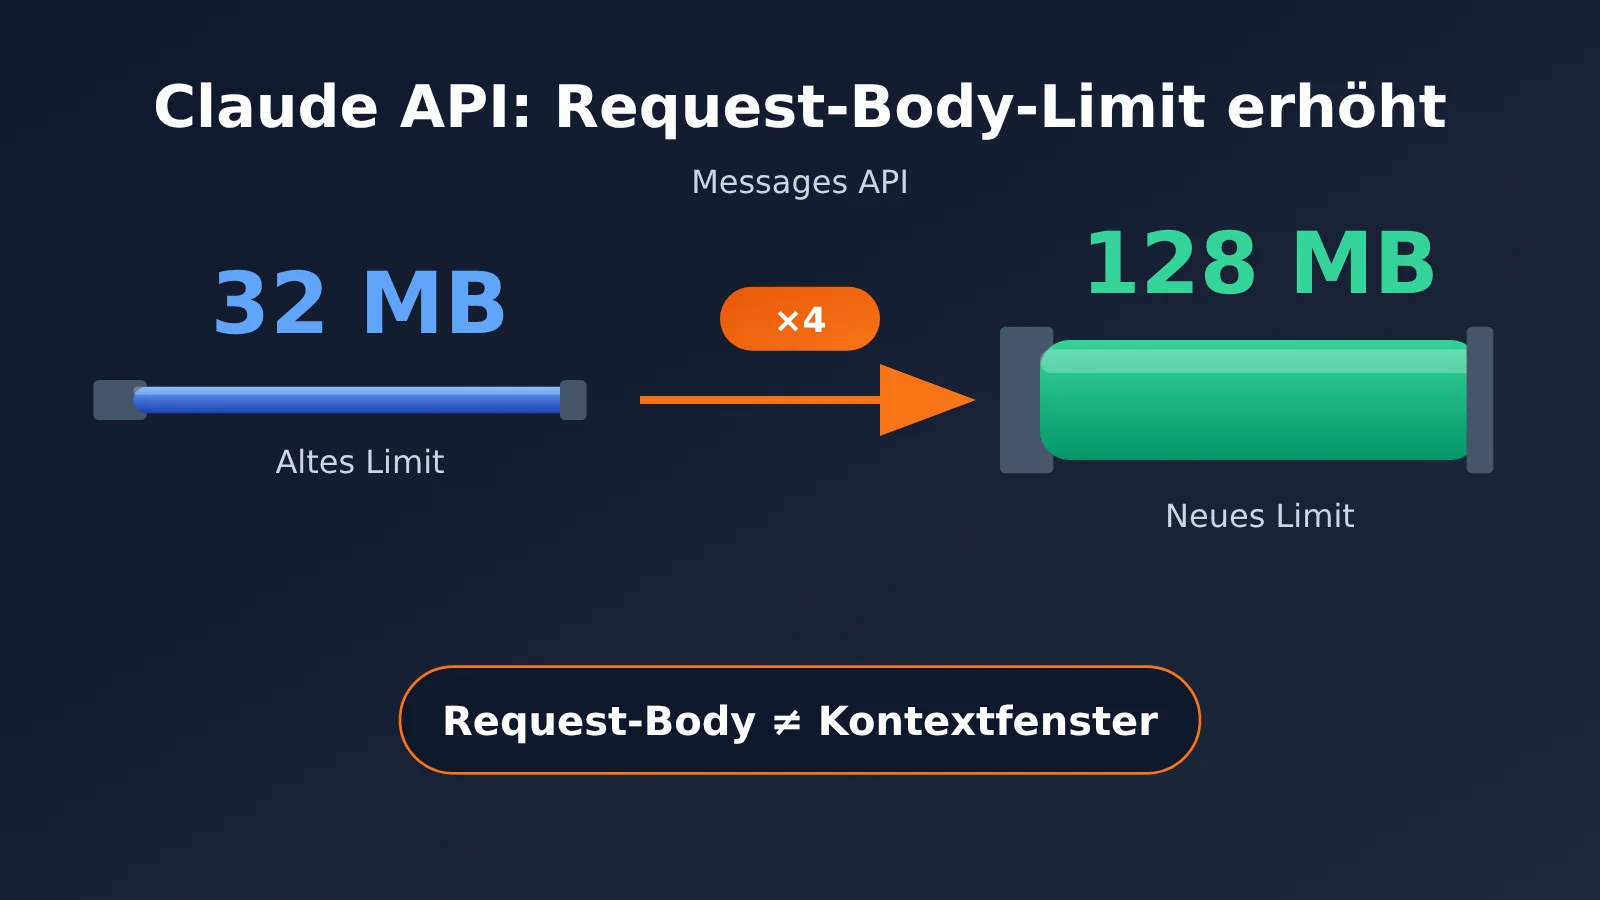
Am 28. Oktober 2026 kündigte Anthropic in seinem offiziellen Änderungsprotokoll ein Update an: Die maximale Größe des Anfragekörpers für die Messages API und die Token Counting API der Claude API stieg von 32 MB auf 128 MB. Das Limit hat sich damit vervierfacht. Seit der Ankündigung stellen sich viele technische Verantwortliche in Unternehmen eine praktische Frage: Sollten sie die Prozesse zum Aufteilen, Hochladen und Vorverarbeiten großer Dateien überarbeiten, die ursprünglich zur Umgehung des 32-MB-Limits entwickelt wurden?
Dieses Update macht das Modell nicht leistungsfähiger. Es ändert die Größenbegrenzung für Anfragekörper auf HTTP-Ebene, nicht das Kontextfenster des Modells oder die Ausgabelänge. Zu Fehleinschätzungen kommt es vor allem dann, wenn 128 MB mit 128K oder 1M Token verwechselt werden.
Das Wichtigste im Überblick: Dieser Artikel erklärt zunächst, welches Limit bei der Claude API angehoben wurde. Anschließend ordnet er verschiedene Geschäftsszenarien in die Kategorien A, B und C ein und liefert einen kostengünstigen, umsetzbaren Validierungsplan samt Checkliste. Die Architekturvorschläge sind eine technische Analyse auf Basis offizieller Informationen und keine offiziellen Migrationsanweisungen von Anthropic.
Claude API: Die wichtigsten Fakten zur Erweiterung des Request-Bodys
Die folgende Tabelle fasst die Fakten zum Update der Claude API zusammen. Sie bilden die Grundlage für die weitere Analyse.
| Information | Details | Quelle |
|---|---|---|
| Veröffentlichungsdatum | 28. Oktober 2026 | Offizielles Änderungsprotokoll (S1) |
| Anbieter | Anthropic | Offizielles Änderungsprotokoll (S1) |
| Betroffene Endpunkte | Messages API und Token Counting API der Claude API von Anthropic | S1, S2 |
| Zentrale Änderung | Maximaler Request-Body von 32 MB auf 128 MB erhöht | S1, S2 |
| Unverändert | Kontextfenster und Ausgabelänge der Modelle werden dadurch nicht erweitert | S2, S5 |
| Bei Überschreitung | HTTP-413-Fehler request_too_large |
S2 |
| Abrechnung | Weiterhin nach Token-Verbrauch; ein größerer Request-Body bedeutet nicht, dass die Dateiverarbeitung kostenlos ist | S6 |
Die Größenlimits unterscheiden sich je nach Claude-API-Endpunkt
Wichtig: Für die Endpunkte der Claude API von Anthropic gilt kein einheitliches Größenlimit. Mit diesem Update wurden nur die Limits für Messages und Token Counting angepasst. Für die anderen Endpunkte gelten weiterhin ihre jeweiligen Grenzen. Bei Architekturentscheidungen sollten Unternehmen daher nicht nur eine einzelne Zahl betrachten.
| Endpunkt | Aktuelles Limit für die Anfragegröße | Erläuterung |
|---|---|---|
| Messages API | 128 MB | Mit diesem Update von 32 MB erhöht |
| Token Counting API | 128 MB | Von 32 MB erhöht, entsprechend dem Limit der Messages API |
| Batch API | 256 MB | Für die asynchrone Stapelverarbeitung |
| Files API | 500 MB | Speicherlimit von 500 MB pro Datei |
| Sessions / Agents / Environments | 32 MB | Bisheriges Limit bleibt bestehen |
Die Daten stammen aus der offiziellen API-Übersicht (S2). Wenn deine Anwendung sowohl Messages- als auch Agents-Endpunkte verwendet, musst du die Größenlimits weiterhin getrennt einplanen. Ein einheitliches Limit von 128 MB lässt sich nicht auf beide anwenden.
Welche Grenze die Erweiterung der Claude-API-Request-Body-Größe verändert
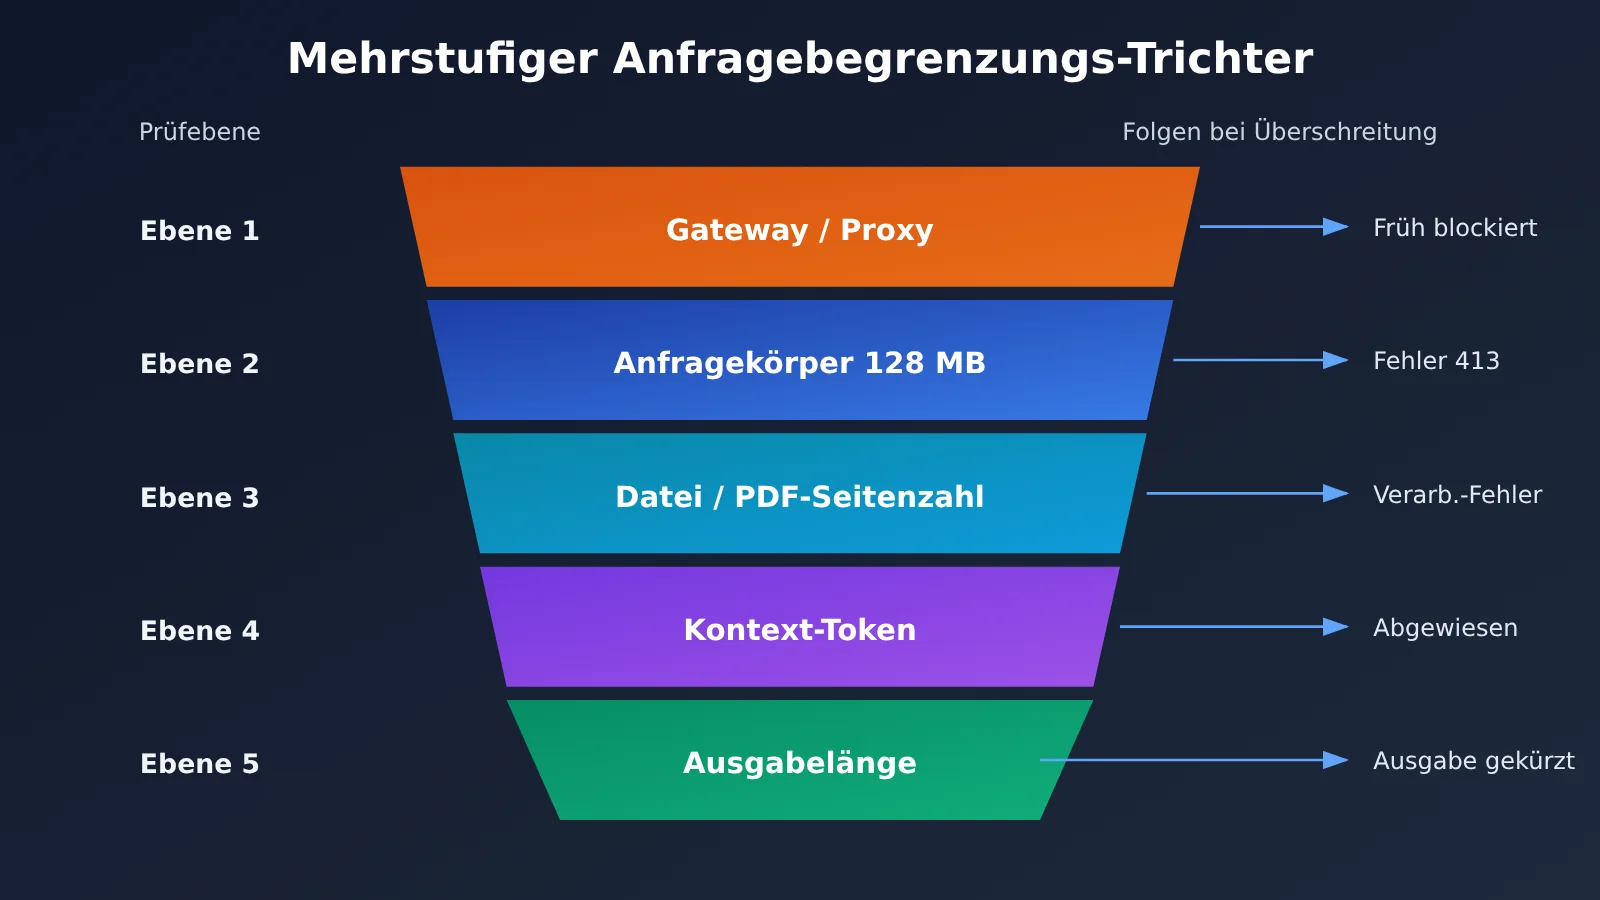
Ein Aufruf der Claude API muss mehrere „Kontrollpunkte“ passieren. Die Größe des Request-Bodys ist nur der äußerste davon. Wer entscheiden möchte, ob eine Architekturänderung nötig ist, sollte die einzelnen Grenzen auseinanderhalten.
| Art der Begrenzung | Maßeinheit | Änderung | Folge bei Überschreitung |
|---|---|---|---|
| Größe des HTTP-Request-Bodys | Byte (MB) | Ja, für Messages / Token Counting auf 128 MB erhöht | HTTP 413 request_too_large |
| Kontextfenster des Modells | Token | Nein | Anfrage wird abgelehnt oder muss gekürzt werden |
| Datei- und PDF-Grenzen | Dateigröße, Seitenzahl | PDF-Request-Body auf 128 MB begrenzt, separate Grenze für die Seitenzahl | Datei kann nicht vollständig verarbeitet werden |
| Ausgabelänge | Token | Nein | Ausgabe wird abgeschnitten |
Ein Request-Body von 128 MB bedeutet nicht, dass das Modell 128 MB „versteht“
Die Größe des Request-Bodys misst die über das Netzwerk übertragenen Bytes. Das Kontextfenster gibt dagegen an, wie viele Token das Modell auf einmal verarbeiten kann. Ein hochauflösendes Bild kann mehrere MB groß sein, muss aber nicht entsprechend viele Token belegen. Reiner Text kann hingegen nur wenige hundert KB umfassen und trotzdem die Grenze des Kontextfensters fast erreichen. „Mehr Bytes senden“ und „mehr Inhalte verstehen“ sind also zwei verschiedene Dinge.
Außerdem müssen Binärdaten wie Bilder und PDFs in JSON-Anfragen normalerweise mit Base64 kodiert werden. Dabei wächst ihr Umfang auf etwa das 4/3-Fache der ursprünglichen Größe. Ein Request-Body von 128 MB kann also deutlich weniger als 128 MB an ursprünglichen Binärdateien aufnehmen. Diesen zusätzlichen Platzbedarf sollten Sie bei der Größenplanung berücksichtigen.
Wie hängen die Größe des Claude-API-Request-Bodys und die PDF-Seitenzahl zusammen?
Laut der offiziellen PDF-Dokumentation (S3) gilt bei der Verarbeitung von PDFs über die direkte Schnittstelle eine Request-Body-Grenze von 128 MB. Für die Seitenzahl gibt es jedoch eine separate Grenze, die vom Kontextfenster des verwendeten Modells abhängt. Ein eingescannter Vertrag mit 100 MB kann also die HTTP-Ebene passieren und trotzdem nicht vollständig verarbeitet werden, weil die Seitenzahl oder die Token-Zahl das Kontextfenster überschreitet.
Welche Unternehmensanwendungen von der größeren Claude-API-Anfrage profitieren könnten
Die folgende Einschätzung ist eine Annahme und setzt voraus, dass die jeweilige Anwendung bisher tatsächlich durch die Grenze von 32 MB für den Anfragekörper eingeschränkt war. Selbst dann bedeutet die Erweiterung nicht, dass sich die Aufteilung in kleinere Abschnitte immer vermeiden lässt.
- Analyse großer PDFs und Verträge: Rechts- und Prüfungsabteilungen müssen häufig eingescannte Verträge oder Berichte mit vielen Anhängen einreichen. Scans benötigen viel Speicherplatz, enthalten aber oft vergleichsweise wenig Text. Lag das Hauptproblem bisher darin, dass die Datei größer als 32 MB war, könnte sie sich nun in einer einzigen Anfrage übermitteln lassen. Sind dagegen die Seitenzahl oder die Anzahl der Kontext-Token der Engpass, ist der Vorteil begrenzt.
- Übermittlung mehrerer Bilder oder mehrseitiger Unterlagen: Bei Versicherungsansprüchen oder Qualitätskontrollen werden einer Anfrage häufig zahlreiche Fotos vom Einsatzort beigefügt. Zusammen überschreiten sie schnell die alte Grenze. Die Erweiterung könnte deshalb den Fehler 413 seltener machen. Die Anzahl der Bilder bleibt jedoch durch das Modell und das Kontextfenster begrenzt.
- KI-Anwendungen mit umfangreichen strukturierten Daten: Manche Systeme übergeben große Mengen an JSON-Daten, Logs oder Tabellen direkt in der Anfrage. Auf Byte-Ebene steht nun zwar mehr Platz zur Verfügung, doch solche Daten enthalten oft besonders viele Token. Daher wird das Kontextfenster häufig vor der Grenze von 128 MB erreicht.
- Anwendungen, die Eingaben bisher nur wegen der 32-MB-Grenze aufgeteilt haben: Sie profitieren am unmittelbarsten. War die Begrenzung des Anfragekörpers der einzige Grund für die Aufteilung, lohnt es sich jetzt zu prüfen, ob sie noch nötig ist.
🎯 Technischer Tipp: Messen Sie zunächst anhand echter Beispieldaten sowohl die Größe in Byte als auch die Anzahl der Token. So lässt sich feststellen, wo der Engpass tatsächlich liegt. Über APIYI apiyi.com können Sie Claude und andere gängige Modelle mit demselben API-Schlüssel für Vergleichstests aufrufen. Die Grenze für den Anfragekörper kann bei Drittplattformen allerdings von der offiziellen API abweichen. Prüfen Sie daher vor dem Produktivstart, welche Grenze die Plattform aktuell unterstützt.
Claude API: Muss die Architektur nach der Erhöhung des Request-Body-Limits angepasst werden? Drei Fälle: A, B und C
Ob eine Architekturanpassung nötig ist, hängt nicht davon ab, dass das offizielle Limit gestiegen ist. Entscheidend ist, welches Problem das ursprüngliche Design lösen sollte.
| Situation | Typische Merkmale | Empfehlung | Priorität |
|---|---|---|---|
| A. Nie in die Nähe von 32 MB gekommen | Request-Bodies sind meist nur wenige MB groß, keine 413-Fehler in den Logs | Alles belassen und die Änderung dokumentieren | Niedrig |
| B. Häufig 413-Fehler wegen der Request-Body-Größe | Der Anteil von 413-Fehlern mit request_too_large im Monitoring ist auffällig |
Upload-Pfad testen und optimieren, weniger Aufteilung prüfen | Hoch |
| C. Aufteilung aus Gründen des Kontexts, der Genauigkeit, der Leistung oder der Kosten | Die Aufteilung dient einer präziseren Suche, der Kostenkontrolle oder geringerer Latenz | Aufteilung, Suche und Caching beibehalten | Unverändert |
Fall A: Systeme, die nie in die Nähe von 32 MB kommen
Bei den meisten Anwendungen für reine Textdialoge, Kundenservice oder Codeunterstützung liegt der Request-Body weit unter 32 MB. Hier besteht normalerweise kein unmittelbarer Anpassungsbedarf. Ein unnötiger Umbau würde nur neue Risiken schaffen. Es reicht, die Endpunkt-Limits in der technischen Dokumentation zu aktualisieren, damit sie bei späteren Problemen zur Hand sind.
Fall B: Systeme mit häufigen 413-Fehlern wegen des Request-Body-Limits
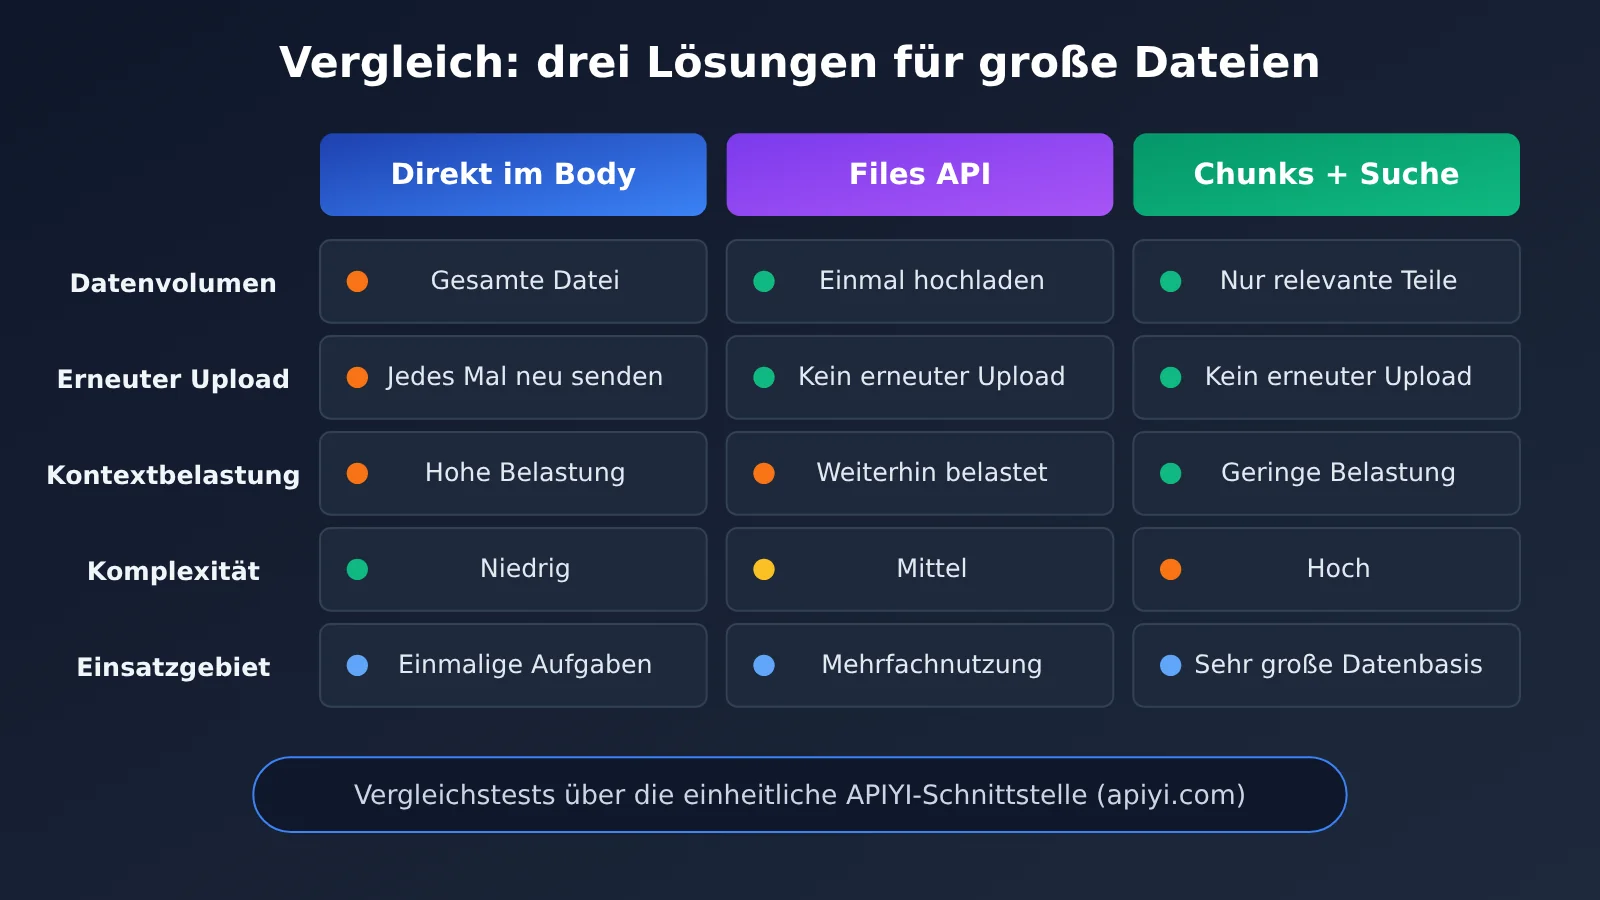
Wenn das Monitoring gehäuft 413-Fehler zeigt und feststeht, dass der Request-Body das Limit des Messages-Endpunkts überschreitet, lohnt sich ein Test der Änderung. Prüfen Sie, ob sich Teile der Aufteilungslogik durch eine einzelne Anfrage ersetzen lassen. Alternativ können Sie die Files API nutzen und Dateien über ihre file_id referenzieren, um wiederholte Übertragungen zu vermeiden.
Fall C: Aufteilung aus Gründen der Qualität, Kosten oder Leistung
Viele RAG-Systeme teilen Inhalte nicht deshalb in Chunks auf, weil die Anfrage sonst zu groß wäre. Vielmehr soll die Suche präziser werden, jeder Aufruf weniger Token verbrauchen und die Antwort schneller erfolgen. Ein höheres Request-Body-Limit ändert daran nichts. Wer in diesem Fall auf Chunking verzichtet, riskiert höhere Kosten und schlechtere Antworten. Die nötige Aufteilung sowie das Such- und Caching-Design sollten daher erhalten bleiben.
Claude API: Architektur-Check in 5 Schritten vor der Vergrößerung des Request-Bodys
Auch in Fall B empfiehlt es sich, die folgenden Punkte der Reihe nach zu prüfen. Viele Teams erhalten trotz höherer offizieller Limits weiterhin Fehlermeldungen – oft liegt die Ursache in einer zwischengeschalteten Komponente.
- Offizielles Limit des Anthropic-Zielendpunkts prüfen: Für Messages gilt ein Limit von 128 MB, für Sessions / Agents / Environments weiterhin 32 MB, für Batch 256 MB und für Files 500 MB (S2).
- Request-Limits von API-Gateway und Reverse-Proxy prüfen: Selbst betriebene Unternehmens-Gateways, Nginx, Load Balancer und WAFs haben oft eigene Standardlimits. Diese können deutlich unter 128 MB liegen und sollten einzeln geprüft werden.
- Client, SDK und Übertragungsweg prüfen: Timeouts, Speicherpufferung und Upload-Verfahren des HTTP-Clients beeinflussen, ob sich große Requests überhaupt senden lassen. Auch die zusätzliche Größe durch Base64-Kodierung muss berücksichtigt werden.
- Separate Grenzen für Token, Kontext und Dateien prüfen: Schätzen Sie die Token-Anzahl mit der Token Counting API und prüfen Sie, ob die PDF-Seitenzahl und das Kontextfenster ausreichen (S3, S5).
- Latenz, Timeouts, Kosten und Fehlerbehandlung bewerten: Große Requests brauchen länger beim Upload, und Wiederholungsversuche nach Fehlern sind aufwendiger. Die Abrechnung erfolgt weiterhin nach Token (S6). Timeout- und Retry-Strategien müssen daher möglicherweise angepasst werden.
Alternative Strategien zum Claude-API-Request-Body
Statt große Dateien direkt in den Request-Body zu packen, lohnt es sich, weitere Optionen zu prüfen:
- Files API und
file_id-Referenzen: Laden Sie eine Datei zunächst hoch und referenzieren Sie sie anschließend in Nachrichten über ihrefile_id. So muss dieselbe Datei nicht bei jedem Request erneut übertragen werden (S4). Das Speicherlimit pro Datei beträgt 500 MB; bei der Verarbeitung durch das Modell gelten jedoch weiterhin Grenzen wie die Kontextkapazität. - Prompt-Caching: Das Caching langer Dokumentpräfixe, die mehrfach verwendet werden, kann die Kosten für wiederholte Eingaben senken. Die genauen Abrechnungsregeln finden Sie auf der offiziellen Preisseite (S6).
- Chunking und Retrieval beibehalten: Bei sehr großen Dokumentbeständen ist es häufig weiterhin sinnvoll, relevante Abschnitte zunächst per Retrieval zu ermitteln und nur diese zu senden. Das bietet meist einen guten Kompromiss zwischen Qualität und Kosten.
Auch das Risiko fehlender Dateitrennung bei mehreren Mandanten sollte nicht unterschätzt werden. Bei der Files API werden Dateien auf Ebene des API-Kontos gespeichert. Teilen sich mehrere Kunden ein Konto, muss die Anwendung den Zugriff auf file_id-Werte strikt voneinander trennen. So lässt sich verhindern, dass ein Request von Mandant A auf eine Datei von Mandant B verweist.
Wie lässt sich der Nutzen des größeren Claude-API-Request-Bodys kostengünstig prüfen?
Derzeit gibt es keine öffentlich zitierbaren Messdaten, die eine höhere Verarbeitungsgeschwindigkeit oder niedrigere Kosten nach der Anhebung des Limits belegen. Am zuverlässigsten ist es daher, den Nutzen mit eigenen Geschäftsdaten zu testen. Der folgende Plan beschreibt einen Test, keine Testergebnisse.
| Teststufe | Größe des Request-Bodys | Beobachtungsschwerpunkt |
|---|---|---|
| Stufe 1 | Deutlich unter 32 MB | Als Basiswert die übliche Dauer und Token-Zahl erfassen |
| Stufe 2 | Nahe 32 MB | Prüfen, ob die Verbindung nahe dem alten Limit stabil bleibt |
| Stufe 3 | Über 32 MB | Prüfen, ob Gateway und SDK die Anfrage durchlassen und ob Fehler 413 auftritt |
| Stufe 4 | Nahe 128 MB | Timeouts, Speicherverbrauch und Kosten fehlgeschlagener Wiederholungsversuche prüfen |
Jede Teststufe sollte innerhalb der zulässigen Modell- und Dateigrenzen liegen. Erfassen Sie dabei sechs Kennzahlen: HTTP-Request-Body-Größe, Token-Zahl, Statuscode, Dauer, Kosten und Ergebnisqualität. Testen Sie anschließend dieselben Beispieldaten mit drei Verfahren: direkter Übertragung, Referenzierung über die Files API und Verarbeitung in Teilen. Anhand der Daten können Sie dann entscheiden, ob der bestehende Ablauf angepasst werden sollte.
Minimalbeispiel: Größe des Claude-API-Request-Bodys messen
Der folgende Code misst vor dem Senden die Größe des Request-Bodys in Byte und fängt 413-Fehler ab, um die Daten während der Tests zu protokollieren:
import json, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

messages = [{"role": "user", "content": "请总结这份长文档的要点:" + open("doc.txt").read()}]
body_mb = len(json.dumps({"messages": messages}).encode("utf-8")) / 1024 / 1024
print(f"请求体约 {body_mb:.2f} MB")

resp = client.chat.completions.create(model="YOUR_CLAUDE_MODEL", messages=messages)
print(resp.usage)  # 记录 Token 用量
Vollständiges Skript zur Testprotokollierung anzeigen
import json
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 通过 APIYI 统一接口调用
)

MODEL = "YOUR_CLAUDE_MODEL"  # 替换为平台模型列表中的 Claude 模型名

def run_case(case_name: str, messages: list) -> dict:
    """记录单次请求的体积、Token、状态、耗时,用于方案对比"""
    body = json.dumps({"model": MODEL, "messages": messages}).encode("utf-8")
    record = {
        "case": case_name,
        "body_mb": round(len(body) / 1024 / 1024, 2),
        "status": None,
        "latency_s": None,
        "prompt_tokens": None,
        "completion_tokens": None,
    }
    start = time.time()
    try:
        resp = client.chat.completions.create(model=MODEL, messages=messages)
        record["status"] = 200
        record["prompt_tokens"] = resp.usage.prompt_tokens
        record["completion_tokens"] = resp.usage.completion_tokens
    except openai.APIStatusError as e:
        record["status"] = e.status_code  # 413 即请求体超限
    except Exception as e:
        record["status"] = f"error: {e}"
    record["latency_s"] = round(time.time() - start, 2)
    return record

if __name__ == "__main__":
    text = open("doc.txt", encoding="utf-8").read()
    cases = {
        "baseline": [{"role": "user", "content": "总结要点:" + text[:20000]}],
        "full_direct": [{"role": "user", "content": "总结要点:" + text}],
    }
    results = [run_case(name, msgs) for name, msgs in cases.items()]
    for r in results:
        print(r)
🚀 Schnellstart: Wenn Ihr Team zunächst den Testablauf erproben möchte, können Sie sich bei APIYI auf apiyi.com registrieren, Testguthaben erhalten und mit dem obigen Skript die Daten für verschiedene Größenstufen protokollieren. Beachten Sie: Bei der Weiterleitung über eine Drittanbieterplattform kann das Gateway-Limit für den Request-Body unter den offiziellen 128 MB liegen. Prüfen Sie daher vor Tests mit großen Datenmengen die Dokumentation der Plattform.
Häufige Fragen (FAQ)
F1: Was bedeutet die Erweiterung des Claude-API-Request-Bodys auf 128 MB konkret?
Die maximale Größe einer einzelnen HTTP-Anfrage an die Messages API und die Token Counting API der offiziellen Claude API wurde von 32 MB auf 128 MB erhöht (S1, S2). Das Limit bezieht sich weder auf das Kontextfenster noch auf die Ausgabelänge.
F2: Was ist der Unterschied zwischen einem 128-MB-Request-Body und einem Kontextfenster von 128K oder 1M Token?
Der Request-Body misst die übertragene Datenmenge in Byte, das Kontextfenster dagegen die Verarbeitungskapazität des Modells in Token. Das sind zwei völlig unterschiedliche Einheiten. Nur weil sich ein Request-Body senden lässt, passt sein Inhalt nicht automatisch ins Kontextfenster. Das Token-Budget muss weiterhin separat mit der Token Counting API geschätzt werden.
F3: Werden Anfragen durch das höhere Limit schneller verarbeitet oder günstiger?
Dafür gibt es weder offizielle Daten noch öffentlich zugängliche Tests. Die Kosten werden weiterhin anhand des Token-Verbrauchs berechnet (S6). Ein größerer Request-Body kann zudem längere Upload-Zeiten verursachen. Ob die Änderung Vorteile bringt, lässt sich nur durch Tests mit eigenen Anwendungsfällen beurteilen.
F4: Wie lässt sich per API schnell prüfen, welche Auswirkungen die Änderung auf den eigenen Anwendungsfall hat?
Dafür können Sie den Testplan mit vier Größenstufen aus diesem Artikel verwenden. Registrieren Sie sich bei APIYI auf apiyi.com, um einen API-Schlüssel zu erhalten, und setzen Sie base_url auf `https://api.apiyi.com/v1`. Erfassen Sie anschließend mit dem Testskript Größe, Token-Zahl, Statuscode und Laufzeit. Da die Plattform andere Limits als der offizielle Anbieter haben kann, sollten Sie vor Tests mit großen Anfragen die unterstützte Obergrenze prüfen.
F5: Muss ein bereits vorhandenes RAG-Chunking-System abgeschafft werden?
In der Regel nicht. Wenn die Aufteilung in Chunks der Suchgenauigkeit dient, die Token-Kosten kontrolliert oder die Latenz senkt, gelten diese Gründe auch nach der Erweiterung des Request-Bodys. Eine Neubewertung lohnt sich nur, wenn die Aufteilung ausschließlich dazu diente, das Limit von 32 MB zu umgehen.
F6: Welche Einschränkungen sind bei der Erweiterung des Claude-API-Request-Bodys bekannt?
Es gibt drei wichtige Einschränkungen: Für die Endpunkte Sessions / Agents / Environments gilt weiterhin ein Limit von 32 MB; für die Seitenzahl von PDFs und das Kontextfenster gelten separate Beschränkungen; und Unternehmens-Gateways, Proxys sowie Drittanbieterplattformen können niedrigere Obergrenzen haben. Wer mehrere Modelle bei der Verarbeitung großer Dokumente vergleichen möchte, kann dafür die einheitliche Schnittstelle von APIYI auf apiyi.com nutzen. Maßgeblich ist jedoch die tatsächlich von der Plattform unterstützte Obergrenze.
Die wichtigsten Punkte zur Erhöhung des Claude-API-Request-Body-Limits
- Was sich geändert hat: Das Request-Body-Limit für Messages und Token Counting steigt von 32 MB auf 128 MB. Die Änderung betrifft die HTTP-Ebene.
- Was gleich bleibt: Kontextfenster, Ausgabelänge und Token-Abrechnung ändern sich nicht.
- Unterschiede zwischen Endpunkten: Für Batch gelten 256 MB, für Files 500 MB. Endpunkte der Agents-Kategorie bleiben bei 32 MB.
- Entscheidungsgrundlage: Prüfen Sie, ob die bisherige Aufteilung der Anfragen Größenlimits umgeht oder der Qualität, den Kosten und der Performance dient.
- Prüfung der Übertragungskette: Limits von Gateways, Proxys und SDKs greifen oft früher als das offizielle Limit.
- So testen Sie: Vergleichen Sie für vier Größenklassen die direkte Übertragung, Dateireferenzen und die Aufteilung in Blöcke. Dafür können Sie die einheitliche Schnittstelle von APIYI unter apiyi.com nutzen.
Fazit: Ein größerer Claude-API-Request-Body bedeutet nicht, dass Sie Ihr bestehendes System umbauen müssen
Die Erhöhung des Claude-API-Request-Body-Limits lässt sich auf drei Punkte bringen:
- Mehr Platz beim Eingang: Über die direkte Messages-Schnittstelle lassen sich pro Anfrage mehr Bytes senden. Anwendungen, die bisher an 413-Fehlern scheiterten, haben dadurch mehr Spielraum.
- Andere Grenzen bleiben bestehen: Kontextfenster, PDF-Seitenzahl, Token-Abrechnung und die Limits anderer Endpunkte müssen weiterhin separat geprüft werden.
- Der Engpass entscheidet über Änderungen: Architekturänderungen sollten sich an tatsächlichen Engpässen sowie an Anforderungen an Ergebnisqualität, Kosten und Sicherheit orientieren – nicht allein an der Nachricht über das höhere Limit.
Für die meisten Unternehmen ist es sinnvoll, zuerst die Logs zu prüfen, dann mit Beispieldaten zu testen und erst anschließend über den Umfang der Änderungen zu entscheiden. Diese Checkliste können Sie direkt verwenden:
- [ ] Häufigkeit und betroffene Endpunkte von 413-Fehlern mit
request_too_largein den letzten Logs ermitteln - [ ] Verwendete Endpunkte und ihre offiziellen Limits prüfen (Messages / Batch / Files / Agents)
- [ ] Request-Body-Limits eigener Gateways, Reverse-Proxys, WAFs und Load Balancer prüfen
- [ ] Timeout- und Pufferkonfiguration von SDK und HTTP-Client prüfen und die Größenvergrößerung durch Base64 berücksichtigen
- [ ] Mit der Token Counting API die Token-Zahl großer Anfragen und den verbleibenden Platz im Kontextfenster abschätzen
- [ ] Für vier Größenklassen die direkte Übertragung, Referenzen über die Files API und die Aufteilung in Blöcke vergleichen
- [ ] Mandantentrennung für
file_idund Datensicherheitsrichtlinien prüfen - [ ] Anhand der Ergebnisse über Anpassungen entscheiden und die interne technische Dokumentation aktualisieren
Mit APIYI unter apiyi.com lässt sich schnell eine Vergleichstestumgebung aufbauen. Über einen API-Schlüssel können Sie verschiedene gängige Modelle aufrufen und die Vor- und Nachteile der Ansätze anhand echter Beispieldaten prüfen.
📚 Quellen
- Offizielle Release Notes von Anthropic: Ankündigung zur Anhebung der Größenbegrenzung für den Request-Body vom 28. Oktober 2026
- Link:
platform.claude.com/docs/en/release-notes/overview -
Hinweis: Originalquelle für die Anhebung von 32 MB auf 128 MB (S1)
-
Claude API: Übersicht und Endpunktlimits: Größenlimits für Anfragen je Endpunkt und Erläuterung des Fehlers 413
- Link:
platform.claude.com/docs/en/api/overview -
Hinweis: Vergleich der Limits für Endpunkte wie Messages, Batch, Files und Agents (S2)
-
Dokumentation zur PDF-Unterstützung: Limits für den Request-Body und die Seitenzahl bei PDFs
- Link:
platform.claude.com/docs/en/build-with-claude/pdf-support -
Hinweis: Vor der Verarbeitung großer PDFs lesen (S3)
-
Files-API-Dokumentation: Datei-Uploads, Referenzierung über
file_id, Speicherung und Berechtigungen - Link:
platform.claude.com/docs/en/build-with-claude/files -
Hinweis: Grundlage für die Bewertung von Dateireferenzen und Mandantentrennung (S4)
-
Dokumentation zum Kontextfenster: Angaben zur Token-Kapazität der Modelle
- Link:
platform.claude.com/docs/en/build-with-claude/context-windows -
Hinweis: Erläutert den Unterschied zwischen Byte- und Token-Limits (S5)
-
Offizielle Informationen zu Preisen und Caching: Token-Abrechnung und Prompt-Caching
- Link:
platform.claude.com/docs/en/about-claude/pricing - Hinweis: Grundlage für die Einschätzung der Kosten (S6)
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns über die Startseite von APIYI unter apiyi.com. Weitere Informationen zur Integration finden Sie im Dokumentationszentrum unter docs.apiyi.com.